Crawl4AI sur GKE Autopilot
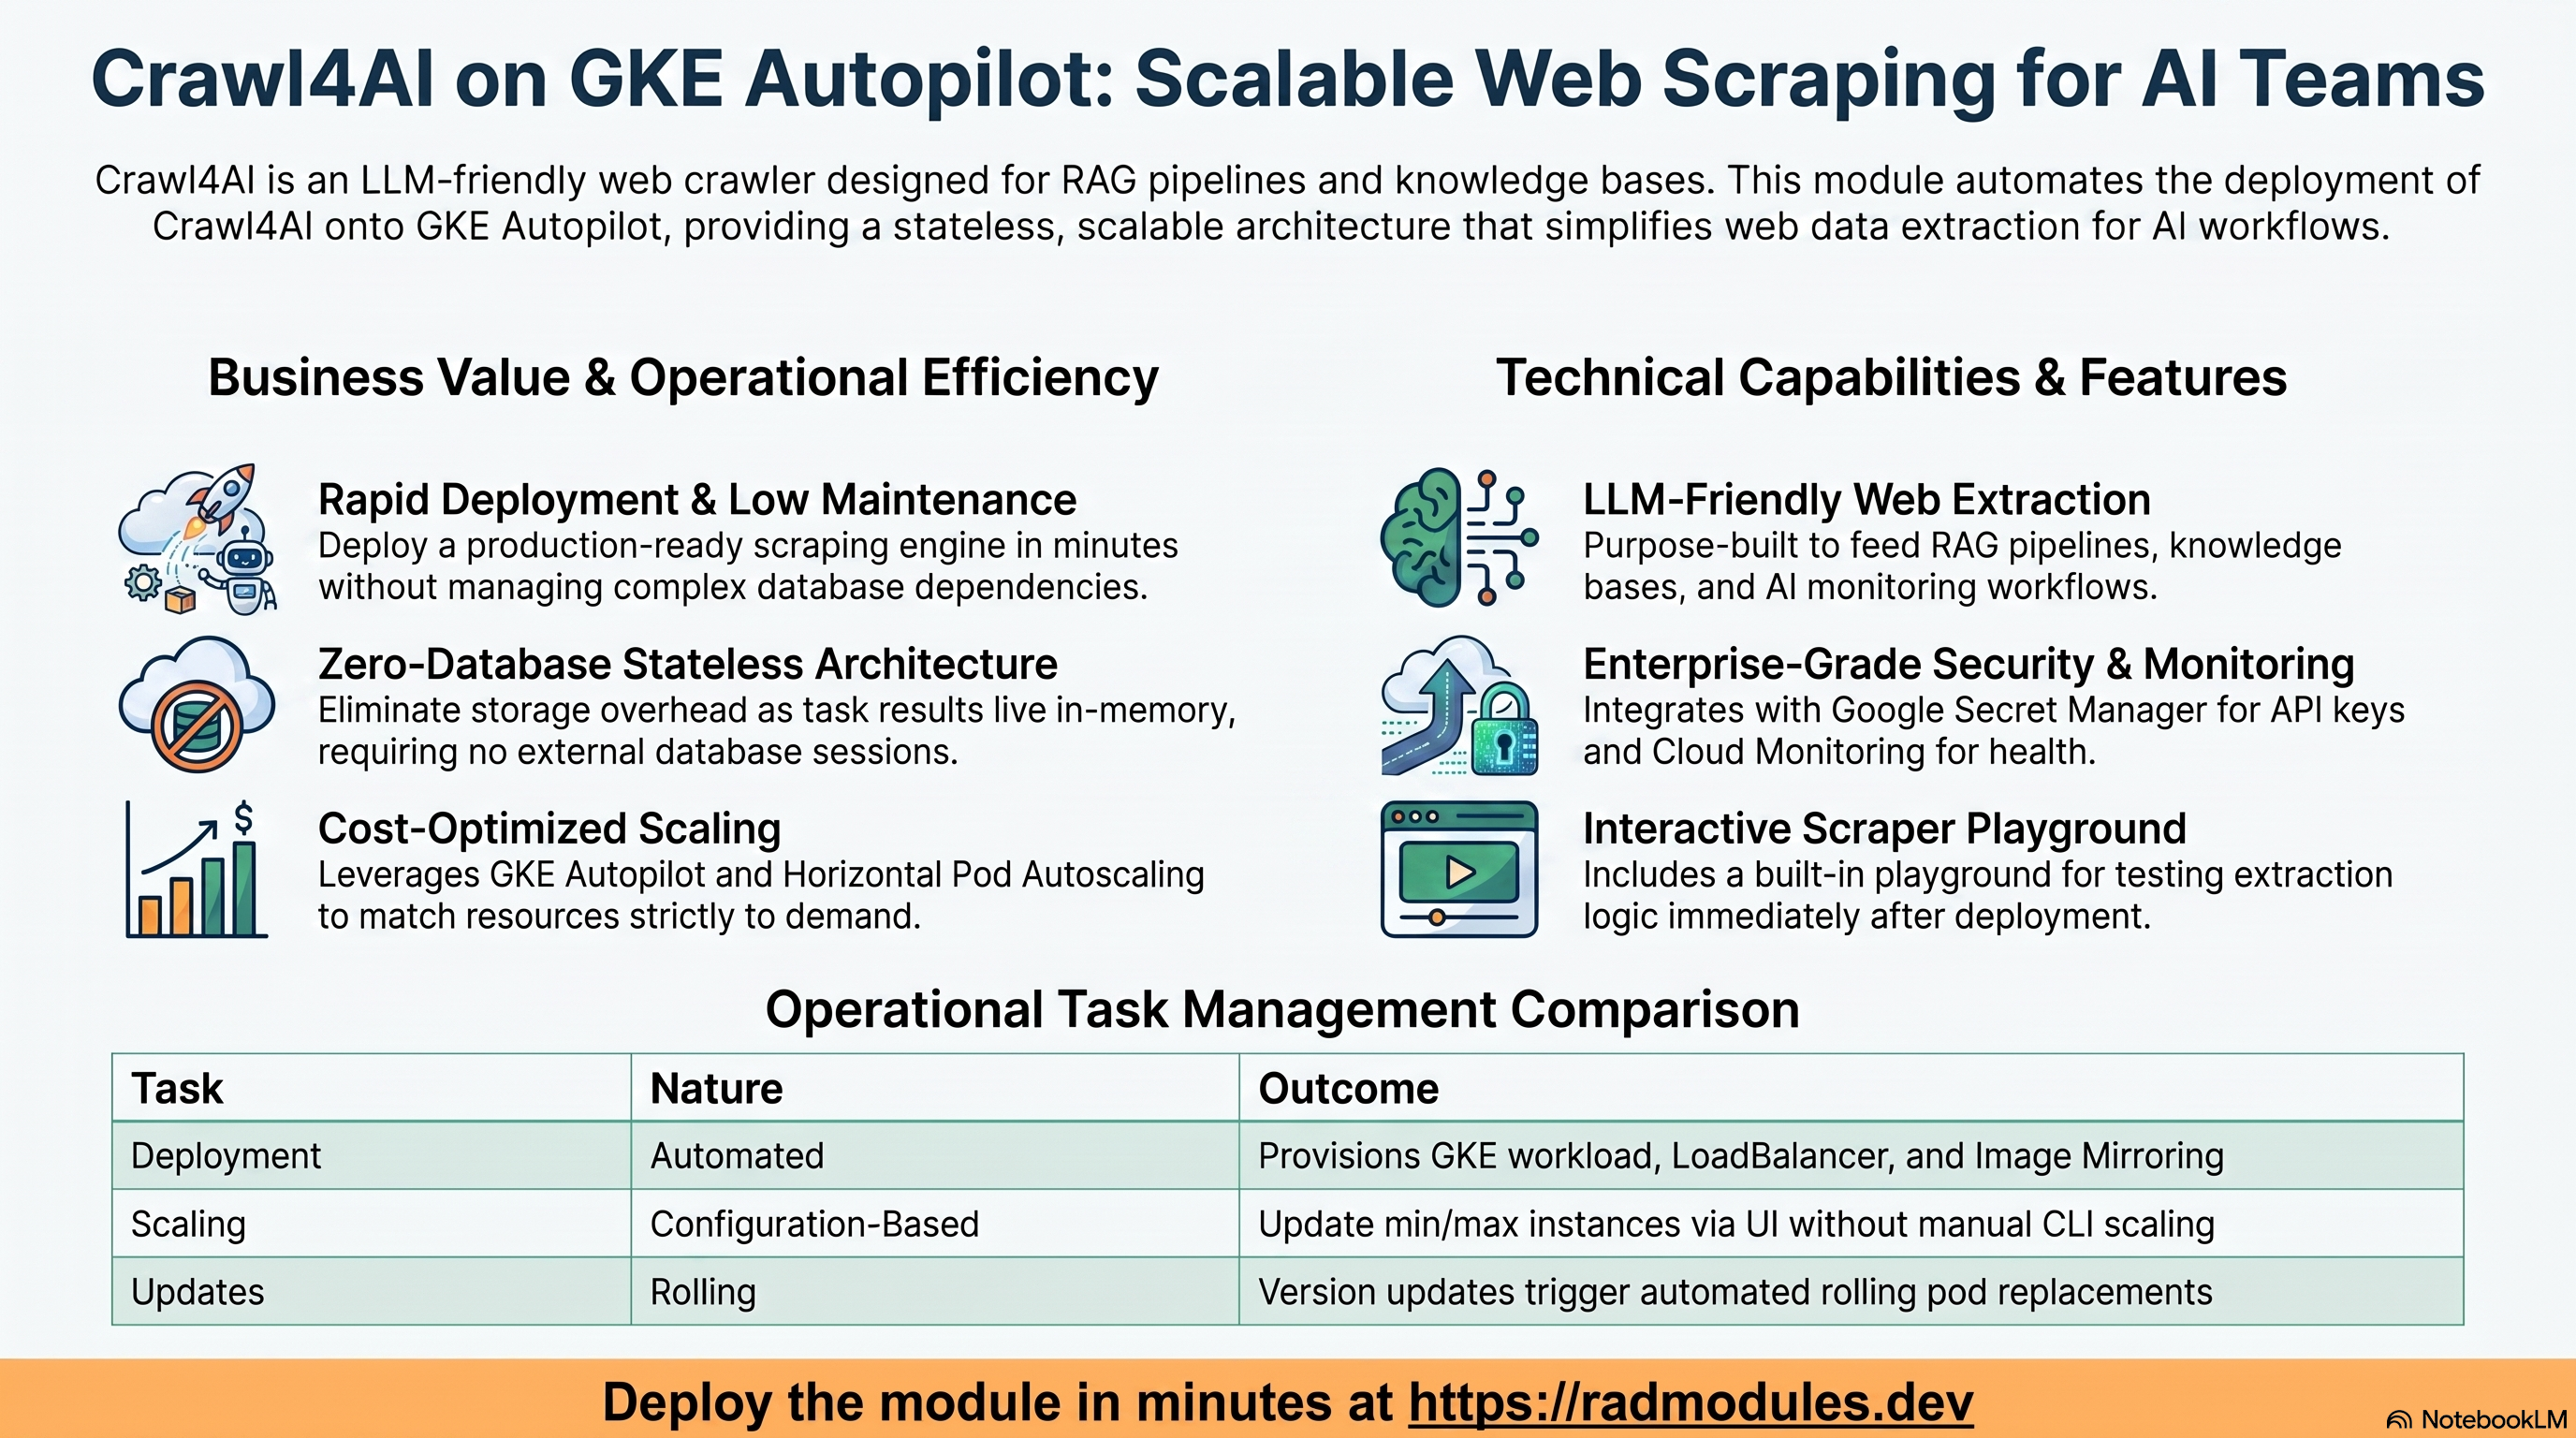
Crawl4AI est un robot d'exploration et extracteur web open source adapté aux LLM. Ce module déploie Crawl4AI sur GKE Autopilot au-dessus du socle App_GKE, qui provisionne et gère l'infrastructure Google Cloud et Kubernetes partagée.
Ce guide se concentre sur les services cloud qu'utilise Crawl4AI et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à toute application GKE — Workload Identity, entrée, mise à l'échelle automatique, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide du socle App_GKE plutôt que de les répéter ici.
1. Vue d'ensemble
Crawl4AI s'exécute comme un service Python/ASGI géré par supervisord. Le déploiement assemble un ensemble ciblé de services Google Cloud :
| Fonctionnalité | Service Google Cloud | Remarques |
|---|---|---|
| Calcul | GKE Autopilot | Pods Python, 4 vCPU / 8 GiB par défaut, mise à l'échelle horizontale automatique |
| File de tâches | Redis intégré (dans le pod) | Supervisord démarre Redis dans le conteneur ; éphémère par pod |
| Serveur ASGI | Gunicorn intégré (dans le pod) | Port 11235, géré par supervisord aux côtés de Redis |
| Stockage d'objets | Cloud Storage | Buckets facultatifs pour la mise en cache des résultats d'exploration (aucun par défaut) |
| Secrets | Secret Manager | Clés d'API et secret JWT injectés à l'exécution |
| Entrée | Cloud Load Balancing | LoadBalancer externe, domaine personnalisé et certificat géré facultatifs |
Valeurs par défaut judicieuses à connaître d'emblée :
- Pas de base de données externe.
database_typeest fixé àNONE— Cloud SQL n'est pas provisionné. Tout l'état des tâches réside dans l'instance Redis du pod et est perdu au redémarrage du pod. - Gen2 n'est pas un sujet sur GKE. Contrairement à Cloud Run, GKE fournit une véritable
arborescence de processus Linux, si bien que supervisord s'exécute sans contrainte. Chromium dispose d'un
vrai volume emptyDir
/dev/shm— le contournement Cloud Run--disable-dev-shm-usagen'est pas nécessaire. - Redis s'exécute dans le pod. Ne définissez pas
REDIS_HOSTniREDIS_PORTcomme variables d'environnement — ils doivent rester àlocalhost:6379pour joindre l'instance intégrée. - L'affinité de session est
None. Les identifiants de tâche émis par un pod ne sont pas visibles des autres pods ; les clients qui interrogent l'état d'une tâche doivent renvoyer leurs requêtes vers le pod d'origine ou utiliser des appels d'exploration synchrones (POST /crawl/sync). - La sécurité est désactivée par défaut. L'authentification JWT exige de fournir un
SECRET_KEYviasecret_environment_variableset unconfig.ymlpersonnalisé avecsecurity.jwt_enabled=true.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que vous avez exécuté
gcloud container clusters get-credentials <cluster> --region <region> --project <project>
et que PROJECT, REGION et NAMESPACE sont définis. L'espace de noms et les autres
identifiants figurent dans les sorties du déploiement.
A. GKE Autopilot — la charge de travail Crawl4AI
Les pods Crawl4AI s'exécutent sur Autopilot, qui facture le CPU et la mémoire que les pods demandent réellement. L'autoscaling horizontal des pods dimensionne le déploiement entre le nombre minimal et le nombre maximal de réplicas. Chaque pod exécute sa propre arborescence supervisord : Redis (priorité 10) démarre en premier, puis Gunicorn (priorité 20).
- Console : Kubernetes Engine → Workloads → sélectionnez la charge de travail Crawl4AI pour voir les pods, les révisions et les événements. Kubernetes Engine → Services & Ingress affiche l'adresse IP externe.
- CLI :
kubectl get pods,svc,hpa -n "$NAMESPACE"
kubectl logs -n "$NAMESPACE" deploy/<service-name> --tail=100
kubectl describe hpa -n "$NAMESPACE"          # current vs target utilisation
# Confirm supervisord is managing both processes:
kubectl exec -n "$NAMESPACE" deploy/<service-name> -- supervisorctl status
Consultez App_GKE pour la gestion d'Autopilot, de la mise à l'échelle et du type de charge de travail (Deployment ou StatefulSet).
B. Redis intégré et file de tâches
Redis s'exécute dans chaque pod comme processus géré par supervisord sur
localhost:6379. Il stocke les résultats des tâches avec une durée de vie configurable
(redis_task_ttl_seconds, 3600 s par défaut). Les résultats des tâches sont perdus au redémarrage
du pod — c'est attendu pour une API d'exploration éphémère. Il n'existe aucune instance
Memorystore ; le Redis intégré n'apparaît pas dans la console.
- CLI (depuis l'intérieur d'un pod) :
kubectl exec -n "$NAMESPACE" deploy/<service-name> -- redis-cli ping
kubectl exec -n "$NAMESPACE" deploy/<service-name> -- redis-cli info keyspace
kubectl exec -n "$NAMESPACE" deploy/<service-name> -- redis-cli dbsize
C. Cloud Storage (facultatif)
Crawl4AI n'a pas de bucket GCS par défaut — il est sans état. Des buckets facultatifs peuvent être
provisionnés via storage_buckets pour stocker les résultats d'exploration ou des fichiers
config.yml personnalisés.
- Console : Cloud Storage → Buckets.
- CLI :
gcloud storage buckets list --project "$PROJECT"
gcloud storage ls gs://<results-bucket>/
Consultez App_GKE pour les montages GCS Fuse et les options CMEK.
D. Secret Manager
Les clés d'API des LLM et le secret de signature JWT sont stockés comme secrets Secret Manager
et injectés dans les pods à l'exécution ; le texte en clair n'apparaît jamais dans la configuration.
Crawl4AI n'a aucun secret généré automatiquement — tous les secrets doivent être fournis via
secret_environment_variables.
- Console : Security → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
Noms de secrets reconnus (transmettez le nom du secret Secret Manager, pas sa valeur) :
SECRET_KEY, OPENAI_API_KEY, ANTHROPIC_API_KEY, DEEPSEEK_API_KEY,
GROQ_API_KEY, GEMINI_API_KEY, LLM_API_KEY.
Consultez App_GKE pour l'intégration Secret Store CSI et la rotation.
E. Réseau et entrée
Par défaut, la charge de travail est exposée via une adresse IP externe Cloud Load Balancing. Un domaine personnalisé avec un certificat géré par Google peut être activé, et une adresse IP statique peut être réservée afin que l'adresse survive aux redéploiements.
- Console : Network services → Load balancing ; VPC network → IP addresses.
- CLI :
kubectl get ingress,svc -n "$NAMESPACE"
gcloud compute addresses list --project "$PROJECT"
Consultez App_GKE pour les domaines personnalisés, Cloud CDN et les détails sur les adresses IP statiques.
F. Cloud Logging et Monitoring
La sortie stdout/stderr des pods (journaux Python via PYTHONUNBUFFERED=1) est acheminée vers Cloud Logging.
Les métriques GKE sont acheminées vers Cloud Monitoring. Des tests de disponibilité et des règles d'alerte
facultatifs sont disponibles.
- Console : Logging → Logs Explorer ; Monitoring → Dashboards / Alerting.
- CLI :
gcloud logging read 'resource.type="k8s_container" AND resource.labels.namespace_name="'"$NAMESPACE"'"' \
  --project "$PROJECT" --limit 50
3. Comportement de l'application Crawl4AI
-
Séquence de démarrage de supervisord. À chaque démarrage de pod, supervisord (PID 1) démarre d'abord Redis (priorité 10), puis Gunicorn (priorité 20). Le point de terminaison
/healthne répond qu'une fois les deux processus prêts — prévoyez au moins 40 secondes de délai initial avant le début des contrôles de santé. -
Points de terminaison de l'API REST. Crawl4AI expose :
Point de terminaison Méthode Rôle /crawlPOST Soumettre une tâche d'exploration asynchrone ; renvoie un task_id/task/{id}GET Interroger l'état et récupérer les résultats d'une tâche /crawl/syncPOST Exploration synchrone (bloque jusqu'à la fin) /healthGET Contrôle de santé — renvoie {"status":"ok"}lorsque le service est prêt/playgroundGET Interface d'exploration interactive dans le navigateur -
Cycle de vie des résultats de tâche. Les résultats d'exploration asynchrone sont stockés dans le Redis intégré avec une durée de vie de
redis_task_ttl_seconds(1 heure par défaut). Une fois cette durée écoulée, le résultat disparaît. Il n'existe aucun stockage durable des résultats. -
Aucune migration de base de données ni job d'initialisation. Crawl4AI est entièrement sans état —
Crawl4AI_Commonne fournit aucun job d'initialisation. Aucune configuration de base de données n'est requis. -
Extraction fondée sur les LLM. Fournissez les clés d'API des LLM via
secret_environment_variableset définissezLLM_PROVIDER(ou des clés propres au fournisseur commeOPENAI_API_KEY) viaenvironment_variablespour activer l'extraction de contenu pilotée par l'IA. -
Authentification JWT (facultative). La sécurité est désactivée par défaut. Pour l'activer, fournissez
SECRET_KEYviasecret_environment_variablesainsi qu'unconfig.ymlpersonnalisé avecsecurity.jwt_enabled=true. Le point de terminaison/tokenémet des JWT de courte durée lorsque l'authentification est activée. -
Avertissement sur
CRAWL4AI_HOOKS_ENABLED. Définir cette variable sur"true"permet l'exécution de code Python arbitraire via des hooks de webhook. Ne l'activez que dans un environnement entièrement de confiance.
4. Variables de configuration
Les variables sont regroupées exactement comme sur la plateforme de déploiement. Seuls les paramètres propres à Crawl4AI ou notables pour lui sont listés ; toutes les autres entrées sont héritées d'App_GKE avec leur comportement et leurs valeurs par défaut standard.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Projet Google Cloud cible. |
region | us-central1 | Région de la charge de travail et des ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques par environnement. |
support_users | [] | Adresses e-mail recevant l'accès au projet et les alertes de surveillance. |
resource_labels | {} | Libellés appliqués à toutes les ressources pour le suivi des coûts et de la propriété. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | crawl4ai | Nom de base des ressources. Ne le modifiez pas après le premier déploiement. |
application_display_name | Crawl4AI Web Crawler | Nom convivial affiché dans la console. |
application_description | (défini) | Annotation de description de la charge de travail. |
application_version | 0.7.8 | Tag de version de l'image Crawl4AI ; épinglez un tag précis en production. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définissez false pour provisionner l'IAM sans déployer la charge de travail. |
workload_type | null | "Deployment" (par défaut, sans état) ou "StatefulSet" pour une mise en cache adossée à un PVC. |
container_resources | { cpu_limit="4", memory_limit="8Gi", cpu_request="2", mem_request="4Gi" } | CPU et mémoire du conteneur. Minimum 4 GiB de mémoire pour un fonctionnement stable de Chromium. |
min_instance_count | 1 | Nombre minimal de réplicas. Gardez ≥ 1 afin qu'un pool Chromium chaud soit toujours disponible. |
max_instance_count | 5 | Nombre maximal de réplicas (plafond de l'autoscaler). |
timeout_seconds | 1800 | Délai de grâce d'arrêt du pod ; définissez ≥ 1800 pour laisser les longues explorations par lots se terminer. |
termination_grace_period_seconds | 60 | Secondes pendant lesquelles Kubernetes attend après SIGTERM avant l'arrêt forcé. |
service_type | LoadBalancer | Mode d'exposition du Service. Utilisez ClusterIP pour un accès interne au cluster uniquement. |
session_affinity | None | Pas de routage persistant — les identifiants de tâche sont locaux au pod ; utilisez /crawl/sync pour une fiabilité entre pods. |
container_image_source | prebuilt | "prebuilt" utilise directement unclecode/crawl4ai ; "custom" construit l'image via Cloud Build. |
container_image | unclecode/crawl4ai | URI de l'image lorsque container_image_source = "prebuilt". |
enable_image_mirroring | true | Met en miroir l'image dans Artifact Registry pour éviter les limites de débit de Docker Hub. |
enable_vertical_pod_autoscaling | false | Laisse Autopilot ajuster automatiquement les demandes de ressources. |
Groupe 5 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Paramètres supplémentaires non secrets. PYTHONUNBUFFERED et REDIS_TASK_TTL sont définis automatiquement. Ne définissez pas REDIS_HOST ni REDIS_PORT. Surcharges reconnues : LLM_PROVIDER, LLM_BASE_URL, LLM_TEMPERATURE, CRAWL4AI_HOOKS_ENABLED. |
secret_environment_variables | {} | Table de correspondance variable d'environnement → nom du secret Secret Manager. À utiliser pour SECRET_KEY, OPENAI_API_KEY, ANTHROPIC_API_KEY, etc. |
Groupe 6 — Backend GKE et cluster
| Variable | Valeur par défaut | Description |
|---|---|---|
gke_cluster_name | "" | Nom du cluster cible. Laissez vide pour une découverte automatique. |
gke_cluster_selection_mode | primary | Stratégie de sélection du cluster. |
namespace_name | "" | Espace de noms Kubernetes. Généré à partir du préfixe de ressource lorsqu'il est vide. |
enable_multi_cluster_service | false | Active le ServiceExport Multi-Cluster Services. |
reserve_static_ip | true | Réserve une adresse IP externe statique pour l'équilibreur de charge afin que l'adresse survive aux redéploiements (valeur par défaut de toute la flotte selon la campagne GKE — une adresse IP éphémère peut sinon laisser GKE_SERVICE_URL/une configuration auto-référencée pointer vers un DNS interne injoignable). |
static_ip_name | "" | Nom d'une adresse IP statique existante à utiliser. Laissez vide pour une création automatique. |
Groupe 7 — Sauvegarde et maintenance
Sans objet pour Crawl4AI — le service est sans état et ne comporte aucune base de données.
backup_schedule, backup_retention_days et enable_backup_import sont
présents pour la compatibilité de l'interface mais n'ont aucun effet.
Groupe 8 — Quota de ressources
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_resource_quota | false | Plafonne le CPU, la mémoire et le nombre d'objets de l'espace de noms. |
quota_cpu_requests | 8 | Total des demandes de CPU autorisées pour l'ensemble des pods. |
quota_cpu_limits | 16 | Total des limites de CPU autorisées. |
quota_memory_requests | 32Gi | Doit utiliser des unités binaires (32Gi, 8192Mi) — des entiers nus sont lus comme des octets et bloquent l'ordonnancement. |
quota_memory_limits | 64Gi | Doit utiliser des unités binaires — même contrainte que quota_memory_requests. |
quota_max_pods | 20 | Nombre maximal de pods dans l'espace de noms. |
Groupe 9 — CI/CD et intégration GitHub
Intégration Cloud Build / Cloud Deploy standard d'App_GKE — consultez
App_GKE. Entrées principales : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy.
Groupe 10 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Crawl4AI_Common ne fournit aucun job d'initialisation par défaut — laissez vide sauf si une étape de configuration personnalisée est nécessaire. |
cron_jobs | [] | CronJobs Kubernetes facultatifs (par exemple, explorations périodiques de préchauffage du cache). |
Groupe 11 — Cloud Storage et Artifact Registry
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Provisionne les buckets listés dans storage_buckets. |
storage_buckets | [] | Aucun bucket par défaut — Crawl4AI est sans état. Ajoutez des entrées pour provisionner des buckets de résultats d'exploration. |
gcs_volumes | [] | Montages GCS Fuse. |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options CMEK. |
max_images_to_retain / delete_untagged_images / image_retention_days | (défini) | Règle de nettoyage d'Artifact Registry. |
Groupe 12 — Backend de base de données
| Variable | Valeur par défaut | Description |
|---|---|---|
database_type | NONE | Fixe — aucune instance Cloud SQL n'est provisionnée pour Crawl4AI. |
Toutes les autres variables de base de données (enable_cloudsql_volume, sql_instance_name,
etc.) sont présentes pour la compatibilité de l'interface et n'ont aucun effet.
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe_config / startup_probe | HTTP /health, délai initial de 40 s | Laisse à supervisord le temps de démarrer Redis puis Gunicorn avant le déclenchement de la première sonde. |
health_check_config / liveness_probe | HTTP /health, délai initial de 60 s | Sonde de vivacité après le démarrage. |
uptime_check_config | désactivé | Test de disponibilité Cloud Monitoring facultatif. |
alert_policies | [] | Règles d'alerte sur métriques facultatives. |
Groupe 16 — Fonctionnalités GKE avancées
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_pod_disruption_budget | true | Protège la disponibilité pendant les mises à niveau des nœuds. Ignoré automatiquement lorsque max_instance_count ≤ 1. |
pdb_min_available | 1 | Augmentez min_instance_count au-delà de 1 si vous avez besoin de marge lors des évictions. |
enable_topology_spread | false | Répartit les pods entre les zones. |
enable_network_segmentation | false | Applique des NetworkPolicies Kubernetes pour isoler l'espace de noms. |
Groupe 17 — StatefulSet
| Variable | Valeur par défaut | Description |
|---|---|---|
stateful_pvc_enabled | null | Active les modèles de PVC si la persistance d'un cache local est requise. |
stateful_pvc_size | 20Gi | Taille du PVC par pod. |
stateful_pvc_mount_path | /mnt/data | Chemin du PVC dans le conteneur. |
stateful_pvc_storage_class | standard-rwo | StorageClass Kubernetes. |
Groupe 19 — Paramètres de l'application Crawl4AI
| Variable | Valeur par défaut | Description |
|---|---|---|
redis_task_ttl_seconds | 3600 | Durée de vie en secondes des résultats de tâche dans le Redis intégré. Plage valide : 300–86400. Trop courte, les résultats expirent avant que les clients ne les interrogent ; trop longue, la mémoire croît sans limite. |
5. Sorties
Ces valeurs sont renvoyées lors d'un déploiement réussi et constituent le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du Service Kubernetes. |
namespace | Espace de noms dans lequel s'exécute la charge de travail. |
service_cluster_ip | ClusterIP interne au cluster. |
stage_service_cluster_ips | Table des ClusterIP des services propres à chaque étape (Cloud Deploy). |
service_external_ip | Adresse IP externe du LoadBalancer (lorsqu'une adresse IP statique est réservée). |
service_url | URL permettant de joindre Crawl4AI. |
storage_buckets | Buckets Cloud Storage créés. |
network_name / network_exists / regions | Réseau VPC, présence, régions disponibles. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels | État de la surveillance et canaux. |
initialization_jobs | Noms des éventuels jobs de configuration. |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / github_repository_url / github_repository_owner / github_repository_name / cicd_configuration | État et détails du CI/CD. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Registre et déclencheur de build. |
kubernetes_ready | Indique si le cluster et la charge de travail sont prêts. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État de VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | État de la journalisation d'audit et de CMEK. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
memory_limit (dans container_resources) | 8Gi | Critique | En dessous de 4 GiB, les processus Chromium sont tués pour manque de mémoire (OOM) en pleine exploration et renvoient des résultats partiels ; en dessous de 2 GiB, le conteneur ne démarre pas. |
quota_memory_requests / quota_memory_limits | unités binaires (32Gi) | Critique | Les entiers nus sont lus comme des octets par Kubernetes et bloquent l'ordonnancement de tous les pods. |
REDIS_HOST / REDIS_PORT (variables d'environnement) | ne pas définir | Critique | Les surcharger rompt la connexion au Redis intégré ; toutes les tâches d'exploration asynchrones échouent immédiatement. |
database_type | NONE | Critique | Crawl4AI n'a pas de base de données ; modifier cette valeur entraîne un provisionnement Cloud SQL inutile et un échec au démarrage. |
min_instance_count | 1 | Élevé | La mise à l'échelle à zéro (0) provoque des démarrages à froid de 30 à 60 s (supervisord doit lancer Redis puis Gunicorn) ; la première requête expire généralement. |
cpu_limit (dans container_resources) | 4 | Élevé | En dessous de 2 vCPU, le rendu JavaScript de Chromium déclenche des délais d'expiration internes sur les pages complexes, ce qui ralentit nettement le débit d'exploration. |
enable_iap / enable_cloud_armor | activer en production | Élevé | Sans IAP ni jeton d'API d'exploration, l'adresse IP du LoadBalancer est publiquement accessible et n'importe qui peut soumettre des tâches d'exploration. |
LLM_API_KEY / clés d'API des fournisseurs | via secret_environment_variables | Élevé | Des clés manquantes ou expirées font échouer silencieusement l'extraction fondée sur les LLM (extracted_content vide). Injectez-les comme secrets, pas comme variables d'environnement en clair. |
redis_task_ttl_seconds | 3600 | Moyen | Trop courte (< 300 s), les résultats expirent avant que les clients asynchrones ne les interrogent ; trop longue, la mémoire Redis croît sans limite. |
session_affinity | None | Moyen | La valeur ClientIP attache les clients à un seul pod et casse la répartition de charge sans aider au routage des tâches (les identifiants de tâche sont déjà locaux au pod). |
application_version | tag épinglé | Moyen | Utiliser "latest" n'est pas reproductible ; une reconstruction peut récupérer une modification incompatible de l'API Crawl4AI. |
enable_image_mirroring | true | Faible | Les images Crawl4AI sont volumineuses ; sans duplication, chaque démarrage de pod tire l'image depuis Docker Hub et risque des échecs dus aux limites de débit. |
Pour le comportement du socle évoqué tout au long de ce guide — IAM et Workload Identity, mise à l'échelle automatique, entrée et certificats, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC et mise en miroir des images — consultez App_GKE. La configuration applicative partagée propre à Crawl4AI est décrite dans Crawl4AI_Common.
Guides associés
- Lab pratique : Crawl4AI sur GKE Autopilot — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Crawl4AI sur Google Cloud Run — la même application sur Cloud Run, lorsque vous avez besoin de l'autre cible de déploiement.
- Crawl4AI Common — Configuration applicative partagée — la configuration partagée par les deux cibles de déploiement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.