Crawl4AI sur Google Cloud Run
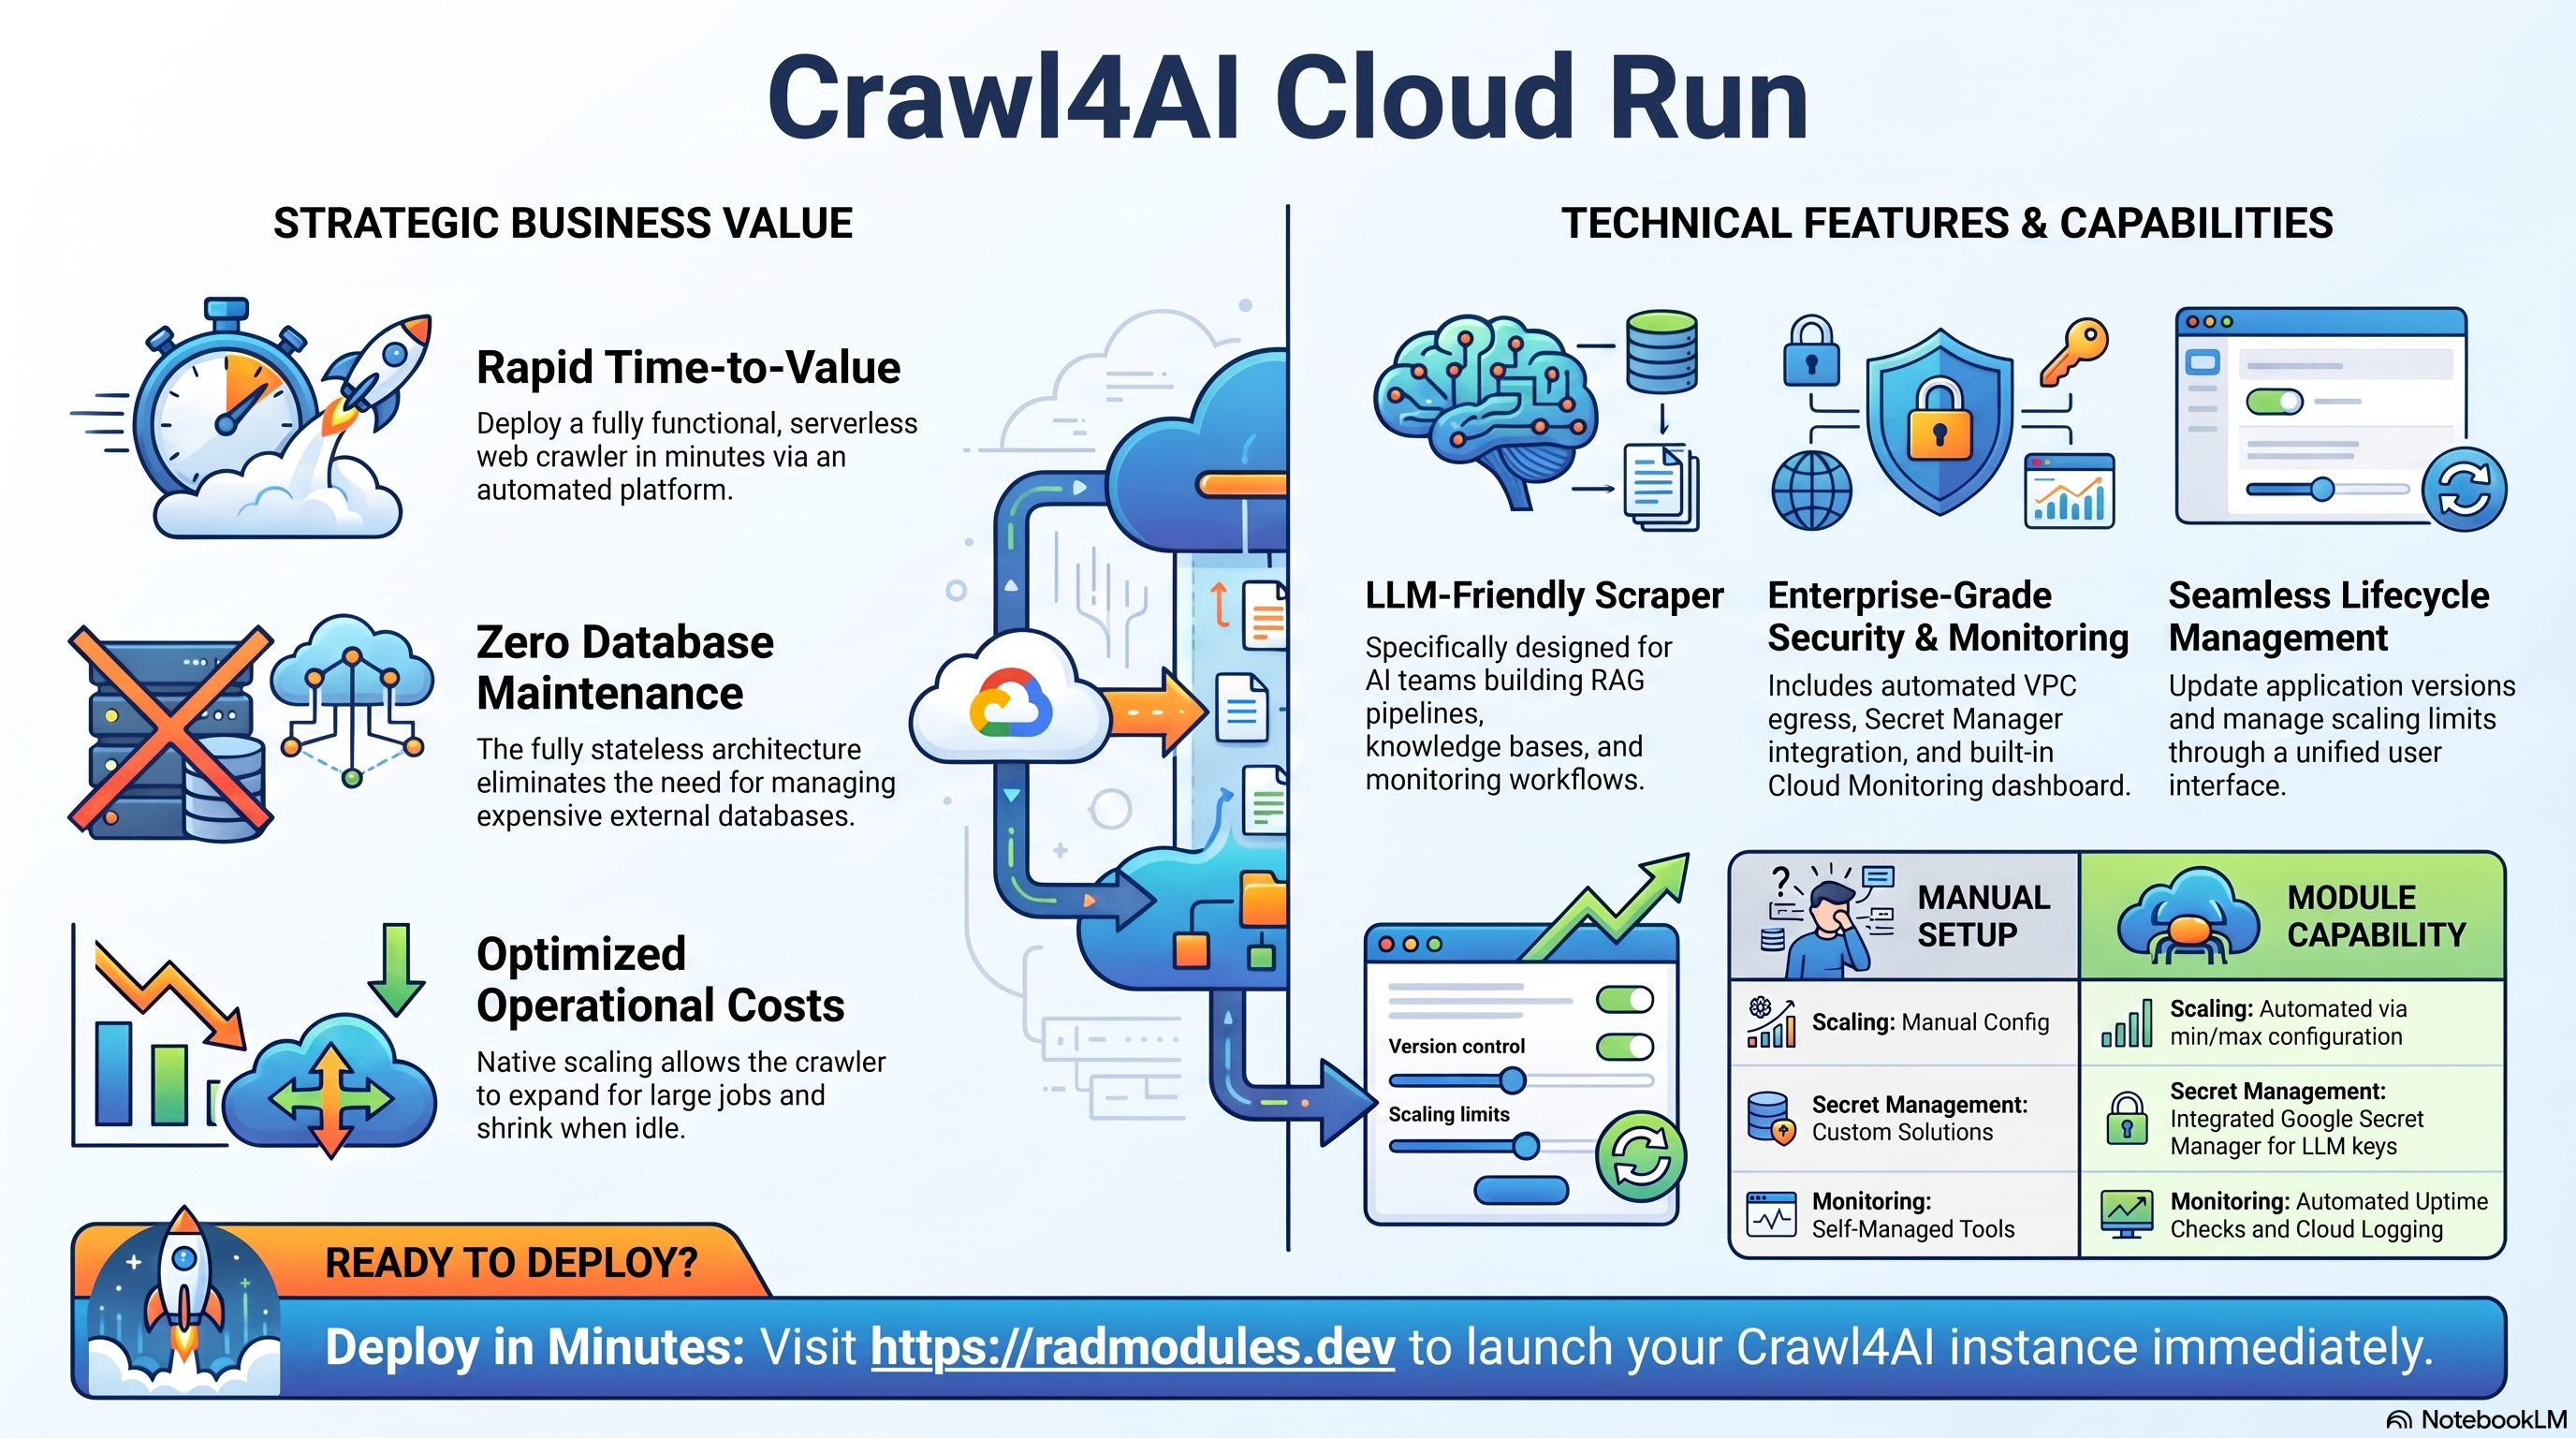
Crawl4AI est un robot d'exploration et extracteur web open source adapté aux LLM. Ce module déploie Crawl4AI sur Cloud Run v2 en s'appuyant sur le socle App_CloudRun, qui provisionne et gère l'infrastructure Google Cloud partagée.
Ce guide se concentre sur les services cloud utilisés par Crawl4AI et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à toutes les applications Cloud Run — identité du service, entrée et équilibrage de charge, mise à l'échelle et concurrence, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide du socle App_CloudRun plutôt que de les répéter ici.
1. Vue d'ensemble
Crawl4AI s'exécute sous forme de conteneur Python/ASGI sur Cloud Run v2 Gen2. Le déploiement assemble un ensemble ciblé de services Google Cloud :
| Fonctionnalité | Service Google Cloud | Remarques |
|---|---|---|
| Calcul | Cloud Run v2 (Gen2) | Service Python, 1 vCPU / 4 GiB par défaut, autoscaling basé sur les requêtes |
| File d'attente des tâches | Redis intégré (dans le conteneur) | Supervisord démarre Redis dans le conteneur ; éphémère, propre à chaque instance |
| Serveur ASGI | Gunicorn intégré (dans le conteneur) | Port 11235, géré par supervisord aux côtés de Redis |
| Stockage d'objets | Cloud Storage | Buckets facultatifs pour la mise en cache des résultats d'exploration (aucun par défaut) |
| Secrets | Secret Manager | Clés d'API et secret JWT injectés à l'exécution |
| Entrée | URL Cloud Run / Cloud Load Balancing | URL run.app par défaut ; équilibreur de charge HTTPS externe + domaine personnalisé en option |
Valeurs par défaut judicieuses à connaître d'emblée :
- Aucune base de données externe.
database_typeest fixé àNONE— Cloud SQL n'est pas provisionné. Tout l'état des tâches réside dans l'instance Redis du conteneur et est perdu au redémarrage du conteneur. - Gen2 est obligatoire. Supervisord a besoin d'une arborescence de processus
Linux complète, et Chromium utilise
/tmppour la mémoire partagée via--disable-dev-shm-usage. Gen1 ne le permet pas. - La sortie
ALL_TRAFFICest obligatoire. Le robot doit pouvoir atteindre des URL publiques arbitraires sur Internet ;PRIVATE_RANGES_ONLYbloque toutes les cibles d'exploration externes. - Redis s'exécute dans le conteneur. Ne définissez pas
REDIS_HOSTniREDIS_PORTcomme variables d'environnement — elles doivent rester àlocalhost:6379pour atteindre l'instance intégrée. - La sécurité est désactivée par défaut. L'authentification JWT nécessite de
fournir un
SECRET_KEYviasecret_environment_variableset unconfig.ymlpersonnalisé avecsecurity.jwt_enabled=true.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que PROJECT et REGION sont définis. Les noms
des services et des ressources figurent dans les sorties du
déploiement.
A. Cloud Run — le service Crawl4AI
Crawl4AI s'exécute comme un service Cloud Run v2 Gen2 qui se met à l'échelle automatiquement selon la charge de requêtes, entre le nombre minimal et le nombre maximal d'instances. Chaque déploiement crée une révision immuable ; le trafic peut être réparti entre les révisions pour des déploiements progressifs sûrs. Chaque instance exécute sa propre arborescence supervisord : Redis (priorité 10) démarre en premier, puis Gunicorn (priorité 20).
- Console : Cloud Run → sélectionnez le service pour les révisions, le trafic, les journaux et les métriques.
- CLI :
gcloud run services list --project "$PROJECT" --region "$REGION"
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION"
gcloud run revisions list --service <service-name> --project "$PROJECT" --region "$REGION"
Consultez App_CloudRun pour la mise à l'échelle, la concurrence, l'environnement d'exécution et la répartition du trafic.
B. Redis intégré et file d'attente des tâches
Redis s'exécute dans chaque instance de conteneur sous forme de processus géré
par supervisord sur localhost:6379. Il stocke les résultats des tâches avec une
durée de vie (TTL) configurable (redis_task_ttl_seconds, 3600 s par défaut).
Les résultats des tâches sont perdus au redémarrage du conteneur — ce qui est
attendu pour une API d'exploration éphémère. Il n'existe pas d'instance
Memorystore ; le Redis intégré n'apparaît pas dans la console.
Il n'y a pas d'accès shell direct sur Cloud Run, mais vous pouvez observer le comportement de Redis à partir des journaux :
gcloud run services logs read <service-name> --project "$PROJECT" --region "$REGION" \
  --filter="supervisord" --limit 50
C. Cloud Storage (facultatif)
Crawl4AI n'a pas de bucket GCS par défaut — il est sans état. Des buckets
facultatifs peuvent être provisionnés via storage_buckets pour stocker les
résultats d'exploration ou des fichiers config.yml personnalisés.
- Console : Cloud Storage → Buckets.
- CLI :
gcloud storage buckets list --project "$PROJECT"
gcloud storage ls gs://<results-bucket>/
Consultez App_CloudRun pour les montages GCS Fuse et CMEK.
D. Secret Manager
Les clés d'API des LLM et le secret de signature JWT sont stockés sous forme de
secrets Secret Manager et injectés dans le service à l'exécution ; aucune valeur
en clair n'apparaît dans la configuration. Crawl4AI n'a aucun secret généré
automatiquement — tous les secrets doivent être fournis via
secret_environment_variables.
- Console : Security → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
Noms de secrets reconnus (transmettez le nom du secret Secret Manager, et non la
valeur) : SECRET_KEY, OPENAI_API_KEY, ANTHROPIC_API_KEY,
DEEPSEEK_API_KEY, GROQ_API_KEY, GEMINI_API_KEY, LLM_API_KEY.
Consultez App_CloudRun pour les détails d'injection et de rotation.
E. Réseau et entrée
Le service est accessible par défaut à son URL run.app avec
ingress_settings = "all". Un équilibreur de charge HTTPS externe avec un
domaine personnalisé, Cloud CDN et Cloud Armor peuvent être ajoutés. La sortie
VPC est définie sur ALL_TRAFFIC afin que le robot puisse atteindre des URL
publiques arbitraires.
- Console : Cloud Run (URL du service) ; Network services → Load balancing.
- CLI :
gcloud run services describe <service-name> --region "$REGION" --format='value(status.url)'
gcloud compute addresses list --project "$PROJECT"
Consultez App_CloudRun.
F. Cloud Logging et Monitoring
Les journaux du conteneur (sortie Python diffusée via PYTHONUNBUFFERED=1) sont
envoyés à Cloud Logging. Les métriques de Cloud Run sont envoyées à Cloud
Monitoring, avec des tests de disponibilité et des règles d'alerte en option.
- Console : Logging → Logs Explorer ; Monitoring → Dashboards / Alerting.
- CLI :
gcloud run services logs read <service-name> --project "$PROJECT" --region "$REGION" --limit 50
3. Comportement de l'application Crawl4AI
-
Séquence de démarrage de supervisord. À chaque démarrage du conteneur, supervisord (PID 1) démarre d'abord Redis (priorité 10), puis Gunicorn (priorité 20). Le point de terminaison
/healthne répond qu'une fois les deux processus prêts — prévoyez un délai initial d'au moins 40 secondes avant le début des contrôles de santé. -
Points de terminaison de l'API REST. Crawl4AI expose :
Point de terminaison Méthode Objectif /crawlPOST Soumettre un job d'exploration asynchrone ; renvoie un task_id/task/{id}GET Interroger l'état et récupérer les résultats d'une tâche /crawl/syncPOST Exploration synchrone (bloque jusqu'à la fin) /healthGET Contrôle de santé — renvoie {"status":"ok"}lorsque le service est prêt/playgroundGET Interface d'exploration interactive dans le navigateur -
Cycle de vie des résultats des tâches. Les résultats des explorations asynchrones sont stockés dans le Redis intégré avec un TTL de
redis_task_ttl_seconds(1 heure par défaut). Une fois le TTL expiré, le résultat disparaît. Il n'existe aucun stockage durable des résultats. -
Aucune migration de base de données ni job d'initialisation. Crawl4AI est entièrement sans état —
Crawl4AI_Commonne fournit aucun job d'initialisation. Aucune configuration de base de données n'est nécessaire. -
Extraction basée sur les LLM. Fournissez les clés d'API des LLM via
secret_environment_variableset définissezLLM_PROVIDER(ou des clés propres à un fournisseur commeOPENAI_API_KEY) viaenvironment_variablespour activer l'extraction de contenu pilotée par l'IA. -
Authentification JWT (facultative). La sécurité est désactivée par défaut. Pour l'activer, fournissez
SECRET_KEYviasecret_environment_variableset unconfig.ymlpersonnalisé avecsecurity.jwt_enabled=true. Le point de terminaison/tokenémet des JWT de courte durée lorsque l'authentification est activée. -
Avertissement concernant
CRAWL4AI_HOOKS_ENABLED. Définir cette variable sur"true"permet l'exécution de code Python arbitraire via des hooks de webhook. Ne l'activez que dans un environnement entièrement de confiance.
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres propres à Crawl4AI ou notables pour lui sont listés ; toutes les autres entrées sont héritées d'App_CloudRun avec leur comportement standard.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Projet Google Cloud cible. |
region | us-central1 | Région du service et des ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques par environnement. |
support_users | [] | Adresses e-mail recevant un accès au projet et les alertes de surveillance. |
resource_labels | {} | Libellés appliqués à toutes les ressources. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | crawl4ai | Nom de base des ressources. Ne le modifiez pas après le premier déploiement. |
application_display_name | Crawl4AI Web Crawler | Nom convivial affiché dans la console. |
description | (défini) | Description du service. |
application_version | 0.7.8 | Tag de version de l'image Crawl4AI ; épinglez un tag précis en production. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définissez false pour provisionner uniquement l'infrastructure sans déployer le conteneur. |
cpu_limit | 1000m | CPU par instance ; ~0,5–1 vCPU par contexte de navigateur actif. |
memory_limit | 4Gi | Mémoire par instance. 4 GiB minimum pour un fonctionnement stable de Chromium ; 8 GiB recommandés pour les explorations simultanées. |
min_instance_count | 0 | Nombre minimal d'instances. Définissez 1 pour un pool Chromium maintenu actif ; la valeur par défaut 0 entraîne des démarrages à froid de 30–60 s. |
max_instance_count | 3 | Nombre maximal d'instances (plafond de coût). |
cpu_always_allocated | false | Facturation à la requête — une exploration s'exécute de manière synchrone dans sa requête HTTP, sans travail en arrière-plan après la réponse ; la limitation du CPU entre les requêtes est donc sans risque. |
execution_environment | gen2 | Obligatoire — Gen2 pour l'arborescence de processus de supervisord et la mémoire partagée /tmp de Chromium. |
timeout_seconds | 3600 | Durée maximale d'une requête ; définie au maximum de Cloud Run pour permettre les longs jobs d'exploration par lots. |
container_protocol | http1 | Version du protocole HTTP. |
enable_image_mirroring | true | Mettre en miroir l'image Crawl4AI dans Artifact Registry pour éviter les limites de débit de Docker Hub. |
traffic_split | [] | Répartition du trafic en pourcentage entre les révisions (canary/blue-green). |
Groupe 5 — Accès et réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
ingress_settings | all | Sources de trafic autorisées à atteindre le service. Utilisez "internal-and-cloud-load-balancing" lorsque le service est placé derrière Cloud Armor. |
vpc_egress_setting | ALL_TRAFFIC | Obligatoire — achemine tout le trafic sortant via le VPC afin que le robot puisse atteindre des URL publiques arbitraires. |
enable_iap | false | Exiger une connexion Google via Identity-Aware Proxy. |
iap_authorized_users / iap_authorized_groups | [] | Personnes autorisées à accéder via IAP. |
enable_cloud_armor | false | Provisionner un équilibreur de charge HTTPS global avec le WAF Cloud Armor. |
application_domains | [] | Noms d'hôte personnalisés pour l'équilibreur de charge externe. |
enable_cdn | false | Activer Cloud CDN sur le backend de l'équilibreur de charge. |
Groupe 6 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Paramètres supplémentaires non secrets. PYTHONUNBUFFERED et REDIS_TASK_TTL sont définis automatiquement. Ne définissez pas REDIS_HOST ni REDIS_PORT. Surcharges reconnues : LLM_PROVIDER, LLM_BASE_URL, LLM_TEMPERATURE, CRAWL4AI_HOOKS_ENABLED. |
secret_environment_variables | {} | Correspondance variable d'environnement → nom de secret Secret Manager. À utiliser pour SECRET_KEY, OPENAI_API_KEY, ANTHROPIC_API_KEY, etc. |
secret_propagation_delay | 30 | Nombre de secondes d'attente après la création d'un secret avant de poursuivre. |
secret_rotation_period | 2592000s | Fréquence des notifications de rotation de Secret Manager. |
Groupe 7 — Sauvegarde et restauration
Sans objet pour Crawl4AI — le service est sans état et n'a pas de base de
données. backup_schedule, backup_retention_days et enable_backup_import
sont présents pour la compatibilité de l'interface, mais n'ont aucun effet.
Groupe 8 — CI/CD et Binary Authorization
Intégration standard Cloud Build / Cloud Deploy d'App_CloudRun — consultez
App_CloudRun. Entrées principales : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy,
enable_binary_authorization.
Groupe 9 — Jobs et SQL personnalisé
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Crawl4AI_Common ne fournit aucun job d'initialisation par défaut — laissez vide sauf si une étape de configuration personnalisée est nécessaire. |
cron_jobs | [] | Cloud Run Jobs récurrents facultatifs déclenchés par Cloud Scheduler. |
enable_custom_sql_scripts | false | Sans objet pour Crawl4AI (pas de base de données). |
Groupe 11 — Stockage et système de fichiers
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Provisionner les buckets listés dans storage_buckets. |
storage_buckets | [] | Aucun bucket par défaut — Crawl4AI est sans état. Ajoutez des entrées pour provisionner des buckets de résultats d'exploration. |
enable_nfs | false | Provisionner un volume NFS Filestore. Non requis pour les déploiements Crawl4AI standard. |
gcs_volumes | [] | Montages GCS Fuse. |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options CMEK. |
Groupe 12 — Backend de base de données
| Variable | Valeur par défaut | Description |
|---|---|---|
database_type | NONE | Fixe — aucune instance Cloud SQL n'est provisionnée pour Crawl4AI. |
Toutes les autres variables de base de données (enable_cloudsql_volume,
database_password_length, etc.) sont présentes pour la compatibilité de
l'interface et n'ont aucun effet.
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe_config / startup_probe | HTTP /health, délai de 40 s | Laisse à supervisord le temps de démarrer Redis puis Gunicorn avant le déclenchement de la première sonde. |
health_check_config / liveness_probe | HTTP /health, délai de 60 s | Sonde de vivacité après le démarrage. |
uptime_check_config | désactivé par défaut, chemin /health | Test de disponibilité Cloud Monitoring. |
alert_policies | [] | Règles d'alerte facultatives basées sur des métriques. |
max_images_to_retain / delete_untagged_images / image_retention_days | (défini) | Règle de nettoyage d'Artifact Registry. |
Groupe 19 — Paramètres de l'application Crawl4AI
| Variable | Valeur par défaut | Description |
|---|---|---|
redis_task_ttl_seconds | 3600 | TTL en secondes des résultats des tâches dans le Redis intégré. Plage valide : 300–86400. Trop court, les résultats expirent avant que les clients ne les interrogent ; trop long, la mémoire croît sans limite. |
5. Sorties
Renvoyées lors d'un déploiement réussi — le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du service Cloud Run. |
service_url | URL run.app par défaut du service. |
service_location | Région dans laquelle s'exécute le service. |
stage_services | URL des services propres à chaque étape (Cloud Deploy). |
load_balancer_ip / load_balancer_url | IP / URL de l'équilibreur de charge HTTPS externe (lorsqu'il est activé). |
storage_buckets | Buckets Cloud Storage créés. |
network_name / network_exists / regions | Réseau VPC, présence, régions. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels / uptime_check_names | État de la surveillance, canaux, tests de disponibilité. |
initialization_jobs | Noms des éventuels jobs de configuration. |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / github_repository_url / github_repository_owner / github_repository_name / cicd_configuration | État et détails du CI/CD. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Dépôt et déclencheur de build. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État de VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | État de la journalisation d'audit et de CMEK. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
vpc_egress_setting | ALL_TRAFFIC | Critique | Utiliser PRIVATE_RANGES_ONLY bloque toutes les cibles d'exploration externes ; chaque exploration d'une URL publique échoue avec une erreur de connexion. |
memory_limit | 8Gi | Critique | En dessous de 4 GiB, les processus Chromium sont tués par OOM en pleine exploration et renvoient des résultats partiels ; en dessous de 2 GiB, le conteneur ne démarre pas. |
REDIS_HOST / REDIS_PORT (variables d'environnement) | à ne pas définir | Critique | Les remplacer casse la connexion au Redis intégré ; tous les jobs d'exploration asynchrones échouent immédiatement. |
database_type | NONE | Critique | Crawl4AI n'a pas de base de données ; modifier ce paramètre provoque un provisionnement Cloud SQL inutile et un échec au démarrage. |
execution_environment | gen2 | Élevé | Gen1 ne peut pas exécuter l'arborescence de processus de supervisord ; le déploiement du service échoue avec la configuration réseau VPC. |
min_instance_count | 1 | Élevé | La mise à l'échelle à zéro (0) entraîne des démarrages à froid de 30–60 s (supervisord doit démarrer Redis puis Gunicorn) ; la première requête expire généralement. |
cpu_limit | 4000m | Élevé | En dessous de 2000m, le rendu Chromium déclenche des délais d'expiration internes sur les pages complexes ; le débit d'exploration chute nettement. |
enable_iap / enable_cloud_armor | à activer en production | Élevé | Avec ingress_settings = "all", l'API est accessible publiquement et n'importe qui peut soumettre des jobs d'exploration consommant des ressources cloud. |
LLM_API_KEY / clés d'API des fournisseurs | via secret_environment_variables | Élevé | Des clés manquantes ou expirées font échouer sans aucun message l'extraction basée sur les LLM (extracted_content vide). Injectez-les sous forme de secrets, et non de variables d'environnement en clair. |
redis_task_ttl_seconds | 3600 | Moyen | Trop court (< 300 s), les résultats expirent avant que les clients asynchrones ne les interrogent ; trop long, la mémoire croît sans limite. Plage valide : 300–86400. |
timeout_seconds | 3600 | Moyen | Les explorations profondes ou l'extraction par LLM de pages volumineuses peuvent prendre plusieurs minutes ; ne réduisez cette valeur que pour des API de courte durée où les requêtes zombies doivent être interrompues plus rapidement. |
application_version | tag épinglé | Moyen | Utiliser "latest" n'est pas reproductible ; une reconstruction peut récupérer un changement incompatible de l'API Crawl4AI. |
enable_image_mirroring | true | Faible | Les images Crawl4AI sont volumineuses ; sans mise en miroir, chaque déploiement les extrait de Docker Hub et s'expose à des échecs dus aux limites de débit et à des démarrages à froid lents. |
Pour le comportement du socle évoqué tout au long de ce guide — identité du service, mise à l'échelle et concurrence, entrée et équilibrage de charge, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC et mise en miroir des images — consultez App_CloudRun. La configuration applicative partagée propre à Crawl4AI est décrite dans Crawl4AI_Common.
Guides associés
- Lab pratique : Crawl4AI sur Cloud Run — déployez-le pas à pas, avec les écrans de la console et les commandes à chaque étape.
- Crawl4AI sur GKE Autopilot — la même application sur Kubernetes, lorsque vous avez besoin de l'autre cible de déploiement.
- Crawl4AI Common — Configuration applicative partagée — la configuration partagée par les deux cibles de déploiement.
- Déployé aux côtés d'Elasticsearch sur GKE Autopilot, de RAGFlow sur GKE Autopilot, de Qdrant sur Google Cloud Run et de Paperless-ngx sur Google Cloud Run dans la solution Enterprise RAG & Document Intelligence.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.