Capacités de la plateforme
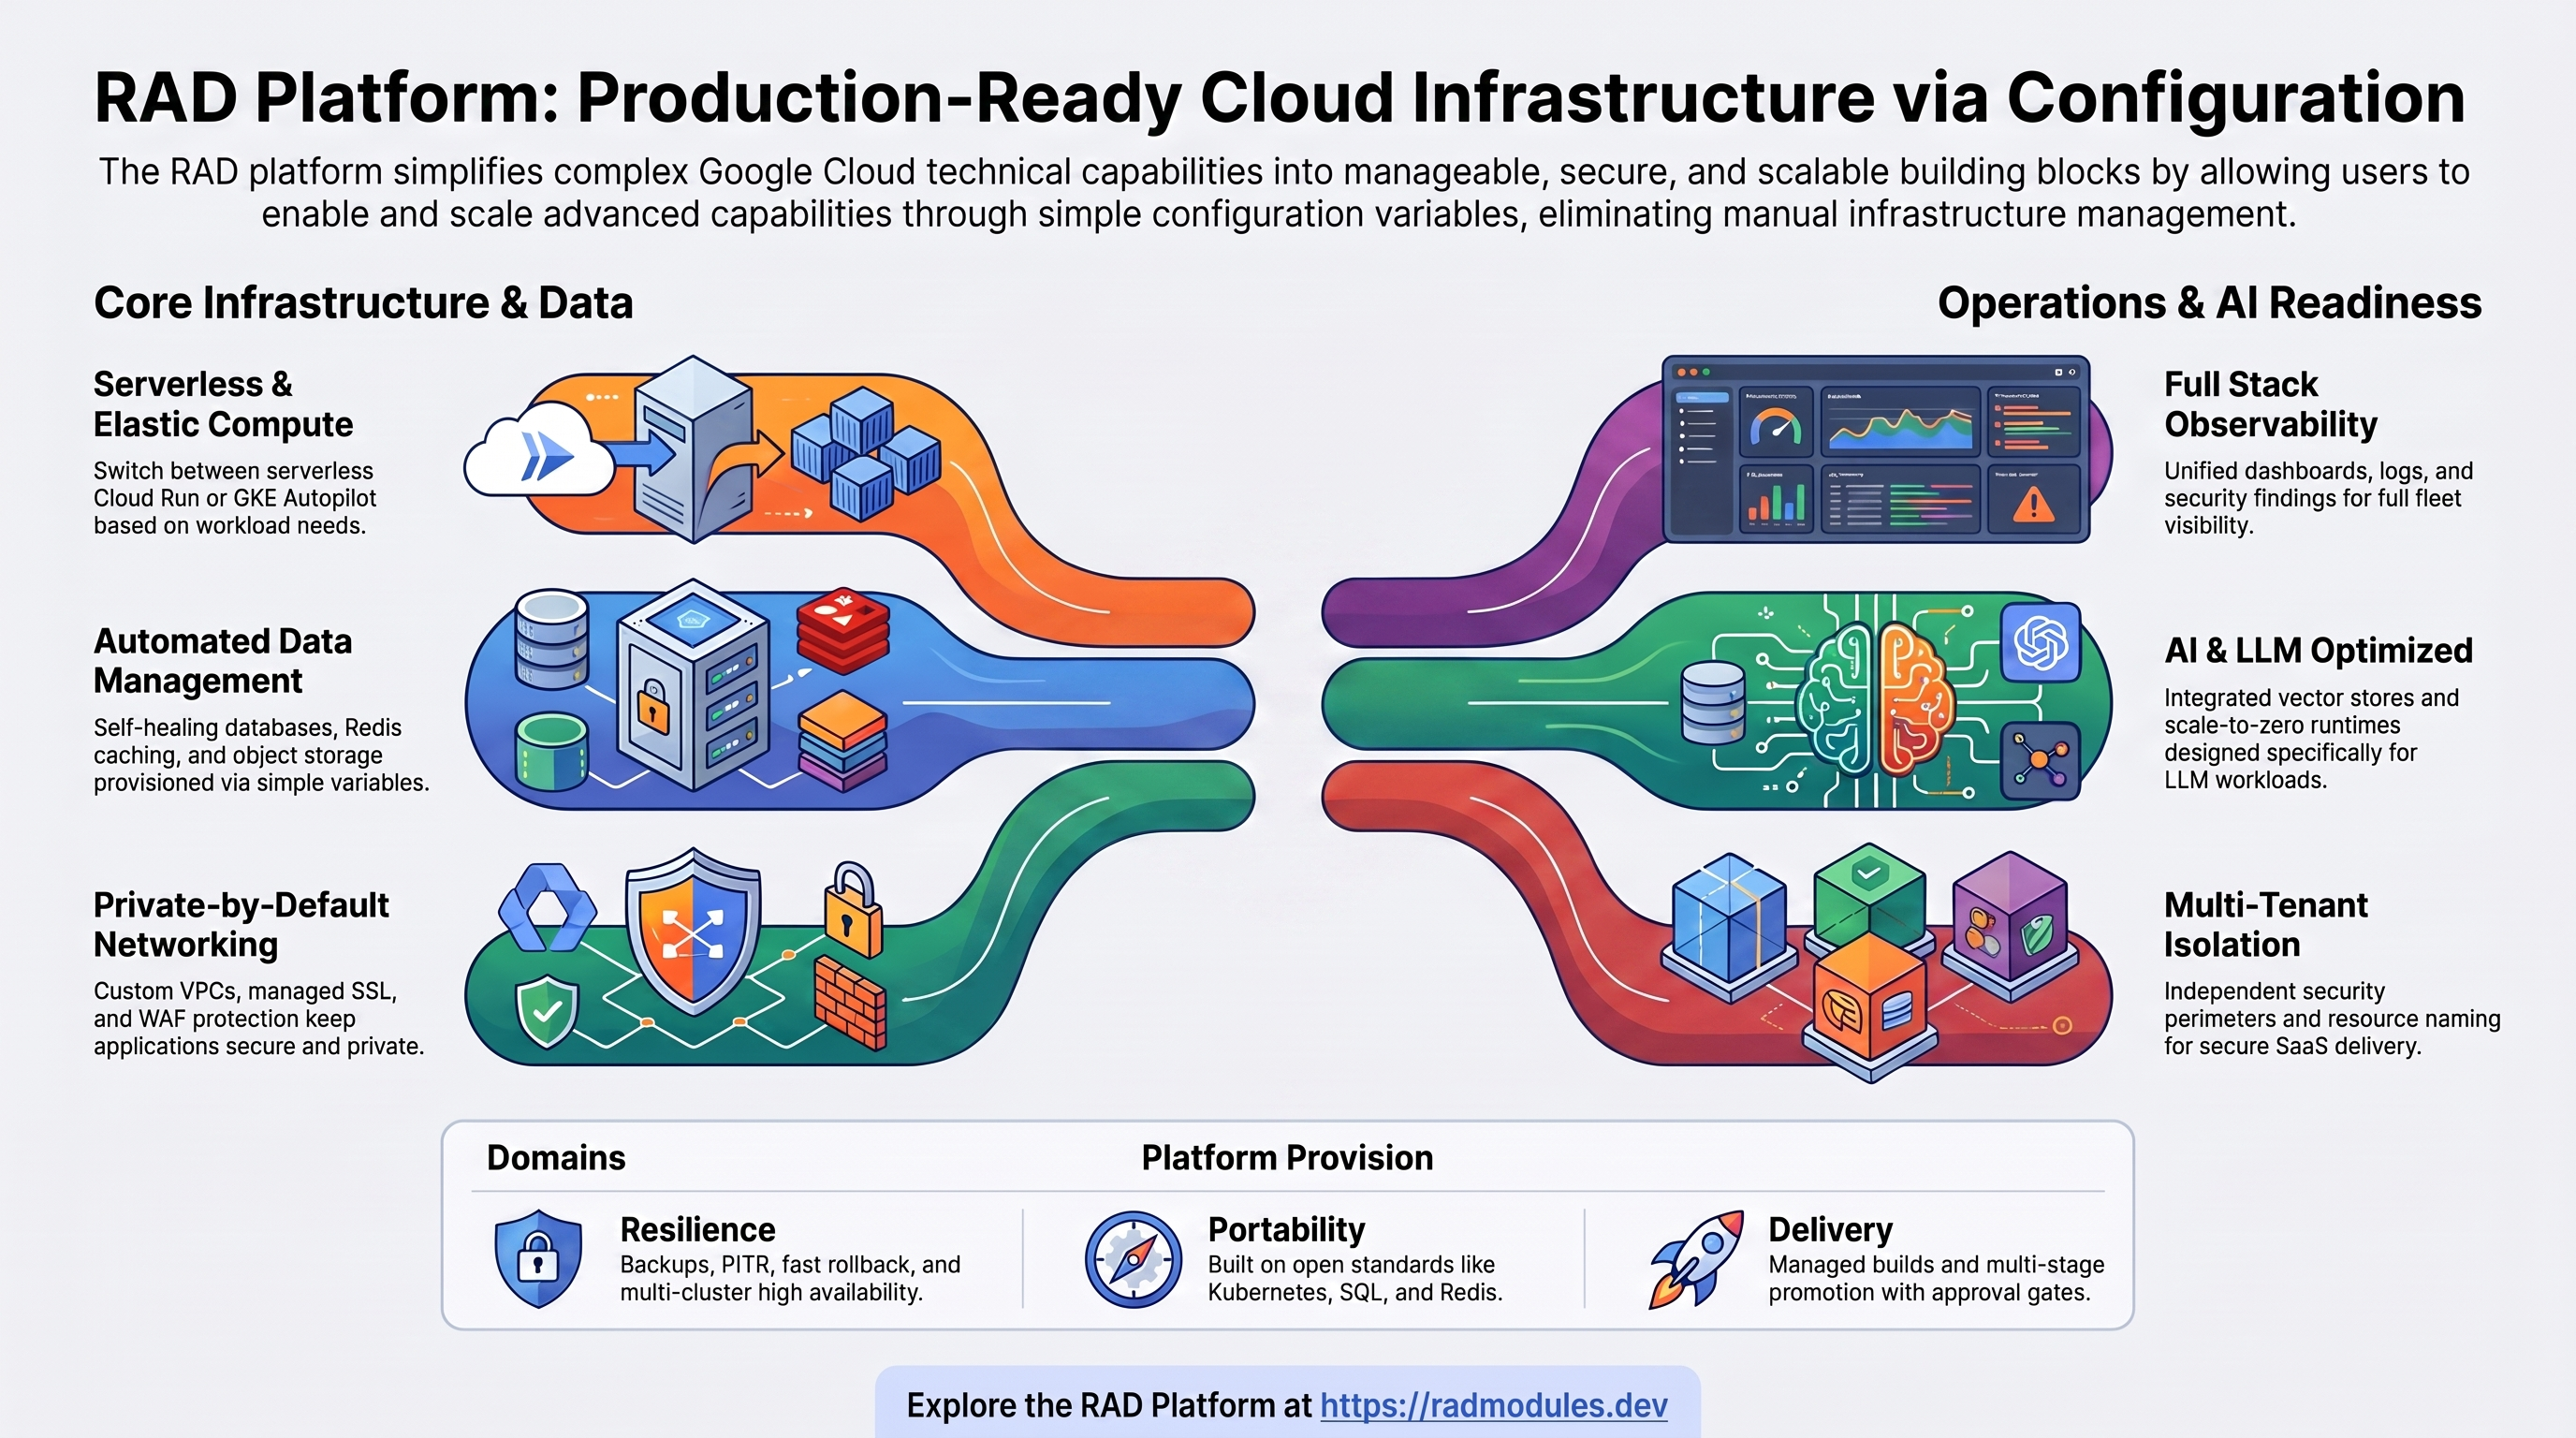
Vue d'ensemble
Ce document résume les capacités techniques que la plateforme RAD fournit pour exécuter des solutions métier sur Google Cloud — calcul élastique, données managées, réseau sécurisé, observabilité complète, résilience, multi-tenant, charges de travail d'IA et portabilité.
Chaque capacité est fournie par des services Google Cloud managés et exposée au moyen de simples variables de configuration — aucune infrastructure à concevoir, à écrire ni à maintenir. Pour la valeur métier qu'apportent ces capacités, consultez L'excellence d'ingénierie.
1. Calcul serverless et élastique
- Cloud Run (environnement d'exécution par défaut). Les applications web sans état s'exécutent en serverless et
descendent à zéro instance au repos (
min_instance_count = 0), facturées à la requête et à la seconde. La concurrence, les plafonds d'instances et les ressources sont réglables (cpu_limit,memory_limit,max_instance_count). Les services accèdent directement aux données privées via le VPC — faible latence, aucuns frais de connecteur — et peuvent être placés derrière un accès contrôlé par l'identité, sans équilibreur de charge. - GKE Autopilot (pour les charges de travail avec état et spécialisées). Les charges de travail qui ont besoin de volumes persistants, d'identités stables ou de contrôleurs personnalisés s'exécutent sur Autopilot, facturées par pod pour les ressources réellement demandées. Le Vertical Pod Autoscaling ajuste en continu les demandes de ressources ; les StatefulSets, CronJobs et Jobs sont pris en charge.
- Choix de l'environnement d'exécution par déploiement. La plupart des applications sont livrées à la fois en variante Cloud Run et en variante GKE à partir d'un socle commun (quelques-unes ne sont proposées que sur un seul environnement), de sorte que l'environnement d'exécution est généralement une décision prise au moment du déploiement — les applications sans état utilisent par défaut Cloud Run, les applications avec état Autopilot.
- Jobs ponctuels. L'initialisation de la base de données, les migrations, l'installation de plugins et
d'extensions, le SQL personnalisé (
enable_custom_sql_scripts) et la sauvegarde/restauration s'exécutent sous forme de jobs facturés uniquement pendant leur exécution, déclenchés automatiquement à chaque déploiement. - Provenance d'image flexible. Déployez une image préconstruite, construisez à partir des sources ou répliquez
une image amont dans le registre du projet (
container_image_source,enable_image_mirroring) pour garder le trafic à l'intérieur du projet et satisfaire la politique d'attestation d'images.
2. Données, bases de données et stockage
- Bases de données relationnelles managées. Cloud SQL pour MySQL 8.0 et PostgreSQL, avec
réseau privé, niveaux de machine configurables et, en option, haute disponibilité et
restauration à un instant donné. AlloyDB (compatible PostgreSQL, optimisé pour l'analytique et la
recherche vectorielle) est disponible, avec un pool de lecture facultatif pour la mise à l'échelle horizontale des lectures
(
enable_alloydb_read_pool). Les applications se connectent via un proxy sécurisé, un socket ou une IP privée (enable_cloudsql_volume), avec une authentification IAM facultative à la base de données. - Mise en cache. Cache en mémoire managé (Memorystore Redis), en niveau standard ou
haute disponibilité (
enable_redis). - Stockage partagé et stockage objet. Stockage de fichiers réseau managé pour un accès partagé à haut débit
entre les réplicas (
enable_nfs) ; buckets de stockage objet avec règles de cycle de vie et chiffrement géré par le client ; et montages de stockage objet pour les données volumineuses, principalement lues, comme les médias et les poids de modèles. - Moteurs de recherche et bases vectorielles. Elasticsearch pour la recherche plein texte et vectorielle, et
pgvectorsur Cloud SQL / AlloyDB pour la recherche par similarité (postgres_extensions). - Cycle de vie des données automatisé. La création d'une base de données par application et d'un utilisateur au moindre privilège, l'installation des plugins et extensions, ainsi que l'initialisation et la migration du schéma s'exécutent toutes automatiquement lors du déploiement — aucune configuration manuelle de base de données.
- Rotation automatisée des identifiants. Les mots de passe des bases de données peuvent faire l'objet d'une rotation planifiée
(
enable_auto_password_rotation), la plateforme s'assurant que le nouveau secret s'est propagé avant le redémarrage des instances.
3. Réseau et connectivité
- Réseau privé par défaut. Un VPC personnalisé avec des sous-réseaux régionaux, une sortie managée (Cloud NAT) et une connectivité de services privée maintiennent les bases de données et les caches hors de l'internet public.
- Entrée et domaines modernes. Domaines personnalisés avec certificats SSL managés, provisionnés
automatiquement (
application_domains) ; une adresse sans configuration est utilisée lorsqu'aucun domaine n'est déclaré. Le contenu pouvant être mis en cache peut être servi depuis la périphérie mondiale (enable_cdn). - Pare-feu applicatif web et protection DDoS. Un WAF mondial avec protection DDoS managée
(
enable_cloud_armor) applique les règles OWASP Top 10 et une limitation de débit adaptative, restreint les chemins d'administration à des réseaux connus (admin_ip_ranges) et fait passer tout le trafic par le pare-feu. - Micro-segmentation. Des règles réseau limitent le trafic de pod à pod au strict
nécessaire (
enable_network_segmentation), selon un principe de refus par défaut. - Maillage de services. Un maillage compatible Istio fournit le TLS mutuel automatique entre services, des règles de trafic (nouvelles tentatives, délais d'expiration, disjoncteurs) et une télémétrie de couche 7 — le tout sans modifier le code applicatif. Il peut fonctionner soit selon un modèle de proxy par charge de travail, soit selon un modèle à nœud partagé moins coûteux, arbitrant entre une couverture complète des fonctionnalités de couche 7 et un coût de ressources par pod réduit.
- Topologie multicluster. De deux à dix clusters dans un réseau partagé, avec un maillage multi-primaire et une découverte de services fondée sur la flotte, assurent la haute disponibilité et la mise à l'échelle interrégionale.
- Connectivité hybride. L'appairage avec un parc VMware existant et une topologie compatible VPN/Interconnect permettent un fonctionnement hybride pendant la migration.
4. Observabilité et exploitation
- Tableaux de bord par application couvrant le débit de requêtes, la latence (p50/p95/p99), le taux d'erreur, le nombre d'instances et l'utilisation CPU/mémoire.
- Alertes sur le taux d'erreur, les objectifs de latence, la saturation des ressources et les déploiements en échec, avec des canaux de notification configurables.
- Journalisation centralisée. Chaque application, job et build envoie ses journaux vers Cloud Logging.
- Journaux d'audit. Journaux d'audit Admin Activity, Data Access et System Event à l'échelle du projet, avec export à long terme facultatif.
- Constats de sécurité. Security Command Center regroupe les vulnérabilités, les erreurs de configuration et les menaces dans une vue unique.
- Le traçage distribué et la télémétrie du maillage sont produits automatiquement pour
les services inscrits au maillage — aucune instrumentation manuelle. Les traces utilisent l'en-tête standard W3C
Trace Context (
traceparent), de sorte qu'elles se raccordent entre services et entre options de maillage sans instrumentation propriétaire. - Visibilité à l'échelle de la flotte. Une vue unifiée sur l'ensemble des clusters, avec une réconciliation continue de la configuration qui fait apparaître les dérives.
5. Résilience, sauvegarde et reprise après sinistre
- Sauvegarde et restauration automatisées de l'état des bases de données et des fichiers vers le stockage objet, avec des chemins d'import pour intégrer des données provenant de l'extérieur du projet.
- Durabilité des services managés. Restauration à un instant donné et sauvegardes quotidiennes de Cloud SQL, instantanés du stockage de fichiers, gestion des versions des objets et secrets versionnés.
- Sauvegarde des charges de travail pour les applications Kubernetes.
- Protection de la disponibilité. Les budgets d'interruption de pods (
enable_pod_disruption_budget,pdb_min_available) empêchent l'arrêt simultané d'un trop grand nombre d'instances pendant la maintenance. - Retour arrière rapide. Rebasculez le trafic vers une révision précédente (Cloud Run) ou ramenez la charge de travail à une version antérieure (GKE) pour une reprise applicative en moins d'une minute.
- Reprise reproductible. Comme chaque solution est entièrement décrite par sa configuration, elle peut être reprovisionnée dans une autre région et restaurée à partir d'une sauvegarde.
- La haute disponibilité multicluster prend en charge l'actif/actif et la reprise après sinistre interrégionale.
- Isolation des défaillances entre emplacements. Pour les clusters répartis sur plusieurs emplacements ou clouds, le trafic interne au cluster et le plan de contrôle Kubernetes local continuent de fonctionner même si la connectivité avec le plan de contrôle central est perdue ; seules les fonctionnalités dépendantes du centre (contrôles d'état intercluster, accès à l'API centrale, mises à jour du maillage managé) sont dégradées jusqu'à son rétablissement.
6. Multi-tenant et activation SaaS
- Un nommage des ressources tenant compte du tenant rend chaque ressource identifiable d'elle-même dans la console, la facturation et les journaux d'audit — ce qui permet la refacturation par tenant et élimine les conflits entre tenants.
- Isolation par déploiement. Chaque déploiement de tenant est indépendant, avec son propre cycle de vie et son propre rythme de mise à niveau — aucun état partagé entre tenants.
- Des périmètres de sécurité par tenant (
enable_vpc_sc,vpc_sc_dry_run; lors d'un déploiement dans votre propre projet) maintiennent isolés les bases de données, le stockage et les secrets de chaque tenant, appuyés par des identités, des secrets et des buckets propres à chaque tenant. Les plages réseau sont calculées automatiquement pour éviter les collisions. - Cycle de vie des tenants. Provisionnez l'infrastructure avec ou sans l'application
(
deploy_application), démantelez proprement un tenant et déplacez les données d'un tenant entre déploiements, projets ou régions. - Un catalogue comme place de marché. La bibliothèque de solutions prêtes à l'emploi peut être proposée aux tenants sous forme de déploiements clés en main.
7. Charges de travail d'IA et de LLM
- Solutions d'IA prêtes à l'emploi. L'inférence de modèles auto-hébergée (Ollama), la création visuelle de workflows LLM (Flowise), la génération augmentée par récupération (RAGFlow) et l'automatisation enrichie par l'IA (N8N AI, Activepieces) se déploient avec la même expérience que n'importe quelle autre solution.
- Bases vectorielles. Elasticsearch et
pgvectorsur Cloud SQL / AlloyDB assurent la recherche par similarité pour les embeddings. - Environnement d'exécution adapté à l'IA. La mise à l'échelle jusqu'à zéro convient au trafic d'inférence irrégulier ; Autopilot convient
aux charges soutenues ; les poids des modèles sont stockés une seule fois sur un stockage partagé et montés
en lecture seule sur tous les réplicas pour éviter les retéléchargements ; les délais de déploiement et les règles de cycle de vie
du registre sont ajustés pour des images de plusieurs gigaoctets (
deployment_timeout). - Posture héritée. Les charges de travail d'IA bénéficient automatiquement des contrôles de sécurité et de coûts de la plateforme — secrets managés pour les clés d'API des fournisseurs, accès contrôlé par l'identité, périmètres de services (lors d'un déploiement dans votre propre projet), attestation d'images et économie de la mise à l'échelle jusqu'à zéro.
8. Portabilité et préparation au multicloud
- Fondée sur des standards ouverts. Conteneurs standard, API Kubernetes standard (Deployment, StatefulSet, Gateway API, network policy) et protocoles SQL et Redis standard — et non des constructions propriétaires propres à un cloud.
- Des applications open source et une source d'image paramétrée
(
container_image_source,container_image) évitent l'enfermement propriétaire. - Kubernetes comme couche de portabilité. Les variantes GKE utilisent des primitives portables qui s'exécutent sur tout cluster conforme ; le maillage multicluster et le modèle de flotte s'étendent à Kubernetes hybride et sur site.
- L'identité fédérée relie des fournisseurs d'identité externes (par ex. AWS, Azure AD, Okta) à Google Cloud.
- Clusters non-GCP rattachés. Des clusters Kubernetes existants sur d'autres clouds (comme Azure AKS et AWS EKS) peuvent être enregistrés comme membres à part entière de la flotte et gérés depuis un plan de contrôle Google Cloud unique, l'accès aux clusters passant par une passerelle de connexion managée plutôt que par l'exposition du point de terminaison public du cluster externe.
- Une présentation honnête. Aujourd'hui, la plateforme cible Google Cloud. Ici, « multicloud » signifie préparation architecturale — charges de travail portables, standards ouverts, modèle d'automatisation neutre vis-à-vis des fournisseurs et capacité à gérer des clusters non-GCP rattachés — et non une solution clés en main pour déployer de nouvelles piles applicatives sur AWS ou Azure, ce qui nécessiterait une prise en charge supplémentaire de la plateforme.
9. Livraison et promotion progressive
- Build et livraison managés, à la demande — aucun serveur de build à provisionner ni à maintenir.
- La promotion en plusieurs étapes (
enable_cloud_deploy,cloud_deploy_stages) fait passer une version par des environnements tels que développement → préproduction → production, avec une promotion automatique facultative et des points d'approbation humaine entre les étapes. - Une validation cohérente s'exécute à chaque modification, avant tout provisionnement.
Les capacités en un coup d'œil
| Domaine | Ce que fournit la plateforme |
|---|---|
| Calcul | Cloud Run serverless (mise à l'échelle jusqu'à zéro) et GKE Autopilot, choisis par déploiement |
| Données et stockage | SQL managé, AlloyDB, Redis, stockage de fichiers et objet, recherche vectorielle — configurés automatiquement |
| Réseau | VPC privé, domaines managés + SSL, CDN, WAF/DDoS, micro-segmentation, maillage de services, multicluster |
| Observabilité | Tableaux de bord, alertes, journalisation centralisée + d'audit, constats de sécurité, traçage, visibilité de la flotte |
| Résilience | Sauvegardes + PITR, sauvegarde des charges de travail, budgets d'interruption, retour arrière rapide, reprovisionnement n'importe où, HA multicluster |
| Multi-tenant | Nommage tenant compte du tenant, isolation par tenant, périmètres (dans votre propre projet), cycle de vie complet des tenants |
| IA | Solutions d'IA prêtes à l'emploi, bases vectorielles, environnement d'exécution adapté à l'IA, posture de sécurité et de coûts héritée |
| Portabilité | Standards ouverts, Kubernetes portable, clusters non-GCP rattachés, identité fédérée, préparation architecturale au multicloud |
| Livraison | Build managé, promotion en plusieurs étapes avec points d'approbation |
Votre propre projet ou un projet géré par RAD
Tout ce qui précède est disponible lorsque vous déployez dans un projet Google Cloud que vous apportez vous-même. Lorsque RAD crée le projet pour vous (un projet géré par RAD), celui-ci se trouve dans l'organisation propre de RAD ; les options qui permettraient de sortir de votre projet pour atteindre cette organisation sont donc retirées du formulaire : les périmètres VPC Service Controls, Workload Identity Federation, Security Command Center et ses notifications, ainsi que les fonctionnalités de flotte (maillage de services, Config Sync, Policy Controller, clusters multiples). AlloyDB n'y est pas non plus disponible, et les projets gérés par RAD sont limités à un ensemble de régions à faible coût. Utilisez Cloud SQL pour PostgreSQL à la place d'AlloyDB.
C'est vous qui configurez
Ces capacités sont fournies et ajustées entièrement au moyen de variables de configuration —
il n'y a aucun code d'infrastructure à écrire. Parmi les contrôles représentatifs figurent
min_instance_count / max_instance_count, cpu_limit / memory_limit,
enable_redis, enable_nfs, enable_cloudsql_volume,
enable_auto_password_rotation, enable_cdn, enable_cloud_armor,
enable_network_segmentation, enable_vpc_sc (lors d'un déploiement dans votre propre projet), enable_pod_disruption_budget,
enable_cloud_deploy et application_domains.
En résumé
La plateforme réunit toute la pile technique dont une solution de production a besoin — calcul élastique, données managées et résilientes, réseau sécurisé, observabilité approfondie, isolation multi-tenant, environnements d'exécution prêts pour l'IA et fondations portables — sous forme de services Google Cloud managés que vous activez et dimensionnez par la configuration. La capacité est là dès le premier déploiement ; c'est vous qui choisissez dans quelle mesure l'utiliser.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.