Project GCP — Garde-fous de bac à sable de niveau 0
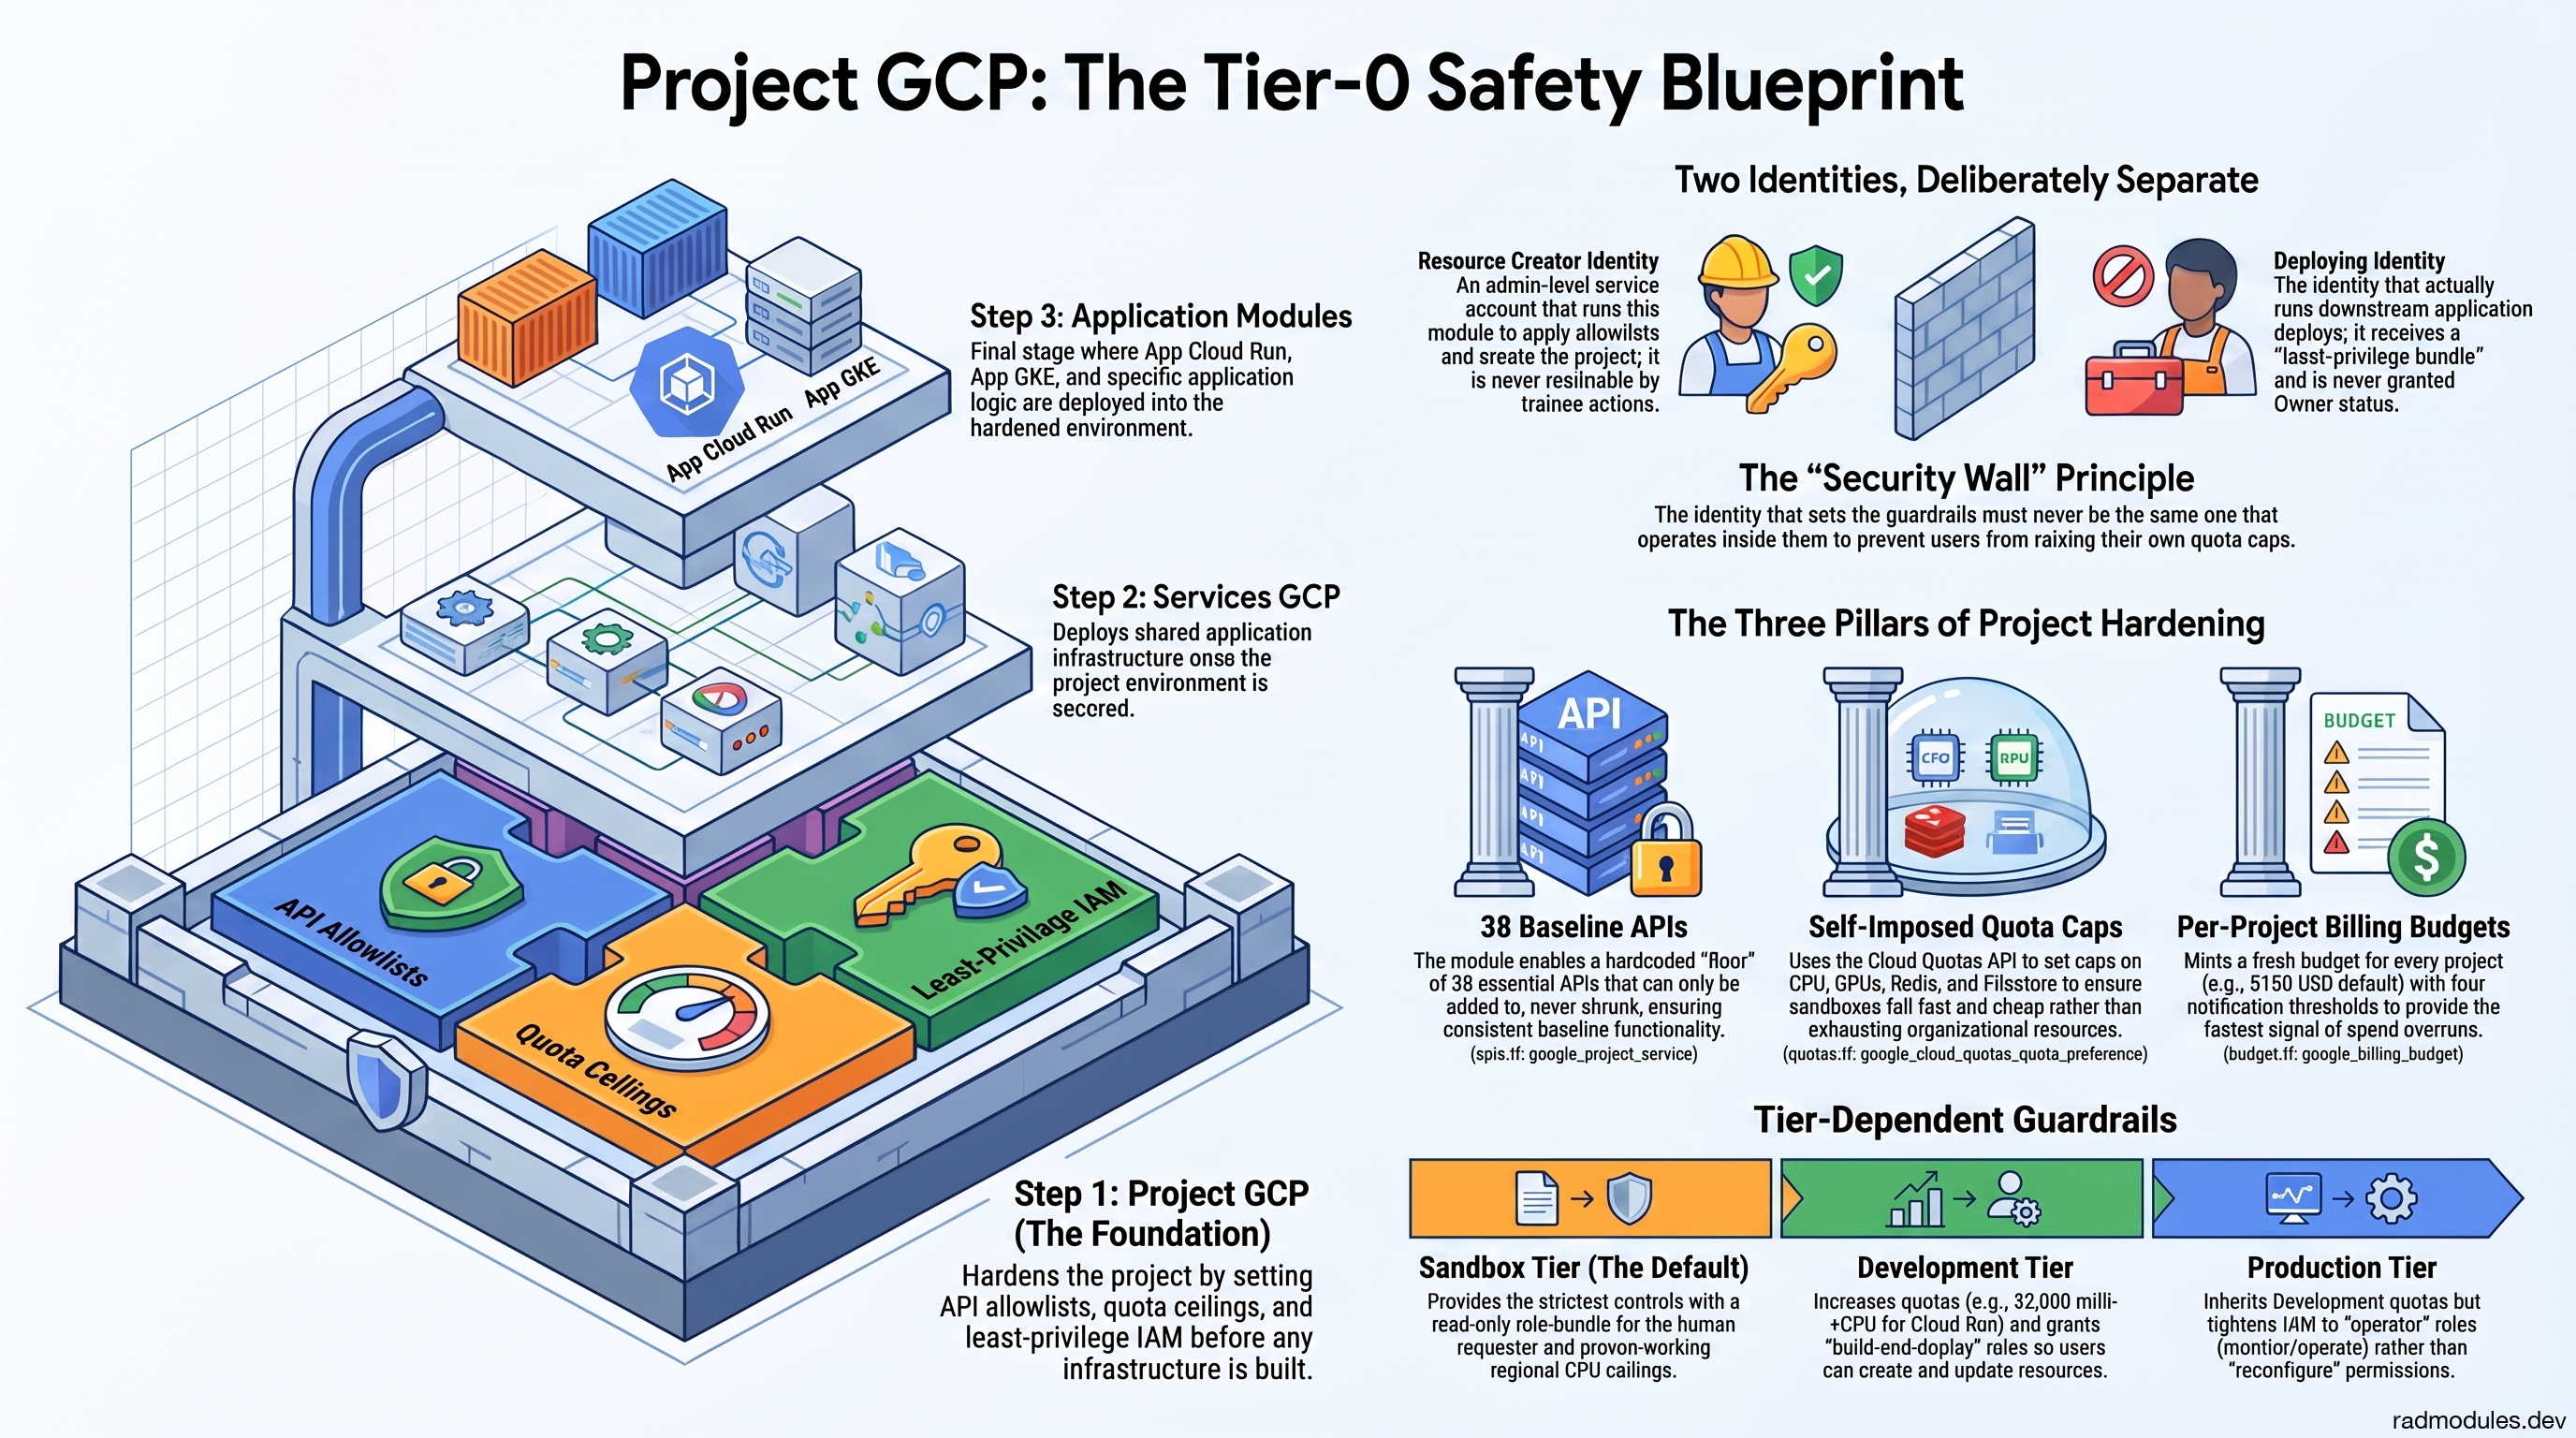
Project GCP est le module de niveau 0 de la plateforme — le seul module de ce catalogue appliqué avant Services GCP. Il ne déploie pas d'application ou d'infrastructure d'application partagée ; il renforce le projet lui-même : quelles API Google Cloud sont autorisées à être activées, un ensemble de plafonds de quota auto-imposés, et — facultativement — la création du projet de bac à sable et une identité de déploiement à moindre privilège pour opérer à l'intérieur une fois créé.
Ordre de déploiement :
Project GCP → Services GCP → App CloudRun / App GKE → Application Modules
Contrairement à tous les autres modules de ce catalogue, Project GCP n'est pas destiné à être exécuté par la même identité, pipeline ou action destinée au stagiaire qui déploie des applications — voir « Deux identités, délibérément séparées » ci-dessous.
Ce qu'il gère
| Fichier | Ressource | Gouverne |
|---|---|---|
apis.tf | google_project_service | Quelles API Google Cloud sont activées sur le projet cible |
quotas.tf | google_cloud_quotas_quota_preference | Plafonds de quota auto-imposés (CPU régional Cloud Run, CPU régional Compute Engine, GPU à l'échelle du projet, mémoire régionale Redis, trois niveaux Filestore, un plafond de scan quotidien BigQuery sur le développement/la production, et 81 quotas d'accélérateur Vertex AI) |
project.tf | google_project, google_project_iam_member, google_iam_deny_policy, google_resource_manager_lien | Création de projet facultative, IAM à moindre privilège pour une identité de déploiement distincte, une politique de refus empêchant cette identité d'augmenter ses propres plafonds de quota, et un privilège de suppression |
validation.tf | check blocks | Garde-fous de régression au moment de la planification (le plancher d'API ne peut jamais diminuer ; create_project nécessite ses variables d'identité compagnons) |
budget.tf | google_billing_budget | Un budget de facturation limité au projet créé, de sorte qu'une alerte de dépenses nomme le bac à sable d'un utilisateur |
Les garde-fous de politique d'organisation au niveau du dossier (refus d'IP externes, restrictions de clés de compte de service, la liste blanche gcp.restrictServiceUsage, etc.) ne sont pas gérés par ce module — voir « Politiques d'organisation au niveau du dossier » ci-dessous.
Pourquoi un module séparé, appliqué par une identité séparée
Tous les autres modules de ce catalogue supposent une identité de déploiement limitée au projet. Project GCP nécessite un IAM au niveau de l'organisation ou du dossier (orgpolicy.policyAdmin/iam.denyAdmin au niveau de l'organisation, autorisations de classe serviceusage.serviceUsageAdmin pour écrire des listes blanches d'API et des préférences de quota) — un niveau de confiance matériellement différent de tout ce qui est en aval. Il est conçu pour être appliqué par un administrateur de plateforme usurpant l'identité d'un compte de service dédié, uniquement pour l'usurpation d'identité (rad-guardrails-admin dans le déploiement de cette plateforme), jamais connecté à un déclencheur Cloud Build, une fonction Cloud Function ou un chemin Pub/Sub qu'une action de stagiaire pourrait atteindre. Une identité qui peut à la fois exécuter arbitrairement Terraform sur demande et réécrire les garde-fous de l'organisation annulerait la raison d'être des garde-fous.
Deux identités, délibérément séparées
| Identité | Variable | Rôle |
|---|---|---|
| Créateur de ressources | resource_creator_identity | Usurpée pour exécuter ce module. Applique la liste blanche des API et les préférences de quota ; lorsque create_project = true, crée le projet lui-même (GCP lui accorde automatiquement roles/owner sur le projet qu'il crée — il n'y a pas de moyen documenté de supprimer cela). |
| Identité de déploiement | deploying_identity_email | L'identité qui exécute réellement Services GCP / les déploiements de modules d'application à l'intérieur du nouveau projet une fois qu'il existe. Reçoit l'ensemble de rôles deploying_identity_bundle ci-dessous — jamais Propriétaire. |
| Déployé par (humain) | deployed_by_email | L'humain qui a demandé le déploiement. Reçoit un ensemble de rôles dépendant du niveau : lecture seule dans sandbox et lab ; lecture seule plus rôles d'opérateur dans production ; lecture seule plus rôles de build et de déploiement dans development. |
Cette séparation est le point clé : l'identité qui définit les garde-fous n'est jamais la même — ou accessible via le même chemin déclenché par l'utilisateur — que celle qui opère à l'intérieur de ceux-ci.
La liste blanche d'API à plancher additif
apis.tf active un plancher d'API codé en dur (local.baseline_required_apis dans main.tf) fusionné avec var.additional_apis — la variable ne peut que ajouter au plancher ; rien dans ce module ne peut le réduire. La vérification validation.tf de api_floor_never_shrinks existe uniquement comme garde-fou de régression contre une modification future introduisant accidentellement un filtre ou une soustraction.
Le plancher a été vérifié par grep par rapport à Services_GCP, App_CloudRun et App_GKE — l'ensemble réel de chaînes *.googleapis.com qu'une ressource dans ces trois modules lit — et non la liste plus grande que Services_GCP de default_apis active (qui active également plusieurs API qu'aucune ressource dans ces trois modules ne consomme, par exemple Gmail, Agenda, Docs, Drive, Vertex AI) :
billingbudgets · compute · servicenetworking · sqladmin · run · cloudbuild
artifactregistry · secretmanager · iam · iamcredentials · file · redis
cloudresourcemanager · logging · monitoring · storage · cloudscheduler
certificatemanager · iap · binaryauthorization · eventarc · container
cloudkms · containeranalysis · ondemandscanning · pubsub · accesscontextmanager
clouddeploy · securitycenter · gkebackup · firestore · dns · servicedirectory
gkehub · gkeconnect · anthosconfigmanagement · anthospolicycontroller · mesh
Cela représente 38 API (chaque entrée ci-dessus correspond à <name>.googleapis.com), vérifiées le 13/08/2026 en comptant local.baseline_required_apis dans main.tf. Ajoutez tout ce dont une intégration spécifique à une application a besoin au-delà de ce plancher — par exemple aiplatform.googleapis.com pour une application basée sur Vertex AI — via additional_apis ; il est automatiquement intégré à l'activation et à la sortie de la liste blanche.
Deux entrées ont une histoire qui mérite d'être connue. alloydb a été supprimé le 11/08/2026 lorsque AlloyDB a été retiré des listes blanches des dossiers de bac à sable/développement et ajouté à la liste de refus de production sur une décision de coût explicite — le laisser dans le plancher ferait échouer google_project_service sur tout nouveau projet. billingbudgets a été ajouté parce que l'appel budget.tf de google_billing_budget est attribué au quota de ce projet ; sans cela, l'apply échoue avec un simple Error 403: The caller does not have permission, qui est interprété comme un problème IAM et n'en est pas un (confirmé en direct le 11/08/2026 sur les déploiements 605ab251 et d5f4b359). Un supprimé, un ajouté — c'est pourquoi le compte est toujours de 38.
dns et servicedirectory sont sur le plancher car la création de clusters GKE Autopilot les appelle inconditionnellement, et non parce qu'un module les configure. Autopilot provisionne une zone gérée Cloud DNS limitée au VPC pour le DNS du cluster, et appelle Service Directory (ManagedResourceService.AddServiceBundle) pendant le démarrage du cluster. Ni l'un ni l'autre n'est facultatif et aucun ne peut être désactivé. Omettre dns bloque la création de google_container_cluster purement et simplement avec Error 403: Request is disallowed by organization's constraints/gcp.restrictServiceUsage constraint ... attempting to use service 'dns.googleapis.com' ; omettre servicedirectory laisse le cluster bloqué dans ERROR avec le message équivalent pour servicedirectory.googleapis.com. Les deux ont été confirmés en direct en déployant un module GKE dans un projet géré par RAD.
Ceci active l'API sur le projet. Cela ne décide pas en soi si l'API est autorisée — voir la section suivante.
Politiques d'organisation au niveau du dossier (non gérées ici)
Les garde-fous de politique d'organisation au niveau du dossier — refus compute.vmExternalIpAccess, création/téléchargement de clés de compte de service désactivés, restriction d'IP publique Cloud SQL, et (la restriction complémentaire à la liste blanche d'API de ce module) gcp.restrictServiceUsage, qui contrôle quelles API sont autorisées à être activées n'importe où dans le dossier — ont été initialement implémentés dans ce module puis supprimés.
Pourquoi supprimé : GCP n'autorise qu'un seul objet de politique par paire (folder, constraint). Chaque projet de bac à sable partageant un dossier avait son propre état Terraform croyant qu'il possédait exactement la même ressource au niveau du dossier — confirmé en direct pour causer une dérive réelle (l'application d'un projet écrasant silencieusement la politique de dossier d'un autre), et, pire, signifiait que la suppression de l'état d'un seul projet de bac à sable supprimerait la politique partagée pour tous les autres projets de ce dossier.
Les garde-fous au niveau du dossier résident désormais dans rad-automation/scripts/02-setup-ui.sh (étape 10, « Activer la configuration et les déploiements au niveau de l'organisation »), appliqués une fois par dossier au moment de la configuration via des appels gcloud org-policies set-policy bruts — découplés du cycle de vie Terraform de tout projet de bac à sable individuel. Chaque nouveau projet de bac à sable créé sous ce dossier hérite automatiquement des politiques via la hiérarchie des politiques de GCP ; vous n'avez pas besoin (et ne pouvez pas, à partir de ce module) de les réappliquer par projet.
Une API activée par ce module (apis.tf) mais non présente dans la liste blanche gcp.restrictServiceUsage du dossier échouerait à s'activer — maintenez la liste blanche codée en dur de 02-setup-ui.sh synchronisée avec baseline_required_apis à la main si la base de référence change un jour ; il n'y a plus de lien automatique calculé entre les deux.
compute.requireOsLogin est délibérément absent des valeurs par défaut du dossier jusqu'à ce que la VM NFS/Redis de Services_GCP soit mise à jour pour prendre en charge OS Login (elle utilise actuellement IAP-SSH + métadonnées de clé au lieu d'OS Login).
Dépassements de quota
quotas.tf utilise la Cloud Quotas API moderne (google_cloud_quotas_quota_preference) — l'ancienne ressource de dépassement de quota de consommateur Service Usage n'existe plus dans le fournisseur hashicorp/google actuel (tofu validate la rejette purement et simplement). Un quota est identifié par un quota_id lisible par l'homme par service (par exemple "CpuAllocPerProjectRegion"), et non par un triple métrique/unité/limite.
Chaque niveau reçoit un ensemble de plafonds auto-imposés, chacun dimensionné à partir du plafond éprouvé de ce catalogue plutôt que d'une estimation. sandbox et lab utilisent la carte de base (local.default_quota_overrides) ; development et production partagent une carte augmentée (local.production_quota_overrides = local.development_quota_overrides).
| Clé | Service | quota_id | bac à sable / lab | développement / production | Portée |
|---|---|---|---|---|---|
cloud_run_cpu_allocation | run.googleapis.com | CpuAllocPerProjectRegion | 16000 milli-vCPU (16 vCPU) | 32000 | toutes les régions |
compute_cpus_per_region + compute_cpus_<region> | compute.googleapis.com | CPUS-per-project-region | 24 vCPU | 48 | chacune des huit régions autorisées |
compute_gpus_all_regions | compute.googleapis.com | GPUS-ALL-REGIONS-per-project | 0 | 0 | à l'échelle du projet |
redis_total_memory_per_region | redis.googleapis.com | TotalCapacityPerProjectPerRegion | 16 Go | 32 | toutes les régions |
filestore_standard_per_region | file.googleapis.com | StandardStorageGbPerRegion | 1024 Go | 1024 | toutes les régions |
filestore_premium_per_region | file.googleapis.com | PremiumStorageGbPerRegion | 2560 Go | 2560 | toutes les régions |
filestore_high_scale_ssd_per_region | file.googleapis.com | HighScaleSSDStorageGibPerRegion | 0 | 0 | toutes les régions |
bigquery_query_bytes_per_day | bigquery.googleapis.com | QueryUsagePerDay | 32768 Mio (32 Gio/jour) | 1048576 (1 Tio/jour) | global |
compute_disks_total_per_region / compute_disks_total_<region> | compute.googleapis.com | DISKS-TOTAL-GB-per-project-region | 4096 Go, toutes les régions | 8192 Go, par région autorisée | voir colonne |
compute_hyperdisk_balanced_<region> | compute.googleapis.com | HDB-TOTAL-GB-per-project-region | 4096 Go | 8192 | par région autorisée |
compute_ssd_total_<region> | compute.googleapis.com | SSD-TOTAL-GB-per-project-region | 1024 Go | 2048 | par région autorisée |
| Hyperdisk Extreme / ML / Confidentiel / Débit, SSD local | compute.googleapis.com | HDX-…, HDML-…, HDB-CONFIDENTIAL-…, HDT-…, LOCAL-SSD-TOTAL-GB-per-project-region | 0 | 0 | toutes les régions |
En plus de cette carte, chaque niveau fixe trois familles d'accélérateurs et de jetons à 0, car aucune d'entre elles n'est atteinte par le plafond GPU de Compute Engine : 81 quotas d'accélérateur Vertex AI (local.vertex_accelerator_overrides), les quotas de jetons génératifs BigQuery ML (GenAiInputTokensPerDay, GenAiOutputTokensPerDay), et les GPU Cloud Run (quatre ID de quota Nvidia…GpuAlloc…).
Points à connaître avant de modifier l'un d'entre eux :
- L'unité de
cloud_run_cpu_allocationest le milli-vCPU, pas le vCPU. Un16littéral est 0,016 vCPU et fait échouer chaque déploiement Cloud Run réel avecQuota violated: CpuAllocPerProjectRegion requested: 3000 allowed: 16.compute.googleapis.com/cpusest exprimé en vCPU entiers. - Certains quotas ne peuvent pas être définis sans région. L'API Cloud Quotas rejette une carte
dimensionsvide surCPUS-per-project-region,SSD-TOTAL-GB-per-project-regionetHDB-TOTAL-GB-per-project-region(et surDISKS-TOTAL-GBà la valeur de développement), de sorte que ces plafonds sont écrits une fois par région autorisée — les huit régions que la politiquegcp.resourceLocationsdes dossiers de niveau autorise. Les autres utilisentdimensions = {}, qui les applique dans toutes les régions. - Hyperdisk Balanced est maintenu égal au plafond de disque persistant, et non mis à zéro, car GKE Autopilot peut sauvegarder un PVC
standard-rwoordinaire avec l'une ou l'autre famille. dimensionsest souslifecycle { ignore_changes }. L'emplacement d'une préférence de quota est fixe lors de sa création et l'API Cloud Quotas ne peut pas en déplacer une, de sorte qu'un projet créé sous une forme plus ancienne planifierait autrement une différence qui ne peut jamais s'appliquer.
Remplacez la valeur d'une valeur par défaut existante avec quota_value_overrides (indexée par le même nom court, par exemple { cloud_run_cpu_allocation = 32000 } — notez milli-vCPU, selon l'avertissement d'unité ci-dessus ; 32 ici serait 0,032 vCPU), ou ajoutez un nouveau plafond de quota entièrement avec additional_quota_overrides. Avant d'ajouter une nouvelle entrée :
- Recherchez le vrai
quota_idpour le service/projet cible — la source de donnéesgoogle_cloud_quotas_quota_infos, ougcloud beta quotas info list --service=<api> --project=<id>. Ne tapez pas manuellement un nom de métrique Service Usage de mémoire ou ne reportez pas un ancien nom. - Confirmez si la valeur cible nécessite
ignore_safety_checks(un plafond inférieur à la valeur par défaut/utilisation actuelle peut l'exiger — voir la documentation de la ressource pour les valeurs d'énumération valides). - Dimensionnez la valeur délibérément en dessous du plafond d'organisation partagé — de nombreux projets de bac à sable concurrents partagent probablement un pool de quotas au niveau de l'organisation, de sorte qu'un plafond auto-imposé échoue rapidement et à moindre coût dans un bac à sable au lieu d'affamer les autres.
Création de projet facultative
Conditionné par create_project, qui par défaut est true — le module crée le projet par défaut. Définissez-le sur false pour apporter un projet préexistant à la place. Lorsqu'il est activé :
google_project.tier_projectcrée le projet sousfolder_id, lié àbilling_account_id.
(L'ancienne adresse google_project.sandbox ne survit que comme le côté from = du bloc moved dans modules/Project_GCP/moved.tf:21 ; aucune ressource de ce nom n'existe.) deletion_policy = "DELETE" afin qu'un tofu destroy réellement prévu puisse se terminer — le fournisseur par défaut est PREVENT et bloque la destruction purement et simplement même après que le privilège (ci-dessous) a déjà été supprimé.
-
deploying_identity_bundleaccorde àdeploying_identity_emailun ensemble de rôles à moindre privilège —roles/editor,roles/resourcemanager.projectIamAdmin,roles/iam.serviceAccountAdmin,roles/servicenetworking.networksAdmin,roles/pubsub.admin,roles/run.admin,roles/secretmanager.admin— assemblé à partir de cinq lacunes confirmées indépendamment dansroles/editorseul (setIamPolicy/getIamPolicyest structurellement exclu d'Éditeur sur presque tous les types de ressources qu'il gère par ailleurs entièrement : IAM de projet, appairage Private Service Access, IAM de sujet Pub/Sub, IAM de service Cloud Run, et IAM de Secret Manager par secret — le dernier confirmé en direct le 18/08/2026 (#2761) et le plus large des cinq, puisque la liaisonApp_Commondeapp_iamse déclenche pour chaque application avec une base de données, Cloud Run et GKE confondus). Pas encore validé par rapport au catalogue complet de ~150 modules d'application — traitez-le comme un candidat en attendant une véritable campagne de type/deploy-group-test, et non comme un ensemble garanti suffisant. -
end_user_access_bundleaccorde àdeployed_by_emailun ensemble de rôles dépendant du niveau (local.end_user_roles,project.tf). Les trois niveaux obtiennent la base en lecture seule (roles/browserpluslogging/monitoring/run/container/cloudsql/compute.viewer etstorage.objectViewer).developmentobtient en outre un ensemble de build et de déploiement (run.developer,container.developer,cloudsql.client,storage.objectAdmin,secretmanager.secretAccessor,secretmanager.secretVersionAdder,artifactregistry.writer,monitoring.editor,errorreporting.user,cloudtrace.user), de sorte qu'un utilisateur final de développement peut réellement créer et mettre à jour des ressources ; il obtient également un compte de servicerad-app-runtimesans autorisation (google_service_account.app_runtime, créé uniquement à ce niveau) sur lequel l'utilisateur détientroles/iam.serviceAccountUser.productionest délibérément plus strict que le développement — il n'ajoute quemonitoring.editor,errorreporting.vieweretcloudtrace.user(opérer, pas reconfigurer). Aucun niveau ne reçoit jamaisroles/owner,roles/cloudquotas.admin,roles/orgpolicy.policyAdmin, ouroles/iam.serviceAccountUserlimité au projet. -
google_iam_deny_policy.deny_deploying_identity_quota_writeempêchedeploying_identity_emaild'augmenter ses propres plafonds de quota. L'écriture de quota ne peut pas être supprimée en choisissant un rôle prédéfini plus étroit, donc une politique de refus est le mécanisme utilisé ici. Refuse à la fois les autorisations d'écriture modernes (cloudquotas.googleapis.com/quotas.update) et héritées (serviceusage.googleapis.com/quotas.update) pour une défense en profondeur. -
google_resource_manager_lien.prevent_deletionest un blocage réel et structurel surresourcemanager.projects.delete, indépendant des rôles IAM que l'identité de déploiement détient.
La vérification validation.tf de create_project_requires_billing_and_deploying_identity rejette create_project = true au moment de la planification, sauf si billing_account_id, deploying_identity_email et deployed_by_email sont tous définis — de sorte qu'une tentative mal configurée échoue rapidement plutôt que de créer partiellement un projet sans identité de déploiement capable de l'opérer.
Cycle de vie du projet de bac à sable : création fraîche uniquement, jamais de recyclage. Cette plateforme n'est pas uniquement destinée à la formation — certains utilisateurs déploient des travaux réels et non reproductibles dans ces projets de bac à sable, de sorte qu'un projet peut contenir des données utilisateur réelles. Ne détruisez pas et ne réutilisez pas un ID de projet pour un nouvel utilisateur. La suppression logicielle de GCP (fenêtre de 30 jours) est conservée comme filet de sécurité, mais n'est pas un mécanisme de recyclage rapide — un projet restauré est inutilisable pendant 36 heures/3 jours, il ne peut donc pas prendre en charge un flux « renvoyer ce projet à un pool pour le prochain utilisateur ». Une restauration n'est pas non plus un plan de reprise : les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ni les ressources qu'il contient, sera utilisable ; quiconque supprime un projet doit donc d'abord effectuer des sauvegardes appropriées de ses données et de sa configuration — la solution de repli après une restauration échouée consiste à redéployer l'application et à restaurer sa configuration à partir de ces sauvegardes. Une suppression réelle signifie un
projects.deletedélibéré, et non un cycle detofu destroyet de reprovisionnement de routine.
Budget de facturation par projet
budget.tf crée un google_billing_budget limité au projet créé par ce module, de sorte qu'une alerte de dépenses nomme le bac à sable d'un utilisateur. Il n'est créé que lorsque les trois create_project = true, enable_project_budget = true et un billing_account_id non vide sont valides.
Ce n'est pas un plafond de dépenses. Un budget GCP ne fait que notifier — il ne bloque jamais un appel d'API ni ne détache la facturation. L'application reste avec le credit_billing_guard de la plateforme (sondage de 15 minutes, désactive la facturation en cas d'arriérés) et credit_project (mesure horaire par rapport à l'exportation de facturation BigQuery). Ce que le budget ajoute, c'est la vitesse : les deux héritent de la latence de plusieurs heures de l'exportation de facturation, tandis que les seuils budgétaires se déclenchent à partir du suivi des dépenses quasi en temps réel de Google, ce qui en fait le signal le plus rapide disponible qu'un bac à sable spécifique s'emballe.
Il existe par projet car le budget côté plateforme est limité à l'ensemble du compte de facturation et ne peut pas être réduit à ce niveau — ce module crée un nouvel ID de projet par utilisateur au moment du déploiement, de sorte qu'aucune liste de projets statique n'existe côté plateforme au moment tofu apply. À l'intérieur du module qui crée le projet, l'ID est connu.
Quatre règles de seuil se déclenchent : à 50 %, 90 % et 100 % des dépenses réelles, plus une fois lorsque Google prévoit que le mois se terminera au-dessus du budget (généralement des jours avant la règle de dépenses réelles). Les crédits et promotions sont exclus (EXCLUDE_ALL_CREDITS) afin que le seuil suive les dépenses réelles facturables. Les notifications sont envoyées aux administrateurs et aux utilisateurs du compte de facturation, délibérément pas à l'utilisateur final — ils détiennent un IAM en lecture seule sur leur bac à sable et ne peuvent rien faire en cas de dépassement, et les dépenses sont imputées au compte de la plateforme plutôt qu'au leur.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_project_budget | true | Crée le budget par projet. N'a aucun effet sauf si create_project = true et billing_account_id sont définis. |
project_budget_amount | 150 | Budget mensuel en unités monétaires entières, dimensionné par rapport à une pile mono-utilisateur typique. |
project_budget_currency | "USD" | Doit correspondre à la devise du compte de facturation, sinon le budget est rejeté. |
project_budget_pubsub_topic | "" | Sujet Pub/Sub facultatif pour les notifications programmatiques, comme projects/<project>/topics/<topic>. Vide signifie des alertes par e-mail uniquement aux administrateurs du compte de facturation. Connecter cela à un répondeur automatisé est le chemin de réaction le plus rapide possible. |
Variables de configuration
Le groupe 0 (métadonnées du module — module_description, module_dependency, credit_cost, public_access, shared_users, etc.) reflète le bloc de métadonnées obligatoire de tous les autres modules et n'est pas reproduit ici ; voir la convention « Les variables de métadonnées du groupe 0 sont obligatoires » de CLAUDE.md. Trois des paramètres de configuration significatifs se trouvent dans le groupe 0 plutôt que dans un groupe dédié, car ils sont plus proches des paramètres d'administration/d'API que de la configuration de projet par déploiement :
| Variable | Valeur par défaut | Description |
|---|---|---|
tier | sandbox | L'entrée la plus importante de ce module. L'une des valeurs sandbox, development, production, lab (validée au moment de la planification ; lab n'est créée que par une session de lab et n'est jamais proposée sur un formulaire de déploiement). Elle sélectionne la carte de quotas appliquée par quotas.tf, l'ensemble IAM utilisateur final accordé à deployed_by_email (local.end_user_roles dans project.tf), et le dossier dans lequel le projet est créé. development augmente Cloud Run à 32000 milli-vCPU, Compute à 48 vCPU et Redis à 32 Go, ajoute un plafond de scan BigQuery de 1 Tio/jour, et accorde un ensemble de rôles de build et de déploiement plus un compte de service rad-app-runtime sans autorisation. production hérite de la carte de quotas de développement en gros mais est délibérément plus strict sur l'IAM — opérer, pas reconfigurer. Le niveau ne change pas le coût d'un déploiement : il définit le dossier (et ses politiques d'organisation), l'alerte de budget du projet et le plancher d'admission des crédits achetés. |
additional_apis | [] | API Google Cloud supplémentaires à activer au-delà de la base intégrée. Également ajoutées automatiquement à la liste blanche des API. |
resource_creator_identity | "" | Compte de service à usurper pour tous les appels d'API effectués par ce module. Laissez vide pour utiliser les propres identifiants de l'appelant. L'appelant doit déjà détenir roles/iam.serviceAccountTokenCreator sur cette identité. |
enable_services | true | Présent pour la cohérence de l'interface utilisateur inter-modules avec le même commutateur de Services_GCP. Délibérément non connecté à quoi que ce soit — la liste blanche d'API de ce module (apis.tf) est toujours appliquée quelle que soit cette valeur ; il n'y a aucun moyen pris en charge de la contourner. |
Configuration du projet
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Lorsque create_project = true, l'ID du nouveau projet à créer (6 à 30 caractères, lettres minuscules/chiffres/tirets, commençant par une lettre) ; sinon un ID de projet existant. |
create_project | true | Crée project_id comme nouveau projet GCP. Lorsque false, l'appelant apporte un projet préexistant et lui accorde l'accès à deploying_identity_email lui-même — ce module ne touche jamais à ce chemin. |
billing_account_id | "" | Compte de facturation auquel lier le nouveau projet. Obligatoire lorsque create_project = true (appliqué au moment de la planification). |
deploying_identity_email | "" | Compte de service qui déploiera des modules dans le nouveau projet une fois créé. Obligatoire lorsque create_project = true. Reçoit l'ensemble à moindre privilège décrit ci-dessus, jamais Propriétaire. |
deployed_by_email | "" | E-mail de l'humain qui a demandé le déploiement. Obligatoire lorsque create_project = true. Doit être une véritable identité Google (compte Workspace/Gmail) — une attribution IAM à un e-mail sans identité Google correspondante est acceptée par l'API mais n'accorde aucun accès réel tant qu'une n'existe pas. |
folder_id | "" — pas de valeur par défaut | ID numérique du dossier GCP qui contient les projets de ce niveau — rad-sandbox, rad-development, rad-production ou rad-lab, sélectionné par var.tier et injecté par la plateforme — utilisé uniquement pour placer un projet créé (google_project.tier_project). Il était auparavant par défaut l'ID de dossier rad-sandbox de RAD ; cette valeur par défaut a été supprimée (#2774) car cette valeur décide où le projet est créé, et une valeur par défaut est une mauvaise réponse qui attend d'être utilisée. Marqué {{UIMeta group=0}}, de sorte que la plateforme l'injecte plutôt que l'opérateur ne le tape ; les quatre dossiers de niveau portent délibérément des ensembles de politiques d'organisation différents. |
region | "us-central1" | Limite le seul plafond de quota qui ne peut pas être appliqué à l'échelle du projet : compute_cpus_per_region (CPUS-per-project-region) nécessite sa dimension régionale, donc quotas.tf le définit avec { region = var.region } tandis que tous les autres plafonds utilisent dimensions = {} (toutes les régions). Non destiné à l'utilisateur (pas de balise UIMeta) — une décision de plateforme/administrateur sur l'emplacement du calcul du bac à sable, correspondant à la valeur par défaut region de tous les autres modules. |
(L'affirmation « aucune ressource ne lit cette valeur » est maintenant fausse : google_cloud_quotas_quota_preference.guardrails la lit via local.default_quota_overrides.compute_cpus_per_region.dimensions.)
| quota_value_overrides | {} | Remplace la valeur numérique d'un dépassement de quota par défaut, indexé par le même nom (par exemple { cloud_run_cpu_allocation = 32 }). |
| additional_quota_overrides | {} | Ajoute des dépassements de quota au-delà des sept valeurs par défaut, indexés par un nom court. Voir « Dépassements de quota » ci-dessus avant d'ajouter une entrée. |
Sorties
| Sortie | Description |
|---|---|
enabled_apis | L'ensemble complet des API activées (et listées) sur project_id par cette invocation. |
quota_overrides_applied | Dépassements de quota appliqués à project_id, indexés par les mêmes noms courts que default_quota_overrides / additional_quota_overrides. |
created_project_id | L'ID du projet créé par cette invocation, ou null si create_project était false (projet supposé préexistant). |
deploying_identity_bundle_roles | Les rôles exacts accordés à deploying_identity_email lorsque create_project = true — l'ensemble candidat à moindre privilège, en attente de validation complète du catalogue. |
Pièges de configuration et valeurs par défaut judicieuses
Niveaux de risque : Critique (perte de données, panne complète, violation de sécurité) — Élevé (service indisponible ou dégradation significative) — Moyen (fonction dégradée ou coût accru) — Faible (impact mineur).
| Variable | Valeur par défaut judicieuse | Risque | Conséquence d'une valeur incorrecte |
|---|---|---|---|
create_project + billing_account_id/deploying_identity_email/deployed_by_email | Définissez les trois ensemble, ou laissez create_project = false | Élevé 🛡 au moment de la planification | create_project = true avec l'une des trois variables complémentaires vide est rejeté au moment de la planification (create_project_requires_billing_and_deploying_identity) plutôt que de créer partiellement un projet sans identité de déploiement capable de l'opérer. |
folder_id | Le dossier de niveau que la plateforme injecte — il n'y a pas de valeur par défaut de repli | Critique | Un projet placé dans un dossier qui n'a pas eu l'étape 10 de 02-setup-ui.sh exécutée hérite de aucun garde-fou de politique d'organisation au niveau du dossier (refus d'IP externes, restrictions de clés de compte de service, liste blanche d'API) — le projet est créé mais effectivement non protégé au niveau de la politique d'organisation, et ce module ne peut pas détecter ou avertir à ce sujet à partir de l'état d'un seul projet. |
additional_apis | N'ajoutez que ce qu'une intégration spécifique nécessite | Moyen | Chaque API que ce module active est également implicitement considérée comme déjà présente dans la liste blanche gcp.restrictServiceUsage du dossier — une API ajoutée ici mais manquante dans cette liste blanche échoue à s'activer purement et simplement ; une API ajoutée aux deux devient une partie permanente de la surface d'attaque du projet. |
quota_value_overrides / additional_quota_overrides | Maintenez les nouveaux plafonds en dessous du plafond d'organisation partagé | Moyen | Un plafond défini à ou au-dessus du pool partagé de l'organisation ne fournit aucun véritable garde-fou — l'intérêt d'un plafond auto-imposé est d'échouer rapidement et à moindre coût dans ce bac à sable avant d'affamer tous les autres projets de bac à sable concurrents partageant le même pool de quotas au niveau de l'organisation. |
deploying_identity_bundle (ensemble de rôles fixe, pas une variable en soi) | — | Faible | Pas encore validé par rapport au catalogue complet de ~150 modules d'application — un déploiement qui nécessite une autorisation en dehors des sept rôles de l'ensemble échoue avec une erreur IAM PERMISSION_DENIED claire, et non silencieusement. Traitez-le comme un candidat en attendant une véritable campagne /deploy-group-test, et non comme un ensemble garanti suffisant. |
Détruire et réutiliser un project_id pour un nouvel utilisateur | Jamais — création fraîche uniquement | Critique | Cette plateforme n'est pas uniquement destinée à la formation ; un projet peut contenir des données utilisateur réelles et non reproductibles. La suppression logicielle de GCP est un filet de sécurité de 30 jours, pas un mécanisme de recyclage rapide (la restauration prend jusqu'à 36 heures/3 jours, et Google ne garantit pas qu'un projet restauré soit utilisable) — elle ne peut pas prendre en charge un flux « renvoyer ce projet à un pool ». |
Guides associés
- Lab pratique : Project GCP — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.