RAGFlow sur Google Cloud Run
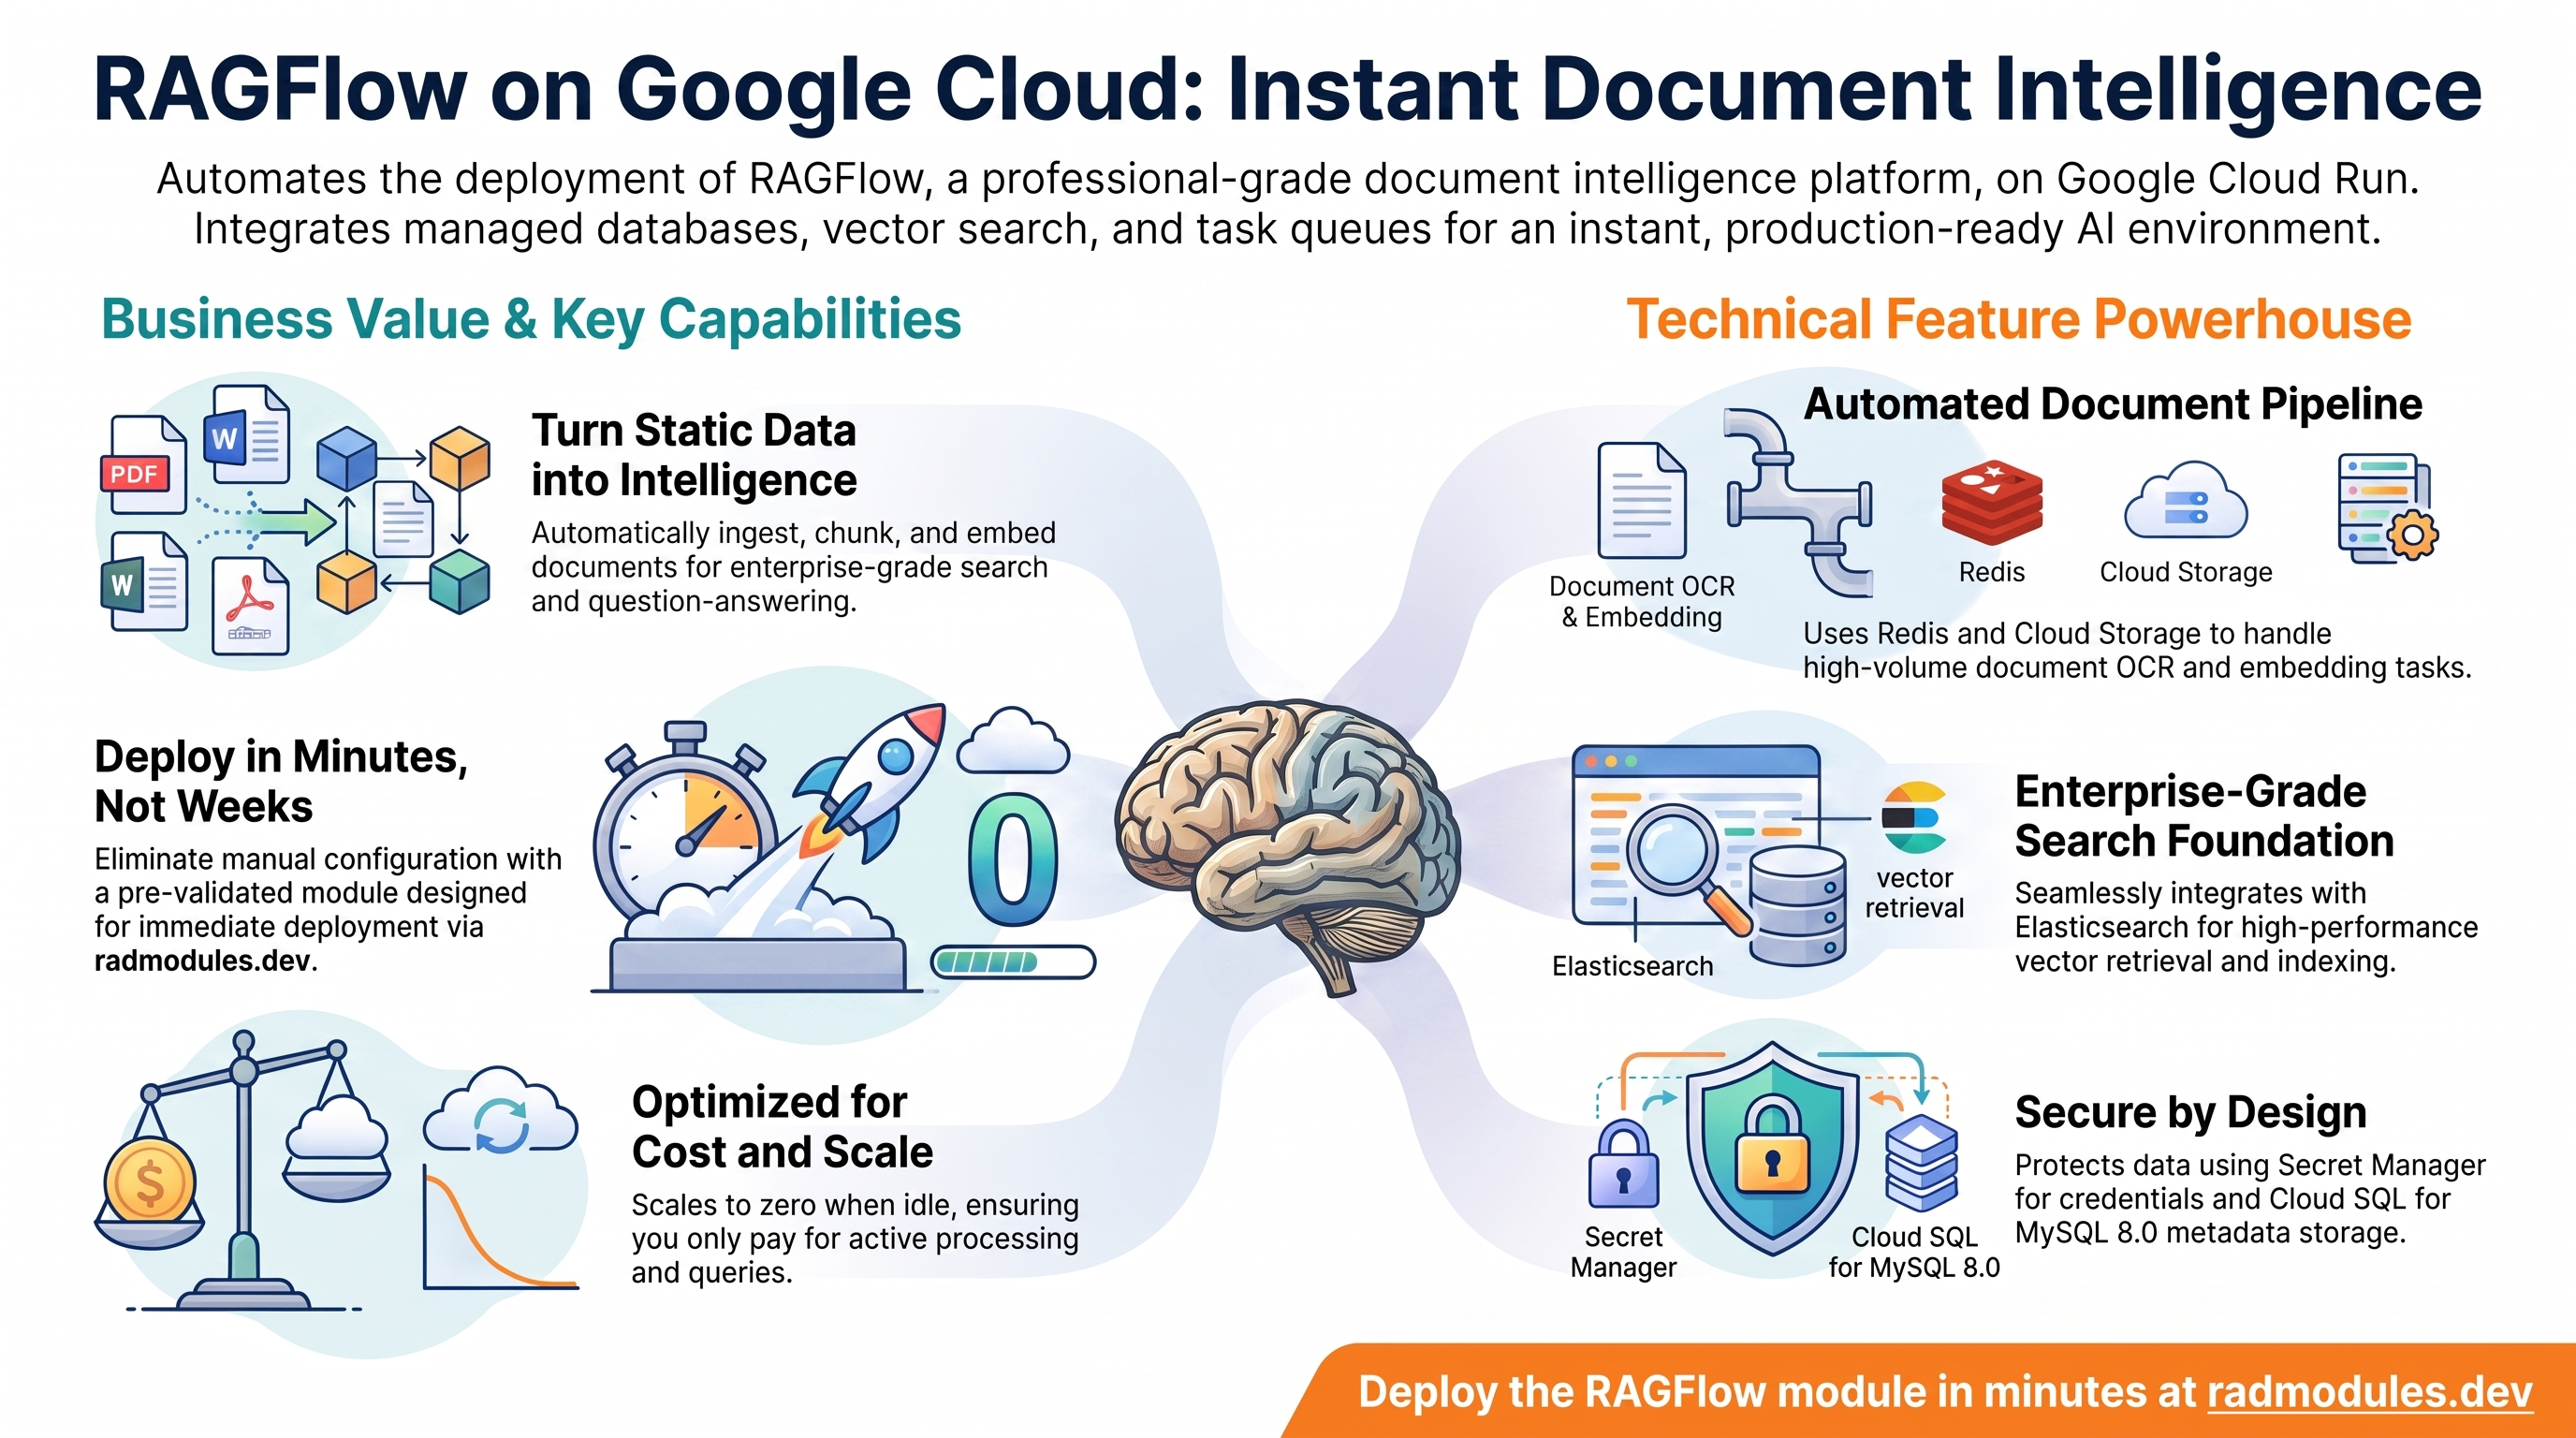
RAGFlow est une plateforme open source d'intelligence documentaire et de génération augmentée par récupération (RAG). Elle ingère des documents PDF, Word, des pages HTML et d'autres formats, les découpe et les intègre, stocke les vecteurs dans Elasticsearch, expose une API REST pour la réponse aux questions et fournit une interface utilisateur web pour la gestion des bases de connaissances et la recherche d'entreprise. Ce module déploie RAGFlow sur Cloud Run v2 au-dessus de la fondation App_CloudRun, qui provisionne et gère l'infrastructure Google Cloud partagée.
Ce guide se concentre sur les services cloud utilisés par RAGFlow et sur la manière de les explorer et de les opérer depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à chaque application Cloud Run — identité de service, ingress et équilibrage de charge, mise à l'échelle et concurrence, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide de la fondation App_CloudRun plutôt que de les répéter ici.
Prérequis de déploiement :
RAGFlow_CloudRunnécessite queElasticsearch_GKEsoit déployé en premier. La variableelasticsearch_hostsdoit être définie lors dedeploy_application = true— le plan est rejeté si elle est vide.
Ce que coûte RAGFlow sur RAD, et comment cela se compare
L'exécution de RAGFlow dans votre propre projet Google Cloud coûte environ 101,98 $ US/mois en infrastructure, plus des frais de module uniques de 110 crédits RAD (dimensionnés à 2 vCPU / 4 GiB sur une instance Cloud Run à mise à l'échelle à zéro). RAD facture les frais de module une seule fois, au moment du déploiement — jamais plus lors d'une mise à jour — et les builds sont inclus dans le prix ; l'utilisation de Google Cloud elle-même est facturée à votre propre compte de facturation au prix catalogue de Google. Sur un projet géré par RAD, les mêmes ressources sont mesurées à l'heure en crédits au prix catalogue plus la marge de RAD — environ 67 crédits/jour — et les frais de module sont 10 % inférieurs, à 99 crédits. Voir "Mettez-le en pause gratuitement" ci-dessous pour savoir comment un déploiement RAGFlow géré par RAD peut être arrêté, sans frais d'exécution, jusqu'à ce que vous en ayez à nouveau besoin. (ou consultez le guide GKE si vous avez besoin de Kubernetes)
Ce que vous payez sur RAD
| Élément | Votre propre projet | Projet géré par RAD |
|---|---|---|
| Frais de module | 110 crédits (une fois) | 99 crédits (une fois) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients sont l'exception : ils sont toujours facturés pour le temps de build à la minute | Identique |
| Coût d'exécution Google Cloud | ~101,98 $ US/mois, facturé à votre propre compte de facturation au prix catalogue de Google | ~67 crédits/jour, mesurés à l'heure au prix catalogue + marge de RAD |
Votre premier déploiement réussi sur RAD est exempt de frais de module, quel que soit le montant des frais : une fois par compte, pour un module que vous déployez et payez vous-même (dans une solution, les frais d'une application : la première à réussir ; jamais une session de lab ou un projet client).
Coût d'exécution par défaut dans votre propre projet
| Ressource | $ US/mois (prix catalogue Google, us-central1) |
|---|---|
| Cloud Run, 2x vCPU / 4 GiB (scaleToZero) | 31,53 |
| Cloud SQL pour MySQL, 1 vCPU / 3,75 Go, zonal, 10 Go SSD | 51,02 |
| Serveur de fichiers NFS/cache (petite VM) | 13,43 |
| Cloud NAT et réseau | 5 |
| Cloud Storage (modules complémentaires, sauvegardes) | 1 |
| Total | 101,98 $ |
Comment cela se compare
- Nous n'avons pas pu vérifier un prix SaaS commercial actuel directement comparable pour ce projet open source exact, la comparaison honnête est donc un serveur autonome nu : Hetzner CPX22 (2 vCPU/4 Go, ~24 $/mois), un DigitalOcean 2 vCPU/4 Go Droplet (~24 $/mois), ou un GCP Compute Engine e2-standard-2 (2 vCPU/8 Go, ~49 $/mois).
- RAD ne prétend pas battre un VPS nu sur le prix affiché — ce n'est généralement pas le cas. Ce que RAD ajoute pour un montant en dollars identique ou similaire, c'est une base de données gérée, des identifiants détenus par Secret Manager, la surveillance et la mise à jour en un clic, dont aucun n'est fourni gratuitement par un VPS nu.
- Sur un VPS nu, c'est vous qui appliquez les correctifs de sécurité du système d'exploitation/de la base de données, effectuez et testez les sauvegardes, et renouvelez les certificats ; Cloud SQL géré par RAD, Secret Manager et la surveillance gèrent les trois pour vous.
Mettez-le en pause gratuitement : supprimez un projet géré par RAD, restaurez-le lorsque vous en avez besoin
C'est l'option principale sur un projet géré par RAD, et elle est gratuite pendant la pause. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer le projet lui-même — la suppression logique récupérable de 30 jours de Google. Contrairement à la suppression d'un seul module, cela ne détruit pas la base de données, une VM ou la ressource de calcul une par une : l'ensemble du projet s'arrête simplement, et comme la facturation est déjà déliée, rien n'est facturé pendant qu'il attend.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, seront utilisables après sa restauration, de sorte que la restauration ne peut pas être invoquée comme moyen de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
La restauration — dans les 30 jours, et uniquement par le propriétaire du projet — demande à Google de récupérer le projet et de rattacher son compte de facturation, puis vous demande d'exécuter une mise à jour sur chaque déploiement pour confirmer que tout est revenu. Comme rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes : c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit. Ce qu'il faut : vous devez être propriétaire du projet (pas seulement faire gérer sa facturation par RAD), vous devez le restaurer vous-même dans les 30 jours — après cela, Google le supprime définitivement — et la restauration est admise comme la création d'un nouveau projet, donc votre solde de crédits achetés doit toujours dépasser le seuil du palier (100 crédits pour le palier sandbox que la plupart des utilisations d'étude et de démonstration conviennent). Google indique que la plupart des services fonctionnent à nouveau pleinement dans les 36 heures suivant une restauration.
Un véritable manque : les sauvegardes nocturnes sont écrites dans un bucket à l'intérieur du projet, et ce bucket a la suppression logique de Cloud Storage explicitement désactivée, de sorte que le bucket de sauvegarde est très probablement supprimé dès que vous supprimez le projet — même si le projet lui-même est récupérable pendant 30 jours. Si vous avez personnalisé ce déploiement et que vous souhaitez conserver ce travail, copiez une sauvegarde (vers Google Drive ou un bucket en dehors du projet) avant de supprimer. Pour une installation par défaut sans rien d'irremplaçable, cela n'a pas d'importance.
Payez uniquement pendant que vous l'utilisez, l'autre méthode : supprimer et redéployer
L'autre levier, pour un projet propre (ou un projet géré par RAD au-delà de sa fenêtre de restauration de 30 jours), est de supprimer RAGFlow purement et simplement et de le redéployer plus tard. Un redéploiement coûte à nouveau les frais de module (les builds sont inclus) — 110 crédits au total pour ce module.
La suppression ne permet d'économiser de l'argent que si RAGFlow reste inutilisé assez longtemps pour compenser ce coût de redéploiement par rapport à son propre coût d'exécution — pour ce module, cela représente environ 4 jours ou plus d'inactivité, basé sur son propre coût d'exécution de 101,98 $ US/mois ci-dessus. La plupart de ce coût d'exécution est généralement la base de données et toute VM de fichier/cache partagée, et ils ne s'arrêtent que si rien d'autre dans le projet ne les utilise, donc la suppression de cette application seule n'économise que sa propre part de calcul si quelque chose d'autre partage le projet.
Conservez d'abord les données : les sauvegardes nocturnes vont dans un bucket à l'intérieur du déploiement et sont supprimées avec lui, donc copiez la dernière sauvegarde avant de supprimer si vous voulez la conserver.
Sessions de lab et environnements gérés
- Sessions de lab, pour la formation : un formateur anime une session pour une classe. Chaque participant obtient l'application dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite d'une allocation définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés retournent au formateur.
- Environnements gérés, pour les cabinets de conseil : un partenaire exécute l'application pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille est faible, la facturation est suspendue et les données sont conservées, de sorte que personne ne reçoit de facture inattendue. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
- Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue de l'API Google Cloud Billing Catalog ; radmodules.dev/pricing pour les frais propres de RAD et les estimations de crédits quotidiens ; Resource Manager : supprimer et restaurer des projets pour les mécanismes de pause/restauration.
1. Vue d'ensemble
RAGFlow s'exécute en tant que service Python/Nginx conteneurisé sur Cloud Run v2. Le déploiement relie un ensemble ciblé de services Google Cloud :
| Capacité | Service Google Cloud | Notes |
|---|---|---|
| Calcul | Cloud Run v2 | Service RAGFlow personnalisé, 2 vCPU / 4 GiB par défaut, démarrage à froid (min_instance_count = 0) par défaut |
| Base de données | Cloud SQL pour MySQL 8.0 | Requis — RAGFlow ne prend pas en charge PostgreSQL |
| Recherche vectorielle | Elasticsearch (Elasticsearch_GKE) | Dépendance externe — doit être déployé en premier ; elasticsearch_hosts est obligatoire |
| File d'attente de tâches | Redis (Memorystore) | Requis pour les workers de traitement de documents |
| Stockage d'objets | Point de terminaison externe compatible S3 | RAGFlow stocke chaque document téléchargé dans un stockage compatible S3. Sur Cloud Run, il n'y a pas de valeur par défaut fonctionnelle : fournissez un point de terminaison avec minio_host / minio_user / minio_password_secret. Un bucket Cloud Storage documents est également provisionné, mais RAGFlow ne l'utilise pas |
| Secrets | Secret Manager | Mot de passe de base de données généré automatiquement |
| Ingress | URL Cloud Run / Cloud Load Balancing | URL run.app par défaut ; équilibreur de charge HTTPS Cloud Armor + domaine personnalisé en option |
Valeurs par défaut judicieuses à connaître d'emblée :
- MySQL 8.0 est obligatoire. La sélection de PostgreSQL ou
NONEinterrompt le démarrage. elasticsearch_hostsest requis. RAGFlow ne peut pas indexer ou rechercher des documents sans un point de terminaison Elasticsearch accessible. Cette vérification est ignorée uniquement lorsquedeploy_application = false.- L'ingestion de documents nécessite un point de terminaison compatible S3 que vous
fournissez. RAGFlow conserve les documents téléchargés dans un stockage d'objets
compatible S3, un bucket par base de connaissances. Définissez
minio_host,minio_useretminio_password_secret(un nom de secret Secret Manager).enable_inline_minio(un sidecar MinIO sur Filestore) est implémenté mais par défaut àfalse: Cloud Run rejette l'image MinIOquay.ioà moins qu'elle ne soit d'abord mise en miroir dans Artifact Registry, et deux révisions qui se chevauchent partageant un répertoire de données MinIO est un risque non prouvé. Pour une valeur par défaut fonctionnelle, utilisez RAGFlow_GKE. - Redis est requis pour le traitement des documents. Avec
enable_redis = true(par défaut),REDIS_HOSTetREDIS_PORTsont injectés automatiquement. Siredis_hostest laissé vide, App_CloudRun revient à l'adresse IP du serveur NFS (la VM NFS co-héberge Redis) — même comportement que la variante GKE. Sans un Redis accessible, les fichiers téléchargés restent non traités indéfiniment. - Démarrage à froid par défaut.
min_instance_count = 0etcpu_always_allocated = false(facturation basée sur les requêtes) — le service se met à l'échelle à zéro lorsqu'il est inactif et ne facture le CPU que pendant le traitement d'une requête. Compromis : l'exécuteur de tâches de documents en arrière-plan s'arrête lorsqu'il est inactif, de sorte que l'ingestion/l'analyse des documents nouvellement téléchargés ne s'exécute pas en arrière-plan ; la requête/le chat fonctionne toujours sur demande. Définissezcpu_always_allocated = trueetmin_instance_count >= 1pour restaurer l'ingestion continue en arrière-plan (et éviter le démarrage à froid de 2 à 3 minutes pendant le chargement des modèles d'intégration). - L'environnement d'exécution Gen2 est requis pour NFS.
execution_environment = "gen2"est la valeur par défaut ; le passage àgen1avecenable_nfs = trueéchoue au moment du plan. - Une image personnalisée est toujours construite. Cloud Build étend
infiniflow/ragflowen utilisant le Dockerfile dansRAGFlow_Common/scripts/, avecAPP_VERSIONdéfini à partir deapplication_version. service_conf.yamlest généré au démarrage. Le point d'entrée personnalisé écrit/ragflow/conf/service_conf.yamlà partir des variables d'environnement injectées avant de démarrer les processus RAGFlow. Un pontsocatadapte le socket Unix du proxy d'authentification Cloud SQL au port TCP attendu par le client MySQL de RAGFlow.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que PROJECT et REGION sont définis. Les noms de
services et de ressources sont signalés dans les Sorties du
déploiement.
A. Cloud Run — le service RAGFlow
RAGFlow s'exécute en tant que service Cloud Run v2. Par défaut, il se met à l'échelle
à zéro lorsqu'il est inactif (min_instance_count = 0, cpu_always_allocated = false) ; définissez les deux
pour maintenir une instance active et éviter les retards de démarrage à froid pendant
le chargement du modèle d'intégration. Chaque déploiement crée une révision
immuable ; le trafic peut être réparti entre les révisions pour des déploiements
sûrs.
- Console : Cloud Run → sélectionnez le service pour les révisions, le trafic, les journaux et les métriques.
- CLI :
gcloud run services list --project "$PROJECT" --region "$REGION"
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION"
gcloud run revisions list --service <service-name> --project "$PROJECT" --region "$REGION"
Voir App_CloudRun pour la mise à l'échelle, la concurrence, l'environnement d'exécution et la répartition du trafic.
B. Cloud SQL pour MySQL 8.0
RAGFlow stocke toutes les métadonnées de l'application (comptes utilisateurs, bases
de connaissances, état des tâches) dans une instance Cloud SQL pour MySQL 8.0 gérée.
Le service se connecte en privé via le sidecar Cloud SQL Auth Proxy via un
socket Unix. Un pont socat à l'intérieur du conteneur mappe ce socket à
127.0.0.1:3306 pour le client MySQL TCP de RAGFlow. Lors du premier déploiement,
un job d'initialisation crée la base de données et l'utilisateur de l'application.
- Console : SQL → sélectionnez l'instance pour les connexions, les sauvegardes, les indicateurs, les métriques.
- CLI :
gcloud sql instances list --project "$PROJECT"
gcloud sql instances describe <instance-name> --project "$PROJECT"
gcloud sql connect <instance-name> --user=<db-user> --project "$PROJECT"
Le nom de l'instance, la base de données, l'utilisateur et le secret du mot de passe se trouvent dans les Sorties. Voir App_CloudRun pour le modèle de connexion, les sauvegardes et la rotation des mots de passe.
C. Elasticsearch — recherche vectorielle
RAGFlow nécessite une instance Elasticsearch externe pour l'indexation de documents
et la recherche vectorielle. Déployez Elasticsearch_GKE séparément et passez sa
sortie elasticsearch_endpoint comme elasticsearch_hosts. Les variables d'environnement
ELASTICSEARCH_HOSTS et ELASTICSEARCH_USERNAME sont injectées automatiquement.
Elasticsearch intégré n'est pas pris en charge sur Cloud Run.
- Console : Kubernetes Engine → Workloads → Elasticsearch namespace.
- CLI :
# Confirm RAGFlow can reach Elasticsearch (from Cloud Shell or a VPC-connected host):
curl -s "$ELASTICSEARCH_HOSTS/_cluster/health" | grep status
D. Redis — file d'attente de tâches
Redis est l'épine dorsale du pipeline de traitement de documents de RAGFlow. Les
workers interrogent Redis pour les tâches ; sans lui, les fichiers téléchargés ne
sont jamais analysés, découpés ou intégrés. L'instance Memorystore Redis est
accessible via le VPC via le paramètre d'égression VPC PRIVATE_RANGES_ONLY (par
défaut).
- Console : Memorystore → Redis (si vous utilisez une instance gérée).
- CLI :
redis-cli -h <redis-host> ping
redis-cli -h <redis-host> info keyspace
E. Cloud Storage
Un bucket Cloud Storage dédié (ragflow-documents) est provisionné pour
l'ingestion et le stockage de documents. Des buckets supplémentaires et des montages
de volume GCS Fuse peuvent être ajoutés via storage_buckets et gcs_volumes.
Le compte de service de la charge de travail est automatiquement autorisé.
- Console : Cloud Storage → Buckets.
- CLI :
gcloud storage buckets list --project "$PROJECT"
gcloud storage ls gs://<documents-bucket>/     # bucket name is in the Outputs
Voir App_CloudRun pour les options GCS Fuse et CMEK.
F. Secret Manager
Le mot de passe de la base de données est stocké dans Secret Manager et injecté dans le service au moment de l'exécution ; le texte en clair n'apparaît jamais dans la configuration.
- Console : Security → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
Voir App_CloudRun pour les détails d'injection et de rotation.
G. Réseau et ingress
Le service est accessible à son URL run.app par défaut. Un équilibreur de
charge HTTPS externe avec Cloud Armor WAF, un domaine personnalisé et Cloud CDN
peuvent être superposés. L'égression VPC est définie sur PRIVATE_RANGES_ONLY par
défaut afin que le trafic Redis et MySQL transite par le VPC privé tandis que
l'égression publique reste illimitée.
- Console : Cloud Run (URL du service) ; Network services → Load balancing.
- CLI :
gcloud run services describe <service-name> --region "$REGION" --format='value(status.url)'
gcloud compute addresses list --project "$PROJECT"
Voir App_CloudRun.
H. Cloud Logging et Monitoring
Les journaux de conteneurs sont envoyés à Cloud Logging ; les métriques Cloud Run et Cloud SQL sont envoyées à Cloud Monitoring, avec des tests de disponibilité et des politiques d'alerte facultatifs.
- Console : Logging → Logs Explorer ; Monitoring → Dashboards / Alerting.
- CLI :
gcloud run services logs read <service-name> --project "$PROJECT" --region "$REGION" --limit 50
3. Comportement de l'application RAGFlow
-
Configuration de la base de données au premier déploiement. Un job d'initialisation Cloud Run (
mysql:8.0-debian) crée la base de données RAGFlow (rag_flow) et l'utilisateur (ragflow) avant le démarrage du service. Il est idempotent et peut être réexécuté en toute sécurité. -
service_conf.yamlgénéré au démarrage. Le point d'entrée personnalisé génère/ragflow/conf/service_conf.yamlà partir des variables d'environnement injectées — y compris l'hôte/utilisateur/base de données MySQL, le point de terminaison Elasticsearch, l'hôte/port Redis et les identifiants facultatifs — avant de démarrer les processus RAGFlow. Un pontsocatadapte le socket Unix du proxy d'authentification Cloud SQL à127.0.0.1:3306pour le client MySQL de RAGFlow. -
Pipeline de traitement de documents. Les documents téléchargés sont mis en file d'attente dans Redis et traités de manière asynchrone par les workers de documents de RAGFlow : OCR, découpage, intégration et indexation dans Elasticsearch. Sans un Redis et un Elasticsearch accessibles, les fichiers apparaissent téléchargés mais ne sont jamais traités.
-
Chargement du modèle d'intégration au démarrage. RAGFlow télécharge et charge les modèles d'intégration lors du premier démarrage. La sonde de démarrage cible
/v1/system/versionavec un délai initial de 120 secondes et 30 tentatives de récupération en cas d'échec. Définissezmin_instance_count >= 1aveccpu_always_allocated = truepour éviter les démarrages à froid et maintenir le traitement des documents en arrière-plan en continu. -
Points de terminaison de santé. Les sondes de démarrage et de vivacité utilisent
/v1/system/version. Le test de disponibilité (s'il est activé) cible/v1/health. Ceux-ci renvoient HTTP 200 uniquement lorsque l'application est entièrement initialisée.Inspecter les exécutions de job :
gcloud run jobs list --project "$PROJECT" --region "$REGION"
gcloud run jobs executions list --job <job-name> --project "$PROJECT" --region "$REGION"
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres spécifiques ou notables pour RAGFlow sont listés ; toutes les autres entrées sont héritées de App_CloudRun avec son comportement standard.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (requis) | Projet Google Cloud cible. |
region | us-central1 | Région pour le service et les ressources régionales. |
elasticsearch_hosts | (requis) | Point de terminaison HTTP Elasticsearch (par exemple http://10.0.0.5:9200). Défini sur la sortie elasticsearch_endpoint de Elasticsearch_GKE. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques par environnement. |
support_users | [] | Adresses e-mail autorisées à accéder au projet et aux alertes de surveillance. |
resource_labels | {} | Étiquettes appliquées à toutes les ressources. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | ragflow | Nom de base des ressources. Ne pas modifier après le premier déploiement. |
display_name | RAGFlow | Nom convivial affiché dans la console. |
description | (défini) | Description du service. |
application_version | v0.13.0 | Tag de version de l'image RAGFlow passé comme APP_VERSION à Cloud Build ; incrémenter pour déployer une nouvelle version. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définissez false pour provisionner uniquement l'infrastructure. |
cpu_limit | 2000m | CPU par instance ; 4 vCPU ou plus recommandés pour le traitement de documents en production. |
memory_limit | 4Gi | Mémoire par instance ; 8–16 GiB recommandés pour la production. |
cpu_always_allocated | false | Valeur par défaut de démarrage à froid axée sur les coûts. true restaure le traitement continu des documents en arrière-plan entre les requêtes. |
min_instance_count | 0 | Se met à l'échelle à zéro lorsqu'il est inactif. Définissez ≥ 1 (avec cpu_always_allocated = true) pour maintenir l'exécuteur de tâches en arrière-plan et les modèles d'intégration actifs. |
max_instance_count | 1 | Nombre maximal d'instances ; augmentez avec prudence (nécessite NFS pour le stockage partagé). |
container_port | 80 | Le frontend Nginx de RAGFlow écoute sur le port 80. |
execution_environment | gen2 | Doit rester gen2 — requis pour les montages NFS. |
timeout_seconds | 600 | Augmentez pour les requêtes de traitement de documents volumineux (max 3600). |
enable_cloudsql_volume | true | Sidecar Cloud SQL Auth Proxy pour les connexions socket. |
traffic_split | [] | Répartir le trafic entre les révisions pour des déploiements échelonnés. |
Groupe 5 — Contrôle d'accès et d'ingress
| Variable | Valeur par défaut | Description |
|---|---|---|
ingress_settings | all | Quels réseaux peuvent atteindre le service (all, internal, internal-and-cloud-load-balancing). |
vpc_egress_setting | PRIVATE_RANGES_ONLY | Acheminer le trafic privé RFC-1918 (Redis, MySQL) via le VPC. |
enable_iap | false | Exiger la connexion Google via Identity-Aware Proxy. |
iap_authorized_users / iap_authorized_groups | [] | Qui peut accéder via IAP. |
Groupe 6 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Paramètres supplémentaires non secrets. Ne pas remplacer MYSQL_*, ELASTICSEARCH_* ou REDIS_* — ceux-ci sont injectés automatiquement. |
secret_environment_variables | {} | Mappage variable d'environnement → nom de secret Secret Manager. |
secret_propagation_delay / secret_rotation_period | (défini) | Attente de réplication / cadence de rotation. |
Groupe 7 — Sauvegarde et restauration
| Variable | Valeur par défaut | Description |
|---|---|---|
backup_schedule | 0 2 * * * | Cron de sauvegarde automatisée (UTC). |
backup_retention_days | 7 | Rétention ; augmenter pour la production/conformité. |
enable_backup_import / backup_source / backup_uri / backup_format | options de restauration | Restaurer à partir d'une sauvegarde lors du déploiement. |
Groupe 8 — CI/CD et Binary Authorization
Intégration standard App_CloudRun Cloud Build / Cloud Deploy — voir
App_CloudRun. Entrées clés : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy,
enable_binary_authorization.
Groupe 9 — Scripts SQL personnalisés
enable_custom_sql_scripts, custom_sql_scripts_bucket, custom_sql_scripts_path,
custom_sql_scripts_use_root — exécuter du SQL à partir d'un bucket GCS après le
provisionnement. Voir App_CloudRun.
Groupe 10 — Cloud Armor, CDN et domaine personnalisé
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_cloud_armor | false | Attacher une politique Cloud Armor WAF via un équilibreur de charge HTTPS global. |
admin_ip_ranges | [] | CIDR autorisés à un accès privilégié. |
application_domains | [] | Noms d'hôtes personnalisés pour l'équilibreur de charge HTTPS. |
enable_cdn | false | Activer Cloud CDN sur le backend de l'équilibreur de charge. |
Groupe 11 — Stockage et système de fichiers
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Provisionner des buckets GCS supplémentaires. Le bucket ragflow-documents est toujours créé. |
storage_buckets | [{ name_suffix="data" }] | Configurations de buckets GCS supplémentaires. |
enable_nfs | true | Volume Filestore partagé. Requis pour les déploiements multi-instances et lorsque redis_host est vide (adresse IP du serveur NFS utilisée comme hôte Redis de secours). |
nfs_mount_path | /mnt/nfs | Chemin de montage à l'intérieur du conteneur. |
gcs_volumes | [] | Volumes GCS Fuse montés dans le conteneur RAGFlow. |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options CMEK. |
Groupe 12 — Backend de base de données
| Variable | Valeur par défaut | Description |
|---|---|---|
database_type | MYSQL_8_0 | Fixe — ne pas modifier. |
db_name | rag_flow | Nom de la base de données. Immuable après le premier déploiement. |
db_user | ragflow | Utilisateur de l'application. Immuable après le premier déploiement. |
database_password_length | 32 | Longueur du mot de passe généré (16–64). |
enable_auto_password_rotation / rotation_propagation_delay_sec | désactivé | Rotation du mot de passe de la base de données. |
db_host_env_var_name / db_name_env_var_name / db_user_env_var_name / db_port_env_var_name / service_url_env_var_name | "" | Noms de variables d'environnement supplémentaires sous lesquels les détails de connexion sont injectés. |
Groupe 13 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Laisser vide pour utiliser le job Cloud Run db-init intégré. |
cron_jobs | [] | Jobs Cloud Run planifiés récurrents. |
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe | HTTP /v1/system/version, délai de 120 s, 30 tentatives | Permet un temps suffisant pour le chargement du modèle d'intégration au premier démarrage. |
liveness_probe | HTTP /v1/system/version, délai de 120 s | Sonde de vivacité une fois le démarrage réussi. |
uptime_check_config | désactivé | Test de disponibilité Cloud Monitoring. |
alert_policies | [] | Politiques d'alerte métrique. |
Groupe 15 — Elasticsearch et Redis
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_redis | true | Utiliser Redis pour la file d'attente de tâches de traitement de documents. Transmis inconditionnellement à App_CloudRun — Redis est câblé que redis_host soit défini ou laissé vide. |
redis_host | "" | Point de terminaison Redis. Lorsqu'il est laissé vide, App_CloudRun injecte REDIS_HOST = <NFS server IP> comme solution de repli (comportement identique à la variante GKE, puisque la VM NFS co-héberge Redis). Définir explicitement pour pointer vers une autre instance Redis (par exemple Memorystore). |
redis_port | 6379 | Port Redis. |
redis_auth | "" | Mot de passe d'authentification Redis facultatif (sensible). |
elasticsearch_username | "" | Nom d'utilisateur Elasticsearch. Laisser vide lorsque xpack.security.enabled = false. |
Groupe 22 — VPC Service Controls et journalisation d'audit
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vpc_sc | false | Appliquer un périmètre VPC-SC (nécessite organization_id). |
vpc_cidr_ranges / vpc_sc_dry_run | (défini) | CIDR de niveau d'accès / mode simulation. |
enable_audit_logging | false | Journaux d'audit Cloud détaillés. |
5. Sorties
Retourné lors d'un déploiement réussi — le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du service Cloud Run. |
service_url | URL run.app par défaut du service. |
service_location | Région dans laquelle le service s'exécute. |
stage_services | Détails du service spécifiques à l'étape (Cloud Deploy). |
load_balancer_ip / load_balancer_url | IP / URL de l'équilibreur de charge HTTPS externe (lorsqu'il est activé). |
database_instance_name | Nom de l'instance Cloud SQL. |
database_name / database_user | Nom / utilisateur de la base de données de l'application. |
database_password_secret | Secret Secret Manager contenant le mot de passe de la base de données. |
database_host / database_port | Point de terminaison / port de la base de données. |
storage_buckets | Buckets Cloud Storage créés. |
network_name / network_exists / regions | Réseau VPC, présence, régions. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels / uptime_check_names | État de la surveillance, canaux, tests de disponibilité. |
initialization_jobs | Noms des jobs de configuration. |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants de projet. |
cicd_enabled / github_repository_url / github_repository_owner / github_repository_name / cicd_configuration | État et détails CI/CD. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Registre et déclencheur de build. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | Journalisation d'audit et état CMEK. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence si incorrect |
|---|---|---|---|
elasticsearch_hosts | requis — défini à partir de Elasticsearch_GKE | Critique | RAGFlow ne peut pas indexer ou rechercher ; toutes les opérations d'ingestion et de récupération échouent. Le plan est rejeté lorsqu'il est vide et deploy_application = true. |
enable_redis | true | Critique | Sans Redis, la file d'attente de traitement de documents ne s'exécute jamais ; les fichiers téléchargés restent non traités indéfiniment. |
database_type | MYSQL_8_0 | Critique | RAGFlow nécessite MySQL ; PostgreSQL/NONE interrompt le démarrage. |
enable_cloudsql_volume | true | Critique | RAGFlow se connecte via un socket Unix ponté vers TCP par socat ; la désactivation du sidecar proxy entraîne un échec de connexion à la base de données au démarrage. |
db_name / db_user | défini une fois | Critique | Immuable après le premier déploiement ; le renommage recrée la base de données/l'utilisateur et détruit les données. |
enable_backup_import | false sauf en cas de restauration | Critique | L'activation sans un backup_uri valide échoue le job d'importation. |
redis_host | laisser vide pour utiliser le Redis de secours du serveur NFS, ou définir une IP Memorystore explicite | Élevé | Lorsque redis_host = "" et enable_redis = true, App_CloudRun injecte REDIS_HOST = <NFS server IP> (nécessite enable_nfs = true, la valeur par défaut) — identique à la variante GKE. Si NFS est désactivé et redis_host est laissé vide, aucun hôte Redis n'est injecté et les workers de documents asynchrones ne s'exécutent silencieusement jamais. |
min_instance_count / cpu_always_allocated | 1 / true pour une ingestion continue | Élevé | Les valeurs par défaut sont 0 / false (démarrage à froid) : le traitement des documents en arrière-plan s'arrête lorsqu'il est inactif et les démarrages à froid prennent 2 à 3 minutes. Définissez les deux pour une ingestion toujours active. |
memory_limit | 4Gi (≥ 8Gi pour la production) | Élevé | Les modèles d'intégration et le serveur d'applications nécessitent une RAM importante ; trop peu entraîne des arrêts OOM. |
vpc_egress_setting | PRIVATE_RANGES_ONLY | Élevé | Memorystore Redis est sur une IP VPC privée ; un routage d'égression incorrect interrompt la file d'attente de tâches. |
execution_environment | gen2 | Élevé | Les montages NFS nécessitent gen2 ; le passage à gen1 avec enable_nfs = true échoue au moment du plan. |
elasticsearch_username | "" ou utilisateur correct | Élevé | Si la sécurité Elasticsearch est activée, laisser ce champ vide entraîne une erreur HTTP 401 et interrompt toute indexation. |
enable_nfs | true | Élevé | Les déploiements multi-instances sans stockage partagé voient des vues de documents incohérentes entre les instances. |
ingress_settings / enable_iap | restreindre pour la production | Élevé | L'ingress public sans IAP expose RAGFlow à des appelants non authentifiés. |
max_instance_count | 1 (augmenter uniquement avec NFS) | Moyen | La mise à l'échelle au-delà de 1 sans NFS entraîne un accès aux documents en split-brain entre les instances. |
timeout_seconds | 600 | Moyen | Les téléchargements de documents volumineux peuvent prendre plusieurs minutes ; un délai trop court entraîne des timeouts 504 avant la fin du traitement. |
backup_retention_days | 7 (augmenter pour la production) | Moyen | Trop court pour la rétention de conformité. |
application_version | v0.13.0 | Moyen | L'incrémentation déclenche une reconstruction d'image et un déploiement de révision ; vérifier la compatibilité du schéma MySQL pour les sauts de version majeure. |
Pour le comportement de la fondation référencé tout au long — identité de service, mise à l'échelle et concurrence, ingress et équilibrage de charge, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir d'images — voir App_CloudRun. La configuration d'application spécifique à RAGFlow partagée avec la variante GKE est décrite dans RAGFlow_Common.
Guides associées
- Lab pratique : RAGFlow sur Cloud Run — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- RAGFlow sur GKE Autopilot — la même application sur Kubernetes, pour quand vous avez besoin de l'autre cible de déploiement.
- RAGFlow Common — Configuration d'application partagée — la configuration partagée par les deux cibles de déploiement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.