Agent Hermes sur Google Cloud Run
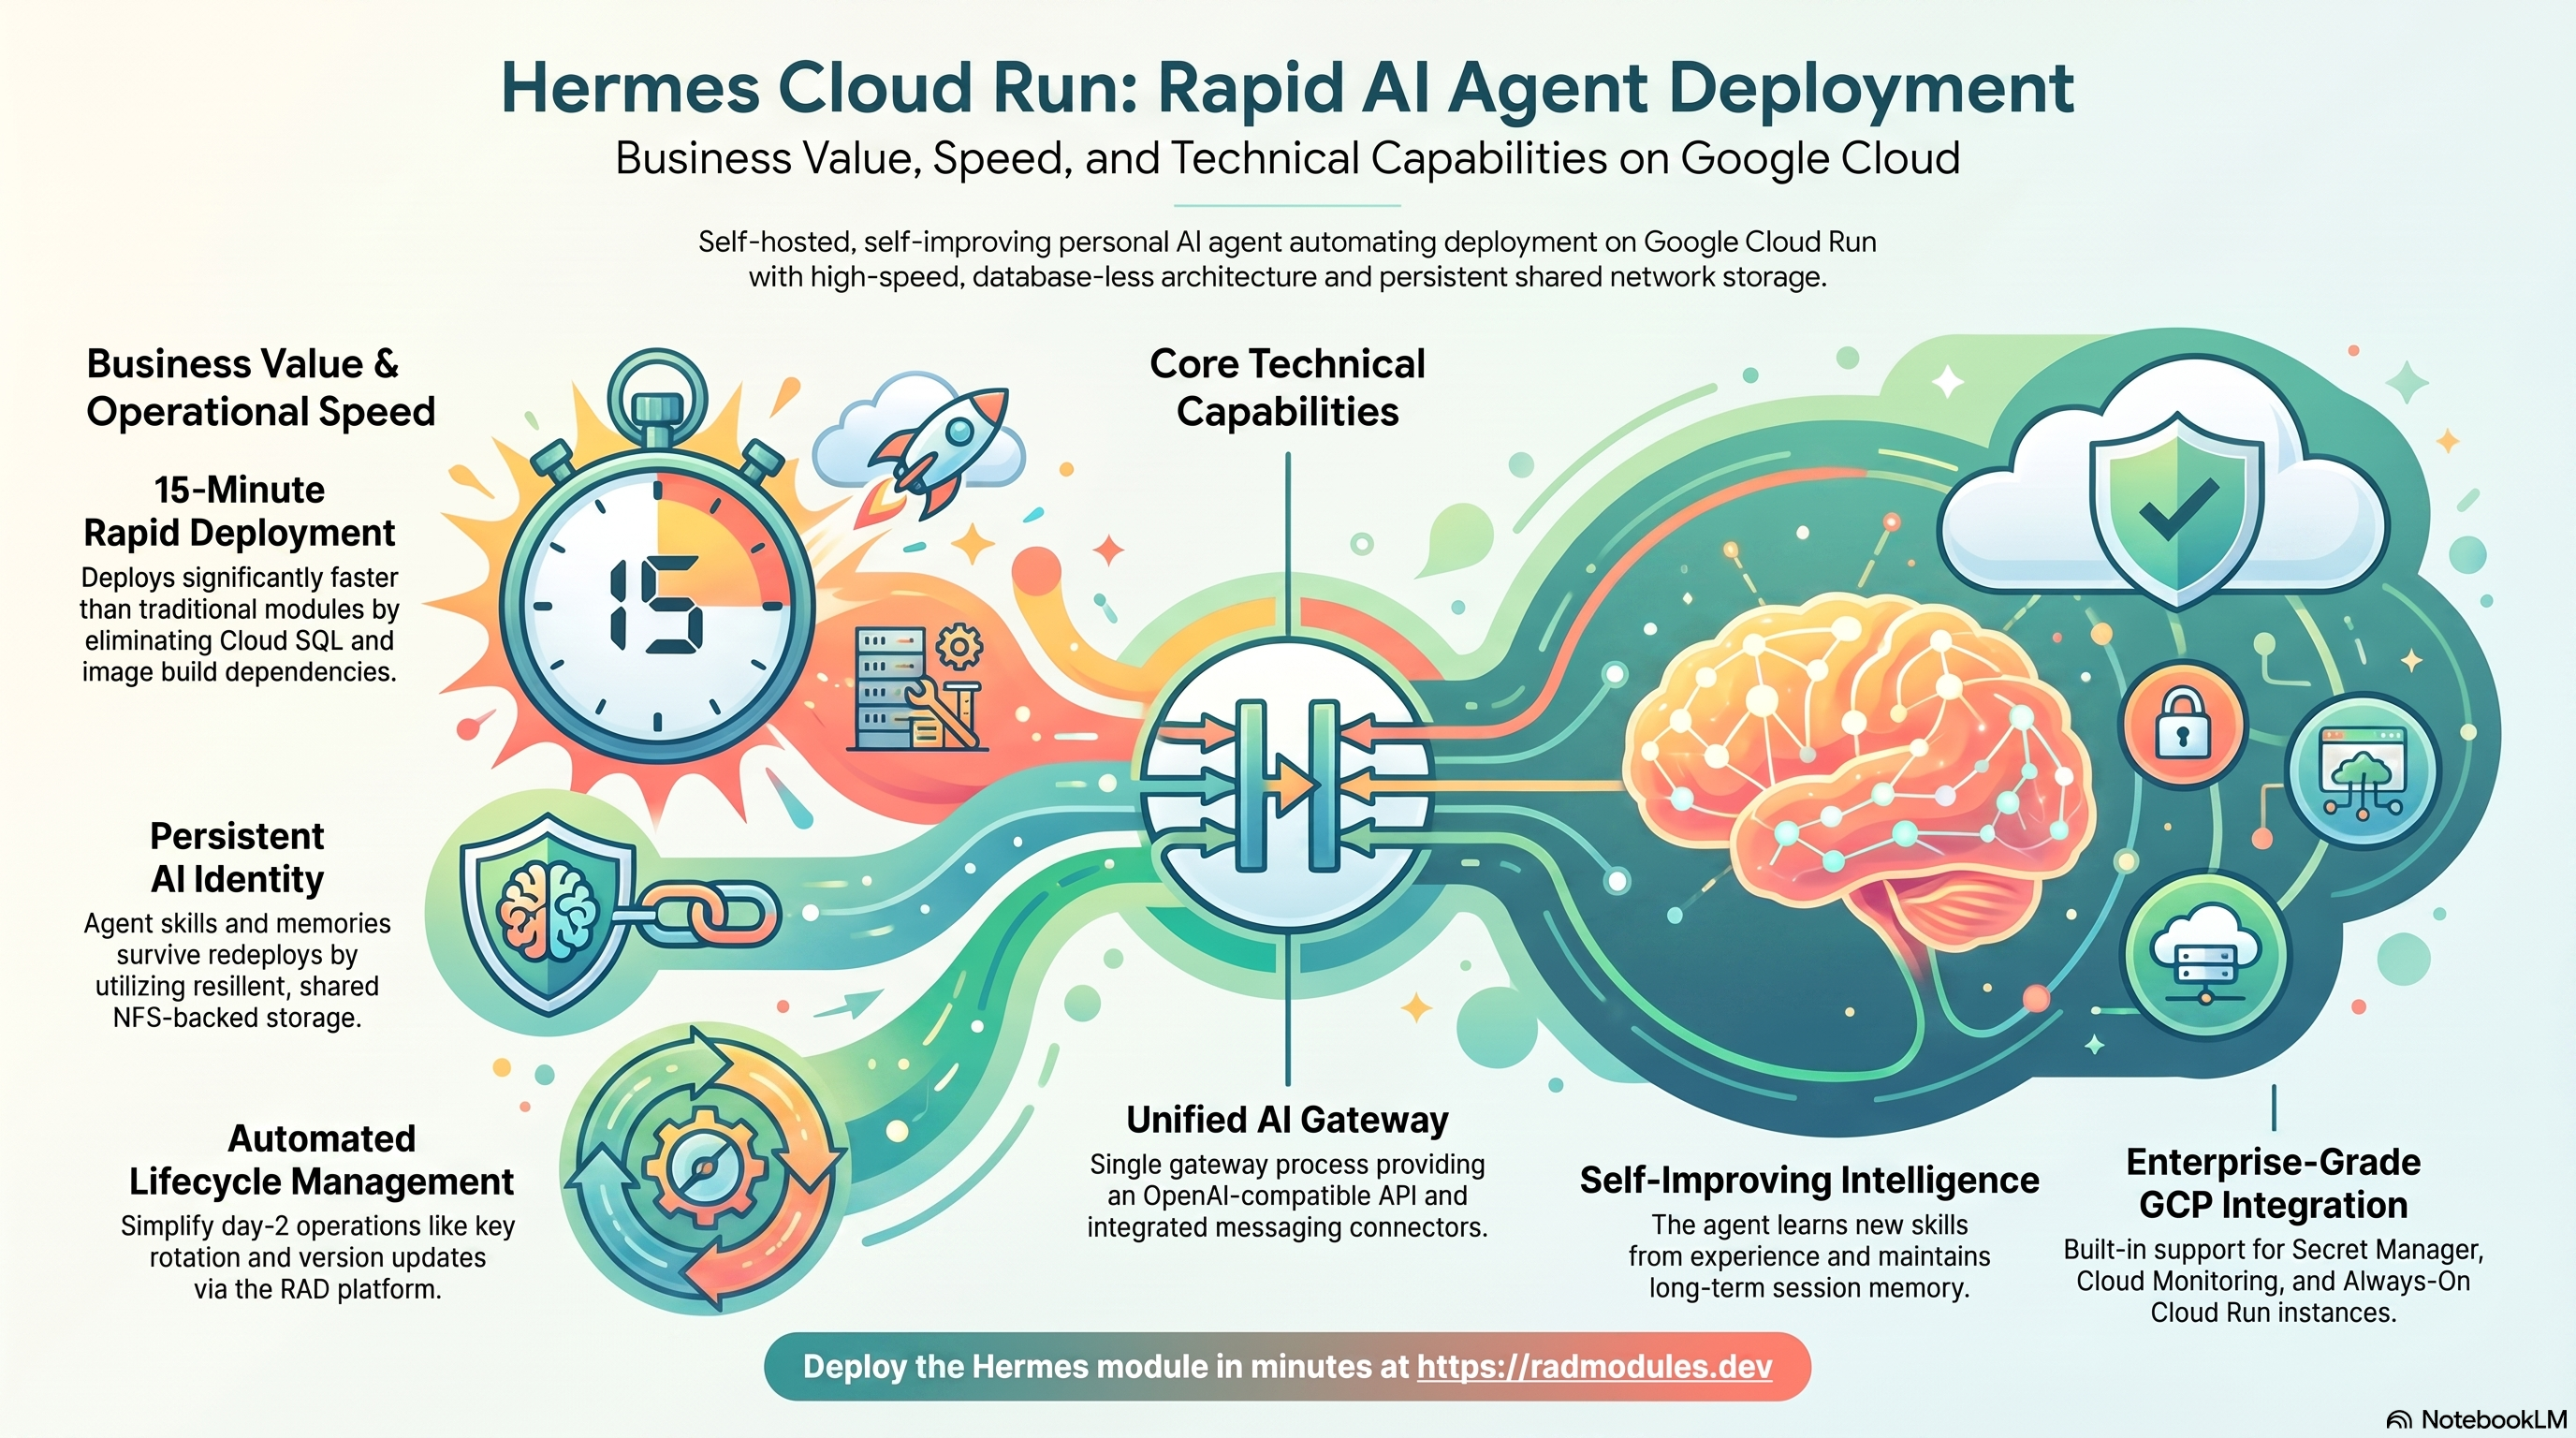
L'Agent Hermes est un agent d'IA personnel auto-hébergé et auto-améliorant,
open-source (licence MIT), de Nous Research : il apprend des compétences par
l'expérience, conserve la mémoire entre les sessions et se connecte aux
plateformes de messagerie ainsi qu'à une API compatible OpenAI à partir d'un
processus de passerelle unique
(documentation). Ce module
déploie l'image officielle nousresearch/hermes-agent sur Cloud Run v2 sur la
fondation App_CloudRun, qui provisionne et gère
l'infrastructure partagée de Google Cloud.
Ce guide se concentre sur les services cloud utilisés par Hermes et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à chaque application Cloud Run — identité du service, ingress et équilibrage de charge, mise à l'échelle et concurrence, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide de la fondation App_CloudRun plutôt que de les répéter ici.
Coût d'Hermes sur RAD et comparaison
L'exécution d'Hermes sur Cloud Run dans votre propre projet Google Cloud coûte environ 123,06 $/mois en frais Google Cloud, en plus d'un frais de module RAD unique de 110 crédits facturé une fois au moment du déploiement. L'Agent Hermes est un agent d'IA personnel auto-hébergé avec une mémoire persistante, ce déploiement comprend donc à la fois une base de données pour cette mémoire et un petit serveur de fichiers pour son état de fonctionnement — il n'existe pas de version commerciale hébergée de ce projet exact pour comparaison. Dans un projet géré par RAD, les frais de module tombent à 99 crédits (10 % de moins) et le coût d'exécution est mesuré à l'heure en crédits au lieu d'être facturé directement par Google — voir Mettre en pause gratuitement ci-dessous pour le seul avantage géré par RAD qu'un VPS auto-hébergé ne peut égaler — ou voir le guide GKE si vous préférez l'exécuter sur Kubernetes.
Ce que vous payez sur RAD
| Votre propre projet | Projet géré par RAD | |
|---|---|---|
| Frais de module (unique) | 110 crédits | 99 crédits (10 % de moins) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients sont l'exception : ils sont toujours facturés pour le temps de build à la minute | Idem |
| Coût d'exécution Google Cloud | 123,06 $/mois, facturé par Google au prix catalogue | ~88 crédits/jour, mesuré au prix catalogue plus la marge de RAD |
Votre premier déploiement réussi sur RAD est exempt de frais de module, quel que soit le montant : une fois par compte, pour un module que vous déployez et payez vous-même (dans une solution, les frais d'une application : la première à réussir ; jamais une session de lab ou un projet client).
Coût d'exécution par défaut dans votre propre projet
| Ressource | US$/mois (prix catalogue Google, us-central1) |
|---|---|
| Cloud Run, 1x vCPU / 2 GiB (alwaysOn) | 52,60 $ |
| Cloud SQL pour PostgreSQL, 1 vCPU / 3,75 Go, zonal, 10 Go SSD | 51,02 $ |
| Serveur de fichiers NFS/cache (petite VM) | 13,43 $ |
| Cloud NAT et réseau | 5,00 $ |
| Cloud Storage (modules complémentaires, sauvegardes) | 1,00 $ |
| Total | 123,06 $ |
Comparaison
- Une comparaison auto-gérée : Hetzner CPX22 (2 vCPU/4 Go) coûte environ 24 $/mois, un Droplet DigitalOcean 2 vCPU/4 Go coûte le même prix de 24 $/mois, et un GCP Compute Engine e2-standard-2 (2 vCPU/8 Go) coûte environ 49 $/mois — sur l'empreinte 1 vCPU/2 GiB de la variante Cloud Run, une classe plus petite ferait également l'affaire ; les 2 vCPU de la variante GKE correspondent plus étroitement aux boîtiers cités.
- Ce qu'un VPS nu ne vous offre pas ici est plus important que d'habitude pour un agent qui conserve la mémoire entre les sessions : sauvegardes Postgres automatiques, rotation des secrets pour ses clés API et surveillance si le processus se bloque — tout est couvert par la pile gérée de RAD.
- Les coûts d'exécution de votre propre API LLM ne sont pas affectés dans les deux cas — cette comparaison ne concerne que l'infrastructure d'hébergement sur laquelle Hermes s'exécute, pas les appels de modèle qu'il effectue.
Mettre en pause gratuitement : supprimer un projet géré par RAD, le restaurer quand vous en avez besoin
C'est l'avantage principal d'un projet géré par RAD, et cela ne coûte rien pendant la pause. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer purement et simplement le projet — la suppression logicielle récupérable de 30 jours de Google. Contrairement à la suppression d'un module, cela ne démantèle pas Cloud SQL, aucune VM, ni la ressource de calcul une par une : l'ensemble du projet s'arrête simplement, et rien n'est facturé pendant qu'il attend, car la facturation est déjà déliée.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, seront utilisables après sa restauration, de sorte que la restauration ne peut pas être considérée comme un moyen de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
La restauration, dans les 30 jours et uniquement par le propriétaire du projet, demande à Google de récupérer le projet et de rattacher son compte de facturation, puis vous demande d'exécuter « Mettre à jour » sur chaque déploiement pour confirmer que tout est revenu. Comme rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes — c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit.
Ce qu'il faut : vous devez être propriétaire du projet (pas un projet dont RAD gère uniquement la facturation), vous devez le restaurer vous-même dans les 30 jours — après cela, Google le supprime définitivement — et la restauration est admise comme la création d'un nouveau projet, donc votre solde de crédits achetés doit toujours dépasser le seuil du palier (100 crédits pour le palier sandbox qui convient à la plupart des utilisations d'étude/démo). Google indique que la plupart des services sont à nouveau pleinement fonctionnels dans les 36 heures suivant une restauration.
Un véritable manque : les sauvegardes nocturnes sont écrites dans un bucket à l'intérieur du projet, et ce bucket a la suppression logicielle de Cloud Storage explicitement désactivée, il est donc très probable qu'il disparaisse dès que vous supprimez le projet — même si le projet lui-même est récupérable pendant 30 jours. Si vous avez personnalisé Hermes et que vous souhaitez conserver ce travail, copiez une sauvegarde (vers Google Drive, ou un bucket en dehors du projet) avant de supprimer. Pour une installation par défaut sans rien d'irremplaçable, cela n'a pas d'importance.
Payer uniquement pendant l'utilisation, l'autre méthode : supprimer et redéployer
Dans votre propre projet, ou une fois que 30 jours se sont écoulés sur un projet géré par RAD, il n'y a pas de pause gratuite — la suppression supprime les ressources définitivement, et ramener Hermes signifie le redéployer à partir de zéro. Cela coûte 110 crédits (les frais de module ; les builds sont inclus).
La suppression ne permet d'économiser de l'argent que si Hermes resterait inutilisé assez longtemps pour que le coût de redéploiement soit inférieur à son propre coût d'exécution — pour Hermes, c'est environ 3 jours ou plus. La majeure partie de ce coût d'exécution est généralement la base de données (et, lorsque ce module en utilise un, la VM du serveur de fichiers partagé ou le cluster GKE) — ceux-ci ne s'arrêtent que lorsque rien d'autre dans le projet ne les utilise, donc la suppression de cette application pendant que quelque chose d'autre partage le projet n'économise que sa propre part de calcul.
Conservez d'abord les données : les sauvegardes nocturnes vont dans un bucket à l'intérieur du déploiement et sont supprimées avec lui, donc copiez la dernière sauvegarde avant de supprimer si vous voulez la conserver.
Sessions de lab et environnements gérés
Sessions de lab, pour la formation : un formateur anime une session pour une classe. Chaque participant obtient l'application dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite d'une allocation définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés sont reversés au formateur.
Environnements gérés, pour les sociétés de conseil : un partenaire exécute l'application pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille est faible, la facturation est suspendue et les données sont conservées, de sorte que personne ne reçoit de frais inattendus. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue de l'API Google Cloud Billing Catalog ; radmodules.dev/pricing pour les propres frais de RAD et les estimations de crédits quotidiens ; documentation de Google sur la suppression/restauration de projets pour les affirmations de pause/restauration.
1. Vue d'ensemble
Hermes s'exécute comme un conteneur de passerelle unique toujours actif sur Cloud Run v2. Le déploiement relie un ensemble délibérément restreint de services Google Cloud :
| Capacité | Service Google Cloud | Notes |
|---|---|---|
| Calcul | Cloud Run v2 | Conteneur de passerelle, 1 vCPU / 2 GiB par défaut, min=1 / max=1, CPU toujours alloué |
| État de l'agent | NFS auto-géré (Services_GCP) | Monté à /opt/data — configuration SQLite, sessions, compétences, mémoires. Pas de Cloud SQL |
| Secrets | Secret Manager | ANTHROPIC_API_KEY, API_SERVER_KEY auto-généré et mot de passe du tableau de bord, OPENAI_API_KEY / TELEGRAM_BOT_TOKEN optionnels |
| Image de conteneur | Artifact Registry (miroir) | Image pré-construite officielle mise en miroir ; pas de build personnalisé, pas d'étape Cloud Build |
| Réseau | VPC + URL run.app | Sortie VPC sans serveur pour le montage NFS ; URL publique pour le serveur API |
| Base de données / cache | — | Pas de Cloud SQL, pas de Redis — Hermes est entièrement SQLite-sur-NFS |
Valeurs par défaut judicieuses à connaître d'emblée :
- Tout l'état de l'agent se trouve à
/opt/data, et ce chemin est fixe à l'intérieur de l'image. Le NFS de la plateforme partagée est monté directement par-dessus (enable_nfs = true,nfs_mount_path = "/opt/data", tous deux par défaut et appliqués par une validation au moment de la planification). Sans le montage, chaque démarrage à froid ou redéploiement efface silencieusement l'identité accumulée de l'agent. max_instance_countest validé à 1. L'état d'Hermes est SQLite, qui a un modèle à un seul rédacteur — une deuxième instance concurrente corrompt la base de données.cpu_always_allocated = trueetmin_instance_count = 1. Les connecteurs de messagerie (Telegram/Discord/Slack) effectuent un long-polling sortant ; avec la mise à l'échelle à zéro, l'agent est endormi et manque des messages, et la limitation du CPU basée sur les requêtes bloque les boucles de polling et les tours d'agent asynchrones. Attendez-vous à une instance toujours chaude.- Le serveur API compatible OpenAI écoute sur le port 8642 et nécessite le
API_SERVER_KEYauto-généré comme jeton de porteur. - La sonde de démarrage est par défaut une écoute de port TCP ; la sonde de vivacité est désactivée. Le serveur API nécessite une authentification, donc une sonde HTTP contre lui renverrait 401 et bloquerait le déploiement — et Cloud Run ne prend pas en charge les sondes de vivacité TCP (TCP est uniquement pour le démarrage). La sonde de démarrage TCP plus la gestion d'instance propre à Cloud Run couvrent la santé ; activez une sonde de vivacité avec un chemin HTTP seulement après avoir vérifié que le point de terminaison n'est pas authentifié.
- Le tableau de bord web (port 9119) n'est pas routé sur Cloud Run — Cloud
Run expose un seul port d'entrée. Utilisez la variante GKE avec
kubectl port-forwardsi vous avez besoin de l'interface utilisateur du tableau de bord. - Au moins une clé de fournisseur de modèle est requise lors du déploiement
initial (
anthropic_api_key, ouenable_openai+openai_api_key) ; une vérification au moment de la planification avertit lorsqu'aucune n'est fournie. - Pas de jobs d'initialisation, pas de bootstrap de base de données — le
premier démarrage initialise uniquement
/opt/datasur le partage NFS.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que PROJECT et REGION sont définis. Les noms de
services et de ressources sont rapportés dans les Sorties du
déploiement.
A. Cloud Run — le service de passerelle Hermes
Hermes s'exécute comme un service Cloud Run v2 à instance unique. Chaque déploiement crée une révision immuable ; comme l'application est basée sur NFS/SQLite et limitée à une seule instance, il n'y a pas d'autoscaling à observer — les signaux intéressants sont la santé de la révision et la disponibilité de l'instance.
- Console : Cloud Run → sélectionnez le service pour les révisions, le trafic, les logs et les métriques.
- CLI :
gcloud run services list --project "$PROJECT" --region "$REGION"
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION"
gcloud run revisions list --service <service-name> --project "$PROJECT" --region "$REGION"
Voir App_CloudRun pour la mise à l'échelle, les modes de facturation, l'environnement d'exécution et la répartition du trafic.
B. Stockage partagé NFS — l'identité de l'agent
L'état complet de l'agent (base de données de configuration SQLite, clés API,
sessions, compétences apprises, mémoires) réside sur le serveur NFS partagé
auto-géré provisionné par Services_GCP (create_network_filesystem = true), monté à
/opt/data dans le conteneur via l'environnement d'exécution gen2. La VM NFS
doit être RUNNING avant que ce module ne soit déployé — la découverte la
trouve par étiquette.
- Console : Compute Engine → Instances de VM (la VM du serveur NFS) ; Cloud Run → service → onglet Volumes.
- CLI :
gcloud compute instances list --project "$PROJECT" \
  --filter="name~nfs" --format="table(name,zone,status)"
# Confirm the NFS volume mount on the running revision:
gcloud run services describe <service-name> --region "$REGION" \
  --format="yaml(spec.template.spec.volumes)"
Le partage et ses données sont détenus par Services_GCP — la destruction du déploiement Hermes ne supprime pas l'état de l'agent sur l'exportation NFS.
C. Secret Manager
Cinq secrets peuvent exister par déploiement, tous injectés comme variables
d'environnement : ANTHROPIC_API_KEY (fourni par l'opérateur), API_SERVER_KEY
(hexadécimal de 64 caractères auto-généré — le jeton de porteur de l'API de
passerelle), HERMES_DASHBOARD_BASIC_AUTH_PASSWORD (auto-généré), et
optionnellement OPENAI_API_KEY et TELEGRAM_BOT_TOKEN.
- Console : Sécurité → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT" --filter="name~hermes"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
Les variables d'identification vides lors d'un déploiement de mise à jour
conservent la version latest stockée — les clés n'ont jamais besoin d'être
saisies à nouveau. Voir App_CloudRun pour les détails
d'injection et de rotation.
D. Artifact Registry — l'image mise en miroir
L'image officielle nousresearch/hermes-agent:<version> est mise en miroir dans
Artifact Registry avant le déploiement (enable_image_mirroring = true) afin que le
service ne tire jamais depuis Docker Hub à l'exécution. Il n'y a pas d'étape
Cloud Build — il s'agit d'un module pré-construit.
- Console : Artifact Registry → Dépôts.
- CLI :
gcloud artifacts repositories list --project "$PROJECT" --location "$REGION"
gcloud artifacts docker images list \
  "$REGION-docker.pkg.dev/$PROJECT/<repo>" --filter="package~hermes"
E. Réseau et ingress
Le serveur API est accessible par défaut à l'URL run.app du service
(ingress_settings = "all"), protégé par le jeton de porteur API_SERVER_KEY plutôt
que par des contrôles réseau. La sortie VPC (PRIVATE_RANGES_ONLY) transporte le
trafic NFS ; le long-polling du connecteur sort directement vers l'internet
public.
- Console : Cloud Run (URL du service) ; Réseau VPC → Réseaux VPC.
- CLI :
gcloud run services describe <service-name> --region "$REGION" --format='value(status.url)'
gcloud compute networks list --project "$PROJECT"
Voir App_CloudRun pour Cloud Armor, les domaines personnalisés et IAP.
F. Cloud Logging et Monitoring
Les logs des conteneurs sont envoyés à Cloud Logging ; les métriques Cloud Run à Cloud Monitoring. Le test de disponibilité est désactivé par défaut — le serveur API nécessite une authentification, donc un test de disponibilité non authentifié échouerait toujours.
- Console : Logging → Explorateur de logs ; Monitoring → Tableaux de bord / Alertes.
- CLI :
gcloud run services logs read <service-name> --project "$PROJECT" --region "$REGION" --limit 50
3. Comportement de l'application Hermes
- Initialisation du répertoire de données au premier démarrage. L'ENTRYPOINT
de l'image est
/initde s6-overlay, qui démarre en tant que root,chownle volume/opt/data(le nouveau répertoire NFS) à l'utilisateur non-roothermes, puis abandonne les privilèges et démarre la passerelle (container_args = ["gateway", "run"]— la CMD par défaut de l'image est la CLI interactive, donc la passerelle doit être démarrée explicitement). - Pas de job d'initialisation de base de données. Hermes crée sa propre
base de données de configuration SQLite sous
/opt/datalors du premier démarrage ; il n'y a rien à amorcer etinitialization_jobsest vide. - L'accès à l'API nécessite le
API_SERVER_KEY. Le point de terminaison compatible OpenAI sur le port 8642 s'authentifie avec un jeton de porteur :KEY=$(gcloud secrets versions access latest --secret=<api-server-key-secret> --project "$PROJECT")
curl -s -H "Authorization: Bearer $KEY" "$(gcloud run services describe <service-name> \
--region "$REGION" --format='value(status.url)')/v1/models" - Premier démarrage du tableau de bord. Le tableau de bord web intégré
(gestion des clés API, configuration du profil) s'exécute sur le port 9119
derrière une authentification basique (
dashboard_username/ le mot de passe auto-généré dans Secret Manager). Cloud Run ne route que le port du conteneur (8642), donc le tableau de bord est inaccessible sur cette variante — utilisez lekubectl port-forwardde la variante GKE, ou configurez l'agent via sa propre interface de chat/API. - Configuration du connecteur (Telegram). Définissez
enable_telegram = trueet fournisseztelegram_bot_token(depuis @BotFather). Le connecteur Telegram d'Hermes effectue un long-polling sortant — aucun webhook, routeur ou URL de rappel public n'est nécessaire. Une validation au moment de la planification rejetteenable_telegram = trueavec un jeton vide. Les autres connecteurs (Discord, Slack, WhatsApp, Signal) sont configurés via la carte opérateurenvironment_variables. - Mises à jour de version. Changez
application_versionet redéployez — le miroir recopie l'étiquette si le digest a changé et une nouvelle révision est déployée. L'état de l'agent est intact (il réside sur NFS, pas dans l'image).
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres spécifiques ou notables pour Hermes sont listés ; toute autre entrée est héritée de App_CloudRun avec son comportement standard.
Groupe 1 — Projet, identité et identifiants
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (requis) | Projet Google Cloud cible. |
region | us-central1 | Région pour le service et les ressources régionales. |
anthropic_api_key | "" | Clé principale du fournisseur de modèle, injectée comme ANTHROPIC_API_KEY. Requise lors du déploiement initial (ou utilisez OpenAI) ; omettre lors des mises à jour pour conserver la version stockée. |
api_server_key | "" (auto) | Jeton de porteur pour le serveur API compatible OpenAI. Hexadécimal de 64 caractères auto-généré lorsqu'il est vide. |
enable_openai / openai_api_key | false / "" | Fournisseur secondaire optionnel, injecté comme OPENAI_API_KEY. |
enable_dashboard | true | Exécute le tableau de bord du port 9119 en cours de processus (non routé sur Cloud Run). |
dashboard_username / dashboard_password | admin / "" (auto) | Authentification basique du tableau de bord ; mot de passe auto-généré dans Secret Manager. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | hermes | Nom de base des ressources. Ne pas modifier après le premier déploiement. |
application_version | latest | Étiquette d'image nousresearch/hermes-agent ; épingler à une étiquette de version en production. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
cpu_limit / memory_limit | 1000m / 2Gi | Ressources par instance ; l'agent exécute les appels de modèle à distance, donc la mémoire reste modérée. |
min_instance_count | 1 | Maintenir à 1 — les connecteurs effectuent un long-polling sortant ; la mise à l'échelle à zéro manque des messages. |
max_instance_count | 1 | Validé à 1 — SQLite à un seul rédacteur sur le NFS partagé. |
container_port | 8642 | Port du serveur API compatible OpenAI de la passerelle. |
cpu_always_allocated | true | Requis — la limitation du CPU interrompt le long-polling du connecteur et les tours d'agent asynchrones. Ne pas définir false. |
execution_environment | gen2 | Requis pour le montage du volume NFS. |
timeout_seconds | 3600 | Les sessions d'agent peuvent être de longue durée. |
enable_cloudsql_volume | false | Hermes n'a pas de base de données. |
container_image_source | prebuilt | Déploie l'image officielle sans étape de build. |
enable_image_mirroring | true | Mettre en miroir dans Artifact Registry pour éviter les limites de débit de Docker Hub. |
Groupe 5 — Accès et réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
ingress_settings | all | URL publique run.app ; le serveur API applique sa propre authentification par jeton de porteur. |
vpc_egress_setting | PRIVATE_RANGES_ONLY | Route le trafic NFS via le VPC ; le polling du connecteur sort directement. |
enable_iap | false | IAP bloquerait également les clients API programmatiques qui ne transportent que le jeton de porteur. |
Groupe 6 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Configuration supplémentaire ; les variables gérées par le module (API_SERVER_*, HERMES_DASHBOARD*) ont la priorité. À utiliser pour les identifiants de connecteur Discord/Slack/WhatsApp/Signal ou les points de terminaison de fournisseur (par exemple, OpenRouter). |
secret_environment_variables | {} | Mappage de la variable d'environnement → nom du secret Secret Manager existant. |
Groupe 11 — Stockage et NFS
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_nfs | true | Requis — validé. L'identité complète de l'agent réside sous /opt/data. |
nfs_mount_path | /opt/data | Répertoire de données fixe de l'image ; le partage NFS est monté directement par-dessus. |
gcs_volumes | [] | Montages GCSFuse auxiliaires uniquement — ne jamais en pointer un vers /opt/data (SQLite est dangereux sur GCSFuse). |
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe | TCP, 20s de délai, 24 tentatives | Écoute de port TCP — sûre quelle que soit l'authentification du serveur API ; marge pour le montage NFS et l'initialisation au premier démarrage. |
liveness_probe | désactivé | Cloud Run ne prend pas en charge les sondes de vivacité TCP (TCP est uniquement pour le démarrage), et le comportement /health d'Hermes derrière l'authentification du serveur API n'est pas vérifié. Activer avec un chemin HTTP seulement après avoir vérifié que le point de terminaison n'est pas authentifié. |
uptime_check_config | désactivé | Un test de disponibilité non authentifié échouerait toujours contre le serveur API authentifié. |
Groupe 15 — Connecteurs Hermes
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_telegram | false | Provisionne le secret du jeton du bot Telegram et injecte TELEGRAM_BOT_TOKEN. |
telegram_bot_token | "" | Jeton du bot de @BotFather ; requis (validé) lorsque enable_telegram = true. |
Miroirs de convention inertes : les variables de base de données (groupe 12),
Redis, SQL personnalisé et additional_services/additional_containers sont déclarées
pour la parité de convention mais non transmises — Hermes n'a pas de base de
données ni de Redis.
5. Sorties
Retournées lors d'un déploiement réussi — le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du service Cloud Run. |
api_url | URL run.app par défaut du serveur API de la passerelle. |
service_location | Région dans laquelle le service s'exécute. |
stage_services | Détails du service spécifiques à l'étape (Cloud Deploy). |
storage_buckets | Buckets Cloud Storage créés (aucun par défaut). |
network_name / network_exists / regions | Réseau VPC, présence, régions. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels / uptime_check_names | État de la surveillance, canaux, tests de disponibilité. |
initialization_jobs | Noms des jobs de configuration (vide — pas de base de données à amorcer). |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants de projet. |
cicd_enabled / github_repository_url / github_repository_owner / github_repository_name / cicd_configuration | État et détails CI/CD. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Registre et déclencheur de build. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
Validation au moment de la planification. Le
validation.tfde ce module et le moteur de la fondation App_CloudRun valident les valeurs et les combinaisons au moment de la planification —max_instance_count > 1,enable_nfs = false, un connecteur Telegram sans son jeton, ou OpenAI activé sans clé échouent tous la planification avec une erreur claire et nommée avant qu'aucune ressource ne soit créée.
| Paramètre | Valeur judicieuse | Risque | Conséquence si incorrect |
|---|---|---|---|
max_instance_count | 1 (validé) | Critique | Une deuxième instance concurrente écrit dans la même base de données SQLite sur NFS — la violation du modèle à un seul rédacteur corrompt l'état complet de l'agent. |
enable_nfs | true (validé) | Critique | Sans le montage NFS, /opt/data est un disque éphémère — chaque démarrage à froid / redéploiement efface silencieusement l'identité de l'agent (configuration, sessions, compétences, mémoires). |
gcs_volumes à /opt/data | jamais | Critique | GCSFuse manque de verrouillage POSIX et de renommages atomiques ; SQLite sur GCSFuse se corrompt. Gardez l'état sur NFS. |
min_instance_count | 1 | Élevé | Avec 0, les connecteurs sont en veille entre les requêtes — les messages Telegram/Discord sont manqués jusqu'à ce qu'un appel HTTP entrant réveille l'instance. |
anthropic_api_key (ou paire OpenAI) | défini au premier déploiement | Élevé | Sans aucune clé de fournisseur, l'agent ne peut pas exécuter un seul tour, et le secret Anthropic vide échoue le déploiement Cloud Run ("Secret was not found"). |
cpu_always_allocated | true | Élevé | La facturation basée sur les requêtes limite le CPU à ~0 entre les requêtes, bloquant le long-polling du connecteur et les tours d'agent asynchrones. |
startup_probe | TCP (par défaut) | Moyen | Une sonde de démarrage HTTP contre le serveur API authentifié renvoie 401/403 indéfiniment — la révision ne devient jamais prête et le déploiement se bloque. |
liveness_probe | désactivé (par défaut) | Moyen | Les sondes s'exécutent sans authentification ; l'activation d'une sonde de vivacité HTTP nécessite de vérifier d'abord que le point de terminaison n'est pas authentifié — un point de terminaison 401/403 tuerait les instances saines. Cloud Run n'a pas d'option de vivacité TCP. |
application_version | épingler une étiquette de version | Moyen | latest se résout à nouveau par exécution de miroir ; le comportement peut changer sous vous lors du redéploiement. |
enable_telegram sans jeton | bloqué | Faible | La validation au moment de la planification le rejette ; le connecteur ne peut pas démarrer sans le jeton du bot. |
Pour le comportement de la fondation référencé tout au long — identité du service, modes de mise à l'échelle et de facturation, ingress et équilibrage de charge, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir d'images — voir App_CloudRun. La configuration d'application spécifique à Hermes partagée avec la variante GKE est décrite dans Hermes_Common.
Guides associés
- Lab pratique : Agent Hermes sur Cloud Run — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Agent Hermes sur GKE Autopilot — la même application sur Kubernetes, lorsque vous avez besoin de l'autre cible de déploiement.
- Hermes Common — Configuration d'application partagée — la configuration partagée par les deux cibles de déploiement.
- Déployé aux côtés de LiteLLM sur Google Cloud Run, OpenClaw sur Google Cloud Run, n8n sur Google Cloud Run dans la solution AI Agent Workspace.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.