Ollama sur Google Cloud Run
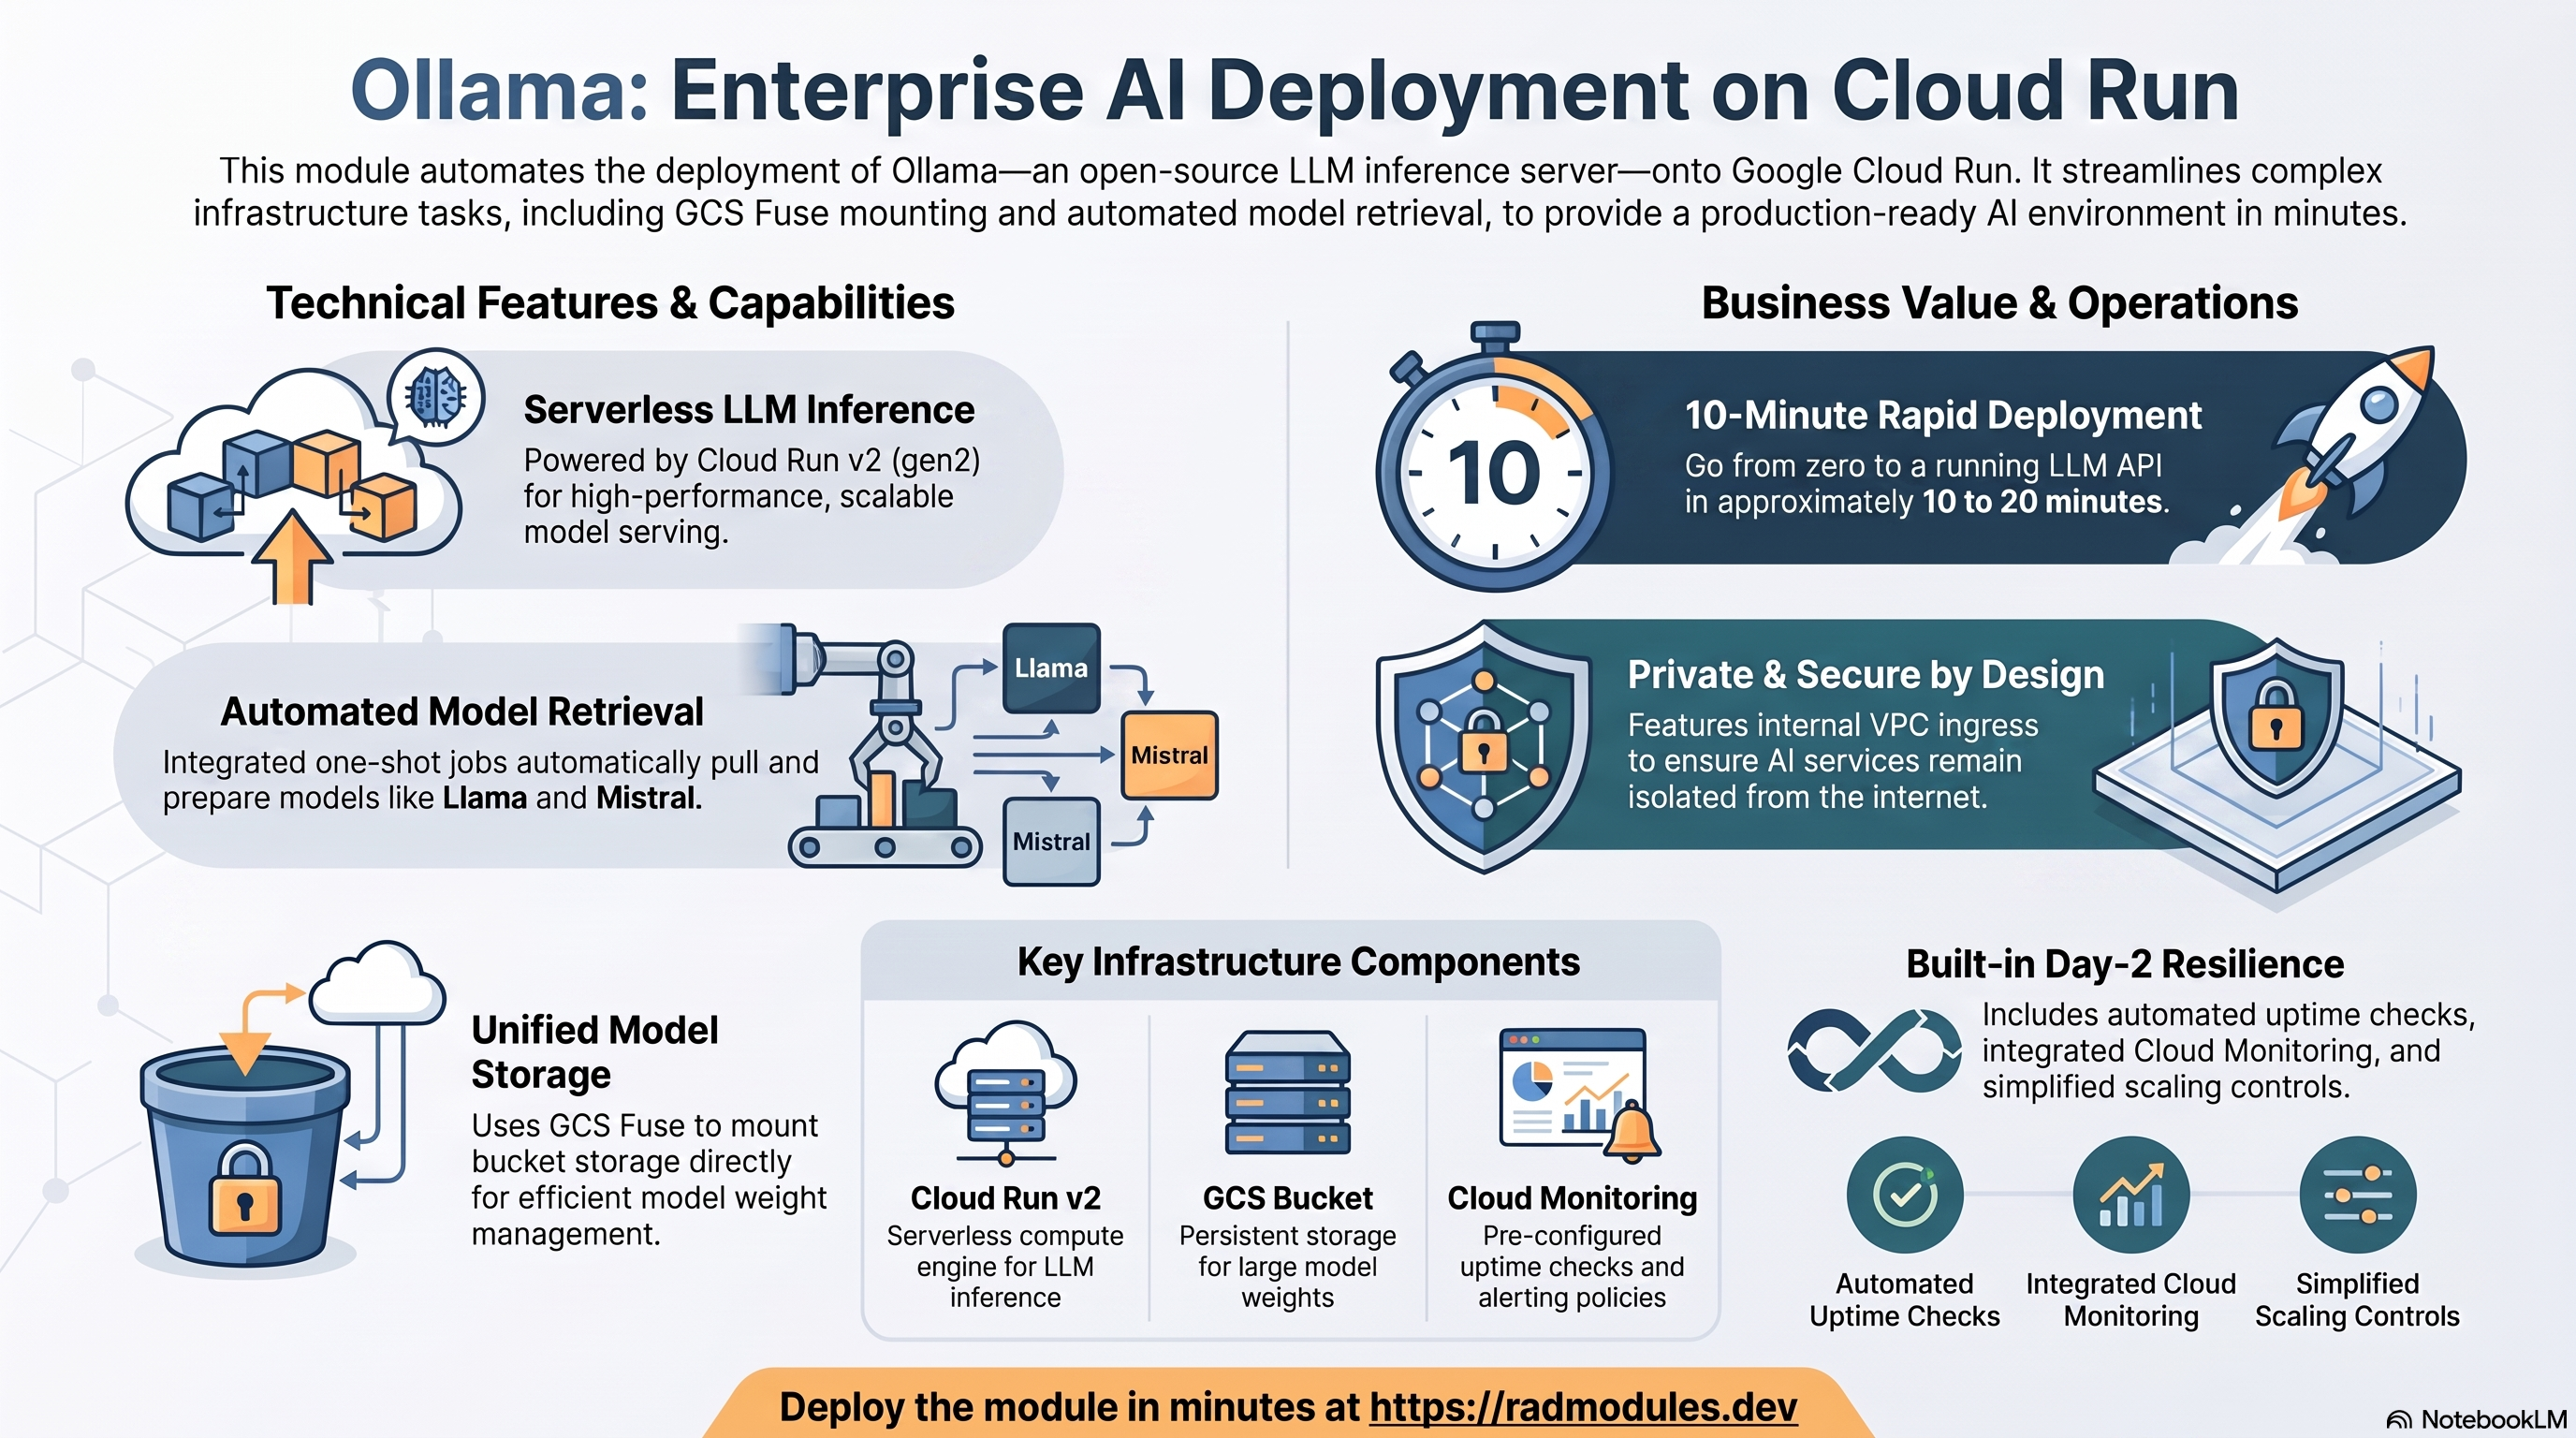
Ollama est un serveur d'inférence de LLM open source qui sert de grands modèles de langage — Llama, Mistral, Gemma, Phi et d'autres — via une API REST. Ce module déploie Ollama sur Cloud Run v2 (CPU uniquement, serverless) au-dessus du socle App_CloudRun, qui provisionne et gère l'infrastructure Google Cloud partagée.
Ce guide se concentre sur les services cloud qu'utilise Ollama et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à toute application Cloud Run — identité du service, entrée et équilibrage de charge, mise à l'échelle et concurrence, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — consultez le guide du socle App_CloudRun plutôt que de les répéter ici.
1. Vue d'ensemble
Ollama s'exécute comme un serveur d'inférence conteneurisé sur Cloud Run v2. Le déploiement assemble un ensemble ciblé de services Google Cloud :
| Fonctionnalité | Service Google Cloud | Remarques |
|---|---|---|
| Calcul | Cloud Run v2 (gen2) | Service Ollama, 4 vCPU / 8 GiB par défaut (modèles 3B), autoscaling basé sur les requêtes |
| Stockage des modèles | Cloud Storage + GCS Fuse | Bucket des modèles monté sur /mnt/gcs ; les poids persistent à travers les redémarrages de conteneur et les nouvelles révisions |
| Secrets | Secret Manager | Aucun secret géré par l'application — Ollama ne requiert aucun identifiant |
| Entrée | URL Cloud Run (interne au VPC) | Entrée internal par défaut ; seuls les services du même VPC peuvent atteindre l'API |
Valeurs par défaut judicieuses à connaître d'emblée :
- Pas de base de données, pas de Redis. Ollama est sans état au-delà de son cache de modèles adossé à GCS. Ni Cloud SQL ni Redis ne sont provisionnés.
- GCS Fuse est la couche de persistance. Les poids des modèles sont stockés dans un bucket GCS dédié
et montés dans le conteneur sur
/mnt/gcsvia GCS Fuse. Au redémarrage, le conteneur charge les modèles depuis GCS au lieu de les retélécharger. ingress_settings = "internal"par défaut. Ollama est conçu comme un point de terminaison d'inférence partagé, interne au VPC, appelé par d'autres applications (Flowise, N8N, RAGFlow, Django). Définiringress_settings = "all"expose l'API non authentifiée à l'internet public — associez-la toujours à IAP dans ce cas.execution_environment = "gen2"est obligatoire pour la prise en charge de GCS Fuse et ne peut pas être rétrogradé en gen1.- Téléchargement automatique du modèle. Lorsque
default_modelest défini et qu'aucuninitialization_jobspersonnalisé n'est fourni, un Cloud Run Job nommémodel-pullest créé lors du premier déploiement et stocke le modèle dans le bucket GCS. - Trois variables d'environnement sont toujours injectées :
OLLAMA_MODELS,OLLAMA_HOSTetOLLAMA_KEEP_ALIVE. Ne remplacez pasOLLAMA_MODELSniOLLAMA_HOSTdansenvironment_variables.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que PROJECT et REGION sont définis. Les noms des services et des ressources sont indiqués
dans les sorties du déploiement.
A. Cloud Run — le service Ollama
Ollama s'exécute comme un service Cloud Run v2 (gen2) qui s'adapte automatiquement à la charge de requêtes entre le nombre minimal et le nombre maximal d'instances. Chaque déploiement crée une révision immuable ; le trafic peut être réparti entre les révisions pour des déploiements progressifs sûrs.
- Console : Cloud Run → sélectionnez le service pour voir les révisions, le trafic, les journaux et les métriques.
- CLI :
gcloud run services list --project "$PROJECT" --region "$REGION"
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION"
gcloud run revisions list --service <service-name> --project "$PROJECT" --region "$REGION"
# Send a test inference request from within the VPC:
curl -s "$OLLAMA_API_URL/api/tags" | jq '.models[].name'
Consultez App_CloudRun pour la mise à l'échelle, la concurrence, l'environnement d'exécution et la répartition du trafic.
B. Cloud Storage — persistance des poids des modèles
Les poids des modèles Ollama sont stockés dans un bucket GCS dédié (nommé
<resource_prefix>-models) et montés dans le conteneur via GCS Fuse sur /mnt/gcs.
La variable d'environnement OLLAMA_MODELS vaut /mnt/gcs/ollama/models, de sorte qu'Ollama
y découvre et y met en cache les modèles.
- Console : Cloud Storage → Buckets → sélectionnez le bucket des modèles pour parcourir les fichiers de modèles téléchargés.
- CLI :
# Bucket name is in the Outputs (models_bucket)
gcloud storage ls gs://<models-bucket>/ollama/models/
gcloud storage buckets describe gs://<models-bucket> --project "$PROJECT"
Le nom du bucket est indiqué dans la sortie models_bucket. Consultez
App_CloudRun pour GCS Fuse, les options CMEK et les règles de cycle de vie.
C. Secret Manager
Ollama ne requiert aucun identifiant géré par l'application — il n'y a ni mot de passe administrateur ni
mot de passe de base de données. Secret Manager reste disponible pour tout secret personnalisé que vous injectez via
secret_environment_variables.
- Console : Security → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
Consultez App_CloudRun pour les détails d'injection et de rotation.
D. Réseau et entrée
Par défaut, le service n'est accessible que depuis le même VPC (ingress_settings = "internal"). Tout service Cloud Run, pod GKE ou VM Compute Engine du VPC peut appeler
l'API Ollama à l'URL du service sur le port 11434. Un équilibreur de charge HTTPS externe avec un
domaine personnalisé, Cloud CDN et Cloud Armor peut être ajouté pour un accès externe.
- Console : Cloud Run (URL du service) ; Network services → Load balancing.
- CLI :
gcloud run services describe <service-name> \
  --region "$REGION" --format='value(status.url)'
gcloud compute addresses list --project "$PROJECT"
Consultez App_CloudRun.
E. Cloud Logging et Monitoring
Les journaux des conteneurs sont envoyés à Cloud Logging ; les métriques Cloud Run à Cloud Monitoring, avec des tests de disponibilité et des règles d'alerte facultatifs.
- Console : Logging → Logs Explorer ; Monitoring → Dashboards / Alerting.
- CLI :
gcloud run services logs read <service-name> \
  --project "$PROJECT" --region "$REGION" --limit 50
3. Comportement de l'application Ollama
-
Aucune initialisation de base de données au premier déploiement. Ollama n'a pas de base de données. Il n'y a ni job
db-initni instance Cloud SQL. -
Téléchargement du modèle au premier déploiement. Lorsque
default_modelest défini et queinitialization_jobsest vide, un Cloud Run Job nommémodel-pulls'exécute une fois. Il démarre un serveur Ollama local en arrière-plan, télécharge le modèle indiqué, le stocke dans le bucket GCS, puis s'arrête. Le job monte le volume GCSollama-modelsafin que les poids persistent. Le délai d'expiration est contrôlé parmodel_pull_timeout_seconds(3600 secondes par défaut) ; les grands modèles (7B et plus) peuvent prendre 20–30 minutes lors du premier téléchargement.Inspectez le job et ses exécutions :
gcloud run jobs list --project "$PROJECT" --region "$REGION"
gcloud run jobs executions list --job <model-pull-job-name> \
--project "$PROJECT" --region "$REGION" -
Chargement du modèle au démarrage à froid. À chaque démarrage d'instance, Ollama charge les poids du modèle depuis GCS Fuse. Cela prend généralement 30–120 secondes selon la taille du modèle. La sonde de démarrage utilise un délai initial de 30 s avec 20 tentatives en échec (environ 5 minutes) pour en tenir compte.
OLLAMA_KEEP_ALIVEvaut"24h"afin que les modèles chargés restent en mémoire entre les requêtes. Remplacez-la viaenvironment_variables. -
Variables injectées automatiquement.
OLLAMA_MODELS(/mnt/gcs/ollama/models),OLLAMA_HOST(0.0.0.0:11434) etOLLAMA_KEEP_ALIVE(24h) sont injectées automatiquement. Ne remplacez pas les deux premières ; la troisième peut être remplacée. -
Point de terminaison de santé. Le chemin racine d'Ollama (
/) répond"Ollama is running"une fois le serveur prêt. Les sondes de démarrage et de vivacité ciblent toutes deux ce chemin. -
Réglages supplémentaires. Utilisez
environment_variablespour définirOLLAMA_NUM_PARALLEL(par défaut1, à augmenter pour des appelants simultanés),OLLAMA_ORIGINS(restreindre le CORS) et d'autres variables d'environnement Ollama.
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres propres à Ollama ou notables pour lui sont listés ; toutes les autres entrées sont héritées de App_CloudRun avec leur comportement standard.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Projet Google Cloud cible. |
region | us-central1 | Région du service et des ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques par environnement. |
support_users | [] | Adresses e-mail recevant l'accès au projet et les alertes de surveillance. |
resource_labels | {} | Libellés appliqués à toutes les ressources. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | ollama | Nom de base des ressources. Ne le modifiez pas après le premier déploiement. |
application_display_name | Ollama LLM Server | Nom convivial affiché dans la console. |
description | (définie) | Description du service. |
application_version | latest | Tag de l'image Ollama ; épinglez une version précise (par exemple 0.3.12) en production. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définissez false pour provisionner le stockage et l'IAM sans déployer le service. |
cpu_limit | 4000m | CPU par instance. Modèles 3B : "4000m" ; modèles 7B : "8000m". Le maximum de Cloud Run est "8". |
memory_limit | 8Gi | Mémoire par instance. Modèles 3B : "8Gi" ; modèles 7B : "16Gi". |
min_instance_count | 1 | Nombre minimal d'instances. Conservez ≥ 1 pour éviter 60–120 s de latence de chargement du modèle au démarrage à froid. |
max_instance_count | 1 | Nombre maximal d'instances. L'inférence de LLM sature le CPU ; plusieurs instances augmentent le coût. |
execution_environment | gen2 | Doit rester "gen2" — requis pour les montages de volumes GCS Fuse. |
timeout_seconds | 3600 | Durée maximale d'une requête. L'inférence sur de grands modèles peut être lente ; 3600 s est le maximum de Cloud Run. |
container_protocol | http1 | Version du protocole HTTP. |
traffic_split | [] | Répartition du trafic entre révisions pour les déploiements canary. La somme de toutes les entrées doit faire 100. |
enable_image_mirroring | true | Duplique ollama/ollama dans Artifact Registry pour éviter les limites de débit de Docker Hub. |
Groupe 5 — Accès et réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
ingress_settings | internal | Conservez "internal" pour un accès limité au VPC. "all" expose l'API non authentifiée à l'internet public. |
vpc_egress_setting | PRIVATE_RANGES_ONLY | Routage du trafic sortant via le VPC. |
enable_iap | false | Exige une connexion Google via Identity-Aware Proxy. Requis lorsque ingress_settings = "all". |
iap_authorized_users / iap_authorized_groups | [] | Qui peut accéder via IAP. |
enable_cloud_armor | false | Associe un WAF Cloud Armor placé derrière un équilibreur de charge HTTPS global. |
application_domains | [] | Noms de domaine personnalisés pour l'équilibreur de charge HTTPS. |
enable_cdn | false | Active Cloud CDN sur l'équilibreur de charge HTTPS. |
enable_vpc_sc | false | Applique un périmètre VPC-SC (requiert organization_id). |
enable_audit_logging | false | Journaux Cloud Audit Logs détaillés. |
Groupe 6 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Paramètres non secrets supplémentaires. OLLAMA_MODELS, OLLAMA_HOST et OLLAMA_KEEP_ALIVE sont injectées automatiquement. Utilisez ici OLLAMA_NUM_PARALLEL, OLLAMA_ORIGINS, etc. |
secret_environment_variables | {} | Correspondance variable d'environnement → nom du secret Secret Manager. |
Groupe 7 — Sauvegarde et maintenance
Sans objet pour Ollama — les poids des modèles sont stockés durablement dans GCS. Ces variables ne sont présentes que pour la compatibilité de l'interface. Consultez App_CloudRun.
Groupe 8 — CI/CD et Binary Authorization
Intégration Cloud Build / Cloud Deploy standard d'App_CloudRun — consultez
App_CloudRun. Entrées principales : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy,
enable_binary_authorization.
Groupe 9 — Instance NFS et initialisation personnalisée
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Laissez vide et définissez default_model pour utiliser le job model-pull généré automatiquement. Fournissez une liste non vide pour le remplacer entièrement. |
cron_jobs | [] | Cloud Run Jobs récurrents déclenchés par Cloud Scheduler. |
Groupe 11 — Stockage et système de fichiers
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Provisionne les buckets GCS de storage_buckets. Le bucket des modèles est toujours créé, quoi qu'il arrive. |
storage_buckets | [] | Buckets GCS supplémentaires en plus du bucket des modèles. |
enable_nfs | false | Non requis pour Ollama (utilise GCS Fuse). |
gcs_volumes | [] | Montages de volumes GCS Fuse supplémentaires. Le bucket ollama-models sur /mnt/gcs est toujours ajouté automatiquement. |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options CMEK. |
max_images_to_retain / delete_untagged_images / image_retention_days | (définies) | Règle de nettoyage d'Artifact Registry. |
Groupe 12 — Backend de base de données
Sans objet pour Ollama. database_type est fixé à "NONE" — aucune instance Cloud SQL n'est
provisionnée. Ces variables ne sont présentes que pour la compatibilité de l'interface.
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe | { type="HTTP", path="/", initial_delay_seconds=30, failure_threshold=20 } | Le seuil de 20 tentatives laisse environ 5 minutes pour charger le modèle depuis GCS. |
liveness_probe | { type="HTTP", path="/", initial_delay_seconds=60, failure_threshold=3 } | Le délai de 60 s évite des redémarrages intempestifs pendant le chargement du modèle. |
uptime_check_config | { enabled=false, path="/" } | Test de disponibilité Cloud Monitoring. |
alert_policies | [] | Règles d'alerte sur métriques. |
max_revisions_to_retain | 7 | Non référencée — déclarée uniquement pour la compatibilité de l'interface ; n'a aucun effet sur le déploiement de ce module. |
Groupe 19 — Configuration des modèles Ollama
| Variable | Valeur par défaut | Description |
|---|---|---|
default_model | "" | Modèle à télécharger lors du premier déploiement (par exemple "llama3.2:3b", "mistral", "llama3:8b"). Laissez vide pour ignorer le job de téléchargement automatique. |
model_pull_timeout_seconds | 3600 | Délai d'expiration du Cloud Run Job model-pull. Les grands modèles (7B et plus) peuvent prendre 20–30 minutes. Plage valide : 300–7200. |
5. Sorties
Renvoyées lors d'un déploiement réussi — le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du service Cloud Run. |
ollama_api_url | URL de base de l'API REST d'Ollama — ajoutez /api/generate, /api/chat, etc. Construite sous la forme <api_url>/api. |
service_location | Région dans laquelle s'exécute le service. |
stage_services | URL des services propres à chaque étape (Cloud Deploy). |
models_bucket | Nom du bucket GCS dans lequel les poids des modèles Ollama sont conservés. |
storage_buckets | Tous les buckets Cloud Storage provisionnés. |
network_name / network_exists / regions | Réseau VPC, présence, régions. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels / uptime_check_names | État de la surveillance, canaux, tests de disponibilité. |
initialization_jobs | Noms des jobs d'initialisation (y compris model-pull lorsqu'il est déclenché). |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / github_repository_url / github_repository_owner / github_repository_name / cicd_configuration | État et détails du CI/CD. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Registre et déclencheur de build. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État de VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | État des journaux d'audit et de CMEK. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
ingress_settings | internal | Critique | "all" expose publiquement l'API Ollama non authentifiée — n'importe quel appelant sur internet peut interroger ou charger des modèles. |
enable_iap | true si ingress_settings = "all" | Critique | Sans IAP, l'API est non authentifiée et accessible publiquement. Ollama n'a aucune authentification intégrée. |
memory_limit | 8Gi (3B) / 16Gi (7B) | Critique | Une mémoire insuffisante provoque un arrêt OOM en pleine inférence ; le conteneur redémarre en boucle. Allouez au moins 2× la taille des poids quantifiés du modèle. |
execution_environment | gen2 (par défaut) | Élevé | Gen1 ne prend pas en charge les montages GCS Fuse. La rétrogradation empêche silencieusement la persistance des modèles. |
cpu_limit | 4000m (3B) / 8000m (7B) | Élevé | Trop peu de CPU rend la génération de tokens extrêmement lente (plusieurs minutes par token sur les modèles 7B). |
min_instance_count | 1 | Élevé | 0 active la mise à l'échelle à zéro mais provoque des démarrages à froid de 60–120 s pendant le rechargement du modèle depuis GCS. |
model_pull_timeout_seconds | 3600 | Élevé | Un délai trop court fait échouer le job model-pull avant la fin du téléchargement pour les modèles de plus de 2 GB. |
startup_probe.failure_threshold | 20 (par défaut) | Élevé | Un seuil trop bas conduit Cloud Run à arrêter et redémarrer le conteneur avant qu'Ollama soit prêt après le montage GCS Fuse. |
timeout_seconds | 3600 | Élevé | L'inférence de LLM sur de longs prompts peut dépasser 5 minutes. Si la valeur est trop courte, les requêtes de génération longues sont interrompues avec une erreur 504. |
max_instance_count | 1–3 | Élevé | Chaque instance charge le modèle indépendamment. Plusieurs instances sont sans danger mais augmentent nettement le coût et le trafic de lecture GCS. |
default_model | le modèle souhaité | Moyen | Laisser vide est sans danger pour le déploiement initial, mais l'API renvoie une erreur sur toutes les requêtes d'inférence tant qu'aucun modèle n'a été téléchargé manuellement. |
environment_variables.OLLAMA_NUM_PARALLEL | 2–4 pour un usage partagé | Moyen | La valeur par défaut 1 sérialise toutes les requêtes. Augmentez-la pour les points de terminaison VPC partagés avec des appelants simultanés. |
environment_variables.OLLAMA_KEEP_ALIVE | 24h (injectée automatiquement) | Moyen | La valeur par défaut propre à Ollama (5m) évince les modèles de la mémoire, ce qui entraîne des délais de rechargement de 30–60 s. Le module injecte automatiquement 24h. |
environment_variables.OLLAMA_ORIGINS | à restreindre pour un usage navigateur | Moyen | La politique CORS par défaut d'Ollama accepte n'importe quelle origine. Restreignez-la à des origines d'interface précises lorsque l'API est exposée via un équilibreur de charge. |
options de montage de gcs_volumes | inclure implicit-dirs | Moyen | Sans implicit-dirs, les listages de répertoires GCS Fuse échouent et Ollama ne peut pas découvrir les modèles en cache. |
enable_image_mirroring | true | Moyen | La désactivation entraîne des téléchargements depuis Docker Hub, soumis à des limites de débit. Conservez true en production. |
Pour le comportement du socle évoqué tout au long de cette page — identité du service, mise à l'échelle et concurrence, entrée et équilibrage de charge, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir des images — consultez App_CloudRun. La configuration applicative partagée propre à Ollama est décrite dans Ollama_Common.
Guides associés
- Lab pratique : Ollama sur Cloud Run — déployez-le pas à pas, avec les écrans de la console et les commandes à chaque étape.
- Ollama sur GKE Autopilot — la même application sur Kubernetes, lorsque vous avez besoin de l'autre cible de déploiement.
- Ollama Common — Configuration applicative partagée — la configuration partagée par les deux cibles de déploiement.
- Déployé aux côtés de LiteLLM sur Google Cloud Run, Qdrant sur Google Cloud Run, Open WebUI sur Google Cloud Run, SearXNG sur Google Cloud Run dans la solution Private AI Assistant.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.