Module App GKE — Guide de configuration
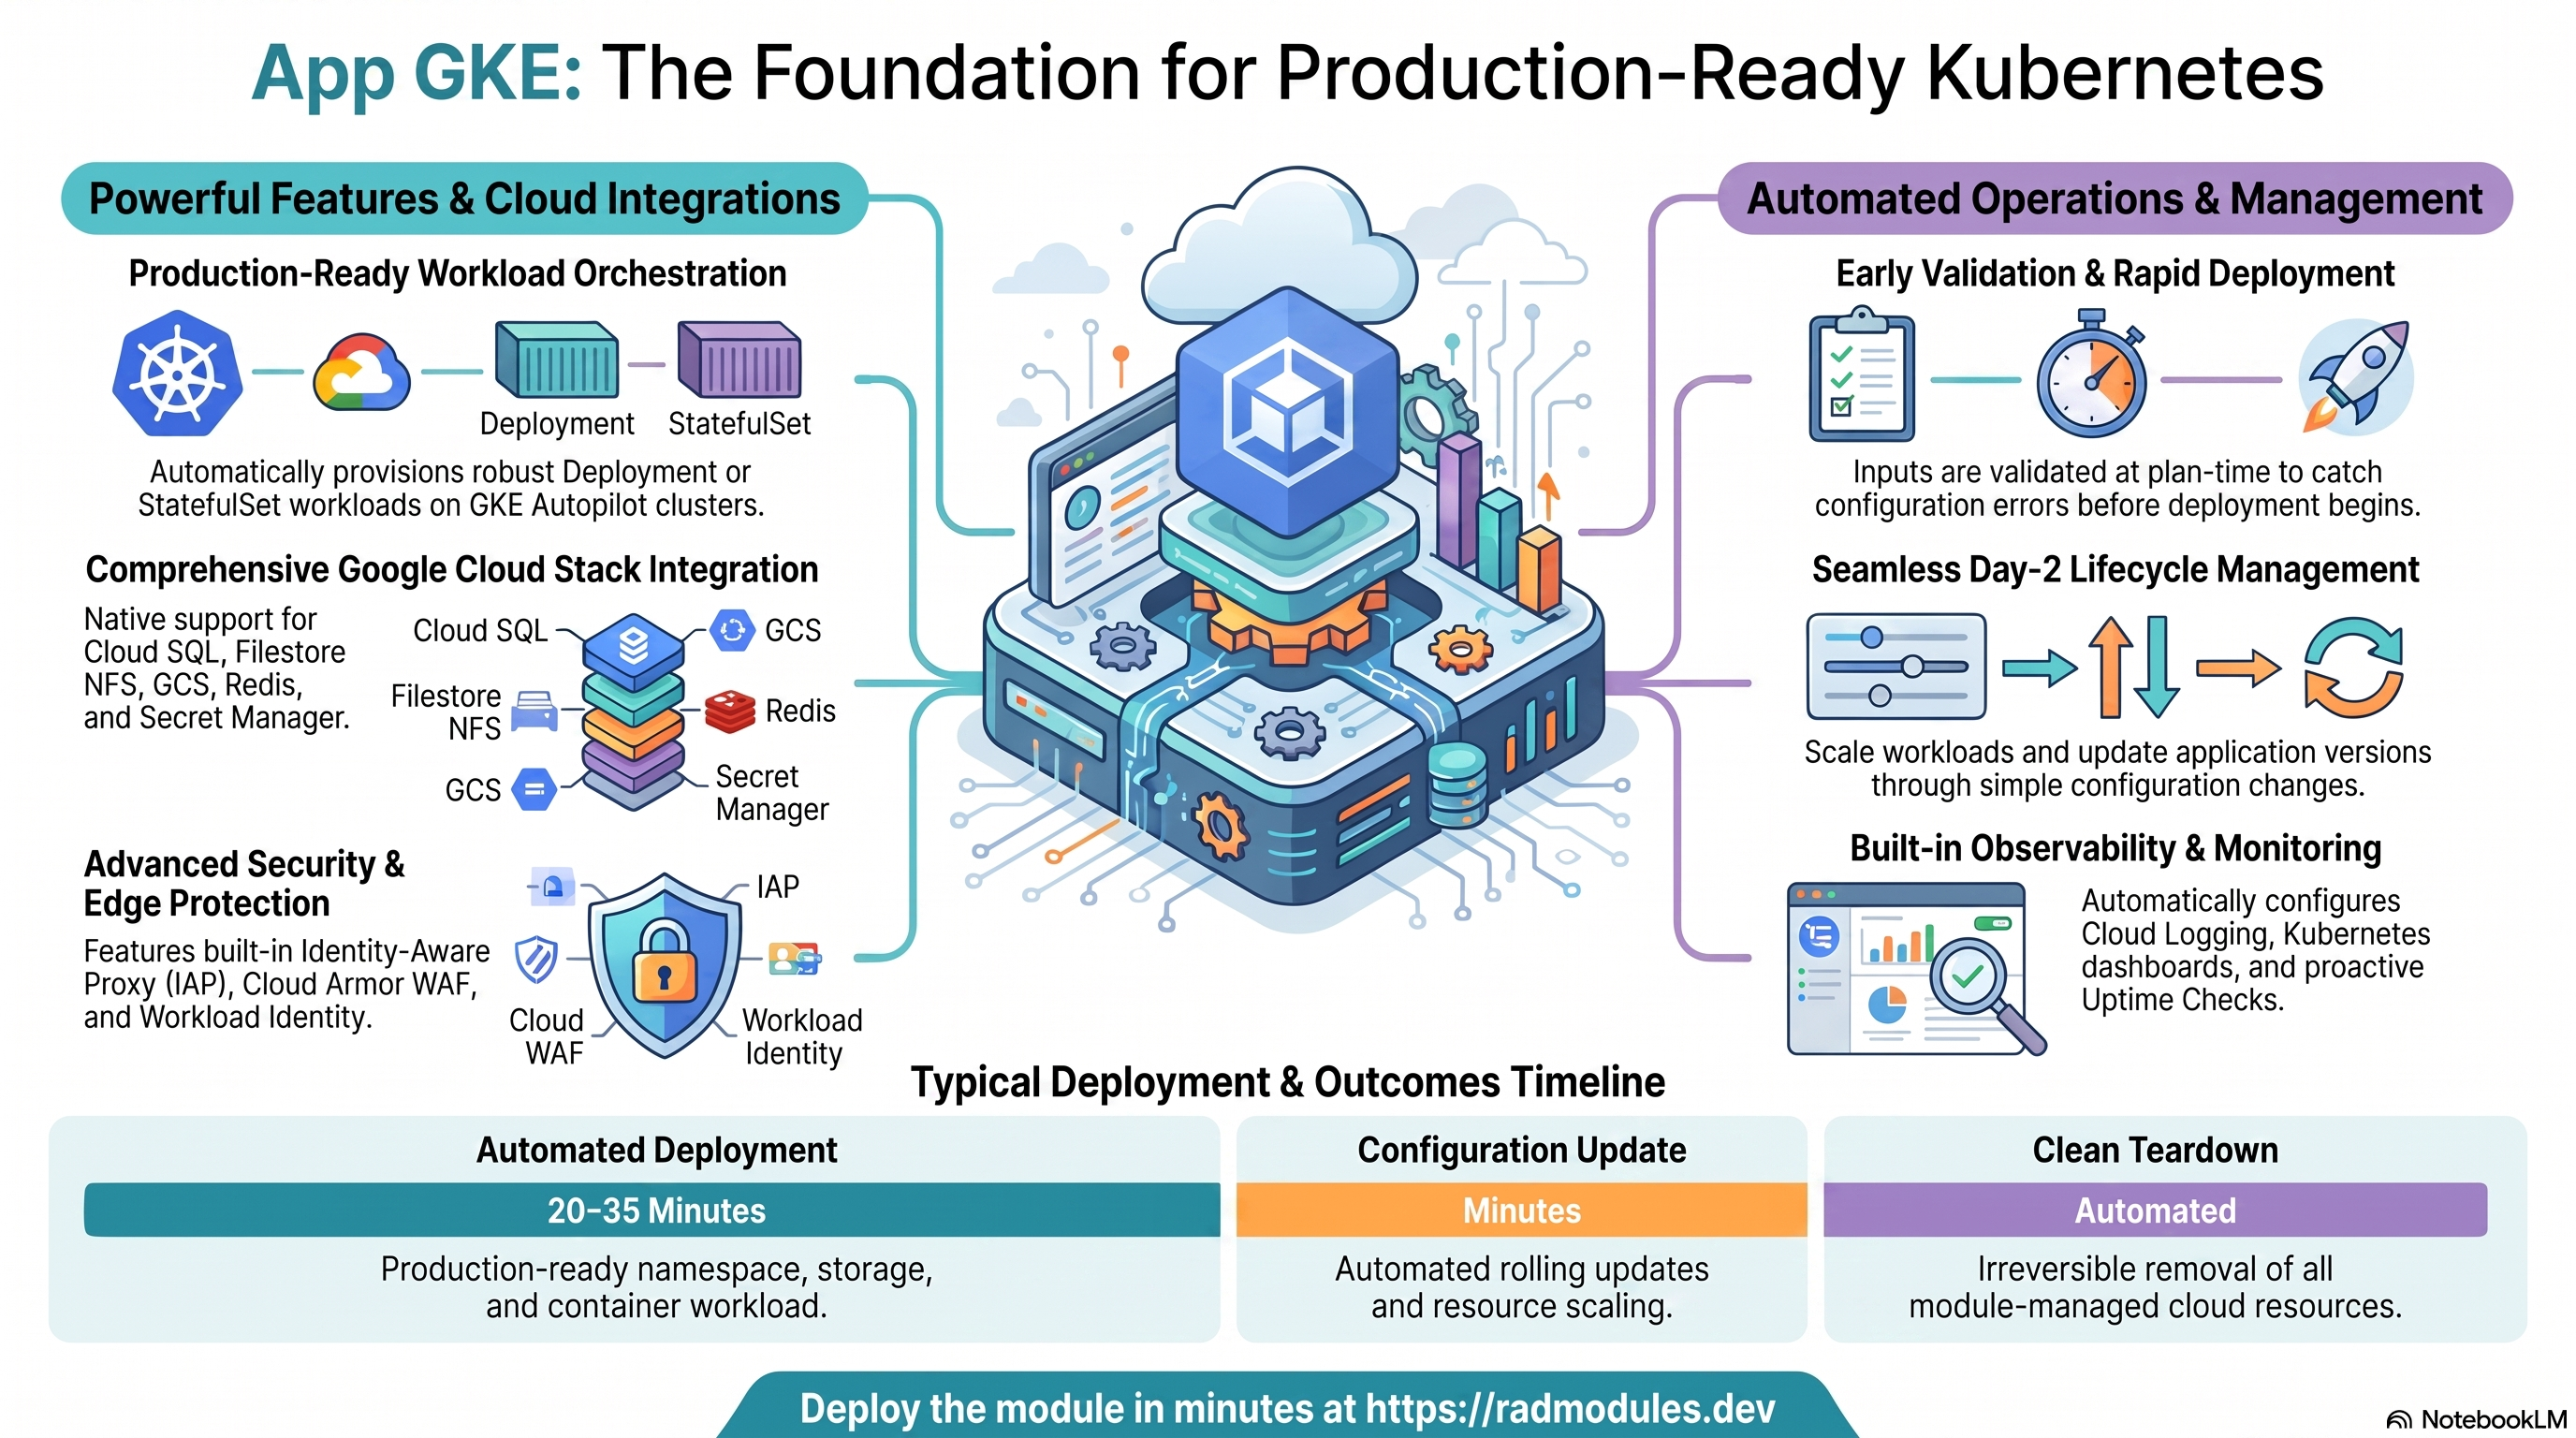
Ce guide décrit chaque variable de configuration disponible dans le module App GKE, organisée par groupes fonctionnels. Pour chaque variable, il détaille les options disponibles, les implications de chaque choix et la façon de valider la configuration obtenue dans la console Google Cloud ou à l'aide des commandes CLI gcloud et kubectl.
Services GCP déployés
Un déploiement App GKE entièrement configuré provisionne et intègre les services GCP suivants :
- GKE Autopilot — Cluster Kubernetes avec gestion automatique des nœuds, Horizontal Pod Autoscaler (HPA) et Vertical Pod Autoscaler (VPA) facultatif
- Kubernetes Deployments / StatefulSets — Contrôleur de charge de travail applicative avec dimensionnement configurable des réplicas et stratégie de mise à jour progressive (rolling update)
- Kubernetes Services — Exposition de l'application via ClusterIP interne, LoadBalancer externe ou NodePort
- Cloud Build — Pipeline de build d'images de conteneurs et déclencheur CI/CD connecté à GitHub
- Artifact Registry — Référentiel d'images de conteneurs avec politiques de nettoyage configurables et chiffrement CMEK facultatif
- Cloud SQL — Instance de base de données gérée PostgreSQL, MySQL ou SQL Server avec side-car Cloud SQL Auth Proxy
- Cloud Storage (GCS) — Buckets applicatifs avec montages facultatifs via le pilote CSI GCS Fuse au sein des pods
- Cloud Filestore / VM GCE NFS — Stockage persistant NFS partagé accessible simultanément par tous les réplicas de pods
- Secret Manager — Stockage sécurisé pour les mots de passe de base de données, les jetons GitHub et les secrets applicatifs ; injectés dans les pods via le pilote CSI Secrets Store
- Workload Identity — Authentification GCP sans clé pour les pods à l'aide de jetons de compte de service projetés (aucun fichier de clé)
- Cloud Monitoring — Tests de disponibilité, politiques d'alerte et canaux de notification pour
support_users - Cloud Deploy (facultatif) — Pipeline de livraison progressive à plusieurs étapes avec barrières de promotion et approbations manuelles facultatives
- Cloud Armor (facultatif) — Politique de sécurité WAF attachée au backend GKE Gateway
- Identity-Aware Proxy (facultatif) — Authentification basée sur l'identité Google appliquée au niveau de la passerelle (Gateway)
- Certificate Manager (facultatif) — Certificats SSL gérés par Google pour les domaines personnalisés via l'API GKE Gateway
- VPC Service Controls (facultatif) — Périmètre d'API limitant l'accès aux services GCP à l'intérieur du VPC et aux identités approuvées
Prérequis
Avant de déployer App GKE :
- Projet GCP avec facturation activée.
- Module Services GCP (fournit les clusters partagés, Cloud SQL partagé, NFS partagé et Artifact Registry partagé). Vous n'avez pas besoin de le déployer vous-même au préalable : la plateforme le provisionne automatiquement avant votre déploiement s'il n'existe pas déjà dans le projet cible. App GKE peut également fonctionner en mode autonome entièrement intégré (inline) sans Services GCP (
require_services_gcp_module = false), mais chaque déploiement provisionne alors son propre VPC, cluster GKE, VM NFS et instance Cloud SQL. - Autorisations IAM : Le compte de service effectuant le déploiement requiert des autorisations étendues au niveau du projet (Éditeur de projet ou équivalent) pour créer des espaces de noms GKE, des utilisateurs Cloud SQL, des buckets GCS et des secrets Secret Manager.
- Secrets Secret Manager référencés dans
secret_environment_variablesdoivent exister avant le déploiement ; le déploiement échoue si un secret référencé est manquant. - Pour le CI/CD (
enable_cicd_trigger = true) : un dépôt GitHub et soit un jeton d'accès personnel GitHub (Personal Access Token, portées :repo,admin:repo_hook), soit un ID d'installation GitHub App. - Pour IAP (
enable_iap = true) : un client OAuth 2.0 créé préalablement (ID client et secret) depuis APIs & Services → Credentials et un écran de consentement OAuth configuré. - Pour l'importation de sauvegarde (
enable_backup_import = true) : le fichier de sauvegarde doit être importé dans le bucket de sauvegarde GCS avant le déploiement.
Groupe 0 — Métadonnées du module et intégration à la plateforme
Ces variables sont consommées par la plateforme de déploiement plutôt que par les ressources Terraform elles-mêmes. explicit_secret_values et scripts_dir sont renseignées par un module Application (wrapper) — tel que Ghost_GKE — qui appelle App_GKE en tant que module enfant ; elles doivent être laissées à leurs valeurs par défaut vides lors du déploiement autonome de App_GKE.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
module_description | string | (module blurb) | Description lisible de l'objectif du module, affichée dans l'interface de la plateforme. Métadonnées uniquement — ne modifiez pas sauf en cas de personnalisation du module pour un fork. |
module_documentation | string | "https://docs.radmodules.dev/docs/modules/App_GKE" | Lien vers la documentation externe de ce module, affiché dans l'interface de la plateforme comme référence d'aide. Métadonnées uniquement. |
module_dependency | list(string) | ["Services_GCP"] | Autres modules de la plateforme devant être déployés avant celui-ci. Utilisé par la plateforme pour appliquer l'ordre de déploiement. Métadonnées uniquement. |
module_services | list(string) | ["GKE Autopilot", …] | Services GCP activés ou consommés par ce module. Utilisé pour la documentation et la visibilité des services de la plateforme. Métadonnées uniquement. |
credit_cost | number | 0 | Crédits de plateforme consommés lors du déploiement de ce module. Utilisé par le système de facturation de la plateforme. Métadonnées uniquement. |
require_credit_purchases | bool | false | Lorsque true, les frais de module ne peuvent être payés qu'à partir de crédits achetés (abonnement ou recharge), et non depuis des crédits offerts gratuits ou des crédits d'événements. |
enable_purge | bool | true | Autorise la suppression complète de toutes les ressources gérées par le module lors de la destruction. Définissez à false pour conserver les ressources après le retrait du module, protégeant ainsi contre les pertes accidentelles de données. Métadonnées uniquement. |
public_access | bool | true | Contrôle si ce module est listé publiquement dans le catalogue de la plateforme. Métadonnées uniquement. |
require_services_gcp_module | bool | true | Lorsque true, le déploiement échoue lors de la phase de plan avec une erreur explicite si aucun réseau VPC géré par Services_GCP n'est détecté dans le projet. Définissez à false pour autoriser un déploiement autonome avec des ressources prérequises intégrées (inline). |
shared_users | list(string) | [] | Utilisateurs pouvant afficher et déployer ce module, quel que soit le paramètre public_access. |
technical_support_users | list(string) | [] | Utilisateurs responsables de la fourniture du support technique pour ce module. Le portail de déploiement achemine les demandes de support vers ces adresses. Métadonnées uniquement. |
resource_creator_identity | string | "rad-module-creator@YOUR_PLATFORM_PROJECT.iam.gserviceaccount.com" | Compte de service utilisé par Terraform pour créer et gérer les ressources. Remplacez par un compte de service propre au projet pour les déploiements en production. |
impersonation_service_account | string | "" | Compte de service dont l'identité est empruntée lorsque les scripts shell (découverte, mise en miroir des images, configuration NFS) appellent les API GCP. Requis pour les déploiements inter-projets ; laissez vide pour utiliser les propres identifiants du runner. |
job_execution_wait_timeout | number | 900 | Nombre maximal de secondes pendant lesquelles un déploiement attend que le job de configuration de la base de données (db-create) se termine avant d'abandonner, afin qu'un job bloqué fasse échouer l'apply rapidement au lieu de rester figé jusqu'au délai d'expiration global du build. |
explicit_secret_values | map(string) | {} | Valeurs de secrets brutes fournies directement par un module wrapper. Les clés doivent correspondre aux entrées de secret_environment_variables. Lorsqu'elles sont fournies, la recherche de source de données Secret Manager lors du plan est ignorée pour ces clés, ce qui permet au premier apply de réussir avant que les secrets n'existent. |
scripts_dir | string | "" | Répertoire contenant les scripts d'initialisation et d'utilitaires. Par défaut, utilise le répertoire de scripts intégré au module lorsqu'il est laissé vide. À remplacer lorsqu'un module wrapper fournit des scripts personnalisés. |
requires_services | object | { create_postgres = true, create_network_filesystem = true, create_google_kubernetes_engine = true, … } | Mappage explicite des ressources provisionnées par Services GCP dont ce module a besoin. La plateforme lit ce mappage — et non module_services, qui est une liste lisible pour l'interface de confirmation du déploiement — pour déterminer quelles options create_* de Services GCP doivent être activées lors de l'auto-provisionnement ou de la mise à jour du déploiement partagé de Services GCP pour le projet de destination. Les clés reflètent exactement le nom des variables booléennes de Services GCP : create_postgres, create_mysql, create_redis, create_network_filesystem, create_filestore_nfs, create_google_kubernetes_engine, create_firestore, enable_alloydb. create_redis et create_filestore_nfs valent par défaut false car le chemin de déploiement automatisé utilise la VM NFS+Redis Compute Engine (create_network_filesystem) ; le passage à Memorystore/Filestore géré est une optimisation manuelle post-déploiement. |
Groupe 1 — Projet et identité
Ces variables établissent le contexte du projet GCP. Elles doivent être configurées correctement avant que tout déploiement ne puisse aboutir.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
project_id | string | (requis) | L'ID du projet GCP dans lequel toutes les ressources sont provisionnées. Tous les noms de ressources, associations IAM et appels d'API sont limités à ce projet. Doit comporter de 6 à 30 caractères minuscules et commencer par une lettre. |
region | string | "us-central1" | Région GCP utilisée lorsqu'aucun mappage de sous-réseau Services GCP ne peut être découvert automatiquement. À remplacer pour les déploiements en dehors de us-central1. |
Exploration dans GCP — Groupe 1
Google Cloud Console :
- Confirmation du projet : Le nom et l'ID du projet sont affichés dans la barre de navigation supérieure. Accédez à Home → Dashboard pour vérifier que vous êtes dans le bon projet.
- Région du cluster GKE : Accédez à Kubernetes Engine → Clusters pour confirmer que la région du cluster correspond à la région de déploiement attendue.
gcloud CLI :
# Confirm the project exists and is active
gcloud projects describe PROJECT_ID

# List GKE clusters in the project
gcloud container clusters list --project=PROJECT_ID \
  --format="table(name,location,status,currentNodeCount)"
Groupe 2 — Identité du déploiement
Ces variables définissent le suffixe d'environnement de déploiement et les paramètres de notification partagés appliqués à toutes les ressources.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
tenant_id | string | "demo" | Identifiant court ajouté au nom des ressources (ex. espace de noms Kubernetes, secrets, instance SQL) pour distinguer ce déploiement des autres dans le même projet. Utilisez prod, staging, dev ou un identifiant de tenant. Ne jamais modifier après le déploiement initial — il est intégré dans chaque nom de ressource. |
support_users | list(string) | [] | Adresses e-mail des destinataires des notifications d'alerte Cloud Monitoring (échecs de disponibilité, dépassements de seuils d'alerte). L'ajout d'adresses ici n'accorde aucune autorisation IAM GCP. |
resource_labels | map(string) | { env = "dev" } | Libellés clé-valeur appliqués à toutes les ressources GCP créées par ce module. Utilisés pour l'imputation des coûts, le marquage des environnements et l'application des règles organisationnelles. |
Exploration dans GCP — Groupe 2
Google Cloud Console :
- Espace de noms Kubernetes : Accédez à Kubernetes Engine → Workloads et filtrez par espace de noms pour vérifier que le nom de l'espace de noms correspond à
APPLICATION_NAME-TENANT_ID. - Libellés : Accédez à n'importe quelle ressource (ex. Cloud Storage → Buckets → votre bucket → Configuration) pour vérifier les libellés.
- Canaux de notification Monitoring : Accédez à Monitoring → Alerting → Notification channels pour vérifier que les adresses e-mail de support sont enregistrées.
gcloud CLI :
# List Kubernetes namespaces on the cluster
kubectl get namespaces --show-labels

# List Cloud Monitoring notification channels
gcloud beta monitoring channels list --project=PROJECT_ID \
  --format="table(displayName,type,labels.email_address)"
Groupe 3 — Identité de l'application
Ces variables définissent l'identité de l'application déployée. Elles déterminent la façon dont l'application est nommée dans les services GCP et les ressources Kubernetes.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
application_name | string | "gkeapp" | Identifiant interne de l'application. Utilisé comme nom de base pour le Deployment Kubernetes, l'espace de noms, le dépôt Artifact Registry et les secrets Secret Manager. Doit commencer par une lettre minuscule et contenir de 1 à 20 caractères. Ne jamais modifier après le déploiement initial. |
application_display_name | string | "App_GKE Application" | Nom lisible affiché dans l'interface de la plateforme et les tableaux de bord de surveillance. Peut être modifié librement à tout moment sans incidence sur les noms des ressources. |
application_description | string | "App_GKE Custom Application…" | Brève description de l'objectif de l'application. Renseignée dans les annotations de déploiement Kubernetes et la documentation de la plateforme. |
application_version | string | "1.0.0" | Tag de version appliqué à l'image du conteneur et utilisé pour le suivi du déploiement. L'incrémentation de cette valeur déclenche un nouveau build d'image et un déploiement progressif lorsque container_image_source est custom. |
Exploration dans GCP — Groupe 3
Google Cloud Console :
- Nom du déploiement : Accédez à Kubernetes Engine → Workloads pour vérifier que le déploiement figure dans la liste avec le nom attendu dérivé de
application_name. - Référentiel Artifact Registry : Accédez à Artifact Registry → Repositories pour confirmer qu'un référentiel nommé d'après
application_nameexiste. - Versions d'images : Cliquez sur le référentiel pour voir toutes les versions d'images étiquetées.
gcloud CLI :
# Confirm the Kubernetes Deployment exists
kubectl get deployment APPLICATION_NAME -n NAMESPACE

# List tagged images for the application in Artifact Registry
gcloud artifacts docker images list \
  REGION-docker.pkg.dev/PROJECT_ID/APPLICATION_NAME \
  --include-tags \
  --format="table(image,tags,createTime)"

# List Secret Manager secrets associated with the application
gcloud secrets list --project=PROJECT_ID \
  --filter="name:APPLICATION_NAME" \
  --format="table(name,createTime)"
Groupe 4 — Exécution et dimensionnement
Choix de l'exécution et du dimensionnement. Source de l'image :
"custom"compile à partir de votre dépôt via Cloud Build (nécessite la connexion GitHub) ;"prebuilt"déploie un URI d'image existant et nécessitecontainer_image(vérifié lors du plan). Dimensionnement : sur Autopilot, vous payez par ressource demandée par pod, doncmin_instance_count/max_instance_count(les limites HPA — le minimum ne doit pas dépasser le maximum, règle appliquée) déterminent directement la disponibilité et le coût ; définissezmin≥ 1 pour les services sensibles à la latence, et dimensionnezcontainer_resourcesen fonction de l'utilisation réelle puisque Autopilot facture la requête, pas le nœud. La forme de la charge de travail est définie dans les groupes 6 et 7 : unDeploymentsans état évolue horizontalement et librement ; unStatefulSet(sélectionné automatiquement parstateful_pvc_enabled) fournit une identité stable et un stockage persistant par pod, mais restreint le dimensionnement — ne le choisissez que si la charge de travail a véritablement besoin d'un stockage ou d'une identité stables.
Ces variables contrôlent la façon dont le conteneur applicatif est sourcé, compilé, déployé et dimensionné sur GKE Autopilot.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
deploy_application | bool | true | Lorsque true, la charge de travail Kubernetes est déployée. Définissez sur false pour provisionner l'infrastructure sous-jacente (VPC, base de données, stockage, espace de noms GKE) sans déployer le conteneur applicatif. Utile pour les déploiements échelonnés ou les flux de travail axés d'abord sur l'infrastructure. |
container_image_source | string | "custom" | Détermine l'origine de l'image de conteneur. prebuilt déploie directement un URI d'image existant ; custom utilise Cloud Build pour compiler l'image à partir des sources. |
container_image | string | "" | URI complet de l'image de conteneur à déployer. Requis lorsque container_image_source vaut prebuilt ou que enable_image_mirroring vaut true. Exemples : us-docker.pkg.dev/my-project/my-repo/app:v1.0, nginx:latest. |
container_build_config | object | { enabled = true } | Configuration de Cloud Build lorsque container_image_source vaut custom. Champs principaux : enabled, dockerfile_path, dockerfile_content, context_path, build_args, artifact_repo_name, base_image. |
enable_image_mirroring | bool | true | Met en miroir l'image de conteneur depuis son registre source vers Artifact Registry avant le déploiement. Fortement recommandé pour les images publiques externes afin d'éviter les limites de débit et de garantir la traçabilité. |
min_instance_count | number | 1 | Nombre minimal de réplicas de pods à maintenir en cours d'exécution à tout moment (HPA minReplicas). Définissez à 0 pour une réduction à zéro (non recommandé pour les charges de travail de production sensibles à la latence). |
max_instance_count | number | 3 | Nombre maximal de réplicas de pods autorisés à s'exécuter simultanément (HPA maxReplicas). Sert de plafond de coûts. Veillez à ce que max × connections_per_pod ne dépasse pas la capacité Cloud SQL max_connections. |
container_port | number | 8080 | Port TCP sur lequel l'application écoute à l'intérieur du conteneur. Le service Kubernetes achemine tout le trafic vers ce port. Doit correspondre exactement au port sur lequel votre serveur d'application est lié. |
container_protocol | string | "http1" | Version du protocole HTTP pour le backend du service Kubernetes. http1 correspond à HTTP/1.1 standard ; h2c correspond à HTTP/2 en texte clair (requis pour gRPC). Lorsque h2c est défini, le port du Service annonce appProtocol: kubernetes.io/h2c. |
container_resources | object | { cpu_limit = "1000m", memory_limit = "512Mi" } | Demandes et limites de ressources CPU et mémoire pour le conteneur. GKE Autopilot facture selon les ressources demandées — spécifiez des demandes réalistes. Accepte la notation de quantité Kubernetes (1000m, 512Mi, 1Gi). Champs facultatifs : cpu_request, mem_request, ephemeral_storage_limit, ephemeral_storage_request. |
timeout_seconds | number | 300 | Durée maximale en secondes pendant laquelle l'équilibreur de charge attend une réponse d'un pod backend avant de renvoyer une erreur 504 (délai dépassé). Plage valide : 0–3600. |
enable_vertical_pod_autoscaling | bool | false | Active le Vertical Pod Autoscaler (VPA), qui ajuste automatiquement les demandes de processeur et de mémoire en fonction de l'utilisation constatée. Recommandé pour GKE Autopilot où des demandes précises réduisent les coûts. Ne combinez pas avec HPA sur la même métrique CPU/mémoire. |
enable_cloudsql_volume | bool | true | Injecte un conteneur side-car Cloud SQL Auth Proxy dans le pod GKE, exposant la base de données sur 127.0.0.1 via un socket Unix. Il s'agit de la méthode recommandée et sécurisée pour la connectivité à Cloud SQL. |
cloud_sql_proxy_version | string | "2-alpine" | Tag de version pour l'image du conteneur side-car Cloud SQL Auth Proxy. Figez sur un condensat (digest) pour des déploiements immuables. L'image du proxy est automatiquement mise en miroir dans Artifact Registry. |
cloudsql_volume_mount_path | string | "/cloudsql" | Chemin du système de fichiers à l'intérieur du conteneur où le socket Unix du Cloud SQL Auth Proxy est monté. La chaîne de connexion à la base de données de votre application doit référencer ce chemin. |
service_annotations | map(string) | {} | Annotations personnalisées appliquées à la ressource Service Kubernetes. À utiliser pour les configurations avancées de GKE ou de l'équilibreur de charge qui ne sont pas exposées directement sous forme de paramètres standards. |
service_labels | map(string) | { env = "dev" } | Libellés personnalisés appliqués spécifiquement à la ressource Service Kubernetes, en plus de resource_labels. |
deployment_timeout | number | 1800 | Nombre maximal de secondes que la plateforme attend pour que le déploiement progressif du Kubernetes Deployment ou StatefulSet se termine. Augmentez cette valeur pour les clusters qui téléchargent des images volumineuses ou pour les pods dont le démarrage est long. |
Exploration dans GCP — Groupe 4
Google Cloud Console :
- Déploiement et dimensionnement : Accédez à Kubernetes Engine → Workloads → votre déploiement pour afficher le déploiement, le nombre de réplicas et la configuration HPA.
- Image du conteneur : Dans les détails de la charge de travail, sélectionnez l'onglet YAML pour afficher la spécification du conteneur, y compris l'URI de l'image et les limites de ressources.
- Images Artifact Registry : Accédez à Artifact Registry → Repositories → application_name pour afficher les tags d'images disponibles.
- Statut HPA : Accédez à Kubernetes Engine → Workloads et recherchez les ressources
HorizontalPodAutoscalerdans le même espace de noms.
gcloud CLI / kubectl :
# Describe the Kubernetes Deployment
kubectl describe deployment APPLICATION_NAME -n NAMESPACE

# View HPA configuration and current replica counts
kubectl get hpa -n NAMESPACE

# Describe the HPA for scaling details
kubectl describe hpa APPLICATION_NAME -n NAMESPACE

# List pod resource requests/limits
kubectl get pods -n NAMESPACE -o custom-columns=\
"NAME:.metadata.name,CPU_REQ:.spec.containers[*].resources.requests.cpu,\
MEM_REQ:.spec.containers[*].resources.requests.memory,\
CPU_LIM:.spec.containers[*].resources.limits.cpu,\
MEM_LIM:.spec.containers[*].resources.limits.memory"

# List container images in Artifact Registry
gcloud artifacts docker images list \
  REGION-docker.pkg.dev/PROJECT_ID/APPLICATION_NAME \
  --include-tags --format="table(image,tags,createTime)"
Groupe 5 — Variables d'environnement et secrets
Ces variables contrôlent la façon dont la configuration et les identifiants sensibles sont transmis aux pods en cours d'exécution.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
environment_variables | map(string) | {} | Variables d'environnement en texte clair injectées dans le pod GKE à l'exécution. À utiliser pour les configurations non sensibles telles que les indicateurs de fonctionnalités (feature flags), les niveaux de journalisation ou les points de terminaison d'API. N'y stockez jamais de mots de passe ou de jetons. |
secret_environment_variables | map(string) | {} | Références aux secrets Secret Manager injectées en tant que variables d'environnement dans le pod via valueFrom de Kubernetes. La clé du mappage correspond au nom de la variable d'environnement ; la valeur correspond au nom du secret Secret Manager. La valeur en texte brut n'est jamais stockée dans la configuration ou l'état. |
secret_rotation_period | string | "2592000s" | Fréquence à laquelle Secret Manager publie une notification de rotation via Pub/Sub. Spécifiée en secondes avec un suffixe s (ex. "2592000s" pour 30 jours). Ne fait pas pivoter automatiquement le secret — un gestionnaire de rotation doit être implémenté séparément. |
secret_propagation_delay | number | 30 | Secondes d'attente après la création ou la mise à jour d'un secret avant de continuer. Permet à la réplication globale de Secret Manager de se terminer avant que les pods ne tentent de lire la valeur du secret. Augmentez ce délai si les déploiements échouent avec des erreurs indiquant que le secret est introuvable. |
Exploration dans GCP — Groupe 5
Google Cloud Console :
- Contenu du Secret Kubernetes (CSI) : Accédez à Kubernetes Engine → Workloads → votre déploiement → YAML pour afficher les blocs
envetenvFromprésentant les références aux secrets. - Secrets Secret Manager : Accédez à Security → Secret Manager pour afficher tous les secrets, leurs versions, les calendriers de rotation et les règles d'accès.
- Accès IAM aux secrets : Dans Secret Manager, cliquez sur un secret → Permissions pour confirmer que le compte de service de la charge de travail GKE dispose des autorisations
Secret Accessor. Le compte n'a pas de rôle Secret Manager au niveau du projet : ce module lui accorde chaque secret lu par SecretSync (les secrets de l'application, les secrets nommés uniquement dans lesecret_env_varsd'un job d'initialisation, et le mot de passe de base de données de chaque étape de Cloud Deploy), etServices GCPaccorde le mot de passe root Cloud SQL.
gcloud CLI / kubectl :
# View environment variables on a running pod
kubectl exec -n NAMESPACE POD_NAME -- env | sort

# List Kubernetes Secrets in the namespace
kubectl get secrets -n NAMESPACE

# List Secret Manager secrets for the application
gcloud secrets list --project=PROJECT_ID \
  --filter="name:APPLICATION_NAME" \
  --format="table(name,createTime)"

# View the rotation config for a specific secret
gcloud secrets describe SECRET_NAME \
  --project=PROJECT_ID --format="yaml(rotation,labels)"

# Confirm the GKE workload SA has Secret Accessor access
gcloud secrets get-iam-policy SECRET_NAME \
  --project=PROJECT_ID \
  --format="table(bindings.role,bindings.members)"
Groupe 6 — Configuration du backend GKE
Ces variables contrôlent la façon dont l'application est exposée au sein du cluster Kubernetes et la manière dont elle est reliée au cluster GKE et au réseau.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
gke_cluster_name | string | "" | Nom du cluster GKE dans lequel effectuer le déploiement. Laissez vide pour découvrir automatiquement un cluster géré par Services GCP à l'aide de gke_cluster_selection_mode. |
gke_cluster_selection_mode | string | "primary" | Stratégie de sélection du cluster GKE cible lorsque gke_cluster_name n'est pas défini. primary cible le premier cluster découvert géré par Services GCP ; round-robin répartit sur plusieurs clusters ; explicit exige que gke_cluster_name soit défini. |
namespace_name | string | "" | Espace de noms Kubernetes dans lequel déployer les ressources applicatives. Laissez vide pour générer automatiquement à partir de application_name et tenant_id. |
workload_type | string | null | Contrôleur de charge de travail Kubernetes. Deployment pour les applications sans état ; StatefulSet pour les applications nécessitant des identités réseau stables ou un stockage persistant par pod. Vaut par défaut Deployment lorsqu'il est nul. Définir stateful_pvc_enabled = true résout automatiquement la valeur en StatefulSet. |
service_type | string | "LoadBalancer" | Type de Service Kubernetes. LoadBalancer provisionne un équilibreur de charge GCP avec une adresse IP externe ; ClusterIP pour un accès interne uniquement ; NodePort expose un port statique sur tous les nœuds. Lorsqu'une passerelle (Gateway) est utilisée (domaine personnalisé, CDN ou Cloud Armor), LoadBalancer est créé en tant que ClusterIP afin que la Gateway — avec tout IAP ou Cloud Armor associé — soit le seul point d'entrée public. |
service_port | number | 80 | Port exposé sur le Service Kubernetes (le port auquel les clients se connectent). Définissez pour correspondre au port natif de l'application lorsque les clients doivent se connecter sur ce port précis. |
extra_service_ports | list(object) | [] | Ports supplémentaires à exposer sur le Service Kubernetes, pour une charge de travail qui communique via plusieurs protocoles sur le même pod (par exemple ClickHouse, qui sert du HTTP sur 8123 alors que son protocole natif est sur 9000). Chaque entrée définit name, port, un champ facultatif target_port (par défaut port) et un champ facultatif protocol (par défaut TCP). Les noms doivent être uniques — Kubernetes exige un nom distinct pour chaque port dans un Service multi-ports, ce qui est vérifié lors du plan. Purement additif : la valeur par défaut vide génère exactement le même Service qu'auparavant. |
session_affinity | string | "ClientIP" | Mode d'affinité de session pour le Service Kubernetes. ClientIP achemine toutes les requêtes provenant de la même adresse IP cliente vers le même pod (utile pour les applications avec état). None répartit les requêtes sur l'ensemble des pods. |
enable_network_segmentation | bool | false | Crée des ressources Kubernetes NetworkPolicy pour limiter le trafic d'entrée et de sortie entre pods. Réduit le rayon d'impact en cas de compromission de charges de travail. Nécessite que le cluster GKE ait l'application des règles de réseau activée. À n'activer qu'après avoir répertorié tous les flux de trafic entre espaces de noms. |
configure_service_mesh | bool | false | Active l'injection du maillage de services Istio pour l'espace de noms de l'application en ajoutant le libellé istio-injection: enabled. Nécessite l'installation de Cloud Service Mesh ou Anthos Service Mesh sur le cluster. |
enable_multi_cluster_service | bool | false | Destiné à activer GKE Multi-Cluster Services (MCS) pour la découverte de services entre clusters au sein d'une flotte GKE (Fleet). Remarque : la ressource ServiceExport n'est actuellement pas créée par ce module — cette variable n'a aucun effet sur le déploiement dans la version actuelle. |
termination_grace_period_seconds | number | 60 | Secondes d'attente de Kubernetes après l'envoi du signal SIGTERM avant d'interrompre de force le conteneur avec SIGKILL. Augmentez pour les applications nécessitant du temps pour terminer les requêtes en cours ou vider les données. Plage valide : 0–3600. |
prereq_gke_subnet_cidr | string | "10.201.0.0/24" | Plage CIDR pour le sous-réseau GKE intégré créé lorsqu'un VPC Services GCP existe mais qu'aucun cluster GKE n'est présent. Ne doit pas chevaucher d'autres sous-réseaux. Chaque déploiement App GKE dans le même VPC doit utiliser un CIDR distinct. Ne jamais modifier après la création du cluster GKE intégré. |
prereq_subnet_cidr_override | string | "" | Remplacement du CIDR du sous-réseau principal du VPC intégré. S'il est vide, un /24 unique est dérivé par déploiement. Figez sur la valeur précédemment appliquée sur les déploiements existants afin d'éviter le remplacement du sous-réseau. |
prereq_gke_pod_cidr_override | string | "" | Remplacement du CIDR de la plage secondaire de pods du cluster GKE intégré. Figez sur la valeur précédemment appliquée sur les déploiements existants afin d'éviter le remplacement du cluster GKE. |
prereq_gke_service_cidr_override | string | "" | Remplacement du CIDR de la plage secondaire de services du cluster GKE intégré. Figez sur la valeur précédemment appliquée sur les déploiements existants afin d'éviter le remplacement du cluster GKE. |
prereq_gke_master_cidr_override | string | "" | Remplacement de la plage privée /28 du plan de contrôle du cluster GKE intégré. Lorsqu'elle est vide, le module socle dérive un /28 unique par déploiement à partir de l'identifiant aléatoire de déploiement dans 172.16.0.0/12 — un bloc RFC1918 différent des plages de sous-réseau/pods/services ci-dessus, afin qu'il ne puisse jamais entrer en collision avec celles-ci. Figez sur la valeur précédemment appliquée sur les déploiements existants pour éviter le remplacement du cluster GKE. |
Les clusters GKE intégrés exécutent toujours des nœuds privés
Le cluster GKE Autopilot intégré est créé avec private_cluster_config { enable_private_nodes = true }, ce qui n'est pas facultatif et ne dispose d'aucune variable de désactivation. Les projets gérés par RAD appliquent une règle d'administration de refus DENY constraints/compute.vmExternalIpAccess ; sans nœuds privés, GKE tente d'attribuer des adresses IP externes à ses nœuds, la création des nœuds échoue avec Constraint constraints/compute.vmExternalIpAccess violated et le cluster reste bloqué en état ERROR.
Seuls les nœuds sont privés. enable_private_endpoint est délibérément laissé à sa valeur par défaut (false), afin que le plan de contrôle conserve son point de terminaison public — Cloud Build et d'autres outils extérieurs au VPC s'y connectent directement. La plage privée propre au plan de contrôle provient de prereq_gke_master_cidr_override (ou du /28 dérivé ci-dessus).
Exploration dans GCP — Groupe 6
Google Cloud Console :
- Cluster GKE : Accédez à Kubernetes Engine → Clusters pour confirmer le cluster cible et sa configuration.
- Espace de noms Kubernetes : Accédez à Kubernetes Engine → Workloads et filtrez par espace de noms.
- Service Kubernetes : Accédez à Kubernetes Engine → Services & Ingress pour afficher le type de Service, l'adresse IP externe et le mappage des ports.
- NetworkPolicies : Accédez à Kubernetes Engine → Workloads et recherchez les ressources NetworkPolicy dans l'espace de noms.
kubectl :
# Confirm the namespace exists with correct labels
kubectl get namespace NAMESPACE --show-labels

# Describe the Kubernetes Service (type, IP, ports)
kubectl describe service APPLICATION_NAME -n NAMESPACE

# List all Services in the namespace
kubectl get services -n NAMESPACE

# Check for NetworkPolicies
kubectl get networkpolicies -n NAMESPACE

# Describe a NetworkPolicy to review ingress/egress rules
kubectl describe networkpolicy -n NAMESPACE

# Check service mesh injection label
kubectl get namespace NAMESPACE -o jsonpath='{.metadata.labels}'
Groupe 7 — StatefulSet / PVC
Choisir StatefulSet ou Deployment. Définir
stateful_pvc_enabled = trueest l'unique commutateur : cela résout automatiquement la charge de travail en unStatefulSet(vous ne devez pas définir égalementworkload_type— son association avecworkload_type = "Deployment"est rejetée lors du plan) et attribue à chaque réplica une identité réseau stable ainsi que sa propre PersistentVolumeClaim conservée lors des réordonnancements. Utilisez-le pour les bases de données dans le cluster, les courtiers de messages ou tout élément nécessitant un stockage stable par pod. Pour les charges de travail Web/API sans état, laissez cette option désactivée — unDeployments'adapte plus librement et n'a aucun cycle de vie PVC à gérer. Lorsqu'il est activé,stateful_pvc_sizeetstateful_pvc_mount_pathsont obligatoires (règle appliquée). Notez que le stockage partagé entre pods répond à un besoin différent — utilisez NFS (Groupe 13), et non des PVC par pod.
Ces variables configurent le stockage persistant pour les charges de travail StatefulSet. Chaque réplica de pod reçoit sa propre PersistentVolumeClaim (PVC) isolée pour un stockage stable et dédié à chaque pod.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
stateful_pvc_enabled | bool | null | Active les modèles de PersistentVolumeClaim dans la spécification du StatefulSet afin que chaque réplica de pod reçoive son propre PVC isolé. Définir cette variable sur true résout automatiquement workload_type en StatefulSet. Définir workload_type = "Deployment" en même temps provoque l'échec de la planification (plan). |
stateful_pvc_size | string | null | Taille de stockage pour chaque PVC provisionné par le StatefulSet. Chaque pod reçoit un PVC de cette taille. Exemple : "20Gi". |
stateful_pvc_mount_path | string | null | Chemin du système de fichiers à l'intérieur de chaque conteneur de pod où le PVC dédié au pod est monté. L'application lit et écrit les données persistantes à cet emplacement. Exemple : "/var/lib/data". |
stateful_pvc_storage_class | string | null | StorageClass Kubernetes pour les PVC du StatefulSet. Laissez à null pour utiliser la StorageClass par défaut du cluster. Pour GKE Autopilot, standard-rwo (Balanced PD, ReadWriteOnce) est la valeur par défaut. |
stateful_headless_service | bool | null | Crée un Service Kubernetes headless (clusterIP: None) aux côtés du StatefulSet, attribuant à chaque pod une entrée DNS stable (ex. pod-0.service.namespace.svc.cluster.local). Requis pour les applications avec architecture maître-esclave (leader-follower) ou découverte de pairs. |
stateful_pod_management_policy | string | null | Contrôle l'ordre de création et de suppression des pods. OrderedReady démarre/arrête les pods de manière séquentielle (requis pour l'architecture leader-follower). Parallel démarre tous les pods simultanément pour une mise à l'échelle plus rapide. Vaut par défaut OrderedReady. |
stateful_update_strategy | string | null | Stratégie de mise à jour pour le StatefulSet. RollingUpdate remplace les pods un par un lorsque le modèle change. OnDelete met à jour les pods uniquement lorsqu'ils sont supprimés manuellement. Vaut par défaut RollingUpdate. |
stateful_fs_group | number | 0 | GID défini comme fsGroup au niveau du pod dans le contexte de sécurité du StatefulSet. Kubernetes applique un chown du point de montage PVC vers ce GID lors de l'association, accordant au processus applicatif les droits d'écriture lorsqu'il s'exécute avec un UID non root. Définissez à 0 pour laisser fsGroup non défini. |
Exploration dans GCP — Groupe 7
Google Cloud Console :
- StatefulSet : Accédez à Kubernetes Engine → Workloads et confirmez que le type de charge de travail est
StatefulSet. - PersistentVolumeClaims : Accédez à Kubernetes Engine → Storage → PersistentVolumeClaims pour visualiser les PVC par pod et leur état d'association.
- Persistent Volumes : Accédez à Kubernetes Engine → Storage → PersistentVolumes pour voir les ressources de disques sous-jacentes.
kubectl :
# View the StatefulSet configuration
kubectl describe statefulset APPLICATION_NAME -n NAMESPACE

# List PersistentVolumeClaims created by the StatefulSet
kubectl get pvc -n NAMESPACE

# Describe a specific PVC to confirm StorageClass and binding status
kubectl describe pvc PVC_NAME -n NAMESPACE

# Verify headless Service exists (clusterIP should be None)
kubectl get service APPLICATION_NAME-headless -n NAMESPACE \
  -o jsonpath='{.spec.clusterIP}'

# Check pod ordinal DNS resolution (from within the cluster)
# nslookup pod-0.APPLICATION_NAME-headless.NAMESPACE.svc.cluster.local
Groupe 8 — Quotas de ressources
Ces variables créent un ResourceQuota Kubernetes dans l'espace de noms de l'application, empêchant une charge de travail unique de monopoliser les ressources partagées du cluster GKE Autopilot.
Important :
quota_memory_requestsetquota_memory_limitsdoivent utiliser des suffixes d'unités binaires (Gi,Mi) — des entiers bruts comme"4"sont interprétés par Kubernetes comme 4 octets et bloqueront toute planification de pods dans l'espace de noms.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_resource_quota | bool | false | Crée un ResourceQuota Kubernetes dans l'espace de noms de l'application. Recommandé pour les clusters mutualisés partagés afin d'empêcher une application de consommer des ressources illimitées. |
quota_cpu_requests | string | "4" | Total des requêtes de CPU autorisées pour l'ensemble des pods de l'espace de noms. Laissez vide pour n'appliquer aucun quota de requêtes de CPU. Accepte la notation CPU de Kubernetes ("4", "4000m"). |
quota_cpu_limits | string | "4" | Total des limites de CPU autorisées pour l'ensemble des pods de l'espace de noms. Doit être ≥ quota_cpu_requests. |
quota_memory_requests | string | "4Gi" | Total des requêtes de mémoire autorisées pour l'ensemble des pods de l'espace de noms. Doit utiliser un suffixe d'unité binaire (Gi, Mi). |
quota_memory_limits | string | "8Gi" | Total des limites de mémoire autorisées pour l'ensemble des pods de l'espace de noms. Doit être ≥ quota_memory_requests. Doit utiliser un suffixe d'unité binaire (Gi, Mi). |
quota_max_pods | string | "20" | Nombre maximal de pods autorisés dans l'espace de noms. Laissez vide pour n'appliquer aucun quota sur le nombre de pods. |
quota_max_services | string | "10" | Nombre maximal de Services Kubernetes autorisés dans l'espace de noms. |
quota_max_pvcs | string | "5" | Nombre maximal de PersistentVolumeClaims autorisés dans l'espace de noms. Pertinent lorsque workload_type est à StatefulSet. |
Exploration dans GCP — Groupe 8
Google Cloud Console :
- ResourceQuota : Accédez à Kubernetes Engine → Workloads et filtrez par ressources
ResourceQuotadans l'espace de noms pour visualiser l'utilisation actuelle par rapport aux limites.
kubectl :
# View the ResourceQuota and current usage
kubectl describe resourcequota -n NAMESPACE

# List all ResourceQuotas in the namespace
kubectl get resourcequota -n NAMESPACE -o yaml

# Check if pods are being rejected due to quota exhaustion
kubectl describe pod PENDING_POD_NAME -n NAMESPACE \
  | grep -A5 "Events:"
Groupe 9 — Fiabilité
Ces variables configurent les PodDisruptionBudgets et les TopologySpreadConstraints pour maintenir la disponibilité lors des perturbations volontaires et répartir les pods entre les domaines de défaillance.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_pod_disruption_budget | bool | true | Crée un PodDisruptionBudget (PDB) Kubernetes qui limite le nombre de pods pouvant être indisponibles simultanément lors de perturbations volontaires telles que les mises à niveau de nœuds GKE Autopilot. Fortement recommandé pour les déploiements en production. |
pdb_min_available | string | "1" | Nombre ou pourcentage minimal de pods qui doivent rester disponibles lors des perturbations volontaires. Accepte un entier ("1", "2") ou un pourcentage ("50%"). Attention : définir "1" avec un déploiement à réplica unique bloque les mises à niveau des nœuds GKE — utilisez "0" pour les charges de travail à réplica unique où une brève interruption pendant les mises à niveau est acceptable. |
enable_topology_spread | bool | false | Ajoute des TopologySpreadConstraints Kubernetes à la spécification du pod, répartissant uniformément les pods entre les zones de nœuds GKE et les nœuds individuels. Améliore la disponibilité en évitant que tous les réplicas ne soient situés dans le même domaine de défaillance. Recommandé pour les déploiements en production avec min_instance_count > 1. |
topology_spread_strict | bool | false | Contrôle le comportement de whenUnsatisfiable de la contrainte de répartition topologique. Lorsque défini sur true, les pods sont rejetés avec DoNotSchedule si la contrainte de répartition ne peut être satisfaite (nécessite ≥ 3 réplicas répartis sur ≥ 3 zones). Lorsque défini sur false, utilise ScheduleAnyway — plus sûr pour les déploiements de plus petite taille. |
Exploration dans GCP — Groupe 9
Google Cloud Console :
- PodDisruptionBudget : Accédez à Kubernetes Engine → Workloads et filtrez par ressources
PodDisruptionBudgetdans l'espace de noms. - Répartition des pods par zone : Accédez à Kubernetes Engine → Workloads → votre déploiement → Managed pods pour voir sur quels nœuds/zones chaque pod s'exécute.
kubectl :
# View the PodDisruptionBudget
kubectl describe pdb -n NAMESPACE

# Check pod distribution across zones and nodes
kubectl get pods -n NAMESPACE -o wide

# Describe a pod to view TopologySpreadConstraints in the spec
kubectl describe pod POD_NAME -n NAMESPACE | grep -A10 "Topology"

# Check for scheduling failures due to topology constraints
kubectl get events -n NAMESPACE \
  --field-selector reason=FailedScheduling
Groupe 10 — Observabilité
Ces variables configurent les sondes de santé Kubernetes, les tests de disponibilité Cloud Monitoring et les règles d'alerte.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
startup_probe_config | object | { enabled = true, path = "/healthz" } | Sonde de démarrage (startup probe) Kubernetes — Kubernetes n'acheminera pas les requêtes vers le pod tant que cette sonde n'aura pas réussi. Sous-champs : enabled, type (HTTP / TCP), path, initial_delay_seconds (par défaut : 10), timeout_seconds (par défaut : 5), period_seconds (par défaut : 10), failure_threshold (par défaut : 3). Pour les applications lentes à démarrer, augmentez failure_threshold ou period_seconds. |
health_check_config | object | { enabled = true, path = "/healthz" } | Sondes de vivacité et de disponibilité (readiness) Kubernetes — une configuration unique génère les deux, sur les charges de travail de type Deployment et StatefulSet. (À l'origine, les StatefulSets ne généraient aucune readinessProbe et utilisaient donc le repli GET / de Gateway décrit ci-dessous ; statefulset.tf émet désormais une readinessProbe identique sur ses deux spécifications de conteneur, de sorte que ce repli ne s'applique plus. Notez que cela ne modifie pas rétroactivement le contrôle de santé d'un Backend Service déjà créé.) La sonde de vivacité vérifie périodiquement si le conteneur en cours d'exécution est sain ; si elle échoue failure_threshold fois consécutives, Kubernetes redémarre le conteneur. La sonde de disponibilité détermine en outre si le pod reçoit du trafic, et l'API Gateway de GKE (Container-Native Load Balancing) en déduit son contrôle de santé de Backend Service au niveau de GCP — sans sonde de disponibilité, la Gateway se replie silencieusement sur un contrôle GET / non configurable attendant un 200, ce qui marque en permanence le backend comme UNHEALTHY pour toute application dont le chemin racine n'est pas un 200. Les sous-champs sont identiques à startup_probe_config (initial_delay_seconds par défaut : 15, timeout_seconds par défaut : 5, period_seconds par défaut : 30, failure_threshold par défaut : 3). Le point de terminaison de santé doit répondre rapidement et ne pas effectuer d'opérations coûteuses. |
uptime_check_config | object | { enabled = false, path = "/" } | Test de disponibilité Google Cloud Monitoring qui envoie des requêtes HTTP à l'application depuis plusieurs emplacements mondiaux. Déclenche une alerte vers support_users si le point de terminaison devient inaccessible. Désactivé par défaut — définissez enabled = true pour provisionner le test. Sous-champs : enabled, path, check_interval (par défaut : "60s"), timeout (par défaut : "10s"). Actif uniquement lorsque le point de terminaison de l'application possède un hôte stable et résoluble. Pour un service LoadBalancer avec une adresse IP statique réservée (valeur par défaut — voir reserve_static_ip), le test sonde automatiquement un nom d'hôte <reserved-ip>.nip.io par défaut ; définissez application_domains pour sonder votre propre domaine à la place. Un service LoadBalancer classique avec IP éphémère (c'est-à-dire reserve_static_ip = false sans application_domains) n'a pas d'hôte stable, le test est donc ignoré. |
alert_policies | list(object) | [] | Règles d'alerte Cloud Monitoring qui déclenchent des notifications vers support_users lorsque les métriques Kubernetes dépassent des seuils définis. Chaque règle requiert : name, metric_type, comparison (COMPARISON_GT / COMPARISON_LT), threshold_value, duration_seconds, aggregation_period (par défaut : "60s"). Types de métriques GKE courants : kubernetes.io/container/cpu/usage_time, kubernetes.io/container/memory/used_bytes. |
Exploration dans GCP — Groupe 10
Google Cloud Console :
- Sondes de santé : Accédez à Kubernetes Engine → Workloads → votre déploiement → YAML et repérez les champs
livenessProbe,readinessProbeetstartupProbedans la spécification du conteneur. - Tests de disponibilité : Accédez à Monitoring → Uptime checks pour visualiser les tests actifs, l'état actuel et les résultats par emplacement géographique.
- Règles d'alerte : Accédez à Monitoring → Alerting pour visualiser les règles d'alerte configurées, leur état et les canaux de notification.
kubectl / gcloud CLI :
# Describe the deployment to view probe configuration
kubectl describe deployment APPLICATION_NAME -n NAMESPACE \
  | grep -A20 "Liveness\|Readiness\|Startup"

# Check pod events for probe failures
kubectl describe pod POD_NAME -n NAMESPACE | tail -20

# List all uptime checks in the project
gcloud monitoring uptime list-configs \
  --project=PROJECT_ID \
  --format="table(displayName,httpCheck.path,period,timeout)"

# List all Cloud Monitoring alert policies
gcloud alpha monitoring policies list \
  --project=PROJECT_ID \
  --format="table(displayName,enabled,conditions[0].conditionThreshold.filter)"
Groupe 11 — Automatisation des charges de travail
Ces variables définissent les jobs d'initialisation, les tâches récurrentes planifiées et les services complémentaires qui s'exécutent aux côtés de la charge de travail applicative principale.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
initialization_jobs | list(object) | [{ name = "db-init", … }] | Jobs Kubernetes exécutés une fois pendant ou après le déploiement pour initialiser l'application. Utilisations courantes : migrations de schéma de base de données, chargement de données initiales (seed data), configuration de répertoires NFS. Principaux sous-champs : name, description, image, command, args, script_path, env_vars, secret_env_vars, cpu_limit, memory_limit, timeout_seconds, max_retries, task_count, mount_nfs, mount_gcs_volumes, depends_on_jobs, execute_on_apply, needs_db, needs_secrets. Sur GKE, execute_on_apply contrôle uniquement si Terraform attend que le job se termine avant de continuer — le job Kubernetes est créé et planifié dans les deux cas, de sorte qu'un job dont le bon fonctionnement dépend du démarrage complet de la charge de travail principale peut tout de même entrer en concurrence avec elle. |
cron_jobs | list(object) | [] | Tâches planifiées récurrentes déployées en tant que CronJobs Kubernetes. Chaque entrée définit : name, schedule (expression cron en UTC), image, command, args, env_vars, cpu_limit, memory_limit, restart_policy, concurrency_policy, failed_jobs_history_limit, successful_jobs_history_limit, starting_deadline_seconds, suspend, mount_nfs, mount_gcs_volumes, script_path. |
additional_services | list(object) | [] | Déploiements Kubernetes supplémentaires déployés aux côtés de l'application principale dans le même espace de noms. À utiliser pour les modèles de type sidecar : workers dédiés, services proxy, consommateurs de file d'attente en arrière-plan. Chacun crée son propre Deployment, Service et HPA optionnel. Principaux sous-champs : name, image, port, command, args, env_vars, secret_env_vars (associe un nom de variable d'environnement à une clé dans le secret matérialisé de l'application, afin qu'un sidecar puisse lire les mêmes secrets que le conteneur principal), cpu_limit, memory_limit, ephemeral_storage_limit, ephemeral_storage_request, min_instance_count, max_instance_count, ingress, service_port, loadbalancer_ip (rattache un service supplémentaire LoadBalancer à une adresse IP externe statique réservée, offrant une URL stable connue dès la phase de planification), extra_ports (ports de Service additionnels pour un conteneur écoutant sur plusieurs ports sous un seul nom de Service), output_env_var_name (injecte automatiquement l'URL du service dans l'application principale en tant que variable d'environnement), volume_mounts, persistent_volume (un PVC dédié sur stockage bloc — size, mount_path, storage_class, par défaut standard-rwo — pour un sidecar avec état ; ReadWriteOnce, le service doit donc rester à un seul réplica, et le PVC n'est pas supprimé avec le Deployment), wait_for_rollout (par défaut true ; définissez false uniquement si le service ne peut pas devenir sain avant l'exécution d'une étape ultérieure, ce qui bloquerait autrement l'apply — cela convertit un échec lors de l'apply en un échec silencieux), startup_probe, liveness_probe. |
Exploration dans GCP — Groupe 11
Google Cloud Console :
- Jobs Kubernetes : Accédez à Kubernetes Engine → Workloads et filtrez par type de ressource
Jobpour visualiser les jobs d'initialisation, leur état d'achèvement et leur durée. - CronJobs : Accédez à Kubernetes Engine → Workloads et filtrez par type de ressource
CronJobpour visualiser les plannings et l'état de la dernière exécution. - Services supplémentaires : Accédez à Kubernetes Engine → Services & Ingress pour visualiser les points de terminaison des services supplémentaires.
kubectl :
# List all Kubernetes Jobs in the namespace
kubectl get jobs -n NAMESPACE

# View the logs of a specific initialization job
kubectl logs -n NAMESPACE job/JOB_NAME

# List all CronJobs and their schedules
kubectl get cronjobs -n NAMESPACE

# View the last few runs of a CronJob
kubectl get jobs -n NAMESPACE \
  --selector=app=CRONJOB_NAME \
  --sort-by=.metadata.creationTimestamp

# Check pod logs for a CronJob execution
kubectl logs -n NAMESPACE -l job-name=JOB_NAME

# List all Deployments (includes additional services)
kubectl get deployments -n NAMESPACE
Groupe 12 — CI/CD
Ces variables configurent les pipelines de build et de déploiement automatisés à l'aide de Cloud Build et éventuellement de Cloud Deploy.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_cicd_trigger | bool | false | Interrupteur principal pour le pipeline CI/CD. Lorsque défini sur true, un déclencheur Cloud Build est créé pour surveiller le dépôt GitHub connecté et compiler et déployer automatiquement l'application lors des pushs de code éligibles. |
github_repository_url | string | "" | URL HTTPS complète du dépôt GitHub à connecter à Cloud Build. Requis lorsque enable_cicd_trigger est à true. Format : https://github.com/ORG/REPO. |
github_token | string | "" | Jeton d'accès personnel GitHub (PAT) utilisé pour autoriser la connexion GitHub de Cloud Build. Requis lors du premier déploiement lorsque enable_cicd_trigger est à true. Portées requises : repo et admin:repo_hook. Stocké dans Secret Manager après le premier déploiement et réutilisé automatiquement par la suite. |
github_app_installation_id | string | "" | ID d'installation de l'application GitHub Cloud Build. Privilégié pour les dépôts au niveau de l'organisation. Lorsqu'il est fourni aux côtés de github_token, la connexion s'authentifie via l'application GitHub. |
cicd_trigger_config | object | { branch_pattern = "^main$" } | Configuration avancée pour le déclencheur Cloud Build. Sous-champs : branch_pattern (expression régulière correspondant aux noms de branches), included_files, ignored_files, trigger_name, description, substitutions. |
enable_cloud_deploy | bool | false | Bascule le pipeline CI/CD des déploiements directs Cloud Build vers un pipeline géré Google Cloud Deploy avec des étapes de promotion. Nécessite que enable_cicd_trigger soit défini sur true. |
cloud_deploy_stages | list(object) | [dev, staging, prod] | Liste ordonnée des étapes de promotion pour le pipeline de diffusion Cloud Deploy. Chaque étape crée une cible Cloud Deploy et un espace de noms GKE associé. Sous-champs : name, target_name, namespace, cluster, project_id, region, require_approval, auto_promote. |
gateway_backend_stage | string | "dev" | Étape de Cloud Deploy dont le Service est ciblé par le HTTPRoute de la Gateway. Modifiez vers "staging" ou "prod" une fois que Cloud Deploy a effectué la promotion vers cette étape. Ignoré lorsque enable_cloud_deploy est à false. |
enable_binary_authorization | bool | false | Applique la règle Binary Authorization sur le cluster GKE, exigeant que les images de conteneurs disposent d'une attestation valide avant de pouvoir être déployées. |
binauthz_evaluation_mode | string | "ALWAYS_ALLOW" | Mode d'application pour la règle Binary Authorization. ALWAYS_ALLOW autorise toute image (à utiliser lors de la configuration initiale). REQUIRE_ATTESTATION exige des images signées. ALWAYS_DENY bloque tous les déploiements (verrouillage strict). Utilisé uniquement lorsque enable_binary_authorization est à true. |
Exploration dans GCP — Groupe 12
Google Cloud Console :
- Déclencheurs Cloud Build : Accédez à Cloud Build → Triggers pour afficher le déclencheur, le dépôt connecté et l'état du dernier build.
- Historique des builds : Accédez à Cloud Build → History pour afficher les builds passés, leur état et leurs journaux.
- Pipelines Cloud Deploy : Accédez à Cloud Deploy → Delivery Pipelines pour visualiser les étapes du pipeline, la version actuelle et l'historique des promotions.
- Règle Binary Authorization : Accédez à Security → Binary Authorization pour afficher la règle d'application actuelle.
gcloud CLI / kubectl :
# List Cloud Build triggers
gcloud builds triggers list \
  --project=PROJECT_ID --region=REGION \
  --format="table(name,github.name,github.push.branch,disabled)"

# View recent Cloud Build history
gcloud builds list --project=PROJECT_ID --region=REGION \
  --limit=10 \
  --format="table(id,status,source.repoSource.branchName,createTime)"

# List Cloud Deploy delivery pipelines
gcloud deploy delivery-pipelines list \
  --region=REGION --project=PROJECT_ID \
  --format="table(name,condition.pipelineReadyCondition.status)"

# List Cloud Deploy releases for a pipeline
gcloud deploy releases list \
  --delivery-pipeline=PIPELINE_NAME \
  --region=REGION --project=PROJECT_ID \
  --format="table(name,buildArtifacts[0].tag,renderState,createTime)"

# View Binary Authorization policy
gcloud container binauthz policy export --project=PROJECT_ID
Groupe 13 — Stockage NFS
Ces variables configurent le stockage partagé Cloud Filestore (NFS) monté dans le pod GKE en tant que volume persistant. NFS fournit un système de fichiers partagé conforme à POSIX, accessible simultanément par tous les réplicas de pods.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_nfs | bool | true | Lorsque défini sur true, un volume NFS est monté dans le pod GKE au niveau de nfs_mount_path. Le module découvre automatiquement une instance Filestore existante ou une VM NFS GCE dans le projet, ou provisionne une VM NFS GCE intégrée (inline) si aucune n'est trouvée. Essentiel pour les applications gérant des téléversements de fichiers partagés ou des données devant persister au-delà des redémarrages de pods. |
nfs_mount_path | string | "/mnt/nfs" | Chemin du système de fichiers à l'intérieur du conteneur où le volume NFS est monté. Utilisé uniquement lorsque enable_nfs est à true. Les fichiers écrits en dehors de ce chemin dans le système de fichiers du conteneur sont éphémères et perdus au redémarrage du pod. |
nfs_volume_name | string | "nfs-data-volume" | Nom de volume Kubernetes pour le point de montage NFS. Ne le modifiez que lors du montage d'un deuxième partage NFS avec un nom de volume distinct. |
nfs_instance_name | string | "" | Nom d'une VM GCE NFS existante à laquelle se connecter directement. Laissez vide pour découvrir automatiquement une instance gérée par Services GCP ou pour provisionner une VM NFS intégrée (inline). |
nfs_instance_base_name | string | "app-nfs" | Nom de base pour la VM GCE NFS intégrée (inline) créée lorsqu'aucun serveur NFS existant n'est trouvé. L'ID de déploiement est ajouté automatiquement pour garantir l'unicité. |
Exploration dans GCP — Groupe 13
Google Cloud Console :
- Instance NFS (Filestore) : Accédez à Filestore → Instances pour confirmer l'existence de l'instance, son niveau, sa capacité et son adresse IP.
- Instance NFS (VM GCE) : Accédez à Compute Engine → VM Instances et filtrez par nom d'instance pour confirmer qu'elle est en cours d'exécution.
- Point de montage du volume NFS : Dans le YAML de la charge de travail Kubernetes, recherchez le volume
nfset sonmountPathdans la spécification du conteneur.
kubectl / gcloud CLI :
# Verify NFS volume is mounted in the pod spec
kubectl describe pod POD_NAME -n NAMESPACE | grep -A5 "Mounts:"

# List Filestore instances
gcloud filestore instances list \
  --project=PROJECT_ID \
  --format="table(name,tier,networks[0].ipAddresses[0],fileShares[0].capacityGb,state)"

# List GCE VM instances (for inline NFS VMs)
gcloud compute instances list --project=PROJECT_ID \
  --filter="name:nfs" \
  --format="table(name,zone,status,networkInterfaces[0].networkIP)"

# Check pod logs for NFS mount errors at startup
kubectl logs POD_NAME -n NAMESPACE --previous | grep -i nfs
Groupe 14 — Cloud Storage
Ces variables configurent les buckets Google Cloud Storage (GCS) et les montages GCS Fuse pour l'application.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
create_cloud_storage | bool | true | Interrupteur principal pour le provisionnement de buckets GCS. Définissez sur false lorsque les buckets sont gérés en externe ou doivent être partagés entre plusieurs déploiements. |
storage_buckets | list(object) | [] | Buckets GCS à provisionner pour l'application. Chaque nom de bucket est automatiquement préfixé par l'ID du projet et le nom de l'application. Sous-champs par entrée : name_suffix, location, storage_class (STANDARD, NEARLINE, COLDLINE, ARCHIVE), force_destroy, versioning_enabled, lifecycle_rules, public_access_prevention ("enforced" recommandé), uniform_bucket_level_access, cors. |
gcs_volumes | list(object) | [] | Buckets GCS à monter en tant que volumes de système de fichiers dans les pods à l'aide du pilote CSI GCS Fuse. Sous-champs : name, bucket_name, mount_path, readonly, mount_options (par défaut : implicit-dirs, stat-cache-ttl=60s, type-cache-ttl=60s). Nécessite que le pilote CSI GCS Fuse soit activé sur le cluster (activé par défaut sur GKE Autopilot). |
manage_storage_kms_iam | bool | false | Lorsque défini sur true, crée un trousseau de clés KMS CMEK et une clé de chiffrement de stockage, attribue le rôle encrypter/decrypter au compte de service GCS et active CMEK sur tous les buckets de stockage. Sûr à activer dès le premier déploiement — la clé est créée automatiquement. |
enable_artifact_registry_cmek | bool | false | Lorsque défini sur true, crée une clé KMS Artifact Registry et active le chiffrement au repos des images de conteneurs avec une clé gérée par le client. Sûr à activer dès le premier déploiement. |
max_images_to_retain | number | 7 | Nombre maximal d'images de conteneurs récentes à conserver dans Artifact Registry. Sert de garde-fou pour la rétention. Définissez sur 0 pour désactiver. |
delete_untagged_images | bool | true | Supprime automatiquement les images de conteneurs sans tag (couches orphelines) du dépôt Artifact Registry. N'affecte que les images restreintes au nom d'application de ce déploiement. |
image_retention_days | number | 30 | Nombre de jours après lequel les images de conteneurs sont éligibles à la suppression. Les images comprises dans max_images_to_retain sont toujours conservées. Définissez sur 0 pour désactiver la suppression basée sur l'âge. |
Exploration dans GCP — Groupe 14
Google Cloud Console :
- Buckets GCS : Accédez à Cloud Storage → Buckets pour confirmer que les buckets sont créés avec les noms et configurations attendus.
- Montages GCS Fuse : Dans le YAML de la charge de travail Kubernetes, recherchez les volumes CSI avec le pilote
gcsfuse.csi.storage.gke.io. - Règles de nettoyage Artifact Registry : Accédez à Artifact Registry → Repositories → repository → Cleanup Policies.
kubectl / gcloud CLI :
# List all GCS buckets in the project
gcloud storage buckets list --project=PROJECT_ID \
  --format="table(name,location,storageClass,iamConfiguration.publicAccessPrevention)"

# Describe a specific bucket (versioning, lifecycle, encryption)
gcloud storage buckets describe gs://BUCKET_NAME \
  --format="yaml(versioning,lifecycle,encryption)"

# Verify GCS Fuse volumes in pod spec
kubectl describe pod POD_NAME -n NAMESPACE | grep -A10 "gcsfuse"

# List objects in a bucket (validate application writes)
gcloud storage ls gs://BUCKET_NAME/ --recursive

# View Artifact Registry cleanup policies
gcloud artifacts repositories describe REPO_NAME \
  --location=REGION --project=PROJECT_ID \
  --format="yaml(cleanupPolicies)"

# List container images to confirm cleanup is working
gcloud artifacts docker images list \
  REGION-docker.pkg.dev/PROJECT_ID/REPO_NAME \
  --include-tags --format="table(image,tags,createTime)"
Groupe 15 — Cache Redis
Ces variables configurent la connectivité Redis pour l'application en injectant les détails de connexion sous forme de variables d'environnement dans le pod GKE.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_redis | bool | true | Lorsque défini sur true, injecte les variables d'environnement REDIS_HOST et REDIS_PORT dans le pod GKE. Lorsque défini sur false, aucune variable d'environnement Redis n'est injectée. Définissez explicitement sur false pour les applications n'utilisant pas Redis — la valeur par défaut true avec un champ redis_host vide se replie sur l'adresse IP du serveur NFS, ce qui peut consigner des erreurs de connexion inattendues. |
redis_host | string | "" | Nom d'hôte ou adresse IP du serveur Redis injecté sous la forme REDIS_HOST. Laissez vide pour utiliser par défaut l'adresse IP du serveur NFS (adapté aux environnements partagés sur une seule VM). Définissez explicitement en cas de connexion à Google Cloud Memorystore — utilisez l'adresse IP privée de l'instance. |
redis_port | string | "6379" | Port TCP du serveur Redis injecté sous la forme REDIS_PORT. Le port Redis standard est 6379. |
redis_auth | string | "" | Mot de passe d'authentification pour le serveur Redis. Stocké dans Secret Manager et injecté de manière sécurisée — jamais stocké en clair. Laissez vide si l'instance Redis ne nécessite pas d'authentification. Pour Memorystore avec AUTH activé, définissez cette variable sur la chaîne d'authentification de l'instance. |
Exploration dans GCP — Groupe 15
Google Cloud Console :
- Instance Memorystore Redis : Accédez à Memorystore → Redis pour confirmer l'existence de l'instance, son adresse IP, son port et son état AUTH.
- Variables d'environnement Redis : Dans la spécification du pod Kubernetes (ou
kubectl exec), confirmez queREDIS_HOSTetREDIS_PORTsont présentes.
kubectl / gcloud CLI :
# Confirm REDIS_HOST and REDIS_PORT are set on a running pod
kubectl exec -n NAMESPACE POD_NAME -- env | grep REDIS

# List Cloud Memorystore Redis instances
gcloud redis instances list --region=REGION --project=PROJECT_ID \
  --format="table(name,host,port,tier,memorySizeGb,state,authEnabled)"

# Describe a specific Memorystore instance (includes IP and AUTH info)
gcloud redis instances describe INSTANCE_NAME \
  --region=REGION --project=PROJECT_ID \
  --format="yaml(host,port,authEnabled,state)"
Groupe 16 — Configuration de la base de données
Choisir le backend de base de données. Décidez d'abord si vous en avez besoin :
database_type = "NONE"ignore tout provisionnement de BDD (ainsi que les fonctionnalités dépendantes — import de sauvegarde, SQL personnalisé, rotation automatique, volume Cloud SQL — chacune rejetée lors du plan si laissée activée avecNONE). Si vous en avez besoin, choisissez le moteur requis par votre application (POSTGRES/MYSQL, ou une variante avec version figée commePOSTGRES_15/MYSQL_8_0). Figez la version pour la production —database_typeest pratiquement immuable : le modifier après le premier déploiement remplace l'instance Cloud SQL et détruit ses données. Avec un socleServices_GCP, le module crée uniquement une base de données et un utilisateur dans l'instance partagée (aucun coût d'instance par déploiement) ; en mode autonome (standalone), il provisionne une instance dédiée. L'application accède à la base de données via le Cloud SQL Auth Proxy (enable_cloudsql_volume) — laissez-le activé pour les connexions par socket. Les commutateurs par famille de moteurs (enable_postgres_extensions,enable_mysql_plugins) doivent correspondre au moteur choisi (contrainte appliquée).
Ces variables configurent le backend de base de données Cloud SQL. Le module prend en charge PostgreSQL, MySQL et SQL Server, et peut provisionner une nouvelle instance, se connecter à une instance existante ou ignorer complètement le provisionnement de base de données.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
database_type | string | "POSTGRES" | Moteur de base de données Cloud SQL. NONE ignore le provisionnement de la base de données. Les alias génériques (POSTGRES, MYSQL) déploient la dernière version prise en charge. Les valeurs avec version figée (par ex. POSTGRES_17, MYSQL_8_4) sont recommandées pour la production. Modifier cette valeur après le déploiement initial remplace l'instance Cloud SQL et entraîne une perte de données. |
sql_instance_name | string | "" | Nom d'une instance Cloud SQL existante à utiliser directement. Laissez vide pour découvrir automatiquement une instance gérée par Services GCP ou pour provisionner une instance intégrée (inline). |
sql_instance_base_name | string | "app-sql" | Nom de base pour l'instance Cloud SQL intégrée (inline) créée lorsqu'aucune instance existante n'est trouvée. L'ID de déploiement est ajouté automatiquement. |
application_database_name | string | "gkeappdb" | Nom de la base de données créée au sein de l'instance Cloud SQL. Injecté dans le pod sous la forme DB_NAME. Ne modifiez jamais après le déploiement initial. |
application_database_user | string | "gkeappuser" | Nom d'utilisateur de la base de données créé pour l'application. Injecté sous la forme DB_USER. |
database_password_length | number | 32 | Longueur du mot de passe utilisateur généré aléatoirement pour la base de données. Plage valide : 16–64. Des mots de passe plus longs offrent une plus grande entropie. |
db_password_env_var_name | string | "" | Nom de variable d'environnement supplémentaire pour exposer le mot de passe de la base de données aux côtés du nom standard DB_PASSWORD. Défini par les modules wrappers pour les applications qui attendent un nom non standard (par ex. WORDPRESS_DB_PASSWORD). |
enable_postgres_extensions | bool | false | Active l'installation des extensions PostgreSQL listées dans postgres_extensions après le provisionnement de la base de données. S'applique uniquement aux types de bases de données PostgreSQL. Remarque : utilisé pour la validation des entrées uniquement lors d'un déploiement autonome — les extensions sont injectées depuis la configuration du module d'application lorsqu'il est appelé depuis un wrapper. |
postgres_extensions | list(string) | [] | Extensions PostgreSQL à installer. Requiert enable_postgres_extensions = true et un database_type PostgreSQL. Valeurs courantes : postgis, uuid-ossp, pg_trgm, pgcrypto. |
enable_mysql_plugins | bool | false | Active l'installation de plugins MySQL. S'applique uniquement aux types de bases de données MySQL. Remarque : utilisé pour la validation des entrées uniquement lors d'un déploiement autonome. |
mysql_plugins | list(string) | [] | Plugins MySQL à installer. Requiert enable_mysql_plugins = true et un database_type MySQL. Valeurs courantes : audit_log, validate_password. |
enable_auto_password_rotation | bool | false | Active la rotation automatique du mot de passe utilisateur de la base de données via un CronJob Kubernetes et un déclencheur Eventarc. La fréquence de rotation est régie par secret_rotation_period. S'applique uniquement lorsque database_type n'est pas NONE. |
rotation_propagation_delay_sec | number | 90 | Nombre de secondes à attendre après l'écriture d'un nouveau mot de passe de base de données dans Secret Manager avant de redémarrer les pods GKE. Permet à la réplication globale de Secret Manager de se terminer. Augmentez cette valeur pour les applications à forte concurrence. Utilisé uniquement lorsque enable_auto_password_rotation est à true. |
db_host_env_var_name | string | "" | Nom de variable d'environnement supplémentaire pour exposer l'hôte de la base de données aux côtés du nom standard DB_HOST. Défini par les modules wrappers pour les applications qui attendent un nom non standard (par ex. DB_HOSTNAME). |
db_user_env_var_name | string | "" | Nom de variable d'environnement supplémentaire pour exposer l'utilisateur de la base de données aux côtés du nom standard DB_USER. (par ex. DB_USERNAME) |
db_name_env_var_name | string | "" | Nom de variable d'environnement supplémentaire pour exposer le nom de la base de données aux côtés du nom standard DB_NAME. (par ex. DB_DATABASE) |
db_port_env_var_name | string | "" | Nom de variable d'environnement supplémentaire pour exposer le port de la base de données aux côtés du nom standard DB_PORT. (par ex. DB_PORT_NUMBER) |
Exploration dans GCP — Groupe 16
Google Cloud Console :
- Instance Cloud SQL : Accédez à SQL pour confirmer que l'instance existe, sa version de moteur, sa région et son nom de connexion.
- Bases de données et utilisateurs : Cliquez sur l'instance, puis sélectionnez les onglets Databases et Users.
- Identifiants de la base de données dans Secret Manager : Accédez à Security → Secret Manager et filtrez par le nom de l'application pour trouver le secret
DB_PASSWORD. - Variables d'environnement de la BDD sur les pods : Utilisez
kubectl execpour inspecter les variables d'environnement des pods pourDB_HOST,DB_NAME,DB_USER.
kubectl / gcloud CLI :
# List Cloud SQL instances in the project
gcloud sql instances list --project=PROJECT_ID \
  --format="table(name,databaseVersion,region,settings.tier,state)"

# List databases on a Cloud SQL instance
gcloud sql databases list --instance=INSTANCE_NAME \
  --project=PROJECT_ID --format="table(name,charset)"

# List users on a Cloud SQL instance
gcloud sql users list --instance=INSTANCE_NAME \
  --project=PROJECT_ID --format="table(name,host,type)"

# Verify DB environment variables in a pod
kubectl exec -n NAMESPACE POD_NAME -- env | grep DB_

# List Secret Manager secrets related to the database
gcloud secrets list --project=PROJECT_ID \
  --filter="name:db" --format="table(name,createTime)"
Groupe 17 — Sauvegarde et maintenance
Ces variables configurent la planification des sauvegardes automatisées de base de données et l'importation ponctuelle de sauvegardes.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
backup_schedule | string | "0 2 * * *" | Expression cron définissant le moment où s'exécute le job Kubernetes de sauvegarde automatisée de la base de données. Utilise le format cron Unix standard en UTC. Exemple : "0 2 * * *" pour une exécution quotidienne à 02:00 UTC. S'applique uniquement lorsque database_type n'est pas NONE. |
backup_retention_days | number | 7 | Nombre de jours de rétention des fichiers de sauvegarde dans le bucket GCS de sauvegarde avant suppression automatique. Utilisez 7 pour le développement, 30–90 pour la production selon les exigences de conformité. |
enable_backup_import | bool | false | Déclenche un job Kubernetes d'importation ponctuelle de base de données pendant le déploiement, en restaurant le fichier de sauvegarde spécifié par backup_file. Redéfinissez immédiatement sur false après une restauration réussie — le laisser à true écrasera la base de données active avec la sauvegarde obsolète à chaque déploiement ultérieur. |
backup_source | string | "gcs" | Source à partir de laquelle le fichier de sauvegarde est récupéré. gcs effectue l'import depuis le bucket de sauvegarde GCS provisionné par le module ; gdrive effectue l'import depuis Google Drive. |
backup_file | string | "backup.sql" | Nom de fichier de la sauvegarde à importer. Doit exister dans la source configurée avant le déploiement. Exemple : "backup-2024-01-15.sql.gz". |
backup_format | string | "sql" | Format du fichier de sauvegarde. Options : sql, tar, gz, tgz, tar.gz, zip, auto. Utilisez auto pour le détecter à partir de l'extension de fichier. |
Exploration dans GCP — Groupe 17
Google Cloud Console :
- CronJob de sauvegarde : Accédez à Kubernetes Engine → Workloads et filtrez par ressources
CronJobpour trouver le job de sauvegarde et son calendrier. - Fichiers de sauvegarde (bucket GCS) : Accédez à Cloud Storage → Buckets et recherchez le bucket de sauvegarde. Confirmez que les fichiers de sauvegarde y sont écrits et que les règles de cycle de vie sont appliquées.
- Job d'importation : Accédez à Kubernetes Engine → Workloads → Jobs pour confirmer que le job d'import s'est terminé avec succès après avoir activé
enable_backup_import.
kubectl / gcloud CLI :
# List CronJobs in the namespace (includes backup job)
kubectl get cronjobs -n NAMESPACE

# View recent backup job runs
kubectl get jobs -n NAMESPACE --selector=app=BACKUP_JOB_NAME \
  --sort-by=.metadata.creationTimestamp

# Check backup job logs
kubectl logs -n NAMESPACE job/BACKUP_JOB_NAME

# List backup files in the GCS backup bucket
gcloud storage ls gs://BACKUP_BUCKET_NAME/ \
  --recursive --format="table(name,size,timeCreated)"

# View the lifecycle rules on the backup bucket
gcloud storage buckets describe gs://BACKUP_BUCKET_NAME \
  --format="yaml(lifecycle)"
Groupe 18 — Scripts SQL personnalisés
Ces variables permettent l'exécution de scripts SQL personnalisés sur la base de données de l'application pendant le déploiement.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_custom_sql_scripts | bool | false | Lorsque true, récupère les fichiers de scripts SQL depuis le bucket GCS et le chemin configurés, puis les exécute sur la base de données de l'application dans l'ordre lexicographique. Destiné aux migrations de schéma, à l'installation de procédures stockées ou au chargement de données initiales (seed) qui ne peuvent pas être pris en charge par le framework de migration de l'application. Concevez les scripts de manière idempotente (afin qu'ils puissent être exécutés plusieurs fois sans risque). |
custom_sql_scripts_bucket | string | "" | Nom du bucket GCS contenant les scripts SQL. Le compte de service de la charge de travail GKE doit disposer d'un accès en lecture à ce bucket. Requis lorsque enable_custom_sql_scripts est true. |
custom_sql_scripts_path | string | "" | Préfixe de chemin au sein du bucket GCS depuis lequel les scripts SQL sont récupérés. Tous les fichiers .sql sous ce préfixe sont exécutés par ordre lexicographique. Utilisez une convention de nommage telle que 001_create_tables.sql pour contrôler l'ordre d'exécution. |
custom_sql_scripts_use_root | bool | false | Exécute les scripts SQL personnalisés en tant qu'utilisateur root de la base de données au lieu de l'utilisateur applicatif. À activer uniquement lorsque les scripts requièrent des privilèges élevés (par exemple CREATE EXTENSION, CREATE ROLE). |
Exploration dans GCP — Groupe 18
Google Cloud Console :
- Job de scripts SQL : Accédez à Kubernetes Engine → Workloads → Jobs pour trouver le job de scripts SQL et consulter son historique d'exécution.
- Fichiers de script dans GCS : Accédez à Cloud Storage → Buckets → bucket des scripts pour confirmer que les fichiers
.sqlexistent au préfixe de chemin configuré.
CLI kubectl / gcloud :
# Check SQL scripts job completion
kubectl get job SQL_SCRIPTS_JOB_NAME -n NAMESPACE

# View SQL scripts job logs
kubectl logs -n NAMESPACE job/SQL_SCRIPTS_JOB_NAME

# Confirm script files exist in the GCS bucket
gcloud storage ls gs://BUCKET_NAME/SCRIPTS_PATH --recursive

# Check the GKE workload SA has access to the scripts bucket
gcloud storage buckets get-iam-policy gs://BUCKET_NAME \
  --format="table(bindings.role,bindings.members)"
Choisir le mode d'exposition de la charge de travail. Le mode d'exposition est la décision clé et couvre les groupes 19 à 21. Un simple
ClusterIP/LoadBalancerservice_typevous attribue une adresse IP brute ; un domaine personnalisé (groupe 19) provisionne un certificat géré par Google via la Gateway/Ingress et nécessite un enregistrement DNS post-déploiement. Cloud Armor (groupe 21) — la couche WAF/DDoS — requiert soit un domaine personnalisé, soit un serviceLoadBalancer(contrôlé lors du plan) car il a besoin d'un point d'entrée externe pour y associer la stratégie, etenable_cdnne requiert pas de domaine personnalisé — la Gateway bascule sur un certificat HTTPS<ip>.nip.iodérivé. Pour les outils purement internes, privilégiez IAP (groupe 20) — mais IAP sur GKE nécessite un identifiant/secret client OAuth et une adresse e-mail d'assistance (tous obligatoires), configurez-les donc avant l'activation. Choisissez d'abord le modèle d'exposition, puis la couche de sécurité adaptée.
Groupe 19 — Accès et réseau
Ces variables contrôlent la configuration des domaines personnalisés, la réservation d'adresses IP statiques, les tags réseau et la sélection du réseau VPC.
Nom d'hôte
nip.iopar défaut. Avec la configuration par défautLoadBalancerservice_typeetreserve_static_ip = true, le déploiement dérive un nom d'hôte<reserved-ip>.nip.iopar défaut (nip.io est un DNS générique qui résout<ip>.nip.io→ cette adresse IP). Cela fournit à chaque déploiement GKE par défaut un nom d'hôte fonctionnel dès l'initialisation — utilisé comme hôte pour le test de disponibilité Cloud Monitoring et comme URL pratique pour navigateur — sans aucune configuration DNS. Renseignezapplication_domains(avecenable_custom_domain = truepour le SSL Gateway) afin d'utiliser votre propre domaine à la place ; le test de disponibilité interrogera alors ce domaine.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_custom_domain | bool | false | Provisionne une ressource Ingress de la Gateway API Kubernetes afin de router le trafic en utilisant les noms d'hôte personnalisés spécifiés dans application_domains. Requis pour la terminaison SSL d'un domaine personnalisé via Certificate Manager. |
application_domains | list(string) | [] | Noms de domaine personnalisés à associer à la Gateway de l'application. Le DNS doit être configuré pour pointer chaque domaine vers l'adresse IP de l'équilibreur de charge après le déploiement. Utilisé uniquement lorsque enable_custom_domain est true. |
reserve_static_ip | bool | true | Provisionne une adresse IP externe statique pour l'équilibreur de charge. Fortement recommandé pour la production — garantit une IP stable vers laquelle les enregistrements DNS peuvent pointer de manière fiable. Lorsque false, l'équilibreur de charge reçoit une IP éphémère susceptible de changer lors d'un redéploiement. |
static_ip_name | string | "" | Nom personnalisé pour la ressource d'adresse IP statique. Laissez vide pour une génération automatique. |
network_name | string | "" | Nom du réseau VPC à utiliser pour ce déploiement. Laissez vide pour détecter automatiquement un réseau unique géré par Services GCP. Requis lorsque plusieurs réseaux gérés par Services GCP existent dans le projet. |
network_tags | list(string) | ["nfsserver"] | Tags réseau appliqués aux nœuds et pods GKE. Utilisés pour cibler les règles de pare-feu VPC. Le tag par défaut nfsserver est requis pour la connectivité NFS lorsque enable_nfs est true. |
Exploration dans GCP — Groupe 19
Google Cloud Console :
- Gateway et Ingress : Accédez à Kubernetes Engine → Services & Ingress → Gateways, Ingresses & Routes pour afficher la ressource Gateway et ses HTTPRoutes.
- IP statique : Accédez à VPC Network → IP addresses pour vérifier que l'IP statique est réservée et connaître son adresse.
- Certificats SSL : Accédez à Certificate Manager → Certificates pour afficher les certificats SSL gérés et leur état de provisionnement.
- Configuration DNS : Utilisez votre bureau d'enregistrement de domaine ou Cloud DNS pour vérifier que les enregistrements
Apointent vers l'IP de l'équilibreur de charge.
CLI kubectl / gcloud :
# View the Gateway resource
kubectl get gateway -n NAMESPACE

# Describe the Gateway to see IP address and routes
kubectl describe gateway APPLICATION_NAME-gateway -n NAMESPACE

# Check certificate provisioning status
gcloud certificate-manager certificates list --project=PROJECT_ID \
  --format="table(name,managed.domains,managed.state)"

# View reserved static IP addresses
gcloud compute addresses list --project=PROJECT_ID \
  --format="table(name,address,addressType,status,region)"

# Verify DNS resolution to the load balancer IP
dig +short DOMAIN_NAME
Groupe 20 — Identity-Aware Proxy
Ces variables configurent Identity-Aware Proxy (IAP) devant l'application à l'aide de la ressource GCPBackendPolicy de la Gateway API GKE. IAP impose une authentification par identité Google avant que les utilisateurs ne puissent accéder à l'application — aucune modification du code applicatif n'est requise.
Remarque : IAP sur GKE nécessite des identifiants OAuth 2.0 créés au préalable. Contrairement à Cloud Run, ceux-ci ne peuvent pas être générés automatiquement par le module.
iap_oauth_client_idetiap_oauth_client_secretdoivent tous deux être créés manuellement dans APIs & Services → Credentials avant d'activer IAP.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_iap | bool | false | Active Identity-Aware Proxy pour l'application via GCPBackendPolicy sur la Gateway. Lorsque true, configurez iap_authorized_users et iap_authorized_groups avant l'activation — une liste d'autorisation vide renverra une erreur HTTP 403 sur 100 % des requêtes. |
iap_authorized_users | list(string) | [] | Utilisateurs individuels ou comptes de service autorisés à accéder via IAP. Format : "user:email@example.com" ou "serviceAccount:sa@project.iam.gserviceaccount.com". Actif uniquement lorsque enable_iap est true. |
iap_authorized_groups | list(string) | [] | Groupes Google autorisés à accéder via IAP. Format : "group:name@example.com". Préféré aux utilisateurs individuels pour la gestion des accès au niveau de l'équipe. Actif uniquement lorsque enable_iap est true. |
iap_oauth_client_id | string | "" | Client ID OAuth 2.0 pour le service de backend IAP. Doit être créé au préalable dans la console GCP. Requis lorsque enable_iap est true. |
iap_oauth_client_secret | string | "" | Client Secret OAuth 2.0 correspondant à iap_oauth_client_id. Requis lorsque enable_iap est true. Traité comme sensible. |
iap_support_email | string | "" | Adresse e-mail d'assistance affichée sur l'écran de consentement OAuth. Requise lorsque enable_iap est true. Doit être une adresse e-mail ou un groupe Google valide. |
Exploration dans GCP — Groupe 20
Google Cloud Console :
- État d'IAP : Accédez à Security → Identity-Aware Proxy pour vérifier que le backend est répertorié avec IAP activé.
- Membres autorisés : Cliquez sur l'entrée du backend et consultez l'onglet Principals pour vérifier que les utilisateurs et groupes attendus disposent de l'accès
IAP-secured Web App User. - GCPBackendPolicy : Accédez à Kubernetes Engine → Workloads et recherchez la ressource
GCPBackendPolicydans l'espace de noms.
CLI kubectl / gcloud :
# View the GCPBackendPolicy to confirm IAP configuration
kubectl get gcpbackendpolicy -n NAMESPACE -o yaml

# Check IAM bindings for IAP on the backend service
gcloud compute backend-services list --project=PROJECT_ID \
  --format="table(name,iap.enabled,iap.oauth2ClientId)"

# List IAP-enabled resources
gcloud iap web get-iam-policy \
  --resource-type=backend-services \
  --service=BACKEND_SERVICE_NAME \
  --project=PROJECT_ID \
  --format="table(bindings.role,bindings.members)"
Groupe 21 — Cloud Armor et CDN
Ces variables configurent une stratégie de sécurité WAF Cloud Armor associée au backend de la Gateway GKE, ainsi qu'en option Cloud CDN via l'équilibreur de charge de la Gateway API.
Remarque : Sur GKE, seul Cloud CDN est mutuellement exclusif avec IAP sur le même backend de Gateway (
iap.tfrequiertenable_cdn = false). Cloud Armor ne l'est pas — c'est en réalité la méthode recommandée pour satisfaire l'exigence de Gateway HTTPS d'IAP sans posséder de nom de domaine, car il active la Gateway et obtient un certificatnip.iosans aucune configuration.
Remarque sur le CDN : La CRD
GCPBackendPolicyn'expose pas de champ de configuration CDN. Après un déploiement avecenable_cdn = true, Cloud CDN doit être activé hors bande sur le service de backend viagcloud compute backend-services update --enable-cdnou en associant une ressourceGCPHTTPFiltersur les versions de GKE compatibles.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_cloud_armor | bool | false | Associe une stratégie de sécurité Cloud Armor au backend de la Gateway GKE, activant les règles WAF, la protection anti-DDoS et les contrôles d'accès basés sur l'adresse IP. Nécessite enable_custom_domain = true ou service_type = "LoadBalancer". |
admin_ip_ranges | list(string) | [] | Plages IP CIDR exemptées des règles WAF de Cloud Armor. Généralement utilisées pour les réseaux d'exploitation approuvés ou les systèmes CI/CD. Efficace uniquement lorsque enable_cloud_armor est true. Également utilisé comme niveau d'accès administrateur dans les périmètres VPC-SC — une liste vide entraîne l'omission du provisionnement de VPC-SC avec un avertissement. |
cloud_armor_policy_name | string | "default-waf-policy" | Nom de la stratégie de sécurité Cloud Armor à associer. À remplacer pour faire référence à une stratégie personnalisée. La stratégie intégrée (inline) comprend des règles contre les injections SQL (SQLi), XSS, LFI, RCE, ainsi qu'une limitation de débit (500 req/min par IP). |
enable_cdn | bool | false | Achemine l'application via l'équilibreur de charge de la Gateway API en vue de l'utilisation de Cloud CDN. Un domaine personnalisé n'est pas requis — la validation qui en exigeait autrefois un a été assouplie (validation.tf commentaire 20), car la Gateway provisionne HTTPS d'emblée via un certificat <ip>.nip.io dérivé. Voir la remarque ci-dessus concernant l'activation du CDN hors bande. |
Exploration dans GCP — Groupe 21
Google Cloud Console :
- Stratégie Cloud Armor : Accédez à Network security → Cloud Armor policies pour afficher la stratégie, ses règles et les services de backend associés.
- Backend de l'équilibreur de charge : Accédez à Network services → Load balancing pour confirmer que la stratégie Cloud Armor est associée au backend.
- État du CDN : Dans les détails du backend de l'équilibreur de charge, confirmez que Cloud CDN apparaît comme activé.
CLI gcloud :
# List Cloud Armor security policies
gcloud compute security-policies list --project=PROJECT_ID \
  --format="table(name,description)"

# Describe a Cloud Armor policy and view its rules
gcloud compute security-policies describe POLICY_NAME \
  --project=PROJECT_ID --format="yaml(rules)"

# Check if Cloud CDN is enabled on a backend service
gcloud compute backend-services describe BACKEND_SERVICE_NAME \
  --global --format="yaml(enableCDN,securityPolicy)"

# Enable Cloud CDN on a backend service (out-of-band activation)
# gcloud compute backend-services update BACKEND_SERVICE_NAME \
#   --global --enable-cdn
Groupe 22 — VPC Service Controls et journalisation d'audit
Ces variables contrôlent l'application du périmètre VPC Service Controls (VPC-SC) et la journalisation d'audit au niveau du projet.
Remarque : Déployez d'abord VPC-SC en mode simulation (dry-run) (
vpc_sc_dry_run = true, valeur par défaut). Examinez les journaux d'infractions du mode simulation avant de passer en mode d'application stricte. VPC-SC nécessite une organisation GCP — les projets autonomes n'ont pas d'organisation et le périmètre est ignoré silencieusement avec un avertissement.
| Variable | Type | Valeur par défaut | Description |
|---|---|---|---|
enable_vpc_sc | bool | false | Lorsque true, provisionne un périmètre VPC-SC autour des API GCP utilisées par ce module. Restreint l'accès aux API à l'intérieur du VPC et aux identités approuvées, empêchant ainsi l'exfiltration de données. Ignoré automatiquement avec un avertissement pour les projets autonomes, les projets imbriqués dans des dossiers sans organization_id, et les déploiements dont admin_ip_ranges est vide. |
vpc_cidr_ranges | list(string) | [] | Plages CIDR des sous-réseaux VPC pour le niveau d'accès réseau VPC-SC. Lorsqu'elles sont vides, les sous-réseaux sont automatiquement détectés à partir du réseau VPC. |
vpc_sc_dry_run | bool | true | Lorsque true, les infractions à VPC-SC sont consignées dans les journaux mais ne sont pas bloquées. Ne définissez sur false qu'après avoir vérifié que les journaux de simulation sont exempts de refus involontaires. |
organization_id | string | "" | ID de l'organisation GCP pour la stratégie Access Context Manager de VPC-SC. Détecté automatiquement à partir du projet lorsqu'il est vide. Doit être défini explicitement lorsque le projet est imbriqué dans un dossier. |
enable_audit_logging | bool | false | Active les journaux d'audit détaillés Cloud Audit Logs (DATA_READ, DATA_WRITE, ADMIN_READ) pour tous les services GCP du projet, ainsi que des surcharges spécifiques pour Secret Manager et Cloud KMS. Recommandé pour les environnements soumis à des contraintes de conformité (PCI-DSS, HIPAA, SOC 2). Augmente les coûts de Cloud Logging. |
Exploration dans GCP — Groupe 22
Google Cloud Console :
- Périmètre VPC-SC : Accédez à Security → VPC Service Controls pour vérifier que le périmètre existe et consulter la liste des services restreints.
- Infractions en mode simulation (dry-run) : Accédez à Logging → Logs Explorer et filtrez par
VpcServiceControlAuditMetadatapour identifier les appels d'API refusés. - Journalisation d'audit : Accédez à IAM & Admin → Audit Logs pour confirmer que
Admin Read,Data ReadetData Writesont activés.
CLI gcloud :
# List VPC-SC access policies in the organization
gcloud access-context-manager policies list \
  --organization=ORGANIZATION_ID

# List VPC-SC perimeters under the access policy
gcloud access-context-manager perimeters list \
  --policy=POLICY_NAME \
  --format="table(name,status.resources,status.restrictedServices)"

# Check VPC-SC dry-run violation logs
gcloud logging read \
  'protoPayload.metadata.@type="type.googleapis.com/google.cloud.audit.VpcServiceControlAuditMetadata"' \
  --project=PROJECT_ID --limit=20 \
  --format="table(timestamp,protoPayload.serviceName,protoPayload.methodName,protoPayload.metadata.dryRun)"

# Confirm project-level audit config
gcloud projects get-iam-policy PROJECT_ID \
  --format="yaml(auditConfigs)"
Prérequis de déploiement et analyse des dépendances
Cette section récapitule chaque dépendance externe nécessaire au déploiement de App GKE. Les dépendances sont regroupées selon leur mode de défaillance.
Notation : Auto-provisionné signifie que le module crée la ressource automatiquement lors du premier déploiement — aucun prérequis manuel n'est nécessaire.
Niveau 1 — Prérequis stricts
Ces configurations empêcheront le déploiement d'aboutir, ou empêcheront la charge de travail GKE d'atteindre un état sain, si le prérequis indiqué n'est pas satisfait.
| Fonctionnalité | Variable(s) | Exigence |
|---|---|---|
| Références à Secret Manager | secret_environment_variables | Chaque secret nommé dans la map doit exister dans Secret Manager avant le déploiement. Créez d'abord le secret, puis déployez. |
| Scripts SQL personnalisés | enable_custom_sql_scripts = true | Le bucket GCS défini dans custom_sql_scripts_bucket doit exister et tous les fichiers .sql doivent être téléversés vers custom_sql_scripts_path avant le déploiement. |
| Importation d'une sauvegarde de base de données | enable_backup_import = true | Le fichier de sauvegarde nommé dans backup_file doit exister à la source configurée (bucket de sauvegarde GCS ou Google Drive) avant le déploiement. Un fichier manquant entraîne l'échec immédiat du job Kubernetes d'importation. |
| Pipeline CI/CD | enable_cicd_trigger = true | Un dépôt GitHub doit être accessible et soit un Personal Access Token GitHub (portées : repo, admin:repo_hook), soit un ID d'installation GitHub App doit être fourni. |
| Build de conteneur personnalisé | container_image_source = "custom" | Nécessite la même connexion au dépôt GitHub et les mêmes identifiants que enable_cicd_trigger. Cloud Build échoue si le dépôt est inaccessible. |
| IAP | enable_iap = true | Client ID et secret OAuth 2.0 créés au préalable depuis APIs & Services → Credentials. Contrairement à Cloud Run, ceux-ci ne peuvent pas être générés automatiquement. Un écran de consentement OAuth doit exister avant que la ressource GCPBackendPolicy ne puisse être créée. |
| VPC Service Controls (projets imbriqués dans un dossier) | enable_vpc_sc = true + projet imbriqué dans un dossier | organization_id doit être fourni explicitement pour les projets imbriqués dans un dossier — la détection automatique est désactivée. Sans cela, le périmètre est ignoré avec un avertissement. |
| VPC Service Controls (protection contre le blocage de l'administrateur) | enable_vpc_sc = true | admin_ip_ranges doit contenir au moins une plage CIDR. Une liste vide entraîne l'omission du périmètre afin d'éviter un blocage de l'administrateur. |
| GKE intégré (inline) — second apply requis | Provisionnement d'un cluster GKE intégré (inline) | Lors du premier déploiement d'un cluster GKE intégré, la sortie kubernetes_ready vaut false — le cluster est créé mais son point de terminaison n'est pas encore lisible, de sorte que toutes les ressources Kubernetes sont ignorées. Le pipeline CI/CD doit détecter cette valeur et exécuter un second déploiement pour finaliser le déploiement de l'application. |
Niveau 2 — Défaillances silencieuses
Ces configurations se déploient avec succès mais ne fonctionneront pas correctement au moment de l'exécution.
| Fonctionnalité | Variable(s) | Mode de défaillance | Résolution |
|---|---|---|---|
| Cache Redis | enable_redis = true + redis_host explicite | REDIS_HOST et REDIS_PORT sont injectés dans le pod, mais l'application ne peut pas se connecter si aucun service Redis n'existe à l'adresse spécifiée. Le déploiement réussit sans erreur. | Provisionnez une instance Cloud Memorystore ou déployez Services GCP, qui fournit une instance partagée détectée automatiquement lorsque redis_host est vide. |
| Rotation des secrets | secret_rotation_period | La notification de rotation Pub/Sub se déclenche à l'intervalle configuré, mais aucune valeur de secret n'est réellement modifiée. La notification n'est qu'un déclencheur — un gestionnaire doit être implémenté séparément. | Utilisez enable_auto_password_rotation = true pour le mot de passe de base de données (géré automatiquement), ou implémentez une Cloud Function ou un CronJob Kubernetes distinct pour faire tourner les autres secrets. |
| Maillage de services (Service mesh) | configure_service_mesh = true (cluster externe) | Le label d'espace de noms istio-injection: enabled est appliqué, mais aucun plan de contrôle Istio ne le dessert si ASM n'est pas exécuté sur le cluster. Les pods démarrent mais les conteneurs sidecars restent dans l'état ContainerCreating. | Vérifiez que Cloud Service Mesh ou Anthos Service Mesh est installé et opérationnel sur le cluster cible avant l'activation. |
Niveau 3 — Prérequis souples
Ces fonctionnalités se déploient avec succès mais nécessitent une étape manuelle avant d'être pleinement opérationnelles.
| Fonctionnalité | Variable(s) | Action requise |
|---|---|---|
| Domaine personnalisé | application_domains (avec enable_custom_domain = true) | Après le déploiement, créez des enregistrements DNS A pour chaque domaine pointant vers l'adresse IP externe de l'équilibreur de charge (indiquée dans les sorties du déploiement). Le provisionnement du certificat SSL géré par Google démarre automatiquement après la propagation DNS et se termine généralement en 10 à 60 minutes. |
| Cloud CDN | enable_cdn = true | Après le déploiement, activez Cloud CDN hors bande sur le service de backend de la Gateway : gcloud compute backend-services update BACKEND_NAME --global --enable-cdn. Le module ne peut pas activer le CDN lui-même en raison d'une limitation de la CRD GCPBackendPolicy. |
| Mise à disposition du fichier de sauvegarde | enable_backup_import = true | Le fichier de sauvegarde doit être téléversé dans le bucket de sauvegarde GCS (ou Google Drive) avant le déploiement qui active cet indicateur. |
Auparavant manuelles — Désormais auto-provisionnées
| Fonctionnalité | Variable(s) | Comment elle est désormais gérée |
|---|---|---|
| Attestateur, stratégie et clé KMS Binary Authorization | enable_binary_authorization = true | App_Common/modules/app_security crée de manière idempotente le trousseau de clés de signature KMS, la clé binauthz-signer, la note pipeline-attestor, l'attestateur et la stratégie Binary Authorization. Si Services GCP a provisionné ces ressources en premier, les scripts les détectent et les réutilisent. |
| Trousseau de clés CMEK pour le chiffrement du stockage | manage_storage_kms_iam = true | App_Common/modules/app_cmek crée de manière idempotente le trousseau ${project_id}-cmek-keyring et la CryptoKey storage-key avant que la liaison IAM de stockage ne soit appliquée. Peut être activé en toute sécurité dès le premier déploiement. |
| Périmètre VPC Service Controls | enable_vpc_sc = true | App_Common/modules/app_vpc_sc détecte automatiquement l'ID de l'organisation, réutilise toute stratégie Access Context Manager existante, provisionne quatre niveaux d'accès par déploiement (VPC, adresses IP administrateur, IAP, CI/CD) et crée un périmètre de service PERIMETER_TYPE_REGULAR. La valeur par défaut est vpc_sc_dry_run = true. |
Dépendance envers Services GCP pour les ressources partagées
Services GCP est déclaré comme une dépendance de module, mais il n'est pas obligatoire pour un déploiement autonome. Le module auto-provisionne toute l'infrastructure nécessaire de manière intégrée (inline) lorsque Services GCP n'a pas été déployé. Cependant, il est fortement recommandé de déployer Services GCP en premier lieu lorsque plusieurs modules applicatifs partagent le même projet GCP.
| Ressource | Sans Services GCP | Avec Services GCP |
|---|---|---|
| Réseau VPC | Le module auto-provisionne un VPC intégré, un sous-réseau, Cloud NAT et Cloud Router. | Le module se rattache au VPC partagé géré de manière centralisée. Simplifie la gestion du pare-feu et évite la consommation de quota VPC par projet. |
| Cluster GKE | Le module auto-provisionne un cluster GKE Autopilot intégré à l'aide de prereq_gke_subnet_cidr. Un second run de déploiement est nécessaire pour déployer les ressources applicatives une fois le cluster prêt. | Le module détecte automatiquement et cible le cluster GKE partagé. Pas de création de cluster ni de second run requis. |
| Instance Cloud SQL | Le module auto-provisionne une instance Cloud SQL dédiée par déploiement. Chaque déploiement supporte le coût total de l'instance. | Le module détecte automatiquement l'instance Cloud SQL partagée et s'y connecte, ne provisionnant qu'une base de données et un utilisateur distincts au sein de celle-ci. Élimine le coût d'une instance par déploiement. |
| NFS / Filestore | Le module auto-provisionne une VM GCE NFS intégrée. Point de défaillance unique sans sauvegardes gérées. | Le module détecte automatiquement l'instance Filestore gérée de manière centralisée. NFS de niveau entreprise avec débit garanti et snapshots gérés. |
| Redis / Memorystore | enable_redis = true avec un champ redis_host vide bascule sur l'adresse IP de la VM NFS. Requiert un service compatible Redis en cours d'exécution sur cette VM. | Le module détecte automatiquement l'instance Memorystore partagée. redis_host peut être laissé vide. |
| Artifact Registry | Le module auto-crée un dépôt Artifact Registry par déploiement. | Le module détecte automatiquement et utilise le registre partagé, permettant la réutilisation des images et une analyse cohérente des vulnérabilités entre les déploiements. |
Pièges de configuration et valeurs par défaut judicieuses
Niveaux de risque : Critique (perte de données, panne totale ou faille de sécurité) — Élevé (service indisponible ou dégradation importante) — Moyen (fonctionnement dégradé ou augmentation des coûts) — Faible (impact mineur).
De nombreuses combinaisons non valides sont interceptées lors du plan. Le module intègre 34 préconditions entre variables dans
validation.tf, ainsi que des blocsvalidationpar variable et 3 préconditions supplémentaires situées à côté des ressources qu'elles protègent (deployment.tf,iap.tf,prerequisites.tf). Ainsi, une large catégorie d'erreurs de configuration fait échouer le plan avec une erreur claire et explicite avant qu'aucune ressource ne soit créée. Les lignes ci-dessous marquées du libellé 🛡 plan-time sont rejetées dès le départ — vous n'atteignez jamais la conséquence. Les lignes non marquées représentent des aléas d'exécution ou opérationnels (un mauvais port, un changement de CIDR, un renommage destructeur) que le module ne peut pas déterminer à votre place. Un plan sans erreur confirme que les règles sur les valeurs/combinaisons sont respectées ; il ne garantit pas qu'un port corresponde à votre application ou qu'un renommage soit intentionnel.
| Variable | Valeurs par défaut judicieuses | Risque | Conséquence d'une valeur incorrecte |
|---|---|---|---|
container_image_source + container_image | "custom" (build depuis les sources), ou "prebuilt" avec un container_image non vide | Élevé 🛡 plan-time | "prebuilt" avec un container_image vide ne dispose d'aucun URI d'image à déployer — désormais rejeté lors du plan. |
mount_nfs (jobs) + enable_nfs | Activer NFS dès qu'un job le monte | Élevé 🛡 plan-time | Un job avec mount_nfs = true alors que enable_nfs = false (et sans serveur NFS détectable) référence un volume inexistant — désormais rejeté lors du plan. |
enable_postgres_extensions / enable_mysql_plugins + database_type | Faire correspondre l'option à la famille de moteur | Moyen 🛡 plan-time | L'activation des extensions Postgres sur un moteur MySQL (ou vice versa) est rejetée lors du plan. (Défaut corrigé : la liste d'autorisation MySQL inclut désormais correctement MYSQL_8_0, rejeté par erreur auparavant). |
redis_port | "6379" | Faible 🛡 plan-time | Un port non numérique ou hors plage est rejeté lors du plan plutôt que de produire un REDIS_PORT inaccessible. |
application_name | Court, en minuscules, compatible avec les traits d'union (ex. "myapp", "payments-api") | Critique | Intégré dans chaque nom de ressource GCP et Kubernetes (espace de noms, services, secrets, instance SQL, buckets GCS). Ne modifiez jamais après le premier déploiement — toutes les ressources nommées sont détruites et recréées, provoquant une perte totale de données et une nouvelle base de données vide. |
tenant_id | Correspondre à l'environnement : "prod", "staging", "dev" | Critique | Intégré dans tous les noms de ressources aux côtés de application_name. Ne modifiez jamais après le premier déploiement — même conséquence que la modification de application_name : recréation complète des ressources, perte de données et un nouveau déploiement vide fonctionnant à côté de l'ancien devenu orphelin. |
quota_memory_requests / quota_memory_limits | Suffixe d'unité binaire obligatoire : "4Gi", "8192Mi" — jamais un entier seul | Critique | Un entier seul tel que "4" est interprété par Kubernetes comme 4 octets. Le ResourceQuota est créé mais chaque pod est rejeté au moment de l'ordonnancement avec exceeded quota: requests.memory. L'espace de noms est de fait inutilisable jusqu'à ce que le quota soit corrigé. |
stateful_pvc_enabled + workload_type | stateful_pvc_enabled = true se résout automatiquement en StatefulSet — ne définissez pas également workload_type = "Deployment" | Critique | stateful_pvc_enabled = true avec workload_type = "Deployment" échoue à la validation lors du plan. Terraform refuse de faire le apply. |
container_port | Doit correspondre exactement au port sur lequel le serveur applicatif écoute (ex. 8080, 3000, 5000) | Critique | Non-concordance de port : les sondes de vivacité et de disponibilité (readiness) de Kubernetes échouent sur chaque pod. Tous les pods entrent dans une boucle de redémarrage CrashLoopBackOff. Le Deployment n'atteint jamais Ready. Le service est hors ligne. |
prereq_gke_subnet_cidr | "10.201.0.0/24" — figer sur la valeur appliquée et ne jamais la modifier | Critique | Une modification après la création du cluster GKE intégré détruit et recrée le sous-réseau, ce qui force le remplacement du cluster GKE. Toutes les charges de travail sur le cluster sont perdues. Les CIDR doivent être uniques parmi tous les déploiements GKE du projet — des CIDR qui se chevauchent entraînent des échecs d'appairage VPC. |
prereq_subnet_cidr_override | "" au départ ; figer sur la valeur CIDR issue de la sortie du premier déploiement pour tous les déploiements suivants | Critique | Laissé vide lors des déploiements ultérieurs lorsque le sous-réseau VPC intégré existe déjà : Terraform peut réassigner automatiquement un nouveau CIDR, déclenchant le remplacement du sous-réseau qui force la recréation du cluster GKE et une perte totale de données. |
enable_iap + iap_oauth_client_id / iap_oauth_client_secret | Les deux identifiants OAuth doivent être créés au préalable avant d'activer IAP | Critique | enable_iap = true sans iap_oauth_client_id et iap_oauth_client_secret valides : le déploiement de GCPBackendPolicy échoue. Aucun trafic n'est routé. IAP sur GKE nécessite des identifiants OAuth créés au préalable — contrairement à Cloud Run IAP, ils ne peuvent pas être générés automatiquement. |
enable_iap + iap_authorized_users / iap_authorized_groups | Renseignez toujours au moins un utilisateur ou groupe avant d'activer IAP | Critique | enable_iap = true avec des listes d'utilisateurs et de groupes vides : 100 % des requêtes renvoient une erreur HTTP 403. Le service est déployé et joignable, mais aucune identité n'est autorisée à y accéder. |
binauthz_evaluation_mode | "ALWAYS_ALLOW" jusqu'à ce que le pipeline CI produise des attestations valides ; puis "REQUIRE_ATTESTATION" | Critique | "REQUIRE_ATTESTATION" avant la mise en place des attestations : tous les déploiements de pods sont bloqués avec Image is not attested dans les événements de pod. Les retours arrière d'urgence sont également bloqués. "ALWAYS_DENY" bloque tous les déploiements, y compris les correctifs urgents. |
enable_vpc_sc + vpc_sc_dry_run | Toujours activer avec vpc_sc_dry_run = true en premier ; examiner les journaux d'audit avant d'appliquer strictement | Critique | vpc_sc_dry_run = false dès la première activation sans validation préalable : les téléchargements d'images des nœuds GKE depuis Artifact Registry, les appels Cloud SQL Auth Proxy et les lectures Secret Manager peuvent tous échouer simultanément. |
cloud_deploy_stages étape prod | require_approval = true sur l'étape de production | Critique | require_approval = false avec auto_promote = true sur la prod : un déploiement réussi en staging est automatiquement promu en production sans validation humaine. Une migration défectueuse ou une mauvaise image atteint automatiquement la production. |
enable_backup_import | false (défaut) — définir true uniquement pour l'unique déploiement où vous souhaitez restaurer | Critique | Laisser enable_backup_import = true après une restauration réussie : le job Kubernetes d'importation s'exécute à nouveau à chaque déploiement, écrasant la base de données active avec le fichier de sauvegarde obsolète. Repassez à false immédiatement après une restauration réussie. |
session_affinity | "ClientIP" pour les applications avec état (stateful) nécessitant des sessions persistantes | Élevé | "None" pour une application avec état : les requêtes sont réparties aléatoirement entre les pods, entraînant une perte de session — les utilisateurs sont déconnectés ou rencontrent des dysfonctionnements dans les processus multi-étapes. |
enable_pod_disruption_budget | true — toujours laisser activé en production | Élevé | false : lors des mises à niveau des nœuds GKE Autopilot, tous les pods peuvent être expulsés simultanément. Avec min_instance_count = 1, l'unique pod est expulsé et l'application devient totalement indisponible pendant la mise à niveau. |
pdb_min_available | "1" pour les charges multi-réplicas ; "0" pour les charges à réplica unique | Élevé | "1" avec un déploiement à réplica unique : GKE ne peut pas vider le nœud pour les mises à niveau — le budget ne peut jamais être satisfait avec un seul pod. Les mises à niveau des nœuds sont bloquées indéfiniment et le cluster accumule du retard sur les correctifs de sécurité. |
max_instance_count | Dimensionner selon ≤ Cloud SQL max_connections / connections_per_pod | Élevé | Trop élevé : épuise le pool de connexions Cloud SQL, provoquant FATAL: sorry, too many clients already pour tous les pods. Trop bas : limite le débit sous charge, provoquant une mise en file d'attente des requêtes et des pics de latence. |
enable_network_segmentation | false au départ ; n'activer qu'après avoir cartographié l'ensemble des flux de trafic inter-espaces de noms | Élevé | L'activer sans comprendre les schémas de trafic bloque les communications légitimes de pod à pod. Symptômes : les connexions à la base de données expirent, les jobs d'initialisation se bloquent, les sondes de santé échouent. Déboguez avec kubectl describe networkpolicy -n NAMESPACE. |
enable_image_mirroring | true (par défaut ; fortement recommandé) | Élevé | false : les nœuds GKE téléchargent les images depuis des registres externes. Les limites de débit de Docker Hub provoquent ErrImagePull lors des pics de déploiement. Dans les environnements VPC-SC, l'accès aux registres externes est bloqué — tous les démarrages de pods échouent. |
enable_resource_quota + quota_memory_* / quota_cpu_* | Définir des valeurs de quota ≥ à la somme des requêtes de tous les conteneurs dans l'espace de noms | Élevé | Valeurs inférieures aux demandes de ressources globales de la charge de travail : l'ordonnancement des pods échoue avec des événements exceeded quota. Les jobs d'initialisation et les CronJobs échouent également. L'espace de noms reste inutilisable tant que les quotas ne sont pas augmentés. |
enable_auto_password_rotation + rotation_propagation_delay_sec | N'activer qu'après avoir validé le pipeline de rotation ; conserver rotation_propagation_delay_sec ≥ 90 | Élevé | Trop court : l'ancien identifiant est révoqué avant que tous les pods n'aient redémarré avec la nouvelle version. L'épuisement du pool de connexions provoque des erreurs HTTP 500 jusqu'à ce que tous les pods terminent leur cycle de redémarrage. |
workload_type | "Deployment" pour les applications sans état ; "StatefulSet" pour celles nécessitant une identité de pod stable | Élevé | "Deployment" pour une charge nécessitant une identité de volume persistant : les pods reçoivent des PVC différents au redémarrage, provoquant des incohérences de données. "StatefulSet" pour une application sans état : surcoût d'ordonnancement inutile et mises à jour progressives plus lentes. |
Sortie kubernetes_ready | Vérifier cette sortie avant de faire dépendre des ressources Kubernetes dans un pipeline | Élevé | Lors du premier déploiement d'un cluster intégré, kubernetes_ready = false — toutes les ressources Kubernetes sont exclues. Un second run de déploiement est nécessaire pour déployer les ressources applicatives. Sauter cette étape laisse l'infrastructure provisionnée sans aucune application déployée. |
enable_topology_spread + topology_spread_strict | topology_spread_strict = false à moins de disposer de ≥ 3 réplicas répartis sur ≥ 3 zones | Moyen | topology_spread_strict = true avec moins de 3 réplicas ou zones : les nouveaux pods restent indéfiniment en état Pending avec des événements FailedScheduling mentionnant des contraintes de topologie. |
enable_redis | false pour les applications qui n'utilisent pas Redis | Moyen | Laisser true pour une application sans Redis : REDIS_HOST prend par défaut l'IP du serveur NFS. Si aucun service Redis n'y fonctionne, l'application consigne des erreurs de connexion à chaque démarrage. |
secret_rotation_period | "2592000s" (30 jours) — doit inclure le suffixe s | Moyen | Omettre le suffixe s (ex. "2592000") : Secret Manager rejette la configuration au moment du apply. Les notifications de rotation ne sont jamais enregistrées et la rotation automatique ne se déclenche jamais. |
backup_retention_days | 7 pour dev ; 30 pour la production | Moyen | 1 ou 0 : quasi aucune fenêtre de récupération — une erreur ne peut être annulée que sous 24 heures. Trop élevé : les coûts de stockage croissent indéfiniment. Équilibrez selon vos exigences de RPO. |
configure_service_mesh | false jusqu'à confirmation du bon fonctionnement d'ASM sur le cluster | Moyen | Activer sans que les API Fleet/ASM requises soient activées : le déploiement échoue avec API not enabled. Activer sur un cluster partagé sans plan de contrôle ASM opérationnel : les pods démarrent mais les conteneurs sidecars restent indéfiniment dans l'état ContainerCreating. |
Sorties
Le module expose les sorties suivantes après un déploiement réussi.
Informations sur le service
| Sortie | Description |
|---|---|
service_name | Nom du Service Kubernetes |
namespace | Espace de noms Kubernetes où l'application est déployée |
service_url | URL du service — URL externe si LoadBalancer avec IP statique, sinon URL interne du cluster |
service_external_ip | IP externe du LoadBalancer (si une IP statique est réservée) ; null lorsqu'elle n'est pas réservée |
service_cluster_ip | ClusterIP du Service Kubernetes de base ; null lorsque Cloud Deploy est actif |
stage_service_cluster_ips | Mappage du nom d'étape → ClusterIP pour les Services spécifiques aux étapes lorsque enable_cloud_deploy = true ; mappage vide sinon |
additional_service_urls | Mappage des noms de services additionnels vers leurs URL (IP externe du LoadBalancer si disponible, sinon URL interne du cluster) |
kubernetes_ready | true lorsque le point de terminaison du cluster GKE est disponible et que toutes les ressources Kubernetes sont déployées. false lors du premier déploiement d'un cluster intégré (inline) — une seconde exécution du déploiement est nécessaire. |
Base de données
| Sortie | Description |
|---|---|
database_instance_name | Nom de l'instance Cloud SQL ; null lorsque database_type = "NONE" |
database_name | Nom de la base de données applicative au sein de l'instance |
database_user | Nom de l'utilisateur de la base de données applicative |
database_host | Hôte de la base de données (127.0.0.1 via Cloud SQL Auth Proxy) |
database_port | Port de la base de données |
database_password_secret | Nom du secret Secret Manager contenant le mot de passe de la base de données |
Stockage
| Sortie | Description |
|---|---|
storage_buckets | Mappage du nom logique du bucket → nom du bucket pour tous les buckets GCS provisionnés ; mappage vide lorsque create_cloud_storage vaut false |
Réseau
| Sortie | Description |
|---|---|
network_name | Nom du réseau VPC utilisé par le déploiement |
network_exists | Indique si le réseau VPC a été trouvé (true/false) |
regions | Régions GCP disponibles dans le VPC |
region | Région GCP où l'application est déployée |
NFS
| Sortie | Description |
|---|---|
nfs_server_ip | IP interne du serveur NFS (sensible) ; null lorsque NFS est désactivé ou qu'aucun serveur n'existe |
nfs_mount_path | Chemin du système de fichiers du conteneur où le volume NFS est monté |
nfs_share_path | Chemin d'exportation sur le serveur NFS |
Conteneur et registre
| Sortie | Description |
|---|---|
container_image | URI pleinement qualifié de l'image de conteneur utilisée par la charge de travail déployée |
container_registry | Nom du dépôt Artifact Registry ; null lorsqu'aucun build personnalisé n'est configuré |
Surveillance
| Sortie | Description |
|---|---|
monitoring_enabled | Indique si Cloud Monitoring est configuré (true/false) |
monitoring_notification_channels | Liste des noms de canaux de notification Cloud Monitoring |
uptime_check_names | Liste des noms de configurations de tests de disponibilité |
Métadonnées de déploiement
| Sortie | Description |
|---|---|
deployment_id | Identifiant unique de déploiement (suffixe hexadécimal aléatoire généré automatiquement) |
tenant_id | Identifiant du tenant dérivé de tenant_id |
resource_prefix | Préfixe de nommage appliqué aux ressources GCP dans ce déploiement |
project_id | ID de projet GCP |
project_number | Numéro de projet GCP |
Jobs
| Sortie | Description |
|---|---|
initialization_jobs | Mappage de la clé de job → nom du Job Kubernetes pour tous les jobs d'initialisation provisionnés |
cron_jobs | Mappage de la clé de job → nom du CronJob Kubernetes pour tous les jobs cron provisionnés |
statefulset_name | Nom du StatefulSet lorsque workload_type = "StatefulSet" (ou stateful_pvc_enabled = true) ; null sinon |
nfs_setup_job | Nom du Job Kubernetes pour le job de configuration NFS ; null lorsqu'il n'est pas créé |
db_import_job | Nom du Job Kubernetes pour le job d'importation de base de données ; null lorsqu'il n'est pas créé |
CI/CD
| Sortie | Description |
|---|---|
cicd_enabled | Indique si le pipeline CI/CD est activé |
github_repository_url | URL du dépôt GitHub connecté à Cloud Build |
github_repository_owner | Propriétaire / organisation du dépôt GitHub |
github_repository_name | Nom du dépôt GitHub |
artifact_registry_repository | Objet contenant name, location et url du dépôt Artifact Registry ; null lorsque ni le build personnalisé ni le CI/CD ne sont activés |
cloudbuild_trigger_name | Nom du déclencheur Cloud Build ; null lorsque enable_cicd_trigger vaut false |
cloudbuild_trigger_id | ID du déclencheur Cloud Build ; null lorsque enable_cicd_trigger vaut false |
cicd_configuration | Objet contenant les détails complets du CI/CD (nom/ID du déclencheur, informations sur le dépôt, modèle de branche, URL du registre, e-mail du compte de service) ; null lorsqu'aucun déclencheur n'existe |
VPC Service Controls
| Sortie | Description |
|---|---|
vpc_sc_enabled | Indique si le périmètre VPC-SC a été créé avec succès |
vpc_sc_perimeter_name | Nom de la ressource de périmètre de service VPC-SC ; null lorsqu'il n'est pas activé |
vpc_sc_dry_run_mode | true si VPC-SC est en mode simulation (dry-run, journalisation seule) ; false s'il est appliqué activement |
audit_logging_enabled | Indique si Cloud Audit Logs au niveau du projet est activé |
artifact_registry_cmek_enabled | Indique si le chiffrement CMEK d'Artifact Registry est configuré |
Destruction des ressources
Lors de la suppression d'un déploiement App GKE, la plateforme déclenche un démantèlement complet de toutes les ressources Kubernetes, de l'infrastructure GCP et des liaisons de comptes de service gérées par ce module.
Avant de lancer la destruction :
- Comprendre le comportement de purge — un paramètre géré par la plateforme détermine si la destruction supprime intégralement les ressources gérées par le module ou les conserve pour prévenir toute perte accidentelle de données. Confirmez le mode applicable avant de procéder à la destruction.
- Vérifier les sauvegardes — confirmez qu'une sauvegarde récente de la base de données existe dans le bucket de sauvegarde GCS avant de supprimer le déploiement, en particulier pour les environnements de production.
- Enregistrements DNS — si des domaines personnalisés sont configurés, supprimez les enregistrements DNS A pointant vers l'IP de l'équilibreur de charge après la suppression du déploiement afin d'éviter les entrées DNS obsolètes.
- PVC orphelins — pour les charges de travail StatefulSet, Kubernetes ne supprime pas automatiquement les PersistentVolumeClaims lors de la suppression d'un StatefulSet. La plateforme gère la suppression des PVC dans le cadre du démantèlement, mais vérifiez dans Kubernetes Engine → Storage → PersistentVolumeClaims qu'aucun PVC ne subsiste après la destruction.
- Cluster GKE intégré (inline) — si un cluster intégré a été provisionné par ce déploiement (sans dépendance à Services GCP), le cluster, son VPC et toutes les ressources de sous-réseau sont supprimés. Tous les autres espaces de noms et charges de travail sur ce cluster seront également détruits. Assurez-vous qu'aucune autre charge de travail ne partage le cluster intégré avant d'engager la suppression.
Délai connu — libération de l'IP statique : Après la suppression du Service Kubernetes LoadBalancer, GCP peut conserver l'adresse IP externe sur le sous-réseau VPC pendant 20 à 30 minutes. Si cela se produit pendant le nettoyage, attendez 20 à 30 minutes et réessayez. La deuxième tentative réussira une fois que GCP aura libéré l'adresse réservée.
Guides associés
- Lab pratique : App GKE — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Module App CloudRun — Guide de configuration — la même application sur Cloud Run, lorsque vous avez besoin de l'autre cible de déploiement.
- App Common — Guide de configuration — la configuration partagée par les deux cibles de déploiement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.