Elasticsearch sur GKE Autopilot
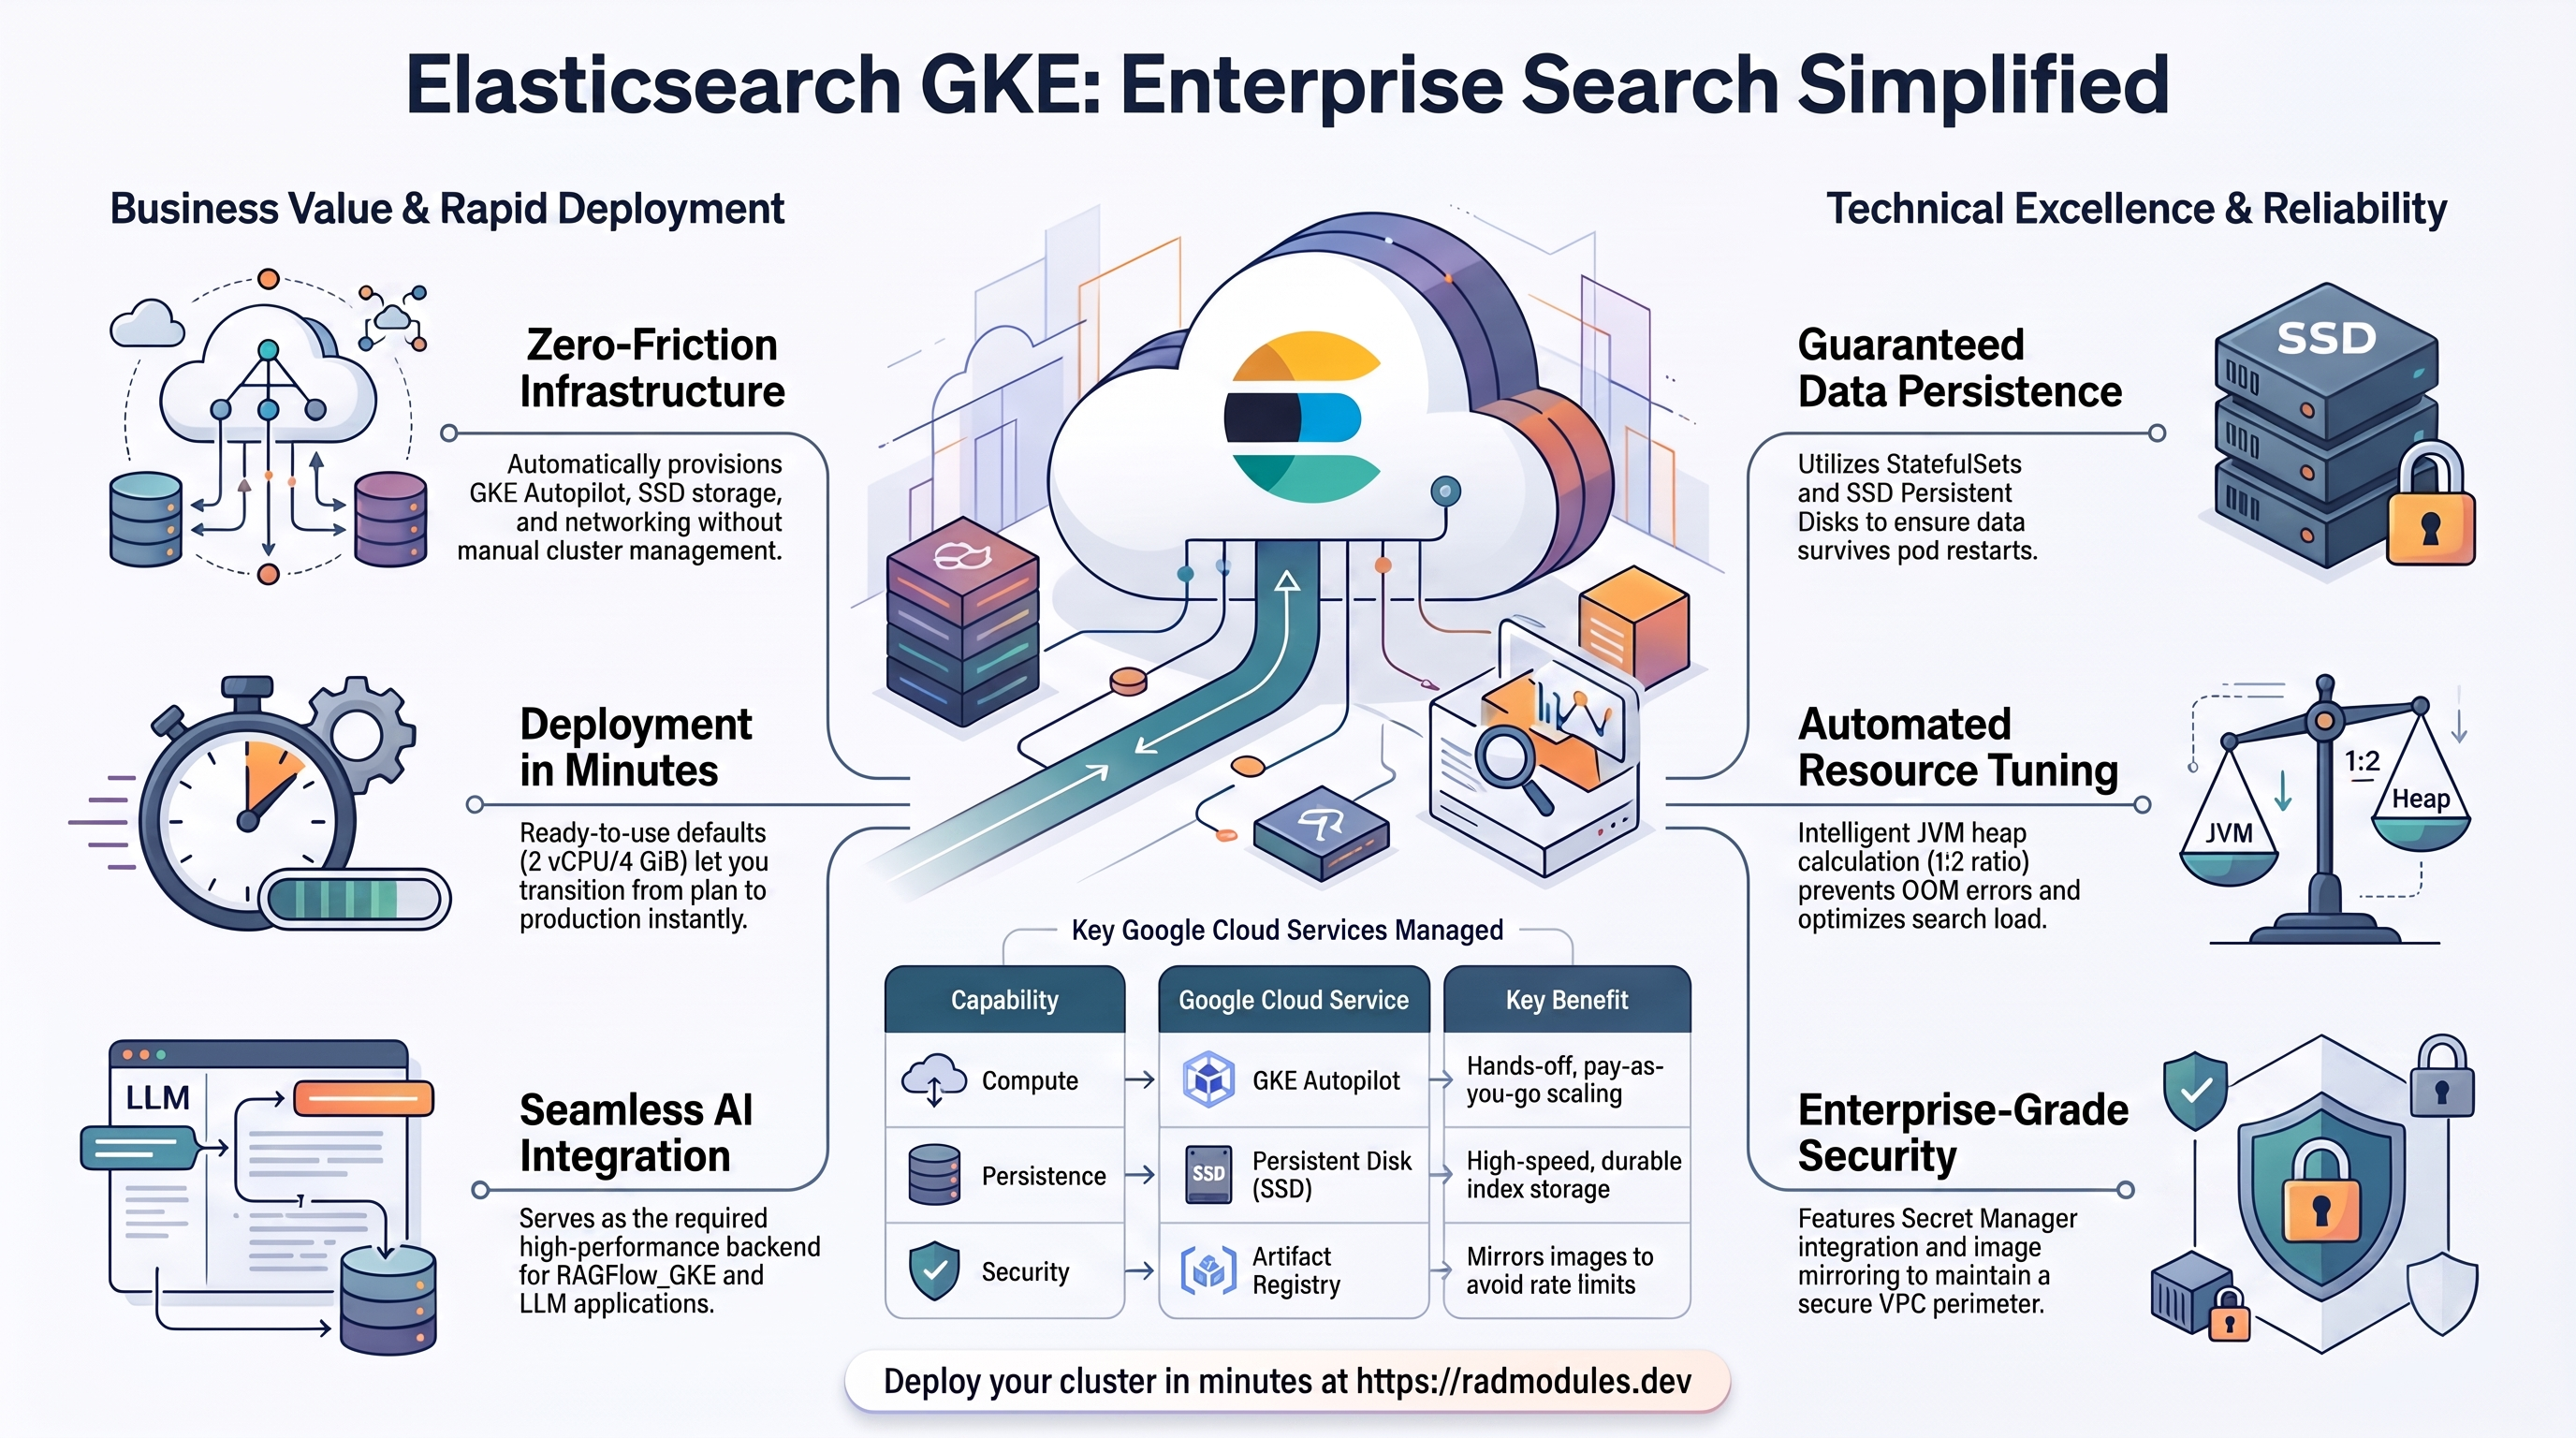
Elasticsearch est un moteur de recherche et d'analyse distribué open source basé sur Apache Lucene. Ce module déploie un cluster Elasticsearch à nœud unique sur GKE Autopilot sur la base du socle App_GKE, qui provisionne et gère l'infrastructure partagée de Google Cloud et Kubernetes.
Ce guide se concentre sur les services cloud utilisés par Elasticsearch et sur la manière de les explorer et de les exploiter depuis la Google Cloud Console et la ligne de commande. Pour les mécanismes communs à toutes les applications GKE — Workload Identity, ingress, autoscaling, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et le cycle de vie du déploiement — référez-vous au guide du socle App_GKE plutôt que de les répéter ici.
Coût d'Elasticsearch sur RAD et comparaison
Le module GKE Autopilot d'Elasticsearch sur RAD coûte environ 136,37 $ US par mois. Un serveur autogéré est moins cher en espèces, mais vous devez alors gérer la base de données, les sauvegardes, les correctifs de sécurité et les mises à niveau vous-même. Les chiffres sont valables au 8 octobre 2026 ; les sources sont listées à la fin de cette section.
Si vous n'en avez besoin qu'occasionnellement — pour des études, une démo, une activité saisonnière — un projet géré par RAD peut être supprimé et restauré dans les 30 jours sans frais supplémentaires, de sorte que les 136,37 $ US ne représentent plus que quelques dollars par mois. Voir Mettez-le en pause gratuitement, ci-dessous.
Ce que vous payez sur RAD
| Dans un projet Google Cloud que vous possédez | Dans un projet géré par RAD pour vous | |
|---|---|---|
| Frais de module, une fois par déploiement | 110 crédits (11 $ US au prix de la recharge) | 99 crédits (10 % de moins) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients sont l'exception : ils sont toujours facturés à la minute pour le temps de build | Idem |
| Coût d'exécution Google Cloud | Facturé par Google à votre propre compte de facturation, environ 136,37 $ US par mois pour la configuration par défaut (tableau ci-dessous) | Mesuré à l'heure en crédits ; RAD publie 135 crédits par jour, soit environ 4 050 par mois (environ 405 $ US au prix de la recharge ; estimé à partir des prix catalogue de Google, et incluant les frais de cluster) |
| Qui possède quoi | Vous possédez le projet et sa facturation ; RAD le déploie et le met à jour | RAD possède le projet, avec des garde-fous, des quotas et des alertes budgétaires ; vous avez accès à la console, et un solde minimum acheté est conservé en réserve |
Pourquoi les deux colonnes diffèrent. Le chiffre géré par RAD inclut les frais de gestion du cluster GKE (environ 73 $ US par mois) et le socle partagé du projet. Dans votre propre projet, le niveau gratuit de Google couvre les frais de gestion d'un cluster par compte de facturation, ce que le chiffre du projet propre suppose. Il est estimé à partir des prix catalogue de Google, car il n'y a pas encore suffisamment d'historique GKE géré par RAD pour le mesurer, de sorte que la confirmation de déploiement ne le cite pas. Une deuxième application GKE dans le même projet géré par RAD partage le cluster et n'ajoute que ses propres pods.
Votre premier déploiement réussi sur RAD est exempt de frais de module, quel que soit le montant : une fois par compte, pour un module que vous déployez et payez vous-même (dans une solution, les frais d'une application : la première à réussir ; jamais une session de lab ou un projet client).
10 crédits coûtent 1 $ US pour une recharge unique, et moins pour un plan mensuel. Dans un projet géré par RAD, la base de données, le serveur de fichiers et le réseau sont partagés par toutes les applications du projet, de sorte qu'une deuxième application n'ajoute pas une deuxième base de données.
Coût d'exécution par défaut dans votre propre projet (us-central1, prix catalogue Google) :
| Ressource (valeur par défaut du module) | Par mois |
|---|---|
| Pod GKE Autopilot, 2x vCPU / 4 GiB | 79,35 $ US |
| Cloud SQL pour PostgreSQL, 1 vCPU / 3,75 Go, zonal, 10 Go SSD | 51,02 $ US |
| Cloud NAT et réseau | 5 $ US |
| Cloud Storage (modules complémentaires, sauvegardes) | 1 $ US |
| Frais de gestion du cluster GKE | partagés entre toutes les applications GKE du projet ; 0 $ si c'est votre seul cluster, sinon ~73 $ |
| Total | environ 136,37 $ US |
Note : la vue d'ensemble de ce module indique qu'il est entièrement autonome, sans Cloud SQL ni bucket Cloud Storage. Les lignes Cloud SQL et Cloud Storage ci-dessus semblent être héritées du modèle de coût partagé plutôt que de dépenses réelles pour ce module — signalées ici pour vérification par rapport au Terraform en direct plutôt que discrètement supprimées.
Comparaison
- Elastic (l'entreprise derrière Elasticsearch) vend Elastic Cloud sur une base de paiement à l'usage, basée sur les ressources, sans prix fixe publié à citer ici. La comparaison honnête est donc un VPS nu : une instance Hetzner CPX22 ou DigitalOcean 2 vCPU/4 Go coûte environ 24 $ US par mois, ou une instance GCP Compute Engine e2-standard-2 environ 49 $ US — proche de la valeur par défaut de 2 vCPU/4 GiB de ce module — plus votre propre temps pour exécuter et patcher Elasticsearch, l'optimiser pour la JVM et gérer son stockage vous-même.
- Un nœud unique autogéré n'a pas de prise de clichés automatisée prête à l'emploi ; le module de RAD l'exécute en tant que StatefulSet GKE avec un volume persistant, qui survit à un redémarrage de pod, mais vous devez toujours exporter des clichés pour tout ce que vous ne pouvez pas vous permettre de perdre (voir Payez uniquement pendant que vous l'utilisez, ci-dessous).
Mettez-le en pause gratuitement : supprimez un projet géré par RAD, restaurez-le lorsque vous en avez besoin
Si Elasticsearch s'exécute dans un projet géré par RAD pour vous, vous avez une deuxième option qui va bien au-delà de la mise à l'échelle à zéro : supprimez l'ensemble du projet et restaurez-le dans les 30 jours pour presque rien. Cela convient bien mieux à Elasticsearch dont vous n'avez besoin qu'occasionnellement — pour des études, une démo, une activité saisonnière — que de le faire fonctionner en continu.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, seront utilisables après sa restauration. Il n'est donc pas possible de se fier à la restauration comme moyen de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
- Comment ça marche. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer le projet. Google ne supprime pas le projet immédiatement : il le conserve, récupérable, pendant 30 jours. Comme la facturation est déjà déliée, rien n'est facturé pendant cette attente. Contrairement à la suppression d'un module, cela ne détruit pas le pod GKE ou son disque persistant un par un — l'ensemble du projet, et tout ce qu'il contient, s'arrête simplement.
- La restauration est une vérification, pas une reconstruction. Dans les 30 jours, le propriétaire du projet peut le restaurer. RAD demande à Google de restaurer le projet et de rattacher son compte de facturation, puis vous demande d'exécuter Mettre à jour sur chaque déploiement pour confirmer que tout est revenu. Parce que rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes — c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit.
- Ainsi, un mois d'utilisation occasionnelle peut coûter quelques dollars, et non les 405 $ US par mois pour le maintenir en fonctionnement. Déployez Elasticsearch, utilisez-le pendant un certain temps, supprimez le projet. Restaurez-le la prochaine fois que vous en avez besoin, confirmez avec Mettre à jour, et supprimez-le à nouveau lorsque vous avez terminé. Vous ne payez les frais de module qu'une seule fois et les heures pendant lesquelles Elasticsearch était réellement actif.
- Ce que cela nécessite. Vous devez être propriétaire du projet (pas un projet que vous apportez et pour lequel RAD ne gère que la facturation), et vous le restaurez vous-même dans les 30 jours — après cela, Google le supprime définitivement. La restauration est admise comme la création d'un nouveau projet : votre solde de crédits achetés doit toujours dépasser le seuil du niveau (100 crédits pour le niveau sandbox que la plupart des études et des démos conviennent). Google indique que la plupart des services sont de nouveau pleinement fonctionnels dans les 36 heures suivant une restauration.
- Un véritable manque : l'index lui-même. Elasticsearch conserve ses données sur un Persistent Disk, et non une base de données avec sa propre sauvegarde automatisée — rien ici ne copie ce disque pour vous. Exportez un cliché avant de supprimer si vous voulez récupérer vos index, même pour une pause de 30 jours.
Payez uniquement pendant que vous l'utilisez, l'autre méthode : supprimer et redéployer
GKE maintient au moins un pod en cours d'exécution, il ne se met donc jamais à l'échelle à zéro de lui-même. L'option ci-dessus ne s'applique qu'à un projet géré par RAD ; dans votre propre projet, ou une fois la fenêtre de 30 jours passée, la façon d'arrêter de payer est de supprimer le déploiement et de le redéployer lorsque vous en avez besoin.
- Ce que coûte un redéploiement. Les frais de module à nouveau (les builds sont inclus) : 110 crédits (11,00 $ US), et environ une heure, car RAD recrée le projet et les services partagés avant Elasticsearch. La suppression permet d'économiser de l'argent une fois qu'Elasticsearch resterait inutilisé pendant environ 3 jours ou plus dans votre propre projet (environ 4,55 $ US par jour), ou environ 1 jour ou plus dans un projet géré par RAD (135 crédits par jour).
- Supprimez tout ce qu'Elasticsearch utilise. Le seul coût d'exécution d'Elasticsearch est son propre pod GKE et son disque persistant — il n'y a pas d'instance Cloud SQL séparée malgré ce qu'un modèle de coût générique pourrait lister (voir la note sur le tableau des coûts d'exécution ci-dessous) — donc sa suppression arrête presque tous ses propres coûts immédiatement.
- Conservez d'abord vos données. Les données indexées d'Elasticsearch résident entièrement sur son propre volume Persistent Disk, qui est supprimé avec le déploiement. Exportez un cliché d'index vers un bucket Cloud Storage en dehors du projet avant de supprimer si vous souhaitez le conserver — les PersistentVolumes de GKE ne sont pas sauvegardés automatiquement.
- Notez vos paramètres. RAD ne recrée pas un déploiement supprimé pour vous ; vous saisissez à nouveau les paramètres lors du déploiement.
Sessions de lab et environnements gérés
- Sessions de lab, pour la formation. Un formateur anime une session pour une classe. Chaque participant dispose d'Elasticsearch dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite d'une allocation définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés sont reversés au formateur.
- Environnements gérés, pour les cabinets de conseil. Un partenaire exécute Elasticsearch pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille est faible, la facturation est suspendue et les données sont conservées, de sorte que personne ne reçoit de frais inattendus. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue Google Cloud de l'API Cloud Billing Catalog ; Frais propres à RAD et estimations de crédits quotidiens de radmodules.dev/pricing ; Supprimer et restaurer des projets pour les mécanismes et la fenêtre de pause/restauration.
1. Vue d'ensemble
Elasticsearch s'exécute en tant que charge de travail StatefulSet. Le déploiement relie un ensemble ciblé de services Google Cloud :
| Capacité | Service Google Cloud | Notes |
|---|---|---|
| Calcul | GKE Autopilot | Pod StatefulSet Elasticsearch, 2 vCPU / 4 GiB par défaut |
| Stockage persistant | Persistent Disk (SSD) | PVC de 30 GiB à /usr/share/elasticsearch/data, survit aux redémarrages de pod |
| Secrets | Secret Manager | Secrets optionnels injectés en tant que variables d'environnement |
| Ingress | Cloud Load Balancing | Service LoadBalancer sur le port 9200 pour l'accès inter-espaces de noms |
| Registre d'images | Artifact Registry | Image Elasticsearch mise en miroir depuis le registre d'Elastic |
Pas de Cloud SQL, pas de Redis, pas de buckets GCS — Elasticsearch est entièrement autonome ; toutes les données résident dans son PVC.
Valeurs par défaut judicieuses à connaître d'emblée :
- StatefulSet avec PVC est le type de charge de travail requis. Le paramètre
stateful_pvc_enabled = true(qui sélectionne automatiquement StatefulSet) donne à chaque pod un volume SSD dédié qui survit aux redémarrages, aux mises à jour progressives et aux évictions de nœuds. Perdre le PVC signifie perdre toutes les données indexées. - Le mode nœud unique (
discovery.type = single-node) est appliqué au moment de la planification —max_instance_countest fixé à1. L'augmenter sans changer le type de découverte crée des clusters à nœud unique isolés, et non un cluster distribué. - Le tas JVM doit être au maximum la moitié de
memory_limit. Elasticsearch a besoin de l'autre moitié pour le cache de pages du système d'exploitation et la surcharge JVM. La violation de ce ratio déclenche des arrêts OOM sous charge de recherche. Une précondition au moment de la planification applique cette règle. cluster_nameest immuable après le premier index. Le modifier après l'indexation des documents entraîne le traitement des données PVC existantes comme étrangères par Elasticsearch et leur rejet. Choisissez un nom significatif avant le premier déploiement.- La période de grâce de terminaison est de 120 secondes pour permettre à Elasticsearch de vider les écritures de segments en mémoire sur le disque proprement avant que le pod ne soit supprimé de force.
- Ce module est la dépendance requise pour
RAGFlow_GKE. Après le déploiement, la sortieelasticsearch_endpoint(http://<external-ip>:9200) est transmise à la variableelasticsearch_hostsde RAGFlow.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que vous avez exécuté
gcloud container clusters get-credentials <cluster> --region <region> --project <project>
et que PROJECT, REGION et NAMESPACE sont définis. L'espace de noms et les autres
identifiants sont signalés dans les Sorties du déploiement.
A. GKE Autopilot — la charge de travail Elasticsearch
Elasticsearch s'exécute en tant que StatefulSet Kubernetes sur GKE Autopilot. Autopilot facture le CPU et la mémoire que le pod demande réellement. Un PodDisruptionBudget maintient le pod disponible pendant les mises à niveau de nœuds.
- Console : Kubernetes Engine → Charges de travail → sélectionnez le StatefulSet Elasticsearch pour voir l'état du pod, les événements et l'attachement du PVC. Kubernetes Engine → Services et Ingress affiche l'adresse IP externe du LoadBalancer sur le port 9200.
- CLI :
kubectl get statefulsets,pods,svc,pvc -n "$NAMESPACE"
kubectl logs -n "$NAMESPACE" <pod-name> --tail=100
kubectl describe pvc -n "$NAMESPACE"          # confirm PVC is Bound
Voir App_GKE pour la mise à l'échelle Autopilot, le PDB et le cycle de vie du StatefulSet.
B. Persistent Disk — stockage d'index
Tous les index Elasticsearch et les fichiers de shards résident sur un PersistentVolumeClaim
soutenu par un Persistent Disk (SSD). Le PVC est provisionné par la StorageClass
standard-rwo (ou premium-rwo) et monté à /usr/share/elasticsearch/data.
- Console : Kubernetes Engine → Stockage → PersistentVolumeClaims pour voir la taille et l'état de liaison. Compute Engine → Disques affiche le disque sous-jacent.
- CLI :
kubectl get pvc -n "$NAMESPACE"
kubectl describe pvc -n "$NAMESPACE" <pvc-name>
# Check disk usage inside the pod:
kubectl exec -n "$NAMESPACE" <pod-name> -- df -h /usr/share/elasticsearch/data
Surveillez les seuils de remplissage du disque — Elasticsearch passe les index en lecture seule à 95 % de capacité par défaut. Planifiez la taille du PVC avec une marge de 50 à 100 % au-dessus du volume de données attendu.
C. Point de terminaison du service Elasticsearch
L'API HTTP d'Elasticsearch est exposée sur le port 9200 via un service Kubernetes LoadBalancer.
Cette adresse IP externe est la sortie elasticsearch_endpoint et est transmise directement
à RAGFlow et aux autres consommateurs.
- Console : Kubernetes Engine → Services et Ingress → sélectionnez le service pour l' adresse IP externe et le mappage de port.
- CLI :
kubectl get svc -n "$NAMESPACE"
# Verify the cluster is up and healthy:
curl http://<elasticsearch-endpoint>/_cluster/health?pretty
curl http://<elasticsearch-endpoint>/_cat/indices?v
# List all indexes:
curl http://<elasticsearch-endpoint>/_cat/indices?h=index,docs.count,store.size
D. Secret Manager
Les secrets optionnels (tels que les identifiants personnalisés ou les clés API) sont stockés dans Secret Manager et injectés en tant que variables d'environnement au démarrage du pod.
- Console : Sécurité → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
Voir App_GKE pour l'intégration et la rotation du CSI de Secret Store.
E. Artifact Registry — image de conteneur
L'image officielle docker.elastic.co/elasticsearch/elasticsearch:<version> est
mise en miroir dans Artifact Registry avant chaque déploiement (lorsque enable_image_mirroring = true). Cela évite les limites de débit du registre Elastic et maintient les images dans le périmètre de votre VPC.
- Console : Artifact Registry → sélectionnez le dépôt pour les tags, les digests et les résultats d'analyse de vulnérabilité.
- CLI :
gcloud artifacts repositories list --project "$PROJECT" --location "$REGION"
gcloud artifacts docker images list "$REGION-docker.pkg.dev/$PROJECT/<repo>" --project "$PROJECT"
F. Réseau et Ingress
Le service LoadBalancer expose Elasticsearch sur le port 9200. Une adresse IP externe statique peut
être réservée. Cloud Armor peut être superposé au backend Ingress pour la protection WAF (bien
que pour Elasticsearch, les restrictions au niveau du réseau — règles de pare-feu et enable_network_segmentation
— soient généralement préférées aux règles WAF orientées navigateur).
- Console : Services réseau → Équilibrage de charge ; Réseau VPC → Adresses IP.
- CLI :
kubectl get ingress,svc -n "$NAMESPACE"
gcloud compute addresses list --project "$PROJECT"
Voir App_GKE pour les domaines personnalisés, les adresses IP statiques et les détails de Cloud Armor.
G. Cloud Logging et Monitoring
Les sorties stdout/stderr des pods (journaux Elasticsearch) sont acheminées vers Cloud Logging. Les métriques GKE sont acheminées vers Cloud
Monitoring. Des tests de disponibilité optionnels peuvent sonder /_cluster/health.
- Console : Logging → Explorateur de journaux ; Monitoring → Tableaux de bord / Alertes.
- CLI :
gcloud logging read 'resource.type="k8s_container" AND resource.labels.namespace_name="'"$NAMESPACE"'"' \
  --project "$PROJECT" --limit 50
3. Comportement de l'application Elasticsearch
- Fonctionnement en nœud unique. Le module déploie Elasticsearch avec
discovery.type = single-node, ce qui désactive la coordination de cluster. C'est le mode correct et pris en charge pour un déploiement à un seul pod. N'augmentez pasmax_instance_countau-delà de1sans également remplacerdiscovery.type— l'exécution de plusieurs clusters à nœud unique en parallèle entraîne une isolation des données, et non une distribution. - Stockage d'index persistant. Toutes les données résident dans le PVC à
/usr/share/elasticsearch/data. Le chemin est appliqué — la modification destateful_pvc_mount_pathsans mettre à jour le paramètrepath.dataentraîne l'écriture des données dans la couche de conteneur éphémère et leur perte silencieuse lors du prochain redémarrage du pod. - Dimensionnement du tas JVM.
ES_JAVA_OPTSest automatiquement défini à-Xms<heap> -Xmx<heap>à partir de la variablees_java_heap. Le tas d'Elasticsearch ne doit pas dépasser la moitié dememory_limit— le reste est consommé par le cache de segments hors tas de Lucene, le metaspace JVM et la mémoire native. Une précondition au moment de la planification applique cette règle. - mmap désactivé. GKE Autopilot n'autorise pas les
initContainersprivilégiés à augmentervm.max_map_count. En conséquence, le module définitnode.store.allow_mmap = false, ce qui empêche les fichiers mappés en mémoire basés sur mmap et entraîne une légère pénalité de lecture séquentielle par rapport au mode mmap. C'est une contrainte connue de GKE Autopilot. - Les sondes de santé sont codées en dur en TCP, inconditionnellement.
elasticsearch.tfdéfinit à la fois la sonde de démarrage et la sonde de vivacité àtype = "TCP"quelle que soitenable_xpack_security— une simple vérification d'ouverture de port sur 9200, et non une requête HTTP à/_cluster/health. La sonde de démarrage autorise jusqu'à 60 tentatives avec une période de 10 s (≈10 minutes au total, en plus d'un délai initial de 30 s) pour s'adapter au provisionnement de nœuds froids, au tirage d'images et au temps de démarrage de la JVM/récupération de shard ; la sonde de vivacité utilise un délai initial de 60 s, une période de 30 s et un seuil de 3 tentatives. C'est délibéré : une sonde HTTP renverrait401 Unauthorizedune fois la sécurité X-Pack activée, et échouerait avant que les propres vérifications de démarrage d'Elasticsearch (implicitement réussies une fois le port 9200 ouvert) ne soient terminées. Les variablesstartup_probe_configethealth_check_confign'ont aucun effet sur ce module —App_GKE(modules.tf) préfère toujours la sonde codée en dur de l'application à la valeur transmise par ces variables, il n'y a donc rien qu'un opérateur puisse configurer ou remplacer ici, y compris lorsqueenable_xpack_security = true. - La sécurité X-Pack est désactivée par défaut. Avec
enable_xpack_security = false, le point de terminaison HTTP accepte les requêtes non authentifiées. Tout appelant pouvant atteindre le port 9200 peut lire, écrire ou supprimer tous les index. C'est acceptable pour un cluster accessible uniquement au sein du VPC ; activez-le pour les déploiements publics ou multi-locataires. - L'authentification X-Pack est entièrement automatisée lorsqu'elle est activée. Le paramètre
enable_xpack_security = truedéclencheelasticsearch_auth.tfpour générer un mot de passe aléatoire, le stocker dans Secret Manager sous le nomsecret-<prefix>-<application_name>-elastic-password, et l'injecter dans le conteneur sous le nomELASTIC_PASSWORD— l'image officielle amorce le superutilisateurelasticavec cette valeur au premier démarrage d'un répertoire de données vide. Aucune configuration par l'opérateur n'est requise. Le nom d'utilisateur (toujourselastic) et l'ID secret sont exposés via les sortieselasticsearch_usernameetelasticsearch_password_secret_id(voir Sorties) — récupérez le mot de passe avecgcloud secrets versions access latest --secret=<elasticsearch_password_secret_id>. Les modules consommateurs tels que RAGFlow ou Zammad peuvent référencer le même ID secret de manière déterministe pour s'authentifier auprès de ce cluster. - Le nom du cluster est intégré à l'identité du nœud. La modification de
cluster_nameaprès la création du premier index entraîne le traitement des données PVC existantes comme étrangères par Elasticsearch et l'échec du démarrage. Un renommage nécessite la destruction du PVC et la réindexation de tous les documents. - Aucun job d'initialisation n'est requis. Elasticsearch s'amorce lui-même au premier démarrage. Il n'y a pas d'étape de création de base de données ou d'utilisateur.
- Période de grâce de terminaison. Kubernetes attend 120 secondes après l'envoi de SIGTERM avant de tuer de force le pod. Cela permet à Elasticsearch de vider les entrées du translog et de fermer les shards proprement, évitant une récupération potentiellement lente du translog au prochain démarrage.
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres spécifiques ou notables pour Elasticsearch sont listés ; toutes les autres entrées sont héritées de App_GKE avec son comportement standard et ses valeurs par défaut.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (requis) | Projet Google Cloud cible. |
region | us-central1 | Région pour la charge de travail et les ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques par environnement. |
support_users | [] | E-mails auxquels sont accordés l'accès au projet et les alertes de surveillance. |
resource_labels | {} | Étiquettes appliquées à toutes les ressources pour le suivi des coûts/de la propriété. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | elasticsearch | Nom de base des ressources. Ne pas modifier après le premier déploiement. |
application_display_name | Elasticsearch | Nom convivial affiché dans la Console. |
application_description | (défini) | Annotation de description de la charge de travail. |
application_version | 8.13.4 | Tag de version de l'image Elasticsearch ; incrémenter pour déployer une nouvelle version. |
cluster_name | ragflow | Définit cluster.name dans Elasticsearch. Immuable après le premier index — le renommage nécessite la destruction complète du PVC et la réindexation. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définissez false pour provisionner l'espace de noms et IAM sans déployer la charge de travail. |
container_image_source | prebuilt | Toujours prebuilt — Elasticsearch utilise l'image officielle d'Elastic. |
container_image | "" | Remplace l'URI de l'image ; laissez vide pour utiliser l'image officielle d'Elasticsearch. |
enable_image_mirroring | true | Mettez en miroir l'image du registre d'Elastic dans Artifact Registry avant le déploiement. |
min_instance_count | 1 | Maintenez à 1 pour le mode nœud unique. |
max_instance_count | 1 | Fixé à 1 — appliqué au moment de la planification. L'augmentation sans remplacer discovery.type crée des clusters isolés. |
container_port | 9200 | Port de l'API HTTP Elasticsearch. |
cpu_limit | 2000m | CPU par pod. 2 vCPU est la base recommandée ; passez à 4000m pour une indexation intensive. |
memory_limit | 4Gi | Mémoire par pod. Doit être au moins 2× es_java_heap. |
es_java_heap | 512m | Tas JVM (-Xms et -Xmx). Doit être ≤ la moitié de memory_limit — appliqué au moment de la planification. |
enable_xpack_security | false | Active la sécurité X-Pack (authentification). Lorsque false, le port 9200 n'est pas authentifié. |
enable_vertical_pod_autoscaling | false | Laissez Autopilot ajuster automatiquement les requêtes de ressources. |
timeout_seconds | 300 | Délai d'expiration du backend de l'équilibreur de charge (0 à 3600 secondes). |
termination_grace_period_seconds | 120 | Secondes pendant lesquelles Kubernetes attend après SIGTERM pour le vidage des segments avant de tuer de force. |
deployment_timeout | 1800 | Secondes pendant lesquelles Terraform attend que le déploiement du StatefulSet soit terminé. |
Groupe 5 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Variables d'environnement supplémentaires fusionnées dans le conteneur après les paramètres Elasticsearch auto-injectés ; peut remplacer toute valeur auto-définie (par exemple, discovery.type, ES_JAVA_OPTS). |
secret_environment_variables | {} | Mappage de variable d'environnement → nom de secret Secret Manager. |
secret_rotation_period | 2592000s | Cadence de notification de rotation de Secret Manager. |
secret_propagation_delay | 30 | Secondes à attendre après la création du secret avant de continuer. |
Groupe 6 — Backend et cluster GKE
| Variable | Valeur par défaut | Description |
|---|---|---|
gke_cluster_name | "" | Nom du cluster GKE ; laissez vide pour la découverte automatique. |
namespace_name | "" | Espace de noms Kubernetes ; auto-généré lorsqu'il est vide. |
workload_type | null | Se résout automatiquement en StatefulSet lorsque stateful_pvc_enabled = true. |
service_type | LoadBalancer | LoadBalancer est requis pour l'accès inter-espaces de noms depuis RAGFlow. Utilisez ClusterIP uniquement lorsque les deux charges de travail partagent le même espace de noms. |
session_affinity | None | Affinité de session. None est correct pour Elasticsearch (HTTP sans état). |
enable_network_segmentation | false | Crée des ressources Kubernetes NetworkPolicy pour restreindre l'entrée/la sortie. |
termination_grace_period_seconds | 120 | Également affiché dans le groupe 4 ; défini une fois ici. |
deployment_timeout | 1800 | Également affiché dans le groupe 4 ; défini une fois ici. |
network_tags | ["nfsserver"] | Tags réseau de nœud/pod GKE pour les règles de pare-feu. |
Groupe 7 — StatefulSet et persistance
La persistance des données est essentielle — toutes les données d'index Elasticsearch résident dans le PVC.
| Variable | Valeur par défaut | Description |
|---|---|---|
stateful_pvc_enabled | null | Définissez true pour tous les déploiements — sélectionne automatiquement StatefulSet. Sans PVC, tous les index sont perdus à chaque redémarrage de pod. |
stateful_pvc_size | 30Gi | Taille du PVC. Prévoyez une marge de 50 à 100 % ; Elasticsearch passe en lecture seule à 95 % d'utilisation du disque. |
stateful_pvc_mount_path | /usr/share/elasticsearch/data | Ne pas modifier — doit correspondre au paramètre path.data d'Elasticsearch. |
stateful_pvc_storage_class | standard-rwo | StorageClass. Utilisez premium-rwo pour l'indexation vectorielle kNN à haut débit. La StorageClass ne peut pas être modifiée après la création du PVC. |
stateful_headless_service | null | Définissez true pour créer un service sans tête pour des entrées DNS de pod stables. |
stateful_pod_management_policy | null | OrderedReady ou Parallel. |
stateful_update_strategy | null | RollingUpdate ou OnDelete. |
stateful_fs_group | 0 | Inerte pour ce module. elasticsearch.tf et main.tf codent en dur stateful_fs_group = 1000 (UID/GID d'Elasticsearch) inconditionnellement lors de l'appel à App_GKE ; la valeur de cette variable n'est jamais lue. Déclaré pour la compatibilité d'interface App_GKE uniquement — aucune action de l'opérateur n'est nécessaire. |
Groupe 8 — Quota de ressources
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_resource_quota | false | Plafonne le nombre de CPU/mémoire/objets de l'espace de noms. |
quota_cpu_requests / quota_cpu_limits | "" | Chaînes de quota CPU (par exemple, "4000m"). |
quota_memory_requests / quota_memory_limits | "" | Doit utiliser des unités binaires (4Gi, 8192Mi) — les entiers bruts sont lus comme des octets par Kubernetes et bloquent toute planification de pod. |
Groupe 9 — Politiques de fiabilité
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_pod_disruption_budget | true | Protège la disponibilité pendant les mises à niveau de nœuds. |
pdb_min_available | 1 | Pour un cluster à nœud unique, "1" empêche toute perturbation volontaire — passez à 2 réplicas ou plus avant de réduire cela. |
enable_topology_spread | false | Répartit les pods sur plusieurs zones. |
Groupe 10 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe_config | HTTP /_cluster/health, 18 tentatives | Inerte pour ce module. Le module déploie toujours une sonde de démarrage TCP codée en dur (délai initial de 30 s, seuil de 60 tentatives) quelle que soit la valeur de cette variable — aucune action de l'opérateur n'est nécessaire, y compris lorsque enable_xpack_security = true. Voir Comportement de l'application Elasticsearch. |
health_check_config | HTTP /_cluster/health, 3 tentatives | Inerte pour ce module. Le module déploie toujours une sonde de vivacité TCP codée en dur (délai initial de 60 s, seuil de 3 tentatives) quelle que soit la valeur de cette variable — aucune action de l'opérateur n'est nécessaire. |
uptime_check_config | désactivé | Test de disponibilité Cloud Monitoring optionnel contre /_cluster/health. |
alert_policies | [] | Politiques d'alerte métrique optionnelles. |
Groupe 11 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Jobs Kubernetes exécutés avant le démarrage du pod Elasticsearch. Non requis pour Elasticsearch — il s'amorce lui-même. |
cron_jobs | [] | CronJobs Kubernetes récurrents (par exemple, tâches de gestion du cycle de vie des index). |
additional_services | [] | Services GKE sidecar ou auxiliaires déployés avec Elasticsearch. |
Groupe 12 — Intégration CI/CD et GitHub
Intégration standard App_GKE Cloud Build / Cloud Deploy — voir
App_GKE. Entrées clés : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy,
enable_binary_authorization, binauthz_evaluation_mode.
Groupe 13 — Système de fichiers (NFS)
NFS n'est pas requis pour Elasticsearch — toutes les données résident dans le PVC du StatefulSet.
Les variables NFS sont présentes pour la compatibilité de l'interface du socle mais sont désactivées par défaut
(enable_nfs = false). Voir App_GKE pour plus de détails.
Groupe 14 — Cloud Storage et Artifact Registry
Les buckets Cloud Storage ne sont pas requis pour Elasticsearch (create_cloud_storage = false par défaut). Les variables Artifact Registry contrôlent la politique de rétention d'images
pour l'image Elasticsearch mise en miroir :
| Variable | Valeur par défaut | Description |
|---|---|---|
max_images_to_retain | 7 | Nombre maximal d'images récentes à conserver dans Artifact Registry. |
delete_untagged_images | true | Supprime automatiquement les images non taguées. |
image_retention_days | 30 | Âge après lequel les images sont éligibles à la suppression. |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options de chiffrement CMEK. |
Groupe 17 — Sauvegarde et maintenance
| Variable | Valeur par défaut | Description |
|---|---|---|
backup_schedule | 0 2 * * * | Planification cron de sauvegarde (UTC). Pour Elasticsearch, envisagez les instantanés Elasticsearch natifs vers GCS plutôt que les sauvegardes au niveau du système d'exploitation. |
backup_retention_days | 7 | Rétention en jours ; augmenter pour la production/conformité. |
Groupe 19 — Domaine personnalisé, IP statique et réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_custom_domain | true | Provisionne Ingress pour un nom d'hôte personnalisé + certificat géré. Ne prend effet que lorsque application_domains n'est pas vide. |
application_domains | [] | Noms d'hôtes à servir. |
reserve_static_ip | true | IP externe stable sur les redéploiements. |
network_tags | ["nfsserver"] | Tags réseau de pod GKE pour les règles de pare-feu. |
Groupe 20 — Identity-Aware Proxy (IAP)
IAP est déconseillé pour Elasticsearch — utilisez plutôt les contrôles au niveau du réseau
(enable_network_segmentation, règles de pare-feu). Les variables IAP sont présentes
pour l'exhaustivité.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_iap | false | Exige une connexion Google devant Elasticsearch. |
iap_authorized_users / iap_authorized_groups | [] | Qui peut accéder. |
iap_oauth_client_id / iap_oauth_client_secret | "" | Requis lorsque IAP est activé. |
iap_support_email | "" | Affiché sur l'écran de consentement OAuth. |
Groupe 21 — Cloud Armor
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_cloud_armor | false | Attache une politique Cloud Armor (WAF) au backend Ingress. |
admin_ip_ranges | [] | CIDR autorisés à un accès privilégié. |
cloud_armor_policy_name | default-waf-policy | Nom de la politique. |
enable_cdn | false | Non applicable pour Elasticsearch. |
Groupe 22 — VPC Service Controls et journalisation d'audit
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vpc_sc | false | Applique un périmètre VPC-SC (nécessite organization_id). |
vpc_cidr_ranges / vpc_sc_dry_run | (défini) | CIDR de niveau d'accès / mode simulation. |
enable_audit_logging | false | Journaux d'audit Cloud détaillés. |
5. Sorties
Ces valeurs sont renvoyées lors d'un déploiement réussi et constituent le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
elasticsearch_endpoint | Sortie principale pour RAGFlow. http://<service_external_ip>:9200. Transmettez ceci à la variable elasticsearch_hosts de RAGFlow_GKE. Renvoie null jusqu'à ce que l'IP externe soit attribuée. |
service_name | Nom du service Kubernetes. |
namespace | Espace de noms dans lequel la charge de travail s'exécute. |
service_cluster_ip | ClusterIP intra-cluster. |
stage_service_cluster_ips | Mappage des ClusterIP pour les services spécifiques à chaque étape (Cloud Deploy). |
service_external_ip | IP externe du LoadBalancer. |
api_url | URL du service. |
statefulset_name | Nom de la ressource StatefulSet. |
storage_buckets | Buckets Cloud Storage créés (liste vide — aucun bucket n'est provisionné). |
network_name / network_exists / regions | Réseau VPC, présence, régions disponibles. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels | Statut et canaux de surveillance. |
initialization_jobs | Noms des jobs de configuration exécutés avant la charge de travail. |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / cicd_configuration | Statut et détails CI/CD (dépôt, déclencheur, registre). |
github_repository_url / github_repository_owner / github_repository_name | Détails du dépôt GitHub connecté. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Registre et déclencheur de build. |
kubernetes_ready | true lorsque le point de terminaison du cluster est disponible et que toutes les ressources de la charge de travail sont déployées. false lors du premier apply d'un nouveau cluster — le pipeline CI/CD doit relancer l'apply pour terminer le déploiement. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | Statut VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | Journalisation d'audit et statut CMEK. |
elasticsearch_username | Nom d'utilisateur du superutilisateur Elasticsearch. Toujours "elastic". N'a de sens que lorsque enable_xpack_security = true. |
elasticsearch_password_secret_id | ID du secret Secret Manager contenant le mot de passe du superutilisateur elastic auto-généré. Chaîne vide lorsque enable_xpack_security = false. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
stateful_pvc_enabled | true | Critique | Sans PVC, tous les index sont stockés dans le système de fichiers éphémère du pod et sont définitivement perdus à chaque redémarrage, mise à jour progressive ou éviction de nœud. |
stateful_pvc_mount_path | /usr/share/elasticsearch/data | Critique | Doit correspondre à path.data. Une non-concordance écrit silencieusement les index dans la couche éphémère — les données sont perdues à chaque redémarrage. |
cluster_name | défini une fois | Critique | Immuable après le premier index. Le renommage entraîne le rejet par Elasticsearch de toutes les données PVC comme étrangères ; une réindexation complète est nécessaire. |
es_java_heap vs memory_limit | tas ≤ memory_limit / 2 | Critique | Un tas dépassant la moitié de la mémoire du conteneur entre en concurrence avec le cache de pages de Lucene ; des arrêts OOM se produisent sous charge de recherche. Une précondition au moment de la planification l'impose. |
stateful_fs_group | n/a — codé en dur | n/a | Le module transmet toujours stateful_fs_group = 1000 (UID/GID d'Elasticsearch) à App_GKE, quelle que soit cette variable. Ce n'est pas une préoccupation de l'opérateur ; listé ici uniquement parce que la variable existe sur l'interface. |
max_instance_count | 1 | Critique | L'augmentation sans remplacement de discovery.type crée des clusters isolés à nœud unique. Appliqué au moment de la planification. |
quota_memory_requests / _limits | unités binaires (4Gi) | Critique | Les entiers bruts sont des octets et bloquent immédiatement toute planification. |
enable_xpack_security | true pour la production | Élevé | Avec false, tout appelant pouvant atteindre le port 9200 peut lire, écrire ou supprimer tous les index sans identifiants. |
stateful_pvc_size | taille avec 50–100 % de marge | Élevé | Un PVC sous-dimensionné déclenche une protection par seuil d'inondation à 95 % de remplissage ; l'index devient en lecture seule. |
stateful_pvc_storage_class | standard-rwo (ou premium-rwo pour la production) | Moyen | standard-rwo est adéquat pour les charges de travail de recherche typiques ; l'indexation vectorielle kNN à haut débit bénéficie de premium-rwo. La StorageClass ne peut pas être modifiée après la création du PVC. |
memory_limit | ≥ 2 × es_java_heap | Critique | Une marge de mémoire insuffisante déclenche des arrêts OOM pendant la recherche/l'indexation. |
startup_probe_config / health_check_config | n/a — codé en dur en TCP | n/a | Le module déploie toujours des sondes TCP codées en dur, quelles que soient les valeurs de ces variables, de sorte qu'une non-concordance HTTP vs X-Pack ne peut pas se produire ; il n'y a rien à remplacer. Listé ici uniquement parce que les variables existent sur l'interface. |
enable_image_mirroring | true | Faible | La désactivation de la mise en miroir tire directement du registre d'Elastic ; les limites de débit peuvent entraîner des échecs de déploiement intermittents. |
application_version | 8.13.4 (ou version verrouillée) | Moyen | Les mises à niveau de version majeure (7.x → 8.x) peuvent nécessiter des vérifications de compatibilité d'index ; ne pas mettre à niveau sans consulter le guide de migration Elasticsearch. |
pdb_min_available vs min_instance_count | marge | Moyen | pdb_min_available = "1" avec un cluster à pod unique empêche toute perturbation volontaire (par exemple, les mises à niveau de nœuds) de se poursuivre. Mettre à l'échelle à 2 pods ou plus ou accepter la contrainte. |
Pour le comportement du socle référencé partout — IAM et Workload Identity, autoscaling, ingress et certificats, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir d'images — voir App_GKE.
Guides associés
- Lab pratique : Elasticsearch sur GKE Autopilot — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Déployé avec MongoDB sur GKE Autopilot, Meilisearch sur GKE Autopilot, Qdrant sur Google Cloud Run dans la solution Services de données partagés.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.