Chroma sur GKE Autopilot
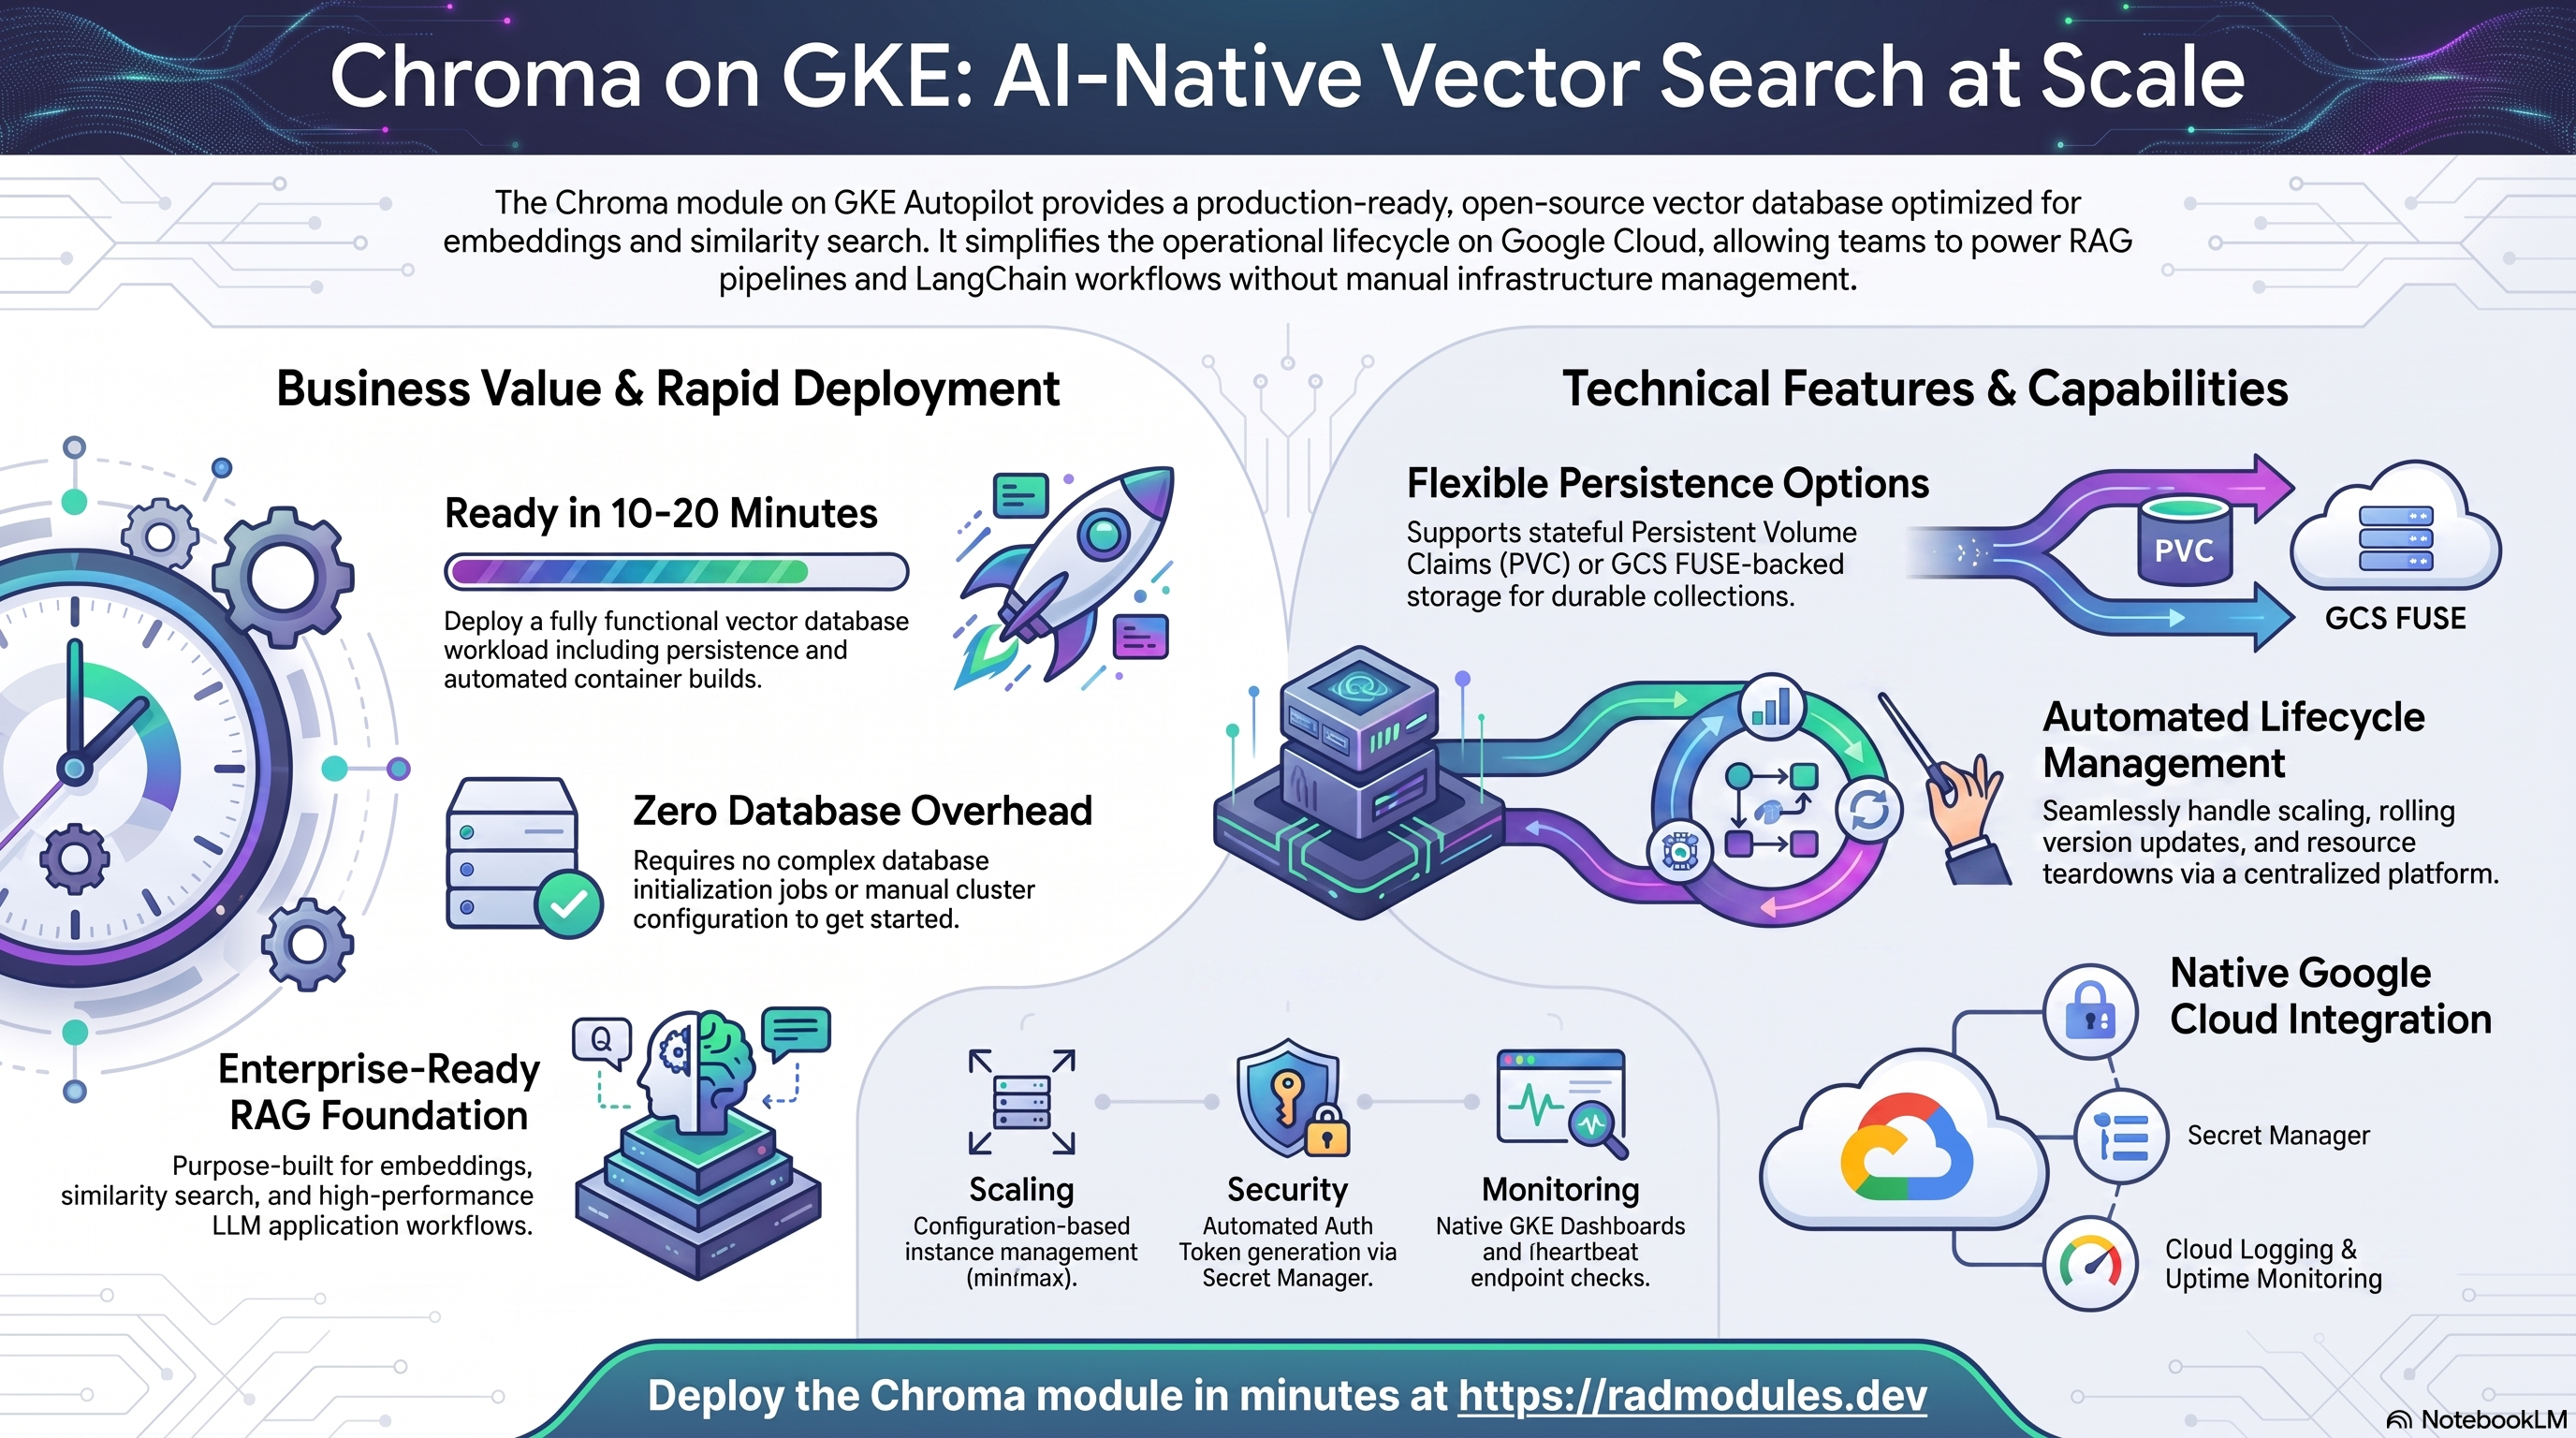
Chroma est une base de données vectorielle open source, conçue nativement pour l'IA et dédiée aux embeddings et à la recherche par similarité. Elle alimente les pipelines RAG, la recherche sémantique et les workflows LangChain/LlamaIndex. Ce module déploie Chroma sur GKE Autopilot au-dessus du socle App_GKE, qui provisionne et gère l'infrastructure Google Cloud et Kubernetes partagée.
Ce guide se concentre sur les services cloud qu'utilise Chroma et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à toute application GKE — Workload Identity, ingress, autoscaling, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide du socle App_GKE plutôt que de les répéter ici.
1. Vue d'ensemble
Chroma s'exécute sous la forme d'une charge de travail de base de données vectorielle conteneurisée. Le déploiement assemble un ensemble restreint de services Google Cloud :
| Fonctionnalité | Service Google Cloud | Remarques |
|---|---|---|
| Calcul | GKE Autopilot | Pods StatefulSet ou Deployment, 1 vCPU / 1 GiB par défaut |
| Persistance des données | PVC de StatefulSet (recommandé) ou GCS FUSE | PVC pour la production ; GCS FUSE pour le développement ou les déploiements à moindre coût |
| Stockage d'objets | Cloud Storage | Bucket <prefix>-data provisionné automatiquement ; utilisé comme stockage principal lorsque le PVC n'est pas activé |
| Jeton d'authentification | Secret Manager | Jeton d'API facultatif — CHROMA_SERVER_AUTHN_CREDENTIALS injecté à l'exécution |
| Entrée | Cloud Load Balancing | ClusterIP par défaut (accès interne au cluster) ; LoadBalancer facultatif avec IAP ou jeton d'authentification |
Valeurs par défaut judicieuses à connaître d'emblée :
- Ni base de données SQL ni Redis. Chroma gère son propre stockage embarqué. Aucune instance Cloud SQL n'est créée et aucune connexion Redis n'est configurée.
ClusterIPpar défaut. Le service n'est joignable qu'à l'intérieur du cluster ; avec cette valeur par défaut, la sortieendpoint_urln'est pas accessible depuis l'extérieur du cluster. Définissezservice_type = "LoadBalancer"uniquement si un accès externe est nécessaire, et activezenable_auth_tokenou IAP en parallèle.- Instance unique recommandée.
max_instance_count = 1est la valeur par défaut. Plusieurs pods Chroma partageant un même PVC ne sont pas pris en charge — des écritures concurrentes corrompraient les collections. - PVC de StatefulSet pour la production. Définir
stateful_pvc_enabled = truerésout automatiquement le type de charge de travail enStatefulSetet désactive le volume GCS FUSE sur/dataafin d'éviter un conflit de double montage. - Le jeton d'authentification est facultatif mais recommandé pour tout déploiement
joignable en dehors de l'espace de noms du pod. Lorsqu'il est activé, le jeton est
stocké dans Secret Manager et doit être transmis sous la forme
Authorization: Bearer <token>dans chaque appel d'API. - Les sondes de santé sont fixées sur
/api/v2/heartbeat. C'est le seul point de terminaison de santé qu'expose Chroma. - La télémétrie anonymisée est toujours désactivée.
ANONYMIZED_TELEMETRY=falseest injecté automatiquement. - De nombreuses entrées de base de données, Redis et configuration de build sont
inertes.
Chroma_GKEdéclare l'ensemble des variables d'App_GKE (base de données, Redis, build de conteneur, quotas et autres entrées reflétant le socle) pour la parité aveccheck_conventions.py, mais la plupart sont codées en dur ou ignorées parChroma_Common/main.tf— consultez la section 4 pour la liste complète, groupe par groupe.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que vous avez exécuté
gcloud container clusters get-credentials <cluster> --region <region> --project <project>
et que PROJECT, REGION et NAMESPACE sont définis. L'espace de noms et les autres
identifiants figurent dans les sorties du déploiement.
A. GKE Autopilot — la charge de travail Chroma
Les pods Chroma sont planifiés sur Autopilot, qui facture le CPU et la mémoire effectivement demandés par les pods. Le déploiement s'exécute en tant que StatefulSet (avec un PVC) ou Deployment (avec GCS FUSE), le Horizontal Pod Autoscaling gérant le nombre de réplicas.
- Console : Kubernetes Engine → Workloads → sélectionnez la charge de travail Chroma pour voir les pods, les révisions et les événements. Kubernetes Engine → Services & Ingress affiche l'IP du service.
- CLI :
kubectl get pods,svc,hpa -n "$NAMESPACE"
kubectl logs -n "$NAMESPACE" deploy/<service-name> --tail=100
kubectl describe statefulset -n "$NAMESPACE"    # when using StatefulSet
Consultez App_GKE pour la gestion d'Autopilot, du scaling et du type de charge de travail (Deployment ou StatefulSet).
B. Persistance des données — PVC de StatefulSet ou GCS FUSE
Chroma stocke sa base SQLite embarquée, ses fichiers d'index HNSW et les métadonnées de
ses collections dans un volume persistant monté sur /data. Deux backends de stockage
sont disponibles :
PVC de StatefulSet (recommandé pour la production) : un PersistentVolumeClaim
Kubernetes adossé à un Balanced PD (standard-rwo) ou à un SSD (premium-rwo) est
provisionné pour chaque pod, offrant un accès disque local à faible latence pour les
lectures et écritures d'index.
- Console : Kubernetes Engine → Storage → PersistentVolumeClaims.
- CLI :
kubectl get pvc -n "$NAMESPACE"
kubectl describe pvc -n "$NAMESPACE" <pvc-name>
GCS FUSE (par défaut lorsque le PVC n'est pas activé) : un bucket Cloud Storage
(<prefix>-data) est provisionné et monté sur /data via le pilote CSI GCS FUSE.
- Console : Cloud Storage → Buckets — repérez le bucket dont le nom se termine par
-data. - CLI :
gcloud storage buckets list --project "$PROJECT"
gcloud storage ls gs://<data-bucket>/chroma/    # inspect Chroma's on-disk layout
# Confirm the GCS FUSE mount inside a pod:
kubectl exec -n "$NAMESPACE" <pod-name> -- df -h | grep /data
Consultez App_GKE pour GCS Fuse, les options CMEK et le provisionnement des PVC.
C. Secret Manager
Lorsque enable_auth_token = true, le jeton d'authentification de l'API de Chroma est
généré et stocké sous forme de secret dans Secret Manager. Il est injecté dans les pods à
l'exécution sous la forme CHROMA_SERVER_AUTHN_CREDENTIALS ; la valeur en clair
n'apparaît jamais dans la configuration.
- Console : Security → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT"
# Retrieve the token to configure API clients:
gcloud secrets versions access latest --secret=<prefix>-auth-token --project "$PROJECT"
Consultez App_GKE pour l'intégration Secret Store CSI et la rotation.
D. Réseau et entrée
Par défaut, le service Chroma est exposé en ClusterIP, accessible uniquement à
l'intérieur du cluster. Lorsque service_type = "LoadBalancer" est défini, une IP
externe Cloud Load Balancing est provisionnée. Un domaine personnalisé, une IP statique
et Cloud Armor peuvent s'y ajouter.
- Console : Kubernetes Engine → Services & Ingress ; Network services → Load balancing ; VPC network → IP addresses.
- CLI :
kubectl get ingress,svc -n "$NAMESPACE"
gcloud compute addresses list --project "$PROJECT"
# Test the Chroma heartbeat from inside the cluster:
kubectl run -n "$NAMESPACE" --rm -it curl --image=curlimages/curl -- \
  curl http://<cluster-ip>:8000/api/v2/heartbeat
Consultez App_GKE pour les domaines personnalisés, Cloud CDN et les détails sur l'IP statique.
E. Cloud Logging et Monitoring
Les flux stdout/stderr des pods sont envoyés vers Cloud Logging ; les métriques GKE vers
Cloud Monitoring. Des tests de disponibilité sur /api/v2/heartbeat et des règles
d'alerte sont disponibles en option.
- Console : Logging → Logs Explorer ; Monitoring → Dashboards / Alerting.
- CLI :
gcloud logging read 'resource.type="k8s_container" AND resource.labels.namespace_name="'"$NAMESPACE"'"' \
  --project "$PROJECT" --limit 50
3. Comportement de l'application Chroma
- Aucune initialisation de base de données. Chroma gère son propre stockage embarqué
et ne nécessite aucun job d'initialisation de base de données. Aucun job
db-initn'est injecté. Si vous fournissez desinitialization_jobspersonnalisés, ils s'exécutent avant le démarrage de l'application. - Chargement des index au démarrage. Lorsque Chroma redémarre (après l'éviction d'un
pod ou une mise à jour progressive), il charge ses index HNSW depuis le PVC ou le
bucket GCS. Pour de grandes collections, cela peut prendre plusieurs dizaines de
secondes ; la sonde de démarrage sur
/api/v2/heartbeatattend que Chroma signale qu'il est prêt. - Contrainte d'écrivain unique. Chroma ne dispose d'aucun verrouillage distribué sur
son stockage. Exécuter plus d'un pod écrivant sur le même PVC ou le même chemin GCS
corrompra les collections. Conservez
max_instance_count = 1, sauf si vous exécutez un déploiement Chroma en cluster avec un stockage distinct par pod. - Utilisation du jeton d'authentification. Lorsque
enable_auth_token = true, tous les appels d'API doivent inclureAuthorization: Bearer <token>. Récupérez le jeton dans Secret Manager, puis utilisez-le avec le client Python :# Retrieve token
TOKEN=$(gcloud secrets versions access latest \
--secret=<prefix>-auth-token --project "$PROJECT")import chromadb
client = chromadb.HttpClient(
host="<cluster-ip>", port=8000,
headers={"Authorization": f"Bearer {TOKEN}"}
) - Sonde de santé. Les sondes de démarrage et de vivacité ciblent toutes deux
/api/v2/heartbeatavec un délai initial de 15 secondes. Le chemin de la sonde est fixé par Chroma_Common et ne peut pas être modifié. - Tâches planifiées. Chroma ne dispose d'aucune commande planifiée intégrée. Utilisez
cron_jobssi vous avez besoin d'instantanés périodiques des collections ou de tâches de maintenance.
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres propres à Chroma ou notables pour lui sont listés ; toutes les autres entrées sont héritées d'App_GKE avec leur comportement et leurs valeurs par défaut standard.
Groupe 0 — Métadonnées du module
| Variable | Valeur par défaut | Description |
|---|---|---|
module_description | Chroma is the AI-native open-source vector database with 18,000+ GitHub stars, purpose-built for embeddings and similarity search. Accelerates AI application development with a production-grade store for RAG pipelines, semantic search, and LangChain/LlamaIndex workflows. Deploy on GKE Autopilot with StatefulSet persistence, GCS Fuse storage, optional token authentication, Workload Identity, Secret Manager, and horizontal auto-scaling. | Description du module. (p. ex. « Chroma GKE: Deploy Chroma vector database on GKE Autopilot. ») |
module_documentation | https://docs.radmodules.dev/docs/modules/Chroma_GKE | URL de la documentation du module. |
module_dependency | (défini) | Indiquez les noms des modules dont ce module dépend, dans l'ordre dans lequel ils doivent être déployés. (p. ex. ["Services_GCP"]) |
module_services | (défini) | Indiquez les services du module. |
credit_cost | 75 | Indiquez le coût du module. (p. ex. 50) |
require_credit_purchases | false | Lorsque true, les frais de module ne peuvent être réglés qu'avec des crédits achetés (abonnement ou recharge), et non avec des crédits offerts gratuits ou des crédits d'événement. |
enable_purge | true | Définissez sur true pour permettre la purge de ce module. |
public_access | true | Définissez sur true pour rendre le module disponible à tous les utilisateurs de la plateforme. |
require_services_gcp_module | true | Impose que le module Services_GCP soit déployé avant ce module. Lorsque la valeur est true, le déploiement échoue au moment du plan avec une erreur explicite si aucun réseau VPC géré par Services_GCP n'est détecté dans le projet. Définissez sur false pour autoriser un déploiement autonome avec des ressources prérequises intégrées. |
resource_creator_identity | rad-module-creator@YOUR_PLATFORM_PROJECT.iam.gserviceaccount.com | Compte de service utilisé par Terraform pour créer les ressources dans le projet de destination. (p. ex. « rad-module-creator@YOUR_PLATFORM_PROJECT.iam.gserviceaccount.com ») |
shared_users | (défini) | Liste des utilisateurs pouvant consulter et déployer ce module, quel que soit le paramètre public_access. Saisissez une ou plusieurs adresses e-mail. Métadonnées uniquement. |
technical_support_users | (défini) | Liste des utilisateurs chargés d'assurer le support technique de ce module. Saisissez une ou plusieurs adresses e-mail. Le portail de déploiement achemine vers ces utilisateurs les demandes de support concernant ce module. Métadonnées uniquement. |
impersonation_service_account | `` | Adresse e-mail du compte de service à utiliser par emprunt d'identité lors des appels aux API GCP depuis les scripts shell. Laissez vide pour utiliser les identifiants propres de l'exécuteur. (p. ex. 'deployer@my-project.iam.gserviceaccount.com') |
job_execution_wait_timeout | 900 | Nombre maximal de secondes pendant lesquelles un déploiement attend la fin du job de configuration de la base de données (db-create) avant d'abandonner, afin qu'un job bloqué fasse échouer rapidement l'apply au lieu de rester suspendu jusqu'au délai d'expiration externe du build. Définissez-le au moins à la durée d'exécution propre du job, plus une marge. |
explicit_secret_values | (défini) | Valeurs sensibles brutes à injecter directement dans les Secrets Kubernetes, en contournant la lecture des sources de données Secret Manager. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
scripts_dir | `` | Chemin du répertoire des scripts d'initialisation. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
requires_services | (défini) | Table explicite des ressources provisionnées par Services_GCP dont ce module a besoin, indépendamment des valeurs par défaut actuelles des variables de Services_GCP. La plateforme lit cette table (et non module_services, qui est une liste lisible destinée à l'interface de confirmation du déploiement) pour déterminer quels interrupteurs create_* de Services_GCP doivent être activés lors du provisionnement automatique ou de la mise à jour du déploiement Services_GCP partagé du projet de destination. Les clés reprennent à l'identique les noms des variables booléennes de Services_GCP. create_redis et create_filestore_nfs doivent rester à false pour le parcours de déploiement automatisé : la VM Compute Engine gratuite NFS+Redis (create_network_filesystem) est ce que reçoit chaque déploiement automatisé ; passer à Cloud Memorystore/Filestore gérés est une optimisation manuelle postérieure au déploiement, jamais quelque chose qu'une chaîne de dépendances automatisée devrait demander d'elle-même. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Sélectionnez un projet existant sur la plateforme RAD ou saisissez l'ID d'un projet GCP externe. Vous devez accorder le rôle Owner au compte de service de l'agent RAD GCP Project lors d'un déploiement dans un projet externe. (p. ex. 'my-project-123') |
tenant_id | demo | Indiquez un identifiant unique de locataire ou de déploiement. Il identifie de manière unique le déploiement de votre application et sert au nommage des ressources (1 à 7 caractères alphanumériques minuscules, sans trait d'union — la limite de 7 caractères découle de la limite de 30 caractères des ID de compte de service GCP). |
region | us-central1 | Région GCP de déploiement des ressources (p. ex. 'us-central1'). Utilisée comme solution de repli lorsque la découverte réseau ne peut pas déterminer la région à partir des sous-réseaux VPC existants. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
support_users | (défini) | Adresses e-mail des utilisateurs à qui accorder l'accès au projet Google Cloud, aux alertes de surveillance et aux notifications (p. ex. ['admin@example.com', 'ops@example.com']). |
resource_labels | (défini) | Libellés clé-valeur appliqués à toutes les ressources créées par ce module. Permet d'appliquer des politiques de marquage organisationnelles, telles que centre de coûts, environnement ou équipe propriétaire. (p. ex. { env = "prod", team = "engineering" }) |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | chroma | Nom de l'application utilisé pour nommer les ressources. Doit commencer par une lettre et ne contenir que des lettres minuscules, des chiffres et des traits d'union (1 à 20 caractères). (p. ex. « chroma ») |
application_display_name | Chroma Vector Database | Nom lisible de l'application, utilisé pour l'affichage. (p. ex. « Chroma Vector Database ») |
application_description | Chroma Vector Database on GKE Autopilot | Brève description de l'objet de l'application. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
description | Chroma — the AI-native open-source vector database for embeddings and similarity search | Brève description de l'objet du déploiement Chroma. Alimente la description de la charge de travail GKE et la documentation de la plateforme. (p. ex. 'Chroma Vector Database for AI applications') |
application_version | latest | Tag de version de l'image Docker de Chroma. Utilisez 'latest' pour la version stable la plus récente, ou figez une version précise pour des déploiements reproductibles. (p. ex. 'latest', '0.5.0') |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définissez sur true pour déployer l'infrastructure de l'application. Lorsque la valeur est false, seules les ressources partagées (secrets, stockage, IAM) sont créées, sans déployer la charge de travail GKE proprement dite. |
container_image_source | custom | Détermine la provenance de l'image de conteneur. Utilisez 'prebuilt' pour déployer directement l'URI d'une image existante, ou 'custom' pour construire l'image à partir des sources. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
container_image | `` | URI de l'image. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
container_build_config | (défini) | Configuration du build. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
enable_image_mirroring | true | Met en miroir l'image de conteneur de Chroma dans Artifact Registry avant le déploiement. Recommandé pour éviter les limites de débit de Docker Hub et fiabiliser le téléchargement des images en production. |
min_instance_count | 1 | Nombre minimal de réplicas de pod à maintenir en fonctionnement en permanence. Pour Chroma, définissez au moins 1 pour éviter les démarrages à froid. Doit être inférieur ou égal à max_instance_count. (p. ex. 1) |
max_instance_count | 1 | Nombre maximal de réplicas de pod autorisés à s'exécuter simultanément. Pour Chroma sans mode distribué, 1 est la valeur habituelle. Doit être supérieur ou égal à min_instance_count. (p. ex. 1) |
enable_vertical_pod_autoscaling | false | Active le Vertical Pod Autoscaling (VPA). Lorsqu'il est activé, le HPA basé sur le CPU et la mémoire est désactivé pour éviter les conflits. Le VPA optimise automatiquement les demandes de ressources. (p. ex. false) |
container_port | 8000 | Port TCP sur lequel écoute le conteneur Chroma. Pour Chroma, il vaut toujours 8000 (défini via Chroma_Common) ; cette variable n'est pas transmise à App_GKE et n'a aucun effet. |
container_protocol | http1 | Version du protocole HTTP utilisée par le backend du Service Kubernetes. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
container_resources | (défini) | Limites CPU/mémoire du conteneur Chroma. Remarque : utilisez les variables cpu_limit et memory_limit pour définir les ressources du conteneur — cet objet structuré est accepté pour la compatibilité avec l'interface, mais ne remplace pas cpu_limit/memory_limit. |
timeout_seconds | 300 | Délai d'expiration des requêtes en secondes (0 à 3600). Durée maximale d'une requête. (p. ex. 300) |
enable_cloudsql_volume | false | Injecte un conteneur sidecar Cloud SQL Auth Proxy dans le pod GKE. Chroma n'utilise pas Cloud SQL — cette valeur doit rester à false, sauf si vous exécutez un sidecar personnalisé à côté de Chroma. |
cloudsql_volume_mount_path | /cloudsql | Chemin de montage du socket Cloud SQL Auth Proxy. Non référencée — Chroma n'a pas de base de données Cloud SQL. |
service_annotations | (défini) | Annotations personnalisées appliquées à la ressource Service Kubernetes. (p. ex. { "cloud.google.com/neg" = "{\\"ingress\\": true}" }) |
service_labels | (défini) | Libellés personnalisés appliqués spécifiquement à la ressource Service Kubernetes. (p. ex. { category = "production", tier = "database" }) |
cloud_sql_proxy_version | 2-alpine | Tag de l'image Cloud SQL Auth Proxy. Sans objet — Chroma n'a pas de base de données Cloud SQL. |
cpu_limit | 1000m | Limite de CPU allouée au conteneur Chroma. (p. ex. '1000m', '2000m') |
memory_limit | 1Gi | Limite de mémoire allouée au conteneur Chroma. Chroma charge les index d'embeddings en mémoire ; dimensionnez cette valeur en fonction de vos collections. (p. ex. '1Gi', '4Gi') |
enable_auth_token | false | Génère un jeton d'authentification aléatoire et le stocke dans Secret Manager. Lorsque la valeur est true, Chroma est démarré avec CHROMA_SERVER_AUTHN_CREDENTIALS et CHROMA_SERVER_AUTHN_PROVIDER définis, de sorte que tous les appels d'API exigent le jeton. Recommandé pour tout déploiement accessible en dehors du pod ou de l'espace de noms. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 5 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | (défini) | Variables d'environnement statiques du conteneur Chroma, sous forme de paires clé-valeur. (p. ex. { CHROMA_LOG_CONFIG_FILE = "/chroma/log_config.yml" }) |
secret_environment_variables | (défini) | Variables d'environnement issues de Secret Manager. Associe le nom de la variable d'environnement au nom du secret dans Secret Manager. |
secret_rotation_period | 2592000s | Calendrier de rotation des secrets. (p. ex. '2592000s' pour 30 jours) |
secret_propagation_delay | 30 | Durée en secondes à attendre après la création ou la mise à jour d'un secret avant de poursuivre les opérations qui en dépendent. (p. ex. 30) |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 6 — Backend GKE et cluster
| Variable | Valeur par défaut | Description |
|---|---|---|
gke_cluster_name | `` | Nom du cluster GKE dans lequel déployer. Laissez vide pour une découverte automatique. (p. ex. 'gke-cluster-1') |
prereq_gke_subnet_cidr | 10.201.0.0/24 | Plage CIDR du sous-réseau GKE intégré. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
gke_cluster_selection_mode | primary | Stratégie de choix du cluster GKE cible. (p. ex. 'primary') |
prereq_subnet_cidr_override | `` | Remplacement du CIDR du sous-réseau principal du VPC intégré. |
namespace_name | `` | Espace de noms Kubernetes du déploiement. Laissez vide pour le générer automatiquement à partir de application_name et tenant_id. (p. ex. 'chroma-prod') |
prereq_gke_pod_cidr_override | `` | Remplacement du CIDR de la plage secondaire des pods GKE intégrée. |
prereq_gke_service_cidr_override | `` | Remplacement du CIDR de la plage secondaire des services GKE intégrée. |
workload_type | null | Type de charge de travail Kubernetes. Utilisez 'StatefulSet' (recommandé pour Chroma) pour une identité de pod stable et des redémarrages ordonnés, ou 'Deployment' pour un fonctionnement sans état avec un stockage adossé à GCS. (p. ex. 'Deployment' ou 'StatefulSet') |
service_type | ClusterIP | Type de Service Kubernetes. Conservez 'ClusterIP' (par défaut) afin que Chroma ne soit joignable qu'à l'intérieur du cluster — avec ce paramètre, la sortie api_url n'est pas accessible depuis l'extérieur du cluster. Définissez 'LoadBalancer' uniquement si un accès externe est nécessaire, et activez IAP ou enable_auth_token en parallèle. |
session_affinity | None | Mode d'affinité de session du Service Kubernetes. (p. ex. 'None' ou 'ClientIP') |
enable_multi_cluster_service | false | Active les Multi-Cluster Services (MCS) pour l'application. Non référencée — définir cette variable n'a aucun effet. |
extra_service_ports | (défini) | Ports supplémentaires à exposer sur le Service Kubernetes, pour une charge de travail qui parle plusieurs protocoles sur le même pod. Reflète la variable d'App_GKE pour satisfaire les contrôles de conventions ; déclarée mais NON transmise par ce module, elle n'a donc aucun effet ici. Par défaut, une liste vide, qui produit exactement le Service que ce module produisait auparavant. |
configure_service_mesh | false | Active l'injection du service mesh Istio pour l'espace de noms de l'application. Nécessite que Cloud Service Mesh ou Anthos Service Mesh soit installé sur le cluster. |
enable_network_segmentation | false | Active les NetworkPolicies Kubernetes pour la micro-segmentation. (p. ex. false) |
termination_grace_period_seconds | 60 | Nombre de secondes pendant lesquelles Kubernetes attend après SIGTERM avant d'arrêter de force le conteneur. Augmentez-le pour permettre à Chroma de vider les écritures en cours. Plage valide : 0 à 3600. (p. ex. 60) |
deployment_timeout | 1800 | Nombre maximal de secondes pendant lesquelles Terraform attend la fin du déploiement progressif Kubernetes. (p. ex. 1800) |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 7 — Configuration du StatefulSet
| Variable | Valeur par défaut | Description |
|---|---|---|
stateful_pvc_enabled | null | Active le Persistent Volume Claim du StatefulSet. Recommandé pour Chroma afin d'éviter la surcharge d'E/S de GCS FUSE sur les grandes collections. Lorsque la valeur est true sans workload_type explicite, le type est automatiquement résolu en 'StatefulSet'. (p. ex. false) |
stateful_pvc_size | 20Gi | Taille de stockage de chaque PVC provisionné par le StatefulSet. Dimensionnez le PVC pour contenir toutes les collections Chroma, plus une marge. (p. ex. '20Gi', '50Gi') |
stateful_pvc_mount_path | /data | Chemin du système de fichiers, dans le conteneur Chroma, où le PVC propre à chaque pod est monté. (p. ex. '/data') |
stateful_pvc_storage_class | standard-rwo | StorageClass Kubernetes des PVC du StatefulSet. 'standard-rwo' (Balanced PD) est la valeur par défaut pour GKE Autopilot. Utilisez 'premium-rwo' pour davantage d'IOPS. (p. ex. 'standard-rwo', 'premium-rwo') |
stateful_headless_service | null | Crée un service headless pour le StatefulSet afin de fournir des identités réseau stables. (p. ex. true) |
stateful_pod_management_policy | null | Contrôle l'ordre de création et de suppression des pods. 'OrderedReady' est requis pour des redémarrages sûrs de Chroma. (p. ex. 'OrderedReady' ou 'Parallel') |
stateful_update_strategy | null | Stratégie de mise à jour du StatefulSet. Utilisez 'RollingUpdate' pour des mises à jour sans interruption. (p. ex. 'RollingUpdate' ou 'OnDelete') |
stateful_fs_group | 1000 | GID défini comme fsGroup au niveau du pod dans le contexte de sécurité du StatefulSet. Garantit que le PVC est accessible en écriture par le groupe. Définissez 0 pour laisser fsGroup non défini. (p. ex. 1000) |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 8 — Quota de ressources
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_resource_quota | false | Crée un ResourceQuota Kubernetes dans l'espace de noms de l'application. |
quota_cpu_requests | `` | Quota total de demandes de CPU pour l'espace de noms. Non référencée — définir cette variable n'a aucun effet. |
quota_cpu_limits | `` | Quota total de limites de CPU pour l'espace de noms. Non référencée — définir cette variable n'a aucun effet. |
quota_memory_requests | `` | Quota total de demandes de mémoire pour l'espace de noms (p. ex. '4Gi'). Doit utiliser des suffixes d'unités binaires tels que 'Gi' ou 'Mi' — Kubernetes interprète les entiers nus comme des octets, ce qui bloque la planification de tous les pods. |
quota_memory_limits | `` | Quota total de limites de mémoire pour l'espace de noms (p. ex. '8Gi'). Doit utiliser des suffixes d'unités binaires tels que 'Gi' ou 'Mi' — Kubernetes interprète les entiers nus comme des octets, ce qui bloque la planification de tous les pods. |
quota_max_pods | `` | Nombre maximal de pods dans l'espace de noms. Non référencée — définir cette variable n'a aucun effet. |
quota_max_services | `` | Nombre maximal de Services dans l'espace de noms. Non référencée — définir cette variable n'a aucun effet. |
quota_max_pvcs | `` | Nombre maximal de PVC dans l'espace de noms. Non référencée — définir cette variable n'a aucun effet. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 9 — Règles de fiabilité
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_pod_disruption_budget | true | Crée un PodDisruptionBudget Kubernetes pour limiter l'indisponibilité des pods lors des perturbations volontaires. |
pdb_min_available | 1 | Nombre minimal de pods disponibles lors des perturbations volontaires. (p. ex. '1') |
enable_topology_spread | false | Ajoute des TopologySpreadConstraints Kubernetes. Non référencée — définir cette variable n'a aucun effet. |
topology_spread_strict | false | Contrôle le comportement whenUnsatisfiable de la contrainte de répartition topologique. Non référencée — définir cette variable n'a aucun effet. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 10 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe_config | (défini) | Configuration de la sonde de démarrage Kubernetes. Chroma expose /api/v2/heartbeat. Exemple : { enabled = true, type = "HTTP", path = "/api/v2/heartbeat", initial_delay_seconds = 15, timeout_seconds = 5, period_seconds = 10, failure_threshold = 10 }. |
health_check_config | (défini) | Configuration de la sonde de vivacité Kubernetes. Utilise /api/v2/heartbeat (le point de terminaison de santé de Chroma). Exemple : { enabled = true, type = "HTTP", path = "/api/v2/heartbeat", initial_delay_seconds = 30, timeout_seconds = 5, period_seconds = 30, failure_threshold = 3 }. |
uptime_check_config | (défini) | Configuration du test de disponibilité. Surveille la disponibilité du service. Exemple : { enabled = true, path = "/api/v2/heartbeat", check_interval = "60s", timeout = "10s" }. |
alert_policies | (défini) | Règles d'alerte personnalisées pour Cloud Monitoring. |
startup_probe | (défini) | Configuration de la sonde de démarrage. Chroma expose /api/v2/heartbeat une fois entièrement prêt à traiter les requêtes. Exemple : { enabled = true, type = "HTTP", path = "/api/v2/heartbeat", initial_delay_seconds = 15, timeout_seconds = 5, period_seconds = 10, failure_threshold = 10 }. |
liveness_probe | (défini) | Configuration de la sonde de vivacité. Utilise /api/v2/heartbeat (le point de terminaison de santé de Chroma). Exemple : { enabled = true, type = "HTTP", path = "/api/v2/heartbeat", initial_delay_seconds = 30, timeout_seconds = 5, period_seconds = 30, failure_threshold = 3 }. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 11 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | (défini) | Jobs Kubernetes pour les tâches d'initialisation. Chroma ne nécessite aucune initialisation par défaut ; ne fournissez des jobs que pour un chargement de données ou des migrations personnalisés. |
cron_jobs | (défini) | Liste des CronJobs à déployer à côté de Chroma (p. ex. pour des instantanés de collections ou des tâches de maintenance). |
additional_services | (défini) | Liste de services Kubernetes supplémentaires à déployer à côté de Chroma (p. ex. sidecars, services d'appoint). |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 12 — CI/CD, Binary Authorization et Cloud Deploy
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_cicd_trigger | false | Active un déclencheur Cloud Build automatisé pour la CI/CD. (p. ex. false) |
github_repository_url | `` | URL du dépôt GitHub pour la CI/CD automatisée (p. ex. 'https://github.com/username/repo'). |
github_token | `` | Jeton d'accès personnel (PAT) GitHub. Obligatoire lorsque enable_cicd_trigger vaut true. |
github_app_installation_id | `` | ID d'installation de la GitHub App. |
cicd_trigger_config | (défini) | Configuration du déclencheur Cloud Build du pipeline CI/CD automatisé. Exemple : { branch_pattern = "^main$", included_files = [], ignored_files = [], trigger_name = null, description = "Automated build and deployment trigger", substitutions = { } }. |
enable_cloud_deploy | false | Active Google Cloud Deploy pour un pipeline de promotion géré Dev → Staging → Prod. Nécessite enable_cicd_trigger = true. |
cloud_deploy_stages | (défini) | Liste ordonnée des étapes du pipeline Cloud Deploy. |
enable_binary_authorization | false | Active Binary Authorization pour ce déploiement. (p. ex. false) |
binauthz_evaluation_mode | ALWAYS_ALLOW | Mode d'application de Binary Authorization. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 13 — NFS
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_nfs | false | Provisionne une instance Cloud Filestore (NFS) et la monte dans le pod GKE comme volume persistant partagé. |
nfs_mount_path | /mnt/nfs | Chemin du système de fichiers, dans le conteneur, où le volume NFS est monté. (p. ex. '/mnt/nfs') |
nfs_volume_name | nfs-data-volume | Nom du volume pour le montage NFS. (p. ex. 'nfs-data-volume') |
nfs_instance_name | `` | Nom d'une VM GCE NFS existante à utiliser. Laissez vide pour une découverte automatique. |
nfs_instance_base_name | app-nfs | Nom de base de la VM GCE NFS intégrée. (p. ex. 'app-nfs') |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 14 — Cloud Storage et Artifact Registry
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Détermine si le module provisionne les buckets GCS définis dans storage_buckets. |
storage_buckets | (défini) | Buckets Cloud Storage à créer en plus du bucket de données de Chroma. |
gcs_volumes | (défini) | Montages de volumes GCS FUSE via le pilote CSI. Le bucket de données de Chroma est ajouté automatiquement ; utilisez ce paramètre pour des volumes supplémentaires. |
manage_storage_kms_iam | false | Lorsque la valeur est true, crée un trousseau de clés KMS CMEK et une clé de chiffrement du stockage. |
enable_artifact_registry_cmek | false | Lorsque la valeur est true, active le chiffrement CMEK des images de conteneur dans Artifact Registry. |
max_images_to_retain | 7 | Nombre maximal d'images de conteneur récentes à conserver dans Artifact Registry. Définissez 0 pour désactiver. (p. ex. 7) |
delete_untagged_images | true | Supprime automatiquement les images de conteneur sans tag d'Artifact Registry. (p. ex. true) |
image_retention_days | 30 | Nombre de jours au-delà duquel les images de conteneur peuvent être supprimées. Définissez 0 pour désactiver. (p. ex. 30) |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 15 — Redis (transmis, sans objet pour Chroma)
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_redis | true | Active la configuration Redis de l'application en injectant les variables d'environnement REDIS_HOST et REDIS_PORT dans le déploiement GKE. Si la valeur est true et que redis_host est laissé vide, le module utilise par défaut l'IP du serveur NFS comme hôte Redis. Définissez redis_host explicitement pour vous connecter à une instance Redis dédiée telle que Memorystore. |
redis_host | `` | Nom d'hôte ou adresse IP du serveur Redis, injecté comme variable d'environnement REDIS_HOST. Utilisé uniquement lorsque enable_redis vaut true. Laissez vide pour utiliser par défaut l'adresse IP du serveur NFS. (p. ex. '10.0.0.5', 'redis.internal.example.com') |
redis_port | 6379 | Port TCP du serveur Redis, injecté comme variable d'environnement REDIS_PORT. Utilisé uniquement lorsque enable_redis vaut true. (p. ex. '6379') |
redis_auth | `` | Mot de passe d'authentification Redis. Sans objet pour Chroma. Transmis au module socle pour compatibilité. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 16 — Configuration de la base de données (transmise, sans objet pour Chroma)
| Variable | Valeur par défaut | Description |
|---|---|---|
database_type | NONE | Moteur de base de données Cloud SQL. Non référencée — Chroma n'a pas de base de données SQL ; database_type est fixé à NONE par Chroma_Common. |
sql_instance_name | `` | Nom d'une instance Cloud SQL existante. Non référencée — Chroma n'a pas de base de données SQL. |
sql_instance_base_name | app-sql | Nom de base de l'instance Cloud SQL intégrée. Non référencée — Chroma n'a pas de base de données SQL. |
application_database_name | gkeappdb | Nom de la base de données à créer dans l'instance Cloud SQL. Injecté dans l'application comme variable d'environnement DB_NAME. Utilisé uniquement lorsque database_type est différent de 'NONE'. (p. ex. 'app_db', 'crm_production') |
application_database_user | gkeappuser | Nom de l'utilisateur de base de données créé pour l'application. Injecté dans l'application comme variable d'environnement DB_USER. Utilisé uniquement lorsque database_type est différent de 'NONE'. (p. ex. 'app_user', 'crm_svc') |
database_password_length | 32 | Longueur du mot de passe de base de données généré aléatoirement. Non référencée — Chroma n'a pas de base de données SQL. Transmise au socle pour compatibilité. (p. ex. 32) |
enable_postgres_extensions | false | Active les extensions PostgreSQL. Non référencée — Chroma n'a pas de base de données SQL. |
postgres_extensions | (défini) | Extensions PostgreSQL à installer. Non référencée — Chroma n'a pas de base de données SQL. |
enable_mysql_plugins | false | Active les plugins MySQL. Non référencée — Chroma n'a pas de base de données SQL. (p. ex. false) |
mysql_plugins | (défini) | Liste des plugins MySQL à installer. Non référencée — Chroma n'a pas de base de données SQL. |
enable_auto_password_rotation | false | Active la rotation automatisée du mot de passe de base de données. Sans objet — Chroma n'a pas de base de données SQL. |
rotation_propagation_delay_sec | 90 | Nombre de secondes à attendre après un événement de rotation du mot de passe de base de données. Sans objet — Chroma n'a pas de base de données SQL. |
db_password_env_var_name | `` | Variable d'environnement supplémentaire exposant le mot de passe de base de données. Sans objet — Chroma n'a pas de base de données SQL. |
db_host_env_var_name | `` | Nom d'une variable d'environnement supplémentaire exposant l'hôte de la base de données en plus de la variable standard DB_HOST. Laissez vide pour n'injecter que DB_HOST. (p. ex. 'DB_HOSTNAME') |
db_user_env_var_name | `` | Nom d'une variable d'environnement supplémentaire exposant l'utilisateur de la base de données en plus de la variable standard DB_USER. Laissez vide pour n'injecter que DB_USER. (p. ex. 'DB_USERNAME') |
db_name_env_var_name | `` | Nom d'une variable d'environnement supplémentaire exposant le nom de la base de données en plus de la variable standard DB_NAME. Laissez vide pour n'injecter que DB_NAME. (p. ex. 'DB_DATABASE') |
db_port_env_var_name | `` | Nom d'une variable d'environnement supplémentaire exposant le port de la base de données en plus de la variable standard DB_PORT. Laissez vide pour n'injecter que DB_PORT. (p. ex. 'DB_PORT_NUMBER') |
db_name | chromadb | Non référencée — Chroma n'a pas de base de données SQL. Transmise au module socle pour compatibilité. |
db_user | chromauser | Non référencée — Chroma n'a pas de base de données SQL. Transmise au module socle pour compatibilité. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 17 — Sauvegarde et maintenance
| Variable | Valeur par défaut | Description |
|---|---|---|
backup_schedule | 0 2 * * * | Planification cron des sauvegardes automatisées (p. ex. '0 2 * * *' pour une sauvegarde quotidienne à 2 h). Laissez vide pour désactiver. |
backup_retention_days | 7 | Nombre de jours de conservation des fichiers de sauvegarde dans le bucket GCS de sauvegarde. (p. ex. 7) |
enable_backup_import | false | Active l'import automatique d'une sauvegarde pendant le déploiement. (p. ex. false) |
backup_source | gcs | Source de la sauvegarde : 'gdrive' ou 'gcs'. (p. ex. 'gcs') |
backup_file | backup.tar | Nom du fichier de sauvegarde à importer. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
backup_uri | `` | URI de la sauvegarde. Pour GCS : URI complet tel que 'gs://bucket/path/backup.tar'. Pour Google Drive : ID du fichier. |
backup_format | tar | Format du fichier de sauvegarde. (p. ex. 'tar') |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 18 — Scripts SQL personnalisés (sans objet pour Chroma)
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_custom_sql_scripts | false | Active l'exécution de scripts SQL personnalisés depuis GCS pendant l'initialisation. Sans objet pour Chroma (pas de base de données SQL). (p. ex. false) |
custom_sql_scripts_bucket | `` | Nom du bucket GCS contenant les scripts SQL personnalisés. Sans objet pour Chroma. |
custom_sql_scripts_path | `` | Préfixe de chemin des scripts SQL dans le bucket GCS. Sans objet pour Chroma. |
custom_sql_scripts_use_root | false | Exécute les scripts SQL personnalisés en tant qu'utilisateur root de la base de données. Sans objet pour Chroma. (p. ex. false) |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 19 — Domaine personnalisé, IP statique et réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_custom_domain | true | Active la configuration d'un domaine personnalisé via la Kubernetes Gateway API avec des certificats SSL. (p. ex. false) |
application_domains | (défini) | Liste des domaines personnalisés de l'application (p. ex. ['chroma.example.com']). |
reserve_static_ip | true | Réserve une IP externe statique. Recommandé pour la production. |
static_ip_name | `` | Nom de l'IP statique réservée. Laissez vide pour le générer automatiquement. |
network_tags | (défini) | Tags réseau appliqués aux nœuds GKE. Le tag 'nfsserver' est requis lorsque enable_nfs vaut true. (p. ex. ['allow-ingress', 'nfsserver']) |
network_name | `` | Nom du réseau VPC à utiliser. Laissez vide pour une découverte automatique. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
gateway_backend_stage | dev | Étape Cloud Deploy dont le Service est ciblé par la HTTPRoute de la Gateway. Pertinent uniquement lorsque enable_cloud_deploy vaut true. (p. ex. 'dev') |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 20 — Identity-Aware Proxy (IAP)
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_iap | false | Active Identity-Aware Proxy (IAP) pour l'authentification via la Kubernetes Gateway. Requis lorsque service_type vaut 'LoadBalancer' afin d'empêcher tout accès externe non authentifié à l'API de Chroma. Nécessite que enable_custom_domain ou enable_cdn vaille true. (p. ex. false) |
iap_authorized_users | (défini) | Liste des adresses e-mail des utilisateurs autorisés à accéder via IAP (p. ex. ['user:alice@example.com']). |
iap_authorized_groups | (défini) | Liste des Google Groups autorisés à accéder via IAP (p. ex. ['group:engineering@example.com']). |
iap_oauth_client_id | `` | ID client OAuth pour IAP. Obligatoire lorsque enable_iap vaut true. |
iap_oauth_client_secret | `` | Secret client OAuth pour IAP. Obligatoire lorsque enable_iap vaut true. |
iap_support_email | `` | Adresse e-mail de support de l'écran de consentement OAuth d'IAP. Non référencée — définir cette variable n'a aucun effet sur le déploiement dans ce module applicatif. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 21 — Cloud Armor et CDN
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_cloud_armor | false | Associe une politique de sécurité Cloud Armor au backend de l'Ingress GKE. Nécessite que enable_custom_domain vaille true ou que service_type vaille 'LoadBalancer'. |
admin_ip_ranges | (défini) | Plages CIDR d'administration autorisées pour l'accès privilégié. (p. ex. ['203.0.113.0/24']) |
cloud_armor_policy_name | default-waf-policy | Nom de la politique de sécurité Cloud Armor à appliquer. (p. ex. « default-waf-policy ») |
enable_cdn | false | Active Cloud CDN via GCPBackendPolicy. (p. ex. false) |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
Groupe 22 — VPC Service Controls et journalisation d'audit
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vpc_sc | false | Active l'application du périmètre VPC Service Controls. |
vpc_cidr_ranges | (défini) | Plages CIDR des sous-réseaux VPC pour le niveau d'accès réseau VPC-SC. |
vpc_sc_dry_run | true | Lorsque la valeur est true, les violations VPC-SC sont journalisées mais pas bloquées. |
organization_id | `` | ID d'organisation GCP pour la politique Access Context Manager de VPC-SC. |
enable_audit_logging | false | Active les Cloud Audit Logs détaillés pour tous les services GCP pris en charge. |
Toutes les autres entrées de ce groupe suivent le comportement standard d'App_GKE.
5. Sorties
Ces valeurs sont renvoyées à l'issue d'un déploiement réussi et constituent le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du Service Kubernetes. |
namespace | Espace de noms dans lequel s'exécute la charge de travail. |
service_cluster_ip | ClusterIP interne au cluster. |
stage_service_cluster_ips | Table des ClusterIP des services propres à chaque étape (Cloud Deploy). |
service_external_ip | IP externe du LoadBalancer (lorsqu'une IP statique est réservée). |
endpoint_url | Point de terminaison de l'API REST de Chroma (<service-url>:8000). |
storage_buckets | Buckets Cloud Storage créés. |
network_name / network_exists / regions | Réseau VPC, présence, régions disponibles. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels | État de la surveillance et canaux. |
initialization_jobs | Noms des éventuels jobs de configuration personnalisés. |
statefulset_name | Nom du StatefulSet (avec un stockage adossé à un PVC). |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / github_repository_url / github_repository_owner / github_repository_name / cicd_configuration | État et détails de la CI/CD. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Dépôt et déclencheur de build. |
kubernetes_ready | Indique si le cluster et la charge de travail sont prêts. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État de VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | État de la journalisation d'audit et de CMEK. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
enable_auth_token | true pour tout déploiement joignable depuis l'extérieur | Critique | Sans jeton, tout appelant pouvant atteindre l'API de Chroma peut lire, écrire ou supprimer chaque collection. |
stateful_pvc_enabled | true pour la production | Élevé | Sans PVC, Chroma stocke ses données dans le système de fichiers éphémère du conteneur. Un redémarrage du pod efface toutes les collections et tous les vecteurs. |
stateful_pvc_mount_path | /data | Critique | Si le chemin de montage ne correspond pas au répertoire de stockage de Chroma, les données sont écrites dans la couche éphémère et perdues sans avertissement au redémarrage. |
stateful_pvc_size | 20Gi (dimensionnez généreusement) | Élevé | Un PVC plein fait planter Chroma avec des erreurs de disque saturé. La capacité d'un PVC ne peut pas être réduite après son provisionnement. |
max_instance_count | 1 | Élevé | Plusieurs pods Chroma sur le même stockage corrompront les collections — Chroma ne dispose d'aucun verrou d'écriture distribué. |
memory_limit | 4Gi ou plus pour la production | Élevé | Chroma charge les index HNSW en mémoire. La valeur par défaut 1Gi ne convient qu'à de très petites collections ; les arrêts pour OOM interrompent les requêtes en cours. |
workload_type | défini par stateful_pvc_enabled | Élevé | Définir explicitement "Deployment" en même temps que stateful_pvc_enabled = true échoue au moment du plan. |
quota_memory_requests / _limits | unités binaires | Critique | Les entiers nus sont interprétés comme des octets et bloquent la planification de tous les pods. |
application_version | figer un tag précis | Moyen | Utiliser latest rend les déploiements non reproductibles. Les formats de données de Chroma peuvent changer d'une version majeure à l'autre. |
iap_oauth_client_id / _secret | à définir avant d'activer IAP | Élevé | Définir enable_iap = true sans identifiants OAuth valides bloque tout le trafic. |
enable_iap / enable_cloud_armor | à activer pour les services joignables depuis l'extérieur | Élevé | Sans authentification, un point de terminaison Chroma exposé à l'extérieur est entièrement ouvert. |
backup_retention_days | à augmenter pour la production | Moyen | Trop court pour la reprise après sinistre ; les instantanés réguliers GCS ou PVC constituent la principale voie de restauration. |
min_instance_count | 1 | Moyen | La mise à l'échelle à zéro entraîne la suppression du pod ; après la remontée en charge, Chroma doit recharger ses index depuis le PVC ou GCS, ce qui allonge le démarrage. |
database_type / sql_instance_name / application_database_name_user / redis_host_port_auth | laisser la valeur par défaut | Faible | Ces entrées des groupes 15/16 sont transmises à App_GKE uniquement pour la parité des conventions ; Chroma_Common fixe database_type = "NONE" et main.tf code en dur enable_redis = false, de sorte que les modifier n'a aucun effet. |
container_image_source / container_protocol / container_build_config | laisser la valeur par défaut | Faible | Non référencées par ce module — la source de l'image, le build et le protocole sont fixés par Chroma_Common. Les modifier n'a aucun effet. |
Pour le comportement du socle évoqué tout au long de ce guide — IAM et Workload Identity, autoscaling, ingress et certificats, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir des images — voir App_GKE. La configuration applicative propre à Chroma, partagée avec la variante Cloud Run, est décrite dans Chroma_Common.
Guides associés
- Lab pratique : Chroma sur GKE Autopilot — déployez-le pas à pas, avec les écrans de la console et les commandes à chaque étape.
- Chroma sur Google Cloud Run — la même application sur Cloud Run, lorsque vous avez besoin de l'autre cible de déploiement.
- Chroma Common — Configuration applicative partagée — la configuration partagée par les deux cibles de déploiement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.