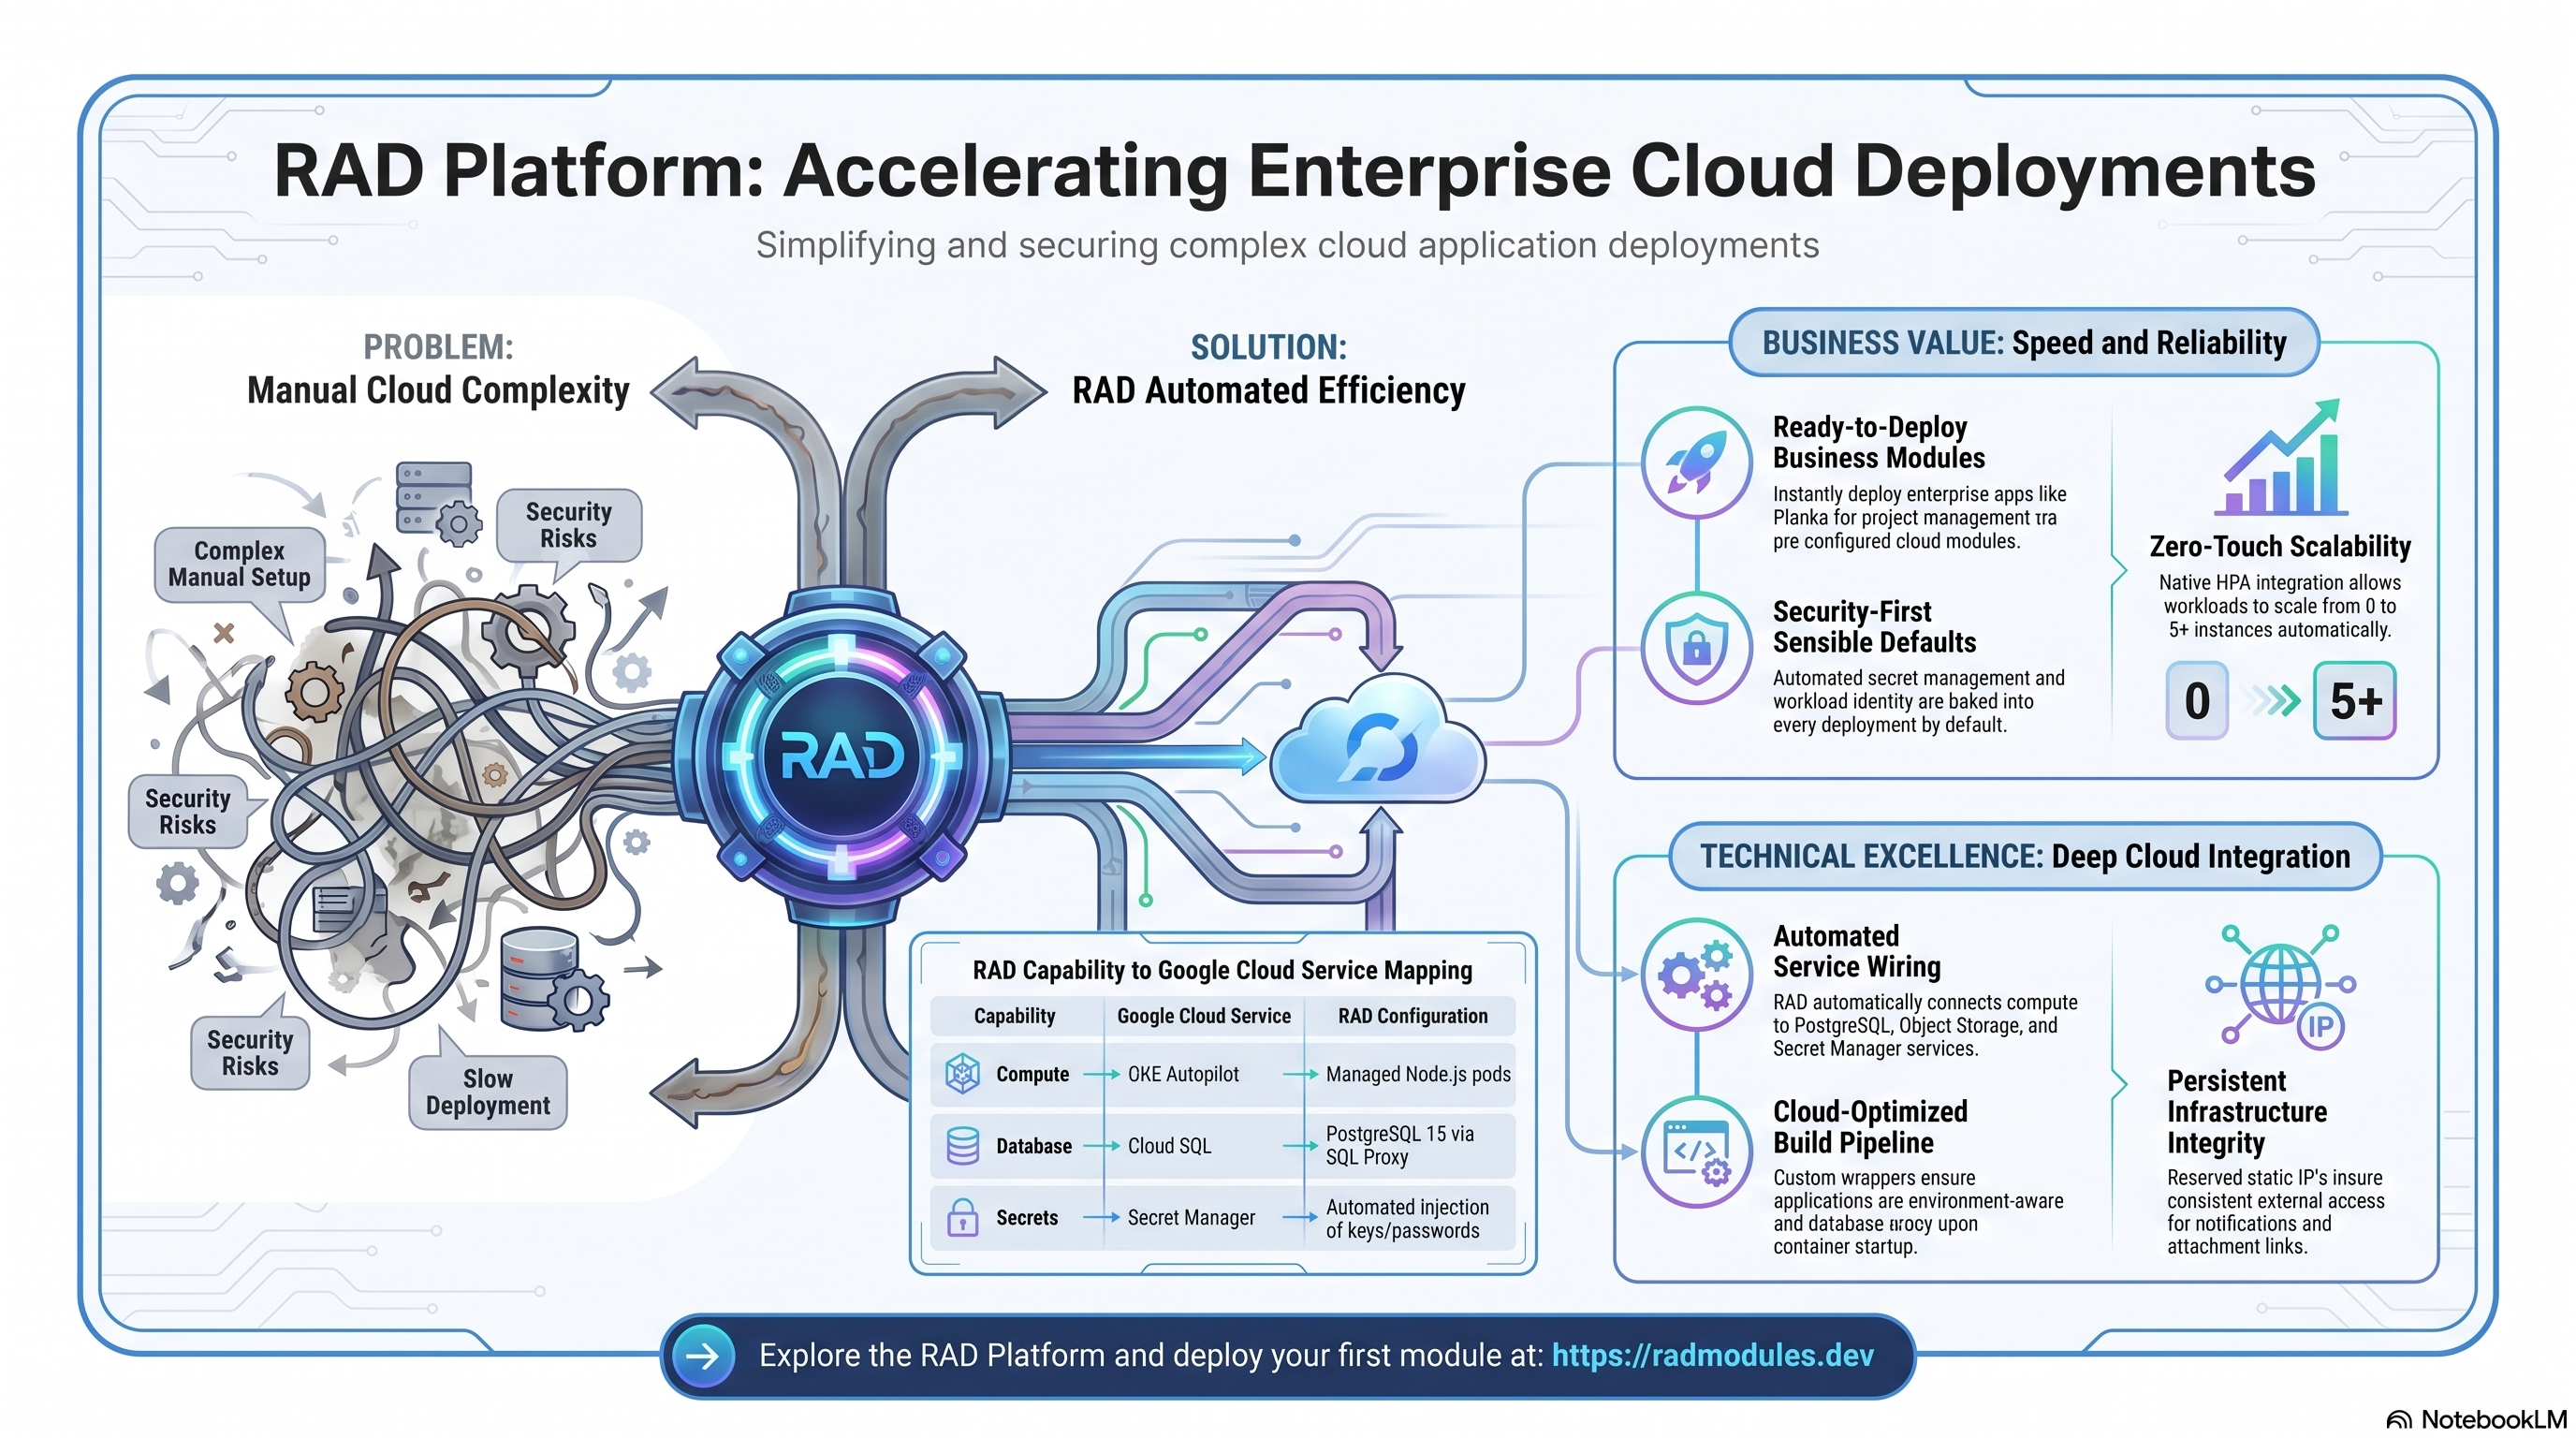
Planka est une application open source et auto-hébergée de tableaux kanban de
type Trello, dotée d'un backend Node.js (Sails.js) et d'un frontend React,
utilisée pour la gestion de projets d'équipe et personnels — tableaux, listes,
cartes, échéances, étiquettes et pièces jointes. Ce module déploie Planka sur
GKE Autopilot en s'appuyant sur le socle App_GKE, qui
provisionne et gère l'infrastructure Google Cloud et Kubernetes partagée.
Ce guide se concentre sur les services cloud utilisés par Planka et sur la
manière de les explorer et de les exploiter depuis la console Google Cloud et la
ligne de commande. Pour les mécanismes communs à toutes les applications GKE —
Workload Identity, entrée, autoscaling, CI/CD, Cloud Armor, IAP, Binary
Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement
— reportez-vous au guide du socle App_GKE plutôt que de les
répéter ici.
1. Vue d'ensemble
Planka s'exécute sous forme d'une unique charge de travail web Node.js, qui sert
à la fois son API et son frontend React depuis un seul port. Le déploiement
assemble un ensemble restreint et ciblé de services Google Cloud :
| Fonctionnalité | Service Google Cloud | Remarques |
|---|
| Calcul | GKE Autopilot | Pod Node.js, 2 vCPU / 4 GiB par défaut |
| Base de données | Cloud SQL for PostgreSQL 15 | Le générateur de requêtes Knex de Planka ne prend en charge aucun autre moteur |
| Stockage d'objets | Cloud Storage | Un bucket storage est créé pour les pièces jointes, mais n'est pas monté automatiquement |
| Cache et file d'attente | aucun | Planka ne dépend ni de Redis ni d'une file d'attente — les mises à jour en temps réel passent par Socket.io dans le processus |
| Secrets | Secret Manager | SECRET_KEY et DEFAULT_ADMIN_PASSWORD — deux secrets réels et fonctionnels — ainsi que le mot de passe de la base de données |
| Entrée | Cloud Load Balancing | LoadBalancer externe, IP statique réservée, domaine personnalisé en option |
Valeurs par défaut judicieuses à connaître d'emblée :
- PostgreSQL est le seul moteur pris en charge.
Planka_Common impose
database_type = "POSTGRES_15".
- Un build personnalisé léger, et non l'image préconstruite. Planka a besoin
d'un point d'entrée cloud pour composer
DATABASE_URL et dériver BASE_URL ;
container_image_source = "custom" construit donc FROM ghcr.io/plankanban/planka:<version> via Cloud Build.
DATABASE_URL est une chaîne de connexion de type autorité d'URL, mais le
SSL est défini par des variables d'environnement distinctes — jamais par un
paramètre de requête ?sslmode=. Planka dispose de deux chemins de
connexion à la base indépendants (la CLI de migration et l'ORM Sails du
serveur en cours d'exécution), qui nécessitent chacun une configuration SSL
différente et ignorent chacun un ?sslmode= intégré à l'URL pour une raison
propre, sans rapport avec l'autre. Sur GKE, le sidecar Cloud SQL Auth Proxy
écoute sur 127.0.0.1 et termine lui-même le TLS ; le point d'entrée ne
définit donc ni PGSSLMODE ni
KNEX_REJECT_UNAUTHORIZED_SSL_CERTIFICATE pour cette connexion loopback —
aucune configuration SSL n'est nécessaire. Consultez le
guide Common pour l'explication complète des deux chemins
et la branche TCP via IP privée.- Deux secrets applicatifs réels et fonctionnels.
SECRET_KEY (signature
des sessions/jetons, requis au démarrage) et DEFAULT_ADMIN_PASSWORD (crée le
compte administrateur initial au premier démarrage sur une base vide) sont
tous deux réellement utilisés par Planka. Il n'y a aucune réinitialisation
du mot de passe imposée ; changez donc le mot de passe initial
immédiatement après le premier déploiement.
workload_type vaut Deployment par défaut, et non StatefulSet. Planka
ne conserve aucun état local au-delà de ce qui se trouve déjà dans Cloud SQL.reserve_static_ip = true (remplace la valeur par défaut false
d'App_GKE). Le point d'entrée cloud dérive BASE_URL de GKE_SERVICE_URL
injectée ; sans IP statique réservée, BASE_URL peut se rabattre sur un DNS
interne *.svc.cluster.local injoignable, ce qui casse les liens des pièces
jointes et les notifications par e-mail.- Les pièces jointes ne sont pas persistées par défaut. Un bucket GCS est
créé mais n'est pas monté automatiquement — ajoutez une entrée
gcs_volumes
si les pièces jointes, avatars et arrière-plans téléversés doivent survivre au
redémarrage d'un pod.
- Pas de Redis, pas de NFS.
enable_redis et enable_nfs valent tous deux
false par défaut — Planka n'a besoin ni d'un backend de cache/file
d'attente ni d'un partage de système de fichiers POSIX.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que vous avez exécuté
gcloud container clusters get-credentials <cluster> --region <region> --project <project>
et que PROJECT, REGION et NAMESPACE sont définies.
A. GKE Autopilot — la charge de travail Planka
- CLI :
kubectl get pods,svc -n "$NAMESPACE"
kubectl logs -n "$NAMESPACE" deploy/<service-name> --tail=100
kubectl exec -n "$NAMESPACE" deploy/<service-name> -- env | grep -E 'DB_HOST|DB_IP|BASE_URL'
B. Cloud SQL for PostgreSQL 15
Les pods accèdent à la base de données de manière privée via le sidecar
cloud-sql-proxy sur 127.0.0.1. Au premier déploiement, un Job
d'initialisation crée la base de données et le rôle de l'application ; Planka
exécute ensuite ses propres migrations et son seed à chaque démarrage de pod.
- CLI :
gcloud sql instances list --project "$PROJECT"
gcloud sql connect <instance-name> --user=<db-user> --database=<db-name> --project "$PROJECT"
C. Cloud Storage
- CLI :
gcloud storage buckets list --project "$PROJECT" --filter="name~planka"
D. Secret Manager
- CLI :
gcloud secrets list --project "$PROJECT" --filter="name~planka"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
E. Réseau et entrée
Par défaut, la charge de travail est exposée via une IP Cloud Load Balancing
externe avec une adresse statique réservée. Le BASE_URL de Planka (utilisé
pour les liens des pièces jointes et les notifications par e-mail) est dérivé de
cette adresse — mettez à jour BASE_URL explicitement si un domaine
personnalisé est ajouté par la suite.
- CLI :
kubectl get svc -n "$NAMESPACE" -o wide
F. Cloud Logging et Monitoring
- CLI :
kubectl logs -n "$NAMESPACE" deploy/<service-name> --tail=100 -f
3. Comportement de l'application Planka
- Configuration de la base de données au premier déploiement. Un Job
d'initialisation exécute
db-init.sh et crée de manière idempotente le rôle
et la base de données de l'application (aucun CREATEROLE/CREATEDB
requis).
- Migrations de schéma et seed à chaque démarrage. Le
start.sh de l'image
officielle exécute node db/init.js (migrations + seed) avant de démarrer le
serveur.
- Véritable identifiant d'amorçage administrateur — sans réinitialisation
imposée. Planka crée
admin@example.com avec le DEFAULT_ADMIN_PASSWORD
généré au premier démarrage (sur une base vide), sans imposer de
réinitialisation du mot de passe — connectez-vous et changez le mot de passe
depuis l'interface de Planka rapidement après le déploiement.
DATABASE_URL composée par le point d'entrée cloud. Construite au
démarrage du conteneur à partir des valeurs DB_* injectées par le socle (le
mot de passe est une valeur Secret Manager disponible à l'exécution,
indisponible au moment du plan). Consultez Planka_Common
pour le détail complet.- Chemin de santé. Les sondes de démarrage et de vivacité sont configurées
via les variables
startup_probe/liveness_probe. Le propre
server/healthcheck.js de Planka cible le chemin racine / sans
authentification, et les variables startup_probe/liveness_probe de ce
module utilisent désormais correctement path = "/" par défaut pour
correspondre.
- Inspecter l'exécution des jobs :
kubectl get jobs -n "$NAMESPACE"
kubectl logs -n "$NAMESPACE" job/<job-name>
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la
plateforme de déploiement. Seuls les paramètres propres à Planka ou notables
pour lui sont listés ; toutes les autres entrées sont héritées
d'App_GKE avec leur comportement standard.
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|
application_name | planka | Nom de base des ressources. |
application_version | latest | Utilisé comme ARG de build PLANKA_VERSION. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|
container_image_source | custom | Planka a besoin de l'enveloppe du point d'entrée cloud — conservez custom. |
container_port | 1337 | Port natif par défaut de Planka ; le port du conteneur et les sondes doivent correspondre. |
min_instance_count / max_instance_count | 0 / 5 | Bornes de mise à l'échelle du HPA. |
container_resources.memory_limit | 4Gi | Planka nécessite au moins 2Gi pour un fonctionnement fiable. |
Groupe 6 — Backend GKE et cluster
| Variable | Valeur par défaut | Description |
|---|
workload_type | null (→ Deployment) | Planka est sans état au niveau du pod. |
service_type | LoadBalancer | Application kanban exposée publiquement — un remplacement par ClusterIP n'a pas lieu d'être ici. |
session_affinity | ClientIP | Routage persistant pour qu'un client reste sur un même pod. |
Groupe 14 — Cloud Storage
| Variable | Valeur par défaut | Description |
|---|
storage_buckets | un bucket storage | Créé mais non monté automatiquement. |
gcs_volumes | [] | Ajoutez une entrée montée sur /app/data pour un stockage persistant des pièces jointes. |
Groupe 16 — Configuration de la base de données
| Variable | Valeur par défaut | Description |
|---|
database_type | POSTGRES_15 | Fixe — Knex ne prend en charge aucun autre moteur. |
application_database_name / application_database_user | planka / planka | Nom de la base de données PostgreSQL et nom d'utilisateur de l'application. |
Groupe 10 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|
startup_probe / liveness_probe | HTTP /, délai de 60s | Les sondes réellement appliquées au pod déployé, désormais alignées sur la cible de santé réelle et non authentifiée de Planka (server/healthcheck.js). |
startup_probe_config / health_check_config | HTTP /, délai de 60s | Valeurs par défaut au niveau du socle ; remplacées par startup_probe/liveness_probe ci-dessus — sans effet en pratique. |
Groupe 13 — NFS
| Variable | Valeur par défaut | Description |
|---|
enable_nfs | false | Inutile — Planka n'exige pas de système de fichiers POSIX. |
Groupe 15 — Redis
| Variable | Valeur par défaut | Description |
|---|
enable_redis | false | Planka ne dépend ni d'un cache ni d'une file d'attente. |
Groupe 19 — Domaine personnalisé, IP statique et réseau
| Variable | Valeur par défaut | Description |
|---|
enable_custom_domain | true | Provisionne un Ingress + un certificat géré. |
reserve_static_ip | true | Remplace la valeur par défaut d'App_GKE (false) afin que BASE_URL se résolve en une adresse réelle et joignable — voir §1. |
5. Sorties
| Sortie | Description |
|---|
service_name / service_url / service_external_ip | Identité et adresse du Service Kubernetes. |
database_instance_name / database_name / database_user / database_host / database_port | Détails de connexion Cloud SQL. |
storage_buckets | Le bucket storage des pièces jointes. |
kubernetes_ready | Indique si la charge de travail a atteint l'état Ready. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) —
Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|
application_database_name / application_database_user | À définir une fois | Critique | Immuables après le premier déploiement ; les renommer recrée la base de données/le rôle et détruit toutes les données. |
container_image_source | custom (par défaut) | Élevé | "prebuilt" déploie directement l'image officielle en ignorant le point d'entrée cloud — Planka démarre sans DATABASE_URL. |
Chemin de startup_probe / liveness_probe | / (valeur par défaut du module) | Élevé | Correspond à la cible de santé réelle et non authentifiée de Planka (selon server/healthcheck.js, un simple GET HTTP sur / qui vérifie un 200). S'il est remplacé par un autre chemin, le pod peut ne jamais devenir Ready. |
reserve_static_ip | true (déjà la valeur par défaut du module) | Élevé | false peut laisser BASE_URL pointer vers un DNS interne *.svc.cluster.local injoignable, ce qui casse les liens des pièces jointes et les notifications par e-mail. |
DEFAULT_ADMIN_PASSWORD (secret généré) | Connectez-vous et changez-le immédiatement après le premier déploiement | Critique | Planka n'impose pas de réinitialisation du mot de passe — quiconque obtient le mot de passe initial peut se connecter en tant qu'administrateur indéfiniment tant qu'il n'est pas changé. |
DATABASE_URL / configuration SSL | Ne jamais modifier à la main — contrôlée par le point d'entrée cloud via les variables d'environnement PGSSLMODE/KNEX_REJECT_UNAUTHORIZED_SSL_CERTIFICATE, et NON par un paramètre de requête ?sslmode= | Critique | Planka dispose de deux chemins de connexion à la base indépendants, avec des mécanismes SSL différents, confirmés en suivant la chaîne de dépendances réelle : (1) la CLI de migration (server/db/knexfile.js) lit KNEX_REJECT_UNAUTHORIZED_SSL_CERTIFICATE ; (2) l'ORM Sails du serveur en cours d'exécution (sails-postgresql → machinepack-postgresql) analyse DATABASE_URL avec l'ancien url.parse() de Node, qui supprime silencieusement tous les paramètres de requête, y compris ?sslmode= — un sslmode intégré à l'URL n'a donc aucun effet sur le chemin d'exécution. Sans configuration ssl explicite, pg brut se rabat sur la variable d'environnement PGSSLMODE, où require signifie « chiffrer ET vérifier » (et non « chiffrer seulement » comme dans libpq classique) — seul PGSSLMODE=no-verify désactive la vérification du certificat. Le certificat auto-signé de Cloud SQL ne figure pas dans le bundle d'autorités de Node ; toute valeur autre que no-verify échoue donc au démarrage avec UNABLE_TO_VERIFY_LEAF_SIGNATURE et le hook orm de Sails ne se charge jamais. La connexion loopback sur GKE (sidecar Cloud SQL Auth Proxy) ne nécessite aucune des deux variables — le proxy termine déjà le TLS. |
gcs_volumes pour les pièces jointes | À ajouter explicitement si nécessaire | Moyen | Sans cela, les pièces jointes téléversées résident sur le système de fichiers éphémère du pod et ne survivent pas à un redémarrage. |
quota_memory_requests / _limits | unités binaires (4Gi, 8192Mi) | Critique | Des entiers nus sont interprétés en octets et bloquent toute planification de pods dans l'espace de noms. |
Pour le comportement du socle mentionné tout au long de ce guide — IAM et
Workload Identity, autoscaling, entrée et certificats, CI/CD, Cloud Armor, IAP,
Binary Authorization, VPC-SC, sauvegardes et mise en miroir des images —
consultez App_GKE. La configuration applicative propre à
Planka partagée avec la variante Cloud Run est décrite dans
Planka_Common.