Planka sur Google Cloud Run
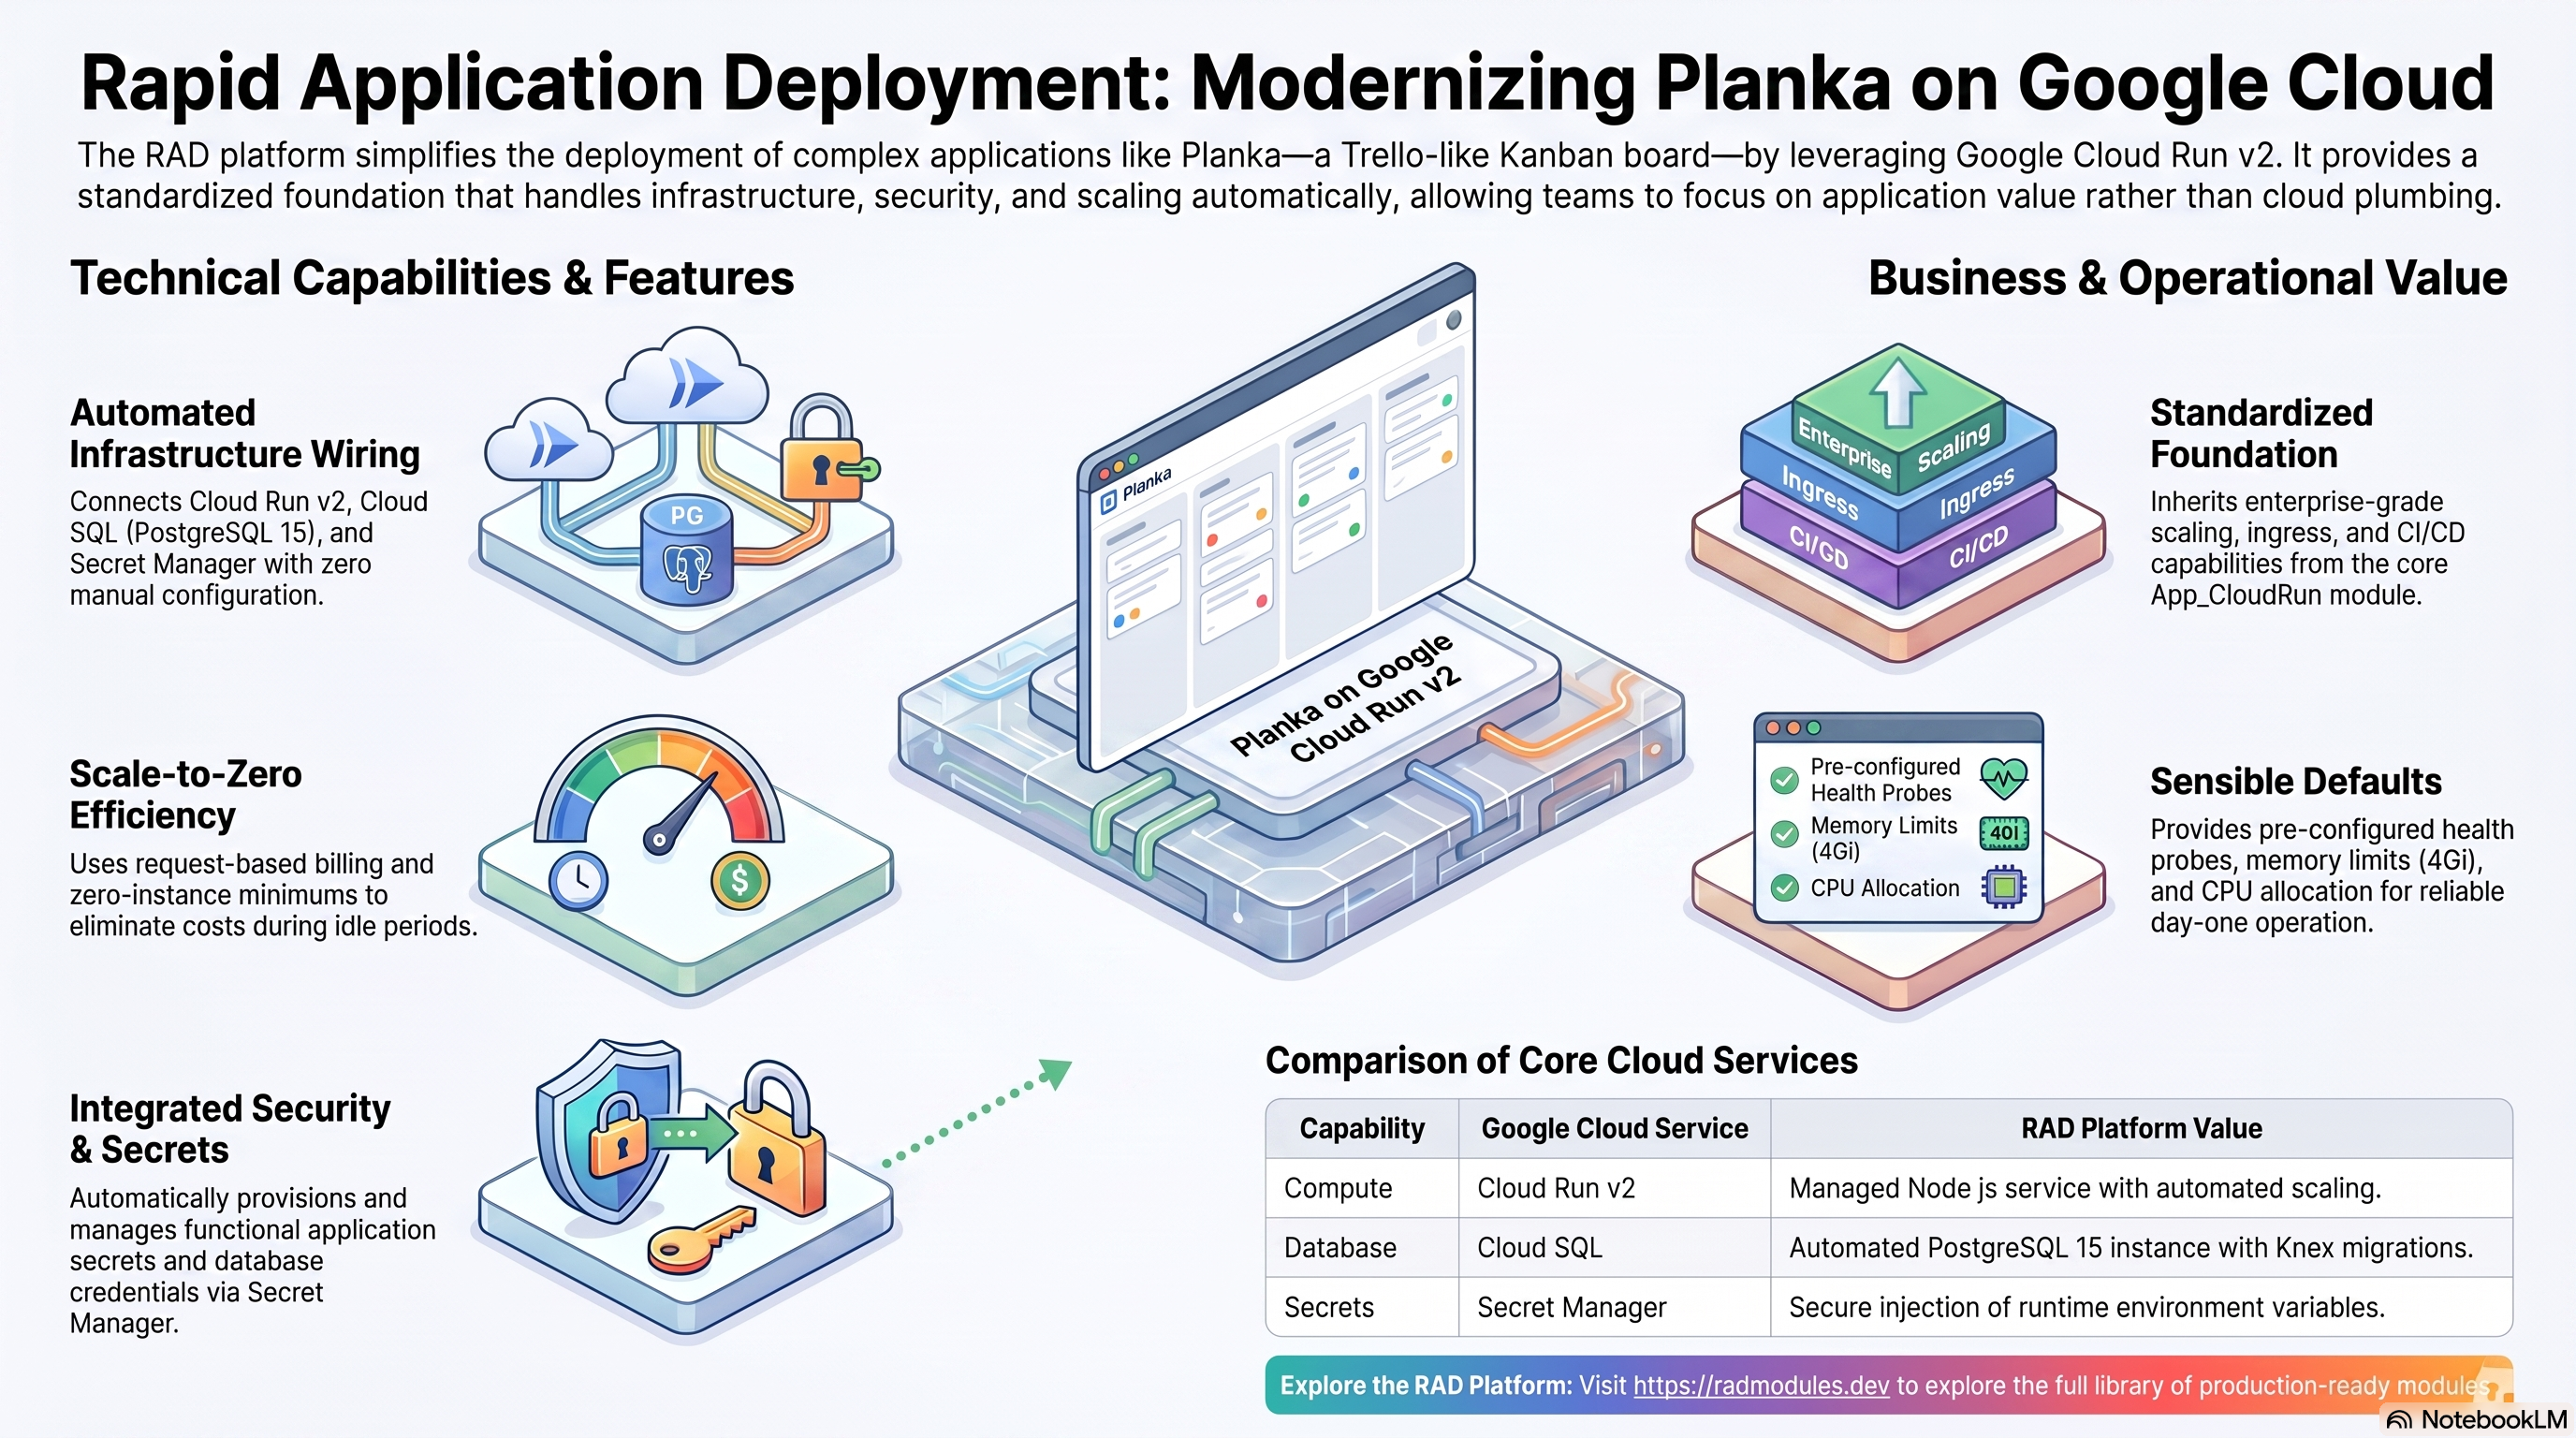
Planka est une application open-source de tableau kanban auto-hébergée, similaire à Trello, avec un backend Node.js (Sails.js) et un frontend React, utilisée pour la gestion de projets personnels et d'équipe — tableaux, listes, cartes, dates d'échéance, étiquettes et pièces jointes. Ce module déploie Planka sur Cloud Run v2 au-dessus de la fondation App_CloudRun, qui provisionne et gère l'infrastructure Google Cloud partagée.
Ce guide se concentre sur les services cloud que Planka utilise et sur la manière de les explorer et de les opérer depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à chaque application Cloud Run — identité de service, ingress et équilibrage de charge, mise à l'échelle et concurrence, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide de la fondation App_CloudRun plutôt que de les répéter ici.
Ce que Planka coûte sur RAD, et comment cela se compare
L'exécution de Planka dans votre propre projet Google Cloud coûte environ 88,56 US$/mois en infrastructure, plus des frais de module uniques de 75 crédits RAD (dimensionnés à 2 vCPU / 4 GiB sur une instance Cloud Run scale-to-zero). RAD facture les frais de module une seule fois, au moment du déploiement — jamais plus lors d'un Update — et les builds sont inclus dans le prix ; l'utilisation de Google Cloud elle-même est facturée à votre propre compte de facturation au prix catalogue de Google. Sur un projet géré par RAD, les mêmes ressources sont mesurées à l'heure en crédits au prix catalogue plus la marge de RAD — environ 61 crédits/jour — et les frais de module sont inférieurs de 10 %, à 67,50 crédits. Voir "Mettez-le en pause gratuitement" ci-dessous pour savoir comment un déploiement Planka géré par RAD peut être arrêté, sans frais d'exécution, jusqu'à ce que vous en ayez à nouveau besoin. (ou voir le guide GKE si vous avez besoin de Kubernetes)
Ce que vous payez sur RAD
| Article | Votre propre projet | Projet géré par RAD |
|---|---|---|
| Frais de module | 75 crédits (une fois) | 67,50 crédits (une fois) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients sont l'exception : ils sont toujours facturés pour le temps de build à la minute | Idem |
| Coût d'exécution Google Cloud | ~88,56 US$/mois, facturé à votre propre compte de facturation au prix catalogue de Google | ~61 crédits/jour, mesurés à l'heure au prix catalogue + marge de RAD |
Votre premier déploiement réussi sur RAD est exempt de frais de module, quel que soit le montant : une fois par compte, pour un module que vous déployez et payez vous-même (dans une solution, les frais d'une application : la première à réussir ; jamais une session de lab ou un projet client).
Coût d'exécution par défaut dans votre propre projet
| Ressource | US$/mois (prix catalogue Google, us-central1) |
|---|---|
| Cloud Run, 2x vCPU / 4 GiB (scaleToZero) | 31,53 |
| Cloud SQL pour PostgreSQL, 1 vCPU / 3,75 GB, zonal, 10 GB SSD | 51,02 |
| Cloud NAT et réseau | 5 |
| Cloud Storage (modules complémentaires, sauvegardes) | 1 |
| Total | 88,56 $ |
Comment cela se compare
- Nous n'avons pas pu vérifier un prix SaaS commercial actuel, directement comparable, pour ce projet open-source exact, donc la comparaison honnête est un serveur auto-géré nu : Hetzner CPX22 (2 vCPU/4GB, ~24 $/mois), un DigitalOcean 2 vCPU/4GB Droplet (~24 $/mois), ou un GCP Compute Engine e2-standard-2 (2 vCPU/8GB, ~49 $/mois).
- RAD ne prétend pas battre un VPS nu sur le prix affiché — ce n'est généralement pas le cas. Ce que RAD ajoute pour un montant en dollars identique ou similaire, c'est une base de données gérée, des identifiants conservés par Secret Manager, la surveillance et la mise à jour en un clic, ce qu'un VPS nu ne vous offre pas gratuitement.
- Sur un VPS nu, c'est vous qui appliquez les correctifs de sécurité du système d'exploitation/de la base de données, effectuez et testez les sauvegardes, et renouvelez les certificats ; Cloud SQL géré par RAD, Secret Manager et la surveillance gèrent les trois pour vous.
Mettez-le en pause gratuitement : supprimez un projet géré par RAD, restaurez-le lorsque vous en avez besoin
C'est l'option principale sur un projet géré par RAD, et elle est gratuite pendant la pause. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer le projet lui-même — la suppression logicielle récupérable de 30 jours de Google. Contrairement à la suppression d'un seul module, cela ne détruit pas la base de données, une VM ou la ressource de calcul une par une : l'ensemble du projet s'arrête simplement, et comme la facturation est déjà déliée, rien n'est facturé pendant qu'il attend.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, sera utilisable après sa restauration, de sorte que la restauration ne peut pas être utilisée comme moyen de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
La restauration — dans les 30 jours, et uniquement par le propriétaire du projet — demande à Google de récupérer le projet et de rattacher son compte de facturation, puis vous demande d'exécuter Update sur chaque déploiement pour confirmer que tout est revenu. Comme rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes : c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit. Ce qu'il faut : vous devez être propriétaire du projet (pas seulement faire gérer sa facturation par RAD), vous devez le restaurer vous-même dans les 30 jours — après cela, Google le supprime définitivement — et la restauration est admise comme la création d'un nouveau projet, donc votre solde de crédits achetés doit toujours dépasser le seuil du palier (100 crédits pour le palier sandbox adapté à la plupart des utilisations d'étude et de démonstration). Google indique que la plupart des services sont à nouveau pleinement opérationnels dans les 36 heures suivant une restauration.
Un véritable manque : les sauvegardes nocturnes sont écrites dans un bucket à l'intérieur du projet, et ce bucket a la suppression logicielle de Cloud Storage explicitement désactivée, de sorte que le bucket de sauvegarde est très probablement supprimé dès que vous supprimez le projet — même si le projet lui-même est récupérable pendant 30 jours. Si vous avez personnalisé ce déploiement et que vous souhaitez conserver ce travail, copiez une sauvegarde (vers Google Drive, ou un bucket en dehors du projet) avant de supprimer. Pour une installation par défaut sans rien d'irremplaçable, cela n'a pas d'importance.
Payez uniquement pendant que vous l'utilisez, l'autre méthode : supprimer et redéployer
L'autre levier, pour un projet propre (ou un projet géré par RAD au-delà de sa fenêtre de restauration de 30 jours), consiste à supprimer Planka purement et simplement et à le redéployer plus tard. Un redéploiement coûte à nouveau les frais de module (les builds sont inclus) — 75 crédits au total pour ce module.
La suppression ne permet d'économiser de l'argent que si Planka reste inutilisé suffisamment longtemps pour compenser le coût de ce redéploiement par rapport à son propre coût d'exécution — pour ce module, cela représente environ 3 jours ou plus d'inactivité, sur la base de son coût d'exécution de 88,56 US$/mois mentionné ci-dessus. La majeure partie de ce coût d'exécution est généralement la base de données et toute VM de fichier/cache partagée, et elles ne s'arrêtent que si rien d'autre dans le projet ne les utilise, de sorte que la suppression de cette application seule n'économise que sa propre part de calcul si quelque chose d'autre partage le projet.
Conservez d'abord les données : les sauvegardes nocturnes vont dans un bucket à l'intérieur du déploiement et sont supprimées avec celui-ci, donc copiez la dernière sauvegarde avant de supprimer si vous voulez la conserver.
Sessions de lab et environnements gérés
- Sessions de lab, pour la formation : un formateur anime une session pour une classe. Chaque participant obtient l'application dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite d'une allocation définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés sont reversés au formateur.
- Environnements gérés, pour les cabinets de conseil : un partenaire exécute l'application pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille devient faible, la facturation est suspendue et les données sont conservées, afin que personne ne reçoive de frais inattendus. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
- Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue de l'API Google Cloud Billing Catalog ; radmodules.dev/pricing pour les propres frais de RAD et les estimations de crédits quotidiens ; Resource Manager : supprimer et restaurer des projets pour les mécanismes de pause/restauration.
1. Vue d'ensemble
Planka s'exécute comme un conteneur Node.js unique sur Cloud Run v2, servant à la fois son API et son frontend React à partir d'un seul port. Le déploiement relie un ensemble restreint et ciblé de services Google Cloud :
| Capacité | Service Google Cloud | Notes |
|---|---|---|
| Calcul | Cloud Run v2 | Service Node.js, 2 vCPU / 4 GiB par défaut, scale-to-zero |
| Base de données | Cloud SQL pour PostgreSQL 15 | Le constructeur de requêtes Knex de Planka ne prend en charge aucun autre moteur |
| Stockage d'objets | Cloud Storage | Un bucket storage est créé et monté à /app/data pour les pièces jointes, les avatars et les arrière-plans |
| Cache et file d'attente | aucun | Planka n'a pas de dépendance Redis ou de file d'attente — les mises à jour en temps réel passent par Socket.io in-process |
| Secrets | Secret Manager | SECRET_KEY et DEFAULT_ADMIN_PASSWORD — tous deux des secrets réels et fonctionnels — plus le mot de passe de la base de données |
| Ingress | URL Cloud Run | URL run.app par défaut ; équilibreur de charge HTTPS externe facultatif + domaine personnalisé |
Valeurs par défaut judicieuses à connaître d'emblée :
- PostgreSQL 15 est le seul moteur pris en charge.
Planka_Commoncorrigedatabase_type = "POSTGRES_15"— Knex n'a pas d'autre backend pour Planka. - Un build personnalisé léger, pas l'image pré-construite. Planka a
besoin d'un point d'entrée cloud pour composer
DATABASE_URLà partir des valeursDB_*injectées par la fondation au moment de l'exécution (le mot de passe est une valeur Secret Manager, indisponible au moment de la planification) et pour dériverBASE_URLde l'URL du service, donccontainer_image_source = "custom"construitFROM ghcr.io/plankanban/planka:<version>via Cloud Build. DATABASE_URLest une chaîne de connexion d'autorité URL, mais SSL est défini via des variables d'environnement séparées — pas un paramètre de requête?sslmode=. Contrairement à certaines applications Node/Postgres de ce catalogue (par exemple Logto), le propre.env.samplede Planka indique que Knex ne parse pas du tout les paramètres de requête de la chaîne de connexion. Le mode TLS est contrôlé à la place par les variables d'environnement simplesPGSSLMODEetKNEX_REJECT_UNAUTHORIZED_SSL_CERTIFICATE, que node-postgres lit nativement — voir le guide commun pour la logique de branchement complète socket/loopback/IP privée.- Deux secrets d'application réels et fonctionnels.
SECRET_KEY(signature de session/jeton, requise au démarrage) etDEFAULT_ADMIN_PASSWORD(initialise le compte administrateur initial lors du premier démarrage avec une base de données vide) sont tous deux réellement consommés par Planka — confirmé par sa propre source (server/.env.sample,server/db/seeds/default.js). Planka n'a pas d'invite de réinitialisation de mot de passe forcée, alors changez le mot de passe initial immédiatement après le premier déploiement. - Les pièces jointes persistent par défaut. Le module monte le bucket
GCS
storageau chemin/app/datade Planka, qui contient tous les types de téléchargement (pièces jointes, avatars, arrière-plans, favicons). Les données des tableaux/cartes/listes se trouvent dans PostgreSQL. - Facturation basée sur les requêtes par défaut.
cpu_always_allocated = false,min_instance_count = 0— les mises à jour en temps réel de Planka passent par Socket.io in-process sur le processus de service de requêtes, donc il n'a pas besoin de CPU en arrière-plan. - Pas de Redis. Planka n'a pas de dépendance de cache ou de file
d'attente ;
enable_redispar défaut àfalse. - Pas de NFS.
enable_nfspar défaut àfalse— Planka n'a pas besoin de partage de système de fichiers POSIX ; le bucket GCS monté automatiquement couvre le stockage de fichiers.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que PROJECT et REGION sont définis. Les
noms des services et des ressources sont indiqués dans les Sorties
du déploiement.
A. Cloud Run — le service Planka
- Console : Cloud Run → sélectionnez le service pour les révisions, le trafic, les logs et les métriques.
- CLI :
gcloud run services list --project "$PROJECT" --region "$REGION"
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION"
# Confirm the injected DB_HOST / DB_IP / BASE_URL on the running revision:
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION" \
  --format='value(spec.template.spec.containers[0].env)'
Voir App_CloudRun pour la mise à l'échelle, la concurrence et la répartition du trafic.
B. Cloud SQL pour PostgreSQL 15
Planka stocke tous les tableaux, listes, cartes et données utilisateur dans
une instance Cloud SQL pour PostgreSQL 15 gérée. Lors du premier
déploiement, un job d'initialisation crée la base de données et le rôle de
l'application ; Planka exécute ensuite ses propres migrations Knex et son
amorçage à chaque démarrage via le start.sh de l'image officielle.
- Console : SQL → sélectionnez l'instance pour les connexions, les sauvegardes, les flags, les métriques.
- CLI :
gcloud sql instances list --project "$PROJECT"
gcloud sql connect <instance-name> --user=<db-user> --database=<db-name> --project "$PROJECT"
C. Cloud Storage
Un bucket storage est provisionné automatiquement pour les pièces jointes,
les avatars et les arrière-plans, et est monté via GCS FUSE à /app/data, le
chemin de base des téléchargements de Planka (pièces jointes, avatars, images
d'arrière-plan et favicons y résident tous), avec uid=1000/gid=1000
afin que l'utilisateur non-root de l'application puisse écrire.
- CLI :
gcloud storage buckets list --project "$PROJECT" --filter="name~planka"
D. Secret Manager
Deux secrets d'application — SECRET_KEY et DEFAULT_ADMIN_PASSWORD — plus le mot de
passe de la base de données sont stockés ici.
- CLI :
gcloud secrets list --project "$PROJECT" --filter="name~planka"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
E. Réseau et ingress
Planka construit toutes les URL absolues (liens de pièces jointes,
notifications par e-mail et URI de redirection OIDC facultatif si le SSO est
configuré) à partir de BASE_URL, que le point d'entrée cloud dérive de
l'URL du service.
- CLI :
gcloud run services describe <service-name> --region "$REGION" --format='value(status.url)'
F. Cloud Logging et Monitoring
- CLI :
gcloud run services logs read <service-name> --project "$PROJECT" --region "$REGION" --limit 50
3. Comportement de l'application Planka
- Configuration de la base de données au premier déploiement. Un job
d'initialisation exécute
db-init.shen utilisantpostgres:15-alpine, créant de manière idempotente le rôle et la base de données de l'application (pas besoin deCREATEROLE/CREATEDB— les propres rôles de Planka sont des lignes RBAC au niveau de l'application, pas des rôles Postgres). - Migrations de schéma et amorçage à chaque démarrage. Le propre
start.shde l'image officielle exécutenode db/init.js(migrations + amorçage) avant de démarrer le serveur — idempotent, donc aucun job de migration séparé ne s'exécute au niveau de la plateforme. - Identifiant d'amorçage administrateur réel — pas de réinitialisation
forcée. Planka initialise
admin@example.comavec leDEFAULT_ADMIN_PASSWORDgénéré lors du premier démarrage (base de données vide). Contrairement aux applications qui forcent une réinitialisation de mot de passe lors de la première connexion, Planka ne le fait pas — connectez-vous et changez le mot de passe via l'interface utilisateur de Planka rapidement après le déploiement. DATABASE_URLcomposé par le point d'entrée cloud. Étant donné que le mot de passe de la base de données n'est disponible qu'en tant que valeur Secret Manager au moment de l'exécution, le point d'entrée cloud construitDATABASE_URLau démarrage du conteneur plutôt qu'au moment de la planification, en se basant sur leDB_HOSTrésolu (répertoire de socket → IP privée ; loopback → TCP simple ; IP privée → chiffré, pas de vérification de certificat). Voir Planka_Common pour tous les détails.- Chemin de santé. Les sondes de démarrage et de vivacité sont
configurées via les variables
startup_probe/liveness_probe. Le propreserver/healthcheck.jsde Planka cible le chemin racine/sans authentification, et les variablesstartup_probe/liveness_probede ce module sont maintenant correctement définies par défaut surpath = "/"pour correspondre. - Inspecter l'exécution du job :
gcloud run jobs executions list --job <job-name> --project "$PROJECT" --region "$REGION"
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres spécifiques ou notables pour Planka sont listés ; toutes les autres entrées sont héritées de App_CloudRun avec leur comportement standard.
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | planka | Nom de base des ressources. |
application_version | latest | Utilisé comme ARG de build PLANKA_VERSION pour l'image personnalisée légère. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
container_image_source | custom | Planka a besoin de l'enveloppe cloud-entrypoint — conservez custom. |
container_port | 1337 | Port natif par défaut de Planka — un seul port sert l'API et le frontend. |
cpu_always_allocated | false | Facturation basée sur les requêtes. |
min_instance_count / max_instance_count | 0 / 5 | Valeur par défaut scale-to-zero. |
memory_limit | 4Gi | Planka nécessite au moins 2 Gi pour un fonctionnement fiable. |
Groupe 11 — Stockage et système de fichiers
| Variable | Valeur par défaut | Description |
|---|---|---|
storage_buckets | un bucket storage | Créé et monté automatiquement à /app/data. |
gcs_volumes | [] | Non nécessaire pour les téléchargements — le module monte déjà son bucket à /app/data. |
enable_nfs | false | Non nécessaire — Planka n'a pas d'exigence de système de fichiers POSIX. |
Groupe 12 — Backend de base de données
| Variable | Valeur par défaut | Description |
|---|---|---|
database_type | POSTGRES_15 | Fixe — Knex ne prend en charge aucun autre moteur. |
db_name / db_user | planka / planka | Nom de la base de données PostgreSQL et nom d'utilisateur de l'application. |
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe / liveness_probe | HTTP /, délai de 60s | Fixé à la cible de santé réelle et non authentifiée de Planka (par server/healthcheck.js), qui effectue simplement un GET / sans chemin et vérifie un HTTP 200. |
startup_probe_config / health_check_config | HTTP /, délai de 60s | Valeurs par défaut au niveau de la fondation ; remplacées par startup_probe/liveness_probe ci-dessus chaque fois que application_config en fournit une (ce qui est toujours le cas ici) — effectivement inertes. |
Groupe 21 — Redis
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_redis | false | Planka n'a pas de dépendance de cache/file d'attente. |
5. Sorties
| Sortie | Description |
|---|---|
service_name / service_url | Nom du service Cloud Run et URL run.app par défaut. |
database_instance_name / database_name / database_user / database_host / database_port | Détails de connexion Cloud SQL. |
storage_buckets | Le bucket storage pour les pièces jointes. |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants de projet. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
db_name / db_user | Définir une fois | Critique | Immuable après le premier déploiement ; le renommage recrée la base de données/l'utilisateur et détruit toutes les données. |
container_image_source | custom (par défaut) | Élevé | "prebuilt" déploie directement l'image officielle, en ignorant le point d'entrée cloud — Planka démarre sans DATABASE_URL et ne peut pas atteindre la base de données. |
DEFAULT_ADMIN_PASSWORD (secret généré) | Connectez-vous et changez-le immédiatement après le premier déploiement | Critique | Contrairement aux applications avec une invite de réinitialisation de mot de passe forcée, Planka ne force pas de réinitialisation — toute personne qui obtient le mot de passe initial (par exemple via l'accès à Secret Manager) peut se connecter en tant qu'administrateur indéfiniment jusqu'à ce qu'il soit modifié. |
DATABASE_URL / Configuration SSL | Ne jamais modifier manuellement — contrôlé par le point d'entrée cloud via les variables d'environnement PGSSLMODE/KNEX_REJECT_UNAUTHORIZED_SSL_CERTIFICATE, PAS un paramètre de requête ?sslmode= | Critique | Planka a deux chemins de connexion DB indépendants avec des mécanismes SSL différents, confirmés en traçant la chaîne de dépendance réelle (pas seulement le .env.sample de Planka) : (1) le CLI de migration (server/db/knexfile.js) lit KNEX_REJECT_UNAUTHORIZED_SSL_CERTIFICATE ; (2) l'ORM Sails du serveur en cours d'exécution (sails-postgresql → machinepack-postgresql) parse DATABASE_URL avec le url.parse() hérité de Node, qui supprime silencieusement tous les paramètres de requête, y compris ?sslmode= — donc un sslmode intégré à l'URL ne fait rien pour le chemin d'exécution. Sans configuration ssl explicite, pg brut revient à la variable d'environnement PGSSLMODE, où require signifie "chiffrer ET vérifier" (pas "chiffrer uniquement" comme le libpq classique) — seul PGSSLMODE=no-verify ignore la vérification de certificat. Le certificat auto-signé de Cloud SQL n'est pas dans le bundle CA de Node, donc tout sauf no-verify échoue au démarrage avec UNABLE_TO_VERIFY_LEAF_SIGNATURE et le hook orm de Sails ne se charge jamais (confirmé en direct : deux tentatives précédentes utilisant ?sslmode=no-verify dans l'URL et PGSSLMODE=require ont toutes deux échoué de cette manière avant que la variable d'environnement PGSSLMODE=no-verify correcte ne soit identifiée). |
gcs_volumes à /app/data | Laisser vide | Moyen | Le module monte déjà son bucket storage à /app/data ; un deuxième montage au même chemin entre en conflit. Sans ce montage, les téléchargements résideraient sur le système de fichiers éphémère de Cloud Run et ne survivraient pas à un redémarrage de révision — les données textuelles des tableaux/cartes/listes ne sont pas affectées. |
Pour le comportement de la fondation référencé tout au long — identité de service, mise à l'échelle et concurrence, ingress et équilibrage de charge, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir d'images — voir App_CloudRun. La configuration d'application spécifique à Planka partagée avec la variante GKE est décrite dans Planka_Common.
Guides associés
- Lab pratique : Planka sur Cloud Run — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Planka sur GKE Autopilot — la même application sur Kubernetes, pour lorsque vous avez besoin de l'autre cible de déploiement.
- Planka Common — Configuration d'application partagée — la configuration partagée par les deux cibles de déploiement.
- Déployé avec Plane sur Google Cloud Run, Vikunja sur Google Cloud Run, Kimai sur Google Cloud Run dans la solution Gestion de projets et de tâches.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.