Module Penpot GKE — Guide de configuration
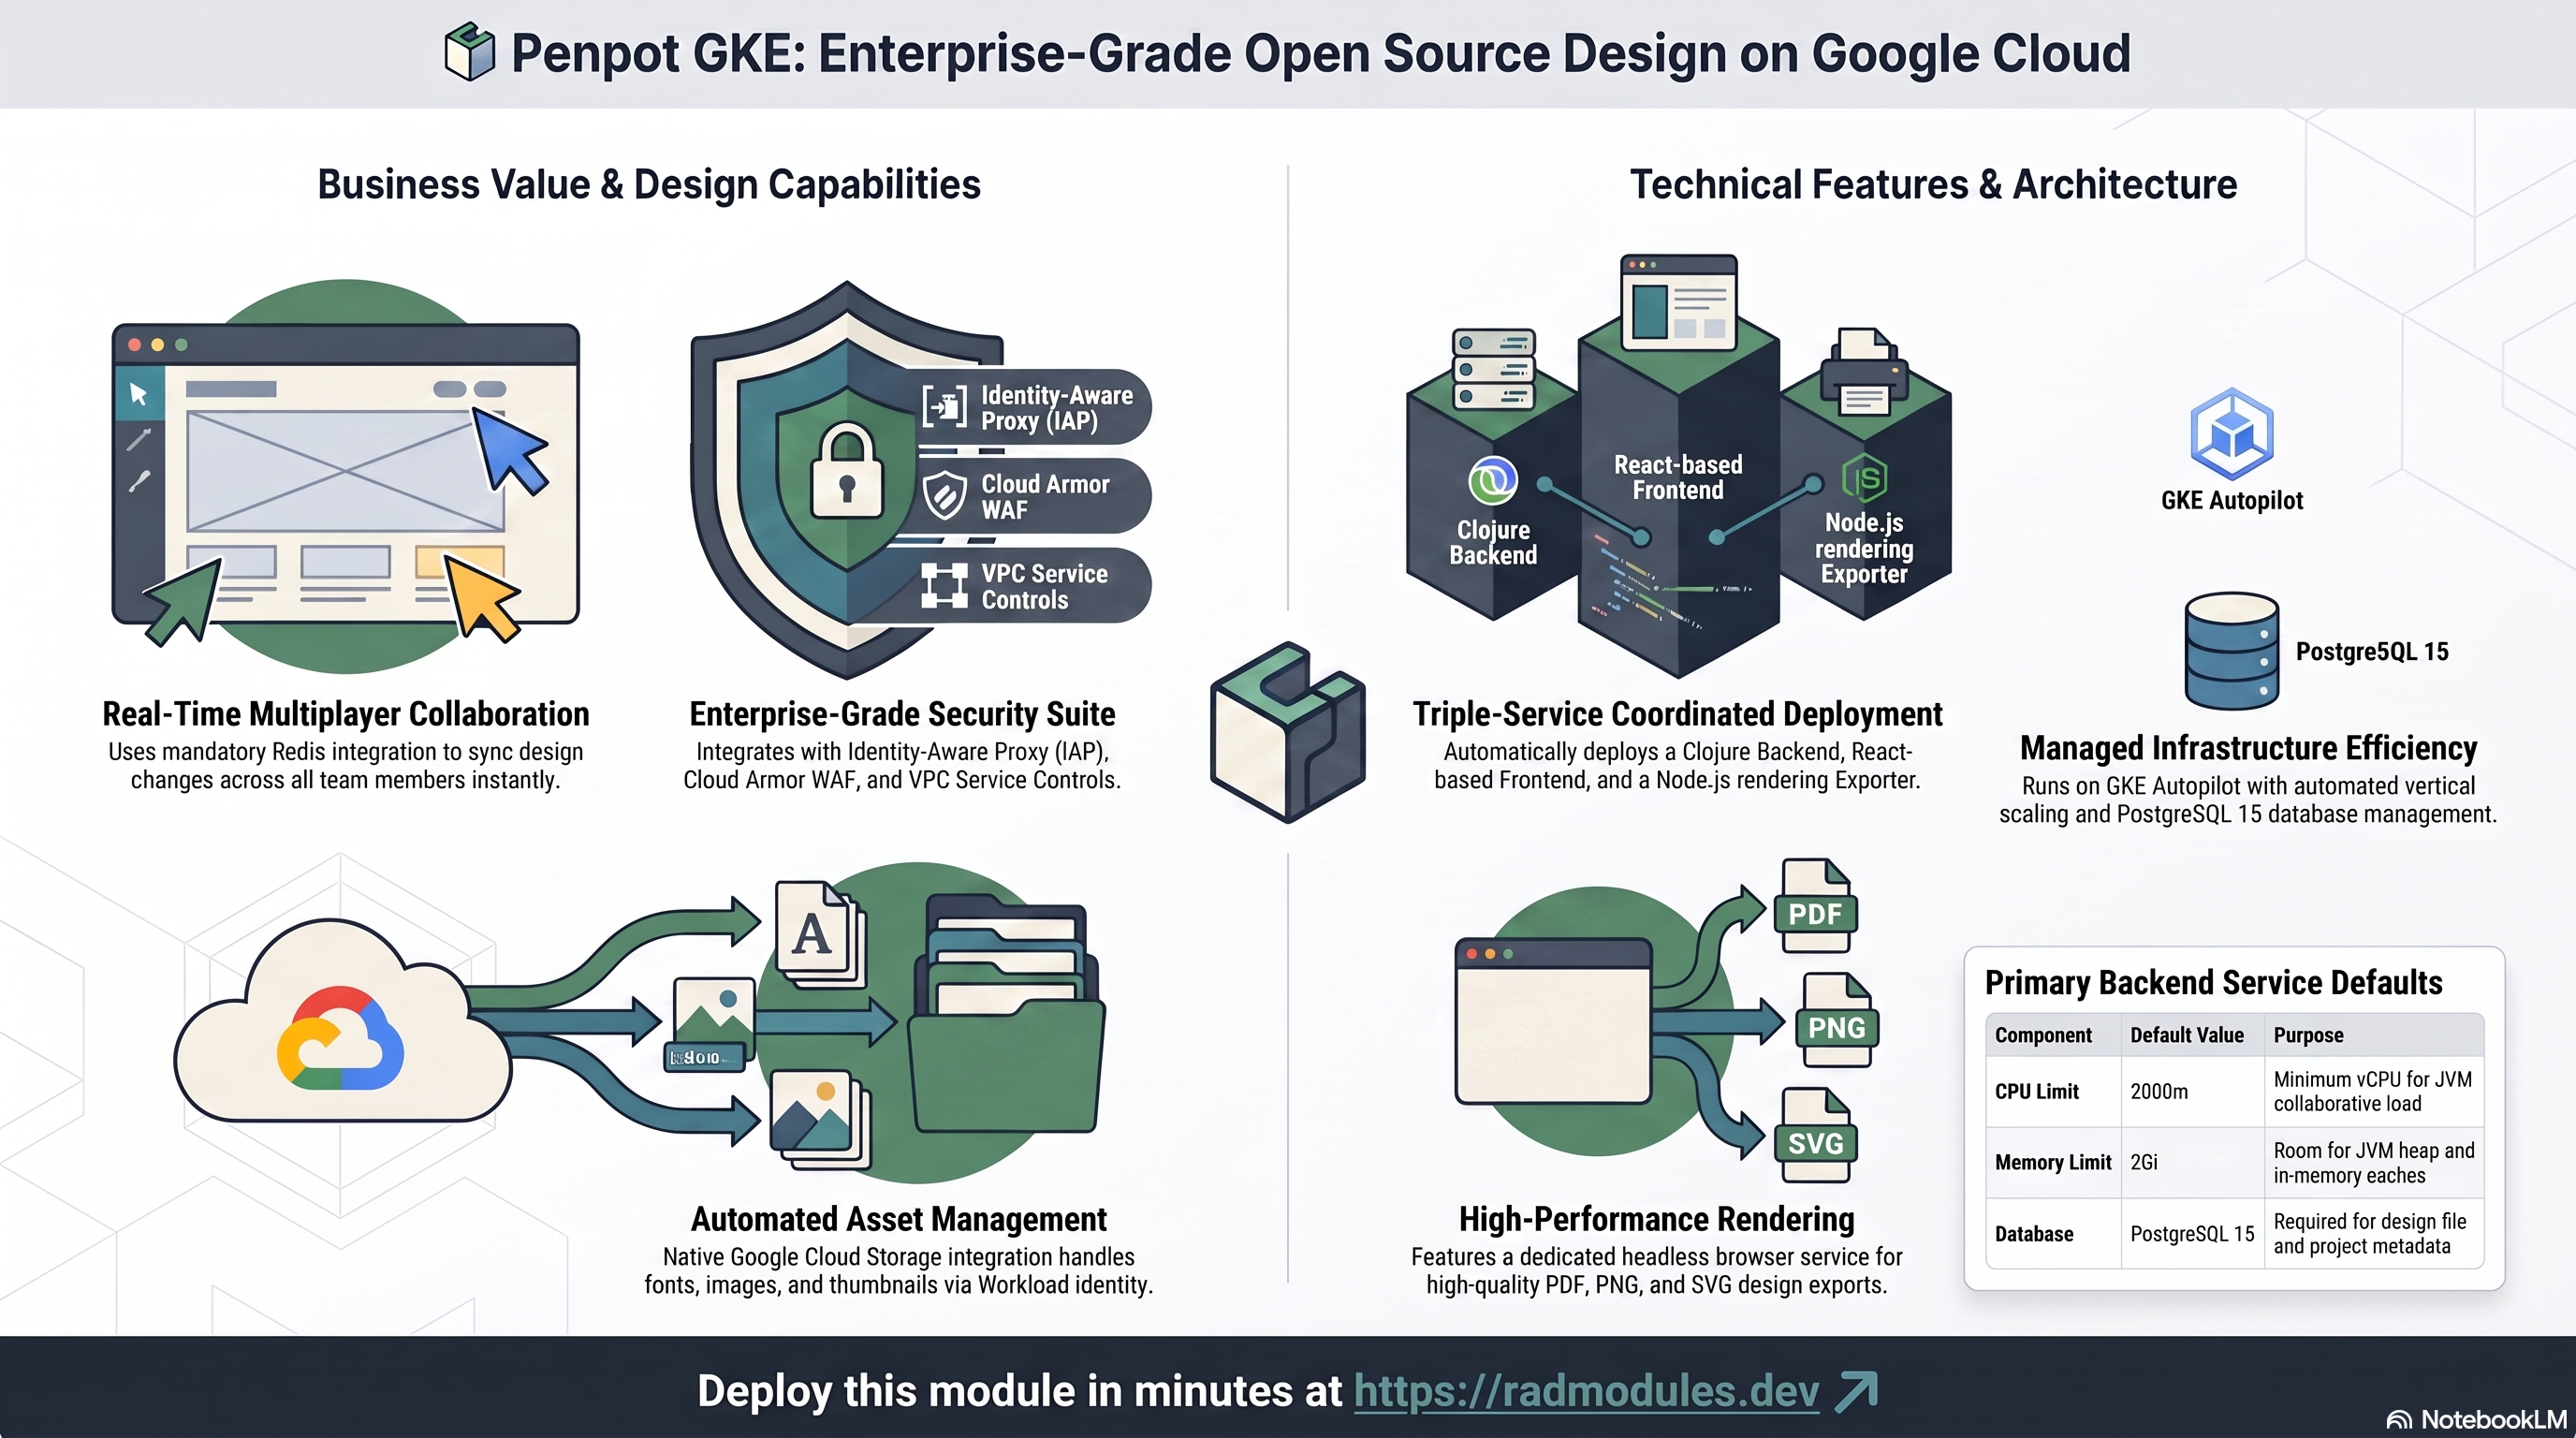
Ce guide décrit chaque variable de configuration disponible dans le module Penpot_GKE. Penpot_GKE est un module enveloppe qui combine le module d'infrastructure générique App_GKE avec la configuration d'application partagée Penpot_Common pour déployer Penpot — un outil de conception et de prototypage open source — sur Google Kubernetes Engine (GKE) Autopilot.
La plupart des options de configuration dans Penpot GKE correspondent directement aux mêmes options dans App GKE. Lorsqu'une variable a un comportement identique, ce guide fait référence au guide App GKE plutôt que de répéter la même documentation. Seules les variables et les valeurs par défaut spécifiques à Penpot sont décrites en détail ici.
Note : Les variables marquées comme gérées par la plateforme sont définies et maintenues par la plateforme. Vous n'avez normalement pas besoin de les modifier.
Ce que coûte Penpot sur RAD, et comment cela se compare
Pour une équipe de conception de dix personnes, Penpot sur le module GKE Autopilot de RAD coûte environ 143 $ US par mois sans licence par utilisateur. GKE convient à un Penpot qui doit rester opérationnel, s'adapter à travers les pods ou fonctionner aux côtés d'autres charges de travail Kubernetes. Pour le coût le plus bas, le module Cloud Run exécute le même Penpot pour environ 99 $ US par mois. Les chiffres sont valables au 8 octobre 2026 ; les sources sont listées à la fin de cette section.
Si vous n'en avez besoin qu'occasionnellement — pour préparer une certification, une démo, une activité saisonnière — un projet géré par RAD peut être supprimé et restauré dans les 30 jours sans frais supplémentaires, de sorte que ces 143 $ US deviennent quelques dollars par mois. Voir Mettez-le en pause gratuitement, ci-dessous.
Ce que vous payez sur RAD
| Dans un projet Google Cloud que vous possédez | Dans un projet géré par RAD pour vous | |
|---|---|---|
| Frais de module, une fois par déploiement | 175 crédits (17,50 $ US au prix de la recharge) | 157,5 crédits (10 % de moins) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients sont l'exception : ils sont toujours facturés à la minute pour le temps de build | Idem |
| Coût d'exécution Google Cloud | Facturé par Google à votre propre compte de facturation (tableau ci-dessous) | Mesuré à l'heure en crédits ; RAD publie 143 crédits par jour, environ 4 290 par mois (environ 429 $ US au prix de la recharge ; estimé à partir des prix catalogue de Google, et incluant les frais de cluster) |
| Qui possède quoi | Vous possédez le projet et sa facturation ; RAD le déploie et le met à jour | RAD possède le projet, avec des garde-fous, des quotas et des alertes budgétaires ; vous avez accès à la console, et un solde minimum acheté est conservé en réserve |
10 crédits coûtent 1 $ US pour une recharge ponctuelle, et moins avec un plan mensuel. Dans un projet géré par RAD, la base de données, le serveur de fichiers et le réseau sont partagés par toutes les applications du projet, de sorte qu'une deuxième application n'ajoute pas une deuxième base de données.
Coût d'exécution par défaut dans votre propre projet (us-central1, prix catalogue Google) :
| Ressource (valeur par défaut du module) | Par mois |
|---|---|
| Pod GKE Autopilot, 2x vCPU / 2 Gio | 72,16 $ US |
| Cloud SQL pour PostgreSQL, 1 vCPU / 3,75 Go, zonal, 10 Go SSD | 51,02 $ US |
| Serveur de fichiers NFS/cache (petite VM) | 13,43 $ US |
| Cloud NAT et réseau | 5 $ US |
| Cloud Storage (modules complémentaires, sauvegardes) | 1 $ US |
| Frais de gestion de cluster GKE | partagés entre toutes les applications GKE du projet ; 0 $ si c'est votre seul cluster, sinon ~73 $ |
| Total | environ 143 $ US, ou environ 216 $ US sans le niveau gratuit |
- Le niveau gratuit de GKE couvre les frais de gestion d'un cluster Autopilot ou zonal par compte de facturation, il ne s'applique donc que si c'est votre seul cluster de ce type. Cloud SQL coûte le même prix en africa-south1 (Johannesburg) ; le pod et la VM coûtent environ 10 % de plus là-bas.
- GKE Autopilot ne s'adapte pas à zéro. Au moins un pod Penpot est toujours en cours d'exécution, donc le coût ci-dessus est le même, que quelqu'un l'utilise ou non ; des pods supplémentaires ne sont ajoutés que sous charge.
- Évitez Filestore pour un petit déploiement. Le module utilise par défaut une petite VM NFS/cache. La plus petite instance de Filestore est de 1 Tio, ce qui coûte environ 164 $ US par mois à elle seule.
Comment cela se compare
- Penpot vend son propre plan hébergé Illimité : 7 $ US par éditeur par mois, plafonné à 175 $ US/mois quelle que soit la taille de l'équipe (penpot.app/pricing, 8 octobre 2026) — environ 70 $ US/mois pour dix éditeurs. Un plan Professionnel gratuit existe également, plafonné à 8 membres d'équipe pour la collaboration en temps réel.
- Le chiffre de RAD pour un projet propre est plus élevé en termes monétaires car il s'agit d'une infrastructure dédiée — une instance Cloud SQL dédiée et des services Cloud Run, plus le bus d'événements Redis obligatoire pour la collaboration en temps réel — plutôt qu'une part du cloud multi-tenant de Penpot.
- Un VPS nu — Hetzner CPX22 ou un Droplet DigitalOcean 2 vCPU/4 Go, tous deux à environ 24 $ US/mois — est moins cher que les deux chiffres de RAD, au prix de l'exécution de PostgreSQL, Redis, des sauvegardes et des correctifs par vous-même.
Mettez-le en pause gratuitement : supprimez un projet géré par RAD, restaurez-le quand vous en avez besoin
Si Penpot s'exécute dans un projet géré par RAD pour vous, vous avez une deuxième option qui va bien au-delà de la mise à l'échelle à zéro : supprimez l'ensemble du projet et restaurez-le dans les 30 jours pour presque rien. Cela convient bien mieux à une utilisation occasionnelle — étudier pour une certification, un environnement de démonstration, une activité saisonnière — que de faire fonctionner Penpot en continu.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, seront utilisables après sa restauration, de sorte que la restauration ne peut pas être considérée comme un moyen fiable de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
- Comment ça marche. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer le projet. Google ne supprime pas le projet immédiatement : il le conserve, récupérable, pendant 30 jours. Comme la facturation est déjà déliée, rien n'est facturé pendant cette attente. Contrairement à la suppression d'un module, cela ne démantèle pas Cloud SQL, aucune VM ou le cluster GKE un par un — l'ensemble du projet, et tout ce qu'il contient, s'arrête simplement.
- La restauration est une vérification, pas une reconstruction. Dans les 30 jours, le propriétaire du projet peut le restaurer. RAD demande à Google de récupérer le projet et de rattacher son compte de facturation, puis vous demande d'exécuter Mettre à jour sur chaque déploiement pour confirmer que tout est revenu. Comme rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes — c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit.
- Ainsi, un mois d'utilisation occasionnelle peut coûter quelques dollars, et non les 429 $ US par mois pour le maintenir en fonctionnement. Déployez Penpot, utilisez-le un certain temps, supprimez le projet. Restaurez-le la prochaine fois que vous en avez besoin, confirmez avec Mettre à jour, et supprimez-le à nouveau lorsque vous avez terminé. Vous ne payez les frais de module qu'une seule fois et le temps pendant lequel Penpot a été réellement actif.
- Ce que cela nécessite. Vous devez être propriétaire du projet (pas un projet que vous apportez et dont RAD ne gère que la facturation), et vous le restaurez vous-même dans les 30 jours — après cela, Google le supprime définitivement. La restauration est admise comme la création d'un nouveau projet : votre solde de crédits achetés doit toujours dépasser le seuil du palier (100 crédits pour le palier sandbox qui convient à la plupart des utilisations d'étude et de démonstration). Google indique que la plupart des services sont de nouveau pleinement fonctionnels dans les 36 heures suivant une restauration.
- Une lacune réelle : le bucket de sauvegarde ne survit pas. Les sauvegardes de Penpot sont écrites dans un bucket à l'intérieur du projet, et ce bucket n'est pas protégé par la suppression logicielle de Cloud Storage, il est donc très probable qu'il disparaisse dès que vous supprimez le projet — même si le projet lui-même est récupérable pendant 30 jours. Si vous avez apporté des modifications à Penpot que vous souhaitez conserver, copiez une sauvegarde (vers Google Drive, ou un bucket en dehors du projet) avant de supprimer, comme pour le flux de travail de redéploiement ci-dessous. Pour une installation par défaut sans rien d'irremplaçable, cela n'a pas d'importance.
Payez uniquement pendant que vous l'utilisez, l'autre méthode : supprimer et redéployer
GKE Autopilot ne s'adapte pas à zéro entre les requêtes. L'option ci-dessus ne s'applique qu'à un projet géré par RAD ; dans votre propre projet, ou une fois la fenêtre de 30 jours passée, la façon d'arrêter de payer est de supprimer le déploiement et de le redéployer lorsque vous en avez besoin.
- Ce que coûte un redéploiement. Les frais de module à nouveau (les builds sont inclus) : 175 crédits (17,50 $ US), car RAD recrée le projet et les services partagés avant Penpot. La suppression ne permet d'économiser de l'argent que si Penpot devait rester inutilisé pendant environ 4 jours ou plus, à la fois dans votre propre projet (environ 4,75 $ US par jour) et dans un projet géré par RAD (143 crédits par jour).
- La majeure partie du coût d'exécution est généralement la base de données et la VM de fichier/cache partagée. Elles ne s'arrêtent que si rien d'autre dans le projet ne les utilise, donc la suppression de Penpot alors que quelque chose d'autre partage le projet n'économise que la partie calcul de Penpot.
- Conservez d'abord les données. Les sauvegardes sont écrites dans un bucket à l'intérieur du déploiement et sont supprimées avec celui-ci, donc copiez la dernière sauvegarde avant de la supprimer si vous souhaitez la conserver.
- RAD ne recrée pas un déploiement supprimé pour vous ; vous saisissez à nouveau les paramètres lorsque vous déployez.
Sessions de lab et environnements gérés
- Sessions de lab, pour la formation. Un formateur anime une session pour une classe. Chaque participant obtient l'application dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite d'une allocation définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés sont reversés au formateur.
- Environnements gérés, pour les sociétés de conseil. Un partenaire exécute l'application pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille est faible, la facturation est suspendue et les données sont conservées, de sorte que personne ne reçoit de frais inattendus. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue Google Cloud de l'API Cloud Billing Catalog ; radmodules.dev/pricing pour les propres frais de RAD et les estimations de crédits quotidiens ; Supprimer et restaurer des projets pour la fenêtre de pause/restauration et ce qu'elle dit sur les objets Cloud Storage sans suppression logicielle ; Tarification Penpot.
Référence de configuration standard
Les zones de configuration suivantes sont fournies par le module sous-jacent App_GKE. Consultez les sections liées du Guide de configuration App_GKE pour une documentation complète.
| Zone de configuration | Section App GKE.md | Notes spécifiques à Penpot |
|---|---|---|
| Projet et identité | §2 IAM et contrôle d'accès | Identique. |
| Identité de l'application | §3.A Calcul (GKE Autopilot) | Valeurs par défaut spécifiques à Penpot ; voir Groupe 2 : Identité de l'application. |
| Exécution et mise à l'échelle | §3.A Calcul (GKE Autopilot) | Valeurs par défaut spécifiques à Penpot pour container_port, cpu_limit, memory_limit et timeout_seconds ; voir Groupe 3 : Exécution et mise à l'échelle. |
| Configuration de l'application Penpot | (Spécifique à Penpot) | penpot_flags, jvm_max_heap, jvm_min_heap, public_uri ; voir Groupe 5 : Configuration de l'application Penpot. |
| Configuration SMTP | (Spécifique à Penpot) | Variables SMTP de premier ordre pour les e-mails d'invitation ; voir Groupe 8 : Configuration SMTP. |
| Variables d'environnement et secrets | §3 Configuration du service principal | Un secret auto-généré (PENPOT_SECRET_KEY) ; voir Groupe 7 : Variables d'environnement et secrets. |
| Réseau et stratégies réseau | §3.D Réseau et stratégies réseau | Identique. |
| Jobs d'initialisation et CronJobs | §3.E Jobs d'initialisation et CronJobs | Un job db-init par défaut (de Penpot Common) crée la base de données et l'utilisateur ; Penpot exécute ensuite ses propres migrations de schéma au démarrage ; voir Groupe 9 : Jobs et tâches planifiées. |
| Services supplémentaires | §3.F Services supplémentaires | Le frontend et l'exportateur sont provisionnés automatiquement comme services supplémentaires ; voir Comment Penpot GKE est lié à App GKE. |
| Stockage — NFS | §3.C Stockage (NFS / GCS / GCS Fuse) | enable_nfs utilise par défaut true ; requis lorsqu'aucun redis_host explicite n'est fourni ; voir Groupe 10 : Stockage et système de fichiers — NFS. |
| Stockage — GCS | §3.C Stockage (NFS / GCS / GCS Fuse) | Bucket GCS assets (gcs-<service-name>-assets) provisionné automatiquement ; accès via Workload Identity ADC ; voir Groupe 11 : Stockage et système de fichiers — GCS. |
| Configuration de la base de données | §3.B Base de données (Cloud SQL) | PostgreSQL 15 requis ; voir Groupe 12 : Configuration de la base de données. |
| Planification et rétention des sauvegardes | §3.B Base de données (Cloud SQL) | Identique. |
| Scripts SQL personnalisés | §3.E Jobs d'initialisation et CronJobs | Identique. |
| Observabilité et vérifications de santé | §3.A Calcul (GKE Autopilot) | Les vérifications de santé ciblent /api/health ; voir Groupe 14 : Observabilité et santé. |
| Cloud Armor WAF | §4.A Cloud Armor WAF | Identique. |
| Identity-Aware Proxy | §4.B Identity-Aware Proxy (IAP) | Identique. |
| Autorisation binaire | §4.C Autorisation binaire | Identique. |
| Contrôles des services VPC | §4.D Contrôles des services VPC | Identique. |
| Pilote CSI du magasin de secrets | §4.E Pilote CSI du magasin de secrets | Toujours activé — aucune configuration requise. |
| Trafic et Ingress | §5 Trafic et Ingress | Identique. |
| CDN | §5.B CDN | Identique. |
| Domaine personnalisé et IP statique | §5.C Réservation d'IP statique | public_uri doit être mis à jour pour correspondre au domaine personnalisé ; voir Groupe 15 : Domaine personnalisé et IP statique. |
| Déclencheurs Cloud Build | §6.A Déclencheurs Cloud Build | Identique. |
| Pipeline Cloud Deploy | §6.B Pipeline Cloud Deploy | Identique. |
| Mise en miroir d'images | §6.C Mise en miroir d'images | enable_image_mirroring utilise par défaut true ; les images Penpot sont hébergées sur Docker Hub. |
| Budgets d'interruption de pod | §7.A Budgets d'interruption de pod | enable_pod_disruption_budget utilise par défaut false ; voir Groupe 15 : Stratégies de fiabilité. |
| Contraintes de répartition de topologie | §7.B Contraintes de répartition de topologie | Identique. |
| Quotas de ressources | §7.C Quotas de ressources | Identique. |
| Rotation automatique des mots de passe | §7.D Rotation automatique des mots de passe | Voir Groupe 12 : Configuration de la base de données. |
| Cache Redis | §8.A Redis / Memorystore | enable_redis utilise par défaut true — Redis est obligatoire pour la publication/souscription WebSocket ; voir Groupe 16 : Redis (Publication/Souscription WebSocket). |
| Importation de sauvegarde | §8.B Importation de sauvegarde | Voir Groupe 6 : Sauvegarde et maintenance. |
| Service Mesh (ASM) | §8.C Service Mesh (ASM via Fleet) | Identique. |
| Services multi-clusters | §8.D Services multi-clusters (MCS) | enable_multi_cluster_service existe sur App_GKE mais n'est pas mis en miroir sur Penpot_GKE — MCS n'est pas configurable pour ce module. |
Comment Penpot GKE est lié à App GKE
Penpot GKE transmet toutes les variables à App GKE et ajoute un sous-module Penpot Common qui fournit des valeurs par défaut et une configuration d'application spécifiques à Penpot. Les principaux effets sont les suivants :
- PostgreSQL 15 est requis. Le backend Clojure de Penpot ne prend en charge que PostgreSQL.
Penpot Commoncode en durdatabase_type = "POSTGRES_15"dans leconfigqu'il assemble — ce n'est pas piloté par une variable.Penpot GKEdéclare sa propre variabledatabase_type(valeur par défaut"POSTGRES", reflétant la convention deApp_GKE), mais elle n'est jamais transmise àPenpot Commonou à la configuration appliquée deApp_GKE, donc la définir n'a aucun effet. - Trois services coordonnés sont déployés. Penpot GKE déploie trois services Kubernetes distincts fonctionnant de concert :
- Backend (charge de travail principale, port 6060) : l'API HTTP Clojure, le serveur WebSocket et le planificateur de jobs. Géré par App GKE comme déploiement principal.
- Frontend (service supplémentaire, port de service
80→ port de conteneur8080, le nginx frontend de Penpot n'écoute pas sur le port 80) : un conteneur nginx servant le SPA ClojureScript/React. Il proxyfie les requêtes/apiet/wsvers le backend via son adresse de service interne au cluster. - Exportateur (service supplémentaire, port 6061) : un navigateur sans tête Node.js + Puppeteer/Chromium qui rend les pages de conception pour l'exportation vers PDF, PNG et SVG. Chromium navigue vers le service frontend pour rendre les pages avant la capture.
- L'URI de l'exportateur est injecté automatiquement.
PENPOT_EXPORTER_URIest défini sur l'URL interne au cluster du service exportateur (http://<service-name>-exporter.<namespace>.svc.cluster.local:6061) au moment du déploiement. Vous n'avez pas besoin de configurer cela manuellement. - Redis est obligatoire. Toutes les répliques du backend Penpot partagent l'état des événements WebSocket via la publication/souscription Redis (base de données 0). Sans Redis, la collaboration de conception multijoueur en temps réel se brise immédiatement lorsque plus d'une réplique du backend est en cours d'exécution — les utilisateurs sur différentes répliques ne peuvent pas voir les modifications des autres.
- Un bucket GCS
assetsest provisionné automatiquement.Penpot Commonfournit un bucket (name_suffix = "assets", nom completgcs-<service-name>-assets) pour les ressources de conception (polices, images, vignettes, téléchargements de fichiers). Le backend lit et écrit dans ce bucket en utilisant Workload Identity ADC — aucune accréditation explicite n'est requise. public_uriest automatiquement défini sur l'URL de service prédite. L'URL prédite est transmise àPenpot Commoncommepublic_uri. Pour les déploiements de domaines personnalisés, vous devez remplacerpublic_uriviaenvironment_variablespour qu'il corresponde à l'URL à laquelle les utilisateurs accèdent, afin que le SPA frontend, les liens backend et la navigation de l'exportateur utilisent tous la bonne URL de base.- Un secret au niveau de l'application est auto-généré.
Penpot CommoncréePENPOT_SECRET_KEY— une valeur aléatoire de 64 caractères stockée dans Secret Manager sous le nomsecret-<prefix>-penpot-key— la clé de signature JWT partagée utilisée à la fois par le backend et l'exportateur. Elle est injectée comme variable d'environnement secrète viamodule_secret_env_vars = module.penpot_app.secret_ids, et l'exportateur la référence en outre directement (secret_env_vars = { PENPOT_SECRET_KEY = "PENPOT_SECRET_KEY" }) car son schéma de configuration nécessite:secret-keyou le conteneur se ferme au démarrage. Le secretDB_PASSWORDest provisionné automatiquement parApp GKE. - Dimensionnement du tas JVM. Le backend Clojure s'exécute sur la JVM.
jvm_max_heapetjvm_min_heapcontrôlent l'allocation du tas JVM et doivent être dimensionnés par rapport àmemory_limit. timeout_secondsest par défaut à 3600 secondes. Les opérations d'exportation importantes (PDF/PNG de conceptions complexes) peuvent prendre plusieurs minutes. Le délai d'attente maximal de 3600 secondes permet de gérer même de très gros jobs d'exportation.
Groupe 1 : Projet et identité
Identique à App_GKE. Voir App_GKE.
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (requis) | ID de projet GCP. |
region | "us-central1" | Région GCP pour le déploiement des ressources. Utilisée comme solution de repli lorsque la découverte réseau ne peut pas déterminer la région à partir des sous-réseaux VPC existants. Également utilisée comme emplacement pour le bucket GCS assets. |
Groupe 2 : Identité de l'application
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE pour les descriptions.
Valeurs par défaut spécifiques à Penpot :
| Variable | Valeur par défaut Penpot GKE | Valeur par défaut App GKE | Notes |
|---|---|---|---|
application_name | "penpot" | "gkeapp" | Utilisé comme nom de base pour toutes les ressources GCP et Kubernetes. Le service frontend est nommé <application_name>-frontend et l'exportateur <application_name>-exporter. Ne pas modifier après le déploiement. |
display_name | "Penpot - Open Source Design Tool" | "App GKE Application" | Affiché dans l'interface utilisateur et les tableaux de bord de la plateforme. Peut être modifié librement. |
description | "Penpot - Open-source design and prototyping tool for teams" | "App GKE Custom Application…" | Libellé descriptif. Peut être modifié librement. |
application_version | "latest" | "1.0.0" | Tag de version appliqué à toutes les trois images de conteneur Penpot (backend, frontend, exportateur). Les trois images doivent utiliser le même tag de version pour assurer la compatibilité API — ne pas mélanger les versions entre les services. Épinglez à une version spécifique (par exemple, "2.3.0") pour la production. |
Groupe 3 : Exécution et mise à l'échelle
La plupart des variables se comportent de manière identique à App_GKE. Voir App_GKE Groupe 4.
Valeurs par défaut et comportement spécifiques à Penpot :
Note : Les variables de mise à l'échelle (
min_instance_count,max_instance_count) et les variables de ressources (cpu_limit,memory_limit) s'appliquent au service backend. Les services frontend et exportateur ont leurs propres limites de ressources définies en interne :
- Frontend :
1000mCPU,512Mimémoire, s'adapte avecmin_instance_count/max_instance_count- Exportateur :
2000mCPU,2Gimémoire, minimum 1 réplica, s'adapte àmax_instance_count
| Variable | Valeur par défaut Penpot GKE | Valeur par défaut App GKE | Notes |
|---|---|---|---|
container_port | 6060 | 8080 | Port HTTP + WebSocket du backend Clojure de Penpot. Ne pas modifier — la configuration du proxy nginx frontend est codée en dur pour se connecter au backend sur ce port via l'adresse de service interne au cluster. |
cpu_limit | "2000m" | "1000m" | 2 vCPU est le minimum pour le backend JVM sous charge collaborative. La JVM elle-même nécessite environ 500m au repos ; les connexions WebSocket concurrentes et les opérations de fichiers de conception nécessitent une marge supplémentaire. |
memory_limit | "2Gi" | "512Mi" | La JVM nécessite plus de mémoire que les applications Node.js ou Python typiques. Avec jvm_max_heap = "1g", le conteneur a besoin d'au moins 1,5 Gio pour l'overhead JVM, l'OS et les caches de fichiers en mémoire de Penpot. 2 Gio est le minimum recommandé ; augmentez à 4 Gio pour les grandes équipes ou les fichiers de conception complexes. |
min_instance_count | 1 | 1 | Toujours au moins un pod en cours d'exécution. La mise à l'échelle à zéro provoque des déconnexions WebSocket pour les collaborateurs actifs et un délai de démarrage à froid JVM de 60 à 120 secondes. |
max_instance_count | 3 | 3 | Nombre maximal de réplicas du backend. Tous les réplicas partagent l'état de conception via Redis — la mise à l'échelle horizontale est sûre. |
timeout_seconds | 3600 | 300 | Délai d'expiration maximal pour les opérations d'exportation importantes (PDF/PNG de conceptions complexes multi-pages). La valeur maximale autorisée est de 3600 secondes. |
enable_cloudsql_volume | true | true | Le sidecar Cloud SQL Auth Proxy est requis. Le backend Penpot se connecte à PostgreSQL via le socket Unix du Auth Proxy. |
enable_image_mirroring | true | true | Les images Penpot sont hébergées sur Docker Hub. La mise en miroir vers Artifact Registry évite les limites de débit et satisfait aux exigences d'autorisation binaire. Appliqué à l'image du backend ; les images du frontend et de l'exportateur sont également mises en miroir automatiquement. |
Les variables d'exécution restantes (deploy_application, container_image, container_build_config, enable_vertical_pod_autoscaling, container_protocol, container_resources, cloudsql_volume_mount_path, service_annotations, service_labels) se comportent comme décrit dans App_GKE Groupe 4.
Groupe 4 : Accès et réseau
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE, App_GKE et App_GKE.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_iap | false | Active l'authentification Identity-Aware Proxy sur l'équilibreur de charge. |
iap_authorized_users | [] | Utilisateurs individuels ou comptes de service ayant accès à IAP. |
iap_authorized_groups | [] | Groupes Google ayant accès à IAP. |
iap_oauth_client_id | "" | ID client OAuth pour la configuration IAP. |
iap_oauth_client_secret | "" | Secret client OAuth pour la configuration IAP. |
enable_custom_domain | true | Configure Ingress/Gateway pour le routage de domaine personnalisé avec des certificats SSL gérés. Activé par défaut — une Gateway avec une IP statique est provisionnée automatiquement. Lors de l'utilisation d'un domaine personnalisé, mettez à jour PENPOT_PUBLIC_URI dans environment_variables pour qu'il corresponde au domaine. |
application_domains | [] | Noms de domaine personnalisés (par exemple ["penpot.example.com"]). |
reserve_static_ip | true | Réserve une IP statique globale pour l'équilibreur de charge. Recommandé lors de l'utilisation d'un domaine personnalisé. |
static_ip_name | "" | Nom de l'IP réservée ; auto-généré si vide. |
network_tags | ["nfsserver"] | Tags de pare-feu appliqués aux nœuds du cluster GKE. Le tag nfsserver est requis pour la connectivité NFS. |
enable_cloud_armor | false | Active une stratégie de sécurité Cloud Armor WAF. |
admin_ip_ranges | [] | Plages CIDR d'administration autorisées via Cloud Armor. |
cloud_armor_policy_name | "default-waf-policy" | Nom de la stratégie de sécurité Cloud Armor à attacher. |
enable_vpc_sc | false | Active l'application du périmètre des contrôles de service VPC. |
enable_cdn | false | Active Cloud CDN sur l'équilibreur de charge. |
Groupe 5 : Configuration de l'application Penpot
Ces variables sont spécifiques à Penpot et sont transmises directement à Penpot Common. Elles contrôlent le comportement d'exécution du backend Clojure et l'allocation des ressources JVM.
| Variable | Valeur par défaut | Options / Format | Description et implications |
|---|---|---|---|
penpot_flags | "enable-registration enable-login disable-demo-users" | Chaînes de drapeaux séparées par des espaces | Drapeaux de fonctionnalités Penpot séparés par des espaces qui contrôlent les fonctionnalités et les méthodes d'authentification actives. La même chaîne de drapeaux est transmise au backend et au conteneur nginx frontend afin que le rendu des fonctionnalités du SPA corresponde aux capacités du backend. Drapeaux clés : enable-registration (autoriser l'auto-inscription), disable-registration (exiger des invitations créées par l'administrateur), enable-login-with-password (connexion standard nom d'utilisateur/mot de passe), disable-demo-users (désactiver le compte de démonstration accessible sans inscription), enable-oidc (activer le fournisseur OIDC générique), enable-google-login, enable-github-login. Les drapeaux sont appliqués au démarrage — leur modification nécessite un redémarrage du pod. |
jvm_max_heap | "1g" | Chaîne de taille de tas JVM (par exemple "1g", "2g", "512m") | Taille maximale du tas JVM pour le backend Penpot. Doit être définie à environ la moitié de memory_limit pour laisser de la marge pour l'overhead JVM, les tampons hors tas Netty/HttpKit et l'OS. Pour un conteneur de 2 Gio, "1g" est approprié. Pour un conteneur de 4 Gio, utilisez "2g". Définir jvm_max_heap près de memory_limit risque des arrêts OOM dus à la croissance de la mémoire hors tas. |
jvm_min_heap | "512m" | Chaîne de taille de tas JVM | Taille initiale du tas JVM. Contrôle la quantité de tas que la JVM réserve au démarrage. Un jvm_min_heap plus élevé réduit la fréquence des pauses d'expansion du tas JVM mais augmente l'empreinte mémoire de base du pod. Pour les déploiements de production, définir jvm_min_heap égal à jvm_max_heap élimine toutes les pauses de redimensionnement du tas au prix d'une réservation de mémoire constante plus élevée. |
Validation des paramètres du groupe 5
Console Google Cloud :
- Charges de travail GKE : Accédez à Kubernetes Engine → Charges de travail, sélectionnez le déploiement du backend Penpot et vérifiez que les variables d'environnement incluent
PENPOT_FLAGS,JVM_MAX_HEAPetJVM_MIN_HEAP.
gcloud CLI / kubectl :
# Confirm Penpot feature flags are set in the backend pod
kubectl exec -n NAMESPACE POD_NAME -- env | grep PENPOT_FLAGS

# Check JVM heap settings
kubectl exec -n NAMESPACE POD_NAME -- env | grep JVM

# View backend startup logs to confirm JVM initialisation and flag parsing
kubectl logs -n NAMESPACE POD_NAME --since=5m | grep -i "flags\|heap\|migration\|started"
Groupe 6 : Sauvegarde et maintenance
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Penpot :
| Variable | Valeur par défaut | Notes |
|---|---|---|
backup_schedule | "0 2 * * *" | Quotidiennement à 02:00 UTC. Ajustez pour correspondre à votre objectif de point de récupération. |
backup_retention_days | 7 | Rétention de 7 jours. Augmentez pour les déploiements de production ; les fichiers de conception et l'historique du projet sont irremplaçables. |
Importation de sauvegarde — Penpot GKE prend en charge l'importation d'une sauvegarde de base de données existante lors du premier déploiement :
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_backup_import | false | Lorsque true, exécute un job d'importation unique pendant le déploiement pour restaurer la sauvegarde spécifiée par backup_uri. |
backup_source | "gcs" | Système source du fichier de sauvegarde. "gcs" importe à partir d'un URI Cloud Storage ; "gdrive" importe à partir d'un ID de fichier Google Drive. |
backup_uri | "" | URI GCS complet (par exemple "gs://my-bucket/backups/penpot.sql") ou ID de fichier Google Drive. |
backup_file | "backup.sql" | Nom de fichier d'une sauvegarde déjà placée dans le bucket de sauvegardes géré par le module. Utilisé uniquement lorsque enable_backup_import = true. |
backup_format | "sql" | Format du fichier de sauvegarde. Valeurs prises en charge : sql, tar, gz, tgz, tar.gz, zip, auto. |
Note : Une importation de sauvegarde ne restaure que la base de données PostgreSQL. Les fichiers d'actifs de conception stockés dans le bucket GCS
assets(gcs-<service-name>-assets) doivent être migrés séparément — copiez-les dans le bucket d'actifs une fois la restauration de la base de données terminée.
Groupe 7 : Variables d'environnement et secrets
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Un secret au niveau de l'application est auto-généré. Penpot Common crée PENPOT_SECRET_KEY (une valeur aléatoire de 64 caractères stockée dans Secret Manager sous le nom secret-<prefix>-penpot-key) — la clé de signature JWT partagée utilisée par le backend et l'exportateur. Elle est exposée via la sortie secret_ids et câblée comme module_secret_env_vars ; l'exportateur la référence en outre directement puisque son schéma de configuration requiert :secret-key. Penpot ne crée pas d'autres mots de passe administrateur ou d'autres secrets d'application. Le mot de passe de la base de données (DB_PASSWORD) est provisionné automatiquement par App GKE.
PENPOT_PUBLIC_URI est injecté automatiquement par le module en utilisant l'URL de service prédite. Pour le remplacer (par exemple, lors de l'utilisation d'un domaine personnalisé), définissez-le explicitement dans environment_variables :
environment_variables = {
  PENPOT_PUBLIC_URI = "https://penpot.example.com"
}
PENPOT_EXPORTER_URI est injecté automatiquement par le bloc local penpot.tf. Il est défini sur l'URL interne au cluster du service d'exportation. Ne le remplacez pas, sauf si vous déployez un exportateur personnalisé à une adresse différente.
Les variables standard (environment_variables, secret_environment_variables, secret_rotation_period, secret_propagation_delay, manage_storage_kms_iam) se comportent comme décrit dans App_GKE.
Groupe 8 : Configuration SMTP
Penpot utilise SMTP pour les e-mails d'invitation (invitant les membres de l'équipe à une organisation Penpot) et les notifications de réinitialisation de mot de passe. SMTP est facultatif — sans lui, Penpot fonctionne toujours pleinement pour les utilisateurs invités et la connexion, mais les e-mails d'invitation et les e-mails de réinitialisation de mot de passe ne peuvent pas être envoyés.
| Variable | Valeur par défaut | Description |
|---|---|---|
smtp_enabled | false | Active l'envoi d'e-mails SMTP. Lorsque false, tous les e-mails d'invitation et de notification sont silencieusement ignorés. |
smtp_from | "" | Adresse e-mail de l'expéditeur affichée dans les e-mails sortants (par exemple, "noreply@example.com"). |
smtp_reply_to | "" | Adresse e-mail de réponse pour les e-mails sortants. Laissez vide pour utiliser smtp_from. |
smtp_host | "" | Nom d'hôte du serveur SMTP (par exemple, "smtp.mailgun.org", "smtp.sendgrid.net"). Requis lorsque smtp_enabled = true. |
smtp_port | 587 | Port du serveur SMTP. 587 est le port STARTTLS standard. Utilisez 465 pour SSL/TLS, 25 pour non chiffré (non recommandé). |
smtp_username | "" | Nom d'utilisateur d'authentification SMTP. |
smtp_use_tls | true | Active la négociation STARTTLS. Recommandé pour le port 587. |
smtp_use_ssl | false | Active SSL/TLS direct. À utiliser pour le port 465. Mutuellement exclusif avec smtp_use_tls. |
Mot de passe SMTP : Le mot de passe SMTP n'est pas une variable de premier niveau. Ajoutez-le via
secret_environment_variablespour le garder hors de l'état Terraform :secret_environment_variables = {
PENPOT_SMTP_PASSWORD = "your-smtp-password-secret-name"
}
Validation des paramètres SMTP
gcloud CLI / kubectl :
# Confirm SMTP environment variables are set in the backend pod
kubectl exec -n NAMESPACE POD_NAME -- env | grep -i smtp

# Check backend logs for SMTP configuration confirmation
kubectl logs -n NAMESPACE POD_NAME | grep -i "smtp\|email\|mail"
Groupe 9 : Jobs et tâches planifiées
Ces variables se comportent comme décrit dans App_GKE.
Job db-init par défaut : Lorsque initialization_jobs est vide (la valeur par défaut), Penpot Common fournit un Job Kubernetes db-init (image postgres:15-alpine, script scripts/db-init.sh, execute_on_apply = true) qui crée la base de données PostgreSQL et l'utilisateur de l'application. L'application Clojure de Penpot gère ensuite la création et la migration du schéma en interne au démarrage du backend, avant d'accepter les connexions HTTP ou WebSocket. Fournir une liste initialization_jobs non vide remplace le job par défaut.
CronJobs :
La variable cron_jobs est disponible pour les tâches planifiées personnalisées telles que les jobs d'exportation par lots ou le traitement analytique. Voir App_GKE pour la documentation complète du schéma.
Note : Les CronJobs GKE utilisent les champs
restart_policy,concurrency_policy,failed_jobs_history_limit,successful_jobs_history_limit,starting_deadline_secondsetsuspend. Les champs de style Cloud Run (parallelism,paused,max_retries,task_count) ne sont pas disponibles.
Services supplémentaires : Le frontend et l'exportateur sont provisionnés automatiquement — vous n'avez pas besoin de les ajouter via additional_services. La variable additional_services est disponible pour tout service supplémentaire au-delà des trois standards (par exemple, un processeur de webhook personnalisé ou un service sidecar d'exportation de métriques).
Groupe 10 : Stockage et système de fichiers — NFS
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Penpot :
| Variable | Valeur par défaut | Notes |
|---|---|---|
enable_nfs | true | Le stockage NFS est activé par défaut. Lorsque enable_redis = true et qu'aucun redis_host externe n'est fourni, le module utilise l'adresse IP du serveur NFS comme hôte Redis. Si vous désactivez NFS, vous devez fournir un redis_host explicite — sans Redis, la collaboration en temps réel n'est pas disponible. |
nfs_mount_path | "/mnt/nfs" | Le chemin où le volume NFS est monté à l'intérieur du conteneur. Penpot n'utilise pas NFS pour le stockage d'applications directement — NFS dans ce module co-héberge principalement le processus Redis utilisé pour le pub/sub WebSocket. |
Groupe 11 : Stockage et système de fichiers — GCS
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE Groupe 14.
Bucket auto-provisionné spécifique à Penpot :
Penpot Common provisionne automatiquement un bucket GCS (name_suffix = "assets", nom complet gcs-<service-name>-assets) pour le stockage des ressources de conception. Contrairement à Paperless-ngx (qui utilise GCS FUSE pour le stockage de documents), le backend Clojure de Penpot accède à ce bucket nativement via Workload Identity ADC — aucun montage de volume GCS FUSE n'est requis. Le backend utilise le SDK Java GCS pour lire et écrire directement les ressources de conception.
| Bucket | name_suffix | Méthode d'accès | Objectif |
|---|---|---|---|
| Auto-provisionné | assets | Workload Identity ADC (SDK GCS) | Ressources de conception : polices, images, miniatures, téléchargements de fichiers |
Les variables d'environnement suivantes sont injectées automatiquement par Penpot Common :
PENPOT_STORAGE_BACKEND=gcs— indique à Penpot d'utiliser GCS comme backend de stockage d'actifsPENPOT_STORAGE_GCS_BUCKET_NAME— défini sur le nom du bucket provisionné
Vous n'avez pas besoin de configurer manuellement les identifiants GCS. Le compte de service Kubernetes du backend est lié à un compte de service GCP avec des autorisations d'administrateur d'objets de stockage sur le bucket d'actifs via Workload Identity.
Les variables create_cloud_storage, storage_buckets, gcs_volumes, manage_storage_kms_iam, enable_artifact_registry_cmek, max_images_to_retain, delete_untagged_images et image_retention_days se comportent comme décrit dans App_GKE Groupe 14.
Groupe 12 : Configuration de la base de données
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut et restrictions spécifiques à Penpot :
| Variable | Valeur par défaut Penpot GKE | Valeur par défaut App GKE | Notes |
|---|---|---|---|
db_name | "penpot" | "gkeappdb" | Nom de la base de données PostgreSQL créée pour Penpot. Immuable après le déploiement — la modification de cette valeur recrée la base de données et détruit tous les projets Penpot, les fichiers de conception et les données d'équipe. |
db_user | "penpot" | "gkeappuser" | Utilisateur PostgreSQL pour Penpot. Immuable après le déploiement. |
database_password_length | 32 | 32 | Longueur du mot de passe de la base de données auto-généré. Plage valide : 16 à 64 caractères. |
Important : Penpot nécessite PostgreSQL. La variable
database_typedéclarée surPenpot_GKEest présente uniquement pour la convention de mise en miroir des variables de la Fondation (valeur par défaut"POSTGRES") — elle n'est jamais transmise àPenpot CommonouApp_GKE, donc la définir n'a aucun effet. Le moteur de base de données réellement provisionné est toujoursPOSTGRES_15, codé en dur dansPenpot Common.
Découverte d'instances Cloud SQL :
| Variable | Valeur par défaut | Description |
|---|---|---|
sql_instance_name | "" | Nom d'une instance Cloud SQL existante à utiliser. Laissez vide pour découvrir automatiquement une instance gérée par Services GCP ou créer une instance intégrée. |
sql_instance_base_name | "app-sql" | Nom de base pour l'instance Cloud SQL intégrée lorsqu'aucune instance existante n'est trouvée. L'ID de déploiement est ajouté. |
Rotation automatique des mots de passe :
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_auto_password_rotation | false | Déploie un job de rotation automatique des mots de passe de base de données. Lorsque true, le mot de passe de la base de données est tourné selon le calendrier défini par secret_rotation_period et les pods GKE sont redémarrés pour prendre en compte le nouveau credential. |
rotation_propagation_delay_sec | 90 | Secondes à attendre après la rotation avant de redémarrer les pods. |
Groupe 13 : Scripts SQL personnalisés
Identique à App_GKE. Voir App_GKE.
Variables disponibles : enable_custom_sql_scripts, custom_sql_scripts_bucket, custom_sql_scripts_path, custom_sql_scripts_use_root.
Groupe 14 : Observabilité et santé
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Penpot :
Le backend Clojure de Penpot exécute l'initialisation JVM et les migrations PostgreSQL au démarrage. Le premier démarrage après un déploiement frais peut prendre 60 à 120 secondes avant que le backend n'accepte les connexions HTTP.
Routage de la sonde de santé
Penpot GKE expose deux ensembles parallèles de variables de sonde qui configurent les sondes Kubernetes via différents chemins de routage :
| Ensemble de variables | Transmis à | Configure |
|---|---|---|
startup_probe, liveness_probe | Sous-module Penpot Common | La spécification de sonde Kubernetes du conteneur d'application (initialDelaySeconds, path, failureThreshold, etc.) |
startup_probe_config, health_check_config | App GKE directement | La configuration de sonde standard App GKE utilisée pour les vérifications de santé de l'équilibreur de charge et les sondes d'infrastructure GKE |
Ce sont des chemins parallèles, pas des alias. Changer startup_probe n'affecte pas startup_probe_config, et vice versa.
Sonde de démarrage (startup_probe → Penpot Common) :
| Champ | Valeur par défaut Penpot | Notes |
|---|---|---|
type | "TCP" | Sonde TCP sur le port backend (6060). Délibérément pas HTTP /api/health — le backend Penpot n'a pas de point de terminaison /api/health (ce chemin renvoie 404 ; le vrai est /readyz), donc une sonde HTTP redémarrerait en boucle un backend sain. |
path | "/api/health" | Présent dans l'objet mais ignoré pour une sonde TCP. |
initial_delay_seconds | 30 | Permet 30 secondes avant la première tentative de sonde. La JVM démarre rapidement ; le délai initial tient compte du temps de migration du schéma. |
timeout_seconds | 10 | Délai d'expiration de la sonde par tentative. |
period_seconds | 10 | Intervalle de la sonde. |
failure_threshold | 30 | Jusqu'à 300 secondes (30 × 10s) de temps de démarrage autorisé avant le redémarrage du pod. |
Sonde de vivacité (liveness_probe → Penpot Common) :
| Champ | Valeur par défaut Penpot | Notes |
|---|---|---|
type | "TCP" | Sonde TCP sur le port 6060. Délibérément pas HTTP /api/health (ce chemin renvoie 404 sur le backend Penpot, ce qui redémarrerait en boucle un pod sain). |
path | "/api/health" | Présent dans l'objet mais ignoré pour une sonde TCP. |
initial_delay_seconds | 60 | Donne au backend un temps supplémentaire pour se stabiliser avant le début des vérifications de vivacité. |
period_seconds | 30 | Moins fréquent que la sonde de démarrage — approprié pour un service stable en cours d'exécution. |
failure_threshold | 3 | Trois échecs consécutifs déclenchent un redémarrage du pod. |
Sondes standard App GKE (startup_probe_config, health_check_config → App GKE) :
| Variable | Valeur par défaut Penpot | Notes |
|---|---|---|
startup_probe_config | { enabled = true, type = "TCP", timeout_seconds = 240, period_seconds = 240, failure_threshold = 1 } | Sonde TCP sur container_port (6060). Permet jusqu'à 240 secondes pour le démarrage. |
health_check_config | { enabled = true, type = "HTTP", path = "/api/health" } | Requête HTTP GET vers /api/health. Point de terminaison de santé dédié de Penpot. |
uptime_check_config : Par défaut { enabled = false, path = "/api/health" } — les vérifications de disponibilité sont désactivées par défaut. Activez-les explicitement pour la surveillance de production. Si le backend Penpot n'est pas accessible publiquement (par exemple, derrière IAP), les vérifications de disponibilité doivent utiliser un point de terminaison accessible par Google ou être configurées via la surveillance interne au VPC.
Validation des sondes de santé
gcloud CLI / kubectl :
# Check startup probe status from pod events
kubectl describe pod -n NAMESPACE POD_NAME | grep -A5 "Startup Probe"

# Manually test the health endpoint from inside the pod
kubectl exec -n NAMESPACE POD_NAME -- \
  wget -qO- http://localhost:6060/api/health

# Check the frontend service health
kubectl exec -n NAMESPACE FRONTEND_POD_NAME -- \
  wget -qO- http://localhost:80/
Groupe 15 : Politiques de fiabilité
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Penpot :
| Variable | Valeur par défaut Penpot GKE | Notes |
|---|---|---|
enable_pod_disruption_budget | false | Le PDB est désactivé par défaut. Activez-le pour les déploiements de production — sans PDB, la maintenance des nœuds peut terminer toutes les répliques du backend simultanément, déconnectant tous les collaborateurs actifs et potentiellement corrompant les modifications de conception en cours. |
pdb_min_available | 1 | Au moins un pod backend doit rester disponible pendant les perturbations volontaires. Nécessite au moins 2 répliques (min_instance_count >= 2) pour être efficace. |
Variables disponibles : enable_pod_disruption_budget, pdb_min_available, enable_topology_spread, topology_spread_strict.
Groupe 15 : Domaine personnalisé et IP statique
Identique à App_GKE. Voir App_GKE.
public_uriet domaines personnalisés : Penpot doit connaître son URL publique au démarrage.PENPOT_PUBLIC_URIest injecté automatiquement en utilisant l'URL de service prédite. Lors de l'utilisation d'un domaine personnalisé, définissezPENPOT_PUBLIC_URIexplicitement viaenvironment_variablespour qu'il corresponde au domaine dansapplication_domains. Penpot utilisepublic_uripour :
- Générer des liens d'invitation envoyés dans les notifications par e-mail
- Configurer l'URL de base de l'API backend du SPA frontend
- Fournir l'URL correcte au Chromium sans tête de l'exportateur pour le rendu des pages
Un
public_uriincorrect rompt les e-mails d'invitation, le rendu d'exportation et toutes les URL absolues intégrées dans les fichiers de conception.
Groupe 16 : Redis (WebSocket Pub/Sub)
Ces variables configurent l'intégration de Redis à Penpot. Le support de l'infrastructure Redis sous-jacente est fourni par App_GKE (voir App_GKE). Redis est obligatoire pour Penpot — c'est le bus d'événements pub/sub WebSocket qui synchronise les changements de conception en temps réel entre tous les utilisateurs connectés sur toutes les répliques du backend.
Note : Dans
Penpot GKE, les variables Redis sont dans le groupe 21.
| Variable | Valeur par défaut | Options / Format | Description et implications |
|---|---|---|---|
enable_redis | true | true / false | Active Redis comme bus d'événements pub/sub WebSocket de Penpot. Doit rester true pour que la collaboration en temps réel fonctionne. Lorsque true et redis_host est vide, le module utilise par défaut l'adresse IP du serveur NFS comme hôte Redis. Sans Redis, tout déploiement avec plus d'une réplique de backend présentera un comportement de "split-brain" — les utilisateurs sur différentes répliques ne peuvent pas voir les changements de conception des autres. Avec une seule réplique, le bus d'événements interne de Penpot est utilisé, mais cela se rompt lors de tout redémarrage de pod ou de mise à jour progressive. |
redis_host | "" (par défaut l'adresse IP du serveur NFS) | Nom d'hôte ou adresse IP | Le nom d'hôte ou l'adresse IP du serveur Redis. Laissez vide pour utiliser l'adresse IP du serveur NFS découverte automatiquement. Remplacez par une IP ou un nom d'hôte explicite lors de l'utilisation d'une instance Redis dédiée — telle que Google Cloud Memorystore pour Redis — pour une disponibilité et un débit plus élevés. Exemple : "10.128.0.10". |
redis_port | "6379" | Chaîne de numéro de port | Le port TCP sur lequel le serveur Redis écoute. La valeur par défaut 6379 est le port Redis standard. |
redis_auth | "" | Chaîne (sensible) | Mot de passe d'authentification pour le serveur Redis. Laissez vide si l'instance Redis ne nécessite pas d'authentification. Pour Google Cloud Memorystore avec AUTH activé, définissez-le sur la chaîne AUTH de l'instance. Cette valeur est traitée comme sensible. |
Validation des paramètres Redis
Console Google Cloud :
- Instance Memorystore (si utilisée) : Accédez à Memorystore → Redis pour confirmer que l'instance existe, son adresse IP, son port et son statut AUTH.
- Environnement de pod GKE : Accédez à Kubernetes Engine → Workloads, sélectionnez le déploiement du backend Penpot et vérifiez les variables d'environnement du pod pour
PENPOT_REDIS_URI.
gcloud CLI / kubectl :
# List Memorystore Redis instances in the project (if using Memorystore)
gcloud redis instances list \
  --region=REGION \
  --project=PROJECT_ID \
  --format="table(name,host,port,state,memorySizeGb,authEnabled)"

# Confirm the Redis URI is set in the Penpot backend pod
kubectl exec -n NAMESPACE POD_NAME -- env | grep PENPOT_REDIS

# Test Redis connectivity from inside the Penpot backend pod
kubectl exec -n NAMESPACE POD_NAME -- \
  nc -zv REDIS_HOST 6379

# Check Penpot backend logs for Redis connection confirmation
kubectl logs -n NAMESPACE POD_NAME | grep -i "redis\|connected\|pub/sub"
Groupe 17 : Configuration du backend GKE
Identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Penpot :
| Variable | Valeur par défaut Penpot GKE | Notes |
|---|---|---|
session_affinity | "ClientIP" | Recommandé pour la stabilité de WebSocket. Avec "None", les requêtes de mise à niveau WebSocket et les trames WebSocket ultérieures peuvent être acheminées vers différentes répliques de backend — cela peut interrompre les sessions de collaboration actives. "ClientIP" garantit que la connexion WebSocket d'un utilisateur atteint toujours le même pod backend. |
service_type | "LoadBalancer" | Expose le backend Penpot via un équilibreur de charge Google Cloud. Le service frontend (ingress = "INGRESS_TRAFFIC_ALL") est également exposé en externe et reçoit directement le trafic du navigateur de l'utilisateur. Le service d'exportation (ingress = "INGRESS_TRAFFIC_INTERNAL_ONLY") est uniquement interne au cluster. |
termination_grace_period_seconds | 60 | Permet aux sessions WebSocket en cours et aux opérations d'exportation de se vider avant la terminaison du pod. Envisagez d'augmenter à 120+ secondes pour les équipes qui utilisent fréquemment la fonction d'exportation PDF/PNG. |
Variables disponibles : gke_cluster_name, namespace_name, workload_type, service_type, session_affinity, configure_service_mesh, enable_network_segmentation, termination_grace_period_seconds, deployment_timeout, network_name, prereq_subnet_cidr_override. (enable_multi_cluster_service et gke_cluster_selection_mode existent sur App_GKE mais ne sont pas mis en miroir sur Penpot_GKE.)
Groupe 18 : Charges de travail avec état
Identique à App_GKE. Voir la configuration StatefulSet décrite dans App_GKE.
La définition de stateful_pvc_enabled = true sélectionne automatiquement workload_type = "StatefulSet". Le stockage des actifs de conception de Penpot est sauvegardé par GCS, donc un PVC par pod n'est pas requis pour la durabilité des données de conception. Un StatefulSet avec PVC peut être utile pour stocker des vidages de tas JVM locaux ou des caches internes persistants de Penpot entre les redémarrages.
| Variable | Valeur par défaut | Notes |
|---|---|---|
stateful_pvc_enabled | null | Défini sur true pour activer StatefulSet avec PVC par pod. |
stateful_pvc_size | "10Gi" | Taille initiale du PVC. |
stateful_pvc_mount_path | "/data" | Chemin du conteneur où le PVC par pod est monté. |
stateful_pvc_storage_class | "standard-rwo" | StorageClass pour le PVC. |
stateful_headless_service | null | Crée un service sans tête pour des identités DNS de pod stables. |
stateful_pod_management_policy | null | "OrderedReady" ou "Parallel". |
stateful_update_strategy | null | "RollingUpdate" ou "OnDelete". |
stateful_fs_group | null | GID pour le fsGroup au niveau du pod dans le contexte de sécurité. |
Sorties du module
Penpot GKE expose les sorties Terraform suivantes :
| Sortie | Description |
|---|---|
service_name | Nom du service Kubernetes principal (backend) |
service_cluster_ip | ClusterIP intra-cluster du service Kubernetes principal |
frontend_url | URL externe du frontend Penpot |
backend_cluster_url | URL intra-cluster du service backend Penpot |
exporter_cluster_url | URL intra-cluster du service d'exportation Penpot |
service_external_ip | Adresse IP externe de l'équilibreur de charge |
project_id | ID du projet GCP |
deployment_id | Suffixe de l'ID de déploiement |
namespace | Espace de noms Kubernetes |
database_instance_name | Nom de l'instance Cloud SQL |
database_name | Nom de la base de données de l'application |
database_user | Nom de l'utilisateur de la base de données de l'application |
database_password_secret | Nom du secret Secret Manager pour le mot de passe de la base de données |
storage_buckets | Buckets de stockage GCS créés (inclut le bucket d'actifs auto-provisionné) |
container_image | Image du conteneur backend utilisée pour le déploiement |
cicd_enabled | Indique si le pipeline CI/CD est activé |
github_repository_url | URL du dépôt GitHub connecté pour le CI/CD |
kubernetes_ready | true lorsque le point de terminaison du cluster GKE est accessible et que toutes les ressources de charge de travail Kubernetes sont déployées. false lors du premier apply d'un nouveau cluster intégré — réexécutez apply pour terminer le déploiement. |
Pièges de configuration et valeurs par défaut judicieuses
Niveaux de risque : Critique (perte de données, panne totale, faille de sécurité) — Élevé (service indisponible ou dégradation significative) — Moyen (fonction dégradée ou coût accru) — Faible (impact mineur).
| Variable | Valeur par défaut judicieuse | Risque | Conséquence d'une valeur incorrecte |
|---|---|---|---|
project_id | (requis) | Critique | Pas de valeur par défaut — le déploiement échoue immédiatement. |
enable_redis | true | Critique | Redis est le bus pub/sub WebSocket. Le désactiver entraîne une rupture immédiate de la collaboration en temps réel avec plus d'une réplique de backend. Split-brain : les utilisateurs sur différentes répliques ne peuvent pas voir les changements de conception des autres. |
redis_host | "" | Élevé | Se résout automatiquement en IP NFS. Si NFS est désactivé et qu'aucun hôte explicite n'est donné, la connexion Redis de Penpot échoue au démarrage et le backend refuse de démarrer. |
enable_nfs | true | Élevé | Requis lorsque redis_host est vide. La désactivation de NFS sans fournir d'hôte Redis explicite entraîne un échec de démarrage du backend. |
container_port | 6060 | Critique | Le backend Penpot écoute sur 6060. Changer cela sans correspondre au port lié du conteneur entraîne l'échec immédiat de toutes les sondes de santé et du proxy nginx frontend. |
memory_limit | "2Gi" | Élevé | La JVM nécessite une marge au-delà de jvm_max_heap. Définir memory_limit égal à jvm_max_heap ne laisse aucune place à la mémoire hors tas (tampons Netty, surcharge GC) et provoque des OOM kills. Toujours définir memory_limit à au moins 1,5× jvm_max_heap. |
jvm_max_heap | "1g" | Élevé | Définir jvm_max_heap au-dessus de memory_limit provoque un OOM kill immédiat au démarrage de la JVM. Le définir trop bas provoque une collecte de déchets excessive sous charge, réduisant la réactivité et le débit de WebSocket. |
timeout_seconds | 3600 | Moyen | Les exportations PDF/PNG volumineuses de conceptions complexes de plusieurs pages peuvent prendre plusieurs minutes. Réduire cela en dessous de 120 secondes entraîne l'expiration des jobs d'exportation et le renvoi d'une erreur à l'utilisateur. |
session_affinity | "ClientIP" | Élevé | Sans affinité de session, les requêtes de mise à niveau WebSocket et leurs trames ultérieures peuvent être acheminées vers différentes répliques de backend. Les sessions de collaboration actives subissent des déconnexions et des pertes d'événements. |
penpot_flags | "enable-registration enable-login disable-demo-users" | Moyen | Des drapeaux incorrects peuvent désactiver complètement la connexion (par exemple, supprimer enable-login-with-password sans configurer OIDC) ou ouvrir l'enregistrement au public de manière inattendue (supprimer disable-registration sur un déploiement exposé à Internet). |
public_uri (via environment_variables) | (auto-prédit) | Élevé | Doit correspondre à l'URL réelle que les utilisateurs utilisent pour accéder à Penpot. Un public_uri incorrect rompt les liens des e-mails d'invitation, les redirections OIDC et la navigation Chromium sans tête de l'exportateur — les PDF et PNG exportés seront vides ou échoueront. |
db_name | "penpot" | Critique | Immuable après le déploiement — la modification de cette valeur recrée la base de données et détruit tous les projets Penpot, les fichiers de conception, les composants et les données d'équipe. |
db_user | "penpot" | Critique | Immuable après le déploiement — la modification de cette valeur recrée l'utilisateur, invalide les identifiants et rompt la connexion de Penpot à la base de données. |
application_version | "latest" | Élevé | Les trois images de service (backend, frontend, exportateur) doivent utiliser la même balise de version. Des versions incompatibles entre le backend et le frontend peuvent entraîner des incompatibilités d'API qui rompent l'interface utilisateur web. Épinglez à une version spécifique pour la production. |
backup_retention_days | 7 | Moyen | Insuffisant pour les équipes de conception ayant des exigences strictes en matière de récupération de données. Augmentez à 30+ jours pour les déploiements de production avec un travail de conception actif qui ne peut pas être recréé. |
quota_memory_requests / quota_memory_limits | "" | Critique (spécifique à GKE) | Doit utiliser des suffixes binaires (Gi, Mi) lorsqu'il est défini. Les entiers nus sont traités comme des octets et empêchent tous les pods d'être planifiés — cela affecte simultanément les trois services Penpot. |
enable_pod_disruption_budget | false | Élevé | Sans PDB, la maintenance des nœuds peut terminer toutes les répliques du backend simultanément, déconnectant tous les collaborateurs actifs et potentiellement entraînant la perte de modifications de conception non enregistrées. Activez-le pour tout déploiement de production avec des utilisateurs actifs. |
smtp_enabled | false | Moyen | Sans SMTP, les e-mails d'invitation ne peuvent pas être envoyés. L'intégration des équipes nécessite le partage manuel des identifiants de connexion ou l'utilisation d'un fournisseur OIDC. La réinitialisation du mot de passe est également indisponible sans SMTP. |
Guides associés
- Lab pratique : Penpot sur GKE Autopilot — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Penpot sur Google Cloud Run — la même application sur Cloud Run, lorsque vous avez besoin de l'autre cible de déploiement.
- Module de configuration partagée commune de Penpot — la configuration partagée par les deux cibles de déploiement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.