ClickHouse sur GKE Autopilot
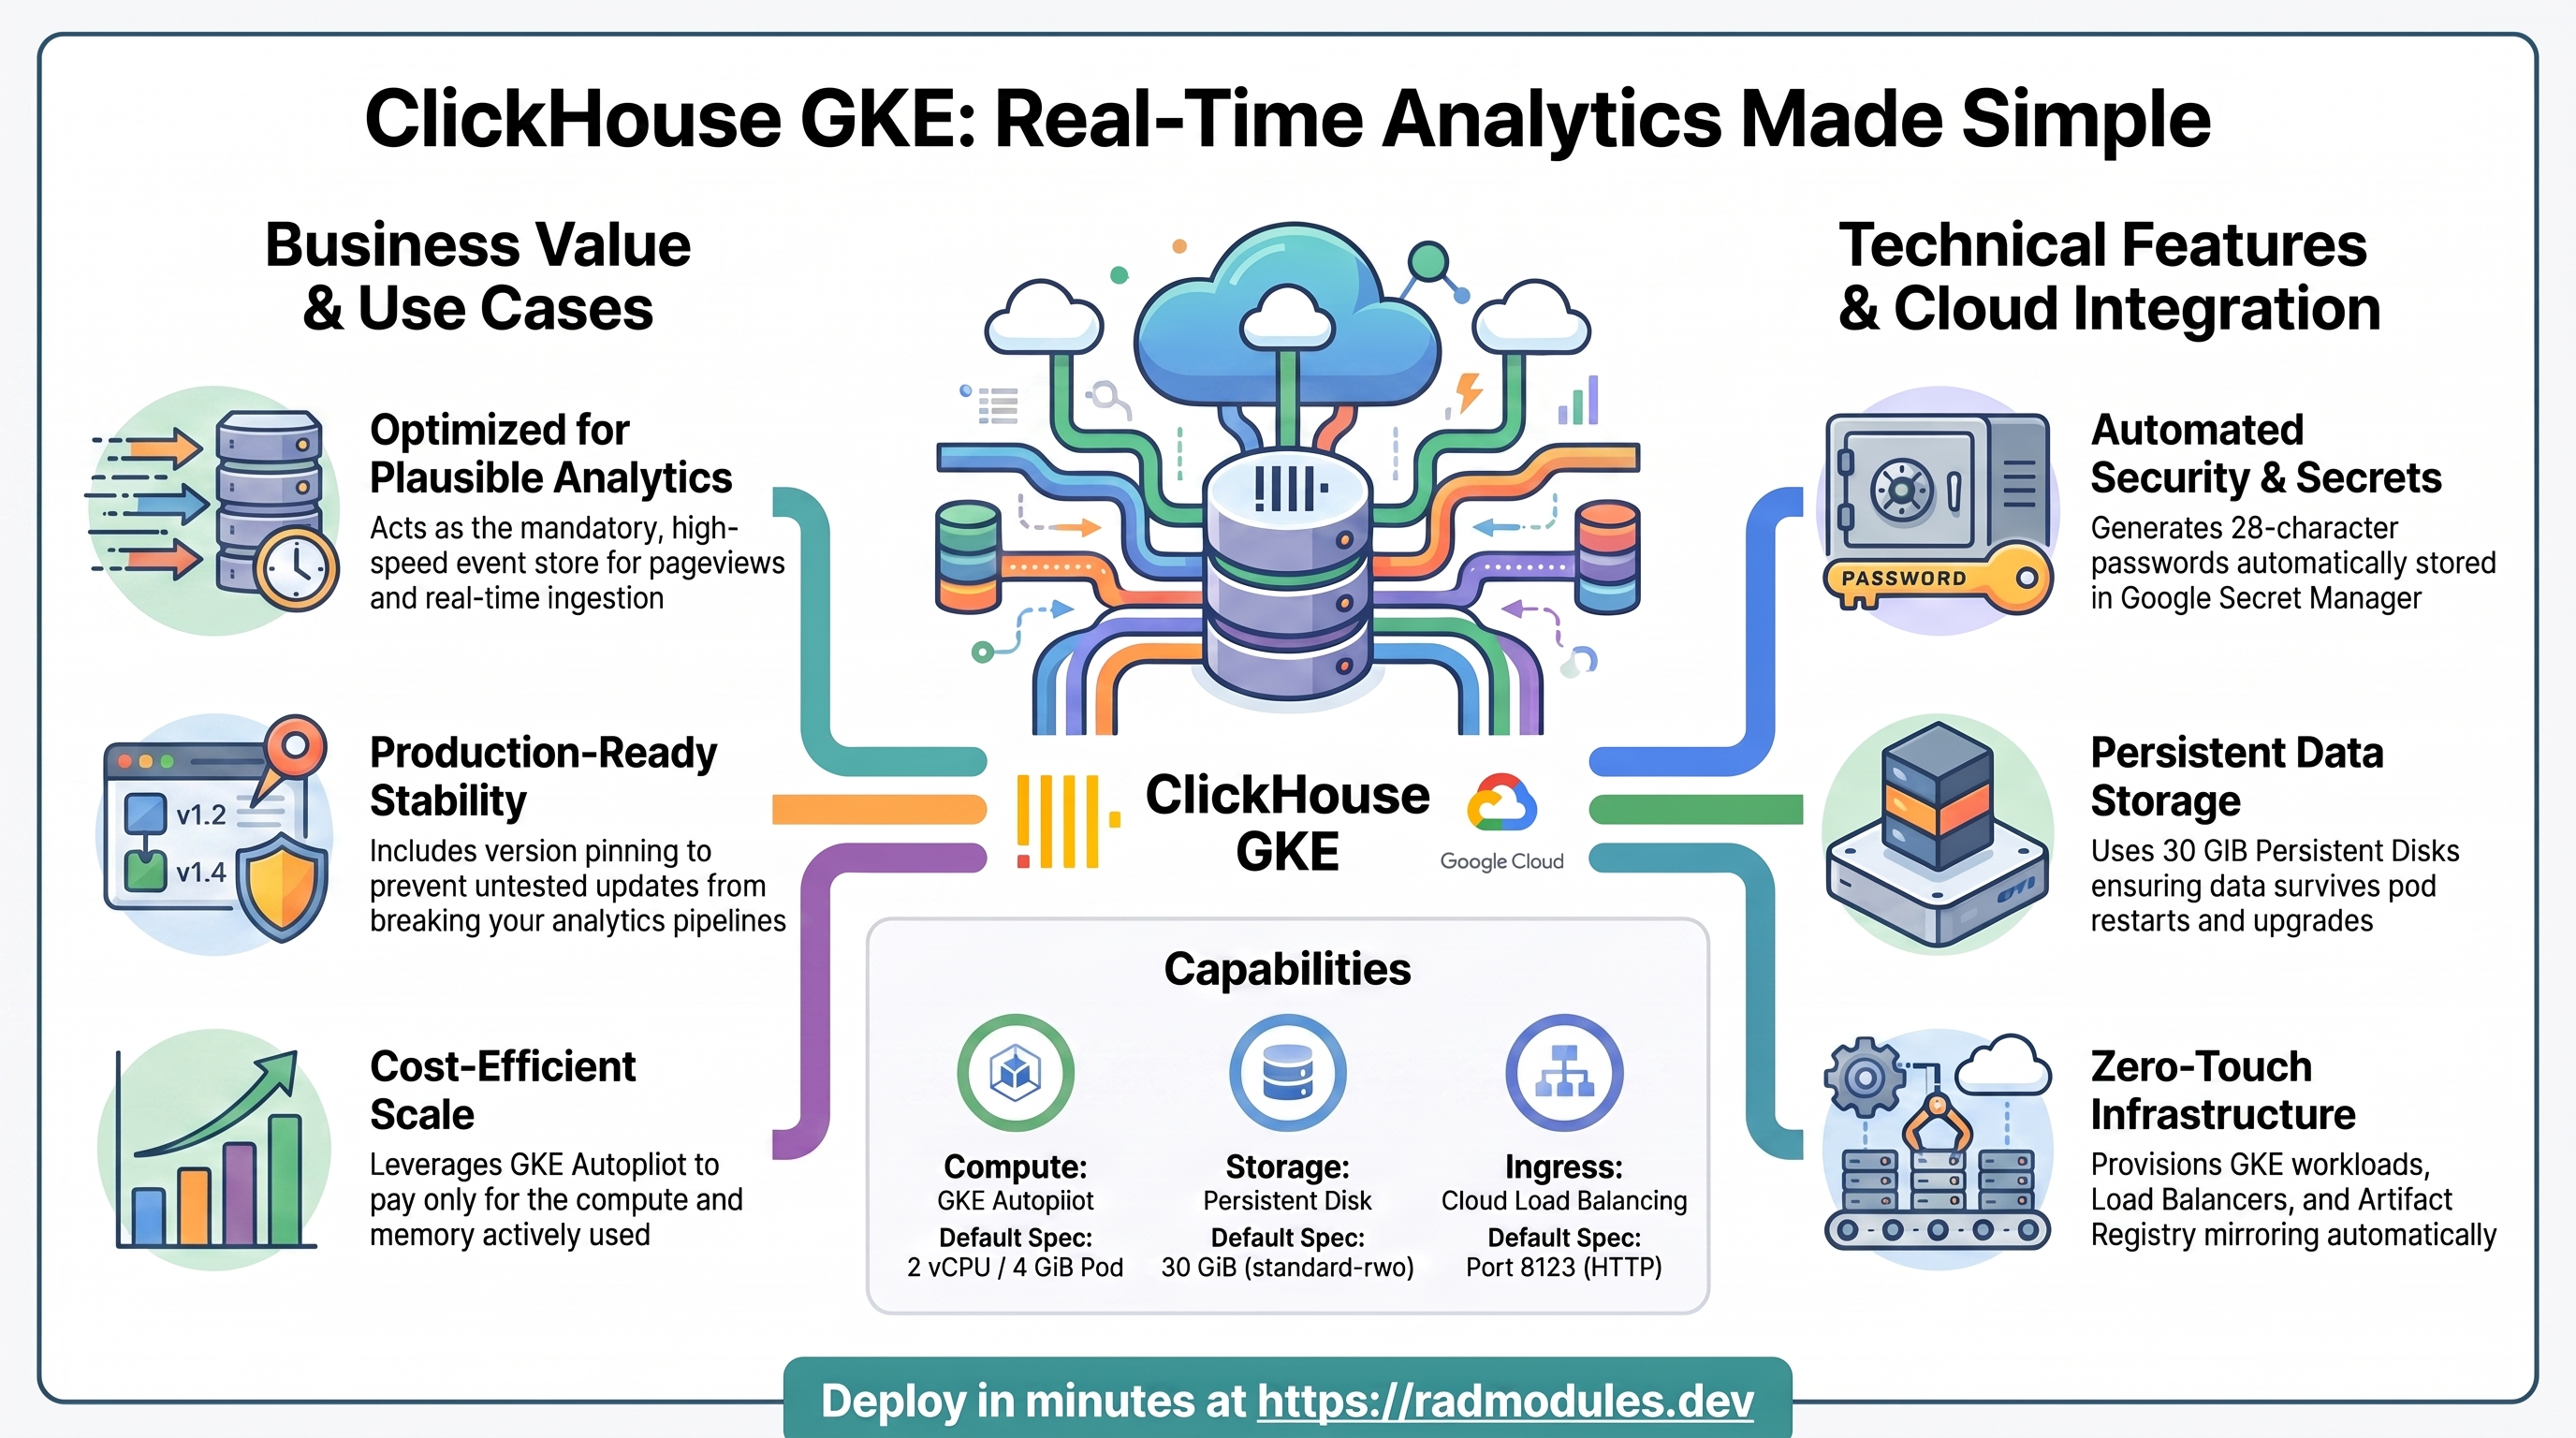
ClickHouse est une base de données OLAP orientée colonne open source (Apache-2.0) conçue pour l'analyse en temps réel de grands flux d'événements. Ce module déploie un serveur ClickHouse à nœud unique sur GKE Autopilot au-dessus de la fondation App_GKE, qui provisionne et gère l'infrastructure partagée de Google Cloud et Kubernetes.
ClickHouse_GKE existe principalement en tant que magasin d'événements obligatoire
pour Plausible Analytics (Plausible_GKE) : la base de données PostgreSQL de Plausible
ne contient que les comptes et la configuration du site — chaque page vue/événement
est écrit et interrogé à partir de cette instance ClickHouse. Le module fonctionne
également comme une base de données OLAP à nœud unique à usage général.
Ce guide se concentre sur les services cloud utilisés par ClickHouse et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à chaque application GKE — Workload Identity, ingress, autoscaling, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide de la fondation App_GKE plutôt que de les répéter ici.
Ce que coûte ClickHouse sur RAD, et comment cela se compare
Le module GKE Autopilot de ClickHouse sur RAD coûte environ 136,37 $ US par mois dans un projet Google Cloud que vous possédez, plus des frais de module uniques de 110 crédits (11 $ US). ClickHouse est une base de données OLAP orientée colonne pour l'analyse en temps réel de grands flux d'événements.
Si ClickHouse n'est nécessaire qu'occasionnellement — une démo, un essai, une charge de travail saisonnière ou d'étude — un projet géré par RAD peut être supprimé et restauré dans les 30 jours sans frais supplémentaires, de sorte que les 136,37 $ US deviennent quelques dollars par mois. Voir Mettez-le en pause gratuitement, ci-dessous.
Ce que vous payez sur RAD
| Dans un projet Google Cloud que vous possédez | Dans un projet géré par RAD pour vous | |
|---|---|---|
| Frais de module, une fois par déploiement | 110 crédits (11 $ US au prix de la recharge) | 99 crédits (10 % de moins) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients sont l'exception : ils sont toujours facturés à la minute pour le temps de build | Idem |
| Coût d'exécution Google Cloud | Facturé par Google à votre propre compte de facturation, environ 136,37 $ US par mois pour la configuration par défaut (tableau ci-dessous) | Mesuré à l'heure en crédits ; RAD publie 136 crédits par jour, soit environ 4 080 par mois (environ 408 $ US au prix de la recharge ; estimé à partir des prix catalogue de Google, et incluant les frais de cluster) |
| Qui possède quoi | Vous possédez le projet et sa facturation ; RAD le déploie et le met à jour | RAD possède le projet, avec des garde-fous, des quotas et des alertes budgétaires ; vous avez accès à la console, et un solde d'achat minimum est conservé en réserve |
Pourquoi les deux colonnes diffèrent. Le chiffre géré par RAD inclut les frais de gestion du cluster GKE (environ 73 $ US par mois) et la fondation partagée du projet. Dans votre propre projet, le niveau gratuit de Google couvre les frais de gestion d'un cluster par compte de facturation, ce que le chiffre du propre projet suppose. Il est estimé à partir des prix catalogue de Google, car il n'y a pas encore suffisamment d'historique GKE géré par RAD pour le mesurer, donc la confirmation de déploiement ne le cite pas. Une deuxième application GKE dans le même projet géré par RAD partage le cluster et n'ajoute que ses propres pods.
Votre premier déploiement réussi sur RAD est exempt de frais de module, quel que soit le montant : une fois par compte, pour un module que vous déployez et payez vous-même (dans une solution, les frais d'une application : la première à réussir ; jamais une session de lab ou un projet client).
10 crédits coûtent 1 $ US lors d'une recharge unique, moins sur un forfait. Dans un projet géré par RAD, la base de données, le serveur de fichiers et le réseau sont partagés par chaque application du projet, de sorte qu'une deuxième application n'ajoute pas de deuxième base de données.
Coût d'exécution par défaut dans votre propre projet (us-central1, prix catalogue Google) :
| Ressource (module par défaut) | Par mois |
|---|---|
| Pod GKE Autopilot, 2x vCPU / 4 Gio | 79,35 $ US |
| Cloud SQL pour PostgreSQL, 1 vCPU / 3,75 Go, zonal, 10 Go SSD | 51 $ US |
| Cloud NAT et réseau | 5 $ US |
| Cloud Storage (modules complémentaires, sauvegardes) | 1 $ US |
| Frais de gestion du cluster GKE | partagés entre toutes les applications GKE du projet ; 0 $ si c'est votre seul cluster, sinon ~73 $ |
| Total | environ 136,37 $ US |
Comment cela se compare
- L'offre gérée propre au projet, ClickHouse Cloud, n'a pas de minimum mensuel — un essai gratuit de 30 jours et 300 crédits, puis un calcul basé sur l'utilisation (mesuré à la minute, facturé par unité de calcul-heure, une unité = 2 vCPU/8 Gio) et le stockage (par To-mois) ; sur le niveau Enterprise, ceux-ci s'élèvent à 0,32-0,50 $ par unité de calcul-heure et 22-27,50 $ par To-mois, les niveaux Basic et Scale étant moins chers mais non publiés séparément.
- Si vous l'exécutez vous-même, un VPS exécutant un serveur ClickHouse à nœud
unique coûte moins cher en espèces : dimensionné à environ 2 vCPU/4 Gio, un VPS
comparable (Hetzner ou DigitalOcean) coûte environ 24-48 $ par mois, ou une VM
GCP de classe
e2-standard-2environ 49 $ — plus votre propre temps pour les sauvegardes, les correctifs de sécurité et les mises à niveau, que Cloud SQL, Secret Manager et la surveillance gérés par RAD couvrent pour vous. - RAD ne prétend jamais être moins cher que l'infrastructure nue en termes monétaires — ce n'est généralement pas le cas. La différence est ce que RAD gère pour vous : les correctifs, les sauvegardes, les secrets et la surveillance, ainsi que la possibilité de mettre ClickHouse en pause gratuitement plutôt que de payer pour une capacité inactive (voir ci-dessous).
- La majeure partie du coût d'exécution ci-dessus est la base de données PostgreSQL gérée (et, le cas échéant, le serveur de fichiers partagé) — la partie qu'une comparaison avec un VPS nu doit exécuter et sauvegarder à la main.
Mettez-le en pause gratuitement : supprimez un projet géré par RAD, restaurez-le lorsque vous en avez besoin
Si ClickHouse s'exécute dans un projet géré par RAD pour vous, vous avez une deuxième option qui va bien au-delà de la mise à l'échelle à zéro : supprimez l'ensemble du projet et restaurez-le dans les 30 jours pour presque rien. Cela convient bien mieux à ClickHouse dont vous n'avez besoin qu'occasionnellement que de le faire fonctionner en continu.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, seront utilisables après sa restauration, de sorte que la restauration ne peut pas être considérée comme un moyen de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
- Comment ça marche. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer le projet. Google ne supprime pas le projet immédiatement : il le conserve, récupérable, pendant 30 jours. Comme la facturation est déjà déliée, rien n'est facturé pendant qu'il attend. Contrairement à la suppression d'un module, cela ne démantèle pas les ressources Cloud SQL ou GKE Autopilot une par une — l'ensemble du projet, et tout ce qu'il contient, s'arrête simplement.
- La restauration est une vérification, pas une reconstruction. Dans les 30 jours, le propriétaire du projet peut le restaurer. RAD demande à Google de réactiver le projet et de rattacher son compte de facturation, puis vous demande d'exécuter Mettre à jour sur chaque déploiement pour confirmer que tout est revenu. Comme rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes — c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit.
- Ainsi, un mois d'utilisation occasionnelle peut coûter quelques dollars, et non les 408 $ US par mois pour le maintenir en fonctionnement. Déployez ClickHouse, utilisez-le, supprimez le projet. Restaurez-le la prochaine fois que vous en avez besoin, confirmez avec Mettre à jour, et supprimez-le à nouveau lorsque vous avez terminé. Vous ne payez les frais de module qu'une seule fois et les heures pendant lesquelles il a été réellement actif.
- Ce dont cela a besoin. Vous devez posséder le projet (pas un projet que vous apportez et dont RAD ne gère que la facturation), et vous le restaurez vous-même dans les 30 jours — après cela, Google le supprime définitivement. La restauration est admise comme la création d'un nouveau projet : votre solde de crédits achetés doit toujours dépasser le seuil du niveau (100 crédits pour le niveau sandbox que la plupart des utilisations d'étude et de démo conviennent). Google indique que la plupart des services sont entièrement fonctionnels dans les 36 heures suivant une restauration.
- Un véritable manque : le bucket de sauvegarde ne survit pas. Les sauvegardes nocturnes sont écrites dans un bucket à l'intérieur du projet, et ce bucket n'est pas protégé par la suppression logicielle de Cloud Storage, il est donc très probable qu'il disparaisse dès que vous supprimez le projet — même si le projet lui-même est récupérable pendant 30 jours. Si vous avez personnalisé ClickHouse et que vous souhaitez conserver ce travail, copiez une sauvegarde (vers Google Drive ou un bucket en dehors du projet) avant de supprimer. Pour une installation par défaut sans rien d'irremplaçable, cela n'a pas d'importance.
Payez uniquement pendant que vous l'utilisez, l'autre méthode : supprimer et redéployer
GKE Autopilot maintient au moins un pod en cours d'exécution, il ne se met donc jamais à l'échelle à zéro de lui-même. L'option ci-dessus ne s'applique qu'à un projet géré par RAD ; dans votre propre projet, ou une fois la fenêtre de 30 jours passée, la façon d'arrêter de payer est de supprimer le déploiement et de le déployer à nouveau lorsque vous en avez besoin.
- Ce que coûte un redéploiement. Les frais de module à nouveau (les builds sont inclus) : 110 crédits (11,00 $ US) dans votre propre projet. La suppression n'économise de l'argent que si ClickHouse resterait inutilisé pendant environ 3 jours ou plus dans votre propre projet (4,55 $ US par jour), ou environ 1 jour ou plus dans un projet géré par RAD (136 crédits par jour).
- La majeure partie du coût d'exécution est généralement la base de données. Elle ne s'arrête que si rien d'autre dans le projet ne l'utilise, donc la suppression de ClickHouse alors que quelque chose d'autre partage le projet n'économise que la partie calcul propre à cette application.
- Conservez d'abord vos données. Les sauvegardes nocturnes sont écrites dans un bucket à l'intérieur du déploiement et sont supprimées avec celui-ci, donc copiez la dernière sauvegarde avant de la supprimer si vous souhaitez la conserver.
- Notez vos paramètres. RAD ne recrée pas un déploiement supprimé pour vous ; vous saisissez à nouveau les paramètres lors du déploiement.
Sessions de lab et environnements gérés
- Sessions de lab, pour la formation. Un formateur anime une session pour une classe. Chaque participant obtient l'application dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite d'une allocation définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés sont reversés au formateur.
- Environnements gérés, pour les sociétés de conseil. Un partenaire exécute l'application pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille est faible, la facturation est suspendue et les données sont conservées, de sorte que personne ne reçoit de frais inattendus. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue Google Cloud de l'API Cloud Billing Catalog ; frais propres à RAD et estimations de crédits quotidiens de radmodules.dev/pricing ; Supprimer et restaurer des projets pour la fenêtre de récupération de 30 jours et ce qu'elle dit sur les objets Cloud Storage sans suppression logicielle ; ClickHouse Cloud. Les prix changent ; vérifiez chaque source avant de vous fier à un chiffre.
1. Vue d'ensemble
ClickHouse s'exécute en tant que charge de travail StatefulSet. Le déploiement relie un ensemble ciblé de services Google Cloud :
| Capacité | Service Google Cloud | Notes |
|---|---|---|
| Calcul | GKE Autopilot | Pod StatefulSet ClickHouse, 2 vCPU / 4 Gio par défaut |
| Stockage persistant | Persistent Disk | PVC de 30 Gio (standard-rwo) à /var/lib/clickhouse, survit aux redémarrages de pod |
| Secrets | Secret Manager | Mot de passe utilisateur ClickHouse auto-généré, injecté comme CLICKHOUSE_PASSWORD |
| Ingress | Cloud Load Balancing | Service LoadBalancer sur le port 8123 (interface HTTP ClickHouse) pour l'accès inter-espaces de noms |
| Registre d'images | Artifact Registry | clickhouse/clickhouse-server mis en miroir depuis Docker Hub |
Pas de Cloud SQL, pas de Redis, pas de buckets GCS — l'enveloppe force
database_type = "NONE", enable_cloudsql_volume = false et enable_redis = false
dans l'appel de la fondation. Toutes les données résident dans le PVC.
Valeurs par défaut judicieuses à connaître d'emblée :
- La version est explicitement épinglée —
latestest rejeté.application_versionutilise par défaut le tag connu24.12-alpineet une validation au moment de la planification rejette"latest", car Plausible CE épingle la version de ClickHouse — des versions non testées l'ont cassé en amont (plausible/analytics#3855). La Fondation résout le tag déployé à partir de cette variable (un remappage au niveau de la configuration est ignoré), donc un épinglage explicite est le seul contrôle fiable. - Le bootstrap se produit une seule fois. L'image officielle crée
CLICKHOUSE_DB(plausible_events_db) etCLICKHOUSE_USER(plausible) uniquement au premier démarrage d'un répertoire de données vide, avecCLICKHOUSE_DEFAULT_ACCESS_MANAGEMENT=1afin que l'utilisateur puisse gérer les utilisateurs/bases de données via SQL. Les migrations de Plausible créent le schéma des événements. - L'authentification par mot de passe est toujours activée. Un mot de passe
de 28 caractères (pas de caractères spéciaux — il transite dans les URL et les
en-têtes d'authentification de base) est généré par Terraform, stocké dans
Secret Manager sous le nom
secret-<tenant_resource_prefix>-clickhouse-clickhouse-password, et injecté commeCLICKHOUSE_PASSWORD. Comme le service est un LoadBalancer par défaut, une instance non authentifiée serait un magasin d'analyse ouvert. - Le nœud unique est appliqué au moment de la planification —
max_instance_countdoit être1. ClickHouse multi-nœuds nécessite une configuration Keeper/réplication que ce module ne fournit pas. - Le service écoute sur le port 8123, et non sur le port 80 par défaut
d'App_GKE — l'enveloppe transmet
service_port = container_portafin que les consommateurs (CLICKHOUSE_DATABASE_URLde Plausible) construisent leur chaîne de connexion sur le port d'interface HTTP standard de ClickHouse. - Les sondes sont TCP, câblées dans la configuration du module. Démarrage : délai initial de 30 s, période de 10 s, seuil d'échec de 60 — jusqu'à ~10 minutes, car Autopilot doit provisionner un nœud, attacher le PVC et tirer l'image avant même que le conteneur ne démarre. Vivacité : 60 s / 30 s / 3. TCP est robuste sur toutes les variantes d'image et ne peut pas être bloqué par des changements d'authentification.
- fsGroup 101. L'image
clickhouse/clickhouse-servers'exécute en tant que UID/GID 101 ; le module définit le fsGroup du pod à101afin que Kubernetes change le propriétaire du PVC lors de l'attachement et que le serveur puisse créer/var/lib/clickhouse. - La période de grâce de terminaison est de 120 secondes afin que ClickHouse
puisse vider les parties de données (segments) en mémoire sur le disque avant
que le pod ne soit supprimé de force ;
deployment_timeoutest de 1800 s.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que vous avez exécuté
gcloud container clusters get-credentials <cluster> --region <region> --project <project>
et que PROJECT, REGION et NAMESPACE sont définis.
L'espace de noms et les autres identifiants sont signalés dans les Sorties
du déploiement.
A. GKE Autopilot — la charge de travail ClickHouse
ClickHouse s'exécute en tant que StatefulSet Kubernetes sur GKE Autopilot. Autopilot facture le CPU et la mémoire que le pod demande réellement. Un PodDisruptionBudget maintient le pod disponible pendant les mises à niveau des nœuds.
- Console : Kubernetes Engine → Charges de travail → sélectionnez le StatefulSet ClickHouse pour voir l'état du pod, les événements et l'attachement du PVC. Kubernetes Engine → Services et Ingress affiche l'adresse IP externe du LoadBalancer sur le port 8123.
- CLI :
gcloud container clusters list --project "$PROJECT"
kubectl get statefulset,pvc,svc -A | grep clickhouse     # name-agnostic discovery
kubectl get statefulsets,pods,svc,pvc -n "$NAMESPACE"
kubectl logs -n "$NAMESPACE" <pod-name> --tail=100
kubectl describe pvc -n "$NAMESPACE"          # confirm the PVC is Bound
Voir App_GKE pour la mise à l'échelle d'Autopilot, le PDB et le cycle de vie du StatefulSet.
B. Persistent Disk — stockage d'événements
Toutes les parties de données ClickHouse résident sur un PersistentVolumeClaim
soutenu par Persistent Disk, provisionné par la StorageClass standard-rwo
et monté à /var/lib/clickhouse (le répertoire de données du serveur).
- Console : Kubernetes Engine → Stockage → PersistentVolumeClaims pour la taille et l'état de liaison. Compute Engine → Disques affiche le disque sous-jacent.
- CLI :
kubectl get pvc -n "$NAMESPACE"
kubectl describe pvc -n "$NAMESPACE" <pvc-name>
# Check disk usage inside the pod:
kubectl exec -n "$NAMESPACE" <pod-name> -- df -h /var/lib/clickhouse
Dimensionnez le PVC en fonction du volume d'événements — les charges de travail Plausible se compressent extrêmement bien dans ClickHouse, mais laissez de la marge pour les fusions (les fusions de parties en arrière-plan nécessitent temporairement un espace supplémentaire).
C. Point de terminaison du service ClickHouse et authentification
L'interface HTTP de ClickHouse est exposée sur le port 8123 via un service
Kubernetes LoadBalancer. L'adresse externe est la sortie clickhouse_endpoint ;
l'adresse DNS intra-cluster est clickhouse_internal_endpoint (préférable lorsque
Plausible s'exécute dans le même cluster). Le mot de passe de l'utilisateur
amorcé réside dans Secret Manager.
- Console : Kubernetes Engine → Services et Ingress pour l'adresse IP externe ; Sécurité → Secret Manager pour le secret du mot de passe.
- CLI :
CH_IP=$(kubectl get svc -n "$NAMESPACE" \
  -o jsonpath='{.items[?(@.spec.type=="LoadBalancer")].status.loadBalancer.ingress[0].ip}')
CH_SECRET=$(gcloud secrets list --project "$PROJECT" \
  --filter="name~clickhouse-password" --format="value(name)" --limit=1)
CH_PASS=$(gcloud secrets versions access latest --secret="$CH_SECRET" --project "$PROJECT")

# Unauthenticated health ping (expect "Ok."):
curl -s "http://$CH_IP:8123/ping"

# Authenticated query over HTTP:
echo "SELECT version()" | curl -s "http://$CH_IP:8123/" --user "plausible:$CH_PASS" --data-binary @-
echo "SHOW DATABASES" | curl -s "http://$CH_IP:8123/" --user "plausible:$CH_PASS" --data-binary @-

# Native client inside the pod:
kubectl exec -n "$NAMESPACE" -it <pod-name> -- \
  clickhouse-client --user plausible --password "$CH_PASS" --query "SELECT 1"
D. Secret Manager
Le mot de passe utilisateur de ClickHouse est généré par Terraform (random_password,
28 caractères, pas de caractères spéciaux) et stocké en tant que secret
d'application à portée de service — secret-<tenant_resource_prefix>-clickhouse-clickhouse-password — puis injecté
dans le conteneur en tant que variable d'environnement secrète CLICKHOUSE_PASSWORD.
Les modules consommateurs (Plausible) référencent le même secret via la sortie
clickhouse_password_secret_id et la fondation accorde à leur SA de charge de travail
secretAccessor.
- Console : Sécurité → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT" --filter="name~clickhouse-password"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
Voir App_GKE pour le mécanisme d'injection et de rotation des secrets.
E. Artifact Registry — image de conteneur
L'image officielle clickhouse/clickhouse-server:<version> est mise en miroir dans Artifact
Registry avant le déploiement (lorsque enable_image_mirroring = true), évitant les
limites de débit de Docker Hub et conservant les images à l'intérieur de votre
périmètre VPC.
- Console : Artifact Registry → sélectionnez le dépôt pour les tags et les digests.
- CLI :
gcloud artifacts repositories list --project "$PROJECT" --location "$REGION"
gcloud artifacts docker images list "$REGION-docker.pkg.dev/$PROJECT/<repo>" --project "$PROJECT"
F. Réseau et ingress
Le service LoadBalancer expose ClickHouse sur le port 8123 afin que Plausible
(et les services Cloud Run) puissent l'atteindre à travers les espaces de noms.
L'authentification par mot de passe protège le point de terminaison, mais pour
une défense en profondeur, préférez service_type = "ClusterIP" lorsque tout partage
le cluster, ou restreignez l'accessibilité avec enable_network_segmentation /
admin_ip_ranges / règles de pare-feu.
- Console : Services réseau → Équilibrage de charge ; Réseau VPC → Adresses IP.
- CLI :
kubectl get ingress,svc -n "$NAMESPACE"
gcloud compute addresses list --project "$PROJECT"
Voir App_GKE pour les domaines personnalisés, les adresses IP statiques et les détails de Cloud Armor.
G. Cloud Logging et Monitoring
Les sorties stdout/stderr du pod (le journal du serveur ClickHouse) sont acheminées vers Cloud Logging ; les métriques GKE sont acheminées vers Cloud Monitoring.
- Console : Logging → Explorateur de journaux ; Monitoring → Tableaux de bord / Alertes.
- CLI :
gcloud logging read 'resource.type="k8s_container" AND resource.labels.namespace_name="'"$NAMESPACE"'"' \
  --project "$PROJECT" --limit 50
3. Comportement de l'application ClickHouse
- Amorçage au premier démarrage uniquement. L'image lit
CLICKHOUSE_DB,CLICKHOUSE_USERetCLICKHOUSE_PASSWORDuniquement lorsque/var/lib/clickhouseest vide. Une fois que des données existent dans le PVC, la modification de ces variables n'a aucun effet sur le serveur en cours d'exécution — gérez plutôt les utilisateurs et les bases de données via SQL (CLICKHOUSE_DEFAULT_ACCESS_MANAGEMENT=1accorde à l'utilisateur amorcé la gestion des accès). La validation au moment de la planification rejette les valeurs videsclickhouse_db/clickhouse_user. - Plausible crée le schéma. Aucun job d'initialisation n'est exécuté ; le
module livre la base de données vide et les migrations de Plausible créent les
tables d'événements au premier démarrage de Plausible. Les sorties
clickhouse_database/clickhouse_username/clickhouse_password_secret_idsont exactement ce quePlausible_GKEconsomme. - L'épinglage de version est une fonctionnalité de correction.
application_versionutilise par défaut24.12-alpineet"latest"est rejeté au moment de la planification — la Fondation résout le tag déployé à partir de cette variable (un remappage au niveau de la configuration est ignoré), donc l'épinglage explicite est le seul contrôle fiable. Plausible CE ne prend en charge que les versions de ClickHouse qu'il teste ; un tag plus récent arbitraire a déjà cassé Plausible en amont (plausible/analytics#3855). Considérez une augmentation de version comme un changement à valider par rapport à votre version de Plausible, et non comme une mise à jour de routine. - Nœud unique uniquement.
max_instance_count = 1est appliqué par une précondition au moment de la planification. La mise à l'échelle d'un StatefulSet ClickHouse simple à 2+ réplicas ne crée pas de cluster — les réplicas auraient besoin de ClickHouse Keeper et de moteurs de tableReplicated*, que ce module ne configure pas. - Sondes TCP par conception.
/pingrépond HTTP 200 sans authentification, mais les sondes TCP sont robustes sur toutes les variantes d'image et ne peuvent pas être bloquées par des changements de configuration d'authentification. Le compromis : un passage de sonde prouve seulement que le port est à l'écoute — vérifiez explicitement l'authentification et le comportement des requêtes après le déploiement (voir les commandes d'exploration ci-dessus). Les variablesstartup_probe_config/health_check_configexistent pour la mise en miroir de convention ; les sondes de conteneur réellement utilisées sont les sondes TCP assemblées dansclickhouse.tf. - Le démarrage à froid lent est normal. Sur un nouveau cluster Autopilot, le
premier déploiement peut prendre jusqu'à ~10 minutes avant d'être Prêt :
provisionnement du nœud, attachement du PVC, extraction de l'image, puis
initialisation de ClickHouse. La sonde de démarrage (seuil 60 × 10 s) et
deployment_timeout = 1800sont dimensionnées pour cela — ne les raccourcissez pas parce qu'un redéploiement à chaud a été rapide. - L'arrêt gracieux est important. ClickHouse met en mémoire tampon les
insertions dans des parties en mémoire et fusionne sur disque en arrière-plan
;
termination_grace_period_seconds = 120lui donne le temps de vider proprement. Tuer de force risque une récupération lente au prochain démarrage. - UID/GID 101. Le processus serveur s'exécute en tant que
clickhouse(101:101). Lestateful_fs_group = 101du module rend le PVC accessible en écriture par le groupe lors de l'attachement ; sans cela, le serveur ne peut pas créer son répertoire de données et plante immédiatement.
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres spécifiques ou notables pour ClickHouse sont listés ; toutes les autres entrées sont héritées d'App_GKE avec son comportement et ses valeurs par défaut standard.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Projet Google Cloud cible. |
region | us-central1 | Région pour la charge de travail et les ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques par environnement. |
support_users | [] | Adresses e-mail ayant accès au projet et aux alertes de surveillance. |
resource_labels | {} | Libellés appliqués à toutes les ressources pour le suivi des coûts/propriétés. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | clickhouse | Nom de base des ressources. Ne pas modifier après le premier déploiement. |
application_display_name | ClickHouse | Nom convivial affiché dans la console. |
application_version | 24.12-alpine | Tag d'image. latest est rejeté au moment de la planification — la Fondation résout le tag déployé à partir de cette variable (un remappage au niveau de la configuration est ignoré), donc un épinglage explicite testé par Plausible est le seul contrôle fiable. |
clickhouse_db | plausible_events_db | Base de données amorcée au premier démarrage (CLICKHOUSE_DB). Non vide imposé au moment de la planification. |
clickhouse_user | plausible | Utilisateur amorcé au premier démarrage (CLICKHOUSE_USER) ; mot de passe auto-généré dans Secret Manager. Non vide imposé au moment de la planification. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définir false pour provisionner uniquement l'infrastructure. |
container_image_source | prebuilt | Toujours prebuilt — image officielle clickhouse/clickhouse-server, pas de build. |
container_image | "" | Remplacer l'URI de l'image ; laisser vide pour l'image officielle. |
enable_image_mirroring | true | Mettre en miroir l'image dans Artifact Registry avant le déploiement. |
min_instance_count | 1 | Garder à 1 pour le mode nœud unique. |
max_instance_count | 1 | Doit être 1 — imposé au moment de la planification ; le multi-nœud nécessite Keeper/réplication que ce module ne fournit pas. |
container_port | 8123 | Port de l'interface HTTP de ClickHouse — également transféré comme port de service (pas le port 80 par défaut d'App_GKE). |
cpu_limit | 2000m | CPU par pod. |
memory_limit | 4Gi | Mémoire par pod. ClickHouse recommande 4 Gio comme plancher pratique ; Plausible à faible trafic fonctionne de manière acceptable à 2 Gio. |
timeout_seconds | 300 | Délai d'expiration du backend de l'équilibreur de charge. |
Groupe 5 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Variables d'environnement supplémentaires fusionnées dans le conteneur ; les valeurs utilisateur remplacent les valeurs intégrées du module (CLICKHOUSE_DB, CLICKHOUSE_USER, CLICKHOUSE_DEFAULT_ACCESS_MANAGEMENT). |
secret_environment_variables | {} | Mappage de variable d'environnement → nom de secret Secret Manager (le module injecte déjà CLICKHOUSE_PASSWORD). |
secret_rotation_period | 2592000s | Cadence de notification de rotation de Secret Manager. |
secret_propagation_delay | 30 | Secondes à attendre après la création du secret avant de continuer. |
Groupe 6 — Backend et cluster GKE
| Variable | Valeur par défaut | Description |
|---|---|---|
gke_cluster_name | "" | Nom du cluster GKE ; laisser vide pour la découverte automatique. |
namespace_name | "" | Espace de noms Kubernetes ; auto-généré si vide. |
workload_type | null | Laisser non défini — null se résout automatiquement en StatefulSet lorsque stateful_pvc_enabled = true (la valeur par défaut) ; un déploiement est rejeté avec un PVC. |
service_type | LoadBalancer | Requis pour l'accès inter-espaces de noms/inter-plateformes depuis Plausible. Utiliser ClusterIP lorsque tous les consommateurs partagent le cluster. |
termination_grace_period_seconds | 120 | Grâce SIGTERM pour le vidage des segments. |
deployment_timeout | 1800 | Secondes pendant lesquelles Terraform attend le déploiement du StatefulSet. |
Groupe 7 — StatefulSet et persistance
La persistance des données est essentielle — toutes les données d'événements ClickHouse résident dans le PVC.
| Variable | Valeur par défaut | Description |
|---|---|---|
stateful_pvc_enabled | true | Par défaut true — sans PVC, ClickHouse se déploie en tant que déploiement sur un disque éphémère et l'intégralité du magasin d'événements est effacée à chaque réordonnancement de pod. Résout automatiquement workload_type en StatefulSet. |
stateful_pvc_size | 30Gi | Taille du PVC. Laisser de la marge pour les fusions en arrière-plan. |
stateful_pvc_mount_path | /var/lib/clickhouse | Ne pas modifier — le répertoire de données du serveur. |
stateful_pvc_storage_class | standard-rwo | Valeur par défaut de GKE Autopilot ; premium-rwo pour des charges de requêtes plus lourdes. Ne peut pas être modifié après la création du PVC. |
stateful_fs_group | 101 | UID/GID de l'image clickhouse/clickhouse-server. main.tf transmet cette variable, et la configuration assemblée du module dans clickhouse.tf définit également en dur 101, de sorte que les deux concordent. |
Groupe 8 — Quota de ressources
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_resource_quota | false | Plafonner le CPU/la mémoire de l'espace de noms. |
quota_memory_requests / quota_memory_limits | "" | Doit utiliser des unités binaires (4Gi, 8192Mi) — les entiers bruts sont lus comme des octets et bloquent toute planification de pod. |
Groupe 9 — Politiques de fiabilité
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_pod_disruption_budget | true | Protéger la disponibilité pendant les mises à niveau des nœuds. |
pdb_min_available | 1 | Pour ClickHouse à nœud unique, "1" empêche toute perturbation volontaire. |
Groupe 10 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe_config / health_check_config | (déclaré) | Miroirs de convention — le conteneur utilise les sondes TCP câblées du module (démarrage 30 s/10 s/60 ; vivacité 60 s/30 s/3). |
uptime_check_config | désactivé, chemin /_cluster/health | Vérification de disponibilité Cloud Monitoring facultative ; le chemin configuré n'est pas un véritable point de terminaison ClickHouse (utiliser /ping si vous activez ceci). |
alert_policies | [] | Politiques d'alerte métrique facultatives. |
Groupe 11 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Non requis — ClickHouse s'amorce lui-même ; Plausible crée le schéma. |
cron_jobs / additional_services | [] | CronJobs / services sidecar facultatifs. |
Groupe 12 — CI/CD et intégration GitHub
Intégration standard App_GKE Cloud Build / Cloud Deploy — voir App_GKE.
Entrées clés : enable_cicd_trigger, github_repository_url, github_token,
enable_cloud_deploy, enable_binary_authorization.
Groupes 13-16 — NFS, Cloud Storage, Redis, Base de données
Non utilisé par ClickHouse. enable_nfs = false et create_cloud_storage = false par
défaut ; main.tf force enable_redis = false, database_type = "NONE",
et enable_cloudsql_volume = false indépendamment des variables déclarées (qui existent
pour la parité de l'interface de fondation). Les boutons de rétention d'Artifact
Registry (max_images_to_retain = 7, delete_untagged_images = true,
image_retention_days = 30) s'appliquent à l'image mise en miroir.
Groupe 17 — Sauvegarde et maintenance
| Variable | Valeur par défaut | Description |
|---|---|---|
backup_schedule | 0 2 * * * | Cron (UTC). Pour ClickHouse, préférez les instructions natives BACKUP ... TO S3/GCS aux sauvegardes au niveau du système d'exploitation. |
backup_retention_days | 7 | Rétention en jours. |
enable_backup_import | false | Non applicable pour ClickHouse. |
Groupe 19 — Domaine personnalisé, IP statique et réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_custom_domain | true | Provisionner Ingress pour le routage d'hôtes personnalisés. |
application_domains | [] | Noms d'hôtes à servir. |
reserve_static_ip | true | IP externe stable sur les redéploiements. |
network_tags | ["nfsserver"] | Tags réseau de nœud/pod GKE pour les règles de pare-feu. |
Quota d'IP statique : sur les projets plafonnés sur le quota d'IP statique
globale externe, lorsque le seul consommateur est intra-cluster (Plausible dans
le même cluster GKE), définissez service_type = "ClusterIP", reserve_static_ip = false, et
enable_custom_domain = false — cela évite de consommer une IP externe statique globale
pour une base de données que rien en dehors du cluster n'appelle.
Groupe 20 — Identity-Aware Proxy (IAP)
IAP n'est pas recommandé pour ClickHouse — les consommateurs sont des
services, pas des navigateurs. Utilisez plutôt des contrôles au niveau du réseau.
Lorsque enable_iap = true, iap_oauth_client_id et iap_oauth_client_secret
sont tous deux requis (vérification au moment de la planification).
Groupe 21 — Cloud Armor
enable_cloud_armor = false, admin_ip_ranges = [],
cloud_armor_policy_name = "default-waf-policy", enable_cdn = false (non applicable).
Groupe 22 — VPC Service Controls et journalisation d'audit
enable_vpc_sc = false, vpc_cidr_ranges = [], vpc_sc_dry_run = true,
organization_id = "", enable_audit_logging = false.
5. Sorties
Ces valeurs sont renvoyées lors d'un déploiement réussi et constituent le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
clickhouse_endpoint | Point d'accès HTTP externe : http://<external-ip>:8123. À transmettre à Plausible en tant que clickhouse_url. Renvoie null tant que l'adresse IP externe n'est pas attribuée. |
clickhouse_internal_endpoint | Point d'accès intra-cluster : http://<svc>.<ns>.svc.cluster.local:8123 — préférable lorsque Plausible_GKE s'exécute dans le même cluster. |
clickhouse_database | Base de données amorcée par l'image au premier démarrage. |
clickhouse_username | Nom d'utilisateur ClickHouse amorcé au premier démarrage. |
clickhouse_password_secret_id | ID du secret Secret Manager contenant le mot de passe de l'utilisateur. Les modules consommateurs le transmettent en tant que Plausible_GKE's clickhouse_password_secret. |
service_name / namespace | Nom / espace de noms du service Kubernetes. |
service_cluster_ip / service_external_ip / api_url | IP intra-cluster, IP du LoadBalancer et URL. |
stage_service_cluster_ips | Carte des ClusterIPs pour les services spécifiques à l'étape (Cloud Deploy). |
statefulset_name | Nom de la ressource StatefulSet. |
storage_buckets | Buckets Cloud Storage créés (vides — aucun n'est provisionné). |
network_name / network_exists / regions | Réseau VPC, présence, régions disponibles. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels | État et canaux de surveillance. |
initialization_jobs | Noms des jobs de configuration (aucun par défaut). |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / cicd_configuration | État et détails CI/CD. |
github_repository_url / github_repository_owner / github_repository_name | Détails du dépôt GitHub connecté. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Registre et déclencheur de build. |
kubernetes_ready | true lorsque le point d'accès du cluster est disponible et que toutes les ressources de charge de travail sont déployées ; false lors du premier apply d'un nouveau cluster intégré — relancez l'apply pour terminer. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | Journalisation d'audit et état CMEK. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Risque | Piège | Conséquence | Évitement |
|---|---|---|---|
| Critique | Définir application_version à une version de ClickHouse non testée | Plausible CE épingle la version de ClickHouse ; une balise plus récente arbitraire l'a cassée en amont (plausible/analytics#3855) — les migrations ou les requêtes échouent et l'ingestion d'analyses s'arrête. "latest" est maintenant rejeté au moment de la planification. | Conservez l'épingle 24.12-alpine par défaut. Ne définissez une version explicite que si elle est validée par rapport à votre version de Plausible ; traitez une mise à jour comme un changement testé. |
| Critique | Suppression du PVC, ou définition de stateful_pvc_enabled = false | Chaque événement d'analyse jamais enregistré est détruit (ou, sans PVC, perdu silencieusement à chaque redémarrage de pod/éviction de nœud). Le PostgreSQL de Plausible conserve les comptes, mais l'historique des événements est irrécupérable. | Conservez le stateful_pvc_enabled = true par défaut (StatefulSet) — le piège du disque éphémère est fermé par défaut. Ne supprimez jamais le PVC en dehors d'un démantèlement intentionnel ; sauvegardez d'abord avec BACKUP natif de ClickHouse. |
| Critique | Définir max_instance_count > 1 | Les réplicas simples ne sont PAS un cluster — chaque pod aurait un répertoire de données isolé ; les écritures et les lectures divergent. Bloqué au moment de la planification : le multi-nœud nécessite Keeper/réplication que ce module ne fournit pas. | Laissez min = max = 1. Pour une véritable haute disponibilité, utilisez un déploiement ClickHouse configuré avec Keeper en dehors de ce module. |
| Élevé | Exposer 8123 sur un LoadBalancer public sans contrôles réseau | L'authentification par mot de passe est toujours activée, mais l'interface HTTP reste accessible via Internet — la force brute, la reconnaissance /ping et toute future mauvaise configuration d'authentification deviennent exploitables de l'extérieur. | Préférez service_type = "ClusterIP" (utilisez clickhouse_internal_endpoint) lorsque les consommateurs partagent le cluster ; sinon, restreignez avec enable_network_segmentation, les règles de pare-feu et admin_ip_ranges. |
| Élevé | Faire confiance à la sonde TCP comme preuve de santé | La sonde TCP passe dès que le port écoute — une mauvaise configuration d'authentification ou un répertoire de données vide/étranger affiche toujours un pod "sain" alors que toutes les requêtes Plausible échouent. | Après le déploiement, vérifiez explicitement : curl http://$CH_IP:8123/ping, puis un SELECT version() authentifié avec le mot de passe Secret Manager. |
| Élevé | Modifier clickhouse_db/clickhouse_user (ou s'attendre à ce qu'un nouveau mot de passe s'applique) après le premier démarrage | L'image amorce les identifiants uniquement au premier démarrage d'un répertoire de données vide — les modifications post-amorçage ne font rien silencieusement ; les consommateurs s'authentifient alors avec des valeurs que le serveur n'a jamais apprises. | Définissez-les une fois avant le premier déploiement (la vérification au moment de la planification rejette les valeurs vides). Après l'amorçage, gérez les utilisateurs/bases de données via SQL (CLICKHOUSE_DEFAULT_ACCESS_MANAGEMENT=1). |
| Moyen | Déclarer le premier déploiement échoué avant la fin d'Autopilot | Un nouveau cluster Autopilot nécessite le provisionnement des nœuds + l'attachement du PVC + le pull de l'image — jusqu'à ~10 minutes avant d'être prêt. Une intervention manuelle en cours de déploiement (suppression de pods, ré-application) bloque le StatefulSet. | Attendez la fin de la fenêtre de la sonde de démarrage (60 × 10 s + 30 s de délai ; deployment_timeout = 1800). Surveillez kubectl get pods -w et les événements au lieu de redémarrer. |
| Moyen | Sous-dimensionner memory_limit en dessous de ~2Gio | Les fusions et la mémoire de requête de ClickHouse dépassent les petites limites ; le pod est tué par OOM lors de l'ingestion ou des requêtes de tableau de bord. | Conservez la valeur par défaut de 4Gio (le plancher pratique de ClickHouse) ; 2Gio uniquement pour les sites Plausible à très faible trafic. |
| Moyen | quota_memory_requests / quota_memory_limits sans suffixes binaires | Les entiers bruts sont traités comme des octets par Kubernetes et bloquent TOUTE la planification des pods dans l'espace de noms. | Utilisez toujours des valeurs de style "4Gi" / "8192Mi" (validation au moment de la planification dans App_GKE). |
| Faible | Désactiver enable_image_mirroring | Les pulls proviennent directement de Docker Hub ; les limites de débit peuvent occasionnellement faire échouer les déploiements et les re-pulls imagePullPolicy. | Maintenez la mise en miroir activée ; les boutons de rétention (max_images_to_retain, image_retention_days) gèrent la croissance du dépôt. |
Pour le comportement de base référencé partout — IAM et Workload Identity, autoscaling, ingress et certificats, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir d'images — voir App_GKE.
Guides associés
- Lab pratique : ClickHouse sur GKE Autopilot — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Déployé aux côtés de Kestra sur GKE Autopilot, Apache Superset sur GKE Autopilot, Metabase sur GKE Autopilot dans la solution Analytics Warehouse.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.