VictoriaMetrics sur GKE Autopilot
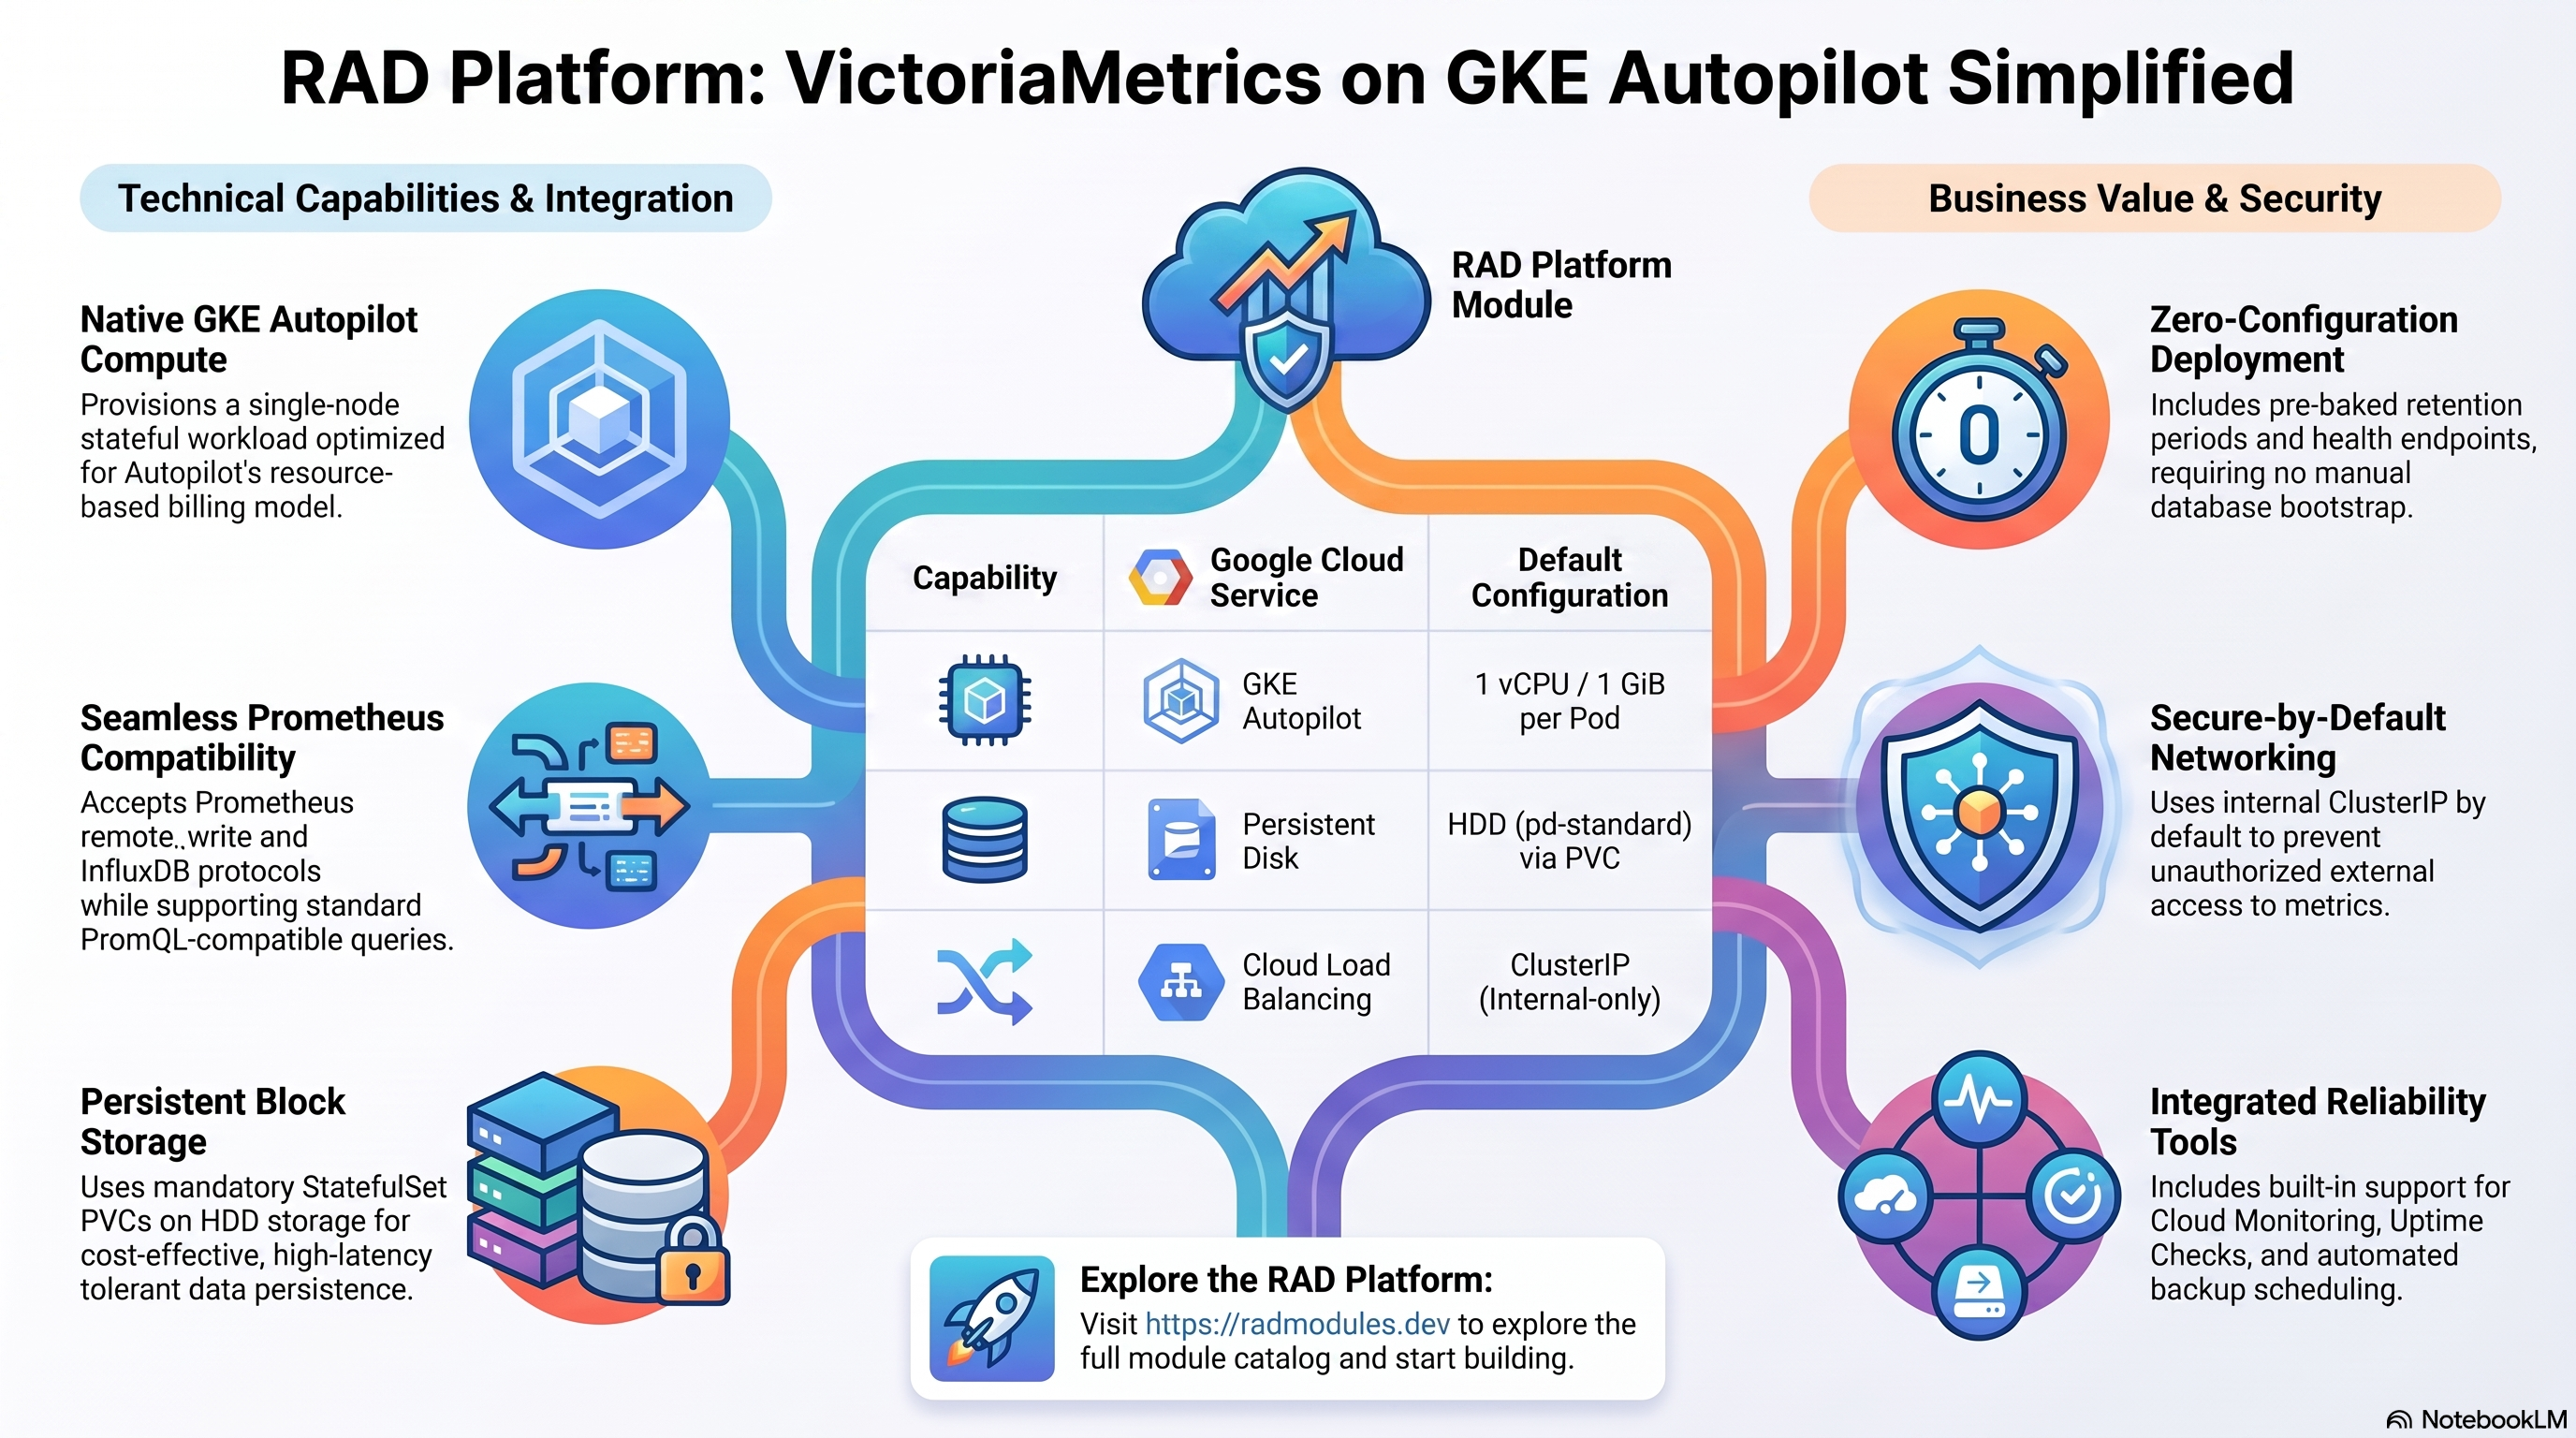
VictoriaMetrics est une base de données de séries temporelles rapide,
économique et compatible avec Prometheus — le backend de stockage de métriques
auto-hébergé standard à associer au module Grafana de ce catalogue. Elle
accepte l'ingestion Prometheus remote_write, le protocole de ligne InfluxDB,
Graphite et OpenTSDB via HTTP simple, et répond aux requêtes compatibles
PromQL. Ce module déploie VictoriaMetrics sur GKE Autopilot au-dessus de
la fondation App_GKE, qui provisionne et gère
l'infrastructure partagée Google Cloud et Kubernetes.
Il n'existe pas de variante Cloud Run de ce module — voir le §1 ci-dessous pour en comprendre la raison.
Ce guide se concentre sur les services cloud utilisés par VictoriaMetrics et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à toutes les applications GKE — Workload Identity, ingress, autoscaling, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et le cycle de vie du déploiement — reportez-vous au guide de la fondation App_GKE plutôt que de les répéter ici.
Ce que coûte VictoriaMetrics sur RAD, et comparaison
L'exécution de VictoriaMetrics sur GKE Autopilot dans votre propre projet Google Cloud coûte environ 42,08 $ US/mois en frais Google Cloud (environ 115,08 $ US si ce n'est pas votre seul cluster Autopilot), en plus d'un frais de module RAD unique de 75 crédits (7,50 $ US) facturé une seule fois au moment du déploiement. Il n'existe pas de variante Cloud Run de ce module. Dans un projet géré par RAD, les frais de module passent à 67,5 crédits (10 % de moins) et le coût d'exécution est mesuré à l'heure en crédits — voir Mettre en pause gratuitement ci-dessous.
Ce que vous payez sur RAD
| Votre propre projet | Projet géré par RAD | |
|---|---|---|
| Frais de module (unique) | 75 crédits | 67,5 crédits (10 % de moins) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients font exception : ils sont toujours facturés à la minute pour le temps de build | Identique |
| Coût d'exécution Google Cloud | 42,08 $ US/mois, facturé par Google au prix catalogue | ~60 crédits/jour (environ 1 800/mois, 180 $ US au prix de la recharge), mesuré au prix catalogue majoré de la marge de RAD |
Pourquoi les deux colonnes diffèrent. Le chiffre pour les projets gérés par RAD inclut les frais de gestion du cluster GKE (environ 73 $ US par mois) et la fondation partagée du projet. Dans votre propre projet, le niveau gratuit de Google couvre les frais de gestion d'un cluster par compte de facturation, ce que le chiffre pour votre propre projet suppose. Il est estimé à partir des prix catalogue de Google, car il n'y a pas encore suffisamment d'historique GKE géré par RAD pour le mesurer, de sorte que la confirmation de déploiement ne le mentionne pas. Une deuxième application GKE dans le même projet géré par RAD partage le cluster et n'ajoute que ses propres pods.
Votre premier déploiement réussi sur RAD est exempt de frais de module, quel que soit le montant des frais : une fois par compte, pour un module que vous déployez et payez vous-même (dans une solution, les frais d'une application : la première à réussir ; jamais une session de lab ou un projet client).
10 crédits coûtent 1 $ US pour une recharge unique, et moins avec un plan mensuel.
Coût d'exécution par défaut dans votre propre projet
| Ressource (valeur par défaut du module) | Par mois |
|---|---|
| Pod GKE Autopilot, 1 vCPU / 1 Gio | 36,08 $ US |
| Cloud NAT et réseau | 5 $ US |
| Cloud Storage (modules complémentaires, sauvegardes) | 1 $ US |
| Total | 42,08 $ US |
Les frais de gestion du cluster GKE sont exclus du total ci-dessus car ils sont partagés entre toutes les applications GKE du projet — 0 $ si c'est la seule, sinon environ 73 $/mois répartis entre le nombre d'applications que vous exécutez.
Comparaison
- Les créateurs du projet vendent VictoriaMetrics Cloud, à partir de 200 $/mois pour une instance gérée (500 000 séries temporelles actives) — vérifié sur la page de tarification de VictoriaMetrics, le 8 octobre 2026. Le coût d'exécution de RAD pour votre propre projet ici (environ 42 $/mois) représente environ un cinquième de ce prix de départ, bien que VictoriaMetrics Cloud inclue un stockage élastique et des limites d'ingestion que ce pod de taille fixe n'essaie pas d'égaler.
- Une comparaison avec un VPS autogéré, dimensionné selon la valeur par défaut de VictoriaMetrics de 1 vCPU / 1 Gio : un Hetzner CPX11 ou un DigitalOcean 1 vCPU/2 Go Droplet coûte environ 6 à 12 $/mois, moins cher en termes de trésorerie que les deux options RAD ici — plus votre propre temps pour les sauvegardes et les correctifs, et aucun plan de contrôle Kubernetes à exécuter.
- VictoriaMetrics est presque toujours associé à Grafana comme backend de métriques ; le coût d'exécution de ce module est délibérément minimal (pas de NFS, pas de base de données gérée — VictoriaMetrics gère son propre stockage sur disque) de sorte que le coût total de la paire est dominé par celui des deux qui nécessite le plus de calcul.
Mettre en pause gratuitement : supprimer un projet géré par RAD, le restaurer quand vous en avez besoin
C'est l'avantage principal d'un projet géré par RAD, et cela ne coûte rien pendant la pause. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer purement et simplement le projet — la suppression logicielle récupérable de 30 jours de Google. Contrairement à la suppression d'un seul module, cela ne démolit pas Cloud SQL, aucune VM, ou la ressource de calcul une par une : l'ensemble du projet s'arrête simplement, et rien n'est facturé pendant qu'il attend, car la facturation est déjà déliée.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, seront utilisables après sa restauration, de sorte que la restauration ne peut pas être considérée comme un moyen de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
La restauration, dans les 30 jours et uniquement par le propriétaire du projet, demande à Google de récupérer le projet et de rattacher son compte de facturation, puis vous demande d'exécuter la mise à jour sur chaque déploiement pour confirmer que tout est revenu. Comme rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes — c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit.
Ce qu'il faut pour cela : vous devez être propriétaire du projet (pas un projet pour lequel RAD ne gère que la facturation), vous devez le restaurer vous-même dans les 30 jours — après quoi Google le supprime définitivement — et la restauration est admise comme la création d'un nouveau projet, de sorte que votre solde de crédits achetés doit toujours dépasser le seuil du niveau (100 crédits pour le niveau sandbox qui convient à la plupart des utilisations d'étude/démo). Google indique que la plupart des services sont à nouveau pleinement opérationnels dans les 36 heures suivant une restauration.
Un véritable manque : les sauvegardes nocturnes sont écrites dans un bucket à l'intérieur du projet, et ce bucket a la suppression logicielle de Cloud Storage explicitement désactivée, il est donc très probable qu'il disparaisse dès que vous supprimez le projet — même si le projet lui-même est récupérable pendant 30 jours. Si vous avez personnalisé VictoriaMetrics et que vous souhaitez conserver ce travail, copiez une sauvegarde (vers Google Drive ou un bucket en dehors du projet) avant de supprimer. Pour une installation par défaut sans rien d'irremplaçable, cela n'a pas d'importance.
Payer uniquement pendant l'utilisation, l'autre méthode : supprimer et redéployer
Dans votre propre projet, ou une fois que 30 jours se sont écoulés sur un projet géré par RAD, il n'y a pas de pause gratuite — la suppression supprime les ressources définitivement, et la remise en service de VictoriaMetrics signifie un redéploiement à partir de zéro. Cela coûte environ 78-81 crédits dans votre propre projet, ou environ 70,5-73,5 crédits dans un projet géré par RAD.
La suppression ne permet d'économiser de l'argent que si VictoriaMetrics reste inutilisé suffisamment longtemps pour compenser le coût de redéploiement par rapport à son propre coût d'exécution — environ 6 jours ou plus dans votre propre projet (environ 1,40 $ US par jour), ou environ 2 jours ou plus dans un projet géré par RAD (60 crédits par jour).
Conservez d'abord les données : les sauvegardes nocturnes vont dans un bucket à l'intérieur du déploiement et sont supprimées avec lui, alors copiez la dernière sauvegarde avant de supprimer si vous voulez la conserver.
Sessions de lab et environnements gérés
Sessions de lab, pour la formation : un formateur anime une session pour une classe. Chaque participant obtient l'application dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite d'une allocation définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés sont reversés au formateur.
Environnements gérés, pour les sociétés de conseil : un partenaire exécute l'application pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille est faible, la facturation est suspendue et les données sont conservées, afin que personne ne reçoive de frais inattendus. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue de l'API Google Cloud Billing Catalog ; radmodules.dev/pricing pour les propres frais de RAD et les estimations de crédits quotidiens ; documentation de Google sur la suppression/restauration de projets pour les affirmations de pause/restauration ; tarification de VictoriaMetrics Cloud.
1. Vue d'ensemble
VictoriaMetrics s'exécute en tant que charge de travail de base de données de séries temporelles à nœud unique et avec état sur Autopilot. Le déploiement relie un ensemble ciblé de services Google Cloud :
| Capacité | Service Google Cloud | Notes |
|---|---|---|
| Calcul | GKE Autopilot | Pod VictoriaMetrics unique, 1 vCPU / 1 Gio par défaut |
| Stockage persistant | Persistent Disk via StatefulSet PVC | Requis — monté à /victoria-metrics-data ; classe de stockage standard (HDD pd-standard) par défaut |
| Secrets | aucun | VictoriaMetrics n'a pas d'authentification intégrée — aucun secret Secret Manager n'est créé |
| Ingress | Cloud Load Balancing | ClusterIP par défaut (interne uniquement, par conception — voir ci-dessous) ; LoadBalancer ou domaine personnalisé lorsque le scraping/l'interrogation externe est réellement nécessaire |
Pourquoi GKE uniquement : VictoriaMetrics stocke ses données de séries
temporelles sous forme de fichiers locaux mmap'és sur disque (confirmé via la
FAQ officielle : "VictoriaMetrics stores data in block storage..."). Ceci
est incompatible avec le système de fichiers éphémère par révision de Cloud
Run et avec la sémantique de verrouillage de fichiers/mmap de GCS FUSE — la
même classe de contraintes déjà documentée pour ClickHouse, Elasticsearch et
MongoDB dans ce catalogue. VictoriaMetrics_GKE nécessite donc un
PersistentVolumeClaim de bloc réel (stateful_pvc_enabled = true par défaut) et n'a pas
d'équivalent Cloud Run.
Valeurs par défaut judicieuses à connaître d'emblée :
- Pas de base de données SQL, pas de Redis. VictoriaMetrics gère sa propre
TSDB embarquée. Aucune instance Cloud SQL n'est créée ;
enable_redisest codé en dur àfalse. - Instance unique par défaut, et ce n'est pas un bouton "mettre à l'échelle
plus tard".
max_instance_count = 1— VictoriaMetrics à nœud unique n'a pas de clustering ou de réplication intégrés. Deux pods écrivant sur le même PVC corrompraient les données. - Le PVC StatefulSet est requis, non facultatif. Contrairement à
certaines applications avec état de ce catalogue où il existe un
mécanisme de secours GCS FUSE, VictoriaMetrics n'a pas de mécanisme de
secours — ses fichiers de données mmap'és ne sont pas compatibles FUSE,
même en mode dégradé.
stateful_pvc_enabled = trueest la valeur par défaut et devrait le rester. ClusterIPpar défaut — c'est correct, pas un bug. VictoriaMetrics est destiné à être scrappé et interrogé en interne par des clients compatibles Prometheus (un expéditeurremote_write,vmagentou Grafana) exécutés dans le même cluster, et non exposé comme une application web publique. C'est le même modèle confirmé-correct déjà documenté pour Qdrant et PhpMyAdmin dans ce catalogue — ne le "corrigez" pas enLoadBalanceren supposant qu'il s'agit du bug de copier-coller ClusterIP à l'échelle de la flotte trouvé ailleurs ; ce n'est véritablement pas le cas ici.- Classe de stockage HDD par défaut.
stateful_pvc_storage_class = "standard"(pd-standard), et non lestandard-rwobasé sur SSD par défaut de nombreux autres modules avec état — VictoriaMetrics est documenté comme tolérant un stockage à latence élevée et à faible IOPS, ce qui évite de puiser dans le quota strictSSD_TOTAL_GB. - Configuration par drapeaux CLI, pas par variables d'environnement.
VictoriaMetrics n'a pas de configuration basée sur des variables
d'environnement. Le
ENTRYPOINTde l'image personnalisée épingle-storageDataPath,-httpListenAddret-retentionPerioddirectement — voir §4. - Un seul point d'accès
/healthsert à la fois la sonde de démarrage et la sonde de vivacité — il n'y a pas de distinction distincte entre la disponibilité et la vivacité.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que vous avez exécuté
gcloud container clusters get-credentials <cluster> --region <region> --project <project>
et que PROJECT, REGION et NAMESPACE sont définis. L'espace de noms et les autres
identifiants sont rapportés dans les Sorties du déploiement.
A. GKE Autopilot — la charge de travail VictoriaMetrics
Le pod VictoriaMetrics s'exécute sur Autopilot, qui facture le CPU/la mémoire
que le pod demande réellement. max_instance_count = 1 maintient un seul pod en
exécution — la mise à l'échelle horizontale n'est
intentionnellement pas prise en charge pour ce déploiement à nœud unique.
- Console : Kubernetes Engine → Charges de travail → sélectionnez la
charge de travail VictoriaMetrics pour les pods, les événements et
l'utilisation des ressources. Kubernetes Engine → Services et Ingress
affiche le ClusterIP (ou l'adresse IP externe si
LoadBalancerest utilisé). - CLI :
kubectl get pods,svc -n "$NAMESPACE"
kubectl logs -n "$NAMESPACE" statefulset/<service-name> --tail=100
kubectl describe pod -n "$NAMESPACE" -l app=<service-name>
Voir App_GKE pour la gestion d'Autopilot et du type de charge de travail (StatefulSet).
B. Stockage persistant — PVC StatefulSet (le seul backend pris en charge)
VictoriaMetrics persiste ses fichiers de données de séries temporelles à
/victoria-metrics-data. Contrairement à plusieurs autres applications avec état de ce
catalogue, il n'y a pas de mécanisme de secours GCS FUSE — un
PersistentVolumeClaim de bloc réel est requis. La classe de stockage est
standard (HDD pd-standard) par défaut.
- Console : Kubernetes Engine → Stockage → PersistentVolumeClaims. Compute Engine → Disques pour voir le Persistent Disk sous-jacent.
- CLI :
# PVC status
kubectl get pvc -n "$NAMESPACE"
kubectl describe pvc -n "$NAMESPACE"

# Confirm the mount and inspect on-disk data files inside the pod
kubectl exec -n "$NAMESPACE" <pod-name> -- ls -la /victoria-metrics-data
Voir App_GKE pour les mécanismes du PVC StatefulSet et les options de classe de stockage en général.
C. Pas de secrets Secret Manager
VictoriaMetrics n'a pas d'authentification intégrée, donc VictoriaMetrics_Common
ne génère et ne stocke aucun secret. L'accès est entièrement géré au niveau
du réseau — la valeur par défaut ClusterIP, ou IAP / Cloud Armor si le
service est délibérément rendu accessible de l'extérieur. Il n'y a rien à
récupérer de Secret Manager pour ce module.
D. Réseau et ingress
Par défaut, la charge de travail est exposée uniquement à l'intérieur du
cluster via un service ClusterIP — le modèle d'accès prévu est Grafana,
vmagent, ou un expéditeur Prometheus remote_write exécuté dans le
même cluster. Ne changez service_type en LoadBalancer que si vous avez
un besoin réel de scraper ou d'interroger depuis l'extérieur du cluster (et
ajoutez d'abord vos propres contrôles d'accès — VictoriaMetrics lui-même
n'en impose aucun).
- Console : Kubernetes Engine → Services et Ingress ; réseau VPC → Adresses IP (lorsqu'une adresse IP statique est réservée).
- CLI :
kubectl get svc -n "$NAMESPACE"
gcloud compute addresses list --project "$PROJECT"
Voir App_GKE pour les domaines personnalisés, Cloud CDN et les détails de l'adresse IP statique.
E. Cloud Logging et Monitoring
Les sorties stdout/stderr des pods sont acheminées vers Cloud Logging ; les
métriques GKE sont acheminées vers Cloud Monitoring. Des tests de
disponibilité (contre /health) et des politiques d'alerte
facultatifs sont disponibles, mais n'ont de sens que si le service est
accessible depuis l'endroit où le test est lancé.
- Console : Logging → Explorateur de journaux ; Monitoring → Tableaux de bord / Alertes.
- CLI :
gcloud logging read 'resource.type="k8s_container" AND resource.labels.namespace_name="'"$NAMESPACE"'"' \
  --project "$PROJECT" --limit 50
3. Comportement de l'application VictoriaMetrics
- Pas de bootstrap de base de données, pas de jobs d'initialisation. VictoriaMetrics gère sa propre TSDB embarquée. C'est un binaire autonome sans concept de schéma ou de migration — aucun job d'initialisation n'est injecté par défaut, et aucun n'est nécessaire. La charge de travail commence à servir dès que son répertoire de données est monté.
- Point d'accès de santé. Un seul point d'accès
/healthnon authentifié (renvoieOK) sert à la fois les sondes de démarrage et de vivacité — il n'y a pas de distinction séparée entre la disponibilité et la vivacité, contrairement aux applications avec une séquence de démarrage plus lourde. - Comment les métriques entrent. VictoriaMetrics accepte plusieurs
protocoles d'ingestion via HTTP simple sur le port
8428:- Prometheus
remote_write→POST /api/v1/write - Protocole de ligne InfluxDB →
/write - Protocole Graphite en texte brut / pickle
- OpenTSDB
/api/putet telnet put - Son propre agent piloté par la configuration de scraping,
vmagent, peut également être déployé en tant que sidecar (viaadditional_services) pour extraire des métriques des points d'accès Prometheus/metrics, reproduisant ce qu'un serveur Prometheus autonome ferait.
- Prometheus
- Comment l'interroger. VictoriaMetrics expose une API de requête
compatible PromQL (
/api/v1/query,/api/v1/query_range,/api/v1/series, ...) — la même interface que l'API HTTP de Prometheus. Pointez Grafana vers elle en utilisant le type de source de données Prometheus avec l'URL définie sur le nom DNS interne du service VictoriaMetrics (ou l'URL externe, si exposée), aucun plugin n'est requis. - La rétention est intégrée à l'image, non configurable à l'exécution.
-retentionPeriod=12(12 mois) est compilé dans leENTRYPOINTde l'image personnalisée (voir §4). Il n'est pas exposé en tant que variable Terraform — le modifier nécessite d'éditerVictoriaMetrics_Common/scripts/Dockerfileet de forcer une reconstruction. - Pas de clustering. Ce module déploie VictoriaMetrics en mode
nœud unique. VictoriaMetrics a également une édition "cluster"
(
vminsert/vmstorage/vmselect) pour la mise à l'échelle horizontale, mais il s'agit d'une topologie de déploiement entièrement différente et ce n'est pas ce que ce module provisionne.
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres spécifiques ou notables pour VictoriaMetrics sont listés ; toutes les autres entrées sont héritées de App_GKE avec leur comportement et leurs valeurs par défaut standards.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (requis) | Projet Google Cloud cible. |
region | us-central1 | Région pour la charge de travail et les ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Court suffixe qui rend les noms de ressources uniques par environnement. |
support_users | [] | Adresses e-mail ayant accès au projet et aux alertes de surveillance. |
resource_labels | {} | Étiquettes appliquées à toutes les ressources pour le suivi des coûts/de la propriété. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | victoriametrics | Nom de base des ressources. Ne pas modifier après le premier déploiement. |
application_display_name | VictoriaMetrics | Nom convivial affiché dans la console. |
application_version | latest | Tag de l'image VictoriaMetrics. latest correspond à une version épinglée connue et stable (v1.148.0) comme argument de build du Dockerfile, car l'image amont n'a pas de tag flottant latest propre. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définir false pour provisionner uniquement l'infrastructure. |
cpu_limit | 1000m | CPU par pod. |
memory_limit | 1Gi | Mémoire par pod. ~1 Go de RAM par million de séries temporelles actives est la directive de mise à l'échelle amont ; maintenez l'utilisation de VictoriaMetrics à environ 50 % de la mémoire disponible pour la marge du cache de pages du système d'exploitation. |
min_instance_count | 1 | Réplicas minimum. Maintenir à 1 — un StatefulSet avec replicas=0 n'a rien à servir aux requêtes. |
max_instance_count | 1 | Réplicas maximum. Doit rester à 1 — pas de clustering/réplication en mode nœud unique. |
enable_vertical_pod_autoscaling | false | Laisser Autopilot ajuster automatiquement les requêtes de ressources (désactive le HPA CPU/Mémoire). |
enable_image_mirroring | true | Mettre en miroir l'image VictoriaMetrics dans Artifact Registry pour éviter les limites de débit de Docker Hub. |
timeout_seconds | 300 | Délai d'expiration de la requête en secondes (0–3600). |
termination_grace_period_seconds | 60 | Secondes pendant lesquelles Kubernetes attend après SIGTERM que VictoriaMetrics vide les écritures en cours sur le disque. |
Groupe 5 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Variables d'environnement supplémentaires. VictoriaMetrics ne lit pas les variables d'environnement pour la configuration — uniquement les drapeaux CLI intégrés à l'image (§4 ci-dessus) ; les valeurs ici n'ont aucun effet sur le binaire en cours d'exécution, sauf s'il lit cette variable exacte, ce qu'il ne fait pas par défaut. |
secret_environment_variables | {} | Mappage de variable d'environnement → nom de secret Secret Manager. Non renseigné par défaut — VictoriaMetrics n'a pas d'authentification intégrée. |
secret_propagation_delay | 30 | Secondes à attendre après la création du secret avant de continuer. |
secret_rotation_period | 2592000s | Période de rappel de rotation de Secret Manager (30 jours par défaut). Non applicable sauf si vous ajoutez vos propres secrets. |
Groupe 6 — Backend et cluster GKE
| Variable | Valeur par défaut | Description |
|---|---|---|
gke_cluster_name | "" | Nom du cluster cible. Découvert automatiquement lorsqu'il est vide. |
gke_cluster_selection_mode | primary | Stratégie de sélection de cluster : explicit, round-robin ou primary. |
namespace_name | "" | Espace de noms Kubernetes. Généré automatiquement lorsqu'il est vide. |
workload_type | null | Se résout automatiquement en StatefulSet lorsque stateful_pvc_enabled = true (la valeur par défaut). |
service_type | ClusterIP | Comment le service est exposé. ClusterIP est correct et intentionnel ici — voir §1. |
session_affinity | None | None ou ClientIP. |
enable_network_segmentation | false | Créer des ressources Kubernetes NetworkPolicy pour la micro-segmentation. |
configure_service_mesh | false | Activer l'injection Istio pour l'espace de noms de l'application. |
Groupe 7 — Configuration du StatefulSet
| Variable | Valeur par défaut | Description |
|---|---|---|
stateful_pvc_enabled | true | Requis — les fichiers de données sur disque local mmap'és de VictoriaMetrics ne sont pas compatibles GCS FUSE, même en cas de repli. Doit rester true. |
stateful_pvc_size | 20Gi | Taille du PVC par pod. Taille pour contenir la fenêtre de rétention complète (12 mois par défaut) plus les frais de fusion — ~20 % d'espace libre recommandé. |
stateful_pvc_mount_path | /victoria-metrics-data | Chemin du conteneur pour le PVC. Doit correspondre au drapeau -storageDataPath intégré à l'image. |
stateful_pvc_storage_class | standard | HDD pd-standard par défaut — VictoriaMetrics est documenté comme tolérant aux IOPS, évitant le quota strict SSD_TOTAL_GB. |
stateful_headless_service | null | Créer un service sans tête pour des identités réseau stables. |
stateful_pod_management_policy | null | OrderedReady assure des redémarrages séquentiels sûrs. |
stateful_update_strategy | null | RollingUpdate pour des mises à jour sans interruption. |
stateful_fs_group | 3000 | GID du groupe de fichiers défini dans le contexte de sécurité du pod. VictoriaMetrics s'exécute en tant que UID 1000/GID 2000 ; 3000 garantit que le PVC est inscriptible par le groupe. |
Groupe 8 — Quota de ressources
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_resource_quota | false | Limiter le nombre de CPU/mémoire/objets de l'espace de noms. |
quota_memory_requests / quota_memory_limits | "" | Doit utiliser des unités binaires (4Gi, 8192Mi) — les entiers bruts sont lus comme des octets et bloquent la planification. |
Groupe 9 — Politiques de fiabilité
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_pod_disruption_budget | true | Protéger la disponibilité pendant les mises à niveau de nœuds. Avec max_instance_count = 1, un pod ne peut pas être expulsé tout en satisfaisant pdb_min_available = 1 — tenez-en compte dans la planification des mises à niveau de nœuds. |
pdb_min_available | 1 | Nombre minimum de pods disponibles pendant les perturbations volontaires. |
enable_topology_spread | false | Non significatif avec un seul réplica. |
Groupe 10 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe | /health, délai de 15s | Sonde HTTP. |
liveness_probe | /health, délai de 30s | Sonde HTTP. Même point d'accès que le démarrage — VictoriaMetrics n'a pas de distinction séparée entre la disponibilité et la vivacité. |
uptime_check_config | disabled | Test de disponibilité Cloud Monitoring facultatif contre /health. Utile uniquement si le service est accessible depuis l'endroit où le test est lancé. |
alert_policies | [] | Politiques d'alerte métrique facultatives. |
Groupe 11 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | VictoriaMetrics ne nécessite pas de job d'initialisation par défaut — il est autonome sans concept de schéma/migration. |
cron_jobs | [] | CronJobs Kubernetes pour la maintenance périodique, par exemple une exportation de snapshot vmbackup scriptée. |
additional_services | [] | Sidecar ou services d'aide déployés à côté de VictoriaMetrics — par exemple un sidecar de transfert de scraping vmagent. |
Groupe 12 — CI/CD et intégration GitHub
Intégration standard Cloud Build / Cloud Deploy d'App_GKE — voir
App_GKE. Entrées clés : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy,
enable_binary_authorization.
Groupe 13 — NFS
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_nfs | false | VictoriaMetrics utilise un PVC de bloc pour le stockage — n'activez NFS que pour les jobs personnalisés qui nécessitent un système de fichiers partagé. |
nfs_mount_path | /mnt/nfs | Chemin de montage à l'intérieur du conteneur. |
network_tags | ["nfsserver"] | Tags réseau de nœud/pod GKE ; nfsserver est requis lorsque NFS est activé. |
Groupe 14 — Cloud Storage et Artifact Registry
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Provisionner les buckets GCS définis dans storage_buckets. VictoriaMetrics lui-même ne déclare aucun bucket par défaut — son intégration GCS/S3 est uniquement pour la sauvegarde, jamais pour le stockage de requêtes en direct. |
storage_buckets / gcs_volumes | [] | Buckets supplémentaires / montages GCS FUSE, sans rapport avec le stockage principal. |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options CMEK. |
max_images_to_retain | 7 | Nombre maximal d'images de conteneurs récentes à conserver dans Artifact Registry (pour l'image personnalisée). |
Groupe 17 — Sauvegarde et maintenance
| Variable | Valeur par défaut | Description |
|---|---|---|
backup_schedule | 0 2 * * * | Cron de sauvegarde automatisée (UTC). Aucun mécanisme de sauvegarde par défaut n'est câblé pour VictoriaMetrics au-delà du hook de planification générique de la Fondation — utilisez cron_jobs avec vmbackup pour des sauvegardes de snapshots conscientes de l'application. |
backup_retention_days | 7 | Rétention. |
enable_backup_import / backup_source / backup_uri / backup_format | options de restauration | Restaurer à partir d'une sauvegarde lors du déploiement. |
Groupe 19 — Domaine personnalisé, IP statique et réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_custom_domain | true | Provisionner l'API Kubernetes Gateway avec des certificats SSL. N'a de sens que lorsque le service est délibérément rendu accessible de l'extérieur — service_type reste ClusterIP par défaut. |
application_domains | [] | Noms d'hôtes à servir. |
reserve_static_ip | true | Réserver une adresse IP externe stable. |
Groupe 20 — Proxy conscient de l'identité (IAP)
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_iap | false | Exiger la connexion Google via Kubernetes Gateway. Nécessite enable_custom_domain. Recommandé par rapport à un LoadBalancer nu si VictoriaMetrics est exposé en dehors du cluster, car il n'a pas d'authentification propre. |
iap_authorized_users / iap_authorized_groups | [] | Qui peut accéder. |
iap_oauth_client_id / iap_oauth_client_secret | "" | Requis lorsque l'IAP est activé (sensible). |
Groupe 21 — Cloud Armor
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_cloud_armor | false | Attacher une politique Cloud Armor (WAF) au backend Ingress GKE. |
admin_ip_ranges | [] | CIDR autorisés à un accès privilégié. |
enable_cdn | false | Activer Cloud CDN via GCPBackendPolicy. Non pertinent pour une API de métriques. |
Groupe 22 — Contrôles de service VPC et journalisation d'audit
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vpc_sc | false | Appliquer un périmètre VPC-SC (nécessite organization_id). |
vpc_cidr_ranges / vpc_sc_dry_run | (défini) | CIDR de niveau d'accès / mode simulation. |
enable_audit_logging | false | Journaux d'audit Cloud détaillés. |
5. Pas de base de données SQL, pas de Redis, pas de secrets
Trois choses que ce module ne provisionne délibérément pas, contrairement à la plupart des modules d'application de ce catalogue :
- Pas d'instance Cloud SQL.
database_type = "NONE"est fixé parVictoriaMetrics_Common. VictoriaMetrics est elle-même une base de données. - Pas de Redis.
enable_redisest codé en dur àfalsedansmain.tf, remplaçant la valeur par défautApp_GKEdetrue. - Pas de secrets Secret Manager. La sortie
VictoriaMetrics_Commondesecret_idsest toujours{}. Il n'y a pas de clé API, de mot de passe administrateur ou deCredential de quelque nature que ce soit à récupérer — le contrôle d'accès est entièrement au niveau du réseau (service_type, IAP, Cloud Armor).
6. Sorties
Ces valeurs sont renvoyées lors d'un déploiement réussi et constituent le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du service Kubernetes. |
namespace | Espace de noms dans lequel la charge de travail s'exécute. |
service_cluster_ip | ClusterIP intra-cluster. |
stage_service_cluster_ips | Mappage des ClusterIP pour les services spécifiques à l'étape (Cloud Deploy). |
service_external_ip | IP externe du LoadBalancer (lorsqu'une IP statique est réservée). |
service_url | URL pour atteindre l'API HTTP de VictoriaMetrics — DNS *.svc.cluster.local interne par défaut. |
statefulset_name | Nom du StatefulSet. |
storage_buckets | Buckets Cloud Storage créés — vide par défaut (VictoriaMetrics n'en déclare aucun). |
network_name / network_exists / regions | Réseau VPC, présence, régions disponibles. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels | État et canaux de surveillance. |
initialization_jobs | Noms des jobs de configuration personnalisés (vide par défaut). |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants de projet. |
cicd_enabled / cicd_configuration | État et détails CI/CD. |
github_repository_url / github_repository_owner / github_repository_name | Dépôt GitHub connecté. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Registre et déclencheur de build. |
kubernetes_ready | Indique si le cluster/la charge de travail est prêt. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | Journalisation d'audit et état CMEK. |
7. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
stateful_pvc_enabled | true (par défaut, requis) | Critique | Sans PVC, il n'y a aucun mode de stockage pris en charge pour ce module — les fichiers de données mmap'd de VictoriaMetrics ne sont pas compatibles avec GCS FUSE, même en solution de secours. Ne pas désactiver. |
stateful_pvc_mount_path | /victoria-metrics-data (par défaut) | Critique | Doit correspondre au flag -storageDataPath intégré à l'image personnalisée. Une non-concordance signifie que le PVC est monté à un endroit où le binaire n'écrit jamais, et toutes les données résident dans la couche éphémère du pod — perdues à chaque redémarrage. |
service_type | ClusterIP (par défaut) — ne pas "corriger" en LoadBalancer | Critique (si modifié sans précaution) | C'est la valeur par défaut confirmée pour cette application, et non le bug de copier-coller de ClusterIP à l'échelle de la flotte documenté ailleurs dans ce catalogue. VictoriaMetrics n'a aucune authentification intégrée — l'exposer via LoadBalancer sans IAP ou Cloud Armor rend toutes les métriques ingérées lisibles/écrivables/supprimables par quiconque peut atteindre l'IP. |
application_name | défini une fois | Critique | Immuable après le premier déploiement ; le modifier recrée l'espace de noms et le PVC, perdant tout l'historique des métriques ingérées. |
max_instance_count | 1 (fixe) | Critique | VictoriaMetrics à nœud unique n'a pas de clustering ou de réplication — un deuxième réplica écrivant sur le même PVC corrompt les fichiers de données. Il n'y a pas de moyen pris en charge pour faire évoluer ce module horizontalement ; utilisez l'édition cluster VictoriaMetrics séparée (ce que ce module ne déploie pas) si vous en avez besoin. |
-retentionPeriod (intégré à l'image) | 12 mois (par défaut) | Élevé | Pas une variable Terraform — la modification de la rétention nécessite de modifier VictoriaMetrics_Common/scripts/Dockerfile et de forcer une reconstruction de l'image. Les données plus anciennes que la fenêtre de rétention sont supprimées par VictoriaMetrics lui-même selon son propre calendrier ; il n'y a pas de suppression douce ou de corbeille. |
environment_variables | inerte pour la configuration de VictoriaMetrics | Moyen | VictoriaMetrics ne lit aucune variable d'environnement pour sa propre configuration — seulement les flags CLI intégrés à l'image. Ne vous attendez pas à ce qu'une variable d'environnement de style VICTORIA_METRICS_* modifie le comportement ; elle ne le fera pas, à moins que le binaire amont ne lise ce nom exact (ce n'est pas le cas par défaut). |
stateful_pvc_size | généreux (20 Gio+, à adapter à la rétention × taux d'ingestion) | Élevé | Un PVC sous-dimensionné se remplit à mesure que les données de la fenêtre de rétention s'accumulent ; un disque plein arrête l'ingestion/les fusions. La capacité du PVC ne peut pas être diminuée après la création, et l'augmenter nécessite un redimensionnement conscient du StatefulSet. |
stateful_pvc_storage_class | standard (HDD, par défaut) | Moyen | Ne peut pas être modifié après la création du PVC sans migration de données. Le HDD est la valeur par défaut sensée (VictoriaMetrics est tolérant aux IOPS) — le passage à standard-rwo/SSD n'est pertinent que pour une très forte concurrence de requêtes et puise dans le quota strict de SSD_TOTAL_GB. |
application_version | épingler à un tag spécifique pour la production | Moyen | latest correspond à une version épinglée fixe (v1.148.0) au moment de la build dans ce module — donc contrairement à d'autres applications, "latest" ici ne dérive pas silencieusement lors de la reconstruction. Néanmoins, épinglez explicitement si vous avez besoin d'une reproductibilité stricte entre les environnements. |
min_instance_count | 1 | Moyen | La mise à l'échelle à zéro ne laisse rien pour servir les requêtes ou accepter l'ingestion ; il n'y a pas de comportement de rechargement à froid sur lequel s'appuyer pour un backend de métriques dont d'autres systèmes dépendent pour être toujours actif. |
quota_memory_requests / _limits | unités binaires | Critique | Les entiers nus sont des octets et bloquent toute planification. |
enable_iap / enable_cloud_armor | activer si service_type est modifié de ClusterIP | Élevé | VictoriaMetrics n'applique aucun contrôle d'accès propre — tout ce qui peut atteindre le port peut lire et écrire toutes les données de métriques. |
pdb_min_available vs min_instance_count | être conscient de l'interaction | Moyen | 1/1 (les valeurs par défaut) signifie que le pod unique ne peut pas être évincé volontairement tout en satisfaisant le PDB — peut bloquer les mises à niveau de nœuds jusqu'à ce que Kubernetes revienne à d'autres stratégies d'éviction. |
Pour le comportement de base référencé partout — IAM et Workload Identity, autoscaling, ingress et certificats, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir d'images — voir App_GKE. La configuration d'application spécifique à VictoriaMetrics est décrite dans VictoriaMetrics_Common.
Guides associés
- Lab pratique : VictoriaMetrics sur GKE Autopilot — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- VictoriaMetrics Common — Configuration d'application partagée — la configuration partagée par les deux cibles de déploiement.
- Déployé avec Loki sur Google Cloud Run, Grafana sur Google Cloud Run, Uptime Kuma sur Google Cloud Run, GlitchTip sur Google Cloud Run dans la solution Observabilité et astreinte.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.