Module Paperless-ngx GKE — Guide de configuration
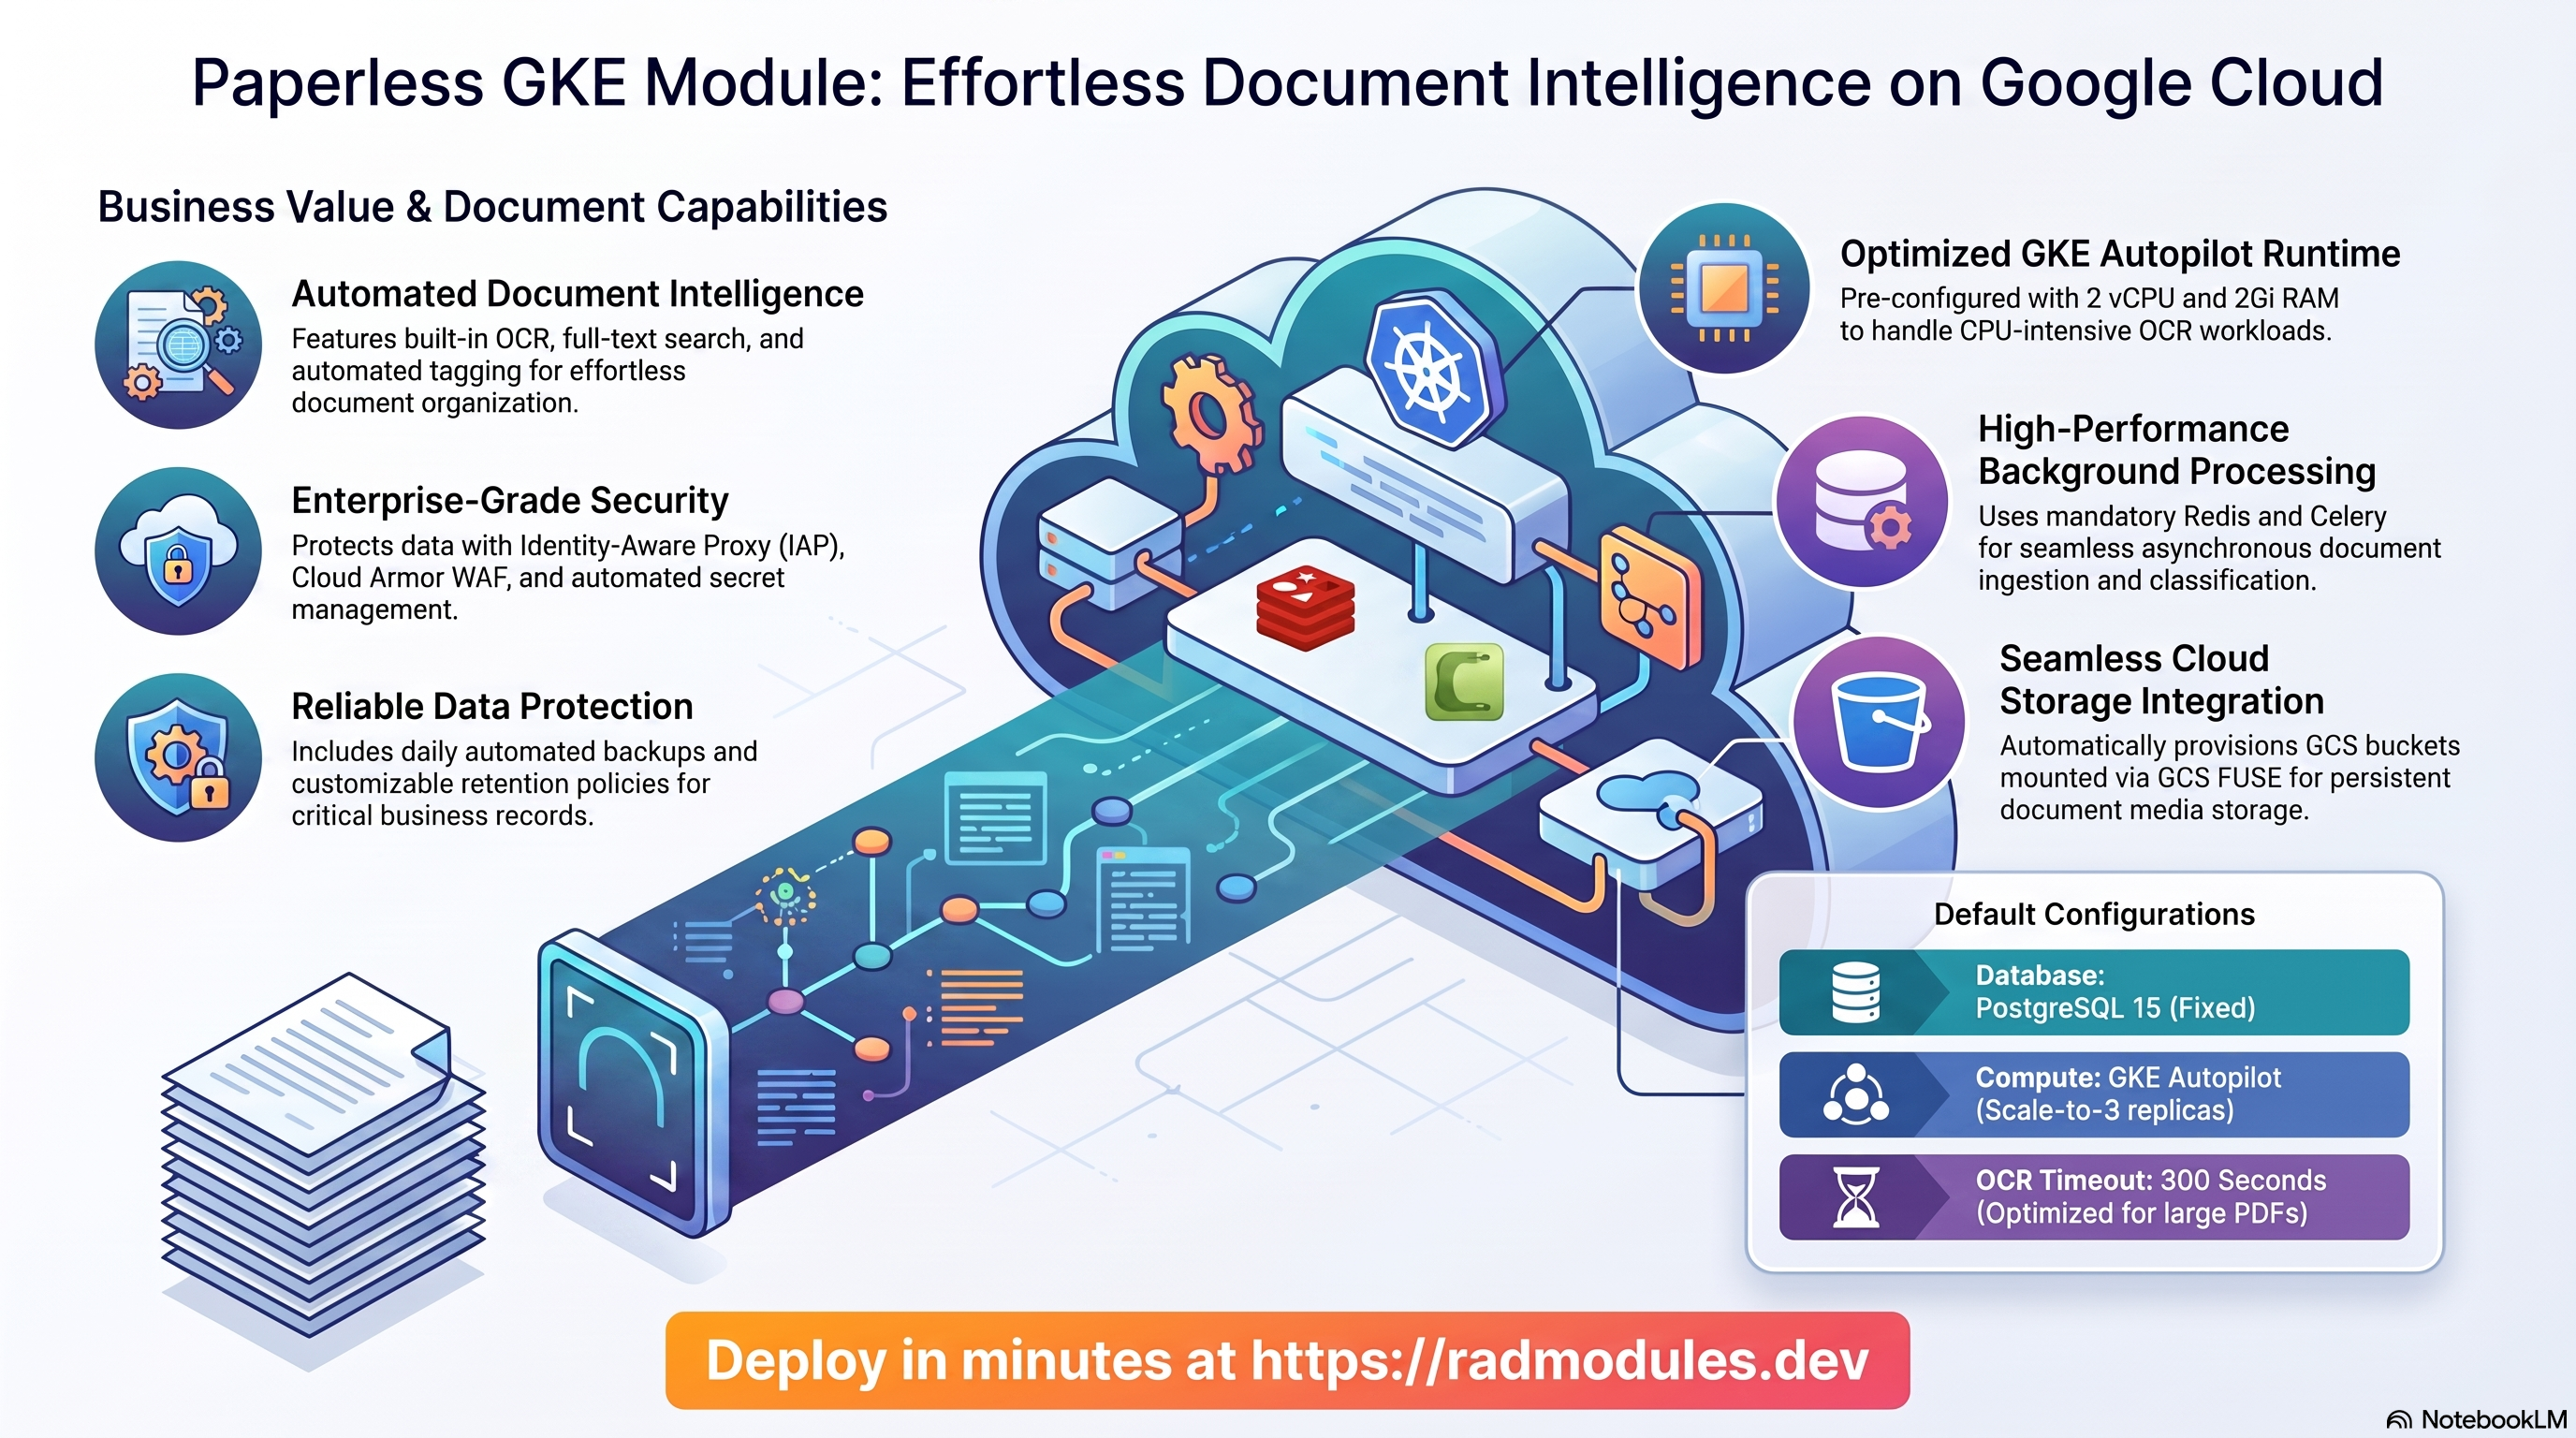
Ce guide décrit chaque variable de configuration disponible dans le module Paperless_GKE. Paperless_GKE est un module enveloppe qui combine le module d'infrastructure générique App_GKE avec la configuration d'application partagée Paperless_Common pour déployer Paperless-ngx — un système de gestion de documents open source avec OCR, recherche plein texte et étiquetage automatisé — sur Google Kubernetes Engine (GKE) Autopilot.
La plupart des options de configuration de Paperless GKE correspondent directement aux mêmes options de App GKE. Lorsqu'une variable a un comportement identique, ce guide fait référence au guide App GKE plutôt que de répéter la même documentation. Seules les variables et les valeurs par défaut spécifiques à Paperless-ngx sont décrites en détail ici.
Note : Les variables marquées comme gérées par la plateforme sont définies et maintenues par la plateforme. Vous n'avez normalement pas besoin de les modifier.
Ce que coûte Paperless sur RAD, et comment cela se compare
Pour une archive de bureau, Paperless sur le module GKE Autopilot de RAD coûte environ 143 $ US par mois sans licence par utilisateur. GKE convient à un Paperless-ngx qui doit rester opérationnel, s'adapter à travers les pods ou fonctionner aux côtés d'autres charges de travail Kubernetes. Pour le coût le plus bas, le module Cloud Run exécute le même Paperless pour environ 99 $ US par mois. Les chiffres sont ceux du 8 octobre 2026 ; les sources sont listées à la fin de cette section.
Si vous n'en avez besoin qu'occasionnellement — pour préparer une certification, une démo, une activité saisonnière — un projet géré par RAD peut être supprimé et restauré dans les 30 jours sans frais supplémentaires, de sorte que ces 143 $ US deviennent quelques dollars par mois. Voir Mettez-le en pause gratuitement, ci-dessous.
Ce que vous payez sur RAD
| Dans un projet Google Cloud que vous possédez | Dans un projet que RAD gère pour vous | |
|---|---|---|
| Frais de module, une fois par déploiement | 175 crédits (17,50 $ US au prix de la recharge) | 157,5 crédits (10 % de moins) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients sont l'exception : ils sont toujours facturés à la minute pour le temps de build | Idem |
| Coût d'exécution Google Cloud | Facturé par Google à votre propre compte de facturation (tableau ci-dessous) | Mesuré à l'heure en crédits ; RAD publie 143 crédits par jour, soit environ 4 290 par mois (environ 429 $ US au prix de la recharge ; estimé à partir des prix catalogue de Google, et incluant les frais de cluster) |
| Qui possède quoi | Vous possédez le projet et sa facturation ; RAD le déploie et le met à jour | RAD possède le projet, avec des garde-fous, des quotas et des alertes budgétaires ; vous avez accès à la console, et un solde minimum acheté est conservé en réserve |
10 crédits coûtent 1 $ US pour une recharge ponctuelle, et moins avec un plan mensuel. Dans un projet géré par RAD, la base de données, le serveur de fichiers et le réseau sont partagés par chaque application du projet, de sorte qu'une deuxième application n'ajoute pas une deuxième base de données.
Coût d'exécution par défaut dans votre propre projet (us-central1, prix catalogue Google) :
| Ressource (valeur par défaut du module) | Par mois |
|---|---|
| Pod GKE Autopilot, 2x vCPU / 2 Gio | 72,16 $ US |
| Cloud SQL pour PostgreSQL, 1 vCPU / 3,75 Go, zonal, 10 Go SSD | 51,02 $ US |
| Serveur de fichiers NFS/cache (petite VM) | 13,43 $ US |
| Cloud NAT et réseau | 5 $ US |
| Cloud Storage (modules complémentaires, sauvegardes) | 1 $ US |
| Frais de gestion de cluster GKE | partagés entre toutes les applications GKE du projet ; 0 $ si c'est votre seul cluster, sinon ~73 $ |
| Total | environ 143 $ US, ou environ 216 $ US sans le niveau gratuit |
- Le niveau gratuit de GKE couvre les frais de gestion d'un cluster Autopilot ou zonal par compte de facturation, il ne s'applique donc que si c'est votre seul cluster de ce type. Cloud SQL coûte le même prix en africa-south1 (Johannesburg) ; le pod et la VM coûtent environ 10 % de plus là-bas.
- GKE Autopilot ne se met pas à l'échelle zéro. Au moins un pod Paperless est toujours en cours d'exécution, donc le coût ci-dessus est le même que quelqu'un l'utilise ou non ; des pods supplémentaires ne sont ajoutés que sous charge.
- Évitez Filestore pour un petit déploiement. Le module utilise par défaut une petite VM NFS/cache. La plus petite instance de Filestore est de 1 Tio, ce qui coûte environ 164 $ US par mois à elle seule.
Comment cela se compare
- Aucun fournisseur ne vend un "Paperless-ngx Cloud" hébergé officiel avec des prix publics, donc cette comparaison se fait avec un serveur nu.
- Un VPS nu dimensionné proche de l'empreinte de Paperless-ngx — Hetzner CPX22 ou un Droplet DigitalOcean 2 vCPU/4 Go, tous deux à environ 24 $/mois, ou un GCP Compute Engine e2-standard-2 (2 vCPU/8 Go) à environ 49 $/mois — est moins cher en espèces que les chiffres RAD ci-dessus.
- La différence est ce que RAD gère : le stockage de documents basé sur GCS, les sauvegardes Cloud SQL et la récupération à un point dans le temps, Redis pour la file d'attente OCR/consommation, et Secret Manager pour le mot de passe administrateur — tout est inclus plutôt que d'être auto-administré.
Mettez-le en pause gratuitement : supprimez un projet géré par RAD, restaurez-le quand vous en avez besoin
Si Paperless s'exécute dans un projet que RAD gère pour vous, vous avez une deuxième option qui va bien au-delà de la mise à l'échelle à zéro : supprimez l'ensemble du projet et restaurez-le dans les 30 jours pour presque rien. Cela convient bien mieux à une utilisation occasionnelle — étudier pour une certification, un environnement de démonstration, une activité saisonnière — que de faire fonctionner Paperless en continu.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, seront utilisables après sa restauration, de sorte que la restauration ne peut pas être considérée comme un moyen fiable de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
- Comment ça marche. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer le projet. Google ne supprime pas le projet immédiatement : il le conserve, récupérable, pendant 30 jours. Comme la facturation est déjà déliée, rien n'est facturé pendant cette attente. Contrairement à la suppression d'un module, cela ne détruit pas Cloud SQL, aucune VM ou le cluster GKE un par un — l'ensemble du projet, et tout ce qu'il contient, s'arrête simplement.
- La restauration est une vérification, pas une reconstruction. Dans les 30 jours, le propriétaire du projet peut le restaurer. RAD demande à Google de récupérer le projet et de rattacher son compte de facturation, puis vous demande d'exécuter Update sur chaque déploiement pour confirmer que tout est revenu. Comme rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes — c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit.
- Ainsi, un mois d'utilisation occasionnelle peut coûter quelques dollars, et non les 429 $ US par mois pour le maintenir en fonctionnement. Déployez Paperless, utilisez-le pendant un certain temps, supprimez le projet. Restaurez-le la prochaine fois que vous en avez besoin, confirmez avec Update, et supprimez-le à nouveau lorsque vous avez terminé. Vous ne payez les frais de module qu'une seule fois et le temps pendant lequel Paperless a été réellement actif.
- Ce que cela nécessite. Vous devez être propriétaire du projet (pas un projet que vous apportez et dont RAD ne gère que la facturation), et vous le restaurez vous-même dans les 30 jours — après cela, Google le supprime définitivement. La restauration est admise comme la création d'un nouveau projet : votre solde de crédits achetés doit toujours dépasser le seuil du palier (100 crédits pour le palier sandbox qui convient à la plupart des utilisations d'étude et de démonstration). Google indique que la plupart des services sont de nouveau pleinement fonctionnels dans les 36 heures suivant une restauration.
- Une lacune réelle : le bucket de sauvegarde ne survit pas. Les sauvegardes de Paperless sont écrites dans un bucket à l'intérieur du projet, et ce bucket n'est pas protégé par la suppression logicielle de Cloud Storage, il est donc très probable qu'il disparaisse dès que vous supprimez le projet — même si le projet lui-même est récupérable pendant 30 jours. Si vous avez apporté des modifications à Paperless que vous souhaitez conserver, copiez une sauvegarde (vers Google Drive, ou un bucket en dehors du projet) avant de supprimer, comme pour le flux de travail de redéploiement ci-dessous. Pour une installation par défaut sans rien d'irremplaçable, cela n'a pas d'importance.
Payez uniquement pendant que vous l'utilisez, l'autre méthode : supprimer et redéployer
GKE Autopilot ne se met pas à l'échelle zéro entre les requêtes. L'option ci-dessus ne s'applique qu'à un projet géré par RAD ; dans votre propre projet, ou une fois la fenêtre de 30 jours passée, la façon d'arrêter de payer est de supprimer le déploiement et de le redéployer lorsque vous en avez besoin.
- Ce que coûte un redéploiement. Les frais de module à nouveau (les builds sont inclus) : 175 crédits (17,50 $ US), car RAD recrée le projet et les services partagés avant Paperless. La suppression ne permet d'économiser de l'argent que si Paperless restait inutilisé pendant environ 4 jours ou plus, à la fois dans votre propre projet (environ 4,75 $ US par jour) et dans un projet géré par RAD (143 crédits par jour).
- La majeure partie du coût d'exécution est généralement la base de données et la VM de fichier/cache partagée. Elles ne s'arrêtent que si rien d'autre dans le projet ne les utilise, donc la suppression de Paperless alors que quelque chose d'autre partage le projet n'économise que la partie calcul de Paperless.
- Conservez d'abord les données. Les sauvegardes sont écrites dans un bucket à l'intérieur du déploiement et sont supprimées avec celui-ci, donc copiez la dernière sauvegarde avant de la supprimer si vous voulez la conserver.
- RAD ne recrée pas un déploiement supprimé pour vous ; vous saisissez à nouveau les paramètres lors du déploiement.
Sessions de lab et environnements gérés
- Sessions de lab, pour la formation. Un formateur anime une session pour une classe. Chaque participant obtient l'application dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés sont reversés au formateur.
- Environnements gérés, pour les sociétés de conseil. Un partenaire exécute l'application pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille est faible, la facturation est suspendue et les données sont conservées, de sorte que personne ne reçoit de frais inattendus. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue Google Cloud de l'API Cloud Billing Catalog ; radmodules.dev/pricing pour les frais propres à RAD et les estimations de crédits quotidiens ; Supprimer et restaurer des projets pour la fenêtre de pause/restauration et ce qu'elle dit sur les objets Cloud Storage sans suppression logicielle.
Référence de configuration standard
Les zones de configuration suivantes sont fournies par le module sous-jacent App_GKE. Consultez les sections liées du Guide de configuration App_GKE pour une documentation complète.
| Zone de configuration | Section App GKE.md | Notes spécifiques à Paperless |
|---|---|---|
| Projet et identité | §2 IAM et contrôle d'accès | Identique. |
| Identité de l'application | §3.A Calcul (GKE Autopilot) | Valeurs par défaut spécifiques à Paperless ; voir Groupe 2 : Identité de l'application. |
| Exécution et mise à l'échelle | §3.A Calcul (GKE Autopilot) | Valeurs par défaut spécifiques à Paperless pour container_port, cpu_limit, memory_limit et timeout_seconds ; voir Groupe 3 : Exécution et mise à l'échelle. |
| Variables d'environnement et secrets | §3 Configuration du service principal | Deux secrets auto-générés par Paperless Common ; voir Groupe 5 : Variables d'environnement et secrets. |
| Réseau et stratégies réseau | §3.D Réseau et stratégies réseau | Identique. |
| Jobs d'initialisation et CronJobs | §3.E Jobs d'initialisation et CronJobs | Un job db-init par défaut (de Paperless Common) crée la base de données et l'utilisateur ; les migrations Django s'exécutent ensuite automatiquement au démarrage ; voir Groupe 8 : Jobs et tâches planifiées. |
| Services supplémentaires | §3.F Services supplémentaires | additional_services peut être utilisé pour ajouter Gotenberg ou Tika ; voir Groupe 8 : Jobs et tâches planifiées. |
| Stockage — NFS | §3.C Stockage (NFS / GCS / GCS Fuse) | enable_nfs utilise true par défaut ; requis lorsqu'aucun redis_host explicite n'est fourni ; voir Groupe 9 : Stockage et système de fichiers — NFS. |
| Stockage — GCS | §3.C Stockage (NFS / GCS / GCS Fuse) | Bucket GCS paperless-media provisionné automatiquement ; GCS FUSE monté automatiquement à /usr/src/paperless/media ; voir Groupe 10 : Stockage et système de fichiers — GCS. |
| Configuration de la base de données | §3.B Base de données (Cloud SQL) | PostgreSQL 15 requis ; voir Groupe 11 : Configuration de la base de données. |
| Planification et rétention des sauvegardes | §3.B Base de données (Cloud SQL) | Identique. |
| Scripts SQL personnalisés | §3.E Jobs d'initialisation et CronJobs | Identique. |
| Observabilité et vérifications de santé | §3.A Calcul (GKE Autopilot) | Système de sonde à deux chemins ; voir Groupe 13 : Observabilité et santé. |
| Cloud Armor WAF | §4.A Cloud Armor WAF | Identique. |
| Identity-Aware Proxy | §4.B Identity-Aware Proxy (IAP) | Identique. |
| Autorisation binaire | §4.C Autorisation binaire | Identique. |
| Contrôles de service VPC | §4.D Contrôles de service VPC | Identique. |
| Pilote CSI du magasin de secrets | §4.E Pilote CSI du magasin de secrets | Toujours activé — aucune configuration requise. |
| Trafic et Ingress | §5 Trafic et Ingress | Identique. |
| CDN | §5.B CDN | Identique. |
| Domaine personnalisé et IP statique | §5.C Réservation d'IP statique | Identique. |
| Déclencheurs Cloud Build | §6.A Déclencheurs Cloud Build | Identique. |
| Pipeline Cloud Deploy | §6.B Pipeline Cloud Deploy | Identique. |
| Mise en miroir d'images | §6.C Mise en miroir d'images | enable_image_mirroring utilise true par défaut ; les images Paperless-ngx sont hébergées sur GHCR. |
| Budgets d'interruption de pod | §7.A Budgets d'interruption de pod | enable_pod_disruption_budget utilise false par défaut ; voir Groupe 14 : Politiques de fiabilité. |
| Contraintes de répartition de topologie | §7.B Contraintes de répartition de topologie | Identique. |
| Quotas de ressources | §7.C Quotas de ressources | Identique. |
| Rotation automatique des mots de passe | §7.D Rotation automatique des mots de passe | Voir Groupe 11 : Configuration de la base de données. |
| Cache Redis | §8.A Redis / Memorystore | enable_redis utilise true par défaut — Redis est obligatoire, pas facultatif ; voir Groupe 16 : Redis (Celery Broker). |
| Importation de sauvegarde | §8.B Importation de sauvegarde | Voir Groupe 6 : Sauvegarde et maintenance. |
| Maillage de services (ASM) | §8.C Maillage de services (ASM via Fleet) | Identique. |
| Services multi-clusters | §8.D Services multi-clusters (MCS) | Identique. |
Comment Paperless GKE est lié à App GKE
Paperless GKE transmet toutes les variables à App GKE et ajoute un sous-module Paperless Common qui fournit des valeurs par défaut et une configuration d'application spécifiques à Paperless-ngx. Les principaux effets sont les suivants :
- PostgreSQL 15 est requis. Paperless-ngx ne prend en charge que PostgreSQL. Le type de base de données est fixé à
"POSTGRES_15". - Deux secrets sont auto-générés par
Paperless Common.PAPERLESS_ADMIN_PASSWORDetPAPERLESS_SECRET_KEYsont créés dans Secret Manager et injectés automatiquement dans le conteneur. Vous n'avez pas besoin de les créer ou de les gérer manuellement. - Un bucket GCS
paperless-mediaest provisionné automatiquement.Paperless Commonfournit une définition de bucketpaperless-media. Par défaut, le pilote CSI GCS FUSE monte ce bucket à/usr/src/paperless/mediaà l'intérieur du conteneur. Vous n'avez pas besoin de définir ce bucket dansstorage_buckets. - Redis est obligatoire. Paperless-ngx utilise Redis comme courtier de messages Celery pour tous les traitements de documents en arrière-plan, l'OCR, les jobs de pipeline de consommation et la planification des tâches asynchrones. Contrairement à d'autres modules où Redis est facultatif pour la mise en cache, la suppression de Redis de Paperless-ngx entraîne l'arrêt complet du traitement des documents en arrière-plan.
- Un job
db-initpar défaut est fourni parPaperless Common. Lorsqueinitialization_jobsest vide, un job Kubernetesdb-init(imagepostgres:15-alpine, scriptdb-init.sh) crée la base de données PostgreSQL et l'utilisateur de l'application avant le démarrage de la charge de travail. Les migrations de schéma Django s'exécutent ensuite automatiquement au démarrage du conteneur via le script de point d'entrée. - Les valeurs par défaut des ressources sont dimensionnées pour les charges de travail OCR. Les valeurs par défaut
cpu_limit(2 vCPU) etmemory_limit(2 Gio) reflètent les exigences de Tesseract OCR. L'OCR sur les PDF multipages est gourmand en CPU — envisagez d'augmentercpu_limitpour une ingestion à volume élevé. - La mise en miroir d'images est activée par défaut. Les images Paperless-ngx sont hébergées sur GitHub Container Registry (GHCR). Le module met en miroir l'image vers Artifact Registry par défaut pour éviter les limites de débit de GHCR.
timeout_secondsest par défaut à 300 secondes (identique à la valeur par défaut de la fondationApp_GKE— pas une surcharge). Le traitement OCR sur de gros documents peut être lent, donc cette valeur par défaut généreuse empêche Kubernetes de terminer prématurément les requêtes d'ingestion lentes.
Groupe 1 : Projet et identité
Identique à App_GKE. Voir App_GKE.
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | ID du projet GCP. |
region | "us-central1" | Région GCP pour le déploiement des ressources. Utilisée comme solution de repli lorsque la découverte réseau ne peut pas déterminer la région à partir des sous-réseaux VPC existants. Également utilisée comme emplacement du bucket de stockage pour le bucket paperless-media. |
Groupe 2 : Identité de l'application
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE pour les descriptions.
Valeurs par défaut spécifiques à Paperless :
| Variable | Valeur par défaut Paperless GKE | Valeur par défaut App GKE | Notes |
|---|---|---|---|
application_name | "paperless" | "gkeapp" | Utilisé comme nom de base pour toutes les ressources GCP et Kubernetes. Ne pas modifier après le déploiement. |
display_name | "Paperless-ngx - Document Management System" | "App GKE Application" | Affiché dans l'interface utilisateur et les tableaux de bord de la plateforme. Peut être modifié librement. |
description | "Paperless-ngx - open-source document management system with OCR, full-text search, and automated tagging" | "App GKE Custom Application…" | Libellé descriptif. Peut être modifié librement. |
application_version | "latest" | "1.0.0" | Tag de version de l'image Paperless-ngx. Épinglez à une version spécifique (par exemple, "2.13.5") pour les déploiements de production afin d'assurer des builds reproductibles. |
Groupe 3 : Exécution et mise à l'échelle
La plupart des variables se comportent de manière identique à App_GKE. Voir App_GKE Groupe 4.
Valeurs par défaut et comportement spécifiques à Paperless :
| Variable | Valeur par défaut Paperless GKE | Valeur par défaut App GKE | Notes |
|---|---|---|---|
container_port | 8000 | 8080 | Gunicorn de Paperless-ngx écoute sur le port 8000. Ne pas modifier sauf si votre Dockerfile personnalisé se lie à un port différent. |
cpu_limit | "2000m" | "1000m" | Tesseract OCR est gourmand en CPU, surtout pour les PDF multipages. 2 vCPU est le minimum recommandé pour la production. Augmenter à 4000m pour les pipelines d'ingestion de documents à volume élevé. |
memory_limit | "2Gi" | "512Mi" | Paperless-ngx charge les miniatures de documents, les modèles linguistiques Tesseract et les modèles de classification ML en mémoire. 2 Gio est le minimum ; augmenter à 4 Gio pour les déploiements traitant de gros documents ou plusieurs langues simultanément. |
min_instance_count | 1 | 1 | Toujours au moins un pod en cours d'exécution. La mise à l'échelle à zéro n'est pas recommandée — garder un pod en vie garantit que le processus worker Celery écoute toujours sur le répertoire de consommation. |
max_instance_count | 3 | 3 | Nombre maximal de réplicas de pods. Augmenter pour l'ingestion de documents à volume élevé. |
timeout_seconds | 300 | 300 | Non surchargé — la valeur par défaut d'App_GKE est déjà de 300s, ce qui couvre confortablement l'OCR sur les PDF volumineux et multipages. |
enable_cloudsql_volume | true | true | Le sidecar Cloud SQL Auth Proxy est requis. Paperless-ngx se connecte à PostgreSQL via le socket Unix de l'Auth Proxy. |
enable_image_mirroring | true | true | Non surchargé — App_GKE met déjà en miroir par défaut. Toujours important pour Paperless-ngx : les images hébergées sur GHCR bénéficient de la copie Artifact Registry pour éviter les limites de débit et satisfaire les exigences d'autorisation binaire. |
Les variables d'exécution restantes (deploy_application, container_image, container_build_config, enable_vertical_pod_autoscaling, container_protocol, container_resources, cloudsql_volume_mount_path, service_annotations, service_labels) se comportent comme décrit dans App_GKE Groupe 4.
Groupe 4 : Accès et réseau
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE, App_GKE, et App_GKE.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_iap | false | Active l'authentification Identity-Aware Proxy sur l'équilibreur de charge. Recommandé pour les déploiements de gestion de documents où l'accès doit être restreint à votre organisation. |
iap_authorized_users | [] | Utilisateurs individuels ou comptes de service ayant accès à l'IAP. |
iap_authorized_groups | [] | Groupes Google ayant accès à l'IAP. |
iap_oauth_client_id | "" | ID client OAuth pour la configuration IAP. |
iap_oauth_client_secret | "" | Secret client OAuth pour la configuration IAP. |
enable_custom_domain | true | Configure Ingress/Gateway pour le routage de domaine personnalisé avec des certificats SSL gérés. Activé par défaut — une passerelle avec une IP statique est provisionnée automatiquement. |
application_domains | [] | Noms de domaine personnalisés (par exemple ["paperless.example.com"]). |
reserve_static_ip | true | Réserve une IP statique globale pour l'équilibreur de charge. |
static_ip_name | "" | Nom de l'IP réservée ; auto-généré si vide. |
network_tags | ["nfsserver"] | Tags de pare-feu appliqués aux nœuds du cluster GKE. Le tag nfsserver est requis pour la connectivité NFS. |
enable_cloud_armor | false | Active une politique de sécurité Cloud Armor WAF. |
admin_ip_ranges | [] | Plages CIDR d'administration autorisées via Cloud Armor. |
cloud_armor_policy_name | "default-waf-policy" | Nom de la politique de sécurité Cloud Armor à attacher. |
enable_vpc_sc | false | Active l'application du périmètre des contrôles de service VPC. |
enable_cdn | false | Active Cloud CDN sur l'équilibreur de charge. |
Groupe 5 : Variables d'environnement et secrets
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Secrets auto-générés spécifiques à Paperless :
Paperless Common crée et gère automatiquement deux secrets au niveau de l'application dans Secret Manager :
| Secret | Description |
|---|---|---|
| PAPERLESS_ADMIN_PASSWORD | Mot de passe du compte superutilisateur initial. Auto-généré au moment du déploiement. Récupérer depuis Secret Manager pour se connecter pour la première fois. |
| PAPERLESS_SECRET_KEY | Clé secrète de l'application Django. Utilisée pour la signature de session et la protection CSRF. Auto-générée au moment du déploiement ; non renouvelée automatiquement — la régénérer invalide toutes les sessions utilisateur actives. |
Les deux secrets sont injectés dans le conteneur au démarrage du pod via le pilote CSI du magasin de secrets. Le texte en clair n'est jamais écrit dans l'état Terraform.
Paramètres d'application spécifiques à Paperless-ngx (time_zone, ocr_language, admin_user, admin_email) sont documentés dans Groupe 15 : Paramètres d'application Paperless-ngx.
Les variables de secrets standard (environment_variables, secret_environment_variables, secret_rotation_period, secret_propagation_delay, manage_storage_kms_iam) se comportent comme décrit dans App_GKE.
Groupe 6 : Sauvegarde et maintenance
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Paperless :
| Variable | Valeur par défaut | Notes |
|---|---|---|
backup_schedule | "0 2 * * *" | Quotidiennement à 02:00 UTC. Ajuster pour correspondre à votre objectif de point de récupération et à vos heures d'ouverture. |
backup_retention_days | 7 | Rétention de 7 jours. Augmenter à 30-90 jours pour les déploiements de production gérant des documents légaux ou de conformité. |
Importation de sauvegarde — Paperless GKE prend en charge l'importation d'une sauvegarde de base de données existante lors du premier déploiement :
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_backup_import | false | Lorsque true, exécute un job d'importation unique pendant le déploiement pour restaurer la sauvegarde spécifiée par backup_uri. |
backup_source | "gcs" | Système source du fichier de sauvegarde. "gcs" importe depuis un URI Cloud Storage ; "gdrive" importe depuis un ID de fichier Google Drive. |
backup_uri | "" | URI GCS complet (par exemple "gs://my-bucket/backups/paperless.sql") ou ID de fichier Google Drive. |
backup_format | "sql" | Format du fichier de sauvegarde. Valeurs prises en charge : sql, tar, gz, tgz, tar.gz, zip, auto. |
Note : Une importation de sauvegarde ne restaure que la base de données PostgreSQL. Les fichiers de documents stockés dans le bucket média GCS doivent être migrés séparément — copiez-les dans le bucket
paperless-mediaune fois la restauration de la base de données terminée.
Groupe 7 : CI/CD et intégration GitHub
Identique à App_GKE. Voir App_GKE.
Variables disponibles : enable_cicd_trigger, github_repository_url, github_token, github_app_installation_id, cicd_trigger_config, enable_cloud_deploy, cloud_deploy_stages, enable_binary_authorization, binauthz_evaluation_mode.
Groupe 8 : Jobs et tâches planifiées
Ces variables se comportent comme décrit dans App_GKE.
Job db-init par défaut : Lorsque initialization_jobs est vide (par défaut), Paperless Common fournit un job Kubernetes db-init (image postgres:15-alpine, script scripts/db-init.sh, execute_on_apply = true) qui crée la base de données PostgreSQL et l'utilisateur de l'application. Les migrations de schéma Django s'exécutent ensuite automatiquement dans le cadre du point d'entrée du conteneur au premier démarrage. Fournir une liste initialization_jobs non vide remplace le job par défaut.
Gotenberg et Tika comme services supplémentaires : Paperless-ngx prend en charge l'intégration facultative avec Gotenberg (conversion de documents avancée) et Apache Tika (extraction de contenu à partir de fichiers Office). Ceux-ci ne sont pas provisionnés par défaut. Pour les ajouter, définissez-les dans additional_services :
| Service | Image | Port | Objectif |
|---|---|---|---|
| Gotenberg | gotenberg/gotenberg:7 | 3000 | Convertir des documents Office, HTML et URL en PDF avant l'OCR |
| Tika | apache/tika:latest | 9998 | Extraire le contenu texte de .docx, .xlsx, .pptx et d'autres formats Office |
Une fois ajoutés, configurez Paperless-ngx pour les utiliser en définissant PAPERLESS_TIKA_ENABLED=true, PAPERLESS_TIKA_ENDPOINT et PAPERLESS_TIKA_GOTENBERG_ENDPOINT dans environment_variables.
CronJobs :
La variable cron_jobs est disponible pour des tâches telles que la reclassification périodique de documents ou la reconstruction d'index. Voir App_GKE pour la documentation complète du schéma.
Note : Contrairement aux jobs de type Cloud Run, les CronJobs GKE utilisent les champs
restart_policy,concurrency_policy,failed_jobs_history_limit,successful_jobs_history_limit,starting_deadline_secondsetsuspend. Les champs de type Cloud Run (parallelism,paused,max_retries,task_count) ne sont pas disponibles.
Groupe 9 : Stockage et système de fichiers — NFS
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Paperless :
| Variable | Valeur par défaut | Notes |
|---|---|---|
enable_nfs | true | Le stockage NFS est activé par défaut. Lorsque enable_redis = true et qu'aucun redis_host externe n'est fourni, le module utilise l'IP du serveur NFS comme hôte Redis. Si vous désactivez NFS, vous devez fournir un redis_host explicite. |
nfs_mount_path | "/mnt/nfs" | Le chemin où le volume NFS est monté à l'intérieur du conteneur. Ceci est distinct du chemin de stockage des documents (/usr/src/paperless/media), qui est monté via GCS FUSE. |
Groupe 10 : Stockage et système de fichiers — GCS
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE Groupe 14.
Bucket auto-provisionné spécifique à Paperless :
Paperless Common provisionne automatiquement un bucket GCS paperless-media et, par défaut, le monte via le pilote CSI GCS FUSE à /usr/src/paperless/media à l'intérieur du conteneur. C'est le chemin où Paperless-ngx stocke :
- Fichiers de documents originaux (avant le traitement OCR)
- Fichiers de documents traités (après OCR et classification)
- Images miniatures pour l'interface utilisateur web
- Répertoire de consommation temporaire pour l'ingestion de nouveaux documents
| Bucket | name_suffix | Chemin de montage | Objectif |
|---|---|---|---|
| Auto-provisionné | paperless-media | /usr/src/paperless/media | Stockage de documents persistant via GCS FUSE |
Vous n'avez pas besoin de définir ce bucket dans storage_buckets. Surchargez gcs_volumes pour personnaliser les options de montage ou ajouter des montages de volume supplémentaires.
Options de montage par défaut de GCS FUSE :
La configuration gcs_volumes par défaut monte le bucket média avec implicit-dirs, stat-cache-ttl=60s et type-cache-ttl=60s. Ces paramètres sont appropriés pour le modèle d'écriture séquentielle de Paperless-ngx (les documents sont écrits une fois puis lus). Pour une ingestion à haut débit, envisagez de réduire les TTL du cache ou d'utiliser metadata-cache-ttl=0 pour assurer une cohérence immédiate.
Les variables create_cloud_storage, storage_buckets, gcs_volumes, manage_storage_kms_iam, enable_artifact_registry_cmek, max_images_to_retain, delete_untagged_images et image_retention_days se comportent comme décrit dans App_GKE Groupe 14.
Groupe 11 : Configuration de la base de données
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut et restrictions spécifiques à Paperless :
| Variable | Valeur par défaut Paperless GKE | Valeur par défaut App GKE | Notes |
|---|---|---|---|
db_name | "paperless" | "gkeappdb" | Nom de la base de données PostgreSQL créée pour Paperless-ngx. Immuable après le déploiement — la modification de cette valeur recrée la base de données et détruit toutes les métadonnées des documents. |
db_user | "paperless" | "gkeappuser" | Utilisateur PostgreSQL pour Paperless-ngx. Immuable après le déploiement. |
database_password_length | 32 | 32 | Longueur du mot de passe de la base de données auto-généré. Plage valide : 16 à 64 caractères. |
Important : Paperless-ngx nécessite PostgreSQL. Ne changez pas
database_typepour une variante MySQL ou SQL Server — l'ORM Django de Paperless-ngx ne prend en charge que PostgreSQL.
Découverte d'instances Cloud SQL :
| Variable | Valeur par défaut | Description |
|---|---|---|
sql_instance_name | "" | Nom d'une instance Cloud SQL existante à utiliser. Laisser vide pour découvrir automatiquement une instance gérée par Services GCP ou créer une instance intégrée. |
sql_instance_base_name | "app-sql" | Nom de base de l'instance Cloud SQL intégrée lorsqu'aucune instance existante n'est trouvée. L'ID de déploiement est ajouté. |
Rotation automatique des mots de passe :
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_auto_password_rotation | false | Déploie un job de rotation automatique des mots de passe de base de données. Lorsque true, le mot de passe de la base de données est renouvelé selon le calendrier défini par secret_rotation_period et les pods GKE sont redémarrés pour prendre en compte le nouveau credential. |
rotation_propagation_delay_sec | 90 | Secondes à attendre après la rotation avant de redémarrer les pods, pour permettre la réplication de Secret Manager. |
Groupe 12 : Scripts SQL personnalisés
Identique à App_GKE. Voir App_GKE.
Variables disponibles : enable_custom_sql_scripts, custom_sql_scripts_bucket, custom_sql_scripts_path, custom_sql_scripts_use_root.
Groupe 13 : Observabilité et santé
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Paperless :
Paperless-ngx exécute les migrations de base de données Django et initialise les workers Celery au premier démarrage. Les valeurs par défaut des sondes de santé tiennent compte de ce délai de démarrage.
Routage des sondes de santé
Paperless GKE expose deux ensembles parallèles de variables de sonde qui configurent les sondes Kubernetes via différents chemins de routage :
| Ensemble de variables | Transmis à | Configure |
|---|---|---|
startup_probe, liveness_probe | Sous-module Paperless Common | La spécification de la sonde Kubernetes du conteneur de l'application (initialDelaySeconds, path, failureThreshold, etc.) |
startup_probe_config, health_check_config | App GKE directement | La configuration de sonde standard App GKE utilisée pour les vérifications de santé de l'équilibreur de charge et les sondes d'infrastructure GKE |
Ce sont des chemins parallèles, pas des alias. Changer startup_probe n'affecte pas startup_probe_config, et vice versa.
Sonde de démarrage (startup_probe → Paperless Common) :
| Champ | Valeur par défaut Paperless | Notes |
|---|---|---|
type | "HTTP" | Sonde HTTP GET sur le chemin racine. |
path | "/" | La page de connexion de Paperless-ngx renvoie HTTP 200 lorsque l'application est prête. |
initial_delay_seconds | 60 | Permet 60 secondes avant la première tentative de sonde, pour tenir compte du temps de migration de la base de données au premier démarrage. |
timeout_seconds | 10 | Délai d'expiration de la sonde par tentative. |
period_seconds | 10 | Intervalle de la sonde. |
failure_threshold | 30 | Jusqu'à 300 secondes (30 × 10 s) de délai de démarrage avant le redémarrage du pod. |
Sonde de vivacité (liveness_probe → Paperless Common) :
| Champ | Valeur par défaut Paperless | Notes |
|---|---|---|
type | "HTTP" | Sonde HTTP GET. |
path | "/" | Le chemin racine renvoie HTTP 200 lorsque l'application est saine. |
initial_delay_seconds | 60 | Donne à Paperless-ngx le temps de terminer son démarrage avant que les vérifications de vivacité ne commencent. |
period_seconds | 30 | Moins fréquente que la sonde de démarrage — appropriée pour un service stable en cours d'exécution. |
failure_threshold | 3 | Trois échecs consécutifs déclenchent un redémarrage du pod. |
Sondes standard App GKE (startup_probe_config, health_check_config → App GKE) :
| Variable | Valeur par défaut Paperless | Notes |
|---|---|---|
startup_probe_config | { enabled = true, type = "TCP", timeout_seconds = 240, period_seconds = 240, failure_threshold = 1 } | Sonde TCP sur container_port (8000). Permet jusqu'à 240 secondes pour le démarrage. |
health_check_config | { enabled = true, type = "HTTP", path = "/" } | HTTP GET sur /. Le chemin racine de Paperless-ngx est le bon point de terminaison de santé. |
uptime_check_config : Par défaut à { enabled = false, path = "/" } — les tests de disponibilité sont désactivés par défaut. Activez-les explicitement pour la surveillance en production.
Groupe 14 : Politiques de fiabilité
Ces variables se comportent de manière identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Paperless :
| Variable | Valeur par défaut Paperless GKE | Valeur par défaut App GKE | Notes |
|---|---|---|---|
enable_pod_disruption_budget | false | true | Le PDB est désactivé par défaut dans Paperless GKE. Activez-le pour les déploiements de production où la continuité du traitement des documents pendant la maintenance des nœuds est importante. |
pdb_min_available | 1 | 1 | Nombre minimum de pods qui doivent rester disponibles pendant les perturbations. |
Variables disponibles : enable_pod_disruption_budget, pdb_min_available, enable_topology_spread, topology_spread_strict.
Groupe 15 : Paramètres de l'application Paperless-ngx
Ces variables sont spécifiques à Paperless-ngx et sont transmises directement à Paperless Common. Elles contrôlent le comportement d'exécution de l'application et ne sont pas présentes dans App_GKE.
| Variable | Valeur par défaut | Options / Format | Description et implications |
|---|---|---|---|
time_zone | "UTC" | Chaîne de fuseau horaire IANA (par exemple "Europe/London", "America/New_York") | Fuseau horaire utilisé pour les horodatages des documents, l'exécution des tâches planifiées et l'analyse des dates dans les titres de documents. Important pour la reconnaissance des dates de documents : Paperless-ngx utilise le fuseau horaire configuré lors de l'analyse des dates à partir des noms de fichiers et des métadonnées des documents. Définissez-le pour qu'il corresponde au fuseau horaire des documents que vous numérisez afin d'éviter les erreurs de décalage d'un jour sur les règles de classement basées sur la date. |
ocr_language | "eng" | Code de langue Tesseract ISO 639-2/T. Combinez plusieurs avec + (par exemple "fra+eng", "deu+eng") | Pack de langue OCR principal chargé par Tesseract. La définition de la langue correcte améliore considérablement la précision de l'OCR. Pour les archives multilingues, combinez les codes — chaque langue supplémentaire augmente l'utilisation de la mémoire et le temps de traitement OCR. Codes disponibles : eng (anglais), deu (allemand), fra (français), spa (espagnol), ita (italien), nld (néerlandais), por (portugais), et bien d'autres. |
admin_user | "admin" | Chaîne | Nom d'utilisateur du compte superutilisateur Paperless-ngx initial, créé au premier démarrage. Utilisé pour se connecter à l'interface web et à l'API REST. Changez pour un nom d'utilisateur non par défaut afin de réduire l'exposition aux attaques par devinette de mots de passe. |
admin_email | "admin@example.com" | Adresse e-mail valide | Adresse e-mail associée au compte administrateur initial. Utilisée pour la récupération de mot de passe et les notifications système. Définissez une adresse valide que vous contrôlez avant le premier déploiement. |
Validation des paramètres du groupe 15
Console Google Cloud :
- Secret Manager : Accédez à Sécurité → Secret Manager et confirmez que
PAPERLESS_ADMIN_PASSWORDetPAPERLESS_SECRET_KEYexistent. Utilisez Accéder à la version du secret pour récupérer le mot de passe administrateur pour la première connexion. - Charges de travail GKE : Accédez à Kubernetes Engine → Charges de travail et confirmez que le déploiement Paperless-ngx est en cours d'exécution. Cliquez sur le déploiement pour afficher la configuration des variables d'environnement du pod.
CLI gcloud / kubectl :
# Retrieve the admin password from Secret Manager
# (secret name pattern: secret-<resource-prefix>-paperless-admin-password)
gcloud secrets versions access latest \
  --secret="secret-RESOURCE_PREFIX-paperless-admin-password" \
  --project=PROJECT_ID

# Confirm the OCR language environment variable is set in the running pod
kubectl exec -n NAMESPACE POD_NAME -- env | grep PAPERLESS_OCR_LANGUAGE

# Confirm the timezone environment variable
kubectl exec -n NAMESPACE POD_NAME -- env | grep PAPERLESS_TIME_ZONE

# Check Paperless-ngx startup logs for migration output
kubectl logs -n NAMESPACE POD_NAME --since=10m | grep -i "migration\|celery\|ready"
Groupe 16 : Redis (courtier Celery)
Ces variables configurent l'intégration de Redis à Paperless-ngx. Le support de l'infrastructure Redis sous-jacente est fourni par App_GKE (voir App_GKE). Redis n'est pas facultatif pour Paperless-ngx — c'est le courtier de messages Celery qui pilote tous les traitements de documents en arrière-plan, les tâches OCR et le pipeline de consommation.
Note : Dans
Paperless GKE, les variables Redis se trouvent dans le groupe 21.
| Variable | Valeur par défaut | Options / Format | Description et implications |
|---|---|---|---|
enable_redis | true | true / false | Active Redis comme courtier Celery et backend de résultats de Paperless-ngx. Doit rester true pour que Paperless-ngx fonctionne. Lorsque true et redis_host est vide, le module utilise par défaut l'IP du serveur NFS comme hôte Redis. La désactivation de Redis entraîne l'arrêt de tous les traitements OCR en arrière-plan, de la classification des documents et du pipeline de consommation. Les documents déposés dans le répertoire de consommation ne seront pas traités. |
redis_host | "" (par défaut l'IP du serveur NFS) | Nom d'hôte ou adresse IP | Le nom d'hôte ou l'adresse IP du serveur Redis. Laissez vide pour utiliser l'IP du serveur NFS découverte automatiquement (qui co-héberge un processus Redis dans la configuration par défaut de la plateforme). Remplacez par une IP ou un nom d'hôte explicite lors de l'utilisation d'une instance Redis dédiée telle que Google Cloud Memorystore. Exemple : "10.128.0.10". |
redis_port | "6379" | Chaîne de numéro de port | Le port TCP sur lequel le serveur Redis écoute. Le port par défaut 6379 est le port Redis standard. |
redis_auth | "" | Chaîne (sensible) | Mot de passe d'authentification pour le serveur Redis. Laissez vide si l'instance Redis ne nécessite pas d'authentification. Pour Google Cloud Memorystore avec AUTH activé, définissez-le sur la chaîne AUTH de l'instance. |
Validation des paramètres Redis
Console Google Cloud :
- Instance Memorystore (si utilisée) : Accédez à Memorystore → Redis pour confirmer l'existence de l'instance, son adresse IP, son port et son statut AUTH.
- Environnement du pod GKE : Accédez à Kubernetes Engine → Charges de travail, sélectionnez le déploiement Paperless-ngx et vérifiez les variables d'environnement du pod pour
PAPERLESS_REDIS.
CLI gcloud / kubectl :
# List Memorystore Redis instances in the project (if using Memorystore)
gcloud redis instances list \
  --region=REGION \
  --project=PROJECT_ID \
  --format="table(name,host,port,state,memorySizeGb,authEnabled)"

# Confirm the Redis connection string is set in the Paperless-ngx pod
kubectl exec -n NAMESPACE POD_NAME -- env | grep PAPERLESS_REDIS

# Test Redis connectivity from inside the Paperless-ngx pod
kubectl exec -n NAMESPACE POD_NAME -- \
  nc -zv REDIS_HOST 6379

# Check Celery worker status in logs
kubectl logs -n NAMESPACE POD_NAME | grep -i "celery\|broker\|ready"
Groupe 17 : Configuration du backend GKE
Identique à App_GKE. Voir App_GKE.
Valeurs par défaut spécifiques à Paperless :
| Variable | Valeur par défaut Paperless GKE | Notes |
|---|---|---|
session_affinity | "ClientIP" | Garantit que les sessions de téléchargement de documents sont acheminées vers le même réplica de pod. Sans affinité de session, les téléchargements en plusieurs parties et les sessions d'administration peuvent échouer lorsqu'ils sont acheminés vers différents réplicas. |
service_type | "LoadBalancer" | Expose Paperless-ngx via un équilibreur de charge Google Cloud. |
termination_grace_period_seconds | 60 | Permet aux tâches OCR en cours de se terminer avant que le pod ne soit terminé. Envisagez d'augmenter à 120+ secondes pour les déploiements traitant de gros documents. |
Variables disponibles : gke_cluster_name, namespace_name, workload_type, service_type, session_affinity, enable_multi_cluster_service, configure_service_mesh, enable_network_segmentation, termination_grace_period_seconds, deployment_timeout, gke_cluster_selection_mode, network_name, prereq_gke_subnet_cidr.
Groupe 18 : Charges de travail avec état
Identique à App_GKE. Voir la configuration StatefulSet décrite dans App_GKE.
Le paramètre stateful_pvc_enabled = true sélectionne automatiquement workload_type = "StatefulSet". Lors de l'utilisation d'un StatefulSet pour Paperless-ngx, le PVC fournit un volume persistant par pod en plus du montage média partagé GCS FUSE. Cela peut être utilisé pour stocker la base de données de consommation SQLite de Paperless-ngx ou les fichiers de travail OCR temporaires.
| Variable | Valeur par défaut | Notes |
|---|---|---|
stateful_pvc_enabled | null | Définir sur true pour activer StatefulSet avec PVC par pod. Sélectionne automatiquement workload_type = "StatefulSet". |
stateful_pvc_size | "10Gi" | Taille initiale du PVC. Étendre si nécessaire — GKE Autopilot prend en charge l'extension du PVC. |
stateful_pvc_mount_path | "/data" | Chemin du conteneur où le PVC par pod est monté. Distinct du montage média GCS FUSE à /usr/src/paperless/media. |
stateful_pvc_storage_class | "standard-rwo" | StorageClass pour le PVC. standard-rwo provisionne un disque persistant Compute Engine (ReadWriteOnce). |
stateful_headless_service | null | Crée un service sans tête pour des identités DNS de pod stables. |
stateful_pod_management_policy | null | "OrderedReady" ou "Parallel". |
stateful_update_strategy | null | "RollingUpdate" ou "OnDelete". |
stateful_fs_group | 0 | GID pour le fsGroup au niveau du pod dans le contexte de sécurité. |
Sorties du module
Paperless GKE expose les sorties Terraform suivantes :
| Sortie | Description |
|---|---|
service_name | Nom du service Kubernetes |
service_cluster_ip | ClusterIP intra-cluster du service Kubernetes |
service_external_ip | Adresse IP externe de l'équilibreur de charge |
project_id | ID du projet GCP |
deployment_id | Suffixe de l'ID de déploiement |
namespace | Espace de noms Kubernetes |
database_instance_name | Nom de l'instance Cloud SQL |
database_name | Nom de la base de données de l'application |
database_user | Nom de l'utilisateur de la base de données de l'application |
database_password_secret | Nom du secret Secret Manager pour le mot de passe de la base de données |
storage_buckets | Buckets de stockage GCS créés (inclut le bucket média auto-provisionné) |
container_image | Image de conteneur utilisée pour le déploiement |
cicd_enabled | Indique si le pipeline CI/CD est activé |
github_repository_url | URL du dépôt GitHub connecté pour le CI/CD |
kubernetes_ready | true lorsque le point de terminaison du cluster GKE est accessible et que toutes les ressources de charge de travail Kubernetes sont déployées. false lors du premier apply d'un nouveau cluster inline — relancez apply pour terminer le déploiement. |
Pièges de configuration et valeurs par défaut judicieuses
Niveaux de risque : Critique (perte de données, panne totale, faille de sécurité) — Élevé (service indisponible ou dégradation significative) — Moyen (fonction dégradée ou coût accru) — Faible (impact mineur).
| Variable | Valeur par défaut judicieuse | Risque | Conséquence d'une valeur incorrecte |
|---|---|---|---|
project_id | (obligatoire) | Critique | Pas de valeur par défaut — le déploiement échoue immédiatement. |
enable_redis | true | Critique | Redis est le courtier Celery. Le désactiver arrête tout traitement en arrière-plan. Les documents déposés dans le répertoire de consommation sont mis en file d'attente silencieusement mais jamais traités. L'interface web Paperless-ngx reste accessible mais n'affiche aucun nouveau document ingéré. |
redis_host | "" | Élevé | Se résout automatiquement en IP NFS. Si NFS est désactivé et qu'aucun hôte explicite n'est donné, Celery ne peut pas se connecter à son courtier et le pipeline de consommation échoue au démarrage. |
enable_nfs | true | Élevé | Requis lorsque redis_host est vide. La désactivation de NFS sans fournir d'hôte Redis explicite entraîne l'échec du démarrage de Celery. |
container_port | 8000 | Critique | Paperless-ngx gunicorn écoute sur 8000. Changer cela sans faire correspondre le port lié du conteneur entraîne l'échec immédiat de toutes les sondes de santé. |
memory_limit | "2Gi" | Élevé | Tesseract OCR charge les modèles linguistiques et les vignettes de documents en mémoire. Un sous-provisionnement (inférieur à 1Gi) provoque des arrêts OOM pendant le traitement des documents, en particulier pour les PDF multipages ou l'OCR multilingue. |
cpu_limit | "2000m" | Moyen | L'OCR est gourmand en CPU. Réduire en dessous de 1 vCPU ralentit considérablement l'OCR ; à 500m, les gros documents peuvent expirer avant que l'OCR ne soit terminé. |
timeout_seconds | 300 | Moyen | L'OCR sur de gros PDF peut prendre plusieurs minutes. Réduire en dessous de 120 secondes entraîne l'arrêt des requêtes OCR lentes par gunicorn. |
ocr_language | "eng" | Moyen | L'utilisation d'un pack de langue incorrect produit une sortie OCR illisible. La recherche en texte intégral et le marquage automatique basés sur le contenu du document ne fonctionneront pas correctement pour les documents non anglais, sauf si le pack de langue correct est spécifié. |
time_zone | "UTC" | Faible | Un fuseau horaire incorrect entraîne un décalage de plusieurs heures pour les dates de documents analysées à partir des noms de fichiers et des métadonnées. Les règles de classement basées sur la date et les tâches du planificateur s'exécutent à des moments inattendus. |
admin_email | "admin@example.com" | Moyen | Le compte administrateur initial est créé avec cet e-mail. Définissez une adresse réelle pour activer la récupération de mot de passe. |
db_name | "paperless" | Critique | Immuable après le déploiement — le modifier recrée la base de données et détruit toutes les métadonnées de documents, les balises, les correspondants et les règles de classement. |
db_user | "paperless" | Critique | Immuable après le déploiement — le modifier recrée l'utilisateur, invalide les identifiants et rompt la connexion à la base de données de Paperless-ngx. |
stateful_pvc_size | "10Gi" | Moyen | Si vous utilisez StatefulSet avec PVC pour le stockage local, 10 Gi peuvent se remplir rapidement avec des fichiers de travail OCR temporaires. Surveillez l'utilisation du disque et étendez si nécessaire. |
backup_retention_days | 7 | Moyen | Insuffisant pour les archives de documents sensibles à la conformité. Augmentez à 30-90 jours pour les déploiements de gestion de documents juridiques ou réglementaires. |
quota_memory_requests / quota_memory_limits | "" | Critique (spécifique à GKE) | Doit utiliser des suffixes binaires (Gi, Mi) lorsqu'il est défini. Les entiers bruts sont traités comme des octets et empêchent la planification de tous les pods. |
enable_pod_disruption_budget | false | Moyen | Le PDB est désactivé par défaut. Sans PDB, la maintenance des nœuds peut terminer tous les pods simultanément, interrompant le traitement OCR actif et entraînant la remise en file d'attente ou la perte de documents du pipeline. |
Guides associés
- Lab pratique : Paperless-ngx sur GKE Autopilot — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Paperless-ngx sur Google Cloud Run — la même application sur Cloud Run, lorsque vous avez besoin de l'autre cible de déploiement.
- Module de configuration partagée commune Paperless-ngx — la configuration partagée par les deux cibles de déploiement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.