Guide de préparation à la certification PCD : Section 4 — Intégration d'applications aux services Google Cloud (Integrating applications with Google Cloud services) (~21 % de l'examen)
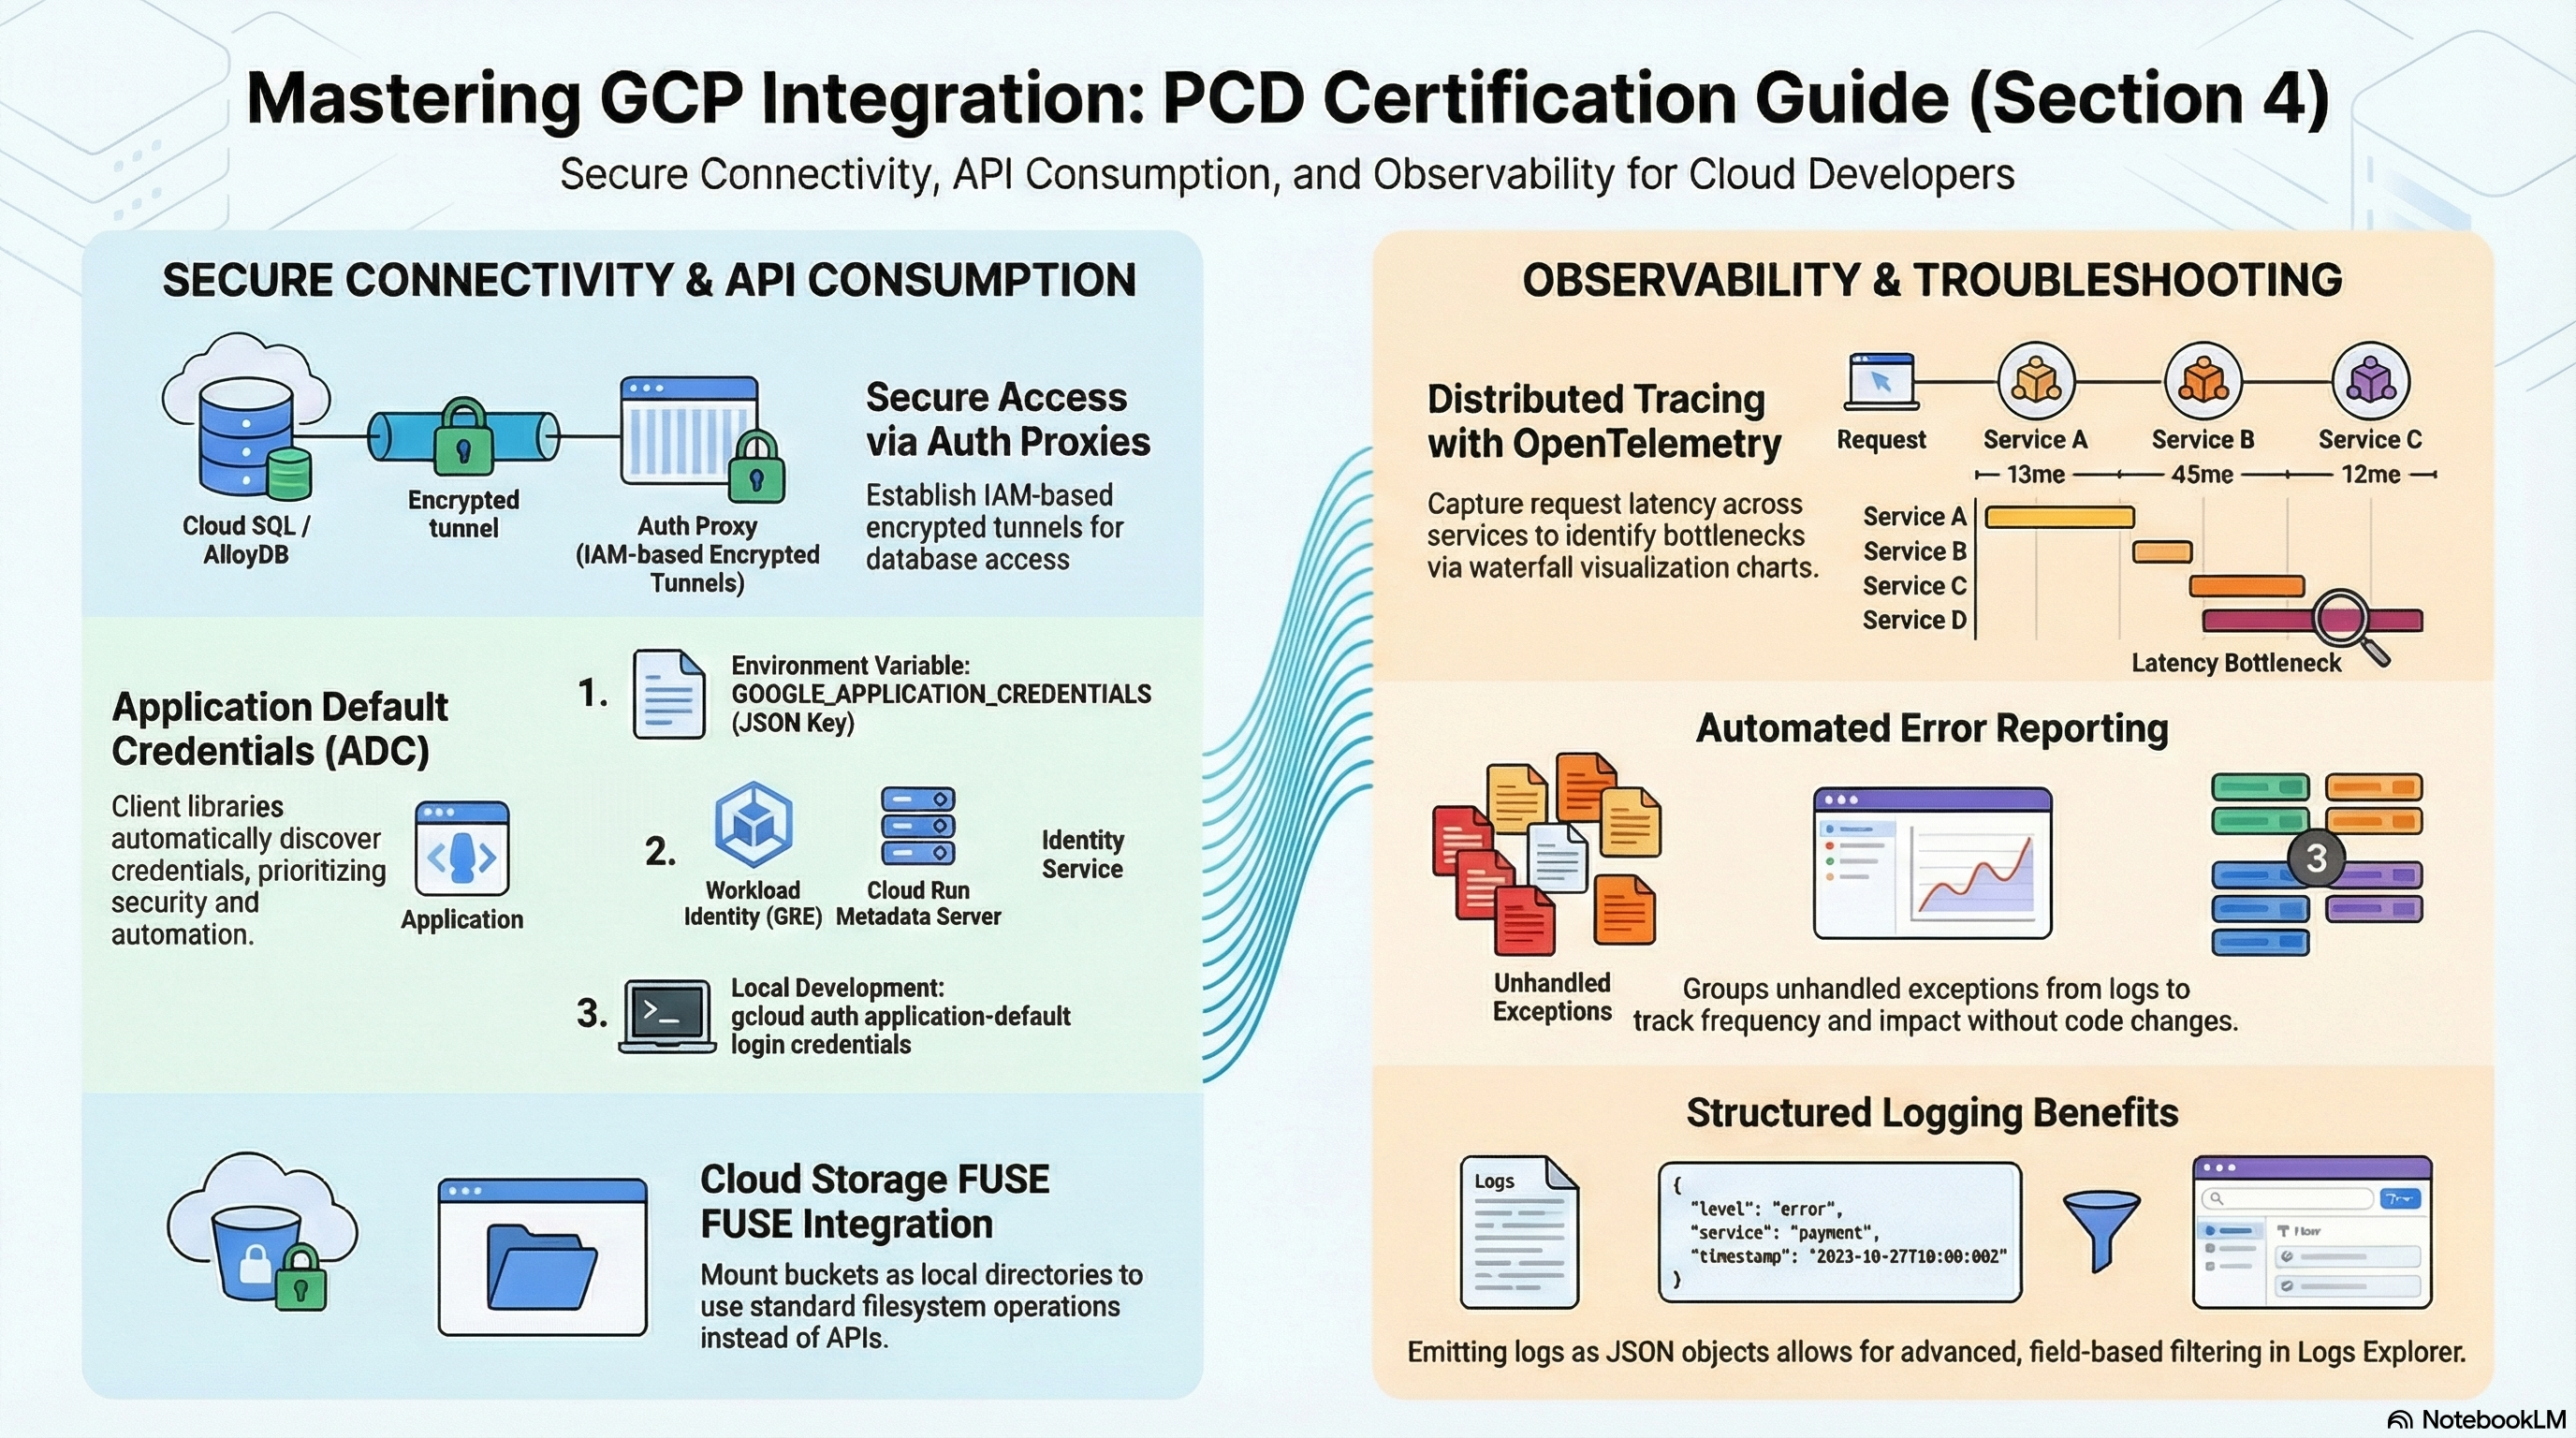
📚 Guide d'examen officiel : Professional Cloud Developer certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Cette section s'appuie sur les surfaces d'intégration que les modules de fondation câblent pour vous : la connectivité aux bases de données et la configuration à l'exécution (le service Cloud Run d'App_CloudRun et le sidecar du proxy sur GKE), l'identité (le câblage des comptes de service GKE, Workload Identity Federation dans Services_GCP et la couche IAM de la plateforme) et la surveillance (les couches de surveillance et de tableaux de bord de la plateforme). Déployez le profil Serverless baseline (socle serverless) ; ajoutez le profil Kubernetes lab (lab Kubernetes) pour les exercices Workload Identity (voir la carte des labs).
4.1 Intégration d'applications aux services de données et de stockage (Integrating applications with data and storage services)
⏱ ~60 min · 💰 aucun coût supplémentaire par rapport au profil déployé · ⚙️ Prérequis : Serverless baseline (Postgres et le volume Cloud SQL sont activés par défaut)
Pourquoi l'examen s'y intéresse — Les questions d'intégration sont concrètes : quelle chaîne de connexion le code utilise-t-il, d'où vient le mot de passe, de quel rôle IAM le compte de service a-t-il besoin, et que se passe-t-il à grande échelle (limites de connexions, comportement du proxy). Le modèle Cloud SQL Auth Proxy — authentifié par IAM, chiffré en TLS, sans liste d'adresses IP autorisées — est la réponse canonique, et vous devez connaître à la fois sa forme Cloud Run (volume de socket géré) et sa forme GKE (conteneur sidecar).
Comment RAD l'implémente —
Connectivité aux bases de données. Sur Cloud Run, enable_cloudsql_volume (par défaut true) rattache le volume Cloud SQL géré, monté sur cloudsql_volume_mount_path (par défaut /cloudsql) ; l'application se connecte via le socket Unix /cloudsql/<project>:<region>:<instance>. Sur GKE, le même indicateur injecte un sidecar cloud-sql-proxy (image mise en miroir dans Artifact Registry, démarrée avec --private-ip, arrêt progressif en preStop via /quitquitquit) et l'application se connecte à localhost. Désactivez l'indicateur pour vous connecter directement par IP privée — le module définit alors DB_HOST sur l'adresse privée de l'instance.
Injection de configuration à l'exécution. App_CloudRun assemble les variables d'environnement que voit le conteneur, sans qu'aucun code n'ait à connaître Terraform : APP_NAME, APP_VERSION, DB_NAME, DB_USER, DB_PORT, DB_HOST (chemin du socket ou IP privée), CLOUDRUN_SERVICE_URL, plus NFS_SERVER_IP lorsque NFS est activé et REDIS_HOST/REDIS_PORT/REDIS_URL lorsque enable_redis est actif. Le mot de passe n'apparaît jamais en clair : DB_PASSWORD arrive sous forme de référence Secret Manager. Tous les noms de variables d'environnement sont remplaçables (db_password_env_var_name, db_host_env_var_name, etc.), de sorte que les images d'applications existantes n'ont besoin d'aucune modification.
Cycle de vie du schéma et des données. initialization_jobs (par défaut : un job db-init exécutant un script d'initialisation de base de données sur postgres:15-alpine avec execute_on_apply = true) prend en charge les migrations et l'amorçage des données, ordonnancés par depends_on_jobs. enable_backup_import restaure un dump depuis GCS ou Google Drive (backup_source, backup_file, backup_format) ; enable_postgres_extensions/enable_mysql_plugins installent des extensions de base de données ; enable_custom_sql_scripts exécute du SQL arbitraire depuis un bucket. Services_GCP propose en outre enable_cloudsql_iam_auth (par défaut false), qui définit l'indicateur de base de données d'authentification IAM (cloudsql.iam_authentication sur PostgreSQL, cloudsql_iam_authentication sur MySQL) et accorde roles/cloudsql.instanceUser — l'authentification IAM à la base de données sans mot de passe que mentionne l'examen.
Intégration des fichiers et des objets. gcs_volumes monte des buckets via GCS Fuse (sémantique de système de fichiers ; gen2 uniquement), enable_nfs (par défaut true) monte l'export NFS partagé sur /mnt/nfs pour des écritures partagées entre instances, et storage_buckets provisionne des buckets avec roles/storage.objectAdmin par bucket pour le compte de service de l'application — le chemin des bibliothèques clientes.
À vous de jouer
-
Voyez exactement ce que voit votre code :
gcloud run services describe <service-name> --region=us-central1 \
  --format="yaml(spec.template.spec.containers[0].env, spec.template.spec.containers[0].volumeMounts)"
Repérez
DB_HOST(un chemin/cloudsql/...), la référence de secretDB_PASSWORDet les montages de volumes. -
Vérifiez l'IAM qui fait fonctionner le proxy — le compte de service a besoin de
roles/cloudsql.client:gcloud projects get-iam-policy <project-id> \
--flatten="bindings[].members" \
--filter="bindings.members~cloudrun-sa" \
--format="table(bindings.role)" -
Observez l'exécution du job d'initialisation par défaut et lisez ses journaux :
gcloud run jobs executions list --job=<db-init-job-name> --region=us-central1
gcloud logging read 'resource.type="cloud_run_job"' --limit=20 -
Sur le profil GKE, confirmez la présence du sidecar :
kubectl -n <namespace> get pod <pod> -o jsonpath='{.spec.containers[*].name}'doit lister votre application etcloud-sql-proxy. -
Vous savez que cela a fonctionné lorsque le conteneur de l'application résout
DB_HOSTvers le chemin du socket, que l'exécution de db-init afficheSucceededet que le pod GKE exécute deux conteneurs.
Testez-vous
Q1 : Cloud Run est monté à 50 instances et Postgres a commencé à refuser des connexions. L'instance utilise les indicateurs par défaut du module. Que s'est-il passé, et quelles sont les corrections ?
R : Chaque instance détient son propre pool ; 50 instances × même un petit pool dépassent l'indicateur par défaut max_connections=200 défini sur l'instance Postgres de RAD. Corrections, dans l'ordre de l'examen : plafonner max_instance_count, réduire le pool par instance, augmenter max_connections (coûte de la mémoire) ou introduire un pooling côté serveur. L'Auth Proxy authentifie et chiffre — il ne gère pas le pooling à votre place.
Q2 : Pourquoi la plateforme exécute-t-elle les migrations de schéma sous forme de job Cloud Run plutôt qu'au démarrage du service ?
R : Un service peut monter à N instances simultanées — exécuter les migrations dans le point d'entrée met N copies en concurrence et ralentit les démarrages à froid. Un job (initialization_jobs avec execute_on_apply) exécute exactement task_count tâches une seule fois, peut être ordonnancé avec depends_on_jobs, relancé indépendamment (max_retries), et garde le chemin de service rapide. Cette séparation entre « exécution unique » et « service » est une réponse de conception PCD classique.
Q3 : Une application a besoin d'un stockage partagé accessible en écriture par toutes les instances Cloud Run. Comparez les deux options RAD.
R : enable_nfs monte un véritable système de fichiers POSIX (Filestore ou la VM NFS de la plateforme) — adapté aux applications qui ont besoin de la sémantique de verrouillage/renommage de fichiers, mais il constitue un point unique de capacité et de débit. gcs_volumes (GCS Fuse) adosse le montage à un stockage objet — pratiquement illimité et moins cher, mais les écritures sont des envois d'objets (pas d'écritures partielles ni de verrouillage). Les deux exigent execution_environment = "gen2".
Au-delà des modules — Les modules ne créent aucun chemin de code de messagerie applicative ou de base documentaire : entraînez-vous à écrire des applications qui publient et consomment avec les bibliothèques clientes Pub/Sub (publication avec attributs et paramètres de traitement par lots, abonnements pull ou push, délais d'accusé de réception, clés d'ordonnancement, sujets de lettres mortes, consommateurs idempotents), à utiliser le SDK Firestore (documents, requêtes nécessitant des index composites, écouteurs en temps réel, transactions) et les modèles de bibliothèque cliente Cloud Storage, y compris les URL signées pour l'envoi et le téléchargement directs depuis le navigateur. Le seul Pub/Sub de la plateforme est interne (sujets de rotation des secrets et de SCC) — utile à inspecter (gcloud pubsub topics list), mais pas un modèle applicatif.
⚠️ Piège d'examen — Le Cloud SQL Auth Proxy remplace les listes d'autorisation réseau et la gestion des certificats TLS, pas l'authentification à la base de données : le code présente toujours un utilisateur et un mot de passe de base de données (sauf si l'authentification IAM à la base de données est activée). « Nous avons ajouté le proxy, pourquoi avons-nous encore besoin du mot de passe ? » distingue roles/cloudsql.client (connexion) de roles/cloudsql.instanceUser + l'authentification IAM (identification).
4.2 Utilisation des API Google Cloud (Consuming Google Cloud APIs)
⏱ ~60 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : Serverless baseline ; profil Kubernetes lab pour Workload Identity ;
enable_workload_identity_federation = truedans Services_GCP pour les étapes WIF
Pourquoi l'examen s'y intéresse — Le guide actuel énumère trois compétences pour 4.2 : activer des services Google Cloud, effectuer des appels d'API avec les options prises en charge (Cloud Client Libraries, REST, gRPC, API Explorer) en regroupant les requêtes par lots, en restreignant les données renvoyées, en paginant, en mettant les résultats en cache et en gérant les erreurs avec un backoff exponentiel, et utiliser des comptes de service pour effectuer des appels aux API Cloud. La plupart des scénarios d'appel aux API Google se ramènent à l'identité : le code doit utiliser les Application Default Credentials adossés au compte de service de l'environnement d'exécution — jamais des fichiers de clé JSON. Vous devez savoir comment ADC se résout sur Cloud Run (serveur de métadonnées), sur GKE (Workload Identity), sur les machines des développeurs (gcloud auth application-default login) et entièrement en dehors de Google Cloud (Workload Identity Federation). Le second axe est l'autorisation : des rôles au moindre privilège sur la ressource (un secret précis, un bucket précis), pas sur le projet.
Comment RAD l'implémente —
Comptes de service dédiés. Services_GCP crée cloudrun-sa-{prefix}, cloudbuild-sa-{prefix}, clouddeploy-sa-{prefix}, gke-sa-{prefix} et nfs-sa-{prefix} — rien ne s'exécute sous le compte de service Compute par défaut. La couche IAM de la plateforme applique le moindre privilège au niveau de la ressource : roles/secretmanager.secretAccessor accordé par secret, roles/storage.objectAdmin par bucket, et roles/iam.serviceAccountUser pour les chaînes d'emprunt d'identité dont le déployeur a besoin. Lorsque votre application a besoin de davantage (par exemple Firestore), additional_cloudrun_sa_roles étend de manière déclarative la liste des rôles du compte de service Cloud Run.
Workload Identity sur GKE. App_GKE crée un ServiceAccount Kubernetes par espace de noms, annoté iam.gke.io/gcp-service-account: <gsa-email>, et lie roles/iam.workloadIdentityUser à serviceAccount:{project}.svc.id.goog[<namespace>/<ksa>]. Les pods qui utilisent ce KSA obtiennent du serveur de métadonnées des jetons adossés au GSA — ADC fonctionne sans aucun fichier de clé, avec un code identique à celui de Cloud Run.
Workload Identity Federation. Services_GCP (enable_workload_identity_federation, par défaut false) crée le pool wif-pool avec un fournisseur choisi par wif_provider_type (par défaut "github" → fournisseur github-actions ; également gitlab → gitlab-ci, ou generic pour n'importe quel émetteur OIDC). Toutes les identités du pool (principalSet://.../*) peuvent emprunter l'identité des comptes de service Cloud Build, Cloud Deploy et Cloud Run via roles/iam.workloadIdentityUser — une CI sans clé depuis des systèmes externes, le remplacement des clés exportées que recommande l'examen.
Autorisation entre services. L'accès à Cloud Run repose sur l'IAM de roles/run.invoker : les services publics reçoivent une liaison allUsers ; les services IAP accordent à la place le droit invoker à l'agent de service IAP, et roles/iap.httpsResourceAccessor à vos comptes principaux. Appeler un service non public depuis un autre service implique de générer un jeton d'identité pour le compte de service de l'appelant — les modules établissent la structure IAM ; le code de récupération du jeton est à vous d'apprendre.
À vous de jouer
-
Vérifiez l'identité d'exécution depuis l'intérieur du service déployé (aucun SDK requis — c'est ce que fait ADC en coulisses) :
# from your workstation, against the metadata-backed identity:
gcloud run services describe <service-name> --region=us-central1 \
--format="value(spec.template.spec.serviceAccountName)" -
Sur GKE, inspectez le câblage de Workload Identity :
kubectl -n <namespace> get sa -o yaml | grep -B2 "iam.gke.io/gcp-service-account"
gcloud iam service-accounts get-iam-policy <gsa-email> \
  --format="table(bindings.role, bindings.members)"
Vous devez voir la liaison
roles/iam.workloadIdentityUserpourserviceAccount:<project>.svc.id.goog[<ns>/<ksa>]. -
Inspectez le pool WIF et son fournisseur, puis testez l'application du rôle invoker :
gcloud iam workload-identity-pools providers list \
  --workload-identity-pool=wif-pool --location=global
gcloud run services get-iam-policy <service-name> --region=us-central1
curl -s -o /dev/null -w "%{http_code}\n" \
-H "Authorization: Bearer $(gcloud auth print-identity-token)" https://<service-url>/ -
Vous savez que cela a fonctionné lorsque l'annotation du KSA correspond au GSA dont la stratégie contient la liaison workloadIdentityUser, et que le curl authentifié renvoie 200 là où un appel anonyme est refusé (sur un service non public).
Testez-vous
Q1 : Le service A sur Cloud Run doit appeler le service privé B. Quel rôle, sur quoi, pour qui — et quel type de jeton A envoie-t-il ?
R : Accordez au compte de service de A le rôle roles/run.invoker sur le service B (au niveau de la ressource, pas du projet). A récupère un jeton d'identité dont l'audience est l'URL de B (depuis le serveur de métadonnées, par exemple via la bibliothèque cliente ou fetch_id_token) et l'envoie dans un en-tête Bearer. Un jeton d'accès OAuth est la mauvaise réponse — le contrôle IAM de Cloud Run valide des jetons d'identité.
Q2 : GitHub Actions doit pousser des images et créer des releases Cloud Deploy sans clé téléchargée. Quelle configuration RAD constitue la mise en place de référence ?
R : enable_workload_identity_federation = true avec wif_provider_type = "github". Le workflow échange son jeton OIDC GitHub via le pool wif-pool / le fournisseur github-actions et emprunte l'identité de cloudbuild-sa-*/clouddeploy-sa-* (le module lie roles/iam.workloadIdentityUser pour le pool). Aucun identifiant de longue durée n'existe nulle part ; notez que le principalSet générique du module est volontairement large — les réponses de production le limitent à attribute.repository.
Q3 : Les appels aux API Google d'un pod s'exécutent sous l'identité du nœud au lieu du GSA de l'application. Que manque-t-il ?
R : L'un des trois éléments de Workload Identity : le pool de charges de travail du cluster, l'annotation KSA iam.gke.io/gcp-service-account, ou la liaison roles/iam.workloadIdentityUser sur le GSA pour {project}.svc.id.goog[ns/ksa] — ou bien la spécification du pod n'utilise pas le KSA annoté (serviceAccountName). Le module RAD câble les trois ; à l'examen, la liaison IAM manquante est le coupable le plus fréquent.
Au-delà des modules — Entraînez-vous aux mécanismes des bibliothèques clientes que les modules ne peuvent pas montrer : relances automatiques avec backoff exponentiel (intégrées aux bibliothèques pour les codes 429/503), itérateurs de pagination et jetons de page, restriction des données renvoyées avec des masques de champs (fields= / $fields) et des réponses partielles, requêtes par lots (par exemple le point de terminaison batch de l'API JSON Cloud Storage, le traitement par lots de l'éditeur Pub/Sub), mise en cache des résultats relus (ETags, un cache Memorystore), choix entre les transports gRPC et REST, et essai des appels dans API Explorer avant de les coder. Étudiez aussi l'activation des services (gcloud services enable <api>.googleapis.com) et les échecs liés à l'activation des API (erreurs 403 SERVICE_DISABLED — la plateforme pré-active ses API, un projet neuf ne le fait pas) ainsi que les erreurs de quota (RESOURCE_EXHAUSTED 429 → backoff ou augmentation de quota, pas des tempêtes de relances).
⚠️ Piège d'examen — Jetons d'accès ou jetons d'identité : gcloud auth print-access-token autorise les appels aux API Google ; gcloud auth print-identity-token vous authentifie auprès d'un service (invoker Cloud Run, IAP). Les intervertir produit des erreurs 401 qui ressemblent à un IAM manquant, sans en être.
4.3 Dépannage et observabilité (Troubleshooting and observability)
⏱ ~60 min · 💰 faible — les alertes et les tableaux de bord sont gratuits à cette échelle ; le stockage des journaux augmente si vous activez les journaux d'audit DATA_READ · ⚙️ Prérequis : n'importe quel profil déployé ; définissez
support_userspour recevoir les notifications
Pourquoi l'examen s'y intéresse — Les questions de dépannage du PCD vous présentent un symptôme (pic de 5xx, régression de latence, boucle de plantages) et attendent que vous choisissiez le bon outil dans le bon ordre : Logs Explorer avec des filtres par type de ressource, métriques et alertes, tableaux de bord, puis outils au niveau du code (Trace, Error Reporting). Le guide actuel cite l'instrumentation du code avec des métriques, des journaux et des traces dans Google Cloud Observability, la gestion des problèmes avec Error Reporting, l'utilisation des ID de trace pour corréler les spans entre services, et l'observabilité assistée par l'IA. La journalisation structurée et l'instrumentation sont des responsabilités du développeur que l'examen évalue directement.
Comment RAD l'implémente — Les conteneurs journalisent sur stdout/stderr, et Cloud Run/GKE transfèrent automatiquement vers Cloud Logging — rien à configurer. Les modules ajoutent la couche d'alertes via la couche de surveillance de la plateforme :
support_userscrée des canaux de notification par e-mail ; les ressources de surveillance ne sont créées que lorsquesupport_users,alert_policiesou une configuration de test de disponibilité activée existe.- Alertes intégrées : utilisation du CPU > 0,9 et utilisation de la mémoire > 0,9 (alignées sur le P99 sur 60s), filtrées sur votre service précis (
resource.labels.service_namesur Cloud Run ; le module GKE transmet des filtres limités à Kubernetes). alert_policiesajoute des règles personnalisées de manière déclarative : chaque entrée est de la forme{ name, metric_type, comparison, threshold_value, duration_seconds, aggregation_period }et le module limite le filtre au service déployé — par exemplerun.googleapis.com/request_latenciesavecCOMPARISON_GTetthreshold_value = 1000.- La plateforme provisionne un tableau de bord Cloud Monitoring par déploiement (mises en page distinctes pour Cloud Run et GKE).
uptime_check_config(par défaut{ enabled = false, path = "/" }— définissezenabled = truepour en provisionner un ;check_intervalpar défaut"60s",timeoutpar défaut"10s") provisionne un véritable test de disponibilité Cloud Monitoring nommé<service>-uptime-check(HTTP GET depuis plusieurs régions du monde) plus une règle<service>-uptime-check-alertsurmonitoring.googleapis.com/uptime_check/check_passed(déclenchée après 300s d'échec, notifie les canaux desupport_users). Sa création est conditionnée, au moment du plan, à l'accessibilité publique — sur Cloud Run, le test sonde la première entrée deapplication_domains, à défaut l'hôte nip.io de l'équilibreur de charge, à défaut l'URL run.app lorsqueingress_settings = "all"; sur GKE, il sonde le domaine personnalisé via la Gateway (HTTPS:443) ou l'IP d'entrée du Service LoadBalancer en HTTP surservice_port. Les déploiements internes uniquement n'ont pas de test, etuptime_check_namesrenvoie le nom du test créé.
À vous de jouer
-
Générez un peu de trafic et lisez les journaux à la manière d'un développeur :
gcloud logging read \
  'resource.type="cloud_run_revision" AND resource.labels.service_name="<service-name>" AND severity>=WARNING' \
  --limit=20 --format="value(timestamp, severity, textPayload)"
Dans Console > Logging > Logs Explorer, refaites l'opération avec le générateur de requêtes et notez que les lignes de journal JSON deviennent des champs
jsonPayload.*filtrables — émettez des journaux structurés depuis votre application pour en bénéficier gratuitement. -
Ajoutez une alerte de latence via le portail :
alert_policies = [{ name = "p-latency", metric_type = "run.googleapis.com/request_latencies", comparison = "COMPARISON_GT", threshold_value = 1000, duration_seconds = 300 }], appliquez, puis vérifiez :gcloud alpha monitoring policies list --format="table(displayName, enabled)"
gcloud monitoring dashboards list --format="value(displayName)" -
Inspectez le test de disponibilité créé par le module (déploiements accessibles publiquement uniquement) et confirmez que l'hôte sondé correspond à votre domaine ou à votre équilibreur de charge :
gcloud monitoring uptime list-configs --format="table(displayName, httpCheck.path, period)"
gcloud monitoring uptime describe <service-name>-uptime-check -
Provoquez une erreur (par exemple en faisant temporairement pointer
health_check_config.pathvers un chemin inexistant) et observez les redémarrages dus à la sonde de vivacité dans Cloud Run > service > Logs ainsi que les graphiques CPU/mémoire du tableau de bord créé par le module. -
Vous savez que cela a fonctionné lorsque la règle d'alerte apparaît avec votre canal e-mail rattaché, et que le test de disponibilité créé par le module s'affiche en vert depuis plusieurs régions dans Monitoring > Uptime checks.
Testez-vous
Q1 : Des utilisateurs signalent des erreurs 503 intermittentes, mais les journaux de votre application ne montrent rien à ces horodatages. Où regardez-vous ensuite sur Cloud Run ?
R : Dans les journaux de requêtes et les métriques de la plateforme, pas dans les journaux de l'application : filtrez resource.type="cloud_run_revision" AND httpRequest.status=503 — des 503 sans journal applicatif signifient généralement que la requête n'a jamais atteint votre code (échecs de démarrage d'instance, max_instance_count dépassé sous la charge, ou délai d'expiration de requête/échecs de sonde). Corrélez avec container/instance_count et les échecs de la sonde de démarrage ; augmenter max_instance_count ou corriger la sonde de démarrage est la correction habituelle.
Q2 : Une alerte doit se déclencher lorsque le taux d'erreurs dépasse 5 % pendant 5 minutes, en notifiant la liste d'astreinte. Associez cela aux variables RAD.
R : Placez les adresses d'astreinte dans support_users (crée les canaux de notification) et ajoutez une entrée alert_policies sur run.googleapis.com/request_count filtrée sur les 5xx — mais pour un ratio, la réponse honnête est que les règles à seuil sur une seule métrique du module ne peuvent pas l'exprimer ; vous construiriez une condition basée sur un ratio (MQL/PromQL) directement dans Cloud Monitoring. Savoir quand de simples seuils déclaratifs ne suffisent plus est en soi pertinent pour l'examen.
Q3 : Le paiement prend 4s ; l'équipe base de données jure que ses requêtes sont rapides. Quel outil prouve où passe le temps entre vos deux services Cloud Run ?
R : Cloud Trace avec propagation du contexte de trace distribuée — instrumentez les deux services avec OpenTelemetry (exportateur Cloud Trace), propagez l'en-tête traceparent lors de l'appel entre services, et lisez la cascade pour voir quel span (gestionnaire, appel en aval, requête de base de données) porte la latence. Les journaux et les métriques agrègent ; seul le traçage montre la décomposition requête par requête.
Au-delà des modules — Rien dans les modules n'instrumente le code applicatif : étudiez la mise en place d'OpenTelemetry et la propagation des traces (Cloud Trace), l'écriture de l'ID de trace dans les entrées de journal structurées (logging.googleapis.com/trace) afin que Logs Explorer corrèle les lignes de journal avec les spans entre services, le regroupement automatique des traces de pile d'Error Reporting (fonctionne à partir des journaux stdout pour les principaux environnements d'exécution) et la gestion de ses problèmes (accuser réception, résoudre, mettre en sourdine, notifications), les métriques basées sur les journaux pour alerter sur des motifs de journaux, et l'observabilité assistée par l'IA — Gemini Cloud Assist qui explique des entrées de journal et aide à investiguer un problème depuis la console. Profiler (google-cloud-profiler) n'est plus cité dans le guide, mais reste un outil utile. Essayez aussi la surveillance des SLO intégrée à Cloud Run (Cloud Run > service > SLOs) — rien de tout cela n'est provisionné par la plateforme.
⚠️ Piège d'examen — Ne supposez pas qu'une variable d'entrée implique une ressource provisionnée — vérifiez toujours dans le code source (les versions antérieures de la plateforme acceptaient uptime_check_config sans créer aucun test ; aujourd'hui, elle en provisionne un, mais uniquement pour les points de terminaison accessibles publiquement). À l'examen, le piège analogue consiste à supposer que Cloud Run « dispose » du traçage/profilage parce que l'agent pourrait s'exécuter — Trace obtient des spans automatiques pour les requêtes entrantes, mais la propagation entre services et les spans personnalisés exigent que vous instrumentiez le code.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.