Guide de préparation à la certification PCD : Section 1 — Conception d'applications cloud natives hautement évolutives, sécurisées et fiables (Designing highly scalable, secure, and reliable cloud-native applications) (~32 % de l'examen)
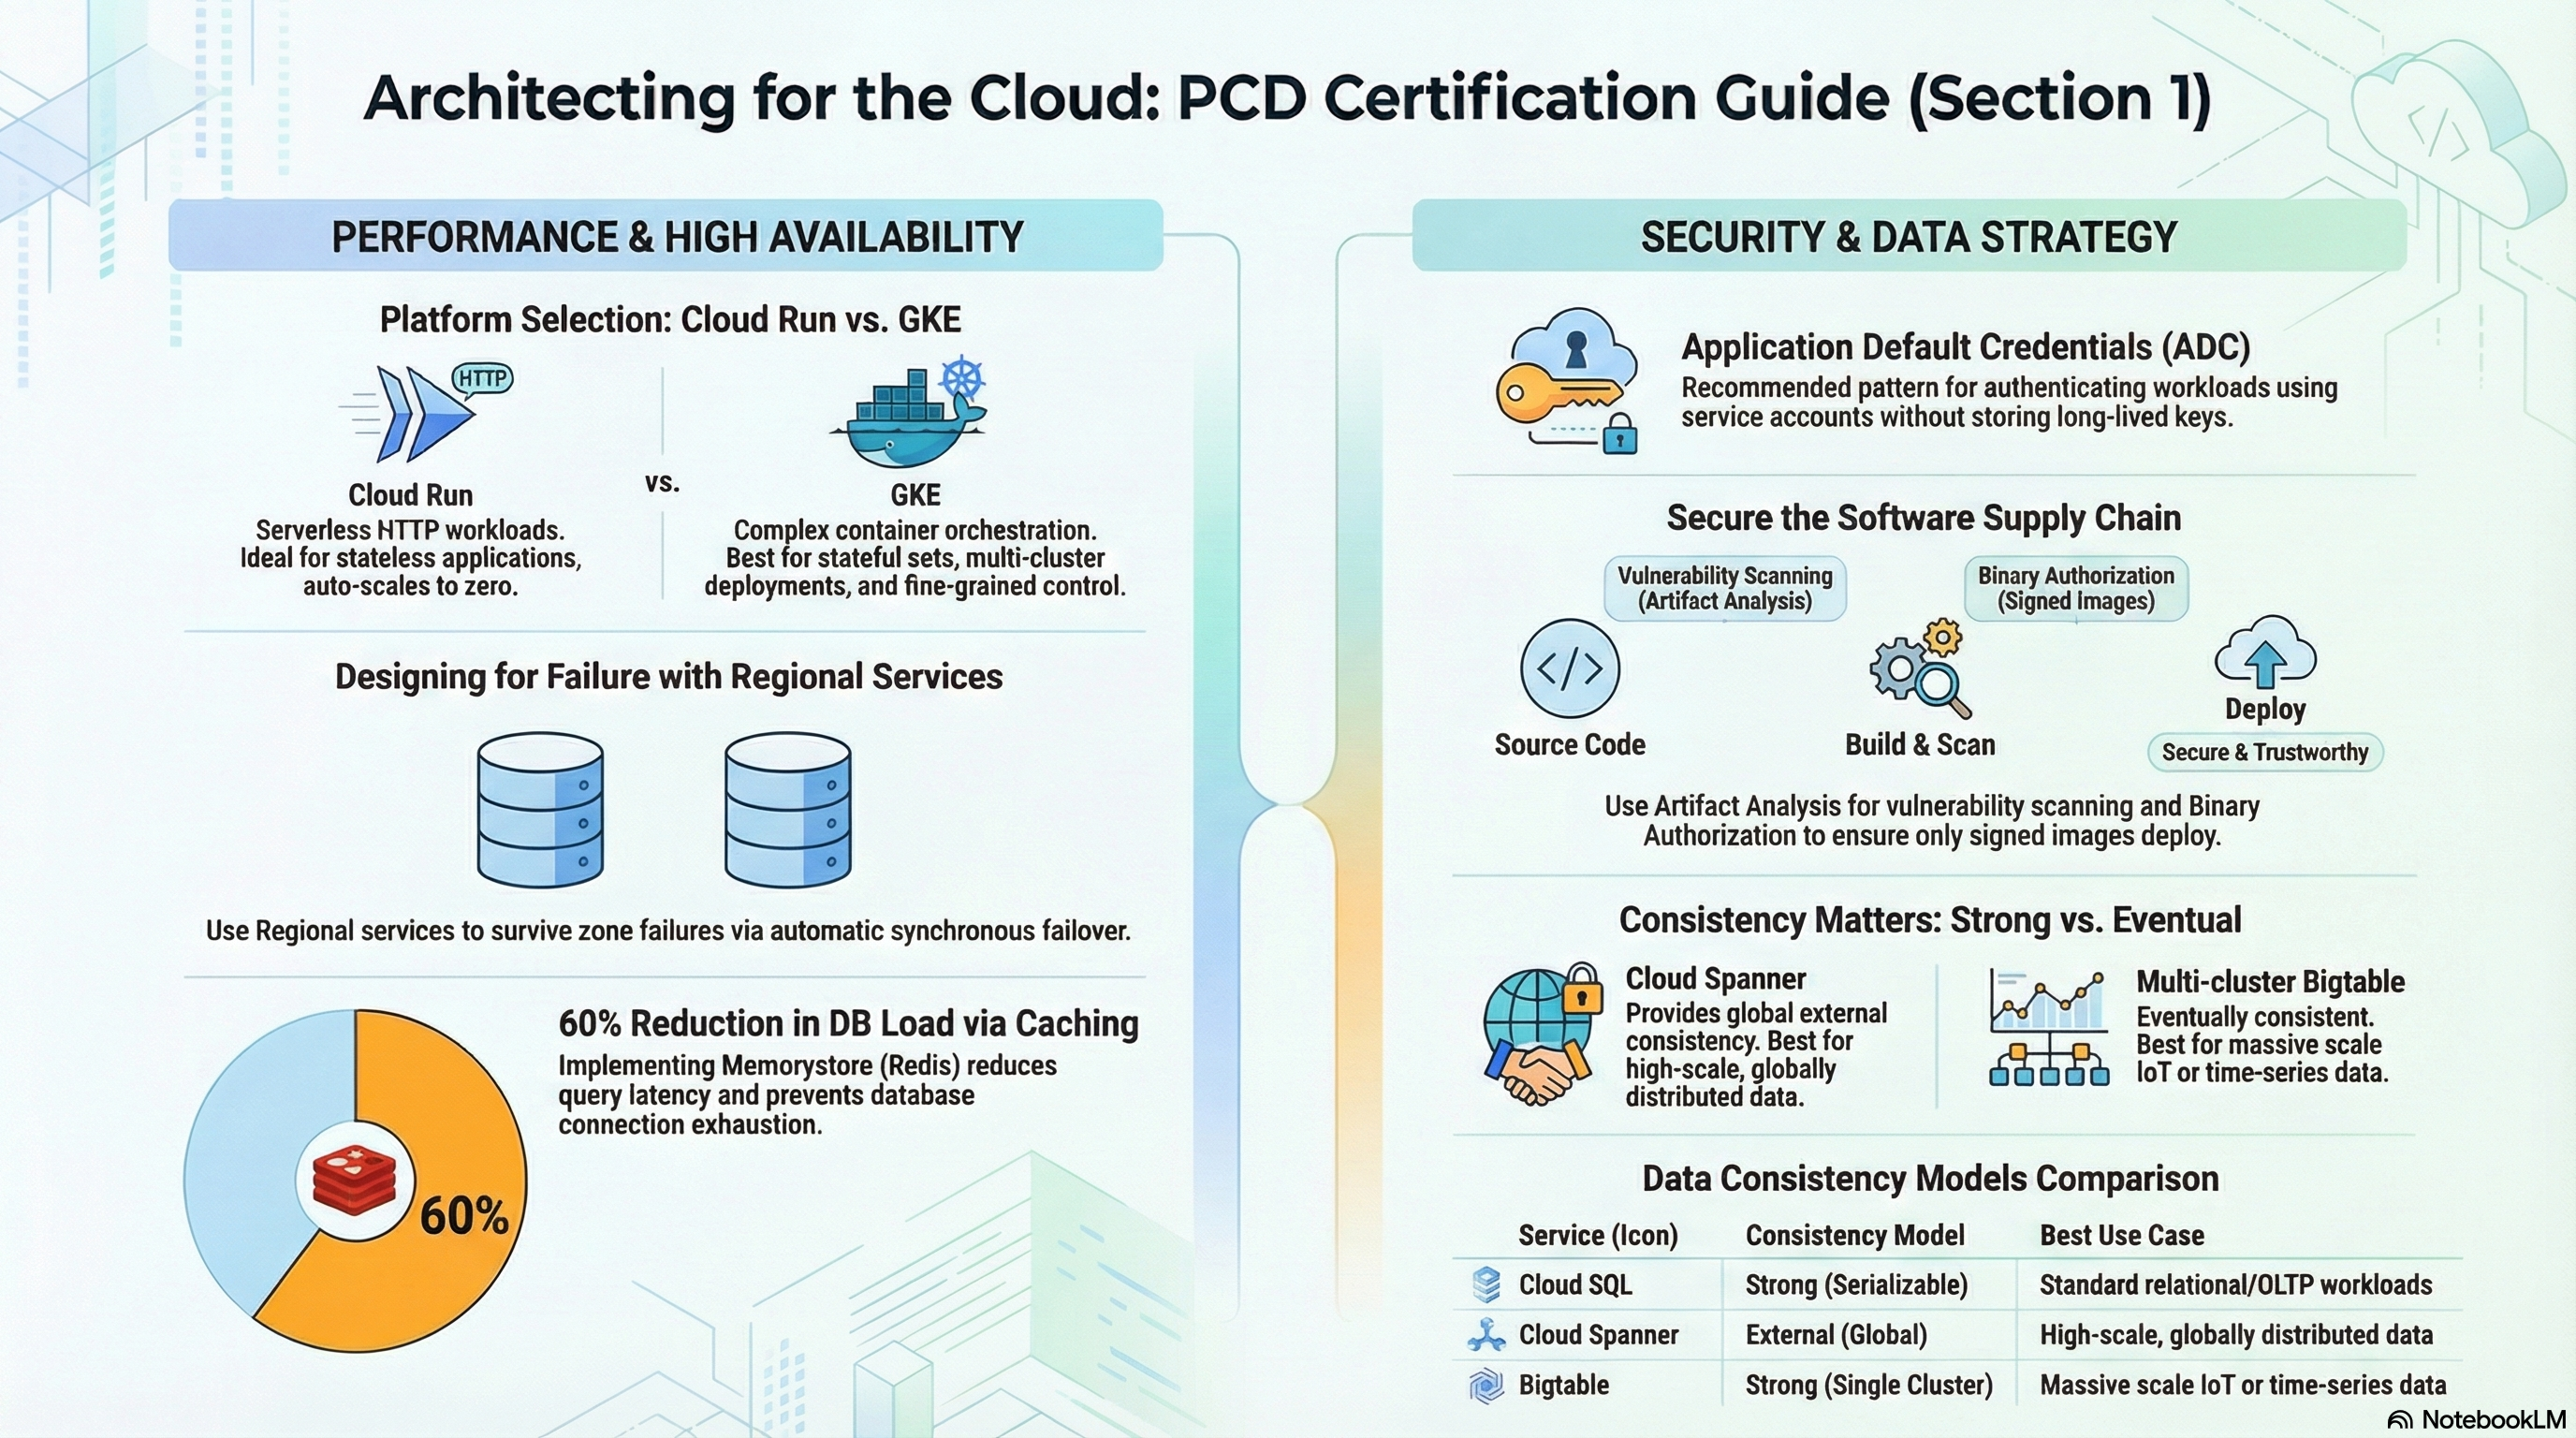
Ce guide couvre la plus importante section de l'examen PCD à l'aide des modules de fondation de la plateforme RAD. Vous mettrez en pratique App_CloudRun (conception de services Cloud Run v2), App_GKE (conception de charges de travail Kubernetes) et Services_GCP (l'infrastructure partagée de base de données, de cache et de sécurité). Déployez le profil Serverless baseline (socle serverless) de la carte des labs avant de commencer ; ajoutez le profil Hardened edge (périphérie renforcée) pour 1.1 (mise en cache/CDN) et 1.2 (IAP, rotation).
1.1 Conception d'applications et d'API performantes (Designing high-performing applications and APIs)
⏱ ~90 min · 💰 faible (valeurs par défaut avec mise à l'échelle jusqu'à zéro) ; Memorystore et l'équilibreur de charge global sont facturés en continu s'ils sont activés · ⚙️ Prérequis : Serverless baseline ; Hardened edge pour les étapes CDN/Redis
Pourquoi l'examen s'y intéresse — Les scénarios PCD vous demandent sans cesse de choisir entre Cloud Run et GKE, puis d'ajuster la plateforme retenue : quand min_instances > 0 est-il préférable à l'acceptation des démarrages à froid, quand la limitation du CPU entre les requêtes est-elle acceptable, comment déployer une nouvelle révision en canary sans redéployer, et où placer un cache ou un CDN sur le chemin des requêtes. Les critères de décision opposent coût, latence et contrôle opérationnel : Cloud Run pour les charges de travail requête/réponse sans état au trafic irrégulier, GKE pour les charges de travail qui nécessitent des sidecars que vous contrôlez, des StatefulSets ou une mise en réseau fine des pods.
Comment RAD l'implémente — Les deux modules de fondation exposent le même vocabulaire de mise à l'échelle, avec des valeurs par défaut adaptées à chaque plateforme :
| Variable | Valeur par défaut App_CloudRun | Valeur par défaut App_GKE | Ce qu'elle contrôle |
|---|---|---|---|
min_instance_count | 0 (mise à l'échelle jusqu'à zéro) | 1 | plancher de mise à l'échelle / minReplicas du HPA |
max_instance_count | 1 | 3 | plafond de mise à l'échelle / maxReplicas du HPA |
container_resources | cpu_limit = "1000m", memory_limit = "512Mi" | identique | ressources par instance/pod |
timeout_seconds | 300 (0–3600) | 300 | délai d'expiration de la requête / du backend de l'équilibreur |
Leviers de performance propres à Cloud Run :
cpu_always_allocated(par défautfalse, c'est-à-dire facturation à la requête) — définisseztruepour conserver le CPU alloué entre les requêtes (planificateurs, workers de file d'attente, serveurs WebSocket). Le boost CPU au démarrage est toujours actif, tout comme l'affinité de session pour le service.execution_environment(par défaut"gen2") — des validations au moment du plan exigent gen2 pour les montages NFS (enable_nfs) et GCS Fuse (gcs_volumes).traffic_split(par défaut[]= 100 % vers la dernière révision) accepte une liste d'entrées{ type, revision, percent, tag }oùtypevautTRAFFIC_TARGET_ALLOCATION_TYPE_LATESTouTRAFFIC_TARGET_ALLOCATION_TYPE_REVISION; la validation impose que la somme des pourcentages soit exactement 100. Letagfacultatif donne à une révision une URL d'aperçu stable.max_revisions_to_retain(par défaut7) supprime automatiquement les anciennes révisions ; les révisions qui reçoivent du trafic ne sont jamais supprimées.- La concurrence des requêtes par instance n'est pas exposée — le service utilise la valeur par défaut de Cloud Run (80 requêtes simultanées par instance).
container_protocol(par défaut"http1") définit le port nommé du service Cloud Run :"h2c"fait passer Cloud Run en HTTP/2 en clair de bout en bout — indispensable pour les services gRPC (gRPC repose sur HTTP/2) et utile pour les charges de travail de streaming ou à grosses charges utiles. Le conteneur doit servir du HTTP/2 en clair sur le port du conteneur. Sur GKE, la même variable annonceappProtocol kubernetes.io/h2csur le port du Service, afin que les backends Gateway/Ingress communiquent en HTTP/2 avec les pods.
Sur GKE, la plateforme ne crée un HorizontalPodAutoscaler que lorsque max_instance_count > 1 et enable_vertical_pod_autoscaling = false, avec une cible de 70 % d'utilisation du CPU et de 80 % de la mémoire.
Mise en cache : Services_GCP provisionne Memorystore avec create_redis (par défaut false), redis_tier (par défaut BASIC, ou STANDARD_HA), redis_memory_size_gb (par défaut 1), avec AUTH activé. Côté application, enable_redis (par défaut true dans App_CloudRun) injecte les variables d'environnement REDIS_HOST/REDIS_PORT (et REDIS_URL lorsqu'elle peut être dérivée) — définissez redis_host sur l'IP de Memorystore, sinon le module se rabat sur le Redis de la VM NFS partagée. CDN : enable_cdn (par défaut false) place obligatoirement le service derrière un Application Load Balancer externe global (le paramètre d'entrée est automatiquement remplacé par internal-and-cloud-load-balancing).
Équilibrage de charge et affinité de session : Cloud Run n'a besoin d'aucun équilibreur de charge pour un service de base ; les modules n'ajoutent un Application Load Balancer externe global que lorsque vous avez besoin de fonctionnalités en périphérie (enable_cloud_armor, enable_cdn, domaines personnalisés). Sur GKE, le Service est de type LoadBalancer par défaut et enable_custom_domain bascule vers un équilibreur de charge L7 global de la Gateway API. L'affinité de session est activée en dur pour le service Cloud Run et définie par session_affinity (par défaut "ClientIP") sur le Service GKE — sachez que l'affinité Cloud Run est assurée au mieux (basée sur un cookie), sans garantie.
Basculement et réplication : Services_GCP expose directement le choix entre zonal et régional — postgres_database_availability_type = "REGIONAL" (instance de secours synchrone dans une autre zone, basculement automatique), create_postgres_read_replica (réplicas asynchrones, placés dans la seconde région de availability_regions lorsqu'il y en a une — lectures localisées entre régions et reprise après sinistre) et redis_tier = "STANDARD_HA" (Memorystore répliqué). Cloud Run est lui-même un service régional qui répartit automatiquement les instances entre les zones ; les clusters Autopilot sont régionaux.
Orchestration : cron_jobs (App_CloudRun) déploie chaque entrée sous forme de job Cloud Run déclenché par Cloud Scheduler (schedule au format cron, paused pour suspendre) — le volet Cloud Scheduler de l'objectif. Workflows et Cloud Tasks ne sont pas provisionnés par les modules, et Eventarc n'apparaît que dans le mécanisme de rotation des secrets (voir 1.2).
À vous de jouer
-
Dans le portail, définissez
max_instance_count = 3et redéployez. Dans Console > Cloud Run > votre service > Revisions, constatez qu'une nouvelle révision a été créée — les modifications de configuration créent toujours des révisions. -
Déployez une modification triviale (par exemple une nouvelle entrée
environment_variables), puis définisseztraffic_splitpour envoyer 10 % du trafic vers la nouvelle révision :gcloud run revisions list --service=<service-name> --region=us-central1
gcloud run services update-traffic <service-name> --region=us-central1 \
--to-revisions=<old-revision>=90,<new-revision>=10
gcloud run services describe <service-name> --region=us-central1 \
--format="yaml(status.traffic)"(Passer par la variable
traffic_splitgarde l'état Terraform comme référence ; c'est la CLI que l'examen évalue.) -
Basculez
cpu_always_allocated = false, appliquez, puis inspectez la révision : Console > Cloud Run > service > Revisions > onglet Containers affiche « CPU is only allocated during request processing ». -
Générez de la charge (
heyou une boucle decurl) et observez Cloud Run > service > Metrics > Container instance count monter vers 3 puis redescendre à 0. -
Vous savez que cela a fonctionné lorsque le graphique de trafic de l'onglet Revisions affiche la répartition 90/10 et que le nombre d'instances revient à zéro une fois la charge arrêtée.
Testez-vous
Q1 : Une API sensible à la latence sur Cloud Run présente des pics p99 de 4 secondes après des périodes d'inactivité. Quels deux paramètres corrigent ce problème, et quel est le compromis en termes de coût ?
R : Définissez min_instance_count >= 1 pour garder une instance chaude (supprime les démarrages à froid, mais l'instance inactive est facturée en continu) et définissez cpu_always_allocated = true pour que l'initialisation en arrière-plan ne soit pas limitée entre les requêtes. Le compromis est de payer du temps d'instance même sans aucun trafic — l'inverse de la mise à l'échelle jusqu'à zéro par défaut.
Q2 : Vous devez déployer une modification risquée auprès de 5 % des utilisateurs avec un retour arrière instantané. Comment procéder sur Cloud Run sans équilibreur de charge ?
R : Déployez la modification sous forme de nouvelle révision et utilisez la répartition du trafic par révision (traffic_split / gcloud run services update-traffic) pour lui envoyer 5 %, éventuellement avec un tag pour obtenir une URL de test directe. Le retour arrière consiste à renvoyer 100 % du trafic vers la révision précédente — sans nouveau build ni redéploiement, car les révisions sont immuables.
Q3 : Quand choisiriez-vous App_GKE plutôt qu'App_CloudRun pour un même conteneur ?
R : Lorsque la charge de travail a besoin d'un stockage stable par pod (StatefulSet via stateful_pvc_enabled), de contrôles natifs Kubernetes (NetworkPolicy, ResourceQuota, PDB, répartition topologique), de protocoles non HTTP de longue durée ou de sidecars que vous définissez vous-même. Cloud Run l'emporte pour le HTTP sans état au trafic irrégulier grâce à la mise à l'échelle jusqu'à zéro et à la facturation à la requête.
Au-delà des modules — L'examen évalue aussi des modèles de conception d'API et asynchrones que les modules n'implémentent pas : le versionnage REST et les spécifications OpenAPI derrière API Gateway ou Apigee, y compris leur limitation de débit (quotas/spike arrest), l'authentification par clé d'API/JWT et l'analyse des API (essayez gcloud api-gateway gateways list dans un projet de test), le code applicatif gRPC (le volet plateforme est couvert — container_protocol = "h2c" est l'équivalent, côté module, de gcloud run deploy --use-http2 — mais l'écriture du service/client gRPC relève de l'étude seule), la publication/l'abonnement Pub/Sub et le choix entre push et pull, Cloud Tasks pour la distribution à débit limité, Workflows pour l'orchestration en plusieurs étapes, et les déclencheurs Eventarc (les modules n'utilisent Eventarc qu'en interne pour la rotation des secrets). Sachez quand chaque orchestrateur convient : Cloud Scheduler pour les déclenchements temporels, Cloud Tasks pour la distribution explicite tâche par tâche avec relances et contrôle du débit, Eventarc pour réagir à des événements, Workflows pour enchaîner des appels avec état et gestion des erreurs. Étudiez aussi la répartition du trafic sur GKE (backendRefs pondérés de la Gateway API entre deux Services, ou un maillage de services — la HTTPRoute du module cible un seul backend) et le réglage de la concurrence sur Cloud Run (--concurrency), puisque les modules figent la valeur par défaut de 80.
⚠️ Piège d'examen — « Min instances = 0 » associé à « CPU toujours alloué » est une contradiction que les candidats ne voient pas : avec min_instance_count = 0, vous payez quand même l'intégralité du temps d'instance tant que des instances existent si le CPU est toujours alloué. La mise à l'échelle jusqu'à zéro ne fait économiser de l'argent entre les requêtes que si les instances s'arrêtent réellement.
1.2 Conception d'applications sécurisées (Designing secure applications)
⏱ ~75 min · 💰 faible (Secret Manager : quelques centimes ; clés KMS ~0,06 $/clé/mois ; IAP gratuit) · ⚙️ Prérequis : profil Hardened edge (
enable_iap,enable_auto_password_rotation) ; ajoutezenable_binary_authorizationsur les deux modules
Pourquoi l'examen s'y intéresse — Les questions de sécurité du PCD portent sur l'emplacement des identifiants et sur qui peut appeler quoi : les secrets doivent parvenir au code à l'exécution (jamais intégrés aux images ou à l'état), l'authentification des utilisateurs finaux doit avoir lieu avant que le trafic n'atteigne l'application (IAP), et seules les images dont le build est prouvé doivent s'exécuter (Binary Authorization). On attend de vous que vous sachiez quel mécanisme résout quel problème, pas que vous administriez l'organisation.
Comment RAD l'implémente —
Secrets à l'exécution. secret_environment_variables (table de correspondance nom de variable d'environnement → nom du secret Secret Manager) est restitué sur le service Cloud Run sous forme de référence de secret épinglée à la version latest — le texte en clair n'entre jamais dans l'état Terraform ni dans l'image. Le mot de passe de la base de données est généré automatiquement (database_password_length, par défaut 32 dans App_CloudRun) et stocké dans Secret Manager par la couche de secrets de la plateforme. Sur GKE, les secrets arrivent par le module complémentaire Secret Manager : la plateforme crée une SecretProviderClass (fournisseur gke) qui synchronise les secrets Secret Manager dans un Secret Kubernetes que les pods consomment via secretKeyRef — le module complémentaire lui-même (secret-manager+secret-sync-v1) est activé sur le cluster via gcloud.
Rotation. secret_rotation_period (par défaut "2592000s" = 30 jours) configure la notification de rotation de Secret Manager. À lui seul, il ne fait que publier dans Pub/Sub ; enable_auto_password_rotation (par défaut false) boucle la boucle : un déclencheur Eventarc appelle un service Cloud Run répartiteur, qui exécute un job Cloud Run de rotation. La logique de rotation fonctionne avec deux versions et sans interruption : d'abord ALTER USER, puis ajout de la nouvelle version du secret, attente de rotation_propagation_delay_sec (par défaut 90), puis désactivation (et non destruction) de l'ancienne version, de sorte que latest soit sans ambiguïté et qu'un retour arrière reste possible.
IAP. enable_iap (par défaut false) active IAP pour le service Cloud Run v2 (stade de lancement BETA). Une validation au moment du plan exige au moins une entrée dans iap_authorized_users ou iap_authorized_groups ; la plateforme accorde roles/run.invoker à l'agent de service IAP et roles/iap.httpsResourceAccessor à vos comptes principaux. Sans IAP, les services publics reçoivent une liaison allUsers → roles/run.invoker. Sur GKE, IAP exige en plus iap_oauth_client_id, iap_oauth_client_secret et iap_support_email.
Chaîne d'approvisionnement. enable_binary_authorization avec binauthz_evaluation_mode (par défaut "ALWAYS_ALLOW", les options incluent REQUIRE_ATTESTATION et ALWAYS_DENY) crée un certificateur adossé à KMS ; le pipeline CI signe les images (voir la section 2). enable_vulnerability_scanning (Services_GCP, par défaut false) active l'analyse Artifact Analysis pour le dépôt partagé.
Protection en périphérie. enable_cloud_armor (par défaut false) déploie une règle de WAF ({service}-waf-policy) avec des règles OWASP préconfigurées (SQLi/XSS/LFI/RCE), Adaptive Protection et une limite de débit de 500 requêtes/min/IP derrière un équilibreur de charge HTTPS global. application_domains est facultatif — si aucun n'est défini, le module dérive un certificat géré par Google <ip-dashed>.nip.io sans configuration, de sorte que l'équilibreur de charge dispose toujours d'un nom d'hôte. La contrainte effective va dans l'autre sens : enable_cdn = true exige enable_cloud_armor = true, car le CDN se rattache à l'équilibreur de charge que provisionne Cloud Armor. La limite de débit de Cloud Armor est ce que les modules offrent de plus proche de la limitation de débit applicative que l'examen associe à Apigee/API Gateway (1.1). Renforcements supplémentaires : enable_cmek (Services_GCP, par défaut false) pour des clés gérées par le client, avec cmek_key_rotation_period par défaut 7776000s (90 jours), enable_audit_logging (par défaut false) pour les journaux d'audit DATA_READ/DATA_WRITE, et enable_network_segmentation (App_GKE, par défaut false) pour des NetworkPolicies limitées à l'espace de noms.
Conservation des données. Les entrées de storage_buckets acceptent des lifecycle_rules (conditions d'âge, de versions plus récentes et de changement de classe de stockage) — l'Object Lifecycle Management, mis en œuvre par la couche de stockage objet de la plateforme. Les règles de conservation des buckets et le verrouillage des règles de conservation (WORM) ne sont pas exposés par les modules.
Réponse aux vulnérabilités. enable_vulnerability_scanning (Services_GCP) active Artifact Analysis pour le dépôt partagé, et enable_security_command_center / enable_scc_notifications (Services_GCP, par défaut false, uniquement dans votre propre projet) activent Security Command Center et acheminent ses résultats vers un sujet Pub/Sub. Les modules font remonter les résultats ; les corriger — refaire le build sur une image de base corrigée, mettre à jour une dépendance, redéployer — est la compétence de développeur que l'examen évalue.
Communication entre services. La sortie Cloud Run utilise la sortie VPC directe (Direct VPC egress) (vpc_egress_setting, par défaut "PRIVATE_RANGES_ONLY" ; pas de connecteur d'accès au VPC sans serveur), Cloud SQL et Memorystore sont joints via l'accès aux services privés (pas d'IP publique), enable_network_segmentation (App_GKE) ajoute des NetworkPolicies Kubernetes, et configure_cloud_service_mesh (Services_GCP) avec configure_service_mesh (App_GKE) activent Cloud Service Mesh avec injection de sidecars — les paramètres du maillage exigent votre propre projet (les API GKE Enterprise ne sont pas autorisées dans les projets gérés par RAD). Chaque charge de travail s'exécute sous un compte de service dédié au moindre privilège (section 4.2).
À vous de jouer
-
Ajoutez un secret personnalisé : créez
MY_API_KEYdans Console > Security > Secret Manager, puis définissezsecret_environment_variables = { MY_API_KEY = "<secret-name>" }et redéployez. Vérifiez dans Cloud Run > service > Revisions > Variables & Secrets qu'il apparaît comme « Secret reference », et non comme une valeur. -
Activez la rotation (
enable_auto_password_rotation = true) et inspectez les composants :gcloud secrets list --filter="name~rotation OR name~password"
gcloud secrets versions list <db-password-secret-name>
gcloud eventarc triggers list --location=us-central1
gcloud run jobs list --region=us-central1 # look for the rotator job -
Activez IAP avec votre utilisateur dans
iap_authorized_users, puis vérifiez la frontière :curl -s -o /dev/null -w "%{http_code}\n" https://<service-url>/ # 302/403 anonymous
curl -s -o /dev/null -w "%{http_code}\n" \
-H "Authorization: Bearer $(gcloud auth print-identity-token)" https://<service-url>/ -
Vous savez que cela a fonctionné lorsque, après une rotation, la liste des versions du secret affiche une nouvelle version ENABLED et une version précédente DISABLED, et que les requêtes anonymes cessent de renvoyer 200 une fois IAP activé.
Testez-vous
Q1 : Votre application lit DB_PASSWORD depuis une variable d'environnement alimentée par Secret Manager avec la version « latest ». Une rotation écrit une nouvelle version alors que 20 instances sont en cours d'exécution. Que se passe-t-il, et comment la conception de RAD évite-t-elle une panne ?
R : Les instances en cours conservent la valeur résolue à leur démarrage — les références de secrets en variables d'environnement sont résolues au démarrage de l'instance, pas à chaque requête. Le job de rotation évite la casse grâce aux deux versions : la base de données accepte le nouveau mot de passe (ALTER USER) avant la publication de la nouvelle version du secret, l'ancienne version n'est désactivée qu'après un délai de propagation, et la charge de travail est redémarrée pour que les nouvelles instances récupèrent « latest ». Une réponse d'examen doit mentionner que les secrets en variables d'environnement exigent une nouvelle révision ou un redémarrage pour être actualisés.
Q2 : Une équipe doit garantir que seules les images construites par son pipeline CI s'exécutent en production. Quelles deux variables RAD l'implémentent, et qu'advient-il d'une image poussée manuellement ?
R : enable_binary_authorization = true plus binauthz_evaluation_mode = "REQUIRE_ATTESTATION". Le pipeline CI signe chaque image avec le certificateur adossé à KMS après le build ; une image construite localement et poussée directement dans Artifact Registry n'a pas d'attestation, et son admission est donc refusée au moment du déploiement (l'application de la règle consiste à bloquer et à consigner dans le journal d'audit).
Q3 : Vous activez enable_cloud_armor = true sans définir application_domains. Que se passe-t-il ?
R : Le déploiement réussit. Le module provisionne automatiquement un certificat SSL géré par Google <ip-dashed>.nip.io sans configuration (security.tf, use_nip_io / nip_io_cert), de sorte que l'équilibreur de charge HTTPS global dispose toujours d'un nom d'hôte auquel se lier. Un domaine est facultatif, pas obligatoire.
La validation qui exigeait autrefois un domaine ici a été supprimée — App_CloudRun/validation.tf ne la conserve que sous forme du commentaire 19, « (removed) Cloud Armor no longer requires a custom domain. »
La contrainte qui existe va dans l'autre sens : enable_cdn = true exige enable_cloud_armor = true (précondition 26). Cloud CDN se rattache à l'équilibreur de charge HTTPS global que provisionne Cloud Armor ; sans lui, il n'existe aucun backend auquel rattacher le CDN.
Au-delà des modules — Étudiez Identity Platform (authentification des utilisateurs finaux/CIAM — les modules ne font qu'IAP pour les identités Google), les flux de jetons OAuth 2.0/OIDC, la validation des JWT et la différence entre jetons d'accès et jetons d'identité, l'AlloyDB Auth Proxy (les modules ne connectent que Cloud SQL via un proxy d'authentification), les règles de conservation des buckets Cloud Storage et leur verrouillage, les URL signées comparées à IAM pour l'accès aux objets, et Web Security Scanner. VPC Service Controls existe dans les modules (enable_vpc_sc, en mode simulation par défaut, les étapes étant ignorées sans erreur lorsque la sonde d'autorisations échoue), mais les questions de conception de périmètre vont plus loin — lisez la documentation sur les règles d'entrée/sortie de VPC-SC.
⚠️ Piège d'examen — secret_rotation_period seul ne fait tourner aucun secret. Il ne fait que planifier une notification Pub/Sub. Quelque chose doit consommer cette notification et écrire une nouvelle version — dans RAD, c'est enable_auto_password_rotation ; à l'examen, c'est « une fonction/un job de rotation que vous implémentez ».
1.3 Stockage et accès aux données (Storing and accessing data)
⏱ ~60 min · 💰 modéré — Cloud SQL
db-custom-1-3840est le principal coût de base ; REGIONAL le double environ ; FilestoreBASIC_HDDde 1 TiB est significatif · ⚙️ Prérequis : Serverless baseline (Postgres est activé par défaut)
Pourquoi l'examen s'y intéresse — Les questions de choix du stockage vous donnent des exigences de forme des données, de cohérence et d'échelle, et attendent le bon produit : OLTP relationnel → Cloud SQL/AlloyDB, documents avec synchronisation mobile → Firestore, colonnes larges/séries temporelles à l'échelle du pétaoctet → Bigtable, relationnel mondial → Spanner, blobs → Cloud Storage, données éphémères très sollicitées → Memorystore. Le PCD y ajoute l'angle du développeur : comment le code se connecte à chacun (traité en 4.1), et quelle cohérence il observe.
Comment RAD l'implémente — Services_GCP provisionne l'offre ; les modules applicatifs la consomment :
| Variable (Services_GCP) | Par défaut | Ce que vous obtenez |
|---|---|---|
create_postgres | true | Cloud SQL Postgres (postgres_database_version par défaut POSTGRES_17), IP privée uniquement, SSL ENCRYPTED_ONLY, PITR avec 7 jours de conservation des journaux, 7 sauvegardes quotidiennes |
postgres_database_availability_type | ZONAL | définissez REGIONAL pour une instance de secours HA avec basculement automatique |
create_postgres_read_replica | false | réplica(s) en lecture (postgres_read_replica_count par défaut 1) pour mettre les lectures à l'échelle |
create_mysql | false | MySQL (MYSQL_8_4), récupération basée sur le binlog (pas de configuration PITR) |
enable_alloydb | false | cluster AlloyDB + instance principale ; enable_alloydb_read_pool ajoute un pool de lecture (uniquement dans votre propre projet ; les modules applicatifs ne s'y connectent pas) |
create_firestore | false | base de données Firestore Native (édition Enterprise) — provisionnement uniquement |
create_redis | false | Memorystore Redis ; persistance redis_persistence_mode par défaut DISABLED |
create_filestore_nfs | false | Filestore (filestore_tier par défaut BASIC_HDD, filestore_capacity_gb par défaut 1024) |
create_network_filesystem | true | VM e2-small NFS+Redis autogérée, avec disque avec état et instantanés quotidiens |
Le stockage objet se trouve dans les modules applicatifs : storage_buckets (une liste de définitions de buckets gérée par la couche de stockage objet de la plateforme) crée des buckets GCS avec gestion des versions, règles de cycle de vie (âge, nombre de versions plus récentes, changements de classe de stockage), CORS, public_access_prevention par bucket et IAM au moindre privilège (roles/storage.objectAdmin accordé par bucket au compte de service de l'application). gcs_volumes monte des buckets dans le conteneur via GCS Fuse (gen2 requis), de sorte que le code peut utiliser de simples appels au système de fichiers.
Faits de cohérence à retenir : Cloud SQL est fortement cohérent sur l'instance principale ; les réplicas en lecture accusent un retard asynchrone. L'instance Postgres de RAD active le PITR (restauration à un horodatage) en plus des sauvegardes quotidiennes — ce sont deux réponses d'examen différentes. Le niveau Redis BASIC n'a pas de réplication et perd ses données au redémarrage, sauf si la persistance RDB/AOF est activée ; le module impose même, au moment du plan, qu'une instance STANDARD_HA de production n'ait pas la persistance DISABLED.
À vous de jouer
-
Inspectez la base de données créée par le profil de base :
gcloud sql instances describe <instance-name> \
  --format="yaml(settings.availabilityType, settings.backupConfiguration, ipAddresses)"
Confirmez
availabilityType: ZONAL,pointInTimeRecoveryEnabled: true, et l'absence d'IP publique. -
Définissez
postgres_database_availability_type = "REGIONAL"dans le portail et réappliquez ; la sortie de describe affiche désormais une zone secondaire. (Cela redémarre l'instance — faites-le pendant un créneau de lab.) -
Ajoutez un bucket via
storage_bucketsavec une règle de cycle de vie, puis vérifiez :gcloud storage buckets describe gs://<bucket-name> \
--format="yaml(lifecycle_config, versioning, public_access_prevention)" -
Vous savez que cela a fonctionné lorsque le bucket affiche votre règle de cycle de vie et
versioning: enabled, et que l'instance SQL indique REGIONAL avec une zone de réplica de basculement.
Testez-vous
Q1 : Une application doit survivre à une panne de zone sans perte de données sur son stockage relationnel. Les sauvegardes quotidiennes sont déjà activées. Quelle modification est nécessaire, et pourquoi les sauvegardes ne suffisent-elles pas ?
R : Définissez postgres_database_availability_type = "REGIONAL" — la réplication synchrone vers une instance de secours dans une autre zone assure un basculement automatique sans perte de données. Les sauvegardes (et même le PITR) sont des mécanismes de récupération, avec un temps de restauration et une perte de données possible jusqu'aux derniers journaux de transactions ; ils n'assurent pas la disponibilité.
Q2 : Un catalogue de produits est lu 50 fois plus souvent qu'il n'est écrit, et l'instance principale Cloud SQL est saturée en CPU. Classez les options RAD.
R : D'abord, ajoutez une mise en cache Memorystore (create_redis = true + enable_redis côté application) — elle supprime entièrement les lectures répétées et c'est la solution la moins chère. Ensuite, create_postgres_read_replica = true pour délester les lectures restantes (le code doit diriger les lectures vers le réplica et tolérer le retard de réplication). La mise à l'échelle verticale (postgres_tier) est la solution de repli, car elle a un plafond et son coût croît linéairement.
Q3 : Pourquoi un développeur pourrait-il préférer gcs_volumes (GCS Fuse) à la bibliothèque cliente Cloud Storage ?
R : Fuse permet à du code non modifié d'utiliser la sémantique d'un système de fichiers (utile pour les applications existantes, les fichiers de modèles de ML, les ressources statiques au démarrage), au prix des caractéristiques de performance du stockage objet et de cas limites POSIX. La bibliothèque cliente est la bonne réponse pour les E/S d'objets à haut débit, les URL signées et les opérations sur les métadonnées. Fuse exige execution_environment = "gen2" sur Cloud Run — validé au moment du plan.
Au-delà des modules — Spanner (tables entrelacées, éviter les clés primaires créant des points chauds, cohérence externe forte), Bigtable (conception des clés de ligne, modèle à index unique, cohérence à terme entre clusters répliqués), la conception de schémas AlloyDB et la cohérence des pools de lecture, la cohérence forte en lecture après écriture de Cloud Storage, les chemins d'écriture BigQuery pour les charges de travail d'analyse et d'IA/ML (Storage Write API, streaming ou chargements par lots) et la génération d'URL signées (blob.generate_signed_url, qui exige roles/iam.serviceAccountTokenCreator ou une clé) sont tous absents des modules et tous évalués. La base de données Firestore peut être créée ici (create_firestore = true), mais l'utilisation du SDK — documents, index composites, écouteurs en temps réel, transactions — doit être pratiquée avec les bibliothèques clientes ou l'émulateur.
⚠️ Piège d'examen — Sauvegardes ≠ PITR. Les sauvegardes quotidiennes restaurent à l'instant d'un instantané ; le PITR rejoue les journaux de transactions jusqu'à un horodatage arbitraire. L'instance Postgres de RAD dispose des deux ; l'instance MySQL de RAD s'appuie sur la journalisation binaire et n'a pas de configuration PITR — une distinction que l'examen adore.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.