Guide de préparation à la certification PCD : Section 2 — Création et test d'applications (Building and testing applications) (~23 % de l'examen)
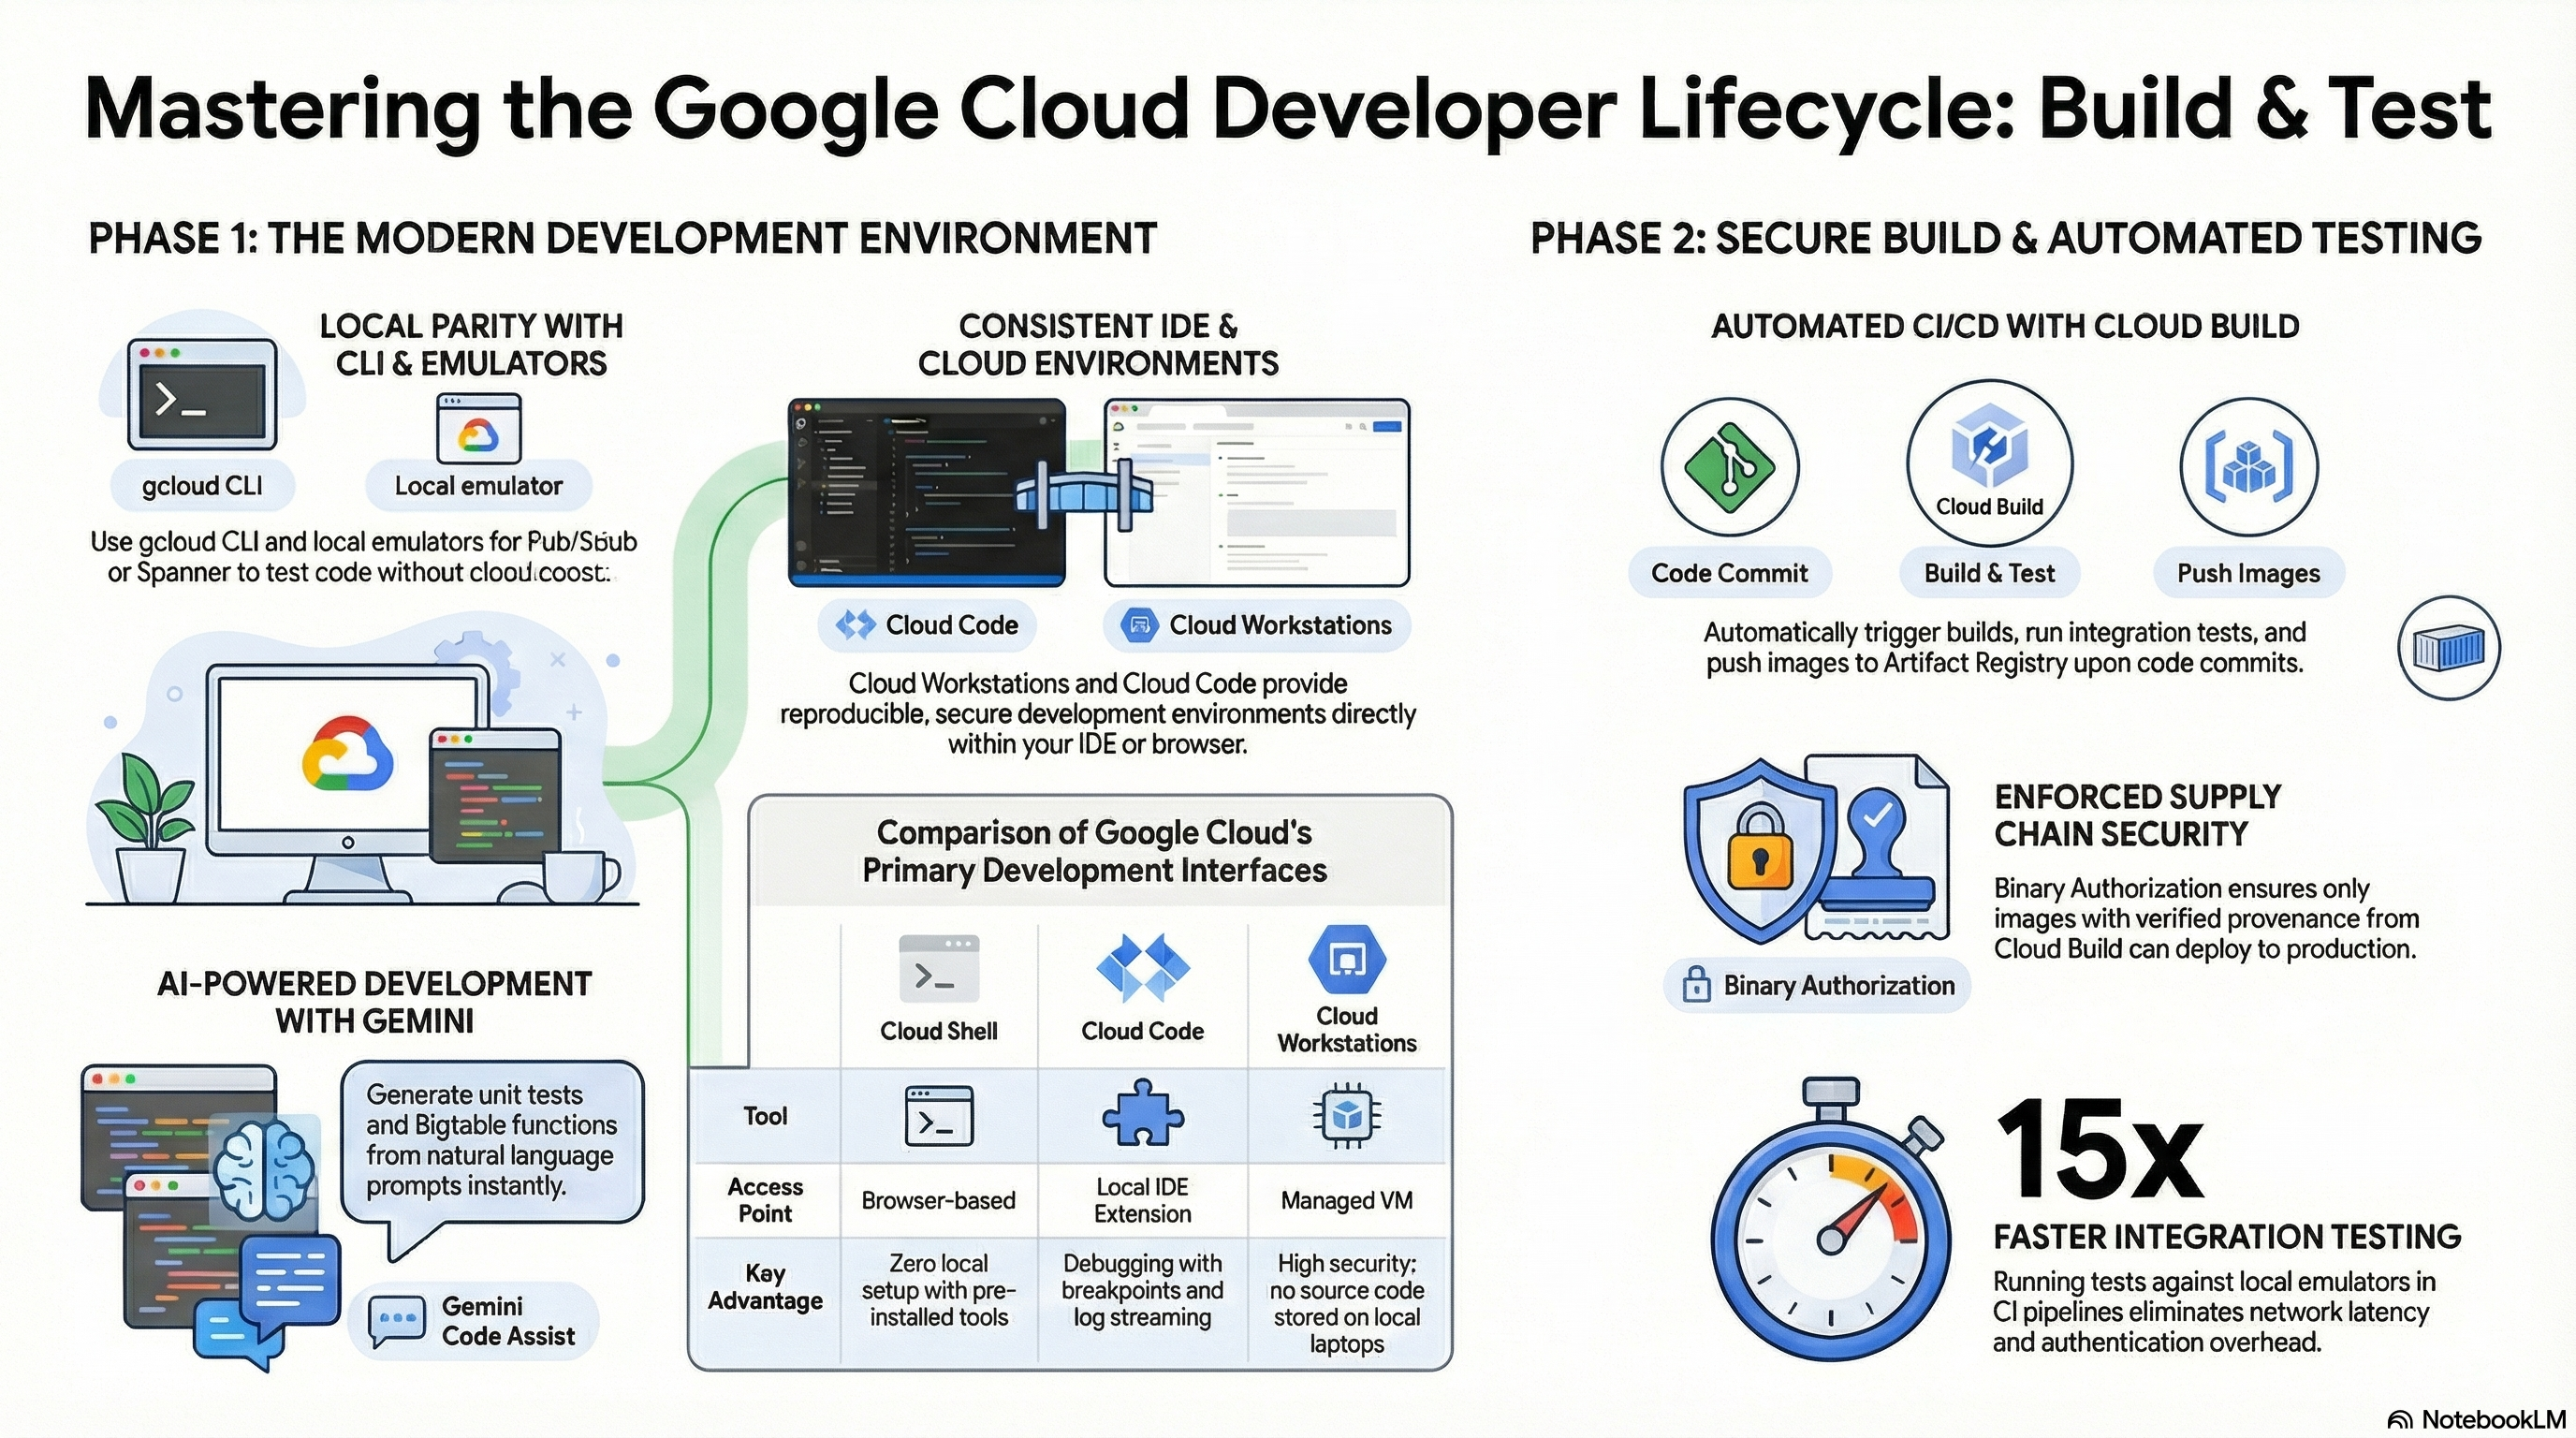
📚 Guide d'examen officiel : Professional Cloud Developer certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Cette section correspond à la mécanique de build de la plateforme RAD : les builds de conteneurs Cloud Build de la plateforme, le déclencheur CI Cloud Build (présent dans App_CloudRun comme dans App_GKE), la gestion d'Artifact Registry et la mise en miroir des images. Déployez le profil Delivery pipeline (pipeline de livraison) de la carte des labs. Les outils de développement local et le développement assisté par l'IA (2.1), ainsi que l'écriture de tests avec des assistants de codage IA (2.3), relèvent de l'étude seule — des pistes honnêtes sont fournies.
2.1 Configuration de votre environnement de développement (Setting up your development environment)
⏱ ~45 min (principalement en dehors de la plateforme) · 💰 aucun coût supplémentaire · ⚙️ Prérequis : n'importe quel profil déployé + un poste de travail ou Cloud Shell
Pourquoi l'examen s'y intéresse — L'examen vérifie que vous connaissez la chaîne d'outils du développeur : les flux d'authentification gcloud (identifiants utilisateur ou Application Default Credentials), les émulateurs locaux lancés depuis la Google Cloud CLI pour des tests unitaires sans coût cloud, les compromis entre Cloud Code, Cloud Shell et Cloud Workstations, Gemini Cloud Assist dans la console, les intégrations à l'IDE, y compris les outils d'IA (assistants de codage, serveurs MCP), et la manière de reproduire un environnement cloud en local (par exemple Cloud SQL Auth Proxy sur votre ordinateur portable).
Comment RAD l'implémente — Pas directement : les modules de fondation s'exécutent côté serveur et supposent que le portail effectue le déploiement. Les capacités voisines les plus proches sont toutefois réelles et utiles :
- Environnements isolés par développeur.
tenant_idalimente le schéma de nommage déterministe (app<name><tenant><8-hex-hash>), de sorte que chaque développeur peut déployer une copie complète et sans collision de la même application dans un projet partagé — la réponse cloud native au « ça marche sur ma machine ». - Image d'outils de base de données. La plateforme construit dans Artifact Registry une image cliente psql/mysql, utilisée par les jobs des modules ; vous pouvez exécuter la même image en local pour obtenir la parité.
- Modèle d'accès local à la base de données. Cloud SQL n'a qu'une IP privée ; l'équivalent local de la configuration déployée consiste donc à exécuter vous-même le Cloud SQL Auth Proxy depuis une machine ayant accès au VPC (ou via un tunnel IAP) — le même binaire que le module GKE exécute en sidecar.
À vous de jouer
-
Déployez une seconde copie d'
App_CloudRunavec untenant_iddifférent et confirmez que les deux piles coexistent :gcloud run services list --region=us-central1
gcloud sql databases list --instance=<instance-name> -
Configurez ADC en local, de la manière dont l'examen attend que les machines de développement s'authentifient :
gcloud auth application-default login
gcloud config set project <project-id> -
Démarrez un émulateur Pub/Sub et faites-y pointer un test (sans intervention de RAD — c'est la compétence évaluée à l'examen) :
gcloud beta emulators pubsub start --project=test-project &
export PUBSUB_EMULATOR_HOST=localhost:8085 -
Vous savez que cela a fonctionné lorsque
gcloud run services listaffiche deux services avec des suffixes de tenant différents, et que les appels de votre bibliothèque cliente locale atteignent l'émulateur (aucun identifiant nécessaire).
Testez-vous
Q1 : Le code exécuté sur l'ordinateur portable d'un développeur appelle storage.Client() et reçoit une erreur 403 au bureau, mais fonctionne sur Cloud Run. Pourquoi, et quelle est la correction ?
R : Sur Cloud Run, la bibliothèque cliente résout les Application Default Credentials à partir du serveur de métadonnées (le compte de service du service). En local, il n'existe aucun identifiant ambiant tant que le développeur n'a pas exécuté gcloud auth application-default login (ou défini GOOGLE_APPLICATION_CREDENTIALS — déconseillé, car les fichiers de clé ont une longue durée de vie). La correction consiste à établir ADC en local ; le code lui-même ne doit pas changer.
Q2 : Vos tests unitaires de CI doivent exercer la logique Pub/Sub et Firestore sans accès réseau ni coût. Qu'utilisez-vous ?
R : Les émulateurs locaux (gcloud beta emulators pubsub start, l'émulateur Firestore), avec les variables d'environnement PUBSUB_EMULATOR_HOST / FIRESTORE_EMULATOR_HOST définies pour que les bibliothèques clientes les ciblent de façon transparente. Les émulateurs ne nécessitent aucun identifiant, ce qui est exactement ce que recherche une CI hermétique.
Au-delà des modules — Étudiez Cloud Code (déploiement/débogage depuis l'IDE pour Cloud Run et GKE, y compris un émulateur Cloud Run local), Cloud Shell (éphémère, pré-authentifié, répertoire personnel persistant de 5 GB) et Cloud Workstations (VM de développement gérées, persistantes, protégées par IAP, pour les équipes soumises à réglementation) — sachez laquelle recommander pour une contrainte donnée. Le guide actuel ajoute les outils d'IA : Gemini Cloud Assist (aide intégrée à la console pour concevoir, exploiter et dépanner les ressources), Gemini Code Assist et d'autres assistants de codage IA dans l'IDE (installation via Cloud Code ou la marketplace de l'IDE ; connaissez les sources de contexte et les contrôles d'entreprise), et les serveurs MCP, qui permettent à un assistant d'appeler des outils comme gcloud ou les API Google Cloud — comprenez avec quels identifiants un tel serveur s'exécute et pourquoi le principe du moindre privilège s'y applique aussi. Rien de cela n'est provisionné par la plateforme. Entraînez-vous aussi à gcloud run deploy --source . (déploiement depuis la source basé sur Buildpacks), puisque le pipeline RAD construit toujours un conteneur explicite.
⚠️ Piège d'examen — gcloud auth login et gcloud auth application-default login sont des identifiants différents : le premier autorise la CLI gcloud, le second écrit le fichier ADC que lisent les bibliothèques clientes. Des tests qui passent pour les commandes de la CLI mais renvoient 401 dans le code signifient généralement que le second a été omis.
2.2 Build (Building)
⏱ ~75 min · 💰 faible — facturation à la minute de Cloud Build plus stockage Artifact Registry · ⚙️ Prérequis : profil Delivery pipeline (
enable_cicd_trigger = true,github_repository_urldéfini)
Pourquoi l'examen s'y intéresse — Le PCD attend une bonne maîtrise de la chaîne d'approvisionnement des conteneurs : construire des images à partir du code source dans Cloud Build et les stocker dans Artifact Registry (et savoir pourquoi un outil de build sans démon comme Kaniko ou Buildpacks est préférable à docker build en CI), la stratégie de tags (latest modifiable ou tags immuables par SHA de commit), le stockage et le nettoyage d'Artifact Registry, et la configuration de la provenance dans Cloud Build (provenance du build plus attestations) afin que Binary Authorization puisse contrôler les déploiements.
Comment RAD l'implémente — Deux chemins de build distincts, tous deux de vrais builds Cloud Build :
- Build piloté par Terraform (chaque déploiement avec
container_image_source = "custom", la valeur par défaut) : la plateforme génère une configuration de build et exécutegcloud builds submit. Kaniko construit avec mise en cache des couches (--cache=true,--cache-ttl=24h) et pousse trois tags : la version de l'application,latestet le SHA du commit. Les nouveaux builds sont déclenchés par empreinte : la plateforme calcule l'empreinte des fichiers du contexte de build, du Dockerfile (ou dudockerfile_contentintégré) et desbuild_args, de sorte qu'une arborescence source inchangée ne déclenche jamais de nouveau build. - Déclencheur CI piloté par Git (
enable_cicd_trigger, par défautfalse) : la plateforme crée un déclencheur Cloud Build lié àgithub_repository_url, filtré parcicd_trigger_config(branch_patternpar défaut"^main$", plusincluded_files/ignored_files/substitutions). Le pipeline généré exécute Kanikov1.23.2, signe éventuellement l'image (gcloud beta container binauthz attestations sign-and-createauprès depipeline-attestor, avec la clé KMSbinauthz-signerdu trousseau{project}-binauthz-keyring), puis exécute directementgcloud run services update --image=...:$COMMIT_SHAou crée une release Cloud Deploy (section 3.1).
Gestion du registre : le module découvre le dépôt partagé de Services_GCP ou, en l'absence de Services_GCP, crée le sien. Les règles de nettoyage dépendent du cas : sur le dépôt partagé, elles appartiennent à Services_GCP — enable_image_retention (par défaut false), image_retention_keep_count (par défaut 10), image_retention_days (par défaut 90) et image_retention_dry_run (par défaut true, rapport uniquement) ; sur un dépôt intégré, le module applicatif applique max_images_to_retain (par défaut 7), delete_untagged_images (par défaut true) et image_retention_days (par défaut 30), limités aux noms de paquets de ce déploiement. Les paramètres du module applicatif n'ont aucun effet sur le dépôt partagé. enable_image_mirroring (par défaut true) copie les images de base externes dans Artifact Registry par comparaison des digests avec Crane : il compare les digests SHA256 de la source et de la cible et ne copie (ou n'écrase un tag obsolète) que lorsqu'ils diffèrent — ce qui vous protège des limites de débit des registres et de la dérive des tags. enable_vulnerability_scanning (Services_GCP) fait analyser par Artifact Analysis tout ce qui est poussé.
À vous de jouer
-
Poussez un commit sur la branche configurée et regardez le déclencheur s'exécuter : Console > Cloud Build > History, ouvrez le build et repérez l'étape Kaniko et (si Binary Authorization est activé) l'étape d'attestation.
gcloud builds list --limit=5
gcloud builds log <build-id> -
Inspectez les tags obtenus et les résultats d'analyse :
gcloud artifacts docker images list \
  us-central1-docker.pkg.dev/<project>/<repo> --include-tags
gcloud artifacts docker images describe \
  us-central1-docker.pkg.dev/<project>/<repo>/<image>:latest \
--show-package-vulnerability -
Vérifiez que l'attestation existe pour le nouveau digest :
gcloud container binauthz attestations list \
--attestor=pipeline-attestor --attestor-project=<project> -
Réappliquez le déploiement sans modifier la source et confirmez qu'aucun nouveau job Cloud Build ne s'exécute (l'empreinte du contenu du build est inchangée).
-
Vous savez que cela a fonctionné lorsque l'image affiche trois tags (version,
latest, SHA du commit), que les vulnérabilités sont listées et qu'une attestation référence le nouveau digest.
Testez-vous
Q1 : Pourquoi le pipeline déploie-t-il par tag de SHA de commit plutôt que par latest, alors que latest est également poussé ?
R : latest est modifiable — il pointe vers ce qui a été poussé en dernier, de sorte qu'un déploiement qui y fait référence n'est pas reproductible et que les retours arrière sont ambigus. Le tag du SHA de commit est de fait immuable et rattache la révision en cours d'exécution à une provenance exacte du code source, ce qui est aussi ce que signe l'attestation Binary Authorization (le digest). latest n'est conservé que par commodité pour les développeurs.
Q2 : Un build échoue avec des erreurs du démon Docker dans Cloud Build. Le pipeline RAD ne rencontre jamais ce problème — pourquoi ?
R : Il utilise Kaniko, qui construit des images OCI entièrement en espace utilisateur à partir du Dockerfile, sans démon Docker — la réponse type pour des builds de conteneurs sans démon et avec cache en CI. (Buildpacks est l'autre réponse d'examen sans démon, utilisée par gcloud run deploy --source.)
Q3 : Les coûts de stockage d'Artifact Registry croissent sans limite dans un dépôt très actif. Quels trois contrôles RAD répondent au problème ?
R : Sur un dépôt créé par le module : delete_untagged_images = true supprime les couches orphelines, image_retention_days = 30 fait expirer les anciennes images et max_images_to_retain = 7 conserve les N plus récentes quel que soit leur âge (une garde de conservation, pas un outil de suppression). Sur le dépôt partagé de Services_GCP, le même modèle correspond à enable_image_retention = true avec image_retention_days et image_retention_keep_count (et image_retention_dry_run = false pour supprimer réellement). Dans les deux cas, c'est le modèle de règle de nettoyage AR recommandé : suppression selon l'âge plus conservation des plus récentes.
Au-delà des modules — L'examen couvre aussi Buildpacks et les déploiements depuis la source, la provenance des builds et les niveaux SLSA (Cloud Build génère une provenance SLSA consultable dans l'onglet Security insights d'un build), les pools privés, ainsi que les substitutions et les secrets dans une configuration Cloud Build (essayez gcloud builds submit --substitutions=_FOO=bar dans un dépôt de test). Le déclencheur RAD ne prend en charge que GitHub (jeton ou installation d'application) — sachez que Cloud Build se connecte aussi aux dépôts GitLab et Bitbucket.
⚠️ Piège d'examen — Pousser une image dans Artifact Registry ne la déploie pas. C'est l'étape explicite gcloud run services update (ou la release Cloud Deploy) du pipeline qui change la révision en cours d'exécution — une étape de déploiement manquante est un scénario de dépannage classique du type « le build a réussi, l'application n'a pas changé ».
2.3 Tests (Testing)
⏱ ~45 min · 💰 faible (minutes Cloud Build supplémentaires) · ⚙️ Prérequis : profil Delivery pipeline + accès en écriture au dépôt de l'application
Pourquoi l'examen s'y intéresse — Le guide actuel nomme deux compétences : écrire des tests unitaires avec l'aide d'assistants de codage IA, et exécuter des tests d'intégration automatisés dans Cloud Build. Les tests doivent s'exécuter dans le pipeline pour qu'un échec bloque la promotion : tests unitaires en amont (peu coûteux, hermétiques, s'appuyant sur des émulateurs), tests d'intégration sur des services réels ou de préproduction après le build, et smoke tests après le déploiement sur une étape hors production. L'examen vérifie où chacun a sa place et ce qu'une étape en échec fait au pipeline.
Comment RAD l'implémente — Pour être honnête : les pipelines générés ne contiennent aucune étape de test par défaut — le flux CI est build → (attestation facultative) → déploiement/release. Les points d'extension pour ajouter des tests sont toutefois réels :
- Le déclencheur Cloud Build exécute la configuration de build générée ; les étapes s'exécutent séquentiellement et toute sortie non nulle fait échouer le build, de sorte qu'une étape de test insérée entre Kaniko et l'étape de déploiement contrôle le déploiement exactement comme le décrit l'examen.
cicd_trigger_config.branch_pattern(par défaut"^main$") détermine quels pushes déclenchent un build ;included_files/ignored_filesévitent que des commits ne touchant que la documentation consomment des minutes de build.- Les modules de fondation eux-mêmes fournissent des tests OpenTofu/Terraform natifs qui exercent les validations au moment du plan — un exemple utile de test de code d'infrastructure, qui apparaît parfois à l'examen sous la forme du « shift-left pour l'IaC ».
- Les étapes Cloud Deploy (section 3.1) fournissent la surface de vérification après déploiement : promouvoir vers
dev, exécuter des smoke tests sur l'URL du service de cette étape, puis promouvoir.
À vous de jouer
-
Dans le dépôt de votre application, ajoutez une étape de test à la configuration de build entre les étapes de build et de déploiement, par exemple :
- name: 'python:3.12-slim'
  entrypoint: 'bash'
args: ['-c', 'pip install -r requirements.txt && pytest -q'] -
Poussez un commit contenant un test volontairement en échec et observez : Console > Cloud Build > History affiche l'étape en rouge, et l'étape de déploiement ne s'exécute jamais.
gcloud builds list --filter="status=FAILURE" --limit=3 -
Confirmez que le service Cloud Run exécute toujours l'image précédente :
gcloud run services describe <service-name> --region=us-central1 \
--format="value(spec.template.spec.containers[0].image)" -
Vous savez que cela a fonctionné lorsque le build en échec laisse l'image déployée intacte et que l'étape de déploiement est ignorée.
Testez-vous
Q1 : Des tests d'intégration ont besoin d'un vrai Postgres mais ne doivent pas toucher aux données de production. Comment structureriez-vous cela avec la pile RAD ?
R : Déployez un tenant distinct (tenant_id = "ci") afin que le pipeline dispose de sa propre base de données Cloud SQL et de son propre service, isolés ; exécutez les tests d'intégration sur cet environnement depuis une étape Cloud Build, puis supprimez-le ou réutilisez-le à chaque exécution. Les tests unitaires restent sur des émulateurs/mocks ; seule la couche d'intégration touche la vraie base de données (isolée).
Q2 : Où se placent les smoke tests dans un pipeline Cloud Deploy, et qu'est-ce qui empêche une mauvaise release d'atteindre la production ?
R : Après le déploiement sur une cible hors production (dev/staging) — exécutez-les sur l'URL de cette étape et protégez prod avec require_approval = true (la valeur par défaut de RAD), afin qu'un humain (ou une vérification automatisée que vous mettez en place) confirme avant la promotion. Un déploiement en échec ou une approbation refusée empêche la release de progresser.
Au-delà des modules — Entraînez-vous à générer des tests unitaires avec un assistant de codage IA (par exemple la génération de tests de Gemini Code Assist dans l'IDE), puis à les relire — vérifiez que les tests générés contrôlent le comportement au lieu de calquer l'implémentation, et qu'ils couvrent les cas limites que l'assistant a omis. Entraînez-vous aussi à écrire des tests unitaires s'appuyant sur des émulateurs (émulateurs Pub/Sub, Firestore, Spanner), aux rapports de tests de Cloud Build et aux tests de charge sur des révisions Cloud Run (par exemple hey/k6 sur une URL canary taguée). Cloud Deploy verify (jobs de vérification après déploiement déclarés dans la configuration Skaffold) est la version gérée de l'idée de smoke test de l'étape 2 et mérite d'être étudié — les configurations Cloud Deploy de RAD utilisent des hooks pour IAM et les jobs, pas pour la vérification.
⚠️ Piège d'examen — Les étapes Cloud Build partagent le volume /workspace, mais sont par ailleurs des conteneurs isolés ; une étape de test ne peut pas joindre un serveur démarré lors d'une étape précédente, sauf si vous le lancez en arrière-plan au sein de la même étape ou si vous utilisez le réseau docker. « Pourquoi l'étape 4 ne voit-elle pas le service démarré par l'étape 3 ? » est une forme de question récurrente.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.