Guide de préparation à la certification PCD : Section 3 — Configuration d'applications cloud natives pour le déploiement (Configuring cloud-native applications for deployment) (~24 % de l'examen)
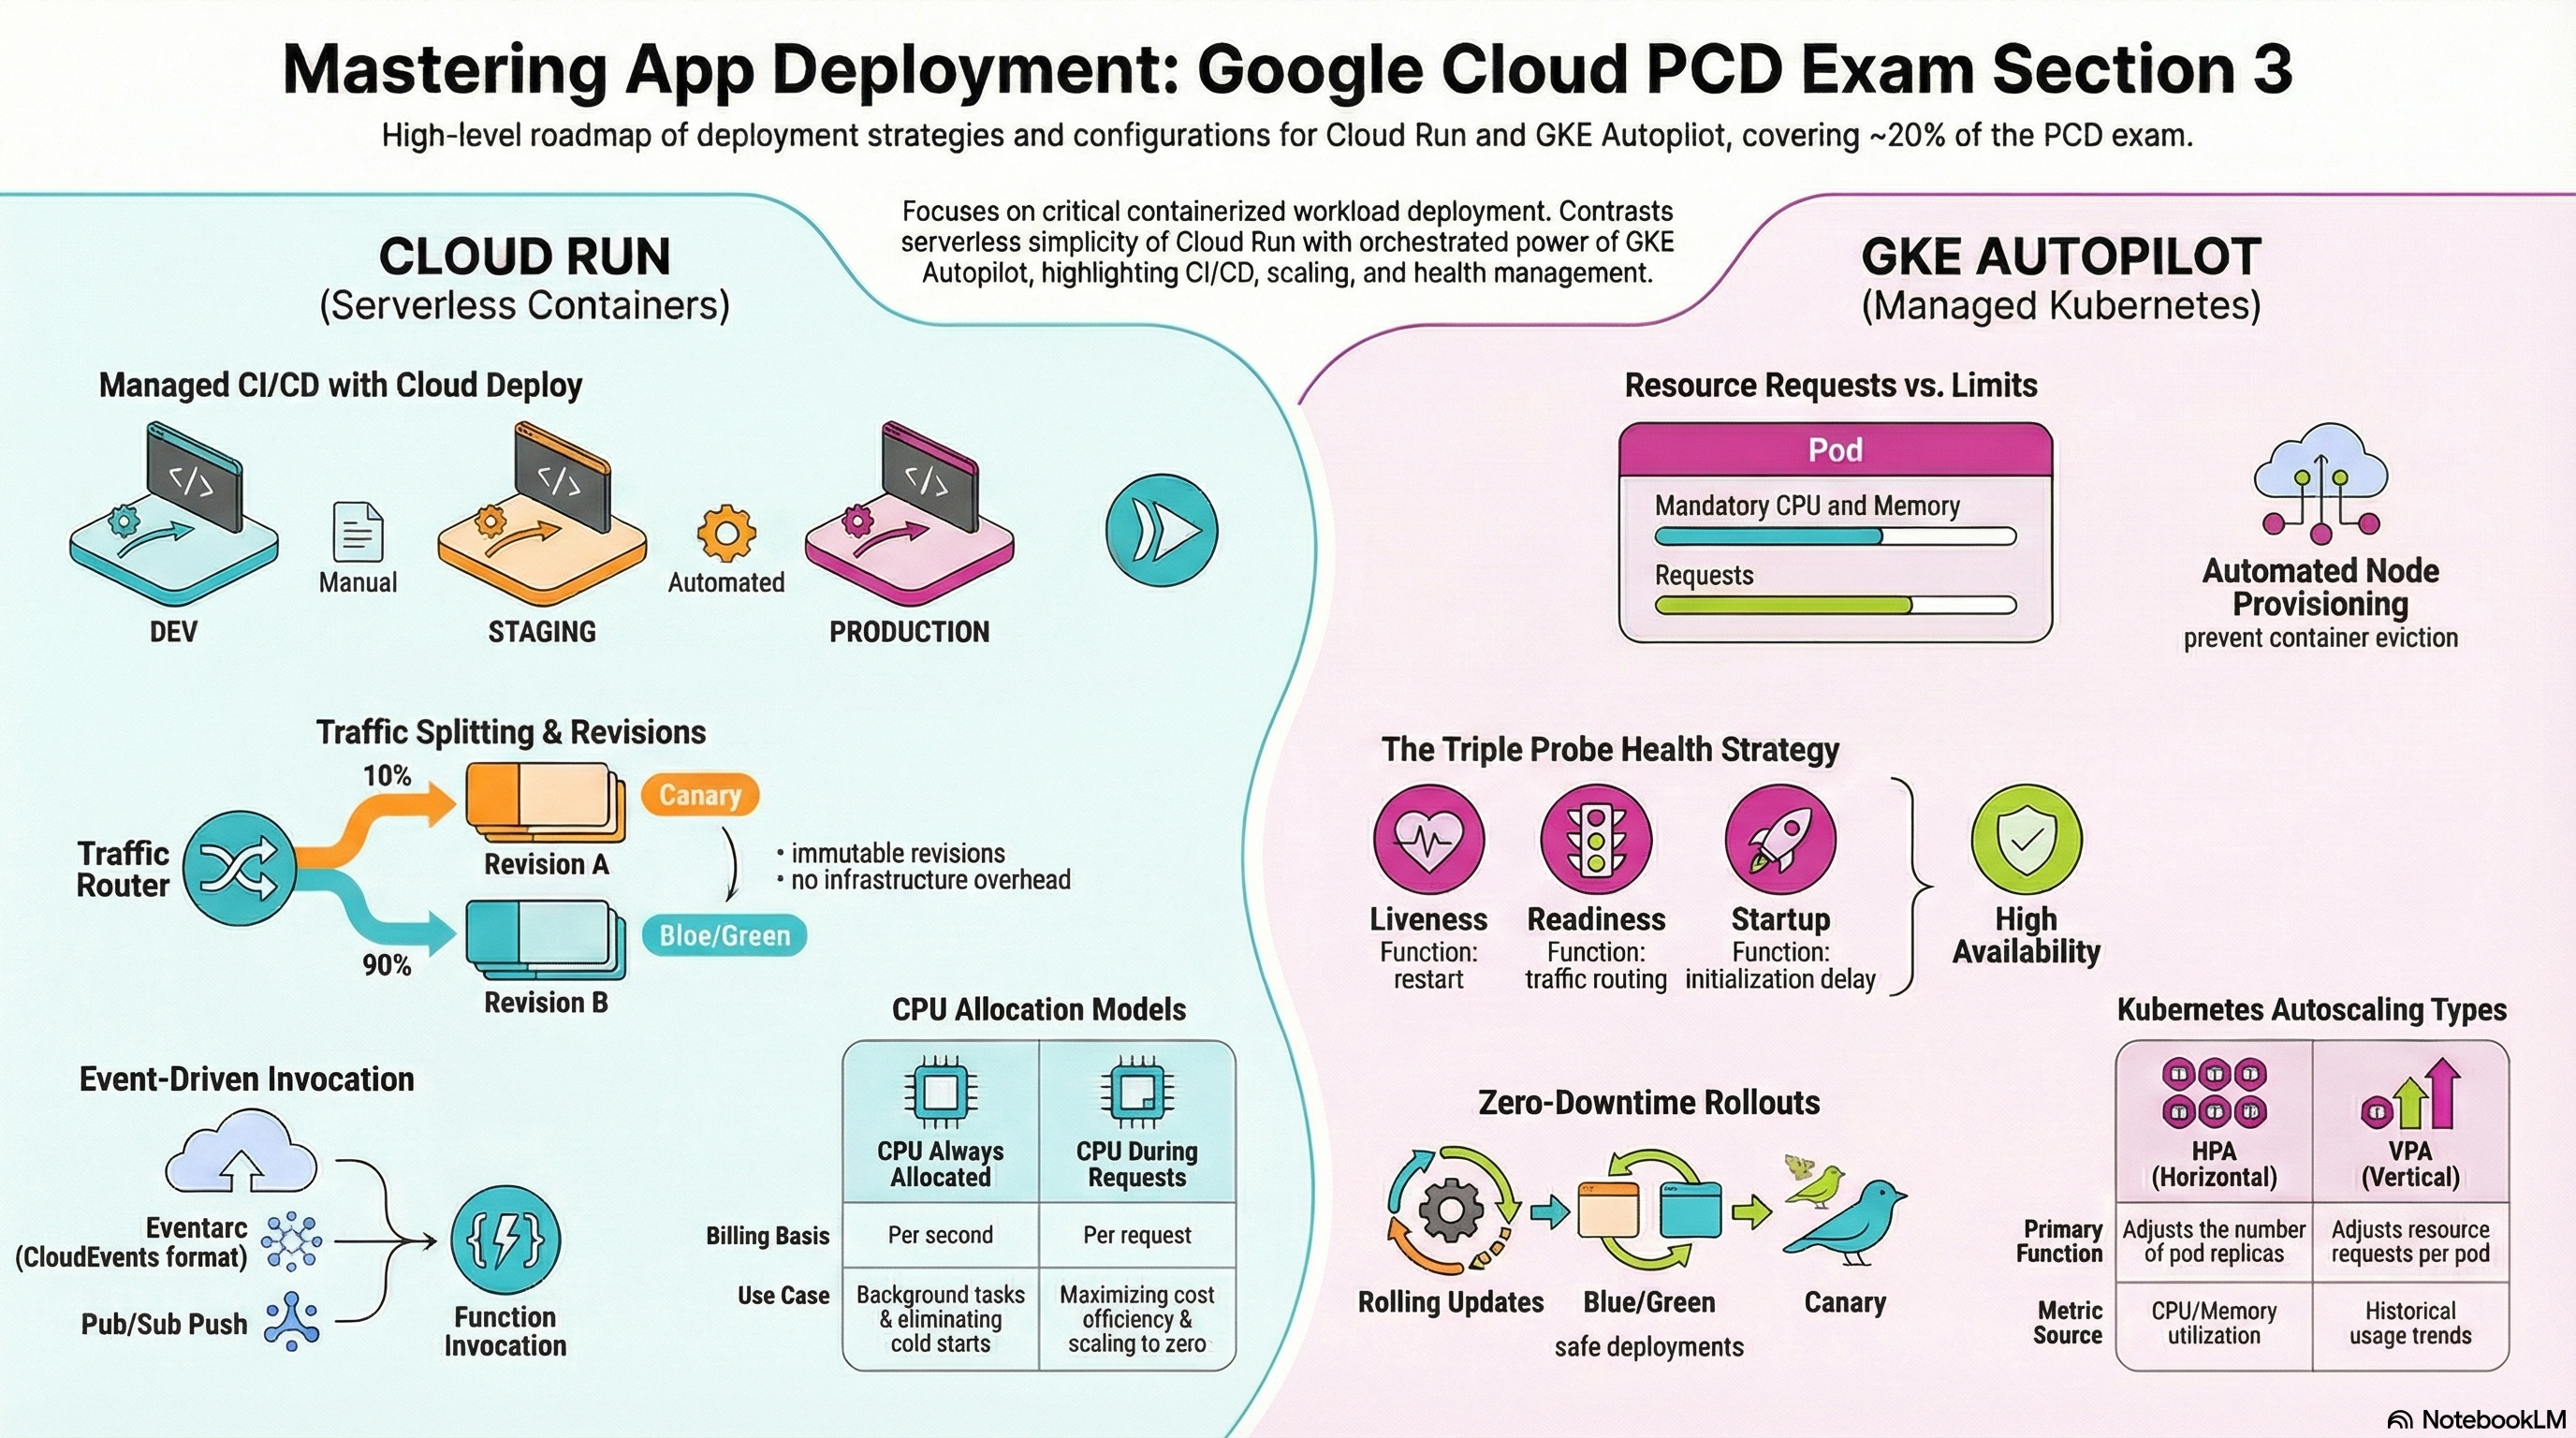
📚 Guide d'examen officiel : Professional Cloud Developer certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
C'est dans cette section que les modules de fondation RAD donnent toute leur mesure : App_CloudRun déploie un service Cloud Run v2 entièrement configuré (mise à l'échelle, sondes, volumes, gestion du trafic, jobs, pipeline Cloud Deploy facultatif) et App_GKE déploie la charge de travail Kubernetes équivalente sur GKE Autopilot (Deployment/StatefulSet, HPA, sondes, quotas, Gateway API). Déployez les profils Serverless baseline (socle serverless) et Delivery pipeline (pipeline de livraison) pour 3.1, et le profil Kubernetes lab (lab Kubernetes) pour 3.2 (voir la carte des labs).
3.1 Déploiement d'applications sur Cloud Run (Deploying applications to Cloud Run)
⏱ ~90 min · 💰 faible — les services par étape descendent à zéro ; Cloud Deploy lui-même est gratuit (vous payez le Cloud Build qu'il exécute) · ⚙️ Prérequis : Serverless baseline ; profil Delivery pipeline pour les étapes Cloud Deploy
Pourquoi l'examen s'y intéresse — Le guide actuel énumère quatre compétences pour 3.1 : déployer des applications à partir du code source, invoquer des services Cloud Run avec des déclencheurs (Eventarc, Pub/Sub), configurer des récepteurs d'événements, et gérer les versions, exposer et sécuriser des API (par exemple avec Apigee). Sous-jacent à toutes, il y a le modèle de ressources du service : chaque déploiement crée une révision immuable ; le trafic est acheminé entre les révisions par pourcentage et par tag ; la mise à l'échelle, l'allocation du CPU, l'environnement d'exécution et les sondes sont des propriétés de la révision. (Les stratégies de répartition du trafic sont désormais évaluées sous 1.1, et Cloud Deploy n'est plus un objectif nommé ; le contenu Cloud Deploy ci-dessous est conservé en tant que mécanisme de release du pipeline RAD.) Vous devez être capable de prédire l'effet d'une configuration donnée sur les démarrages à froid, le coût et le temps de retour arrière.
Comment RAD l'implémente — App_CloudRun construit le service Cloud Run v2 à partir des variables du portail :
| Aspect | Variables (valeurs par défaut) |
|---|---|
| Cycle de vie | deploy_application (true) — false ne provisionne que l'infrastructure |
| Image | container_image_source ("custom" = Cloud Build ; "prebuilt" = utiliser container_image tel quel), enable_image_mirroring (true) |
| Mise à l'échelle | min_instance_count (0), max_instance_count (1) ; vérification au moment du plan que min ≤ max |
| Exécution | container_port (8080), container_resources (1000m/512Mi), timeout_seconds (300), execution_environment ("gen2"), cpu_always_allocated (false), startup_cpu_boost activé en dur |
| Sondes | startup_probe_config (activée, HTTP /healthz, délai 10s, période 10s, seuil d'échec 10) et health_check_config → sonde de vivacité (activée, HTTP /healthz, délai 15s, période 30s, seuil d'échec 3) ; les deux prennent en charge TCP |
| Volumes | socket Cloud SQL (enable_cloudsql_volume true, montage cloudsql_volume_mount_path /cloudsql), NFS (enable_nfs true, nfs_mount_path /mnt/nfs), GCS Fuse (gcs_volumes) — NFS et Fuse exigent gen2 (validé) |
| Trafic | traffic_split (par défaut tout vers la dernière révision), tag de révision pour les URL d'aperçu, max_revisions_to_retain (7) |
| Réseau | ingress_settings ("all"), sortie VPC directe avec vpc_egress_setting ("PRIVATE_RANGES_ONLY") — aucun connecteur d'accès au VPC sans serveur n'est utilisé |
| Jobs | initialization_jobs (jobs Cloud Run v2 avec ordonnancement depends_on_jobs, execute_on_apply, montages NFS/GCS) ; cron_jobs |
À partir du code source : avec container_image_source = "custom", la plateforme construit votre code source (un Dockerfile, ou le container_build_config.dockerfile_content intégré) dans Cloud Build et déploie le résultat, et enable_cicd_trigger fait de même à chaque push sur github_repository_url (section 2.2) — l'équivalent, avec conteneur explicite, de gcloud run deploy --source ., qui utilise Buildpacks et n'est pas ce qu'exécutent les modules.
Exposition et sécurisation : ingress_settings détermine qui peut joindre le service (all, internal, internal-and-cloud-load-balancing), enable_iap place une authentification devant lui, les services publics reçoivent une liaison allUsers → roles/run.invoker alors que les services IAP n'en reçoivent pas, et enable_cloud_armor ajoute le WAF et une limite de débit par IP. Les URL de tag de révision fournissent une adresse stable par version. Les produits d'API — proxys d'API versionnés, clés d'API, quotas, portails développeurs — relèvent d'Apigee et ne sont pas provisionnés.
Livraison progressive : enable_cloud_deploy (par défaut false) crée un pipeline de livraison Cloud Deploy — le définir sans enable_cicd_trigger = true est refusé au moment du plan par une précondition d'App_CloudRun (sans déclencheur CI, le pipeline ne recevrait jamais de release). cloud_deploy_stages vaut par défaut dev → staging → prod, avec require_approval = true sur prod et auto_promote = false partout (un auto_promote par étape crée une automatisation Cloud Deploy). Chaque étape dispose de son propre service Cloud Run nommé <service>-<stage> ; seule l'étape prod hérite de votre ingress_settings (les étapes hors production restent à "all" pour que leurs URL *.run.app fonctionnent). Les configurations Skaffold résident dans un bucket GCS nommé {project}-{8-char-md5}-cd-configs ; les hooks Skaffold post-déploiement accordent le rôle invoker à allUsers sur les étapes publiques et exécutent les jobs d'initialisation avec gcloud run jobs execute --wait. Avec cicd_enable_cloud_deploy = true, le déclencheur Cloud Build se termine par gcloud deploy releases create au lieu de gcloud run services update.
À vous de jouer
-
Déployez le socle, puis listez les révisions et confirmez le câblage des sondes :
gcloud run services describe <service-name> --region=us-central1 \
--format="yaml(spec.template.spec.containers[0].startupProbe, spec.template.spec.containers[0].livenessProbe)" -
Avec le profil Delivery pipeline, poussez un commit et suivez la release :
gcloud deploy releases list --delivery-pipeline=<service-name> --region=us-central1
gcloud deploy rollouts list --delivery-pipeline=<service-name> \
--release=<release-name> --region=us-central1 -
Promouvez vers staging, puis approuvez prod (protégée par défaut) :
gcloud deploy releases promote --release=<release-name> \
  --delivery-pipeline=<service-name> --region=us-central1
gcloud deploy rollouts approve <rollout-name> --release=<release-name> \
  --delivery-pipeline=<service-name> --region=us-central1
Observez Console > Cloud Deploy > Delivery pipelines afficher le graphe des étapes à mesure que chaque déploiement se termine.
-
Inspectez les services par étape :
gcloud run services list --region=us-central1affiche<service>-dev,<service>-staging,<service>-prod. -
Vous savez que cela a fonctionné lorsque le déploiement en prod reste à l'état « Pending approval » jusqu'à ce que vous l'approuviez, et que le service prod sert ensuite la nouvelle image.
Testez-vous
Q1 : Une release a franchi dev et staging, mais le déploiement en prod est bloqué. Aucune erreur nulle part. Quelle est la cause la plus probable dans le pipeline RAD par défaut ?
R : L'étape prod a require_approval = true par défaut — le déploiement attend à l'état PENDING_APPROVAL un gcloud deploy rollouts approve (ou une approbation dans la console). C'est le contrôle manuel voulu, pas un échec ; l'examen le formule ainsi : « le déploiement exige la validation d'un responsable avant la production ».
Q2 : Vous définissez enable_cloud_deploy = true sans enable_cicd_trigger = true et le plan échoue sur une erreur de précondition. Pourquoi le module exige-t-il le déclencheur ?
R : Les releases Cloud Deploy ne sont créées que par le pipeline CI/CD ; un pipeline de livraison sans rien pour créer des releases n'a pas de sens, et le module refuse donc la combinaison au moment du plan au lieu de provisionner un pipeline mort. Leçon d'examen généralisée : la livraison progressive se situe en aval de la CI — Cloud Deploy consomme des artefacts, il ne les construit pas.
Q3 : Comment fournir à l'équipe QA une URL vers une révision non publiée sans lui envoyer de trafic de production ?
R : Ajoutez une entrée traffic_split pour la révision avec percent = 0 et un tag (par exemple "qa"). Cloud Run expose une URL taguée stable (https://qa---<service>-<hash>.run.app) qui achemine directement vers cette révision, tandis que l'URL principale continue de servir la répartition stable.
Au-delà des modules — L'examen attend l'invocation événementielle de Cloud Run et les récepteurs d'événements — les modules n'utilisent Eventarc qu'en interne pour la rotation des secrets ; entraînez-vous donc dans un projet de test : un déclencheur Eventarc livrant des CloudEvents (par exemple un événement de finalisation d'objet Cloud Storage) à un service, un abonnement push Pub/Sub s'authentifiant avec un jeton OIDC pour un compte de service disposant de roles/run.invoker, et le côté récepteur — analyser le CloudEvent ou décoder en base64 le message.data de Pub/Sub, renvoyer un code 2xx pour accuser réception et rendre le gestionnaire idempotent, car la livraison se fait au moins une fois. Étudiez aussi les déploiements depuis la source (gcloud run deploy --source .), les stratégies de gestion des versions d'API (chemin d'URL ou en-tête, tags de révision) et la publication d'une API versionnée, protégée par clé ou par JWT, via Apigee ou API Gateway. Étudiez également les stratégies canary et de retour arrière automatisé dans Cloud Deploy (stratégie de déploiement canary avec pourcentages de trafic par phase) — le pipeline RAD utilise la stratégie standard avec promotion manuelle. Essayez gcloud deploy rollouts retry et gcloud run services update-traffic --to-latest dans un projet de test.
⚠️ Piège d'examen — La sonde de démarrage et la sonde de vivacité échouent différemment : une sonde de démarrage en échec signifie que l'instance ne reçoit jamais de trafic et que Cloud Run continue de relancer/remplacer les instances (les déploiements semblent bloqués) ; une sonde de vivacité en échec redémarre un conteneur qui était sain. « Nouvelle révision bloquée à 0 % de trafic servi » est presque toujours dû à la sonde de démarrage (mauvais path ou mauvais port), pas à la sonde de vivacité.
3.2 Déploiement de conteneurs sur GKE (Deploying containers to GKE)
⏱ ~90 min · 💰 modéré — Autopilot facture la somme des demandes de ressources des pods plus des frais de cluster ; les exercices sur les quotas, les PDB et les sondes n'ajoutent rien · ⚙️ Prérequis : profil Kubernetes lab (
create_google_kubernetes_engine = truedans Services_GCP, puis App_GKE)
Pourquoi l'examen s'y intéresse — Le guide actuel énumère trois compétences pour 3.2 : déployer des applications conteneurisées, mettre en œuvre des contrôles d'état Kubernetes pour améliorer la disponibilité, et intégrer les attributs du Horizontal Pod Autoscaler (mise à l'échelle, métriques). Les questions GKE évaluent le modèle de ressources Kubernetes sous l'angle de Google : demandes ou limites (et la façon dont Autopilot les facture), choix entre Deployment et StatefulSet, HPA ou VPA, sémantique des sondes, budgets d'interruption et exposition moderne via la Gateway API. Les spécificités d'Autopilot comptent : vous dimensionnez des pods, pas des nœuds.
Comment RAD l'implémente — Services_GCP provisionne le cluster : gke_cluster_mode par défaut "AUTOPILOT", Dataplane V2, plages secondaires pods/services en mode VPC natif (IP d'alias), Workload Identity ({project}.svc.id.goog), le canal standard de la Gateway API, la version disponible REGULAR et le module complémentaire Secret Manager. App_GKE y déploie ensuite (en découvrant le cluster via gke_cluster_selection_mode, ou en provisionnant un cluster Autopilot intégré lorsque le module de plateforme est absent) :
- Type de charge de travail.
workload_type(par défautnull) se résout automatiquement :stateful_pvc_enabled = true→ StatefulSet (avecstateful_pvc_sizeetstateful_pvc_mount_pathobligatoires,stateful_pod_management_policypar défautOrderedReady,stateful_update_strategypar défautRollingUpdate) ; sinon Deployment. Définir explicitementworkload_type = "Deployment"en même temps questateful_pvc_enabled = trueéchoue au moment du plan. - Autoscaling. Le HPA n'est créé que lorsque
max_instance_count > 1(par défaut3) etenable_vertical_pod_autoscaling = false(sa valeur par défaut) ; il vise 70 % d'utilisation du CPU et 80 % de la mémoire. Activer le VPA remplace donc la mise à l'échelle horizontale par un redimensionnement des demandes — les deux s'excluent ici, car ils agiraient sur les mêmes signaux CPU/mémoire. - Sondes.
startup_probe_config(activée, HTTP/healthz, délai 10s, période 10s, seuil d'échec 3) ethealth_check_config→ sonde de vivacité (délai 15s, période 30s, seuil d'échec 3). Aucune sonde de disponibilité (readiness) n'est configurée — le module s'appuie sur la sonde de démarrage pour contrôler l'arrivée du premier trafic ; soyez prêt à expliquer à l'examen pourquoi une sonde de disponibilité dédiée reste importante pour les pods temporairement surchargés. - Sidecar. Lorsqu'une base de données existe et que
enable_cloudsql_volume = true, un sidecarcloud-sql-proxy(image mise en miroir dans Artifact Registry) s'exécute avec--private-ipet un hook preStop qui appelle/quitquitquitpour un arrêt progressif. - Gouvernance de l'espace de noms.
enable_resource_quota(par défautfalse) crée un ResourceQuota —quota_cpu_requests/quota_cpu_limitspar défaut"4",quota_memory_requestspar défaut"4Gi",quota_memory_limitspar défaut"8Gi"(le suffixe d'unité binaire est validé : un"4"seul serait interprété par Kubernetes comme 4 octets et bloquerait toute planification),quota_max_pods"20".enable_pod_disruption_budget(par défauttrue) crée un PDB avecpdb_min_availablepar défaut"1", omis lorsquemax_instance_count = 1et validé comme étant <max_instance_count.enable_network_segmentation(par défautfalse) ajoute des NetworkPolicies (exige Dataplane V2).enable_topology_spreadrépartit les pods entre zones/hôtes. - Exposition. Le Service a un
service_typepar défaut"LoadBalancer",service_port80→container_port8080,session_affinitypar défaut"ClientIP".enable_custom_domain(par défautfalse) bascule vers la Gateway API : uneGatewayavecgatewayClassName: gke-l7-global-external-managed, uneHTTPRoute(plus unReferenceGrantpour les backends d'autres espaces de noms), des certificats gérés par Google via Certificate Manager pourapplication_domains, et une IP statique globale réservée (reserve_static_ippar défauttrue). Cloud Armor et le CDN se rattachent viaGCPBackendPolicy.
À vous de jouer
-
Récupérez les identifiants et inspectez ce que le module a déployé (l'espace de noms est généré automatiquement à partir d'
application_name+tenant_id, sauf sinamespace_nameest défini) :gcloud container clusters get-credentials <cluster-name> --region=us-central1
kubectl get ns
kubectl -n <namespace> get deploy,hpa,pdb,resourcequota,svc -
Confirmez le câblage des sondes et du sidecar, et observez une mise à jour progressive :
kubectl -n <namespace> get deploy <name> -o yaml | grep -A6 -E "startupProbe|livenessProbe|cloud-sql-proxy"
kubectl -n <namespace> rollout status deploy/<name>
kubectl -n <namespace> rollout history deploy/<name> -
Déclenchez le HPA : lancez un générateur de charge sur l'IP du Service et regardez le nombre de répliques monter vers
max_instance_count:kubectl -n <namespace> get hpa -w -
Définissez
enable_resource_quota = trueavecquota_max_pods = "2"alors quemax_instance_count = 3, générez de la charge, et observez les pods bloqués par le quota danskubectl -n <namespace> get events --sort-by=.lastTimestamp. -
Vous savez que cela a fonctionné lorsque le HPA affiche des événements de mise à l'échelle
cpu: <current>%/70%et que l'événement de quota indiqueexceeded quotalorsque le plafond est atteint.
Testez-vous
Q1 : Sur Autopilot, une équipe définit des limites de 4 CPU/8Gi « par sécurité » alors que l'utilisation réelle est de 200m/300Mi. Quel est l'effet sur le coût, et quelle est la correction ?
R : Autopilot facture les demandes de ressources du pod (et déduit les demandes des limites lorsqu'elles ne sont pas définies) ; une surdéclaration multiplie donc le coût par ~20, quelle que soit l'utilisation. Correction : définissez des demandes container_resources réalistes (cpu_request/mem_request) inférieures aux limites, ou activez enable_vertical_pod_autoscaling = true et laissez le VPA redimensionner les demandes — en acceptant que le module supprime alors le HPA.
Q2 : Un événement de maintenance évince des pods et l'application sert brièvement 0 réplique. Quelle valeur par défaut de RAD aurait dû l'empêcher, et quand ne s'applique-t-elle pas, sans le signaler ?
R : Le PodDisruptionBudget (enable_pod_disruption_budget = true, pdb_min_available = "1") garantit qu'au moins un pod reste actif lors des évictions volontaires. Il est volontairement omis lorsque max_instance_count = 1 — un PDB avec minAvailable 1 sur une charge de travail à une seule réplique bloquerait complètement les mises à niveau des nœuds. Les charges de travail à une seule réplique n'ont donc, par conception, aucune protection contre les interruptions.
Q3 : Vous avez besoin de volumes stables par pod et d'un démarrage ordonné pour un datastore en cluster. Que définissez-vous, et que se passe-t-il si vous forcez aussi workload_type = "Deployment" ?
R : Définissez stateful_pvc_enabled = true avec stateful_pvc_size et stateful_pvc_mount_path — la charge de travail se résout automatiquement en StatefulSet avec la gestion des pods OrderedReady. Forcer en parallèle workload_type = "Deployment" échoue au moment du plan, car les Deployments partagent leurs volumes et n'ont pas d'identité stable — la validation encode la règle de décision même de l'examen.
Au-delà des modules — Étudiez le réglage de maxSurge/maxUnavailable pour les mises à jour progressives et le blue/green par basculement de labels de Services (le module utilise toujours les paramètres RollingUpdate par défaut), la gestion des pools de nœuds GKE Standard (gcloud container node-pools create) et le trafic canary fin sur GKE (qui exige un maillage de services ou une répartition du trafic de la Gateway API entre deux Services — la HTTPRoute du module cible un seul backend, sélectionnable par étape Cloud Deploy via gateway_backend_stage, par défaut "dev"). Connaissez aussi kubectl rollout undo pour un retour arrière instantané d'un Deployment, ainsi que les attributs du HPA au-delà des cibles CPU/mémoire fixes du module : métriques personnalisées et externes (par exemple le backlog Pub/Sub via Cloud Monitoring) et les fenêtres de stabilisation behavior de montée et de descente en charge.
⚠️ Piège d'examen — Demandes ou limites sur Autopilot : la planification, la comptabilisation des quotas (quota_*_requests) et la facturation reposent toutes sur les demandes, tandis que les arrêts pour OOM reposent sur les limites de mémoire. « Réduire la limite » ne réduit pas le coût Autopilot si la demande reste élevée — et une limite de mémoire inférieure à l'utilisation réelle transforme un pod fonctionnel en CrashLoopBackOff.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.