Guide de préparation à la certification PCDE : Section 3 — Migrer des solutions de données (Migrate data solutions) (~23 % de l'examen)
📚 Guide officiel de l'examen : Certification Professional Cloud Database Engineer — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Ce guide couvre la section 3 de l'examen Professional Cloud Database Engineer (PCDE). Soyons clairs d'emblée : c'est la section où les modules de base de RAD couvrent le moins de terrain. Les modules mettent en œuvre de bout en bout le chemin de migration par export/import (avec interruption prolongée) — des jobs d'import de sauvegarde d'App_CloudRun/App_GKE alimentés depuis GCS ou Google Drive, pilotés par les scripts d'App_Common — ainsi que la réplication en lecture au sein de Google Cloud via Services_GCP. Database Migration Service, Datastream, les basculements sans interruption et la réplication inverse relèvent du concept uniquement et s'accompagnent de longues listes d'étude « Au-delà des modules ». Déployez les profils relational-baseline et app-dataops décrits dans la carte des labs PCDE avant de commencer.
3.1 Concevoir et mettre en œuvre la migration et la réplication de données (Design and implement data migration and replication)
⏱ ~90 min (moitié pratique, moitié lecture) · 💰 faible — un job d'import + un dépôt intermédiaire dans GCS · ⚙️ Prérequis : profil app-dataops avec
enable_backup_import = true
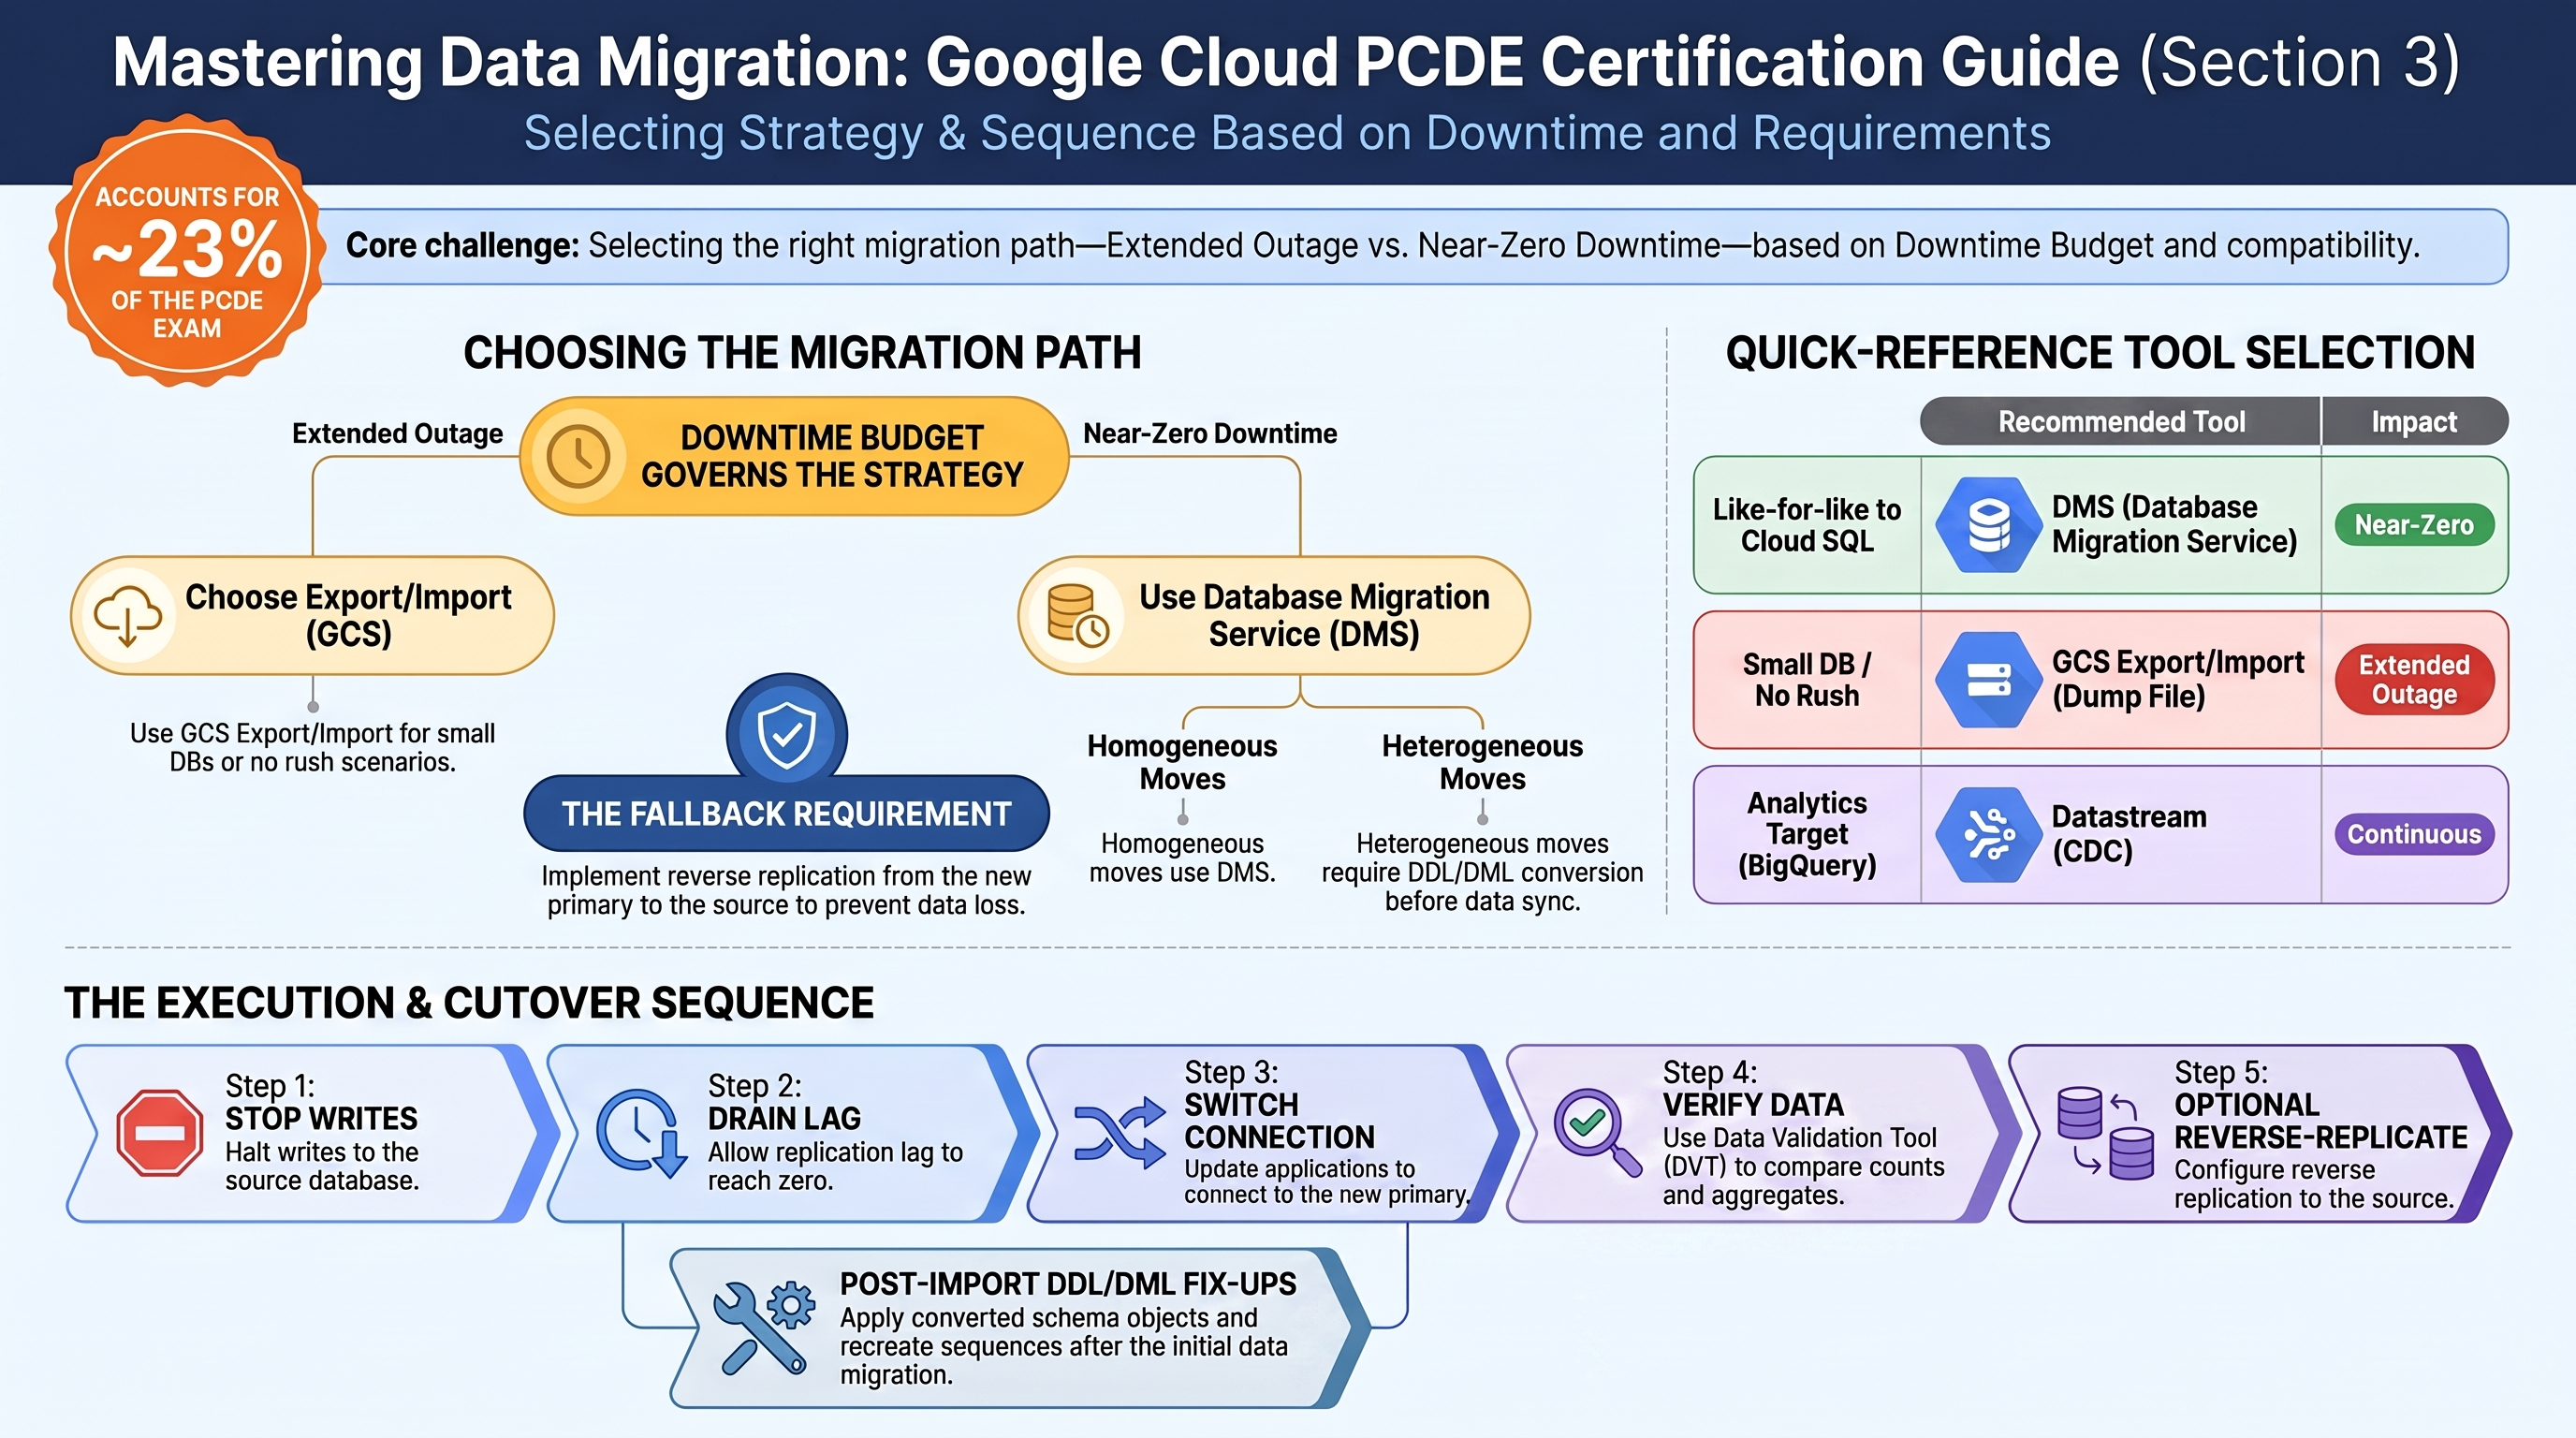
Pourquoi l'examen s'y intéresse — Les questions de migration sont des questions de budget d'interruption. L'arbre de décision évalué par l'examen : interruption prolongée acceptable → export/import ponctuel (fichier de dump via GCS) ; interruption quasi nulle → réplication continue (Database Migration Service pour les migrations homogènes vers Cloud SQL/AlloyDB, Datastream/CDC pour les migrations hétérogènes) avec un basculement court ; retour arrière exigé → réplication inverse depuis la nouvelle instance principale vers la source, afin de pouvoir revenir en arrière si le basculement échoue. Les migrations hétérogènes ajoutent par-dessus une conversion DDL/DML (traduction du schéma, des types et du dialecte). Vous devez choisir l'outil et séquencer le basculement : arrêter les écritures → résorber le délai de réplication → changer les chaînes de connexion → vérifier → (éventuellement) répliquer en sens inverse.
Comment RAD le met en œuvre — le chemin avec interruption prolongée est réel et exécutable :
| Étape d'un lift-and-shift | Mise en œuvre dans les modules |
|---|---|
| Export depuis la source | le script d'export (App_Common) — pg_dump/mysqldump correspondant à la version, qui produit backup-<timestamp>.tar.gz ; pour une source externe, vous exécutez vous-même le dump équivalent |
| Dépôt intermédiaire de l'artefact | Le bucket GCS de sauvegarde provisionné par le module (cycle de vie géré par backup_retention_days, valeur par défaut 7), ou Google Drive |
| Import dans Cloud SQL | enable_backup_import = true (valeur par défaut false) exécute un job ponctuel <service>-backup-import sélectionné par backup_source (gcs/gdrive, valeur par défaut gcs), qui restaure backup_file (valeur par défaut backup.sql) avec backup_format (sql,tar,gz,tgz,tar.gz,zip,auto) via le volume du connecteur Cloud SQL |
| Corrections après import (ajustements DDL/DML) | enable_custom_sql_scripts + custom_sql_scripts_bucket/custom_sql_scripts_path (+ custom_sql_scripts_use_root pour le DDL privilégié) exécute des fichiers .sql dans l'ordre lexicographique — l'endroit où appliquer les objets de schéma convertis, recréer les séquences ou corriger les collations |
| Réplication (au sein de GCP) | create_postgres_read_replica / create_mysql_read_replica dans Services_GCP — la réplication asynchrone native de Cloud SQL, le même mécanisme qu'utilise une migration DMS pour la synchronisation de sa destination, observable de bout en bout |
Ce que les modules ne font délibérément pas : se connecter à une source externe, exécuter une capture des données modifiées (CDC) ou orchestrer un basculement. Il n'existe aucune configuration DMS, Datastream ou de réplication depuis un serveur externe dans aucun des quatre modules.
À vous de jouer
-
Simulez une base de données source : connectez-vous à l'instance du lab (Auth Proxy + psql comme dans la section 1.3), créez une table contenant des lignes et exportez-la — ou laissez simplement l'export planifié de la section 2.5 en produire un. Déposez explicitement votre propre fichier :
pg_dump -h 127.0.0.1 -U postgres -d postgres -f /tmp/source-dump.sql
gcloud storage cp /tmp/source-dump.sql gs://<backup-bucket>/source-dump.sql -
Dans le portail, définissez
enable_backup_import = true,backup_source = "gcs",backup_file = "source-dump.sql",backup_format = "sql", et appliquez. Suivez le job d'import :gcloud run jobs executions list --job=<service>-backup-import --region=us-central1
gcloud logging read 'resource.type="cloud_run_job" AND resource.labels.job_name="<service>-backup-import"' \
--limit=50 --freshness=1h -
Vérifiez que le nombre de lignes correspond à la source (la première validation de l'ingénieur de migration) :
psql -h 127.0.0.1 -U <app-user> -d <db> -c "SELECT count(*) FROM <your_table>;" -
Pour le volet réplication, appliquez ha-production (section 1.2) et observez
cloudsql-<prefix>-postgres-replicas'initialiser puis rattraper son retard —gcloud sql instances describe cloudsql-<prefix>-postgres-replica --format="value(state, replicaConfiguration)". C'est la même mécanique de répliques que pilote DMS pendant une migration continue. -
Vous savez que cela a fonctionné lorsque l'exécution de l'import réussit et que le nombre de lignes dans la destination est égal à celui de la source.
Testez-vous
Q1 : Une base de données PostgreSQL 14 sur site de 2 To doit migrer vers Cloud SQL avec moins de 5 minutes d'interruption. Le modèle de job d'import de la plateforme est-il approprié ? Qu'est-ce qui l'est ?
R : Non — un dump/restauration de 2 To prend des heures, entièrement en interruption (ce modèle ne convient que lorsqu'une interruption prolongée est acceptable). Utilisez Database Migration Service : instantané initial plus réplication CDC continue depuis la source, laissez le délai se résorber pendant que la source reste en service, puis effectuez un basculement de quelques minutes. Les migrations homogènes DMS vers Cloud SQL sont gratuites, ce que l'examen aime mentionner.
Q2 : Après le basculement vers Cloud SQL, l'entreprise exige un chemin de retour arrière pendant deux semaines. Quel est le mécanisme, et qu'est-ce qui doit rester vrai côté source ?
R : La réplication inverse : répliquer les modifications de la nouvelle instance principale Cloud SQL vers l'ancienne source (DMS permet de configurer l'ancienne source comme réplique de l'instance migrée pour PostgreSQL/MySQL, ou bien vous maintenez vous-même une réplication logique), afin que l'application puisse être redirigée vers la source sans perte de données. La source doit rester compatible au niveau du schéma et joignable, et aucune écriture ne doit lui parvenir directement pendant la fenêtre de retour arrière — sinon les deux divergent.
Q3 : Une migration d'Oracle vers PostgreSQL est bloquée à cause de PL/SQL et de types de données incompatibles. De quelle catégorie de travail s'agit-il, et quels outils y répondent ?
R : La conversion DDL/DML — les migrations hétérogènes exigent une traduction du schéma et du code, et pas seulement un déplacement des données. Outils : les espaces de travail de conversion Oracle vers PostgreSQL de DMS (fondés sur Ora2Pg), la réécriture manuelle des procédures stockées, plus des décisions de correspondance de types (NUMBER → numeric, DATE → timestamp). Sur cette plateforme, le DDL converti serait appliqué via le job de scripts SQL personnalisés ; la conversion elle-même reste toujours un travail d'ingénierie que l'examen attend de vous voir planifier avant la synchronisation des données.
Au-delà des modules — L'essentiel de la section 3 se trouve ici ; prévoyez un vrai temps d'étude :
- Database Migration Service (DMS) : profils de connexion, jobs de migration, migrations homogènes (MySQL/PostgreSQL → Cloud SQL/AlloyDB, gratuites) ou hétérogènes (Oracle/SQL Server → PostgreSQL, espaces de travail de conversion). Dans un projet de test, parcourez
gcloud database-migration connection-profiles create postgresql ...etgcloud database-migration migration-jobs create ... --type=CONTINUOUS, même seulement jusqu'à l'étape de validation — la phase de vérification (gcloud database-migration migration-jobs verify) est appréciée de l'examen. - Datastream pour la CDC vers BigQuery/GCS lorsque la cible est l'analytique plutôt qu'une base de données équivalente.
- Réplication depuis un serveur externe pour Cloud SQL (documentation « Replicating from an external server ») : le modèle antérieur à DMS, qui consiste à faire d'une instance Cloud SQL la réplique d'une instance principale externe ; promotion = basculement (
gcloud sql instances promote-replica). - Séquencement sans interruption : pièges de la double écriture, résorption du délai avant basculement, changement des chaînes de connexion via Secret Manager (les secrets
DB_HOST/d'hôte pilotant cette plateforme montrent exactement où vous effectueriez la bascule). - Outils de validation : l'outil open source Data Validation Tool (DVT) pour comparer les lignes et les agrégats entre la source et la cible.
⚠️ Piège d'examen — « Utilisez le job d'import / gcloud sql import sql pour la migration » est la réponse piège chaque fois que le scénario indique un budget d'interruption en minutes. À l'inverse, « mettez en place DMS » est le piège lorsque le scénario indique qu'une interruption d'un week-end est acceptable et que la base de données est petite — un export/import ponctuel est plus simple, moins cher, et c'est exactement ce qu'automatise cette plateforme.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.