Guide de préparation à la certification PCDE : Section 2 — Gérer une solution pouvant couvrir plusieurs technologies de bases de données (Manage a solution that can span multiple database technologies) (~25 % de l'examen)
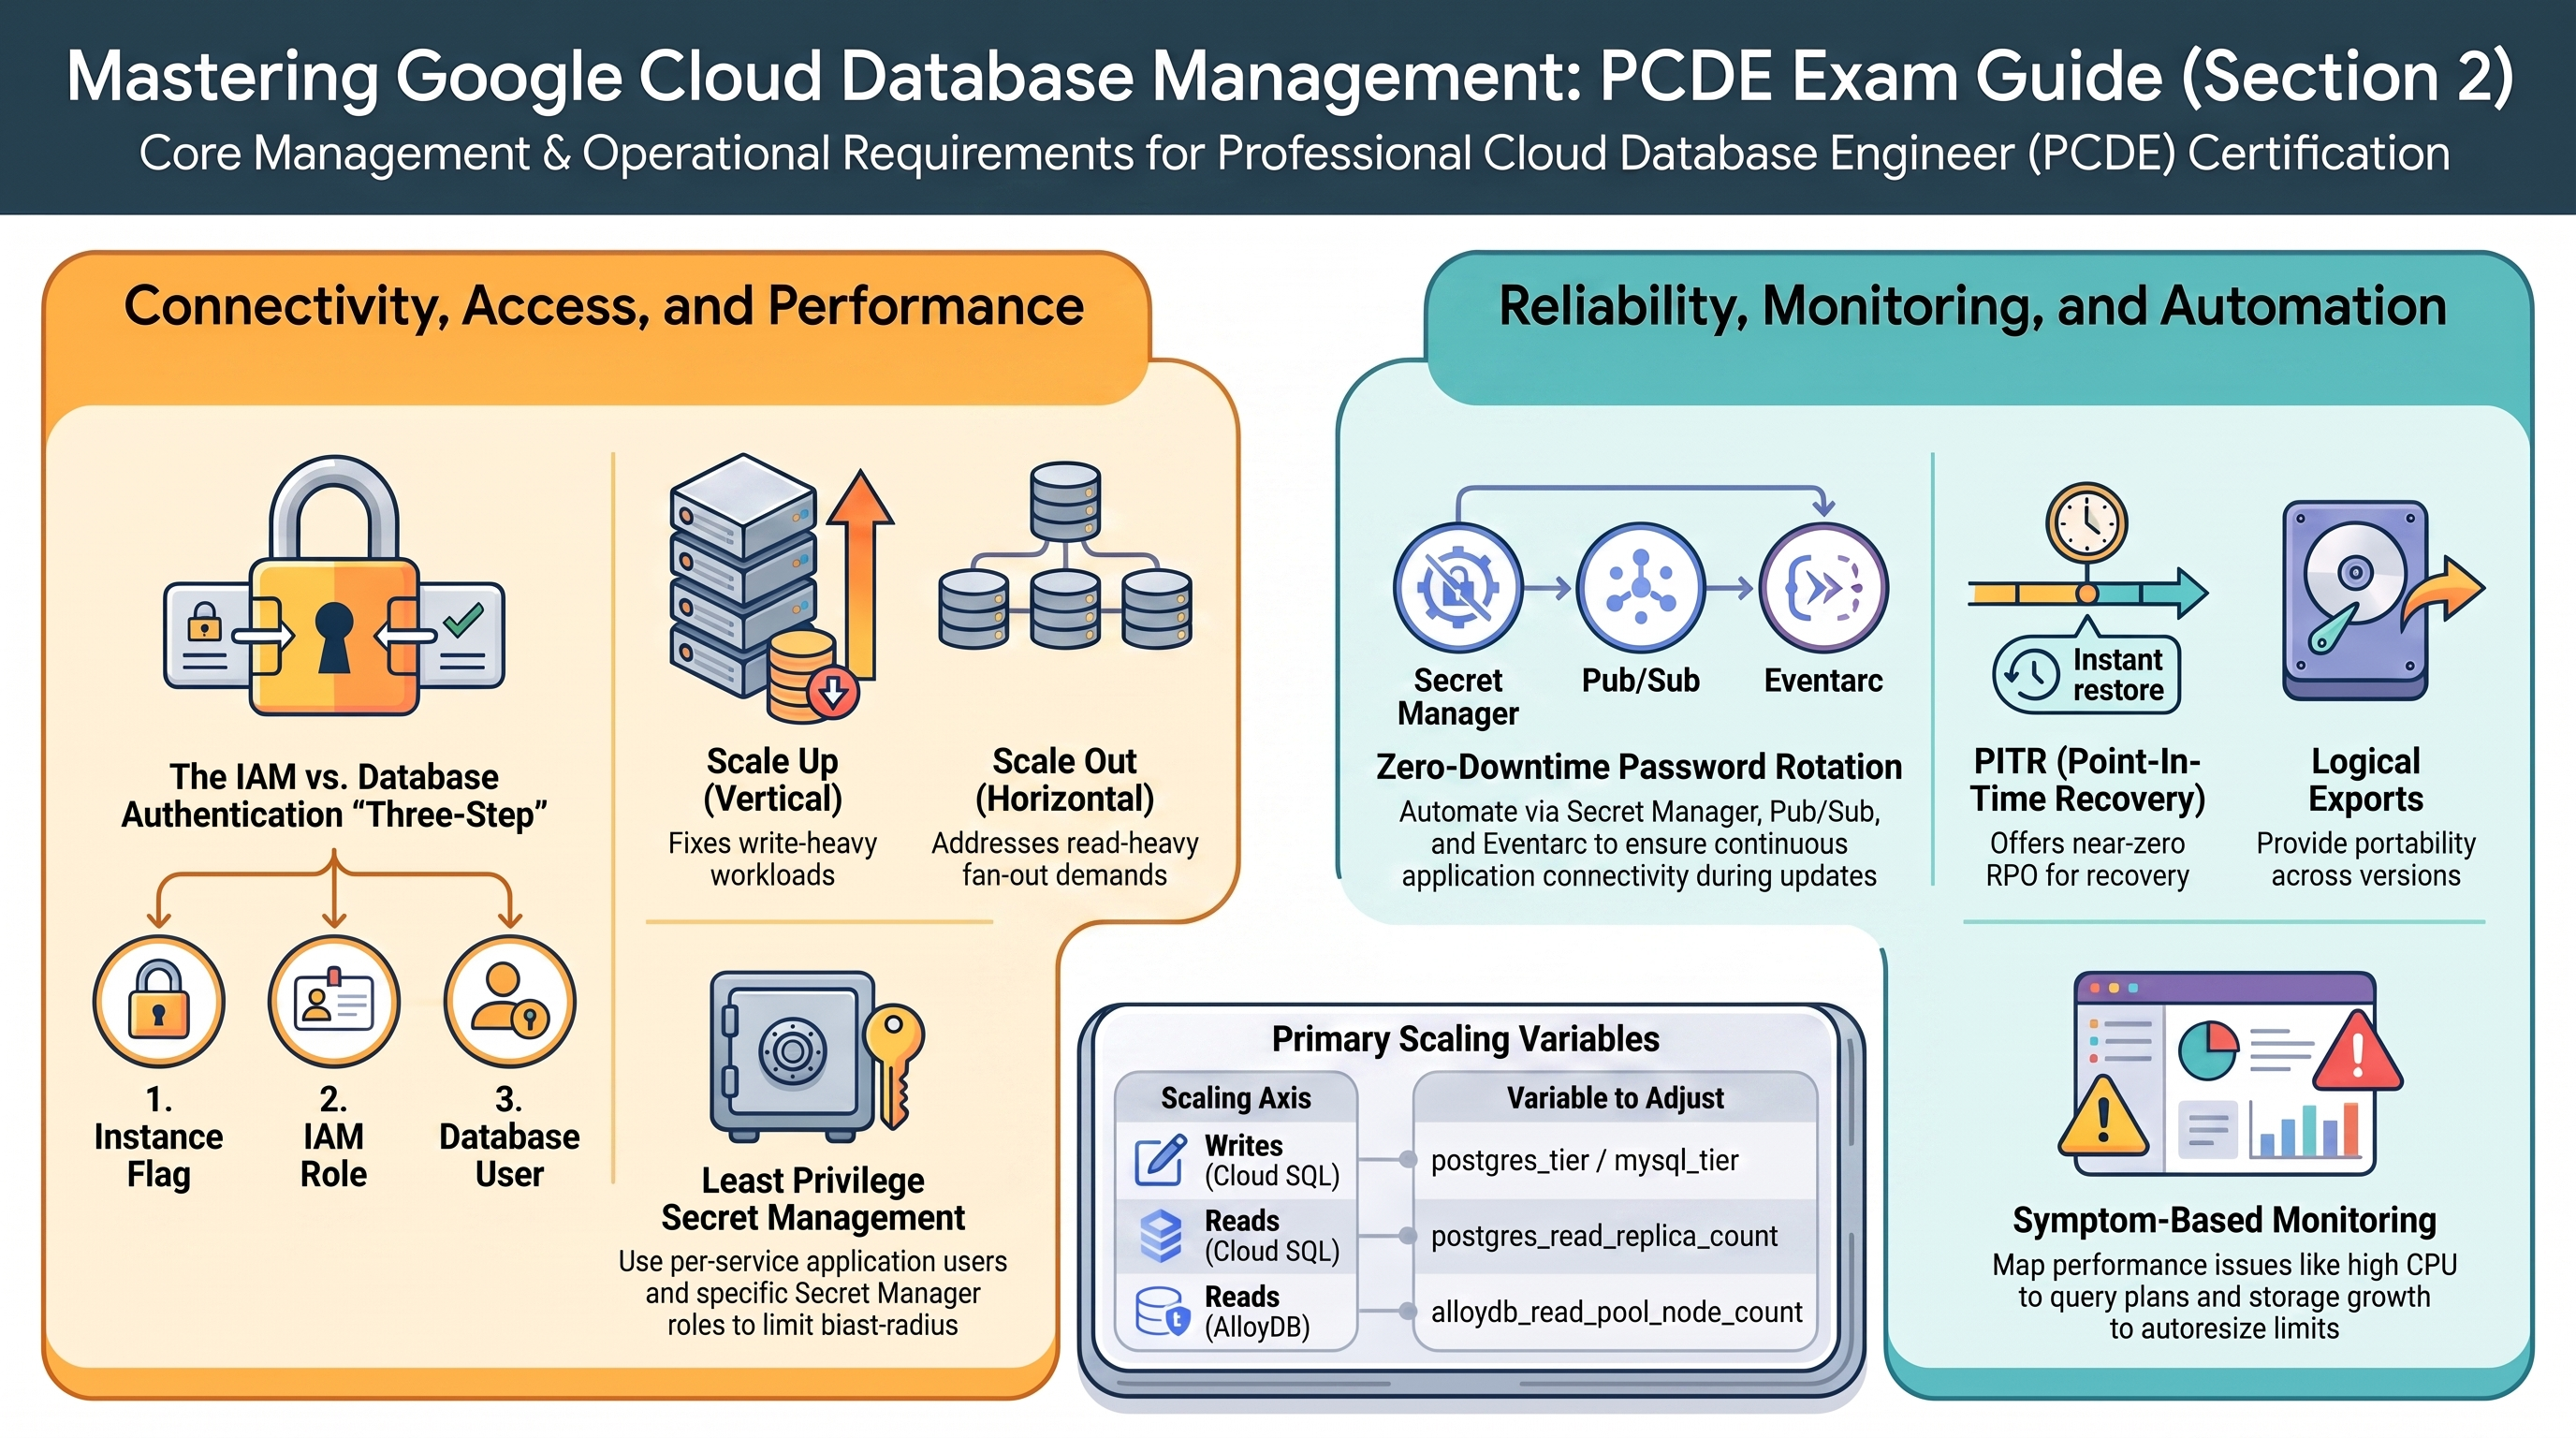
📚 Guide officiel de l'examen : Certification Professional Cloud Database Engineer — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Ce guide couvre la section 2 de l'examen Professional Cloud Database Engineer (PCDE) : la gestion du « jour 2 » — contrôle des accès, surveillance, sauvegarde/restauration, optimisation du coût et des performances, et automatisation des tâches. Il fait travailler les quatre modules de base : Services_GCP (instances, authentification IAM, règles d'alerte), App_CloudRun et App_GKE (utilisateurs de base de données, planificateurs d'export, jobs de rotation), ainsi que les sous-modules et scripts d'App_Common qui les mettent en œuvre. Déployez les profils relational-baseline et app-dataops décrits dans la carte des labs PCDE avant de commencer ; la sous-section 2.2 tire aussi parti des paramètres de notification du profil ha-production.
2.1 Déterminer les considérations de connectivité et de gestion des accès à la base de données (Determine database connectivity and access management considerations)
⏱ ~45 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : profil relational-baseline ; définissez
enable_cloudsql_iam_auth = truesur Services_GCP
Pourquoi l'examen s'y intéresse — L'examen distingue deux couches qu'il aime confondre dans ses distracteurs : IAM contrôle qui peut atteindre et administrer l'instance (roles/cloudsql.client, roles/cloudsql.instanceUser, roles/cloudsql.admin), tandis que les utilisateurs de base de données contrôlent ce qui se passe à l'intérieur du moteur (GRANT, propriété des objets). L'authentification IAM à la base de données fait le pont entre les deux — des jetons OAuth de courte durée à la place des mots de passe — et vous devez connaître ses étapes de mise en place et ses limites.
Comment RAD le met en œuvre —
| Mécanisme | Où | Détail |
|---|---|---|
| Authentification IAM à la base de données | Services_GCP | enable_cloudsql_iam_auth (valeur par défaut false) ajoute l'option de base de données d'authentification IAM à l'instance principale PostgreSQL et à ses répliques ainsi qu'à l'instance principale MySQL, et attribue roles/cloudsql.instanceUser aux comptes de service Cloud Run et Cloud Build |
| Utilisateurs intégrés | Services_GCP | Le mot de passe root est un mot de passe aléatoire de 16 caractères, accompagné d'une ressource explicite d'utilisateur de base de données (root@% pour MySQL — la ressource explicite est nécessaire au modèle d'attribution de MySQL), stocké uniquement dans Secret Manager (secret-<instance>-root-password) |
| Utilisateurs applicatifs | le job db-init dans App_CloudRun / App_GKE | Crée de façon idempotente un utilisateur de base de données par application, crée la base de données avec cet utilisateur comme propriétaire, et applique GRANT ALL PRIVILEGES ON DATABASE / GRANT ALL ON SCHEMA public (PostgreSQL) ou CREATE USER '<user>'@'%' + les attributions (MySQL) |
| Identifiant applicatif | database_password_length d'App_CloudRun/App_GKE (valeur par défaut 32, valeurs validées : 16–64) | Mot de passe généré, stocké sous secret-<instance>-<service> ; injecté uniquement via des références de secrets |
| IAM d'accès aux secrets | App_Common | roles/secretmanager.secretAccessor par secret pour le compte de service d'exécution — moindre privilège, aucun accès aux secrets à l'échelle du projet |
Notez la nuance selon le moteur : le nom de l'option diffère — PostgreSQL utilise cloudsql.iam_authentication (avec un point) tandis que MySQL utilise cloudsql_iam_authentication (avec un tiret bas), et la plateforme définit la forme avec tiret bas pour MySQL. Un joli piège d'examen : la même fonctionnalité, deux orthographes d'option différentes.
À vous de jouer
-
Définissez
enable_cloudsql_iam_auth = truedans le portail et appliquez. Vérifiez l'option et les attributions :gcloud sql instances describe cloudsql-<prefix>-postgres \
--format="value(settings.databaseFlags)"
gcloud projects get-iam-policy <project> \
--flatten="bindings[].members" \
--filter="bindings.role:roles/cloudsql.instanceUser" \
--format="value(bindings.members)" -
Ajoutez un utilisateur de base de données IAM (l'option seule n'en crée pas — une démarche délibérée en deux étapes que teste l'examen) :
gcloud sql users create cloudrun-sa-<prefix>@<project>.iam.gserviceaccount.com \
  --instance=cloudsql-<prefix>-postgres --type=cloud_iam_service_account
gcloud sql users list --instance=cloudsql-<prefix>-postgres \
--format="table(name, type)" -
Dans Console > SQL > <instance> > Users, observez l'utilisateur intégré
postgres/root, l'utilisateur applicatif créé par le jobdb-initet votre nouvel utilisateurCLOUD_IAM_SERVICE_ACCOUNT. -
Vous savez que cela a fonctionné lorsque
gcloud sql users listaffiche le compte principal IAM avec le typeCLOUD_IAM_SERVICE_ACCOUNTet que la sortie des options contientcloudsql.iam_authentication=on.
Testez-vous
Q1 : Après l'activation de enable_cloudsql_iam_auth, un compte de service ne parvient toujours pas à se connecter avec un jeton IAM. L'option est activée et roles/cloudsql.instanceUser est attribué. Que manque-t-il ?
R : L'utilisateur de base de données lui-même. L'authentification IAM requiert trois éléments : l'option de l'instance, le rôle IAM et un utilisateur de base de données de type CLOUD_IAM_SERVICE_ACCOUNT (ou CLOUD_IAM_USER) créé sur l'instance — plus des GRANT dans la base de données sur les objets dont il a besoin. Le module automatise les deux premiers ; la création de l'utilisateur est l'étape que les candidats oublient.
Q2 : Pourquoi la plateforme génère-t-elle un utilisateur applicatif distinct, avec un mot de passe de 32 caractères, pour chaque service, plutôt que de laisser les applications se connecter en tant que root ?
R : Pour le moindre privilège et la maîtrise du rayon d'impact : l'utilisateur applicatif ne possède que sa propre base de données (le job db-init attribue des privilèges par base de données), son mot de passe est limité à un seul secret avec un IAM secretAccessor par secret, et il peut faire l'objet d'une rotation (2.5) sans toucher aux autres locataires. Des identifiants root dans le code applicatif sont un schéma classique de mauvaise réponse à l'examen.
Au-delà des modules — L'authentification IAM par groupe pour Cloud SQL n'est pas mise en pratique ici ; lisez « IAM authentication » pour les deux moteurs. Étudiez aussi gcloud sql generate-login-token et l'option --auto-iam-authn de l'Auth Proxy, qui ensemble remplacent entièrement les mots de passe.
⚠️ Piège d'examen — roles/cloudsql.client permet à un compte principal de se connecter à travers le proxy ou le connecteur ; roles/cloudsql.instanceUser est ce qu'exige la connexion IAM à la base. Les distracteurs les intervertissent.
2.2 Configurer les options de surveillance et de dépannage de la base de données (Configure database monitoring and troubleshooting options)
⏱ ~45 min · 💰 négligeable (volume d'alertes/de journaux) · ⚙️ Prérequis : relational-baseline +
configure_email_notification = true,notification_alert_emailsdéfini sur Services_GCP
Pourquoi l'examen s'y intéresse — On attend de vous que vous associiez des symptômes à des signaux : CPU élevé → plans de requête/index manquants, mémoire élevée → ensemble de travail/nombre de connexions, croissance du stockage → marge du redimensionnement automatique et conservation des journaux, attentes de verrous → vues de contention (pg_stat_activity, INFORMATION_SCHEMA.INNODB_TRX), et que vous mettiez en place les alertes avant l'incident. Les questions portent aussi sur Query Insights et les journaux d'audit comme sources de diagnostic, et sur l'épuisement des quotas (connexions, stockage) comme catégorie de défaillance.
Comment RAD le met en œuvre — Services_GCP crée trois règles d'alerte sur la base de données, toutes filtrées sur resource.type = "cloudsql_database" :
| Règle | Métrique | Variable de seuil (valeur par défaut) |
|---|---|---|
[prefix] Cloud SQL - High CPU Usage | cloudsql.googleapis.com/database/cpu/utilization | alert_cpu_threshold (80) |
[prefix] Cloud SQL - High Memory Usage | cloudsql.googleapis.com/database/memory/utilization | alert_memory_threshold (80) |
[prefix] Cloud SQL - High Disk Usage | cloudsql.googleapis.com/database/disk/utilization | alert_disk_threshold (80) |
Les notifications sont diffusées vers des canaux de messagerie construits à partir de configure_email_notification (valeur par défaut false) + notification_alert_emails. Les modules applicatifs ajoutent le versant charge de travail : alert_policies (une liste d'objets {name, metric_type, comparison, threshold_value, duration_seconds, aggregation_period}, valeur par défaut []) dans App_CloudRun, plus un tableau de bord de surveillance. uptime_check_config (valeur par défaut { enabled = false, path = "/" }) crée une sonde synthétique <service>-uptime-check ainsi qu'une règle d'alerte en cas d'échec, une fois activé, dès que le point de terminaison de l'application est joignable publiquement — une surveillance fondée sur les symptômes du service adossé à la base de données, depuis l'extérieur. Sur la base de données elle-même, enable_query_insights (Services_GCP, valeur par défaut false) ajoute un bloc insights_config (chaînes de requête enregistrées jusqu'à 1 024 caractères) aux instances principales PostgreSQL et MySQL, ce qui alimente Console > SQL > Query insights avec la charge et les plans par requête. Pour le dépannage par piste d'audit, enable_audit_logging (Services_GCP, valeur par défaut false) enregistre ADMIN_READ/DATA_READ/DATA_WRITE. La capture des requêtes lentes est possible via le mécanisme des options — l'exemple fourni par la variable postgres_database_flags elle-même montre log_min_duration_statement = 1000 — mais aucune option de requêtes lentes n'est définie par défaut.
À vous de jouer
-
Activez la notification par e-mail dans le portail, appliquez, puis confirmez que les règles existent :
gcloud alpha monitoring policies list \
--filter='displayName:"Cloud SQL"' --format="table(displayName, enabled)" -
Ajoutez une option de requêtes lentes comme le ferait un DBA, via
postgres_database_flags: ajoutez{ name = "log_min_duration_statement", value = "1000" }dans le portail et appliquez (cela redémarre l'instance). Générez ensuite une requête lente avec psql (SELECT pg_sleep(2);) et relisez-la :gcloud logging read \
'resource.type="cloudsql_database" AND logName:"postgres.log" AND textPayload:"duration"' \
--limit=5 --freshness=1h -
Dans Console > SQL > <instance> > System insights, mettez en corrélation le CPU, la mémoire, les connexions et le disque pendant votre charge de test. Définissez ensuite
enable_query_insights = true, appliquez, et ouvrez Query insights sur la même instance pour voir la charge par requête et le texte des requêtes capturées. -
Vous savez que cela a fonctionné lorsque les trois règles d'alerte apparaissent comme activées, que votre instruction
pg_sleepfigure dans le journal postgres avec sa durée, et que Query insights commence à tracer la charge des requêtes.
Testez-vous
Q1 : Des utilisateurs signalent des expirations intermittentes de l'application. Le CPU de Cloud SQL est à 30 %, la mémoire à 50 %, mais les connexions actives montent à exactement 200 pendant les incidents. Que se passe-t-il, et quels sont deux correctifs démontrés ou abordés sur cette plateforme ?
R : L'instance atteint la valeur par défaut de l'option max_connections=200 — un problème de quota/limite, pas de ressources ; les nouvelles connexions sont mises en file d'attente ou échouent. Correctifs : relever l'option via postgres_database_flags après avoir dimensionné la mémoire en conséquence, ou réduire la demande de connexions grâce au pooling (managed connection pooling de Cloud SQL / PgBouncer — un sujet « Au-delà des modules » de la section 1.3). Augmenter le CPU n'aiderait pas : c'est un distracteur classique.
Q2 : Quel signal vous indique qu'un index manque — et où regarderiez-vous sur une instance Cloud SQL ?
R : Un CPU et des IOPS de lecture élevés de façon soutenue, avec certaines requêtes lentes ; confirmez avec Query Insights (charge et plans par requête) ou un EXPLAIN ANALYZE montrant des parcours séquentiels sur de grandes tables. Dans ce lab, vous captureriez les candidates via log_min_duration_statement, puis vous les passeriez à EXPLAIN dans psql. Le correctif est CREATE INDEX, pas un type de machine plus gros — l'examen récompense le diagnostic avant le redimensionnement.
Au-delà des modules — Les fonctionnalités avancées de Query Insights (attribution des requêtes étiquetées via SQL commenter, conservation plus longue) et l'équivalent gcloud (gcloud sql instances patch <name> --insights-config-query-insights-enabled) méritent d'être connus en complément du commutateur enable_query_insights du module. Le diagnostic des verrous (pg_locks, pg_stat_activity.wait_event, MySQL SHOW ENGINE INNODB STATUS) et les quotas/limites de Cloud SQL (connexions par type de machine, plafond de stockage de 64 To) relèvent uniquement de la documentation ici.
⚠️ Piège d'examen — Les alertes database/disk/utilization à 80 % peuvent rester sans conséquence sur cette plateforme, car disk_autoresize = true agrandit d'abord le disque — mais le redimensionnement automatique ne peut rien lorsque vous atteignez le quota de stockage, ou lorsque la croissance est causée par des WAL/binlogs non purgés à cause d'une réplique défaillante. Sachez distinguer « disque presque plein » et « disque qui grandit sans limite ».
2.3 Concevoir des solutions de sauvegarde et de restauration de bases de données (Design database backup and recovery solutions)
⏱ ~60 min · 💰 faible — stockage des sauvegardes + un petit bucket GCS · ⚙️ Prérequis : profils relational-baseline + app-dataops
Pourquoi l'examen s'y intéresse — Les questions de sauvegarde sont de l'arithmétique RTO/RPO : des sauvegardes quotidiennes automatisées donnent un RPO pouvant atteindre 24 h ; la PITR (journaux de transactions) réduit le RPO à quelques secondes dans la fenêtre de conservation des journaux ; les exports (pg_dump/mysqldump) sont portables mais lents (RTO long) et constituent la seule option entre versions ou entre produits. La conservation est à la fois un levier de conformité et de coût.
Comment RAD le met en œuvre — trois couches indépendantes :
Sauvegardes gérées + PITR (Services_GCP) : l'instance principale PostgreSQL est configurée de façon fixe avec les sauvegardes automatisées activées et la restauration à un instant donné active, 7 jours de conservation des journaux de transactions, 7 sauvegardes conservées (selon le nombre), une heure de début à 04:00 et l'emplacement des sauvegardes défini sur la région principale. MySQL conserve 7 sauvegardes quotidiennes à 04:00 et active la journalisation binaire — le mécanisme binlog sur lequel repose la PITR de MySQL — mais ne définit aucun attribut propre à la PITR. AlloyDB (uniquement dans un projet que vous apportez) bénéficie d'une sauvegarde automatisée hebdomadaire (dimanche 04:00 UTC, fenêtre de sauvegarde d'une heure, conservation de 7 sauvegardes selon le nombre). La persistance Redis est facultative (redis_persistence_mode, valeur par défaut DISABLED ; RDB avec redis_rdb_snapshot_period, valeur par défaut ONE_HOUR, ou AOF — niveau STANDARD_HA uniquement), mais imposée en production : une précondition évaluée au moment du plan rejette la persistance DISABLED sur une instance STANDARD_HA portant le libellé environment = "production".
Exports logiques (App_CloudRun, App_GKE) : une image de job db-clients (Debian 12 avec postgresql-client-14 à 17 et le client MySQL 8.0, construite par App_Common) exécute le script d'export, qui choisit un pg_dump/mysqldump correspondant à la version et écrit backup-<timestamp>.tar.gz dans le bucket GCS dédié aux sauvegardes. La planification est définie par backup_schedule (valeur par défaut "0 2 * * *") ; la conservation dans le bucket par backup_retention_days (valeur par défaut 7) via une règle de suppression du cycle de vie des objets.
Imports / exercices de restauration : enable_backup_import (valeur par défaut false) exécute un job ponctuel <service>-backup-import qui restaure backup_file (valeur par défaut backup.sql, formats sql,tar,gz,tgz,tar.gz,zip,auto) depuis backup_source — gcs (le bucket de sauvegarde) ou gdrive.
À vous de jouer
-
Listez les sauvegardes automatisées configurées par Terraform, puis effectuez-en une à la demande :
gcloud sql backups list --instance=cloudsql-<prefix>-postgres
gcloud sql backups create --instance=cloudsql-<prefix>-postgres \
--description="pre-change safety backup" -
Répétez une PITR en toute sécurité — clonez vers une nouvelle instance à un horodatage donné (UTC, dans la fenêtre de 7 jours des journaux) :
gcloud sql instances clone cloudsql-<prefix>-postgres pitr-drill-1 \
--point-in-time "2026-06-10T03:00:00Z" -
Déclenchez l'export logique immédiatement au lieu d'attendre 02:00 UTC, puis vérifiez l'artefact : Console > Cloud Storage > <backup bucket>.
gcloud scheduler jobs run <service>-backup-schedule --location=us-central1
gcloud storage ls gs://<backup-bucket>/ -
Vous savez que cela a fonctionné lorsque l'instance clonée atteint l'état RUNNABLE avec les données telles qu'elles étaient à votre horodatage, et qu'un nouvel objet
backup-<timestamp>.tar.gzexiste dans le bucket.
Testez-vous
Q1 : Un développeur a supprimé une table à 14:32. Les valeurs par défaut de la plateforme sont en place. Quel est votre chemin de restauration, et quelle est votre perte de données ?
R : Utilisez la PITR : clonez l'instance vers une nouvelle instance à 14:31 (gcloud sql instances clone --point-in-time), puis recopiez la table ou redirigez l'application. Perte de données ≈ une minute (ce que vous choisissez d'écarter), car les journaux de transactions sont conservés 7 jours. Restaurer la sauvegarde de 04:00 de la nuit précédente sans PITR ferait perdre ~10,5 heures — la réponse distractrice.
Q2 : La conformité exige que les sauvegardes survivent à un sinistre touchant toute une région. La configuration du module y répond-elle, et que changeriez-vous ?
R : Pas entièrement : backup_configuration.location est défini sur la région principale, si bien que les sauvegardes gérées résident dans cette région (le bucket GCS des exports ajoute une deuxième copie, mais également régionale par défaut). Pour survivre à la perte d'une région, vous définiriez un emplacement de sauvegarde multirégional ou dans une autre région, répliqueriez le bucket d'export (stockage birégional/multirégional) et/ou conserveriez la réplique en lecture interrégionale de la section 1.2. L'examen attend que vous repériez l'emplacement des sauvegardes comme partie intégrante de la conception de la reprise après sinistre.
Q3 : Quand un export fondé sur pg_dump est-il le bon outil de restauration/migration plutôt que les sauvegardes gérées ?
R : Lorsque vous avez besoin de portabilité : restauration vers une autre version majeure, un autre produit (AlloyDB, PG autogéré), un autre projet ou une autre organisation, ou conservation d'archives à long terme indépendantes du cycle de vie de l'instance (les sauvegardes gérées sont supprimées avec l'instance). Le prix à payer est le RTO — une restauration logique est bien plus lente qu'une restauration de sauvegarde — et la cohérence correspond au début de l'export.
Au-delà des modules — La restauration de sauvegardes entre projets, gcloud sql export sql (l'export géré serverless vers GCS, distinct du pg_dump exécuté par job de ce module), les sauvegardes finales lors de la suppression d'une instance et Backup and DR Service pour la conservation à long terme relèvent uniquement de la documentation. Essayez gcloud sql export sql cloudsql-<prefix>-postgres gs://<bucket>/managed-export.sql --database=postgres dans un projet de test et comparez avec l'export par job.
⚠️ Piège d'examen — Sauvegardes ≠ PITR. Les sauvegardes conservées (7 ici) déterminent jusqu'où vous pouvez remonter ; la conservation des journaux de transactions (7 jours ici) détermine avec quelle précision vous pouvez restaurer. Autre point : une restauration sur place écrase l'instance — clonez vers une nouvelle instance pour vos investigations.
2.4 Optimiser le coût et les performances des bases de données dans Google Cloud (Optimize database cost and performance in Google Cloud)
⏱ ~45 min · 💰 les expériences augmentent le coût — revenez en arrière une fois terminé · ⚙️ Prérequis : relational-baseline ; ha-production pour la mise à l'échelle horizontale (alloydb-ai uniquement dans un projet que vous apportez)
Pourquoi l'examen s'y intéresse — « Mise à l'échelle verticale ou horizontale ? » est la question emblématique de la section : la mise à l'échelle verticale (type de machine plus gros) résout les charges d'écriture limitées par le CPU ou la mémoire, mais elle a un plafond et impose un redémarrage ; la mise à l'échelle horizontale des lectures (répliques/pools de lecture) répond aux charges dominées par les lectures, mais ne fait rien pour les écritures et introduit un délai de réplication. Les questions de coût portent sur le dimensionnement adapté, la logique des engagements d'utilisation et les choix de HA/répliques qui doublent la dépense.
Comment RAD le met en œuvre — chaque axe de mise à l'échelle est une variable :
| Axe | Variable | Remarques |
|---|---|---|
| Mise à l'échelle verticale (écritures) | postgres_tier / mysql_tier / alloydb_cpu_count | Modification sur place ; bref redémarrage |
| Mise à l'échelle horizontale (lectures), Cloud SQL | create_postgres_read_replica + postgres_read_replica_count (valeur par défaut 1) | IP privées des répliques publiées sous forme de secrets <replica-name>-host pour que les applications puissent router les lectures ; les répliques reçoivent une option fixe max_connections=30000 |
| Mise à l'échelle horizontale (lectures), AlloyDB (uniquement dans un projet que vous apportez) | enable_alloydb_read_pool + alloydb_read_pool_node_count (1–20) | Un seul point de terminaison équilibré entre les nœuds — aucun routage par réplique nécessaire |
| Réglage du moteur | postgres_database_flags / mysql_database_flags / alloydb_database_flags | Valeurs par défaut : max_connections=200 (PG), max_connections=200 + local_infile=off (MySQL) |
| Coût plancher | Disponibilité ZONAL par défaut, niveau Redis BASIC par défaut, disque de 10 Go à redimensionnement automatique | Les valeurs par défaut sont la leçon d'optimisation des coûts : HA, répliques, Redis STANDARD_HA et CMEK sont facultatifs |
Les préconditions Redis évaluées au moment du plan sont un exemple de gouvernance : les déploiements portant le libellé environment = "production" sont empêchés d'utiliser le niveau BASIC au moment du plan, et une seconde précondition bloque redis_persistence_mode = "DISABLED" sur une instance STANDARD_HA de production — les configurations bon marché mais fragiles sont interdites précisément là où un SLA existe.
À vous de jouer
-
Avec ha-production appliqué, augmentez la capacité de lecture sans toucher à l'instance principale :
# portal: postgres_read_replica_count = 2, then verify
gcloud sql instances list --filter="name:replica" \
--format="table(name, region, settings.tier, state)" -
Lisez le point de terminaison de réplique qu'utiliserait une application :
gcloud secrets versions access latest \
--secret=cloudsql-<prefix>-postgres-replica-host -
Mesurez la santé de la réplication avant de vous fier aux lectures — dans psql, sur l'instance principale :
psql -h 127.0.0.1 -U postgres -d postgres \
-c "SELECT client_addr, state, replay_lag FROM pg_stat_replication;" -
Vous savez que cela a fonctionné lorsque les deux répliques affichent RUNNABLE et que
pg_stat_replicationles liste avec un faiblereplay_lag.
Testez-vous
Q1 : La base de données d'un site d'e-commerce est saturée en écriture pendant les ventes flash (CPU à 95 %, entièrement dû à des INSERT/UPDATE). L'équipe propose d'ajouter deux répliques en lecture. Pourquoi est-ce une erreur, et quelle est la bonne solution ?
R : Les répliques ne servent que les lectures — chaque écriture est toujours rejouée sur l'instance principale et sur chaque réplique, si bien que la saturation en écriture persiste (et les répliques peuvent prendre du retard). La bonne première mesure est verticale : un postgres_tier plus gros. Si les écritures dépassent le plus gros type de machine, c'est le signal, à l'examen, d'une refonte de l'architecture (sharding ou Spanner), pas de répliques supplémentaires.
Q2 : Quel coût récurrent supplémentaire prenez-vous en charge par unité lorsque vous passez postgres_read_replica_count de 1 à 3, et quel coût opérationnel l'accompagne ?
R : Chaque réplique est facturée comme une instance du type de machine de l'instance principale (postgres_tier est réutilisé dans les paramètres des répliques), plus son propre stockage — 3 répliques ≈ 3 instances principales supplémentaires. Sur le plan opérationnel, les applications doivent consommer les secrets -host propres à chaque réplique et tolérer le délai asynchrone ; les répliques ne sont pas de la HA gratuite (elles sont ZONAL et doivent être promues manuellement).
Au-delà des modules — L'optimisation des requêtes en elle-même (plans EXPLAIN, conception des index, recommandations de Query Insights) n'a aucune surface dans les modules — entraînez-vous sur l'instance du lab avec EXPLAIN (ANALYZE, BUFFERS). Les outils d'optimisation continue des coûts — remises sur engagement d'utilisation pour Cloud SQL, recommandations Active Assist sur les instances inactives ou surdimensionnées, libellés de facturation par base de données dans les exports de facturation — relèvent de la console et de la documentation : consultez Console > SQL > Recommendations dans n'importe quel projet de longue durée.
⚠️ Piège d'examen — Changer le type de machine redémarre l'instance (interruption ≈ de quelques secondes à quelques minutes, ou un basculement sur les instances REGIONAL). « Redimensionner pendant la fenêtre de maintenance avec la HA activée » l'emporte sur « redimensionner à tout moment » dans les réponses aux scénarios.
2.5 Automatiser les tâches courantes sur les bases de données (Automate common database tasks)
⏱ ~60 min · 💰 faible — jobs, planificateur, versions de secrets · ⚙️ Prérequis : profil app-dataops (
enable_auto_password_rotation = true)
Pourquoi l'examen s'y intéresse — L'examen veut des opérations exprimées sous forme d'automatisations planifiées et auditables plutôt que d'humains munis de psql : exports planifiés, rotation des identifiants, initialisation après provisionnement et surveillance de l'état fondée sur des SLO. Savoir quelle primitive GCP planifie quoi (Cloud Scheduler → jobs Cloud Run ; CronJobs Kubernetes ; sujets de rotation Secret Manager → Eventarc) constitue le contenu évaluable.
Comment RAD le met en œuvre — quatre automatisations, toutes observables dans la console :
- Exports planifiés. Chemin Cloud Run : un job Cloud Scheduler (App_CloudRun) envoie un POST à l'API
:runde Cloud Run Jobs avec le jeton OAuth du compte de service d'exécution, selonbackup_schedule(valeur par défaut"0 2 * * *"), ce qui exécute le job<service>-db-export. Chemin GKE : un CronJob Kubernetes (App_GKE), nommé<service>-db-export, avec la règle de concurrenceForbid, des limites d'historique de 3/3 et un script fourni via ConfigMap. - Rotation automatisée des mots de passe.
enable_auto_password_rotation(valeur par défautfalse) relie lerotation_periodde Secret Manager (secret_rotation_period, valeur par défaut"2592000s"= 30 jours) → sujet Pub/Sub de rotation → déclencheur Eventarc (<prefix>-pw-rot-trigger) → un service Cloud Run répartiteur (<prefix>-rot-dispatch) → le job<prefix>-pw-rotator(App_Common). Le job de rotation génère un nouveau mot de passe, exécuteALTER USER, ajoute la nouvelle version du secret, attend un délai de propagation, puis désactive (sans la détruire) l'ancienne version — deux versions coexistantes, aucune interruption, retour arrière possible. - Tâches d'initialisation et de schéma. Le job
db-initcrée la base de données et l'utilisateur à chaque déploiement (de façon idempotente) ;enable_custom_sql_scripts+custom_sql_scripts_bucket/custom_sql_scripts_pathexécute des fichiers.sqldepuis GCS dans l'ordre lexicographique (éventuellement en tant que root viacustom_sql_scripts_use_root) ; des jobs d'installation d'extensions PostgreSQL et de plugins MySQL installent les extensions/plugins configurés — notez que, dans un déploiement autonome d'un module de base, les variablesenable_postgres_extensions/postgres_extensionsne servent qu'à la validation, les listes effectives étant injectées par les modules applicatifs qui les encapsulent. - Surveillance proche des SLO.
alert_policiesfournit des alertes de disponibilité et de latence sur le service adossé à la base de données, etuptime_check_configajoute une sonde synthétique<service>-uptime-checkainsi qu'une alerte en cas d'échec pour les points de terminaison joignables publiquement — des données SLI externes sans configuration manuelle. - Maintenance planifiée.
sql_maintenance_window_day(1–7, semaine commençant le lundi, valeur par défaut7= dimanche),sql_maintenance_window_hour(0–23 UTC, valeur par défaut3) etsql_maintenance_update_track("stable"/"canary"/"week5", valeur par défaut"stable") fixent la maintenance de Cloud SQL dans une fenêtre prévisible à faible trafic sur les instances principales PostgreSQL et MySQL — l'application des correctifs devient une opération déclarée et planifiée plutôt qu'un calendrier choisi par Google.
À vous de jouer
-
Inspectez la mécanique de rotation après avoir appliqué app-dataops : Console > Security > Secret Manager > secret-<instance>-<service> > Rotation, et :
gcloud scheduler jobs list --location=us-central1
gcloud run jobs list --region=us-central1 # <service>-db-export, <service>-db-init, <prefix>-pw-rotator -
Forcez une répétition de rotation en exécutant directement le job de rotation, puis confirmez le basculement de version :
gcloud run jobs execute <prefix>-pw-rotator --region=us-central1 --wait
gcloud secrets versions list secret-cloudsql-<prefix>-postgres-<service> \
--format="table(name, state)" -
Prouvez que l'application s'authentifie toujours : connectez-vous avec la nouvelle dernière version via psql (
PGPASSWORD=$(gcloud secrets versions access latest --secret=...) psql -h <db-ip> -U <app-user> -d <db> -c "SELECT 1;"). -
Sur GKE, exécutez dès maintenant l'export de demain :
kubectl create job --from=cronjob/<service>-db-export manual-export -n <namespace>
kubectl logs -n <namespace> job/manual-export -f -
Vous savez que cela a fonctionné lorsque le secret affiche une nouvelle version ENABLED avec la précédente à l'état DISABLED, et que le journal du job d'export se termine par un envoi vers le bucket de sauvegarde.
Testez-vous
Q1 : Pendant la rotation, pourquoi la plateforme ne désactive-t-elle l'ancienne version du secret qu'après un délai de propagation, au lieu de la détruire immédiatement ?
R : Pour éviter toute interruption et permettre un retour arrière. Les instances en cours d'exécution peuvent conserver l'ancien mot de passe en mémoire ou lire « latest » en pleine rotation ; le délai laisse la nouvelle version se propager avant que « latest » ne devienne sans ambiguïté, et la désactivation (plutôt que la destruction) garde l'ancienne version récupérable pour un retour arrière ou un audit. Une destruction immédiate risque de provoquer des échecs d'authentification sur l'ensemble du parc — la réponse « qu'est-ce qui casse » de l'examen.
Q2 : Une équipe a besoin de sauvegardes logiques nocturnes d'une base de données hébergée sur GKE, avec la garantie que deux exports ne s'exécutent jamais simultanément. Quels paramètres Kubernetes présents dans ce module y répondent ?
R : Un CronJob avec schedule (le backup_schedule du module) et concurrencyPolicy: Forbid — exactement ce que définit le CronJob db-export du module — plus un historique borné (successful/failedJobsHistoryLimit = 3) et restartPolicy: OnFailure avec une limite de tentatives, afin qu'un export bloqué ne puisse pas s'accumuler.
Au-delà des modules — Deux sujets du point 2.5 n'ont aucune mise en œuvre ici : la maintenance des index (REINDEX/pg_repack, OPTIMIZE TABLE de MySQL — vous pourriez les planifier via enable_custom_sql_scripts, mais rien n'est fourni) et les mises à niveau gérées — il n'existe aucune automatisation des mises à niveau de version majeure ; étudiez les mises à niveau sur place (gcloud sql instances patch <name> --database-version=POSTGRES_18 une fois disponible, plus les vérifications préalables à la mise à niveau) et le comportement de maintenance et d'application des correctifs de Cloud SQL. Les SLO formels (budgets d'erreur, API SLO de gcloud monitoring) se situent également en dehors des modules.
⚠️ Piège d'examen — Le rotation_period de Secret Manager se contente de publier une notification Pub/Sub — rien n'est renouvelé à moins que quelque chose ne la consomme. La chaîne Eventarc→répartiteur→job de cette plateforme est ce consommateur ; une réponse affirmant « activez la rotation sur le secret et c'est terminé » est fausse.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.