Guide de préparation à la certification PCDE : Section 1 — Concevoir des solutions de bases de données cloud innovantes, évolutives et hautement disponibles (Design innovative, scalable, and highly available cloud database solutions) (~32 % de l'examen)
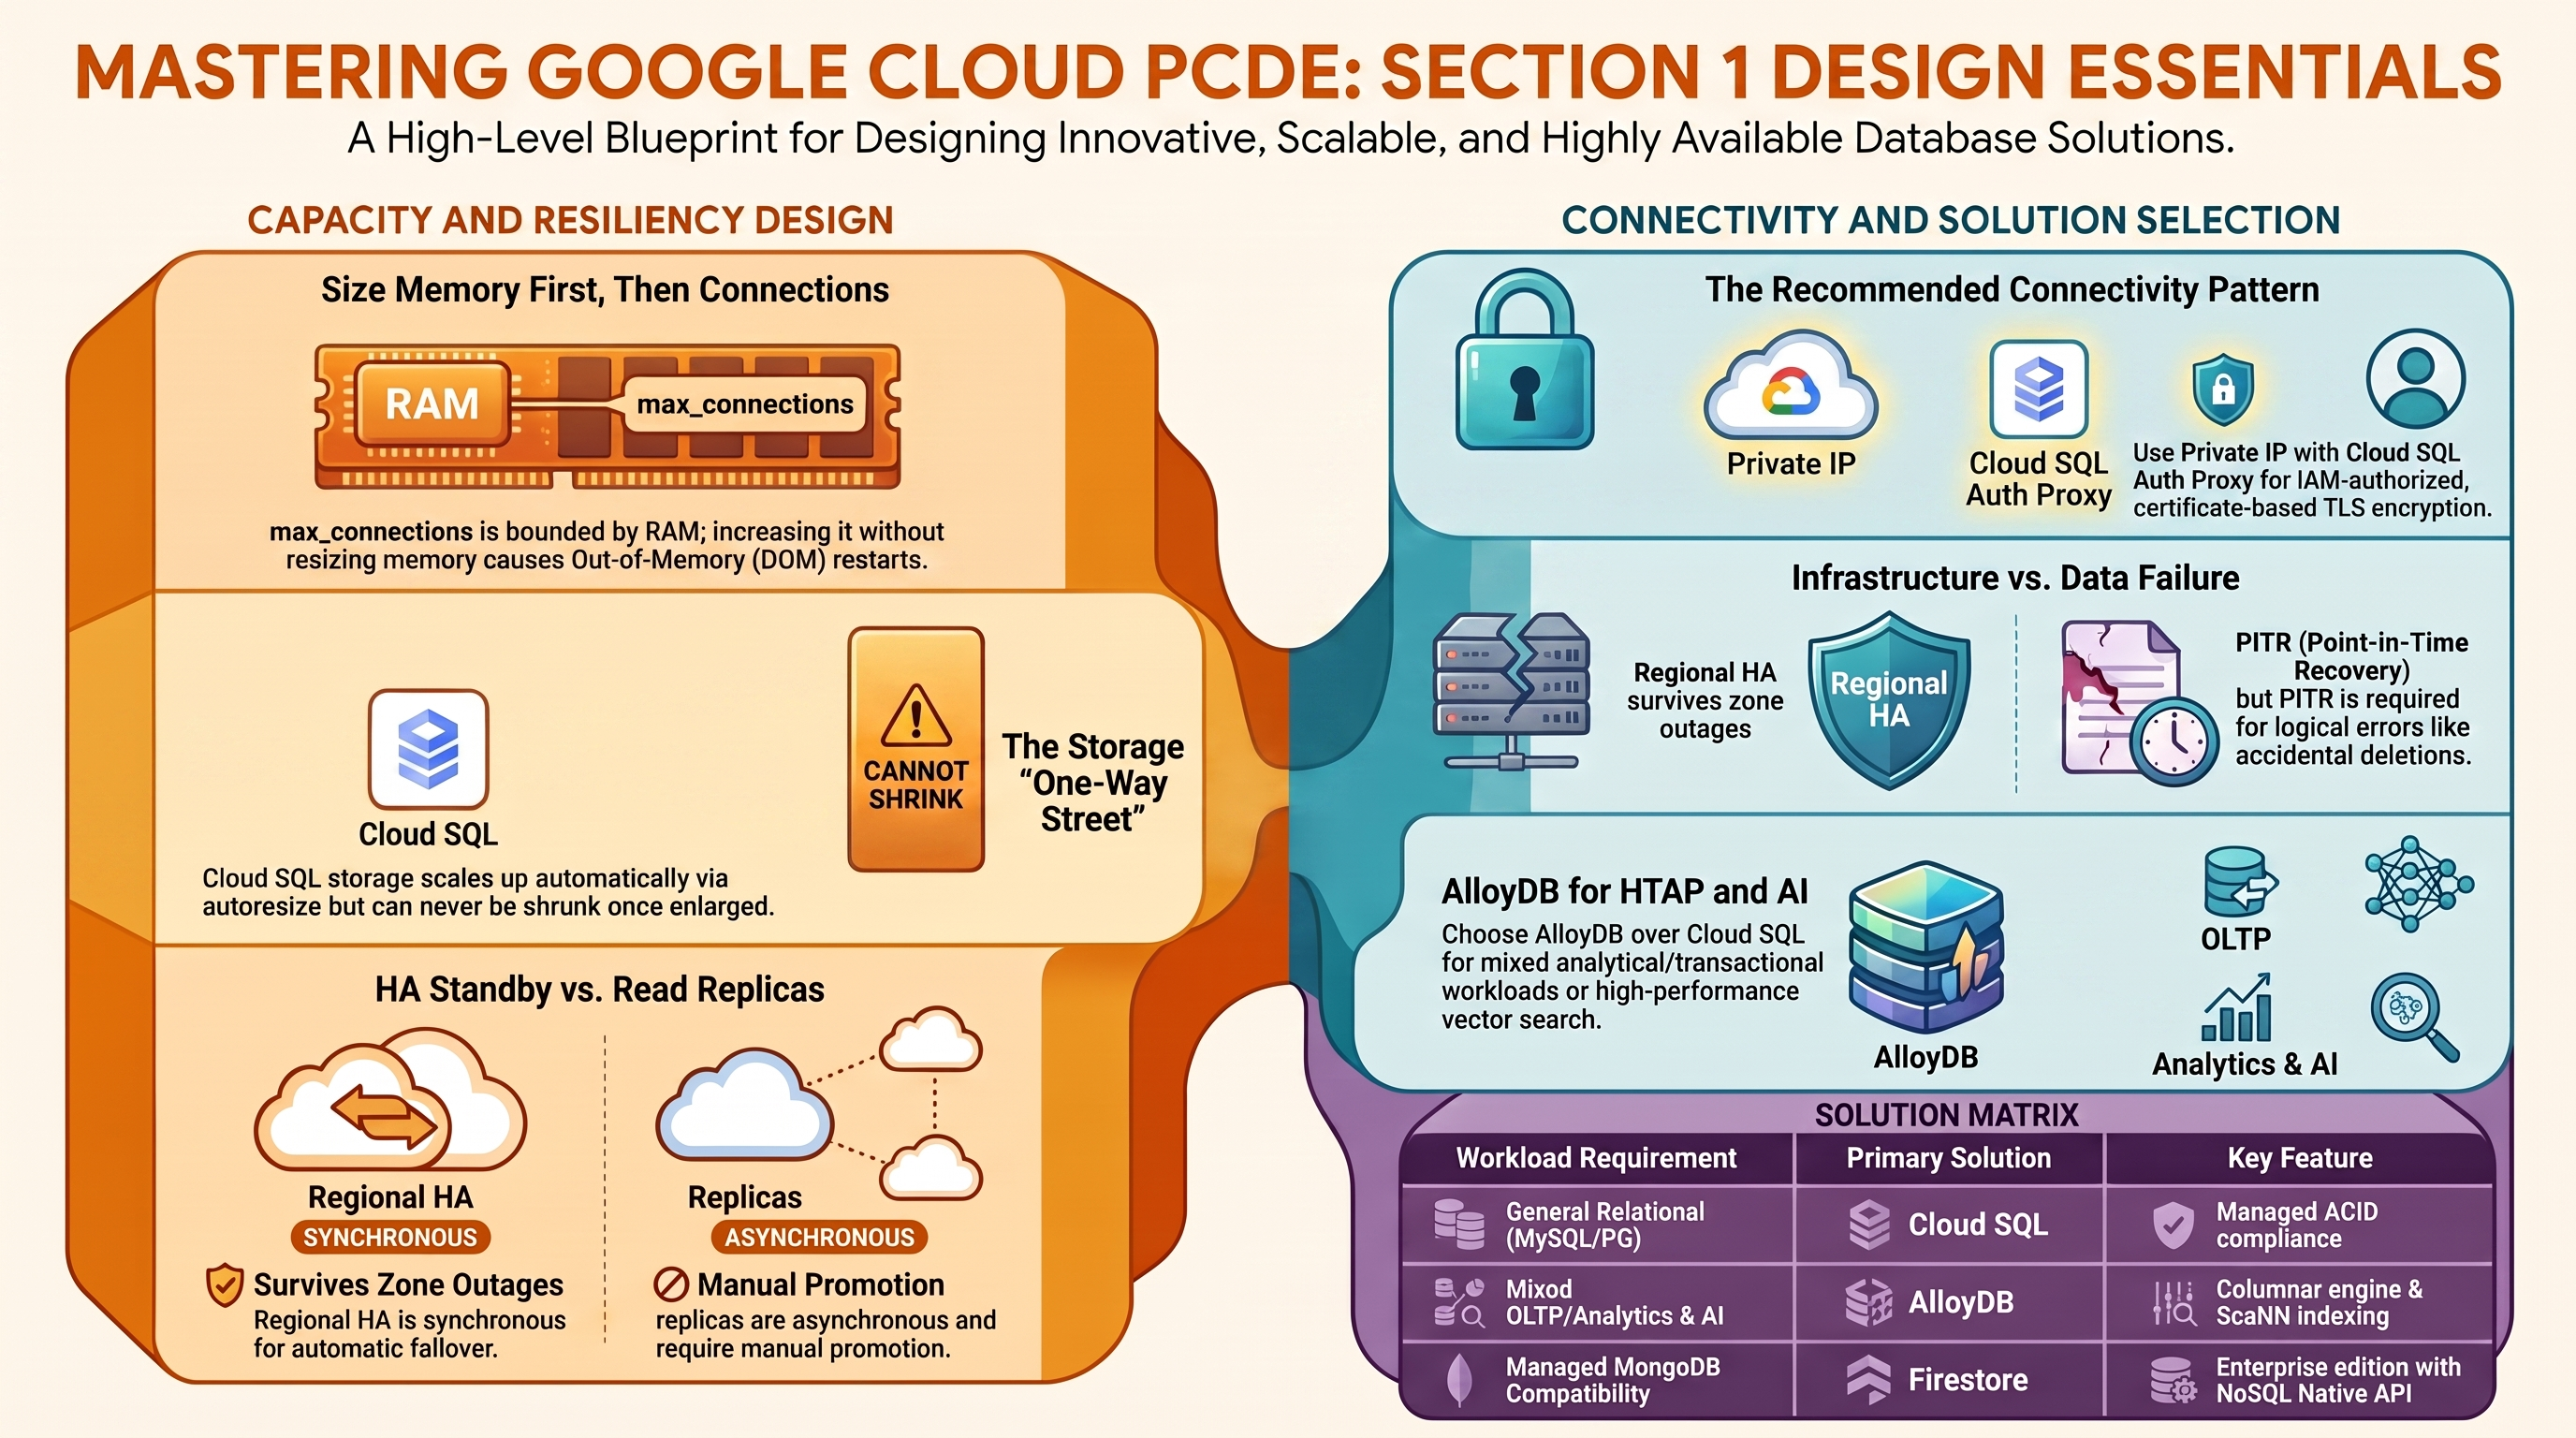
📚 Guide officiel de l'examen : Certification Professional Cloud Database Engineer — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Ce guide couvre la section 1 de l'examen Professional Cloud Database Engineer (PCDE) — la plus grande section, qui représente environ un tiers des questions. Il fait travailler Services_GCP (qui provisionne Cloud SQL PostgreSQL/MySQL, Firestore Enterprise et Memorystore Redis — ainsi qu'AlloyDB, mais uniquement dans un projet Google Cloud que vous apportez, jamais dans un projet géré par RAD) avec des modèles de connectivité complémentaires issus d'App_CloudRun et d'App_GKE. Avant de commencer, déployez le profil relational-baseline décrit dans la carte des labs PCDE ; les sous-sections 1.2 et 1.4 utilisent en plus les profils ha-production et multi-engine, ainsi que le profil alloydb-ai si vous disposez d'un projet personnel dans lequel le déployer.
1.1 Analyser les variables pertinentes pour planifier la capacité et l'utilisation de la base de données (Analyze relevant variables to perform database capacity and usage planning)
⏱ ~45 min · 💰 aucun coût supplémentaire au-delà du profil relational-baseline · ⚙️ Prérequis : déploiement par défaut (
create_postgres = true)
Pourquoi l'examen s'y intéresse — Les questions de capacité vérifient que vous savez traduire des métriques de charge de travail (connexions, taille de l'ensemble de travail, IOPS, ratio lecture/écriture) en type de machine et en configuration de stockage, et que vous comprenez les conséquences sur les coûts : les vCPU et la RAM font croître linéairement le coût de l'instance, le choix SSD ou HDD arbitre entre IOPS et prix, et un stockage surdimensionné ne peut pas être réduit. Attendez-vous à des scénarios du type « le taux de succès du cache de tampons est faible — faut-il ajouter de la mémoire ou des vCPU ? », où la bonne réponse est la modification ciblée la moins coûteuse.
Comment RAD le met en œuvre — Le dimensionnement est entièrement paramétré dans Services_GCP :
| Variable | Valeur par défaut | Ce qu'elle dimensionne |
|---|---|---|
postgres_tier / mysql_tier | db-custom-1-3840 | Machine Cloud SQL : db-custom-<vCPUs>-<RAM MiB> — la valeur par défaut est 1 vCPU / 3,75 Go |
postgres_database_flags | [{ name = "max_connections", value = "200" }] | Capacité de connexions, ajustable selon la charge de travail |
alloydb_cpu_count | 2 (valeurs validées : 2, 4, 8, 16, 32, 64) | Taille de l'instance principale AlloyDB et des nœuds du pool de lecture (uniquement dans un projet que vous apportez) |
redis_memory_size_gb | 1 (valeurs validées : 1–300) | Capacité de l'ensemble de travail Memorystore |
Le stockage n'est délibérément pas une variable : l'instance PostgreSQL utilise obligatoirement un disque PD_SSD de 10 Go au départ, avec le redimensionnement automatique du disque activé et sans limite supérieure (illimité), si bien que le disque grandit automatiquement à mesure que les données arrivent — une réponse gérée à « dimensionner le stockage pour la croissance ». L'édition de l'instance est fixée à Enterprise. Le même schéma s'applique à MySQL.
À vous de jouer
-
Dans votre portail de déploiement, remplacez
postgres_tierdb-custom-1-3840pardb-custom-2-7680(2 vCPU / 7,5 Go) et appliquez. Il s'agit d'unPATCHsur place qui redémarre l'instance. -
Observez la modification dans Console > SQL > cloudsql-<prefix>-postgres > Edit > Machine configuration, puis confirmez-la depuis la CLI :
gcloud sql instances describe cloudsql-<prefix>-postgres \
--format="table(settings.tier, settings.dataDiskType, settings.dataDiskSizeGb, settings.storageAutoResize)" -
Vérifiez le plafond de connexions que vous donne la valeur par défaut de l'option :
gcloud sql instances describe cloudsql-<prefix>-postgres \
--format="value(settings.databaseFlags)" -
Vous savez que cela a fonctionné lorsque la sortie de describe affiche le nouveau type de machine et
storageAutoResize: TrueavecPD_SSD.
Testez-vous
Q1 : Une charge de travail de reporting sur une instance db-custom-1-3840 affiche 95 % d'utilisation de la mémoire et des lectures disque fréquentes, mais le CPU reste à 20 %. Quelle modification unique dans ce module y répond de la façon la plus économique ?
R : Remplacez postgres_tier par une configuration personnalisée dotée de plus de RAM (par ex. db-custom-2-13312) plutôt que de plus de vCPU. Les types personnalisés de Cloud SQL permettent d'augmenter la mémoire pour agrandir le cache de tampons — ce qui transforme des lectures disque en succès de cache — sans payer pour du CPU inutilisé. Ajouter du stockage ou des répliques ne résoudrait pas un problème d'ensemble de travail qui ne tient pas en RAM.
Q2 : Pourquoi le module active-t-il le redimensionnement automatique du disque plutôt que de provisionner d'emblée un grand disque, et quelle est l'opération irréversible à retenir pour l'examen ?
R : Le redimensionnement automatique signifie que vous ne payez que le stockage réellement utilisé, sans jamais subir de panne pour disque plein. Le piège : le stockage Cloud SQL peut augmenter mais jamais diminuer — une fois que le redimensionnement automatique (ou une modification manuelle) a agrandi le disque, le seul moyen de revenir à un disque plus petit est d'exporter puis d'importer dans une nouvelle instance.
Au-delà des modules — Les modules utilisent toujours PD_SSD ; l'examen vérifie aussi quand un stockage HDD est acceptable (rarement — uniquement pour l'archivage ou les faibles IOPS) et comment le prix du SSD par Go se compare au prix de l'instance. Ils fixent également l'édition Cloud SQL à ENTERPRISE ; étudiez l'édition Enterprise Plus (limites par instance plus élevées, cache de données, maintenance quasi sans interruption) dans la page de documentation « Cloud SQL editions ». Entraînez-vous aux estimations avec le simulateur de prix officiel et gcloud sql tiers list.
⚠️ Piège d'examen — max_connections est borné par la mémoire de l'instance : augmenter fortement cette option sans redimensionner le type de machine provoque une pression mémoire par connexion et des redémarrages pour mémoire insuffisante (OOM). Dimensionnez d'abord la mémoire, puis les connexions (ou utilisez un pooler — voir 1.3).
1.2 Évaluer les options de haute disponibilité et de reprise après sinistre de la base de données en fonction des exigences (Evaluate database high availability and disaster recovery options given the requirements)
⏱ ~60 min · 💰 REGIONAL double à peu près le coût de l'instance ; chaque réplique ajoute le coût d'une instance de même taille · ⚙️ Prérequis : profil ha-production
Pourquoi l'examen s'y intéresse — Les questions de HA et de reprise après sinistre reposent sur l'adéquation entre le rayon d'impact toléré par une exigence et la topologie la moins coûteuse capable d'y survivre : zonale (pas de basculement) → régionale/HA (instance de secours synchrone dans une deuxième zone, même région) → réplique en lecture interrégionale (asynchrone, survit à la perte d'une région mais nécessite une promotion). Vous devez aussi savoir ce que chaque option protège et ne protège pas : la HA REGIONAL protège contre la défaillance d'une zone, pas contre un DELETE malencontreux — c'est le rôle de la PITR (voir 2.3).
Comment RAD le met en œuvre — Dans Services_GCP :
| Variable | Valeur par défaut | Comportement |
|---|---|---|
postgres_database_availability_type | ZONAL | Définissez REGIONAL pour une instance principale HA avec une instance de secours à basculement automatique |
mysql_database_availability_type | ZONAL | Même choix pour l'instance MySQL |
create_postgres_read_replica / create_mysql_read_replica | false | Ajoute des répliques en lecture (type d'instance READ_REPLICA_INSTANCE) |
postgres_read_replica_count / mysql_read_replica_count | 1 | Nombre de répliques |
availability_regions | ["us-central1"] | Indiquez au moins 2 régions et les répliques sont placées dans availability_regions[1] — une réplique de reprise après sinistre interrégionale |
Le placement des répliques suit la liste des régions : lorsque deux régions ou plus sont configurées, les répliques sont placées dans la deuxième région ; sinon, elles restent dans la région principale. Les répliques sont toujours ZONAL, et l'IP privée de chaque réplique est publiée dans Secret Manager sous le nom cloudsql-<prefix>-postgres-replica-host afin que les applications puissent répartir les lectures. Les sauvegardes/la PITR (la machine à remonter le temps de la reprise après sinistre) sont codées en dur sur l'instance principale — voir la section 2.3.
Des fenêtres de maintenance sont configurées sur les instances Cloud SQL : sql_maintenance_window_day (1–7, semaine commençant le lundi, valeur par défaut 7 = dimanche), sql_maintenance_window_hour (0–23 UTC, valeur par défaut 3) et sql_maintenance_update_track ("stable"/"canary"/"week5", valeur par défaut "stable") configurent la fenêtre de maintenance sur les instances principales PostgreSQL et MySQL. Memorystore Redis fixe de même la maintenance au dimanche 02:00 UTC.
À vous de jouer
-
Appliquez le profil ha-production (
postgres_database_availability_type = "REGIONAL",create_postgres_read_replica = true,availability_regions = ["us-central1", "us-east1"]). -
Dans Console > SQL, l'instance principale affiche désormais « High availability (regional) » et une réplique
cloudsql-<prefix>-postgres-replicaapparaît dans us-east1. Vérifiez la topologie :gcloud sql instances list \
--format="table(name, region, gceZone, settings.availabilityType, instanceType)" -
Déclenchez un basculement manuel (l'examen attend que vous connaissiez cette commande — elle fait passer l'instance principale dans la zone de secours) :
gcloud sql instances failover cloudsql-<prefix>-postgres -
Vous savez que cela a fonctionné lorsque
gcloud sql instances describe cloudsql-<prefix>-postgres --format="value(gceZone)"indique une zone différente de celle d'avant le basculement, et que la réplique affiche toujoursinstanceType: READ_REPLICA_INSTANCEdans la région secondaire.
Testez-vous
Q1 : Un client exige que la base de données survive à une panne complète d'une région avec un RPO de quelques minutes, mais les lectures et écritures en fonctionnement normal doivent rester dans une seule région pour la latence. Quels sont les deux paramètres du module qui y répondent, et quelle étape manuelle reste nécessaire en cas de sinistre ?
R : postgres_database_availability_type = "REGIONAL" (HA au niveau de la zone avec basculement automatique) plus availability_regions = ["primary", "secondary"] avec create_postgres_read_replica = true (réplique interrégionale asynchrone, RPO = délai de réplication, généralement de quelques secondes à quelques minutes). En cas de perte d'une région, vous devez encore promouvoir la réplique (gcloud sql instances promote-replica) et rediriger les applications — le basculement interrégional n'est pas automatique.
Q2 : Pourquoi l'activation de la seule disponibilité REGIONAL est-elle insuffisante pour une exigence de restauration du type « nous avons supprimé une table par erreur » ?
R : L'instance de secours HA est une copie synchrone — le DROP TABLE y est répliqué instantanément. Les erreurs logiques ou d'opérateur se corrigent avec la restauration à un instant donné (activée dans ce module avec 7 jours de journaux de transactions) ou avec des sauvegardes, pas avec la HA. La HA répond aux défaillances d'infrastructure ; la PITR répond aux défaillances de données.
Q3 : Où configureriez-vous le moment où Cloud SQL applique la maintenance, et que fait ce module à ce sujet ?
R : Via la fenêtre de maintenance de l'instance (gcloud sql instances patch <name> --maintenance-window-day=SUN --maintenance-window-hour=2) et, éventuellement, des périodes de refus de maintenance. Ce module en définit une de façon déclarative — sql_maintenance_window_day/sql_maintenance_window_hour/sql_maintenance_update_track (valeurs par défaut : dimanche, 03:00 UTC, stable) sur les deux moteurs. Pour l'examen, retenez que les instances HA reçoivent une maintenance progressive qui commence par l'instance de secours, et qu'il est possible de s'abonner aux notifications de maintenance pour chaque instance.
Au-delà des modules — Les périodes de refus de maintenance et les notifications de maintenance ne sont pas configurées ici (la fenêtre elle-même l'est — voir ci-dessus) : entraînez-vous avec gcloud sql instances patch --deny-maintenance-period-start-date/--deny-maintenance-period-end-date et la page de documentation « About maintenance on Cloud SQL instances ». Les topologies d'écriture réellement multirégionales (configurations multirégionales de Spanner, clusters secondaires AlloyDB avec basculement planifié) sortent également du périmètre de ces modules — étudiez les pages de documentation « Spanner instance configurations » et « AlloyDB cross-region replication ».
⚠️ Piège d'examen — Une réplique en lecture n'est pas une instance de secours HA. L'instance de secours REGIONAL est synchrone, invisible (pas de chaîne de connexion) et bascule automatiquement ; une réplique est asynchrone, accessible en lecture et doit être promue manuellement. Les questions qui mentionnent un « basculement automatique » désignent la disponibilité REGIONAL, jamais les répliques.
1.3 Déterminer comment les applications se connecteront à la base de données (Determine how applications will connect to the database)
⏱ ~60 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : profil relational-baseline (+ éventuellement
enable_cmek = true,enable_audit_logging = truesur Services_GCP)
Pourquoi l'examen s'y intéresse — Les questions de connectivité portent sur le choix entre IP privée, IP publique avec réseaux autorisés, et Cloud SQL Auth Proxy/connecteurs ; sur la manière dont le chiffrement est imposé en transit (modes SSL) et au repos (clés gérées par Google ou CMEK) ; sur l'emplacement des identifiants ; et sur la façon dont les accès sont audités. La combinaison Auth Proxy + IP privée + Secret Manager démontrée ici est le modèle de production recommandé par Google.
Comment RAD le met en œuvre — en trois couches :
Chemin réseau. La plateforme alloue une plage interne /16 réservée à l'appairage de réseaux VPC et établit une connexion d'accès aux services privés (PSA) avec le service Service Networking. Chaque base de données s'y rattache ensuite en privé : PostgreSQL et MySQL désactivent l'adresse IPv4 publique et se lient au réseau privé du VPC et à la plage allouée ; AlloyDB (uniquement dans un projet que vous apportez) se rattache au même VPC ; Redis utilise le VPC comme réseau autorisé avec redis_connect_mode (valeur par défaut DIRECT_PEERING). Aucune base de données n'a d'IP publique.
Chiffrement en transit. PostgreSQL impose le mode SSL ENCRYPTED_ONLY ; MySQL est assoupli en ALLOW_UNENCRYPTED_AND_ENCRYPTED (une différence délibérée d'un moteur à l'autre qui mérite d'être remarquée).
Rattachement des applications + identifiants. Dans App_CloudRun, enable_cloudsql_volume (valeur par défaut true) monte un volume Cloud SQL sur cloudsql_volume_mount_path (valeur par défaut /cloudsql) — le connecteur Cloud SQL géré de Cloud Run, qui expose un socket Unix par nom de connexion. Dans App_GKE, la même option injecte un conteneur sidecar Cloud SQL Auth Proxy exécuté avec --private-ip et le port de la base de données. Les mots de passe sont générés aléatoirement et stockés uniquement dans Secret Manager (par ex. secret-cloudsql-<prefix>-postgres-root-password) ; les applications les reçoivent via des références de secrets, jamais en clair. Gestion des clés : enable_cmek (valeur par défaut false) chiffre les instances avec une clé KMS gérée par le client (période de rotation cmek_key_rotation_period, valeur par défaut 7776000s). Audit : enable_audit_logging (valeur par défaut false) active les journaux d'audit ADMIN_READ/DATA_READ/DATA_WRITE pour tous les services, ce qui inclut l'API Cloud SQL Admin.
À vous de jouer
-
Confirmez que l'instance n'a pas d'adresse publique et que SSL est imposé :
gcloud sql instances describe cloudsql-<prefix>-postgres \
--format="yaml(ipAddresses, settings.ipConfiguration.sslMode, settings.ipConfiguration.ipv4Enabled)" -
Dans Console > Cloud Run > <service> > Revisions > Volumes, repérez le volume
cloudsqllié au nom de connexion de l'instance. Sur GKE,kubectl get pod -n <namespace> -o jsonpath='{.items[0].spec.containers[*].name}'liste le sidecarcloud-sql-proxy. -
Connectez-vous comme le ferait un opérateur — récupérez le mot de passe root dans Secret Manager et utilisez psql à travers un Cloud SQL Auth Proxy (l'instance n'a qu'une IP privée : exécutez donc ceci depuis une VM ou un poste de travail ayant accès au VPC, ou dans un pod GKE) :
export PGPASSWORD=$(gcloud secrets versions access latest \
  --secret=secret-cloudsql-<prefix>-postgres-root-password)
./cloud-sql-proxy --private-ip <project>:<region>:cloudsql-<prefix>-postgres &
psql -h 127.0.0.1 -U postgres -d postgres -c "SELECT version();" -
Vous savez que cela a fonctionné lorsque psql renvoie la chaîne de version de PostgreSQL 17 et que la sortie de describe affichait
ipv4Enabled: falseavecsslMode: ENCRYPTED_ONLY.
Testez-vous
Q1 : Une application exécutée en dehors du VPC (dans le centre de données d'un partenaire) doit atteindre cette instance Cloud SQL. L'instance n'a qu'une IP privée. Quelles sont les options légitimes ?
R : Soit étendre la connectivité privée (Cloud VPN/Interconnect vers le VPC, puisque les plages appairées via PSA sont joignables à travers le VPC avec l'export de routes personnalisées — que cette plateforme active déjà sur l'appairage), soit exécuter le Cloud SQL Auth Proxy à un endroit ayant accès au VPC et laisser le partenaire s'y connecter. Activer l'IP publique avec des réseaux autorisés est possible mais contredit la posture de sécurité ; l'examen privilégie le maintien de l'IP privée et la correction du chemin réseau.
Q2 : Pourquoi le module GKE déploie-t-il un sidecar Auth Proxy alors que la base de données est déjà sur une IP privée qu'il pourrait joindre directement ?
R : Le proxy ajoute un TLS fondé sur des certificats et contrôlé par IAM, sans avoir à gérer de certificats clients : chaque connexion est autorisée au regard du compte de service du pod (Workload Identity) et chiffrée de bout en bout, quels que soient les paramètres du pilote. Les connexions directes à l'IP privée fonctionnent, mais le proxy apporte un chiffrement uniforme, l'application d'IAM et un nom de connexion stable lors des basculements — le modèle recommandé par Google qu'attend l'examen.
Au-delà des modules — Les poolers de sessions ne sont pas mis en œuvre. Le Managed Connection Pooling intégré à Cloud SQL et le modèle PgBouncer en intermédiaire sont des sujets d'examen — étudiez « Managed connection pooling » dans la documentation Cloud SQL, et sachez quand un pooler (des milliers de connexions serverless de courte durée) l'emporte sur l'augmentation de max_connections. Les règles d'audit d'accès aux données par service, plus fines que le commutateur allServices de ce module, et les points de terminaison Private Service Connect pour Cloud SQL (par opposition à l'appairage PSA) méritent aussi un passage par la documentation.
⚠️ Piège d'examen — Le Cloud SQL Auth Proxy authentifie la connexion ; il ne connecte pas l'utilisateur à la base de données. Il vous faut toujours soit un mot de passe de base de données, soit l'authentification IAM à la base de données (section 2.1) pour la connexion proprement dite.
1.4 Évaluer les solutions de bases de données appropriées sur Google Cloud (Evaluate appropriate database solutions on Google Cloud)
⏱ ~75 min · 💰 modéré à élevé tant que les profils multi-engine et alloydb-ai sont actifs — détruisez-les ensuite · ⚙️ Prérequis : profil multi-engine (+ alloydb-ai dans un projet que vous apportez)
Pourquoi l'examen s'y intéresse — Les questions d'évaluation de solutions vous donnent des qualificatifs de charge de travail — relationnelle, mondiale, à colonnes larges, document, cache, recherche vectorielle/sémantique, analytique — plus des contraintes (compatibilité lift-and-shift, licences, effectif des opérations, conformité) et vous demandent quel produit convient. Les critères discriminants à assimiler : la compatibilité (Cloud SQL/AlloyDB exécutent un vrai PostgreSQL/MySQL), la mise à l'échelle horizontale des écritures (Spanner/Bigtable), le modèle document (Firestore), le cache en moins d'une milliseconde (Memorystore), l'analytique (BigQuery) et le coût total de possession géré ou autogéré.
Comment RAD le met en œuvre — la plateforme vous permet de faire tourner côte à côte quatre moteurs réellement différents, plus un contre-exemple autogéré :
| Moteur | Commutateur (valeur par défaut) | Ce qu'il faut y étudier |
|---|---|---|
| Cloud SQL PostgreSQL 17 | create_postgres (true) | Choix relationnel géré par défaut ; structuré/transactionnel |
| Cloud SQL MySQL 8.4 | create_mysql (false) | Choix du moteur dicté par la compatibilité applicative (par ex. applications de type WordPress) |
| AlloyDB pour PostgreSQL (uniquement dans un projet que vous apportez) | enable_alloydb (false) | Compatible PostgreSQL, conçu pour les charges mixtes OLTP/analytique et l'IA — il fournit un moteur en colonnes et la prise en charge de pgvector avec ScaNN ; pool de lecture via enable_alloydb_read_pool |
| Firestore Enterprise | create_firestore (false) | NoSQL document/semi-structuré ; la plateforme crée une base de données Firestore Native nommée dans l'édition Enterprise, puis active l'accès aux données compatible MongoDB via l'API REST — compatibilité avec le protocole MongoDB pour le lift-and-shift d'applications orientées documents |
| Memorystore Redis | create_redis (false) | Cache en mémoire / stockage de sessions ; compromis entre niveaux et persistance |
| VM Redis + NFS autogérée | create_network_filesystem (true) | Redis s'exécute sur un groupe d'instances géré e2-small que vous corrigez, sauvegardez par instantanés et dont vous vérifiez l'état vous-même — la moitié « non gérée » de la comparaison géré/non géré |
Pour l'angle de l'IA générative : AlloyDB est la plateforme vectorielle désignée par le module là où vous pouvez le déployer (un projet que vous apportez), et sur Cloud SQL — disponible partout — les modules applicatifs peuvent installer des extensions PostgreSQL (dont vector) via le job d'installation des extensions (CREATE EXTENSION en tant qu'utilisateur postgres — voir la section 2.5). Les leviers réglementaires qui influencent la configuration des moteurs sont également présents : enable_cmek, enable_audit_logging et enable_vpc_sc (uniquement dans un projet que vous apportez) s'appliquent uniformément à tous les moteurs que vous activez. Notez que la plateforme encode même un détail opérationnel multimoteur bien réel : un délai de 120 secondes entre la création des deux instances Cloud SQL pour éviter les conflits avec Service Networking.
À vous de jouer
-
Appliquez le profil multi-engine, puis inventoriez ce qu'exécute désormais un seul projet :
gcloud sql instances list --format="table(name, databaseVersion, region)"
gcloud redis instances list --region=us-central1
gcloud firestore databases list --format="table(name, type, locationId)" -
Si vous disposez d'un projet personnel, appliquez-y le profil alloydb-ai et inspectez le cluster (les projets gérés par RAD ne peuvent pas exécuter AlloyDB — sautez cette étape et lisez plutôt la présentation d'AlloyDB) :
gcloud alloydb clusters describe alloydb-<prefix>-cluster --region=us-central1
gcloud alloydb instances list --cluster=alloydb-<prefix>-cluster \
--region=us-central1 --format="table(name, instanceType, machineConfig.cpuCount)" -
Dans Console > Firestore > Databases, ouvrez la base de données nommée (l'édition Enterprise ne prend pas en charge
(default)— le module génèrefirestore-<prefix>-dblorsquefirestore_database_idest vide) et notez le paramètre de compatibilité MongoDB. -
Vous savez que cela a fonctionné lorsque Firestore affiche l'édition Enterprise dans l'emplacement choisi (et, dans un projet que vous apportez, que la liste AlloyDB affiche une instance
PRIMARYet une instanceREAD_POOL).
Testez-vous
Q1 : Une équipe migre une application MongoDB vers Google Cloud et souhaite un service géré sans réécrire la couche d'accès aux données. Quelle option démontrée par cette plateforme convient, et quelle est sa limite ?
R : Firestore Enterprise avec l'accès aux données compatible MongoDB (exactement ce que provisionne la plateforme). Il parle le protocole MongoDB face à un backend entièrement géré. Limites : il doit s'agir d'une base de données nommée (pas de (default)), et la compatibilité couvre la surface courante des pilotes, pas toutes les fonctionnalités de MongoDB — vérifiez la parité fonctionnelle avant de vous engager, ce qui est en soi une réponse typique de l'examen.
Q2 : Quand choisiriez-vous AlloyDB plutôt que Cloud SQL pour PostgreSQL, sachant que les deux sont compatibles PostgreSQL et figurent tous deux dans ce module (AlloyDB uniquement dans un projet que vous apportez) ?
R : Quand la charge de travail mélange OLTP et lectures analytiques intensives ou recherche vectorielle : AlloyDB ajoute un moteur en colonnes, pgvector avec index ScaNN, des pools de lecture à mise à l'échelle horizontale (1 à 20 nœuds ici) et des performances par instance plus élevées — pour un coût plancher plus élevé (2 vCPU minimum, pas de niveau à cœur partagé, comme le montre la validation de alloydb_cpu_count). Du CRUD léger avec un budget serré → Cloud SQL ; HTAP/IA ou mise à l'échelle agressive des lectures → AlloyDB.
Q3 : L'équipe conformité impose des clés gérées par le client et des pistes d'audit des accès aux données pour chaque base de données. Quelles sont les deux variables qui y répondent pour tous les moteurs de la plateforme, et quelle préoccupation au niveau de l'organisation subsiste ?
R : enable_cmek = true (CMEK sur Cloud SQL et AlloyDB via la clé KMS partagée cloudsql) et enable_audit_logging = true (journaux d'audit DATA_READ/DATA_WRITE pour tous les services). Préoccupation restante : les contraintes de règles d'administration de l'organisation (par ex. constraints/gcp.restrictNonCmekServices, restrictions d'emplacement) ne sont pas gérées par ces modules — elles se situent au niveau de l'organisation ou du dossier, et l'examen attend que vous sachiez qu'elles priment sur tout ce que fait un module au niveau du projet.
Au-delà des modules — Non mis en œuvre, et tous susceptibles de tomber à l'examen : Spanner (mise à l'échelle horizontale des écritures, cohérence externe, configurations multirégionales), Bigtable (colonnes larges, séries temporelles, latence de quelques millisecondes à grande échelle), BigQuery (analytique ; également les requêtes fédérées vers Cloud SQL — étudiez EXTERNAL_QUERY() pour le sous-thème « solutions de bases de données multiples / fédération »), Memorystore for Memcached et Vertex AI Vector Search pour la récupération d'embeddings au-delà de pgvector. Le point 1.4 sur le géré ou non géré cite aussi le bare metal (Bare Metal Solution, généralement pour des charges Oracle qui ne peuvent pas migrer vers un moteur géré) et les offres de bases de données partenaires (bases de données tierces de Google Cloud Marketplace, et Oracle Database@Google Cloud) — sachez quand chacune l'emporte sur un moteur géré par Google. L'évaluation des dépendances entre applications et bases de données, l'effet des règles d'administration (les contraintes d'emplacement des ressources et de CMEK restreignent les moteurs et les régions que vous pouvez choisir) et les conceptions hybrides couvrant plusieurs technologies (exports, fédération, sur site plus cloud) relèvent eux aussi uniquement de la documentation ici. À essayer dans un projet de test : gcloud spanner instances create test --config=regional-us-central1 --nodes=1 --description=test et une requête fédérée BigQuery via bq query --use_legacy_sql=false 'SELECT * FROM EXTERNAL_QUERY("<connection>", "SELECT 1;")'. Pour vous entraîner à la prise de décision, la page d'arbre de décision « Google Cloud database options » est la lecture la plus rentable.
⚠️ Piège d'examen — « Compatible PostgreSQL » apparaît trois fois dans le catalogue Google : Cloud SQL (un vrai PostgreSQL), AlloyDB (compatible PostgreSQL, moteur de stockage Google) et l'interface PostgreSQL de Spanner (un dialecte PostgreSQL, non compatible au niveau du protocole avec tous les pilotes et toutes les extensions). Les questions qui mentionnent des extensions PostgreSQL existantes ou des pilotes exotiques éliminent généralement l'interface PG de Spanner.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.