Guide de préparation à la certification PCDE : Section 4 — Déployer des bases de données évolutives et hautement disponibles dans Google Cloud (Deploy scalable and highly available databases in Google Cloud) (~20 % de l'examen)
📚 Guide officiel de l'examen : Certification Professional Cloud Database Engineer — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Ce guide couvre la section 4 de l'examen Professional Cloud Database Engineer (PCDE) — et c'est la section pour laquelle ce dépôt est le corrigé. « Automatiser le provisionnement des instances de base de données » est littéralement ce que fait Services_GCP : chaque déploiement Cloud SQL, Redis et Firestore de la plateforme (et AlloyDB, dans un projet que vous apportez) est de l'infrastructure as code déclarative, appliquée via votre portail de déploiement ou Cloud Build. La mécanique de HA, de répliques et de surveillance provient de Services_GCP ; le comportement des applications lors d'un basculement s'observe via App_CloudRun/App_GKE. Déployez le profil ha-production décrit dans la carte des labs PCDE avant de commencer.
4.1 Appliquer les concepts pour mettre en œuvre des bases de données évolutives et hautement disponibles dans Google Cloud (Apply concepts to implement scalable and highly available databases in Google Cloud)
⏱ ~90 min · 💰 modéré à élevé tant que ha-production est appliqué (REGIONAL ≈ 2× le coût de l'instance ; chaque réplique ≈ +1 instance) — revenez ensuite à ZONAL/sans réplique · ⚙️ Prérequis : profil ha-production
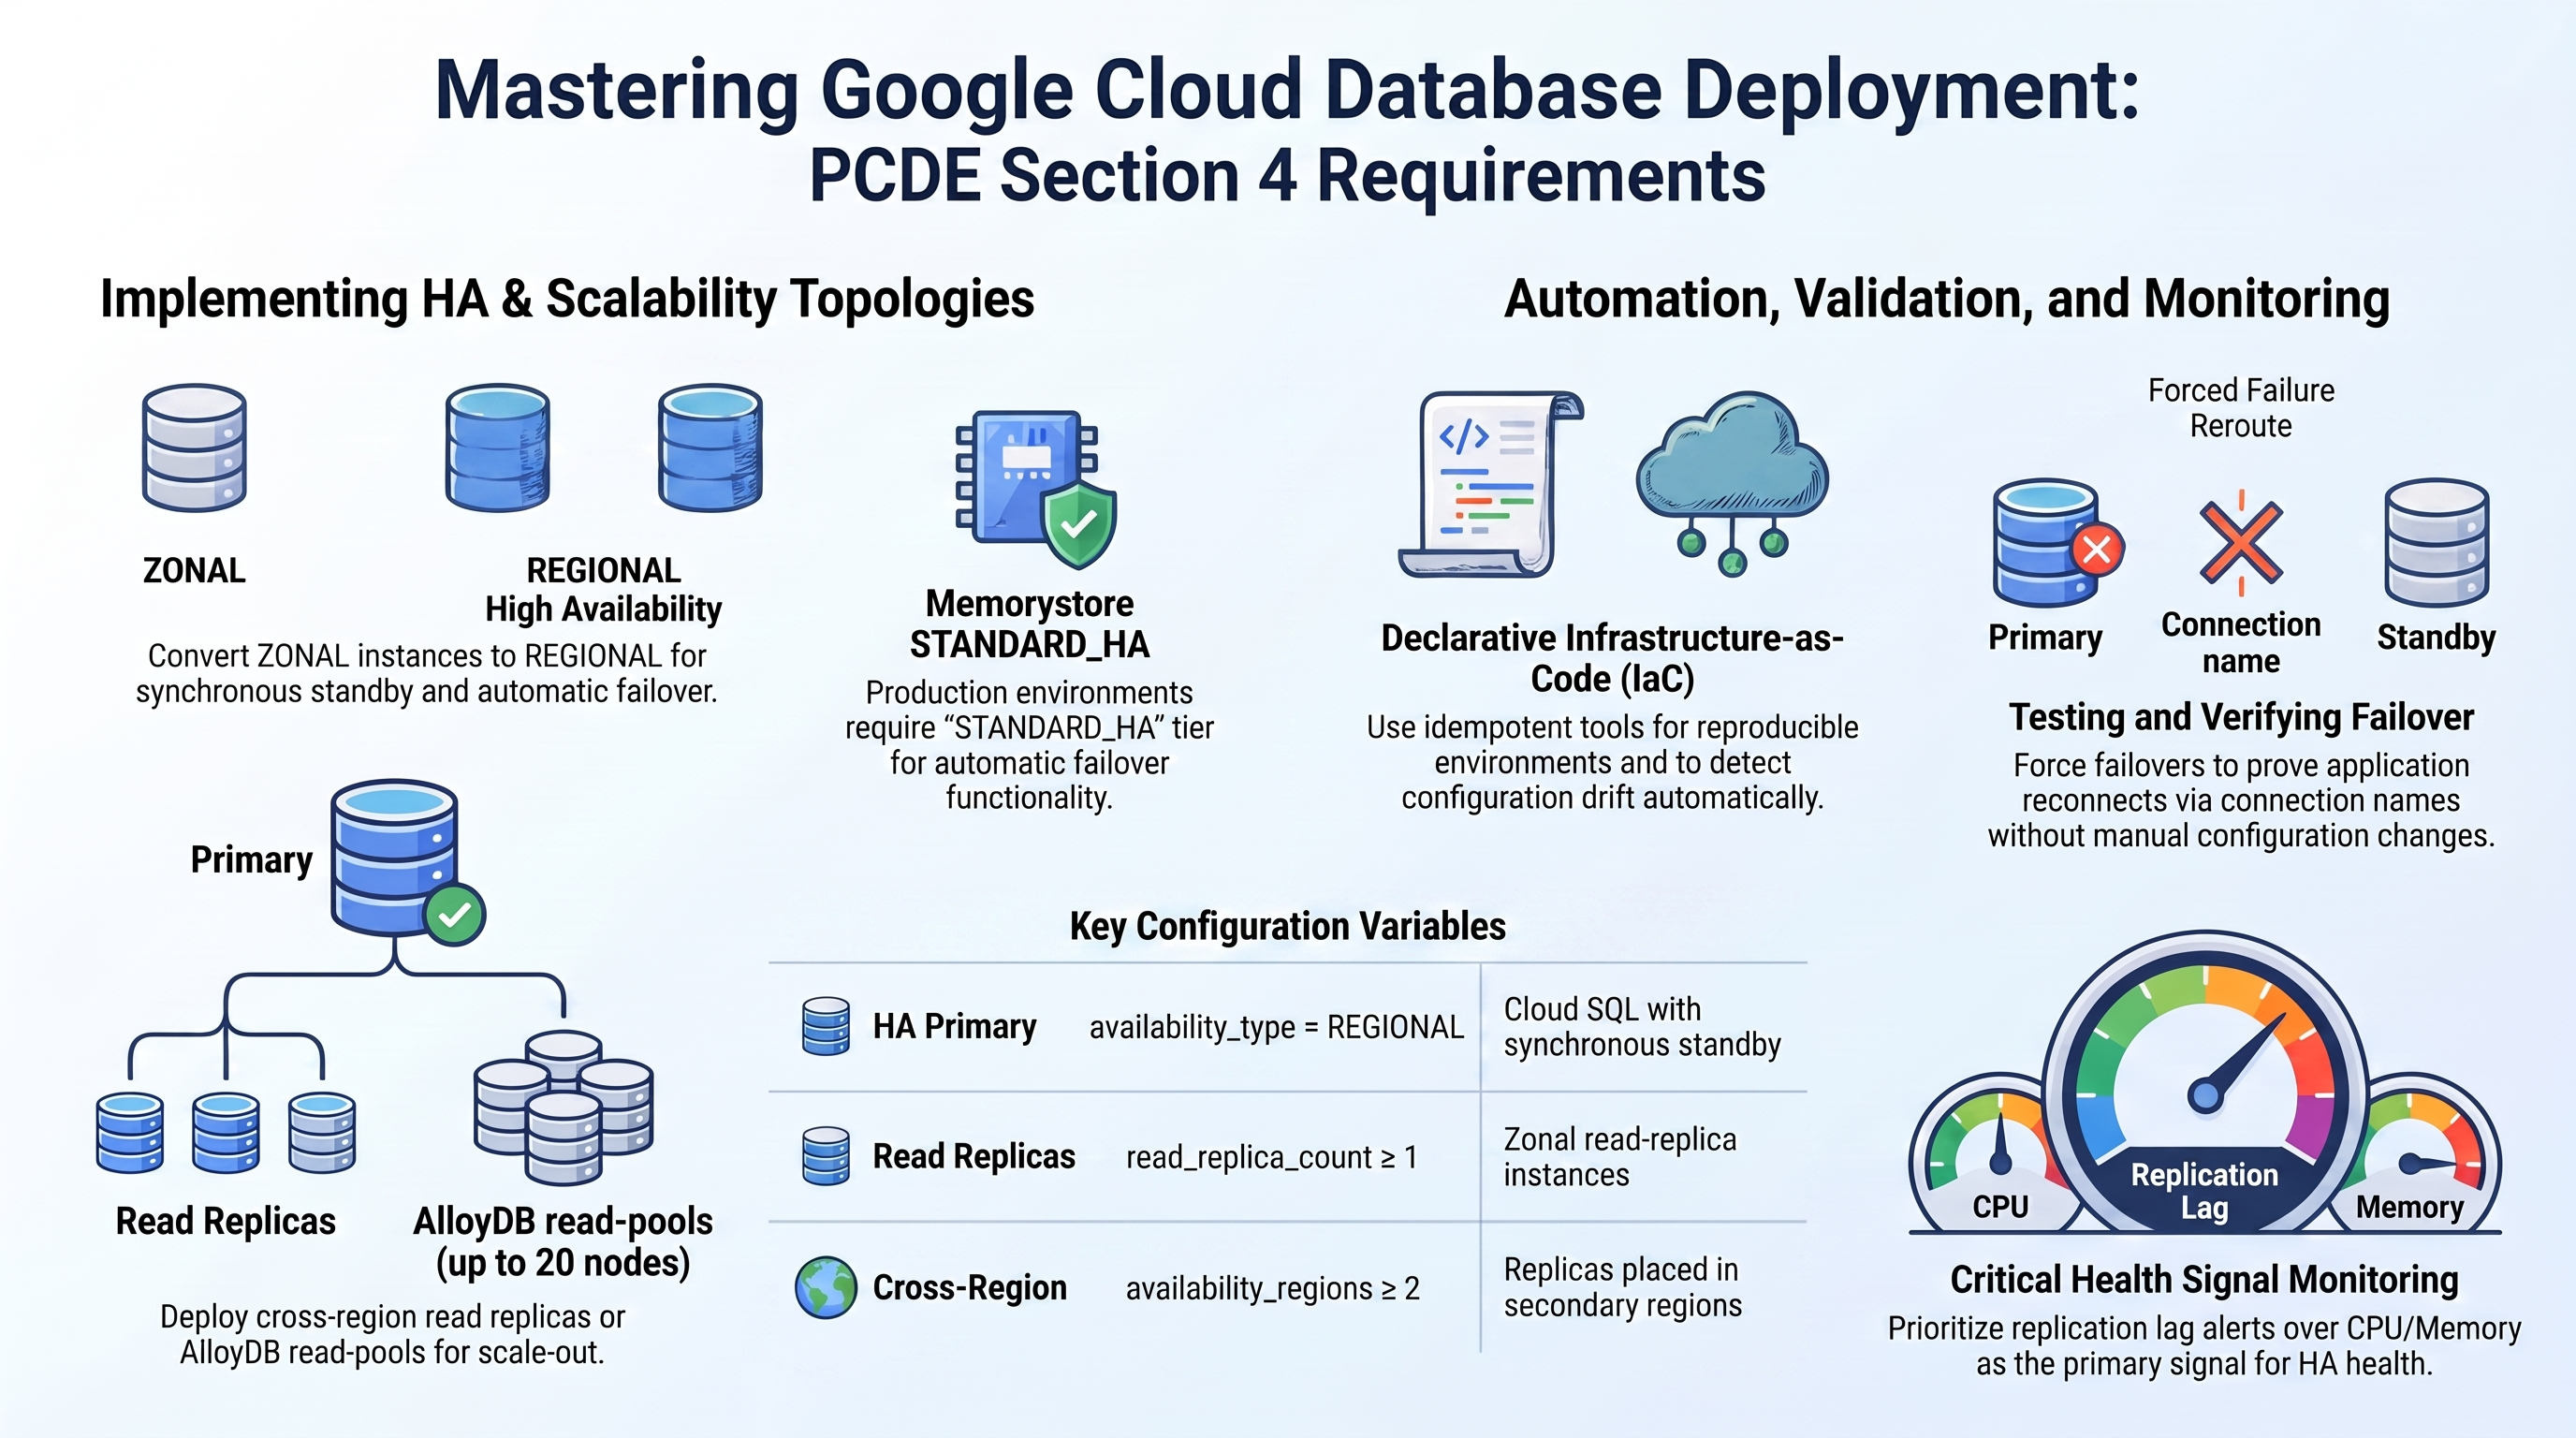
Pourquoi l'examen s'y intéresse — La section 1 vous demandait de choisir une conception de HA ; la section 4 vous demande de la mettre en œuvre et d'en prouver le fonctionnement : provisionner la topologie HA, déployer et mettre à l'échelle des répliques en lecture, répliquer entre régions, vérifier que le basculement fonctionne réellement (un plan de reprise après sinistre non testé est l'anti-modèle préféré de l'examen), automatiser le provisionnement pour que les environnements soient reproductibles, et surveiller les signaux de HA (délai de réplication, événements de basculement, état des instances) plutôt que le seul CPU.
Comment RAD le met en œuvre —
Provisionner la HA de façon déclarative. L'ensemble de la topologie est constitué de variables de Services_GCP :
| Capacité | Variable (valeur par défaut) | Ressource obtenue |
|---|---|---|
| Instance principale HA | postgres_database_availability_type (ZONAL) → REGIONAL | Une instance principale Cloud SQL avec instance de secours synchrone + basculement automatique (de même pour mysql_database_availability_type) |
| Répliques en lecture | create_postgres_read_replica (false), postgres_read_replica_count (1) | Une instance de réplique en lecture Cloud SQL (type READ_REPLICA_INSTANCE), toujours ZONAL |
| Placement interrégional | availability_regions (["us-central1"]) | Avec au moins 2 régions, les répliques sont placées dans la deuxième région ; sinon, elles restent dans la région principale |
| Mise à l'échelle horizontale par pool de lecture (uniquement dans un projet que vous apportez) | enable_alloydb_read_pool (false), alloydb_read_pool_node_count (1, 1–20) | Une instance de pool de lecture AlloyDB (type READ_POOL) |
| HA du cache | redis_tier (BASIC) → STANDARD_HA | Memorystore avec réplique à basculement automatique ; la plateforme bloque BASIC au moment du plan lorsque resource_labels.environment = "production" |
Provisionnement automatisé. C'est de l'infrastructure as code de bout en bout : tofu init → plan → apply (exécuté en CI par le pipeline de création/mise à jour de la plateforme), réapplication idempotente, séquencement des dépendances (les instances attendent la connexion Service Networking ; un délai de 120 s sépare les deux instances Cloud SQL) et découverte plutôt que duplication dans la couche applicative (App_Common trouve l'instance de la plateforme grâce à son libellé managed-by = services-gcp ; App_CloudRun ne provisionne une instance PostgreSQL 17 ZONAL équivalente en ligne que lorsqu'il n'en existe aucune). Le cycle de vie des répliques est lui aussi codifié : les répliques sont reconstruites si l'instance principale est remplacée.
Surveillance des bases de données HA. La plateforme fournit des règles d'alerte sur le CPU, la mémoire et le disque pour resource.type = "cloudsql_database", reliées à des canaux de messagerie (configure_email_notification, notification_alert_emails) ; chaque réplique publie en outre son point de terminaison sous forme de secret <replica-name>-host, afin que les consommateurs basculent leurs lectures de façon délibérée. Côté applicatif, uptime_check_config (valeur par défaut { enabled = false, path = "/" }) crée, une fois activé, une sonde synthétique <service>-uptime-check ainsi qu'une alerte en cas d'échec dès que le point de terminaison de l'application est joignable publiquement — une détection prête à l'emploi de l'impact visible par les utilisateurs pendant les tests de basculement (les déploiements uniquement internes n'en bénéficient pas).
À vous de jouer
-
Appliquez ha-production et cartographiez le parc :
gcloud sql instances list \
  --format="table(name, region, gceZone, settings.availabilityType, instanceType, state)"
Attendez-vous à voir l'instance principale en
REGIONALdans us-central1 et la réplique enREAD_REPLICA_INSTANCEdans us-east1. -
Testez la HA — notez la zone actuelle, forcez un basculement et chronométrez-le :
gcloud sql instances describe cloudsql-<prefix>-postgres --format="value(gceZone)"
gcloud sql instances failover cloudsql-<prefix>-postgres
gcloud sql operations list --instance=cloudsql-<prefix>-postgres --limit=3
Pendant l'opération, appelez l'URL de l'application (ou surveillez le
<service>-uptime-checkcréé par le module dans Console > Monitoring > Uptime checks) pour observer la brève coupure de connexion — le connecteur Cloud SQL se reconnecte au même nom de connexion sans aucune modification de configuration. -
Mettez à l'échelle les lectures — passez
postgres_read_replica_countà2dans le portail, appliquez, et confirmez que la nouvelle réplique apparaît dans la région secondaire ; vérifiez ensuite la santé de la réplication depuis l'instance principale via psql :SELECT client_addr, state, replay_lag FROM pg_stat_replication;. -
Testez la promotion de reprise après sinistre (destructeur pour le statut de réplique de la réplique — faites-le sur la seconde réplique, jetable) :
gcloud sql instances promote-replica cloudsql-<prefix>-postgres-replica-1
gcloud sql instances describe cloudsql-<prefix>-postgres-replica-1 \
  --format="value(instanceType, settings.availabilityType)"
Notez ce que Terraform en pense désormais : l'instance promue a dérivé par rapport à l'état déclaré, et le prochain
tofu planvoudra la réconcilier — la promotion est une action d'urgence (break-glass), pas un processus géré dans ces modules. -
Prouvez la reproductibilité — l'affirmation d'automatisation de cette section : exécutez un plan sur la configuration inchangée et examinez les modifications proposées. Le portail ne propose aucune action de plan seul — un Update (mise à jour) planifie puis applique —, exécutez donc
tofu plandepuis le répertoire du module sur l'état du déploiement, ou lisez la partie plan des journaux du build de l'Update.Vous savez que cela a fonctionné lorsque l'opération de basculement se termine avec l'instance principale dans une nouvelle zone, que l'instance promue indique
CLOUD_SQL_INSTANCE(elle n'est plus une réplique), et qu'un nouveautofu plansur la configuration non modifiée ne montre aucune modification inattendue (idempotence) — tandis que le plan postérieur à la promotion signale visiblement la dérive.
Testez-vous
Q1 : Pendant un test de basculement de l'instance REGIONAL, l'application s'est reconnectée automatiquement sans aucune modification de configuration. Pourquoi — et quel modèle de connexion de cette plateforme l'a rendu possible ?
R : Le basculement HA de Cloud SQL conserve l'identité de l'instance : le nom de connexion et l'IP privée passent à l'instance de secours promue. Comme l'application se connecte via le volume du connecteur Cloud SQL (Cloud Run) ou le sidecar Auth Proxy (GKE), adressés par nom de connexion, et lit ses identifiants dans Secret Manager, rien côté client ne faisait référence à la zone défaillante. Les IP zonales codées en dur sont l'anti-modèle que cette conception évite.
Q2 : Un scénario exige que le trafic de lecture soit servi dans deux régions et qu'une procédure documentée existe en cas de perte d'une région. Quelles variables construisent la topologie, et quelles sont les deux étapes qui restent manuelles ?
R : availability_regions = ["us-central1", "us-east1"], postgres_database_availability_type = "REGIONAL", create_postgres_read_replica = true, postgres_read_replica_count ≥ 1 — les répliques sont placées dans la région secondaire et leurs points de terminaison publiés sous forme de secrets. Manuelles en cas de sinistre : la promotion de la réplique (gcloud sql instances promote-replica) et la redirection des applications vers le point de terminaison promu (par ex. en mettant à jour le secret d'hôte). Le basculement interrégional n'est jamais automatique pour Cloud SQL — un point récurrent de l'examen.
Q3 : Pourquoi le provisionnement fondé sur Terraform est-il en soi un contrôle de HA, et pas une simple commodité ?
R : La reproductibilité, c'est la capacité de restauration : l'ensemble du parc de bases de données (instances, options, réseaux, secrets, alertes) peut être recréé à partir du code dans un autre projet ou une autre région avec tofu apply, et la dérive de configuration est détectée par tofu plan. Des instances créées manuellement dans la console ne peuvent pas être reconstruites de façon fiable sous la pression d'un incident. L'examen formule cela comme « automatiser le provisionnement des instances » — l'IaC plus la réapplication idempotente est la réponse attendue.
Au-delà des modules — Trois lacunes à étudier : (1) les processus gérés de promotion interrégionale — les modules construisent la réplique mais n'automatisent ni la promotion ni la procédure ; lisez « Promoting replicas » et « Cross-region replicas for disaster recovery » dans la documentation Cloud SQL, y compris la manière de rétablir la réplication après une promotion ; (2) les systèmes d'écriture multirégionaux — les configurations d'instances multirégionales de Spanner et les clusters secondaires AlloyDB (gcloud alloydb clusters create-secondary) avec leur sémantique de basculement planifié/non planifié ; (3) les alertes sur le délai de réplication — le module alerte sur le CPU, la mémoire et le disque, mais pas sur cloudsql.googleapis.com/database/replication/replica_lag ; entraînez-vous à ajouter cette alerte dans Console > Monitoring > Alerting ou via gcloud alpha monitoring policies create dans un projet de test, car le délai est le signal de santé de la HA pour les topologies à répliques en lecture.
⚠️ Piège d'examen — gcloud sql instances failover ne fonctionne que sur les instances REGIONAL (HA) — l'exécuter sur une instance ZONAL échoue, faute d'instance de secours. Et la promotion est à sens unique : une réplique promue est une instance principale autonome ; pour retrouver une réplique, vous en créez une nouvelle et la réinitialisez. Les distracteurs qui proposent de « revenir en arrière en rétrogradant » l'instance promue sont faux pour Cloud SQL.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.