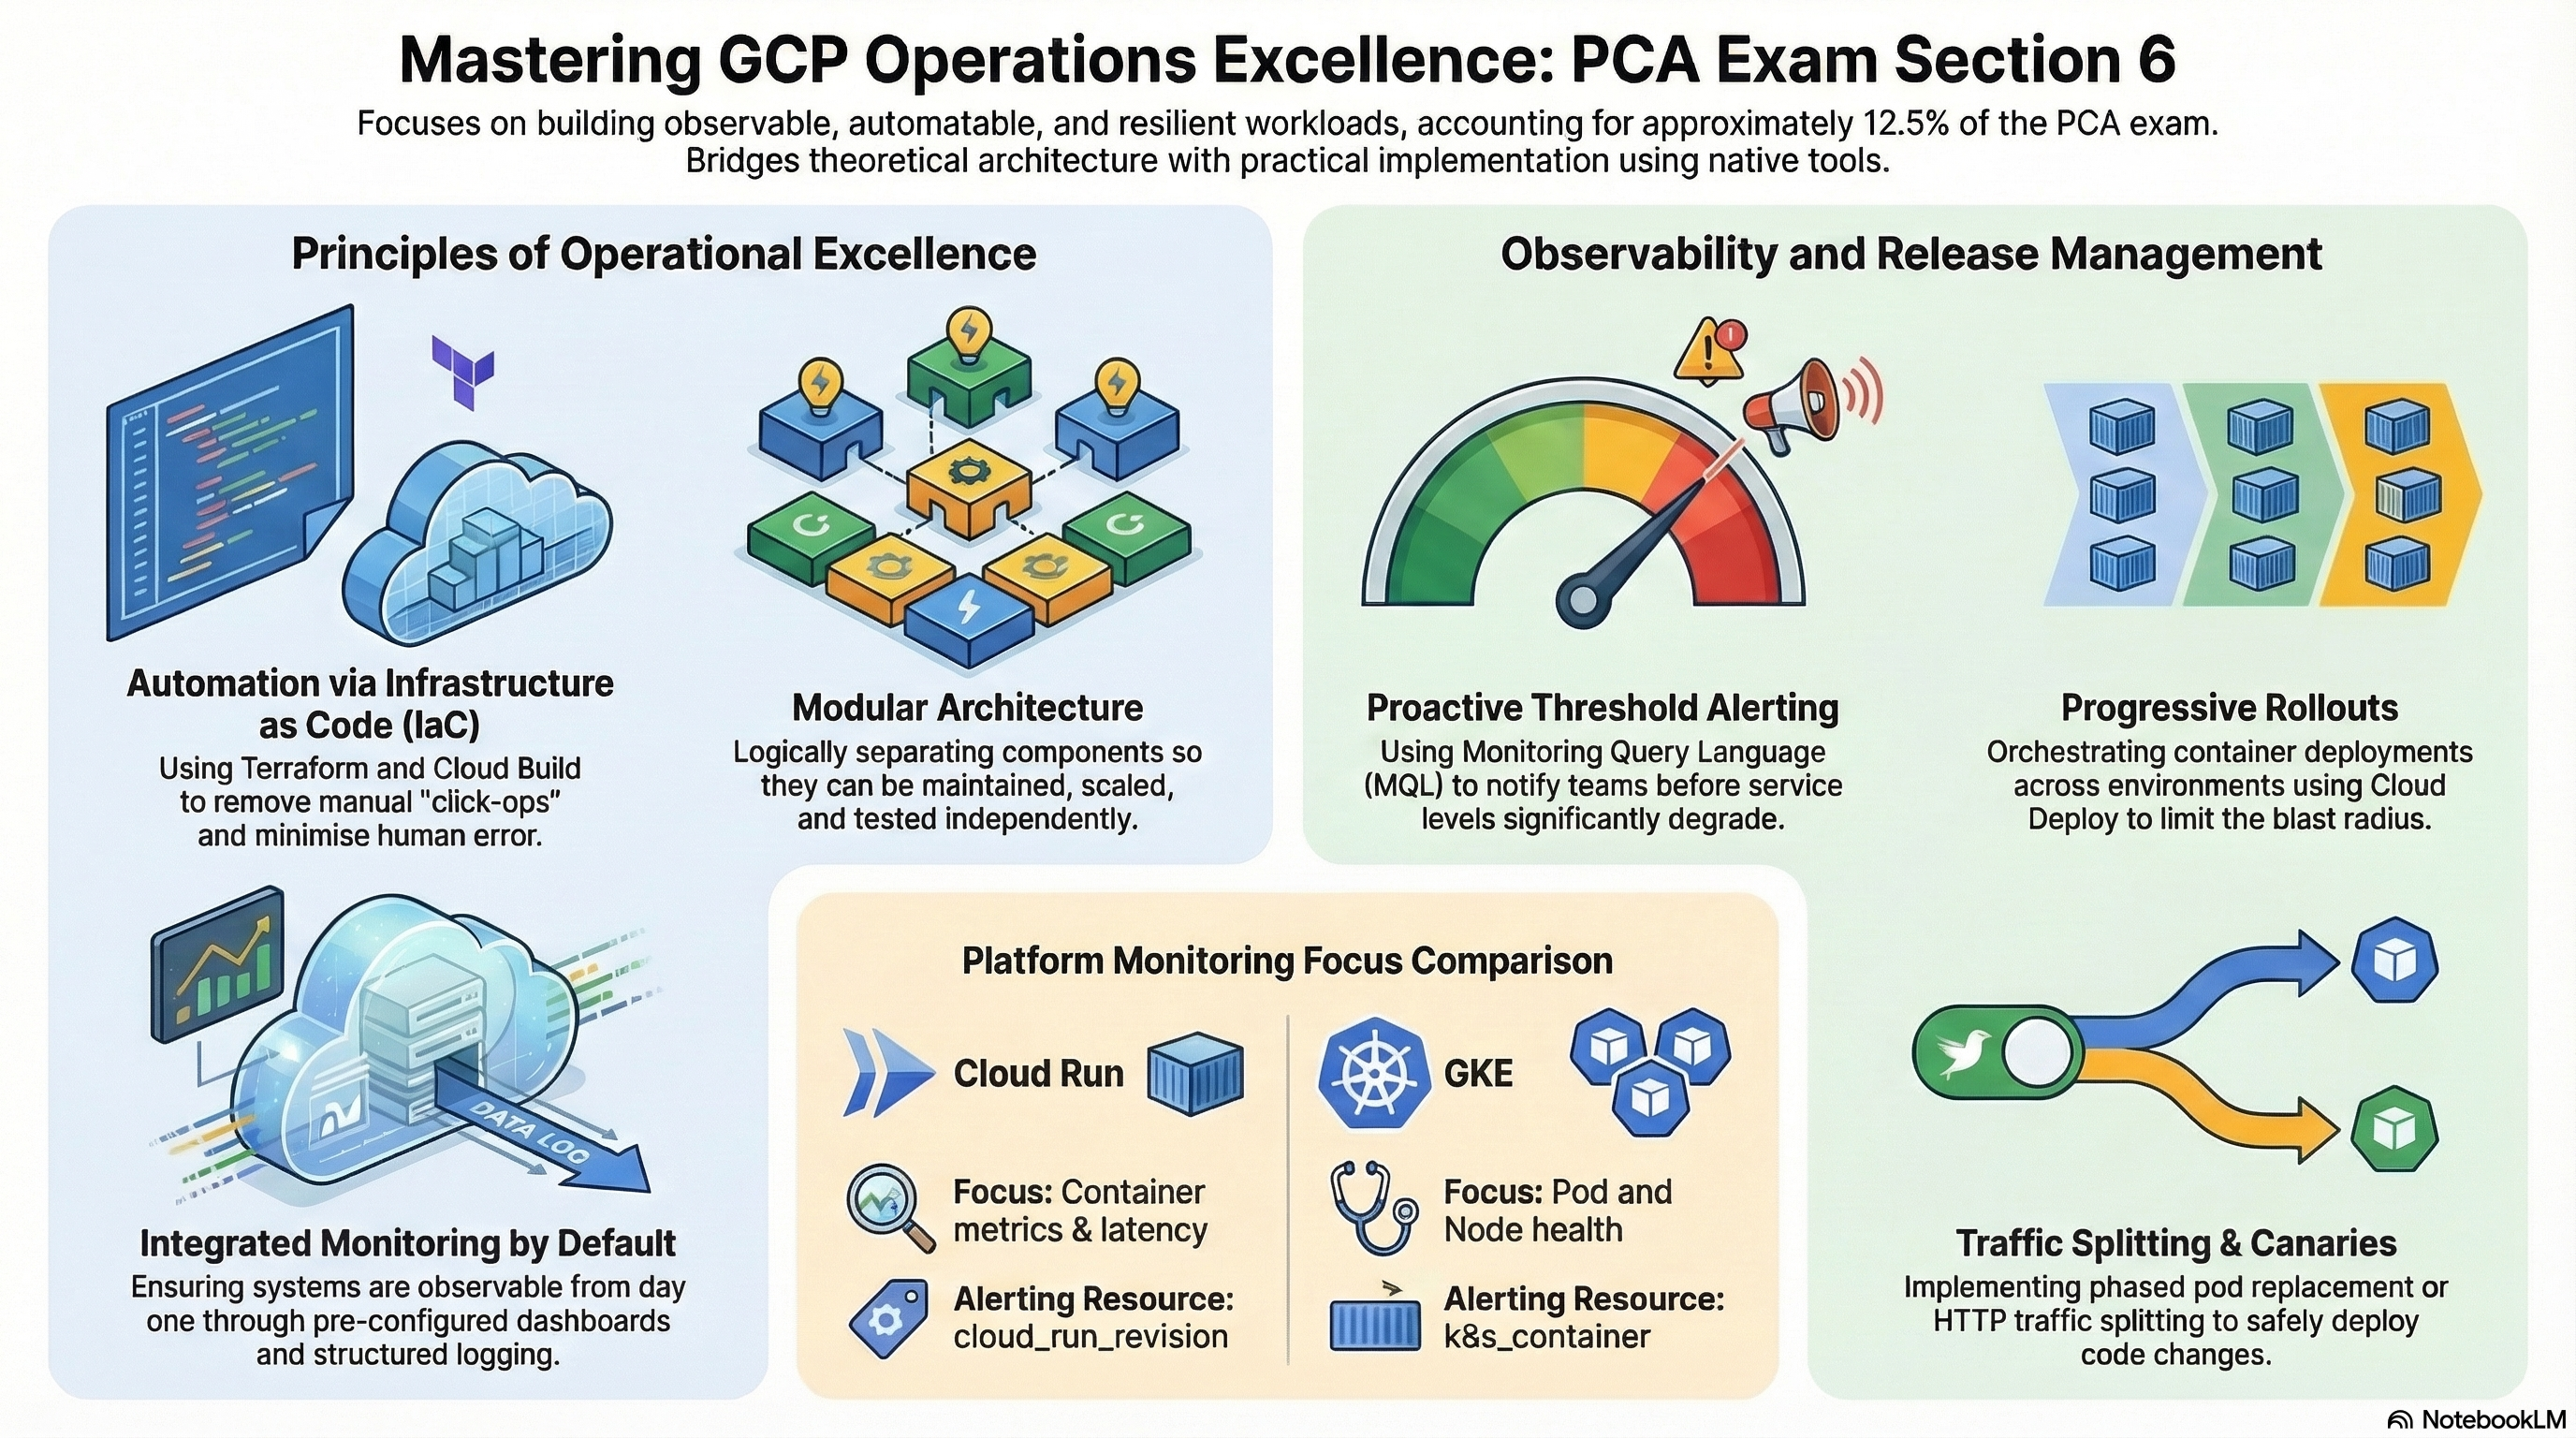
Guide de préparation à la certification PCA : Section 6 — Garantir l'excellence des solutions et des opérations (Ensuring solution and operations excellence) (~12,5 % de l'examen)
📚 Guide d'examen officiel : Professional Cloud Architect certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Les opérations du « jour 2 » : observer les systèmes, mettre en production en toute sécurité, contrôler la qualité et maintenir la fiabilité de la production. Chaque déploiement RAD est livré avec un tableau de bord et des alertes reliées à votre adresse e-mail, et les déploiements accessibles publiquement ajoutent un test de disponibilité synthétique (voir 6.2) — l'essentiel de cette section est donc observable avec le profil Socle allégé de la Carte des labs ; ajoutez le profil Sécurité et livraison pour la gestion des mises en production (6.3) et le profil Architecture GKE pour les mécanismes de fiabilité du point 6.6. Modules sollicités : les quatre, avec un accent sur les couches de surveillance de Services_GCP et d'App_CloudRun, ainsi que sur les couches partagées de surveillance et de tableaux de bord de la plateforme.
6.1 Pilier excellence opérationnelle du Well-Architected Framework (Operational excellence pillar (Well-Architected Framework))
⏱ ~30 min de lecture + revue dans la console · 💰 aucun coût supplémentaire · ⚙️ Prérequis : déploiement par défaut
Pourquoi l'examen s'y intéresse — Le pilier excellence opérationnelle du Well-Architected Framework — tout automatiser, effectuer les changements en toute sécurité, se préparer aux défaillances, s'améliorer en continu — structure de nombreuses réponses aux scénarios. L'examen récompense la capacité à repérer le travail opérationnel répétitif (toil) et à le remplacer par de l'automatisation.
Comment RAD le met en œuvre — Le pilier se manifeste par un ensemble d'automatisations qui suppriment le travail manuel : la VM NFS est un groupe d'instances géré avec des vérifications d'état TCP, une réparation automatique et des instantanés de disque quotidiens (pas d'astreinte pour un serveur de fichiers bloqué) ; la plateforme restaure au moment du plan les versions de clé CMEK désactivées ou programmées pour destruction (auto-réparation avant que la défaillance ne se manifeste) ; les jobs Cloud Run orphelins et les anciennes révisions sont nettoyés automatiquement ; la rotation des secrets est événementielle et sans interruption ; et toute la plateforme est reproductible de manière déclarative, si bien que reconstruire un environnement se résume à une application, pas à un runbook.
À vous de jouer
- Choisissez trois automatisations ci-dessus (le groupe d'instances NFS à réparation automatique, la récupération des clés CMEK au moment du plan et l'élagage des révisions/jobs Cloud Run), et notez le runbook manuel que chacune remplace.
- Observez-en une en action — listez la planification d'instantanés qui protège le disque de données NFS :
gcloud compute resource-policies list --format="table(name,snapshotSchedulePolicy.schedule.dailySchedule)"
- Vous savez que cela a fonctionné lorsque vous pouvez nommer, pour chaque automatisation, la classe d'incidents qu'elle prévient plutôt que celle à laquelle elle réagit.
Testez-vous
Q1 : Le runbook d'une équipe indique : « si le serveur de fichiers ne répond plus, connectez-vous en SSH et redémarrez nfsd ; si le disque est corrompu, restaurez la copie de la nuit dernière ». Par quoi cette plateforme le remplace-t-elle ?
R : Par un groupe d'instances géré avec des vérifications d'état TCP (ports 2049/6379) et une réparation automatique — une instance qui ne répond plus est recréée automatiquement, son disque de données avec état étant rattaché — plus une planification d'instantanés quotidiens avec 7 jours de conservation pour le cas de la corruption. Le runbook devient de l'infrastructure ; l'examen appelle cela éliminer le travail répétitif par l'automatisation.
Au-delà des modules — Lisez de bout en bout le pilier officiel « Google Cloud Well-Architected Framework: Operational excellence » — ses principes (automatiser les déploiements, gérer les incidents, planifier la reprise après sinistre) sont cités presque mot pour mot dans les réponses proposées à l'examen. Les autres piliers du framework (sécurité, fiabilité, optimisation des performances, optimisation des coûts, durabilité) peuvent également être évalués ; les piliers durabilité et performances n'ont pas d'équivalent dans les modules.
6.2 Connaître les solutions Google Cloud Observability (Familiarity with Google Cloud Observability solutions)
⏱ ~60 min · 💰 faible — volume de journaux/métriques uniquement · ⚙️ Prérequis : déploiement par défaut avec
support_usersrenseigné
Pourquoi l'examen s'y intéresse — Vous devez connaître la répartition des rôles dans la pile d'observabilité — Monitoring (métriques, alertes, tests de disponibilité, tableaux de bord), Logging (Logs Explorer, métriques basées sur les journaux, récepteurs), Trace/Profiler (analyse de la latence et au niveau du code) — et concevoir des alertes qui préviennent sur des symptômes, avec des seuils exploitables.
Comment RAD le met en œuvre
| Capacité | Mise en œuvre | Variables (valeurs par défaut) |
|---|---|---|
| Canaux de notification | canaux e-mail par adresse | support_users (modules App), configure_email_notification + notification_alert_emails (Services_GCP) |
| Alertes d'infrastructure | règles CPU/mémoire/disque de Cloud SQL et CPU/mémoire/instance arrêtée de la VM NFS, provisionnées par la plateforme | alert_cpu_threshold / alert_memory_threshold / alert_disk_threshold (tous par défaut 80) |
| Alertes applicatives | règles par service filtrées sur le service Cloud Run | liste alert_policies — metric_type, comparison, threshold_value, duration_seconds, aggregation_period (par défaut "60s") |
| Surveillance synthétique | <service>-uptime-check (HTTP GET depuis plusieurs régions de sonde dans le monde) plus une règle <service>-uptime-check-alert sur monitoring.googleapis.com/uptime_check/check_passed, créés par la couche de surveillance de la plateforme lorsque le point de terminaison est accessible publiquement ; uptime_check_names renvoie le nom réel du test | uptime_check_config (par défaut { enabled = false, path = "/" } ; check_interval par défaut "60s", timeout par défaut "10s") |
| Tableaux de bord | tableau de bord par déploiement provisionné par la plateforme | App_CloudRun / App_GKE |
| Télémétrie GKE | journalisation système + charges de travail, Managed Service for Prometheus | valeurs par défaut fixes dans Services_GCP |
À vous de jouer
- Dans Console > Monitoring > Alerting, identifiez les règles de la plateforme (CPU/mémoire/disque de Cloud SQL, état de NFS) et les règles de votre service ; ouvrez-en une et suivez le chemin métrique → seuil → canal.
- Ajoutez une règle personnalisée via le portail, par exemple
{ name = "high-latency", metric_type = "run.googleapis.com/request_latencies", comparison = "COMPARISON_GT", threshold_value = 1000, duration_seconds = 300 }, et appliquez à nouveau. - Dans Console > Monitoring > Uptime checks, ouvrez le
<service>-uptime-checkcréé par le module et observez les résultats des sondes arriver depuis plusieurs régions, puis interrogez les erreurs applicatives récentes :
gcloud logging read \
  'resource.type="cloud_run_revision" AND severity>=ERROR' \
  --limit=10 --format="table(timestamp,severity,textPayload)"
- Vous savez que cela a fonctionné lorsque votre règle personnalisée apparaît dans Alerting, reliée au canal e-mail
support_users, et que le test de disponibilité créé par le module affiche des sondes réussies depuis plusieurs régions.
Testez-vous
Q1 : Des utilisateurs signalent que l'application est indisponible, mais aucune alerte ne s'est déclenchée — le CPU et la mémoire étaient normaux. Quelle lacune de surveillance existe dans le déploiement par défaut, et quel type d'alerte convient pour la combler ?
R : Un test de disponibilité synthétique sondant le point de terminaison depuis l'extérieur (les modules en créent un via uptime_check_config pour les déploiements accessibles publiquement — les déploiements internes uniquement n'en reçoivent pas ; cette lacune apparaît donc dès que l'entrée est verrouillée). Les métriques de ressources sont fondées sur les causes et peuvent sembler saines alors que l'expérience utilisateur est dégradée (mauvais déploiement, mauvaise configuration de l'équilibreur de charge, dépendance hors service) ; une sonde externe est fondée sur les symptômes — elle mesure ce que vivent les utilisateurs, et c'est sur cela que la pratique SRE (et l'examen) recommande d'alerter.
Q2 : L'équipe base de données veut être avertie avant que la base ne se dégrade. Quels trois seuils de la plateforme s'appliquent, et quel compromis de réglage devez-vous expliquer ?
R : alert_cpu_threshold, alert_memory_threshold, alert_disk_threshold (chacun par défaut à 80 %) sur l'instance Cloud SQL. Des seuils plus bas donnent du délai d'anticipation, mais augmentent la charge de faux positifs (lassitude face aux alertes) ; des seuils plus élevés réduisent le bruit, mais raccourcissent le temps de réaction. Les durées (duration_seconds) suppriment les pics transitoires — la conception des alertes est un compromis précision/rappel, pas un chiffre juste unique.
Au-delà des modules — Non câblés : récepteurs/exports de journaux vers BigQuery, métriques basées sur les journaux, surveillance des SLO avec alertes sur le taux d'épuisement, Cloud Trace et Cloud Profiler. Entraînez-vous à créer une métrique basée sur les journaux et un SLO sur un service Cloud Run dans la console Monitoring — les questions sur les SLO et les budgets d'erreur sont fréquentes.
⚠️ Piège d'examen — Les tests de disponibilité nécessitent un point de terminaison accessible depuis l'extérieur. Si un scénario verrouille l'entrée (par exemple en interne uniquement), un test de disponibilité public échoue par conception — la réponse est un test de disponibilité privé ou des sondes synthétiques internes, pas « le service est indisponible ». RAD l'encode : les modules de fondation ne créent aucun test de disponibilité lorsque le déploiement n'est pas accessible publiquement.
6.3 Gestion des déploiements et des mises en production (Deployment and release management)
⏱ ~60 min · 💰 faible · ⚙️ Prérequis : profil Sécurité et livraison (Cloud Deploy + CI/CD)
Pourquoi l'examen s'y intéresse — Les questions de gestion des mises en production évaluent les stratégies de déploiement (rolling, blue-green, canary), la rapidité du retour arrière et la discipline de promotion entre environnements — y compris le maintien de la compatibilité de la couche de données (schémas, secrets) pendant un déploiement.
Comment RAD le met en œuvre — Cloud Run conserve les révisions antérieures et les élague jusqu'à max_revisions_to_retain (par défaut 7) ; le retour arrière consiste donc à rediriger le trafic, traffic_split fournissant les pourcentages canary et blue-green (dont la somme doit valoir 100, ce qui est validé). Cloud Deploy (cloud_deploy_stages, par défaut dev/staging/prod avec approbation sur prod) promeut un artefact unique d'un environnement à l'autre. Sur GKE, les Deployments utilisent des mises à jour progressives, les StatefulSets utilisent stateful_update_strategy (par défaut RollingUpdate), et les étapes Cloud Deploy correspondent à des services par étape sélectionnés par gateway_backend_stage (par défaut "dev") derrière la Gateway. La couche de données est également couverte : la rotation des secrets est à double version (nouvelle version ajoutée, ancienne désactivée seulement après rotation_propagation_delay_sec, par défaut 90), de sorte qu'un déploiement n'entre jamais en concurrence avec ses identifiants.
À vous de jouer
- Déployez une nouvelle version de l'application, puis revenez en arrière sans reconstruire :
gcloud run services update-traffic <service-name> \
  --region=us-central1 \
  --to-revisions=<previous-revision>=100
- Vérifiez dans Console > Cloud Run > Revisions que le trafic a été déplacé et que l'ancienne révision existe toujours (l'élagage en conserve 7).
- Sur GKE, observez une mise à jour progressive : modifiez l'image/la version dans le portail et exécutez
kubectl rollout status deployment/<name> -n <namespace>. - Vous savez que cela a fonctionné lorsque le retour arrière a pris quelques secondes (déplacement du trafic) plutôt que plusieurs minutes (reconstruction + redéploiement).
Testez-vous
Q1 : Pourquoi l'élagage des révisions compte-t-il pour la gestion des mises en production — conserver toutes les révisions n'est-il pas plus sûr ?
R : Des révisions illimitées accumulent des coûts (images de conteneurs, encombrement de la configuration) et rendent la cible du retour arrière ambiguë. Conserver une fenêtre limitée (7 ici) permet un retour arrière rapide vers n'importe quelle version récente, tout en obligeant à reproduire les états plus anciens à partir du contrôle de source — l'artefact de référence — plutôt qu'à partir d'objets d'exécution périmés.
Q2 : Lors d'une rotation d'identifiants en plein déploiement, d'anciens pods détiennent encore le mot de passe précédent. Pourquoi la rotation de cette plateforme ne les casse-t-elle pas ?
R : La rotation est à double version : le job de rotation ajoute la nouvelle version du secret et modifie le mot de passe de la base de données, mais ne désactive l'ancienne version qu'après un délai de propagation ; les deux identifiants restent donc brièvement valides pendant que les révisions/pods convergent. La rotation à version unique (écraser puis espérer) est le schéma de panne que l'examen veut vous voir éviter.
⚠️ Piège d'examen — Blue-green et canary diffèrent par le coût et le rayon d'impact : le blue-green double la capacité pour une bascule complète instantanée ; le canary expose progressivement un petit pourcentage. traffic_split met en œuvre les deux formes sur Cloud Run — choisissez selon la tolérance du scénario au risque ou à la dépense.
6.4 Contribuer à l'assistance des solutions déployées (Assisting with the support of deployed solutions)
⏱ ~20 min de lecture · 💰 aucun coût supplémentaire · ⚙️ Prérequis : déploiement par défaut
Pourquoi l'examen s'y intéresse — Les architectes conçoivent le modèle d'assistance : qui est notifié, avec quelles preuves, et quand faire remonter le problème à Google Cloud Customer Care (formules Standard/Enhanced/Premium, intervention d'un TAM pour les P1).
Comment RAD le met en œuvre — Largement non mis en œuvre ; la capacité voisine la plus proche est la chaîne de notification : support_users alimente des canaux e-mail Cloud Monitoring (un par adresse, via la couche de surveillance de la plateforme), de sorte que le public d'astreinte fait partie de la définition du déploiement, et chaque alerte du point 6.2 porte les preuves métriques dont un dossier d'assistance a besoin.
À vous de jouer
- Ajoutez une deuxième adresse à
support_userset appliquez à nouveau ; vérifiez le nouveau canal dans Console > Monitoring > Alerting > Notification channels :
gcloud beta monitoring channels list --format="table(displayName,type,labels.email_address)"
- Vous savez que cela a fonctionné lorsque la liste des canaux correspond à la variable.
Testez-vous
Q1 : Un client exploitant des charges de travail de production critiques demande quelle formule d'assistance Google Cloud il lui faut pour une réponse en 15 minutes sur les P1 et un interlocuteur technique désigné. Que recommandez-vous ?
R : Premium Support — elle offre l'objectif de délai de réponse P1 le plus court et l'intervention d'un Technical Account Manager. Enhanced convient aux charges de travail de production aux exigences de réponse moins strictes ; Standard s'adresse aux charges de travail non critiques. Dans les scénarios d'examen, le choix de la formule est une recommandation d'architecture, pas un détail de dernière minute.
Au-delà des modules — Étudiez les niveaux de Cloud Customer Care et les définitions des priorités des dossiers (P1–P4), les chemins d'escalade, et la manière de rassembler des preuves de diagnostic (journaux, traces, captures de la surveillance). Parcourez Console > Support dans n'importe quel projet pour voir le déroulement d'un dossier.
6.5 Évaluer les mesures de contrôle qualité (Evaluating quality control measures)
⏱ ~45 min · 💰 faible · ⚙️ Prérequis :
enable_vulnerability_scanning = true(Services_GCP) et le profil Sécurité et livraison
Pourquoi l'examen s'y intéresse — Le contrôle qualité couvre toute la chaîne de livraison : vérifications statiques avant l'application, analyse des images avant le déploiement, contrôle d'admission au déploiement et surveillance de la posture ensuite. L'examen demande quel contrôle détecte quelle classe de défauts, et à quel endroit du pipeline il doit se trouver.
Comment RAD le met en œuvre — La plateforme superpose quatre portes de qualité. Au moment du plan : tofu validate plus les préconditions des modules (32 rien que dans App_GKE) rejettent les configurations invalides avant tout appel d'API. Au moment du build : enable_vulnerability_scanning active l'analyse d'Artifact Registry (enablement_config = INHERITED), qui fait remonter les CVE par condensé d'image. Au moment du déploiement : Binary Authorization (REQUIRE_ATTESTATION) n'admet que les condensés signés par le pipeline. À l'exécution : les clusters GKE activent security_posture_config (mode BASIC, VULNERABILITY_BASIC) pour les résultats de posture des charges de travail.
À vous de jouer
- Faites passer dans le pipeline une image de base volontairement ancienne, puis examinez les résultats dans Console > Artifact Registry > (repo) > (image) sous Vulnerabilities, ou :
gcloud artifacts docker images list \
  <region>-docker.pkg.dev/<project>/<repo>/<image> \
  --show-occurrences --occurrence-filter='kind="VULNERABILITY"'
- Associez chaque classe de défauts à sa porte : variable incorrecte → précondition du plan ; CVE → analyse AR ; image non signée → Binary Authorization ; configuration de charge de travail risquée → posture de sécurité.
- Vous savez que cela a fonctionné lorsque l'analyse liste les CVE de votre image avec leur gravité, et que vous pouvez indiquer quelle porte aurait détecté chacune des trois autres classes de défauts.
Testez-vous
Q1 : L'analyse a détecté une CVE critique, et pourtant l'image a été déployée. Pourquoi, et qu'est-ce qui comble cette lacune ?
R : L'analyse est détective, pas préventive — elle signale les résultats mais ne bloque rien. Combler la lacune exige un point d'application : Binary Authorization avec une attestation accordée uniquement après une analyse réussie (par exemple, l'étape CI n'atteste que lorsqu'aucune CVE critique n'est présente). L'examen oppose régulièrement les contrôles de visibilité aux contrôles d'application.
Q2 : Qu'est-ce qui est le moins coûteux à détecter : un quota de mémoire mal formé au moment du plan ou au moment de la planification des pods — et comment cette plateforme tranche-t-elle ?
R : Au moment du plan. App_GKE vérifie que les valeurs de quota de mémoire portent des suffixes d'unité binaires ("4Gi") précisément parce qu'un nombre nu est interprété par Kubernetes comme des octets et bloque silencieusement toute planification de pods — une panne d'exécution déroutante transformée en une erreur de plan immédiate et explicite. Détecter les défauts plus tôt (shift left) est le principe de contrôle qualité évalué ici.
Au-delà des modules — Absents : suites de tests automatisés dans la CI (unitaires/d'intégration), étapes SAST/analyse des dépendances, Web Security Scanner, et policy-as-code sur les plans d'infrastructure (par exemple OPA/terraform-compliance). Étudiez la documentation « Container scanning overview » et « Web Security Scanner », et essayez d'ajouter une étape de test à un fichier YAML Cloud Build dans un dépôt de test.
6.6 Garantir la fiabilité des solutions en production (Ensuring the reliability of solutions in production)
⏱ ~75 min · 💰 modéré — nécessite le profil GKE avec au moins 2 réplicas · ⚙️ Prérequis : profil Architecture GKE (
max_instance_count ≥ 2),enable_topology_spread = true
Pourquoi l'examen s'y intéresse — L'ingénierie de la fiabilité consiste à choisir des mécanismes : protéger la capacité pendant les interruptions volontaires (PDB), répartir les réplicas entre domaines de défaillance, conditionner le trafic à l'état de santé (vérifications), réparer automatiquement l'infrastructure et imposer des niveaux adaptés à la production. L'examen présente un récit de défaillance et demande quel mécanisme manquait.
Comment RAD le met en œuvre
| Mode de défaillance | Mécanisme | Variables (valeurs par défaut) |
|---|---|---|
| Une mise à niveau/un drainage évince trop de pods | PodDisruptionBudget | enable_pod_disruption_budget (par défaut true), pdb_min_available (par défaut "1"), omis lorsque max_instance_count = 1 |
| Tous les réplicas se retrouvent dans une seule zone | répartition topologique par zone + nom d'hôte | enable_topology_spread (par défaut false), topology_spread_strict |
| Le trafic atteint un conteneur en cours de démarrage | vérification de démarrage (délai 10 s/période 10 s) et vérification d'activité (délai 15 s/période 30 s), HTTP ou TCP | startup_probe_config, health_check_config (les deux moteurs) |
| La VM NFS se bloque | réparation automatique du MIG sur des vérifications d'état TCP 2049/6379 (délai initial de 300 s), mises à jour PROACTIVE/REPLACE | create_network_filesystem (par défaut true) |
| Production sur un cache non répliqué | un garde-fou au moment du plan bloque redis_tier = "BASIC" lorsque resource_labels.environment = "production" | Services_GCP |
| La demande dépasse la capacité | HPA à 70 % de CPU / 80 % de mémoire (GKE), mise à l'échelle des instances (Cloud Run) | min_instance_count / max_instance_count |
À vous de jouer
- Avec au moins 2 réplicas, vérifiez le PDB puis simulez une interruption volontaire :
kubectl get pdb -n <namespace>
kubectl get pods -n <namespace> -o wide   # note the nodes
kubectl drain <node-name> --ignore-daemonsets --delete-emptydir-data --dry-run=server
- Activez
enable_topology_spread = true, appliquez à nouveau, et vérifiez que les pods se trouvent dans des zones différentes (kubectl get pods -o wide— comparez les zones des nœuds). - Cassez volontairement le chemin de vérification d'activité (faites pointer
health_check_config.pathvers une route inexistante dans un déploiement de test) et observez les pods redémarrer dans Console > Kubernetes Engine > Workloads. - Vous savez que cela a fonctionné lorsque le drainage respecte
minAvailable, que les réplicas couvrent plusieurs zones et que le mauvais chemin de vérification provoque des redémarrages au lieu d'une perte silencieuse du trafic.
Testez-vous
Q1 : Lors d'une mise à niveau des nœuds GKE, un service à 3 réplicas est brièvement tombé à zéro pod sain. Quels deux mécanismes de cette plateforme manquaient ?
R : Un PodDisruptionBudget (minAvailable: 1 aurait forcé le drainage à conserver un pod en service) et la répartition topologique (des réplicas concentrés sur un même nœud/une même zone sont évincés ensemble). Les valeurs par défaut fournissent ici le PDB automatiquement dès que max_instance_count > 1 ; la répartition doit être activée explicitement via enable_topology_spread.
Q2 : Une application JVM lente à démarrer est tuée dans une boucle de redémarrage sur GKE. Quel paramètre de vérification est erroné, et pourquoi existe-t-il deux vérifications ?
R : La fenêtre de la vérification de démarrage est trop courte — elle doit couvrir le pire temps de démarrage avant que la vérification d'activité ne prenne le relais. Les vérifications de démarrage répondent à « a-t-il fini de démarrer ? » (échec = continuer d'attendre, dans certaines limites) ; les vérifications d'activité répondent à « est-il toujours en bonne santé ? » (échec = redémarrage). Régler la vérification d'activité pour tolérer les démarrages lents au lieu d'utiliser une vérification de démarrage affaiblit la détection des défaillances pendant toute la durée de vie du pod.
Q3 : La direction demande du « cinq neuf » pour l'option NFS autogérée. Quelle réponse honnête cette architecture permet-elle ?
R : Elle ne peut pas l'offrir : le serveur NFS est une VM zonale unique — la réparation automatique et les instantanés quotidiens réduisent le MTTR, mais la reprise prend tout de même plusieurs minutes, et une panne de zone met le partage hors service. Pour une disponibilité supérieure, on change d'architecture, pas de réglages : Filestore géré (ou, au-delà de cette plateforme, un niveau de fichiers régional/Enterprise). Savoir reconnaître quand un SLO impose un changement d'architecture est une matière centrale du PCA.
Au-delà des modules — Non démontrés : chaos engineering (injection de pannes), tests d'intrusion (la politique de Google autorise à tester vos propres ressources sans prévenir Google, dans le respect de l'Acceptable Use Policy), tests de charge à grande échelle, basculement multirégional avec gestion globale du trafic, et exploitation formelle des SLO/budgets d'erreur. Étudiez le chapitre « Implementing SLOs » du SRE workbook, et entraînez-vous à un test de charge (par exemple avec hey ou l'architecture de référence de test de charge distribué) contre un déploiement de test en observant la réaction du HPA.
⚠️ Piège d'examen — Un PDB ne protège que contre les interruptions volontaires (drainages, mises à niveau, consolidation par l'autoscaler). Les plantages de nœuds et les pannes de zone l'ignorent totalement — ils exigent un nombre de réplicas suffisant, une répartition topologique et une conception multizone/multirégionale. « Nous avions un PDB, pourquoi la panne de zone nous a-t-elle touchés ? » est exactement la confusion que l'examen cherche à déceler.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.