Guide de préparation à la certification PCA : Section 1 — Conception et planification d'une architecture de solution cloud (Designing and planning a cloud solution architecture) (~25 % de l'examen)
📚 Guide d'examen officiel : Professional Cloud Architect certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
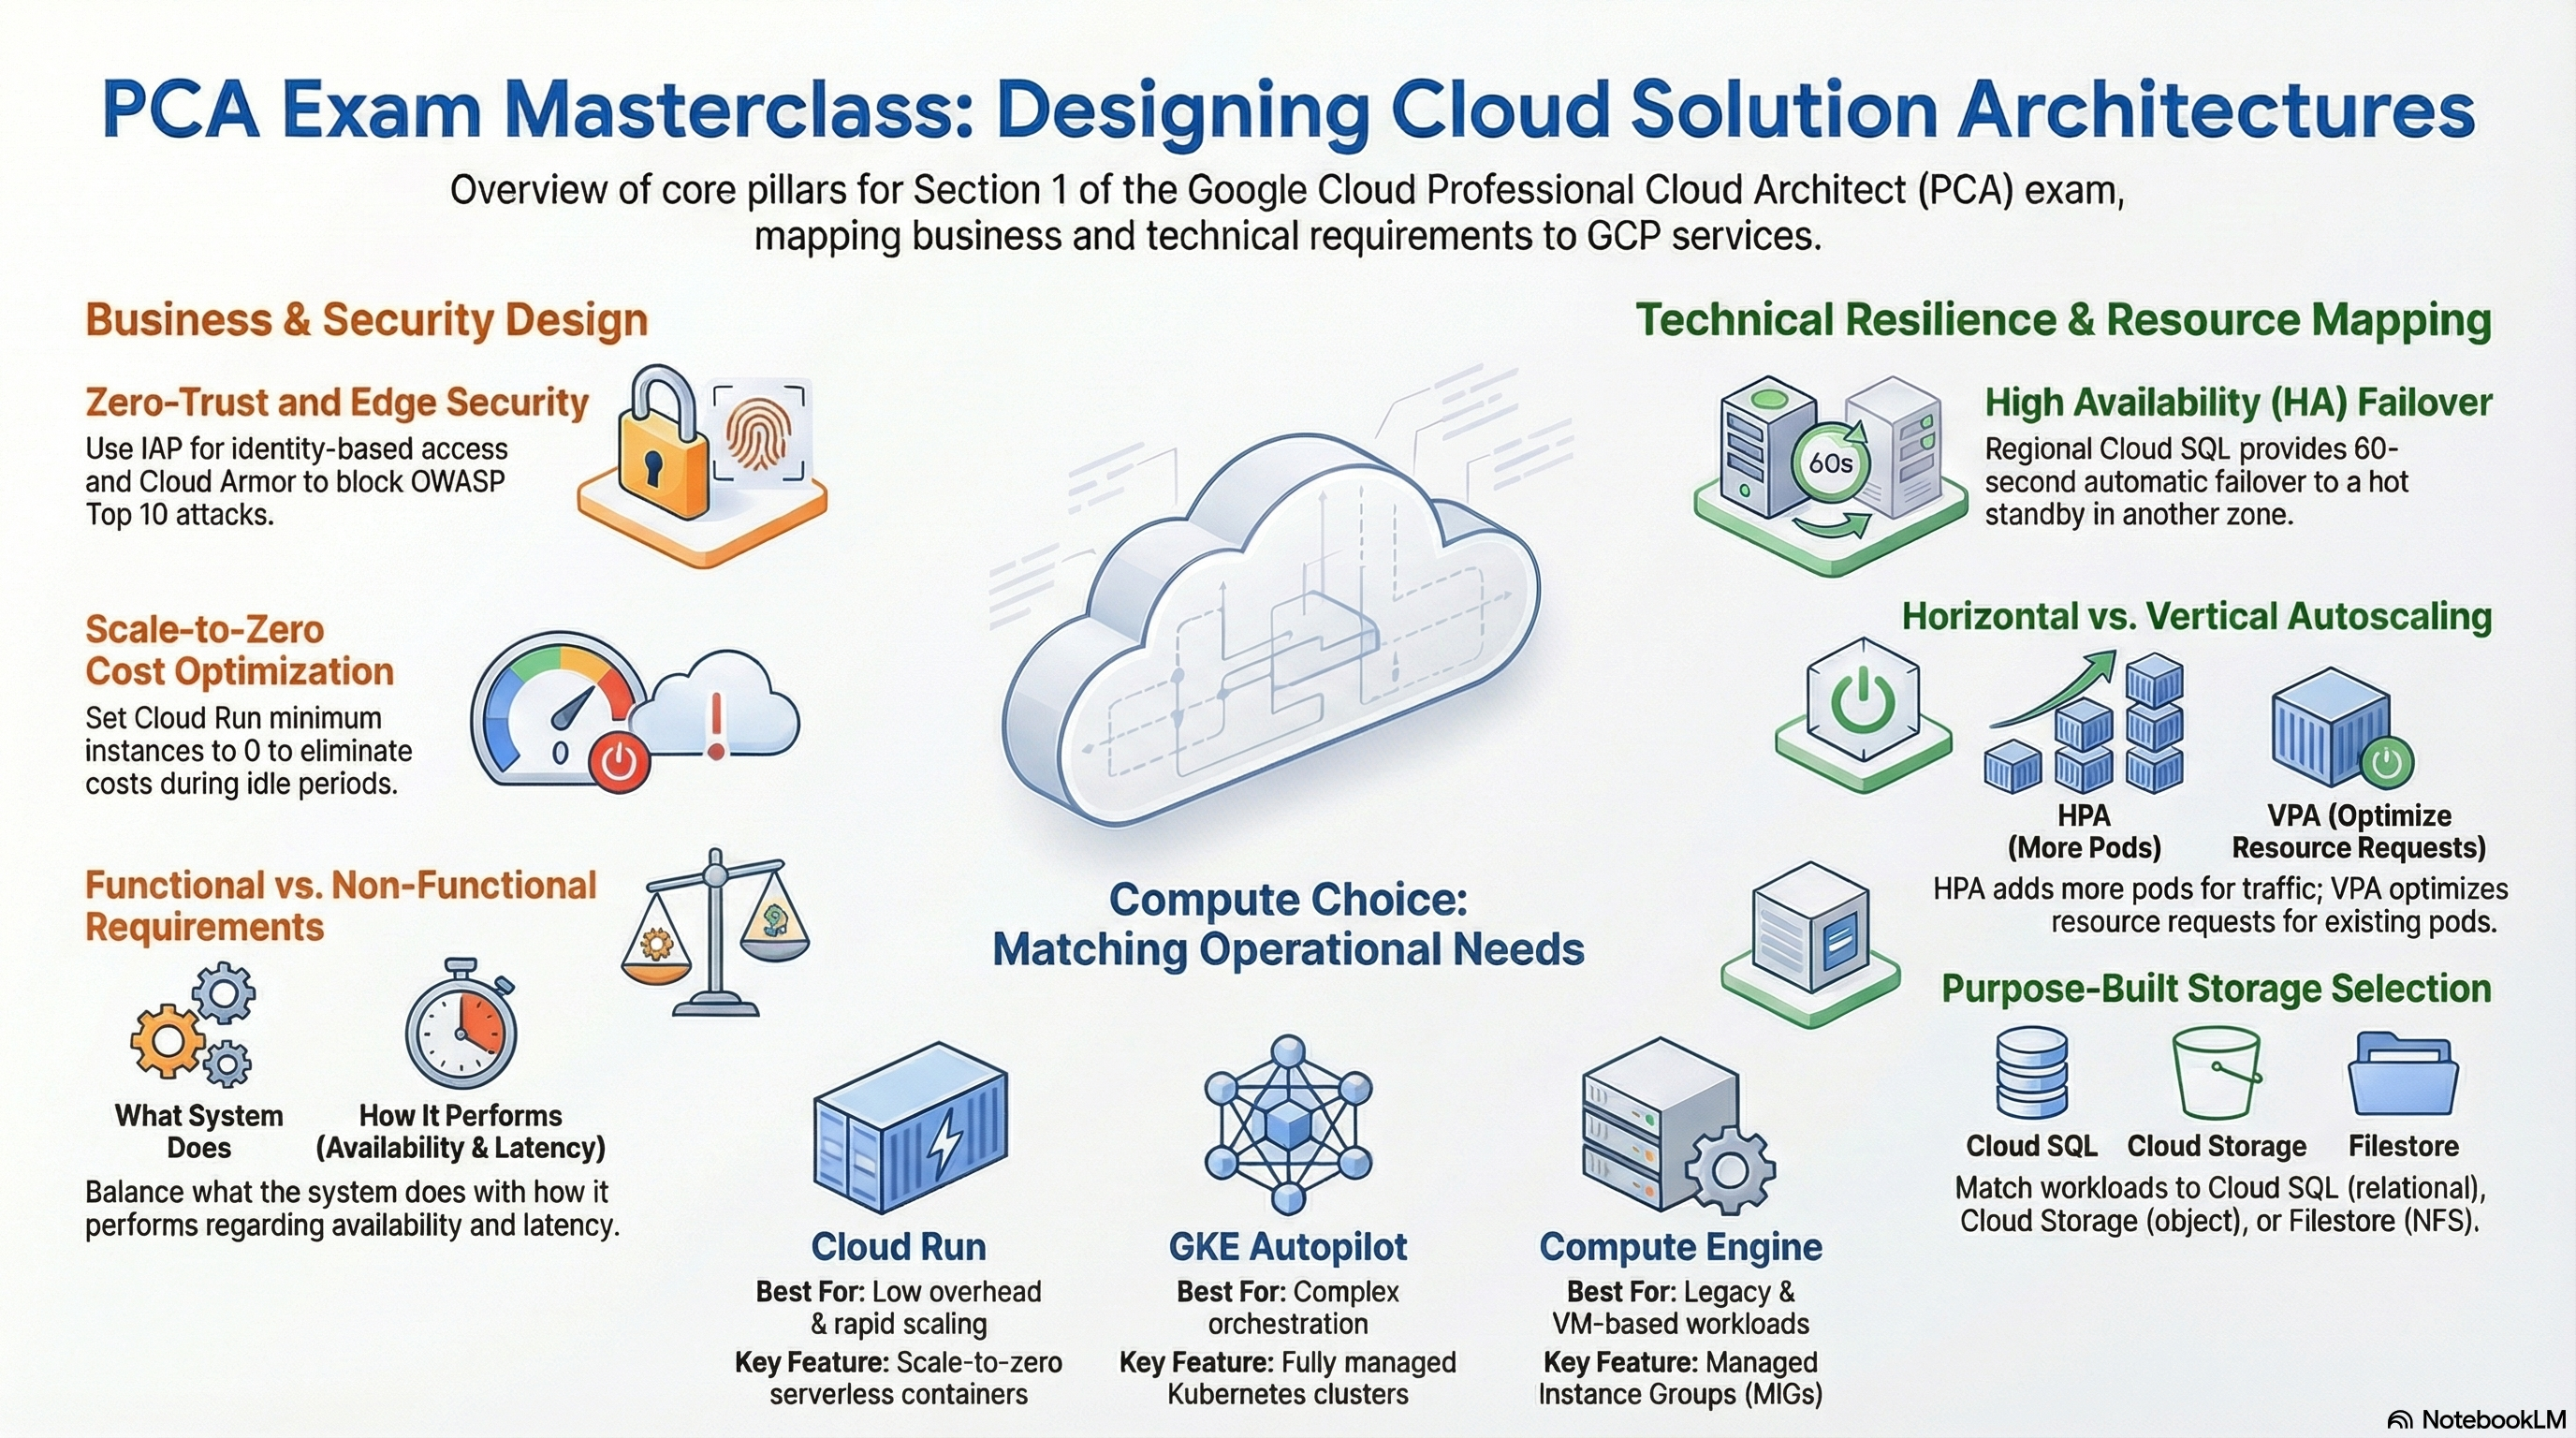
C'est la section du PCA la plus lourdement pondérée, et elle porte sur des choix : quelle plateforme de calcul, quel niveau de disponibilité, quel type de stockage — et pourquoi. Les quatre modules de fondation sont tous sollicités ici. Déployez d'abord le profil Socle allégé de la Carte des labs, puis appliquez les profils Niveau de données résilient et Architecture GKE lorsque vous atteignez les points 1.2 et 1.3, afin de comparer l'architecture économique et l'architecture résiliente dans le même projet.
1.1 Concevoir une infrastructure de solution cloud qui répond aux exigences métier (Designing a cloud solution infrastructure that meets business requirements)
⏱ ~60 min · 💰 faible — profil socle uniquement · ⚙️ Prérequis : profil Socle allégé
Pourquoi l'examen s'y intéresse — Les scénarios du PCA s'ouvrent sur des contraintes métier, pas techniques : « minimiser les coûts », « l'équipe sécurité exige un accès zero-trust », « la direction a besoin de visibilité sur les dépenses ». On évalue votre capacité à les traduire en décisions de plateforme — mise à l'échelle à zéro ou capacité maintenue au chaud, accès fondé sur l'identité ou sur le réseau, budgets et alertes comme garde-fous financiers — et à reconnaître quelle exigence pilote quel réglage.
Comment RAD le met en œuvre
| Exigence métier | Variable (valeur par défaut) | Module |
|---|---|---|
| Minimiser le coût au repos | min_instance_count (par défaut 0) — Cloud Run descend à zéro | App_CloudRun |
| Plafonner la dépense maximale de calcul | max_instance_count (par défaut 1) | App_CloudRun |
| Compromis de facturation du CPU | cpu_always_allocated (par défaut false — facturation à la requête) — définissez true pour garder le CPU alloué entre les requêtes pour un travail d'arrière-plan dans le processus | App_CloudRun |
| Garde-fous financiers | create_billing_budget (par défaut false), budget_amount (par défaut 100), budget_alert_thresholds (par défaut [0.5, 0.9, 1.0]) | Services_GCP |
| Accès zero-trust pour les applications internes | enable_iap (par défaut false) + iap_authorized_users / iap_authorized_groups | App_CloudRun |
| Visibilité pour les parties prenantes | support_users — deviennent des canaux de notification par e-mail Cloud Monitoring | App_CloudRun / App_GKE |
Des choix de plateforme ayant un impact sur les coûts se trouvent aussi dans Services_GCP : la base de données par défaut est une unique instance PostgreSQL 17 zonale db-custom-1-3840 (postgres_tier), et le système de fichiers partagé par défaut est une unique VM e2-small (create_network_filesystem, par défaut true) plutôt que Filestore géré — un choix par défaut délibéré qui privilégie le coût sur la résilience, et que vous inverserez au point 1.2.
À vous de jouer
- Déployez le profil Socle allégé. Dans Console > Cloud Run, ouvrez votre service et vérifiez « Min instances: 0 » dans les détails du service.
- Observez le nombre d'instances tomber à zéro après une période d'inactivité dans l'onglet Metrics du service, puis envoyez une requête et observez le démarrage à froid.
- Vérifiez les limites de mise à l'échelle depuis la CLI :
gcloud run services describe <service-name> \
  --region=us-central1 \
  --format="yaml(spec.template.scaling)"
- Définissez
create_billing_budget = truesur le déploiement Services_GCP et examinez Console > Billing > Budgets & alerts. - Vous savez que cela a fonctionné lorsque l'onglet Metrics montre le nombre d'instances atteignant zéro et qu'un budget avec des seuils à 50 %/90 %/100 % existe.
Testez-vous
Q1 : Une start-up exploite un outil d'administration interne utilisé quelques heures par jour et souhaite la facture la plus basse possible sans l'exposer à Internet. Quels deux paramètres de cette plateforme satisfont les deux exigences ?
R : min_instance_count = 0 (la mise à l'échelle à zéro élimine le coût de calcul au repos) et enable_iap = true avec une liste d'utilisateurs autorisés (accès zero-trust fondé sur l'identité au lieu d'un VPN ou d'une liste d'adresses IP autorisées). IAP authentifie chaque requête à la périphérie du réseau de Google avant qu'elle n'atteigne le service ; aucune infrastructure réseau permanente n'est donc nécessaire.
Q2 : La direction financière veut être avertie avant, et non après, l'épuisement du budget cloud mensuel. Que configurez-vous ?
R : Un budget de facturation avec plusieurs seuils d'alerte — ici, budget_alert_thresholds = [0.5, 0.9, 1.0] envoie une notification à 50 % et 90 % de budget_amount, avant le seuil de 100 %. Les budgets alertent mais n'arrêtent pas les dépenses ; associez-les à des plafonds max_instance_count si des limites strictes comptent.
Au-delà des modules — L'examen évalue aussi une analyse métier que les modules ne peuvent pas montrer : distinguer les exigences fonctionnelles des exigences non fonctionnelles, définir des KPI et des mesures de réussite (ROI, métriques), raisonner en CapEx ou OpEx, coût total de possession, planification de la continuité des activités, modèles d'intégration avec des systèmes externes, et décision de construire/acheter/modifier/abandonner une charge de travail. Étudiez le simulateur de coût Google Cloud, la documentation « Cloud Billing reports » et le pilier optimisation des coûts du Well-Architected Framework. Essayez gcloud billing accounts list et explorez Billing > Reports groupé par SKU dans un projet de test.
⚠️ Piège d'examen — Les budgets n'arrêtent jamais les dépenses ; ils se contentent de notifier. Si un scénario exige d'imposer une limite de dépenses, la réponse fait intervenir des quotas, des plafonds d'instances ou une automatisation programmatique réagissant au budget — pas le budget seul.
1.2 Concevoir une infrastructure de solution cloud qui répond aux exigences techniques (Designing a cloud solution infrastructure that meets technical requirements)
⏱ ~90 min · 💰 élevé — Cloud SQL REGIONAL double à peu près le coût de l'instance ; Redis HA et une instance dupliquée avec accès en lecture ajoutent davantage · ⚙️ Prérequis : profil Niveau de données résilient (+ profil Architecture GKE pour les étapes HPA/PDB)
Pourquoi l'examen s'y intéresse — Les exigences de haute disponibilité, d'évolutivité et de fiabilité (« disponibilité de 99,95 % », « survivre à la panne d'une zone », « absorber 10× le trafic du Black Friday ») correspondent chacune à un mécanisme précis, au coût précis. L'examen attend de vous que vous sachiez que passer Cloud SQL de zonal à régional apporte un basculement automatique entre zones, que les instances dupliquées avec accès en lecture apportent du débit en lecture mais pas la haute disponibilité, et que Redis au niveau BASIC n'offre aucune réplication.
Comment RAD le met en œuvre
| Exigence | Mécanisme | Variable (valeur par défaut) |
|---|---|---|
| La base de données survit à la panne d'une zone | Cloud SQL REGIONAL = instance de secours synchrone dans une seconde zone, basculement automatique | postgres_database_availability_type (par défaut ZONAL) |
| Montée en charge des lectures | Instances dupliquées avec accès en lecture — toujours ZONAL dans ce module | create_postgres_read_replica (par défaut false), postgres_read_replica_count (par défaut 1) |
| Récupération à un instant donné | PITR avec conservation des journaux de transactions pendant 7 jours, 7 sauvegardes quotidiennes conservées à partir de 04:00 UTC | toujours actif pour PostgreSQL |
| Le cache survit à la défaillance d'une instance | Memorystore STANDARD_HA = instance dupliquée + basculement automatique | redis_tier (par défaut BASIC) |
| Le cache survit à un redémarrage | Instantanés RDB ou AOF | redis_persistence_mode (par défaut DISABLED) |
| L'application suit le trafic (GKE) | HPA ciblant 70 % d'utilisation du CPU / 80 % de la mémoire — créé uniquement lorsque max_instance_count > 1 et enable_vertical_pod_autoscaling = false | min_instance_count (par défaut 1), max_instance_count (par défaut 3) dans App_GKE |
| Protection contre les interruptions volontaires | PodDisruptionBudget, omis lorsque max_instance_count = 1 | enable_pod_disruption_budget (par défaut true), pdb_min_available (par défaut "1") |
Un garde-fou qui mérite d'être étudié : la couche Redis de la plateforme comporte deux préconditions vérifiées au moment du plan — l'une bloque redis_tier = "BASIC" lorsque resource_labels.environment = "production", et une seconde bloque redis_persistence_mode = "DISABLED" sur une instance STANDARD_HA de production, de sorte que les caches de production doivent activer RDB ou AOF. C'est la leçon d'examen « le niveau BASIC n'est pas adapté à la production » — et « l'état mis en cache doit survivre au basculement » — encodée sous forme de validations.
À vous de jouer
- Appliquez le profil Niveau de données résilient. Dans Console > SQL, ouvrez l'instance — la vue d'ensemble affiche la haute disponibilité (régionale) et une option de basculement.
- Vérifiez depuis la CLI et trouvez la zone de secours :
gcloud sql instances describe <instance-name> \
  --format="value(settings.availabilityType, gceZone, secondaryGceZone)"
- Dans Console > Memorystore > Redis, vérifiez que le niveau de l'instance indique Standard.
- Sur le profil GKE, inspectez l'autoscaler :
kubectl get hpa -n <namespace> -o wide
- Vous savez que cela a fonctionné lorsque
availabilityTyperenvoieREGIONALavec unsecondaryGceZonerenseigné, et quekubectl get hpaaffiche des cibles d'utilisation de 70 % (CPU) et 80 % (mémoire).
Testez-vous
Q1 : La base de données d'un site e-commerce doit survivre à la panne d'une zone sans intervention manuelle, et les requêtes lourdes de l'équipe reporting ralentissent le paiement. Quelles deux modifications effectuez-vous ?
R : Passez l'instance en disponibilité REGIONAL (l'instance de secours synchrone et le basculement automatique gèrent la panne de zone) et ajoutez une instance dupliquée avec accès en lecture, vers laquelle vous dirigez la charge de reporting (cela décharge les lectures). Aucune ne remplace l'autre : la réplication vers une instance dupliquée avec accès en lecture est asynchrone et sans basculement automatique, et une instance de secours REGIONAL ne sert aucun trafic en lecture.
Q2 : Un cache de sessions sur Memorystore au niveau BASIC perd toutes ses données pendant une maintenance, ce qui casse les connexions des utilisateurs. Quel est le correctif le moins coûteux qui survit à la fois à la maintenance et à la défaillance d'une instance ?
R : Passez à STANDARD_HA, qui ajoute une instance dupliquée et un basculement automatique — exactement ce qu'impose le garde-fou de production du module. La persistance (RDB/AOF) protège en outre contre les redémarrages complets. Le niveau BASIC n'a pas d'instance dupliquée ; tout incident signifie donc un cache vide.
Q3 : Pourquoi le module omet-il de créer un PodDisruptionBudget lorsque max_instance_count = 1 ?
R : Un PDB avec minAvailable: 1 sur une charge de travail à réplica unique rendrait ce pod unique impossible à évincer, bloquant indéfiniment les drainages de nœuds et les mises à niveau GKE. Les PDB n'ont de sens que si des réplicas supplémentaires peuvent continuer à servir pendant une interruption volontaire — une validation d'App_GKE exige également que pdb_min_available soit inférieur à max_instance_count (les pourcentages en sont exemptés).
Au-delà des modules — Deux objectifs du point 1.2 n'ont pas d'équivalent dans les modules. (1) Le Google Cloud Well-Architected Framework — le guide actuel qualifie sa connaissance d'exigence clé ; lisez les six piliers (excellence opérationnelle, sécurité, fiabilité, optimisation des performances, optimisation des coûts, durabilité) et soyez capable de dire à quel pilier appartient la contrainte d'un scénario. (2) Gemini Cloud Assist — l'assistant d'IA de Google pour concevoir, exploiter, dépanner et optimiser les charges de travail Google Cloud ; sachez à quoi il sert pour le reconnaître parmi les réponses proposées, et essayez-le depuis le panneau Gemini de la console d'un projet de test.
⚠️ Piège d'examen — Sauvegardes ≠ PITR ≠ HA. Les sauvegardes restaurent à l'heure d'un instantané, la PITR rejoue les journaux de transactions jusqu'à n'importe quel instant de la période de conservation, et la HA REGIONAL évite la panne en premier lieu. Un scénario demandant de « restaurer la base de données à 14:32 hier » nécessite la PITR ; « aucune interruption lors de la panne d'une zone » nécessite REGIONAL ; aucune des deux ne résout le problème de l'autre.
1.3 Concevoir les ressources réseau, de stockage et de calcul (Designing network, storage, and compute resources)
⏱ ~90 min · 💰 modéré — le minimum de 1024 GB de Filestore et le cluster GKE sont les principaux postes · ⚙️ Prérequis : profil Architecture GKE, éventuellement
create_filestore_nfs = true
Pourquoi l'examen s'y intéresse — C'est la sous-section consacrée au choix des produits : organisation du VPC et modèles d'accès privé, stockage de fichiers, d'objets, en mode bloc ou relationnel, et le choix entre serverless et Kubernetes pour le calcul. L'examen récompense la connaissance des critères de décision — une sémantique POSIX exige un stockage de fichiers, un état persistant par pod exige un StatefulSet, la simplicité opérationnelle favorise Cloud Run.
Comment RAD le met en œuvre
Réseau : un VPC en mode personnalisé (les sous-réseaux ne sont pas créés automatiquement) avec un sous-réseau par entrée de availability_regions (par défaut ["us-central1"]), dimensionné par subnet_cidr_range (par défaut ["10.0.0.0/24"]) ; un Cloud Router et un Cloud NAT par région (couvrant tous les sous-réseaux et toutes les plages d'adresses IP), afin que les charges de travail privées disposent d'un accès Internet sortant uniquement ; et l'accès aux services privés (une plage d'adresses globale d'appairage de VPC plus une connexion de mise en réseau de services) qui achemine en privé le trafic Cloud SQL et Memorystore — l'instance PostgreSQL n'a pas d'adresse IP publique et n'accepte que des connexions SSL chiffrées. Les clusters GKE sont de type VPC natif (alias IP), avec des plages secondaires pour les pods et les services dérivées pour chaque cluster de gke_pod_base_cidr (par défaut 10.64.0.0/10) et gke_service_base_cidr (par défaut 10.8.0.0/16).
Stockage — l'ensemble de modules forme une matrice de choix du stockage :
| Besoin | Service | Variable (valeur par défaut) |
|---|---|---|
| Relationnel, transactionnel | Cloud SQL PostgreSQL/MySQL, AlloyDB | create_postgres (par défaut true), create_mysql (false), enable_alloydb (false) |
| Documents / NoSQL | Firestore (mode natif, édition Enterprise) | create_firestore (par défaut false) |
| Système de fichiers POSIX partagé, géré | Filestore (BASIC_HDD/BASIC_SSD/ENTERPRISE) | create_filestore_nfs (par défaut false), filestore_capacity_gb (par défaut 1024) |
| Système de fichiers POSIX partagé, économique | NFS autogéré sur un MIG e2-small avec un disque de données pd-ssd avec état, réparation automatique, instantanés quotidiens | create_network_filesystem (par défaut true), network_filesystem_capacity (par défaut 10 GB) |
| Stockage d'objets | Buckets GCS avec gestion des versions, règles de cycle de vie, CMEK | liste storage_buckets dans App_CloudRun / App_GKE |
| Cache en mémoire | Memorystore Redis | create_redis (par défaut false) |
| Stockage en mode bloc par pod | PVC de StatefulSet (GKE uniquement) | stateful_pvc_enabled, stateful_pvc_size |
La paire Filestore / VM NFS est un exemple d'école du compromis entre service géré et autogéré : Filestore coûte plus cher (1 TiB minimum sur les niveaux BASIC) mais supprime l'application des correctifs, la réparation et la gestion des instantanés ; la VM est économique, mais c'est une instance zonale unique dont la résilience repose uniquement sur la réparation automatique du MIG et les instantanés de disque quotidiens. La couche de découverte NFS de la plateforme privilégie Filestore lorsque les deux existent.
Calcul — le même câblage App_Common se déploie sur l'un ou l'autre moteur. Cloud Run : piloté par les requêtes, execution_environment par défaut gen2 (requis — et validé — pour les montages NFS et GCS Fuse), timeout_seconds par défaut 300, pas de volumes persistants par instance. GKE : workload_type (par défaut null) se résout automatiquement — stateful_pvc_enabled = true sélectionne un StatefulSet, sinon un Deployment ; définir workload_type = "Deployment" en même temps que stateful_pvc_enabled = true échoue au moment du plan, car les Deployments ne prennent pas en charge les modèles de demande de volume par réplica.
À vous de jouer
- Dans Console > VPC network > VPC networks, ouvrez le VPC de la plateforme ; notez le mode de sous-réseau personnalisé et les deux plages secondaires du sous-réseau GKE.
- Listez l'allocation d'accès aux services privés :
gcloud compute addresses list --global --filter="purpose=VPC_PEERING"
gcloud services vpc-peerings list --network=<vpc-network-name>
- Déployez App_GKE avec
stateful_pvc_enabled = true,stateful_pvc_size = "10Gi"et unstateful_pvc_mount_path; laissezworkload_typenon défini. Puis :
kubectl get statefulset,pvc -n <namespace>
- Définissez maintenant
workload_type = "Deployment"tout en conservantstateful_pvc_enabled = trueet exécutez un plan — lisez l'erreur de validation, puis revenez en arrière. - Vous savez que cela a fonctionné lorsqu'un StatefulSet avec un PVC lié existe, et que la configuration volontairement erronée a été rejetée au moment du plan, et non à l'exécution.
Testez-vous
Q1 : Un CMS historique a besoin d'un système de fichiers partagé accessible en écriture sur six réplicas, avec un SLA strict et aucune équipe d'exploitation pour surveiller un serveur de fichiers. Quelle option choisir ici, et pourquoi pas celle par défaut ?
R : Filestore (create_filestore_nfs = true) — un service géré, sans VM à corriger ni à réparer. La VM NFS autogérée par défaut est bien moins chère, mais c'est une e2-small zonale unique dont la reprise dépend de la réparation automatique du MIG et des instantanés quotidiens ; « aucune équipe d'exploitation + SLA strict » l'exclut.
Q2 : Pourquoi Cloud Run gen2 compte-t-il pour la prise en charge de NFS par cette plateforme ?
R : Les montages de volumes NFS et GCS Fuse nécessitent l'environnement d'exécution gen2 de Cloud Run (compatibilité complète avec le noyau Linux) ; gen1 ne les prend pas en charge. Le module l'encode sous forme de validation au moment du plan : enable_nfs = true avec execution_environment = "gen1" est rejeté avant tout déploiement.
Q3 : Une équipe doit exécuter un conteneur avec un volume persistant par réplica et des identités réseau stables. Cloud Run ou GKE, et quel type de charge de travail ?
R : GKE avec un StatefulSet — les PVC par réplica (volumeClaimTemplates) et les identités de pod stables sont des fonctionnalités des StatefulSets. Les instances Cloud Run sont éphémères et ne partagent rien ; ses options de volume (socket Cloud SQL, NFS, GCS Fuse) sont partagées, et non un stockage en mode bloc par instance.
Au-delà des modules — Non mis en œuvre ici : projets hôtes/de service de VPC partagé, appairage de réseaux VPC entre VPC, Private Service Connect, Cloud DNS, équilibreurs de charge internes, Spanner, Bigtable et BigQuery. Pour l'examen, sachez situer chacun : Spanner pour une échelle relationnelle à cohérence globale, Bigtable pour des séries temporelles orientées colonnes à haut débit, BigQuery pour l'analytique. Lisez « Choose a storage option » et « Compare Google Cloud database services » dans la documentation officielle.
Les points sur le calcul dépassent eux aussi les modules : les Cloud Run functions (code événementiel à usage unique — aucun module ne les déploie) et les choix Compute Engine tels que les Spot VMs (forte remise, préemptibles à tout moment — adaptées aux traitements par lots tolérants aux pannes) et les types de machines personnalisés (ratios vCPU/mémoire exacts). Les modules ne choisissent que parmi des types de machines prédéfinis (gke_node_machine_type pour les nœuds GKE Standard).
Le point solutions d'IA et de machine learning de Google Cloud (LLM et modèles Gemini, Agent Builder, Model Garden, AI Hypercomputer) est lui aussi 📘. L'élément le plus proche sur la plateforme est le module d'application DataAnalyst_CloudRun, qui appelle un modèle Gemini via Vertex AI (agent_model, par défaut gemini-2.5-flash ; vertex_region) en s'appuyant sur l'attribution roles/aiplatform.user de son compte de service Cloud Run plutôt que sur une clé d'API — un exemple de consommation d'un modèle géré, et non de conception d'une plateforme de ML. Étudiez quand appeler directement un modèle Gemini, quand construire un agent avec Agent Builder, quand déployer un modèle ouvert ou tiers depuis Model Garden, et quand une charge d'entraînement/de service nécessite AI Hypercomputer (GPU/TPU).
⚠️ Piège d'examen — « NoSQL » n'est pas une réponse unique. Firestore (le seul moteur NoSQL déployable ici) convient aux données documentaires avec synchronisation mobile/web ; Bigtable convient aux séries temporelles à l'échelle du pétaoctet ; Memorystore est un cache, pas un système de référence — surtout avec la persistance DISABLED, la valeur par défaut.
1.4 Élaborer un plan de migration (Creating a migration plan)
⏱ ~30 min de lecture + un court lab sur les jobs d'import · 💰 aucun coût supplémentaire · ⚙️ Prérequis : déploiement par défaut
Pourquoi l'examen s'y intéresse — Les scénarios de migration évaluent l'ordonnancement (évaluer → planifier → migrer → optimiser), le choix entre réhébergement, replateformage et refactorisation pour chaque charge de travail, et la mécanique du transfert de données : en ligne ou hors ligne, fenêtres d'interruption, ordre des dépendances.
Comment RAD le met en œuvre — Les modules de fondation déploient une infrastructure entièrement nouvelle ; il n'existe aucun outil de migration. La capacité voisine la plus proche est le chemin d'import de données dans App_CloudRun/App_GKE : enable_backup_import (par défaut false) avec backup_source (gcs ou gdrive), backup_file et backup_format exécute un job conteneurisé qui restaure un dump de base de données existant dans la nouvelle instance Cloud SQL — un exercice miniature de type « migrer les données, puis basculer ». Notez la contrainte réelle vérifiée au moment du plan : backup_format = "auto" est rejeté lorsque backup_source = "gdrive".
À vous de jouer
- Exportez un petit dump PostgreSQL depuis n'importe quel système existant et importez-le dans un bucket GCS.
- Redéployez avec
enable_backup_import = true,backup_source = "gcs"et le cheminbackup_file; suivez le job d'import dans Console > Cloud Run > Jobs. - Vérifiez l'activité sur l'instance cible :
gcloud sql operations list --instance=<instance-name> --limit=5
- Vous savez que cela a fonctionné lorsque l'exécution du job d'import réussit et que vos tables existent dans la base de données de l'application.
Testez-vous
Q1 : Une entreprise doit transférer une archive sur site de 400 TB vers GCS via une liaison à 100 Mbps en un mois. Quelle approche de transfert ?
R : Transfer Appliance (matériel hors ligne). À 100 Mbps, 400 TB prennent environ un an en ligne — bien au-delà de la fenêtre. Storage Transfer Service ou gcloud storage ne conviennent aux transferts en ligne que lorsque bande passante × durée couvre le volume.
Q2 : Dans une migration par phases, quelles charges de travail migrent en premier ?
R : Réhébergez (lift-and-shift) d'abord les charges de travail sans état et peu dépendantes pour obtenir des gains rapides ; refactorisez les applications stratégiques lorsque les bénéfices cloud-native justifient l'effort ; reportez les systèmes historiques fortement couplés jusqu'à ce que les dépendances soient cartographiées. L'examen récompense la démarche « évaluer et cartographier les dépendances avant de déplacer quoi que ce soit ».
Au-delà des modules — Étudiez Migration Center (découverte, évaluation et TCO), Migrate to Virtual Machines, Database Migration Service (réplication continue vers Cloud SQL avec une interruption minimale) et le choix entre Storage Transfer Service et Transfer Appliance. Revoyez aussi les prérequis réseau de la migration — HA VPN et Cloud Interconnect —, qu'aucun module ne provisionne. L'objectif couvre également les tests des charges de travail et la planification des dépendances pendant la migration, ainsi que la détermination des implications en matière de licences logicielles (licence apportée ou paiement à l'usage, nœuds à locataire unique pour les licences liées aux cœurs physiques) et de leur impact financier. Parcourez le flux de la console Migration Center dans un projet de test.
1.5 Anticiper les améliorations futures de la solution (Envisioning future solution improvements)
⏱ ~30 min de lecture · 💰 aucun coût supplémentaire · ⚙️ Prérequis : déploiement par défaut
Pourquoi l'examen s'y intéresse — Les architectes conçoivent en vue du changement : nouvelles régions, nouveaux régimes de conformité, remplacement de composants sans tout refaire. L'examen vérifie si votre conception comporte des points d'articulation — couches d'abstraction, couplage faible, définitions déclaratives — qui lui permettent d'évoluer.
Comment RAD le met en œuvre — Ce n'est pas une fonctionnalité déployable, mais le dépôt lui-même sert de démonstration. Deux modèles méritent d'être assimilés comme arguments prêts pour l'examen. D'abord, l'architecture de modules en couches (Platform → Foundation → Application) : remplacer Cloud Run par GKE ne modifie qu'une seule couche, car les deux moteurs de fondation consomment la même configuration partagée. Ensuite, le modèle découverte ou création en ligne : App_CloudRun et App_GKE recherchent les ressources gérées par Services_GCP (sous-réseaux portant la description managed-by=services-gcp, dépôts Artifact Registry dotés d'étiquettes) et ne provisionnent des équivalents en ligne qu'en l'absence de la couche de plateforme — require_services_gcp_module (par défaut true) pouvant imposer la présence de la plateforme. C'est « concevoir pour des topologies de déploiement évolutives » sous forme de code opérationnel.
À vous de jouer
- Notez que la plateforme découvre les sous-réseaux partagés grâce au filtre de description
managed-by=services-gcp. - Reproduisez la requête de découverte qu'exécute le module :
gcloud compute networks subnets list \
  --filter="description~managed-by=services-gcp" \
  --format="table(name,network,region,description)"
- Vous savez que cela a fonctionné lorsque les sous-réseaux créés par votre déploiement Services_GCP apparaissent — le même signal qu'un futur déploiement App_GKE utiliserait pour s'y rattacher.
Testez-vous
Q1 : Une équipe plateforme souhaite que les équipes applicatives déploient sur l'infrastructure partagée lorsqu'elle existe, mais se provisionnent elles-mêmes dans des bacs à sable isolés lorsqu'elle n'existe pas. Quel modèle d'architecture le permet ?
R : La découverte avec repli en ligne — rechercher au moment du plan les ressources partagées identifiées par des tags ou des étiquettes, et ne provisionner des équivalents locaux qu'en leur absence, exactement comme le fait App_CloudRun pour le VPC, SQL, NFS et Artifact Registry. Un indicateur de règle (require_services_gcp_module) transforme le repli en exigence stricte pour la production.
Au-delà des modules — Étudiez les mécanismes d'évolution que les modules ne montrent pas : découplage événementiel avec Pub/Sub et Eventarc, migration progressive hors des monolithes selon le modèle du figuier étrangleur (strangler fig), versionnage d'API derrière API Gateway/Apigee, et suivi des notes de version Google Cloud (« What's new ») comme apport continu à l'architecture. Le guide mentionne aussi une approche de conception cloud-first — privilégier par défaut des services gérés et cloud-native pour les nouveaux travaux plutôt que de recréer des schémas sur site — et l'examen de renouvellement ajoute l'accompagnement et la promotion (enablement and advocacy) (embarquer les équipes et les parties prenantes dans l'architecture).
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.