Guide de préparation à la certification PCA : Section 2 — Gestion et provisionnement d'une infrastructure de solution cloud (Managing and provisioning a cloud solution infrastructure) (~17,5 % de l'examen)
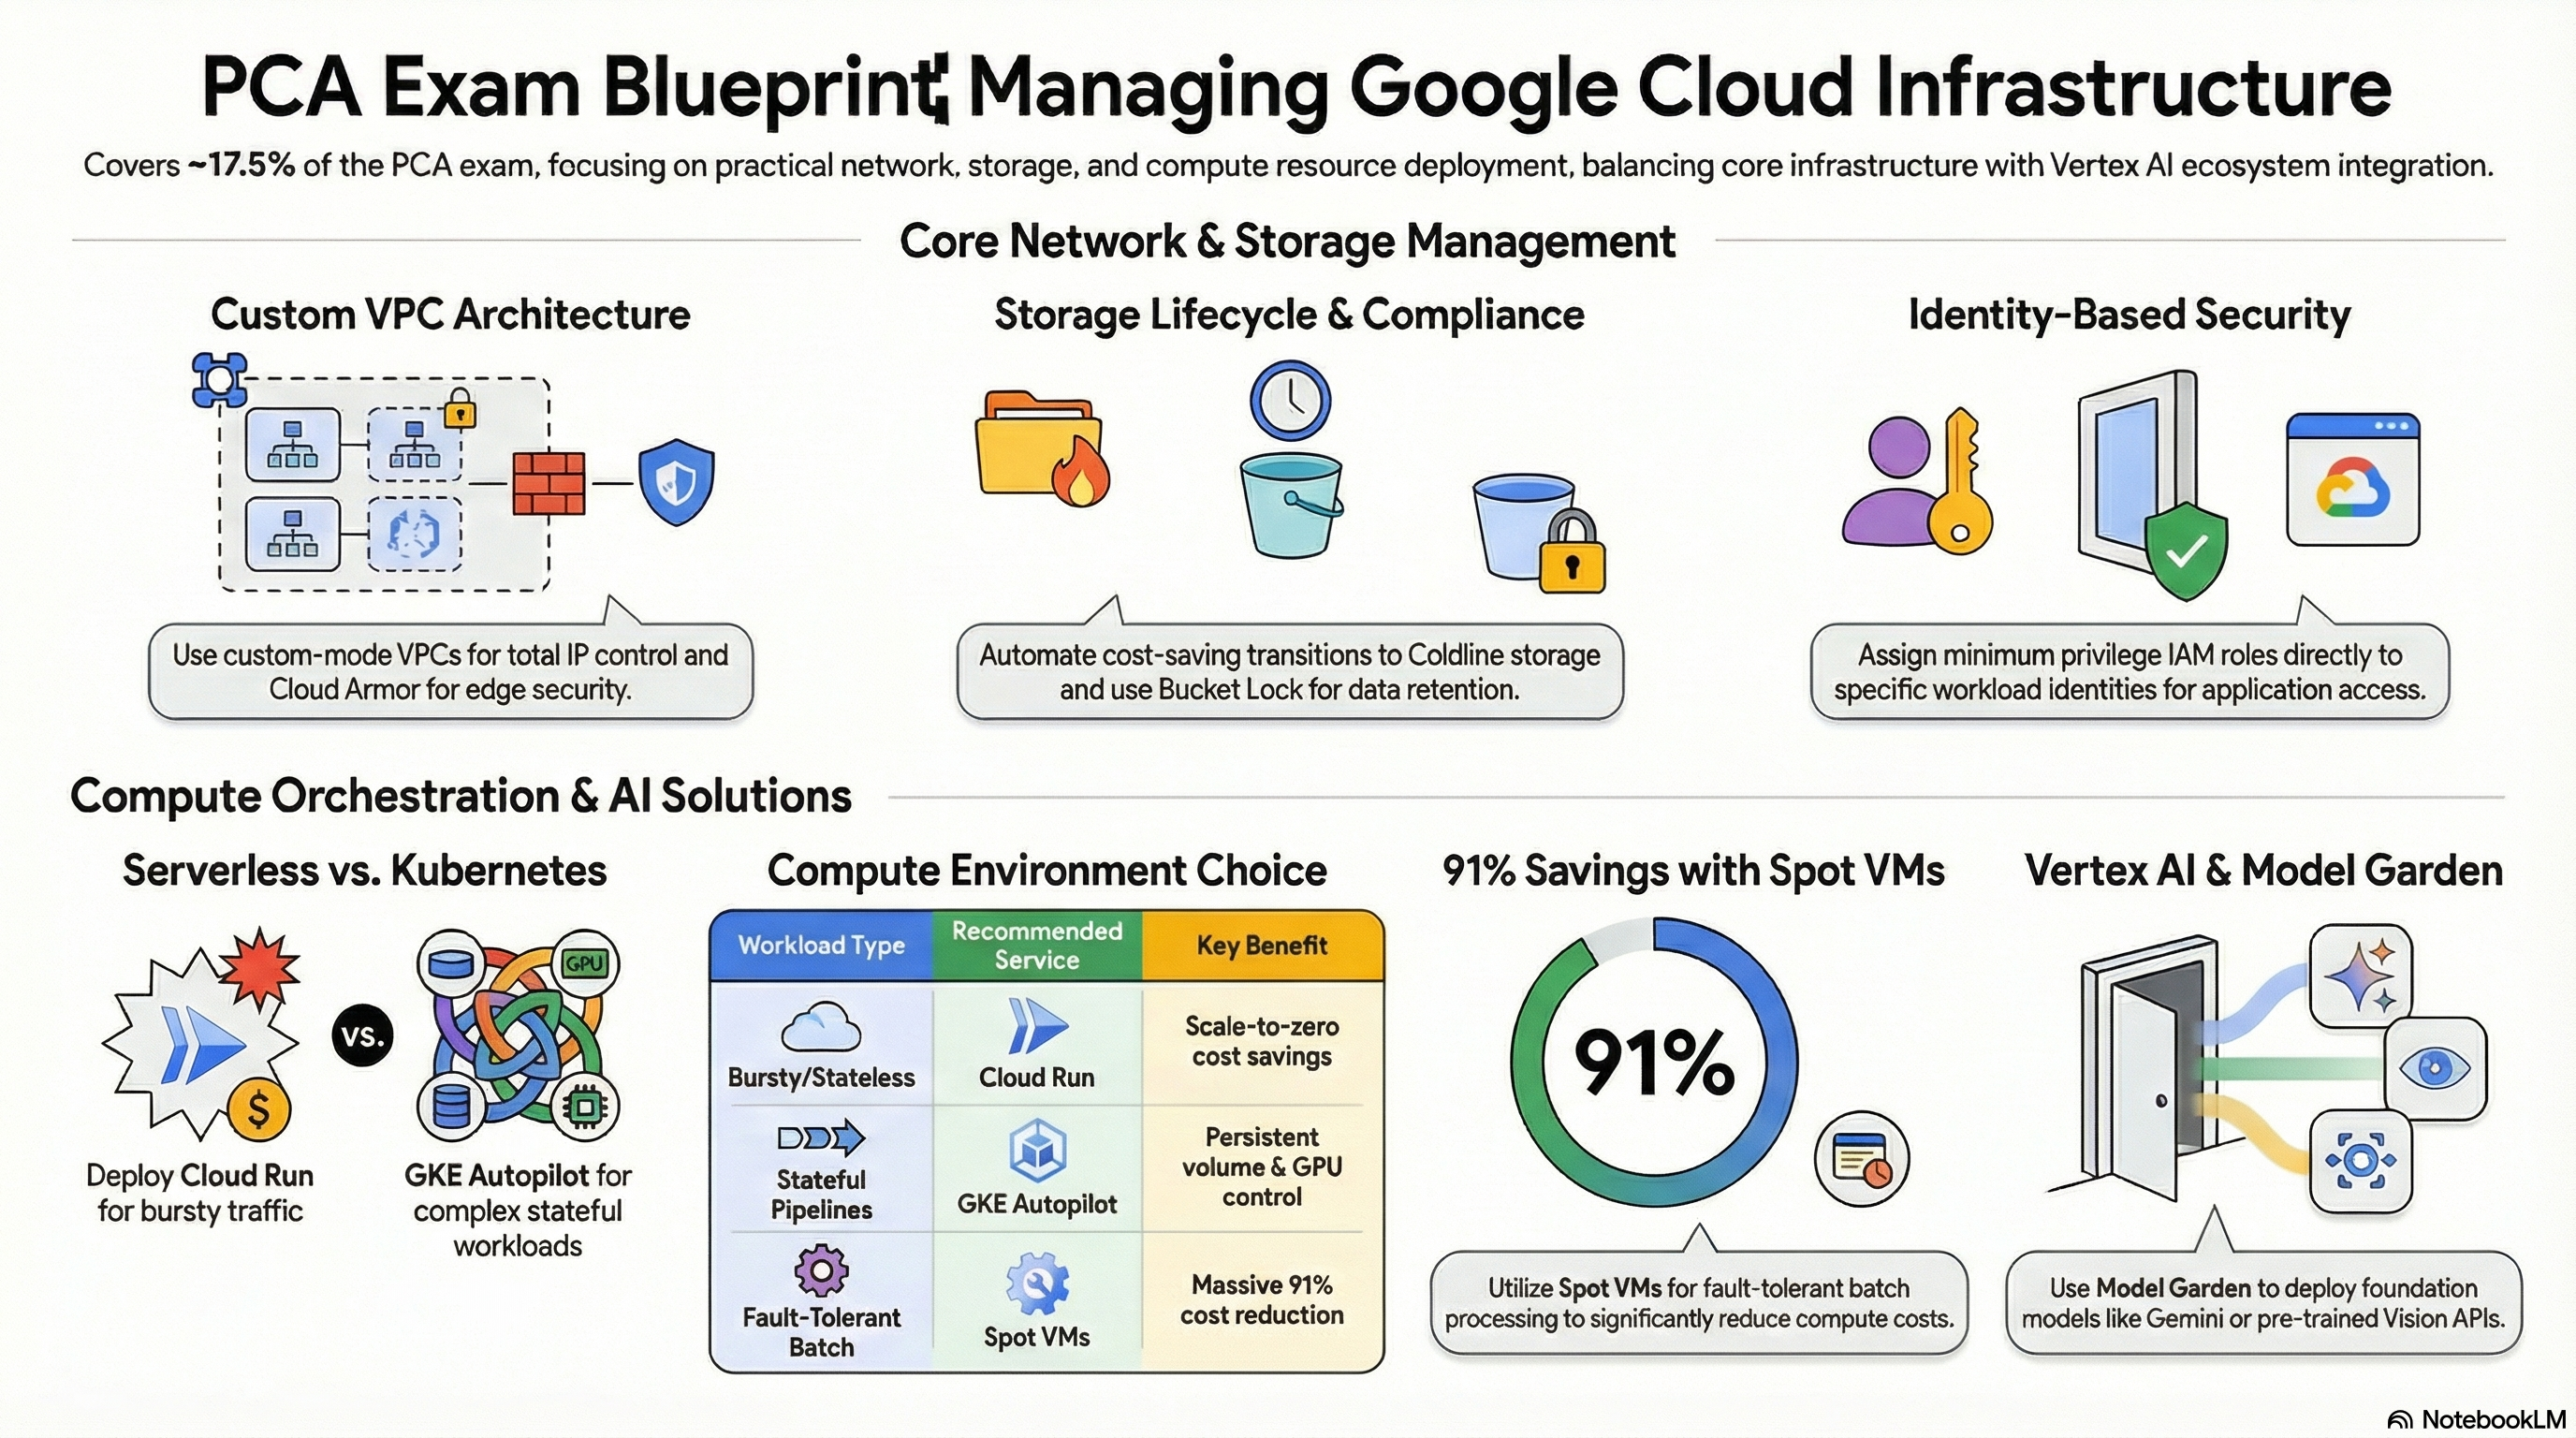
📚 Guide d'examen officiel : Professional Cloud Architect certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Cette section vérifie que vous savez réellement mettre une infrastructure en place — topologie réseau, configuration du stockage, provisionnement du calcul — et couvre les deux sous-sections Gemini Enterprise Agent Platform du guide d'examen actuel. Les modules sollicités sont Services_GCP (réseau, bases de données, GKE) et les deux moteurs de déploiement. Déployez le profil Socle allégé de la Carte des labs, puis activez GKE (profil Architecture GKE) avant le point 2.3. Les sous-sections 2.4 et 2.5 relèvent uniquement de l'étude.
2.1 Configurer les topologies réseau (Configuring network topologies)
⏱ ~45 min · 💰 faible — Cloud NAT et une adresse IP statique sont des coûts mineurs · ⚙️ Prérequis : déploiement Services_GCP par défaut
Pourquoi l'examen s'y intéresse — Les questions de topologie reposent sur le sens du trafic et la confiance : comment les charges de travail privées atteignent-elles Internet (NAT, sortie uniquement), comment les services gérés obtiennent-ils une connectivité privée (accès aux services privés), et comment le trafic est-ouest est-il restreint (règles de pare-feu, tags). L'examen étend ensuite ces notions aux conceptions hybrides et multi-VPC, que vous devez étudier séparément.
Comment RAD le met en œuvre — Voici comment la plateforme le met en œuvre :
| Élément de topologie | Mise en œuvre |
|---|---|
| VPC en mode personnalisé | un sous-réseau par région de availability_regions (par défaut ["us-central1"]), CIDR issus de subnet_cidr_range (par défaut ["10.0.0.0/24"]) |
| Accès Internet sortant uniquement | un Cloud Router et un Cloud NAT par région, couvrant tous les sous-réseaux et toutes les plages d'adresses IP |
| Accès privé aux services gérés | une adresse globale d'appairage de VPC plus une connexion de mise en réseau de services (utilisées par les adresses IP privées de Cloud SQL et Memorystore) |
| Entrée des vérifications d'état | règle de pare-feu fw-allow-lb-hc autorisant 130.211.0.0/22 et 35.191.0.0/16 |
| SSH d'administration sans adresse IP publique | règle de pare-feu fw-allow-iap-ssh autorisant 35.235.240.0/20 sur tcp:22 (plage du transfert TCP d'IAP) |
| Segmentation par tags | les tags nfsserver/redisserver ouvrent tcp 111/2049/6379 + udp 2049 uniquement vers les VM taguées ; httpserver/webserver ouvrent 80/443/8080/8443 |
Côté application, App_CloudRun utilise la sortie VPC directe (Direct VPC egress) (une interface réseau sur le sous-réseau — pas de connecteur d'accès au VPC sans serveur), avec vpc_egress_setting (par défaut PRIVATE_RANGES_ONLY, ou ALL_TRAFFIC pour forcer tout le trafic à passer par le VPC et le NAT). App_GKE peut ajouter des NetworkPolicies Kubernetes via enable_network_segmentation (par défaut false) — traité dans la section 3.
À vous de jouer
- Dans Console > VPC network > VPC networks, ouvrez le VPC de la plateforme et examinez les sous-réseaux ; puis Console > Network services > Cloud NAT pour la passerelle NAT.
- Listez les règles de pare-feu et associez chacune à une décision de confiance :
gcloud compute firewall-rules list \
  --filter="network=<vpc-network-name>" \
  --format="table(name,direction,sourceRanges.list(),allowed[].map().firewall_rule().list(),targetTags.list())"
- Dans Console > Cloud Run, ouvrez l'onglet Networking de votre service et vérifiez le paramètre de sortie VPC.
- Vous savez que cela a fonctionné lorsque vous pouvez expliquer la plage source de chaque règle — vérifications d'état des équilibreurs de charge Google, plage IAP ou trafic interne au VPC — et que l'instance Cloud SQL n'affiche qu'une adresse IP privée.
Testez-vous
Q1 : Des VM d'un sous-réseau privé doivent télécharger des paquets du système d'exploitation, mais ne doivent jamais accepter de connexions entrantes depuis Internet. Quel composant, et pourquoi pas des adresses IP externes ?
R : Cloud NAT — il assure la traduction d'adresse source pour le trafic sortant sans chemin entrant, et supprime la surface d'attaque d'une adresse IP externe par VM. Des adresses IP externes fonctionneraient pour le trafic sortant, mais exposeraient chaque VM aux analyses entrantes et enfreindraient l'exigence.
Q2 : Pourquoi Cloud SQL a-t-il besoin d'une plage d'appairage « private services access » (accès aux services privés) au lieu de simplement résider dans votre sous-réseau ?
R : Les instances Cloud SQL s'exécutent dans un VPC producteur géré par Google, pas dans le vôtre. L'accès aux services privés alloue une plage d'adresses IP de votre VPC et l'appaire au réseau producteur ; l'instance obtient ainsi une adresse RFC-1918 joignable depuis vos sous-réseaux — c'est pourquoi ce module peut désactiver entièrement l'adresse IP publique et tenir la base de données à l'écart de l'Internet public.
Q3 : Un auditeur demande comment les administrateurs se connectent en SSH à la VM NFS sans adresse IP publique ni VPN. Quelle est la réponse dans cette topologie ?
R : Le transfert TCP d'IAP — la règle fw-allow-iap-ssh n'admet tcp:22 que depuis la plage IAP de Google 35.235.240.0/20, et les administrateurs utilisent gcloud compute ssh --tunnel-through-iap. L'identité est vérifiée par IAP avant qu'un seul paquet n'atteigne la VM.
Au-delà des modules — Non mis en œuvre : VPC partagé, appairage entre VPC clients, Cloud VPN / Cloud Interconnect (hybride), Cross-Cloud Interconnect (multicloud), Network Connectivity Center, Cloud DNS, journaux de flux VPC, stratégies de pare-feu hiérarchiques et protection contre les intrusions (Cloud NGFW Enterprise / Cloud IDS). Ces sujets sont très présents à l'examen — étudiez « Choosing a Network Connectivity product » (l'arbre de décision Dedicated Interconnect, Partner Interconnect ou HA VPN ; un SLA de 99,99 % exige HA VPN ou des rattachements Interconnect redondants), ainsi que l'IAM des projets hôtes/de service de VPC partagé. Dans un projet de test, essayez gcloud compute networks subnets update <subnet> --enable-flow-logs.
⚠️ Piège d'examen — L'accès privé à Google (Private Google Access), l'accès aux services privés (private services access) et Private Service Connect sont trois choses différentes. Ce module utilise l'accès aux services privés (appairage de VPC avec les producteurs de services gérés). Ne choisissez pas des points de terminaison PSC lorsque le scénario décrit l'adresse IP privée de Cloud SQL via une plage d'appairage allouée.
2.2 Configurer les systèmes de stockage individuels (Configuring individual storage systems)
⏱ ~60 min · 💰 faible à modéré — le stockage en bucket est peu coûteux ; Filestore ajoute un minimum d'environ 1 TiB s'il est activé · ⚙️ Prérequis : App_CloudRun avec
create_cloud_storage = trueet une entréestorage_buckets
Pourquoi l'examen s'y intéresse — Les questions de configuration du stockage portent sur la mécanique de la durabilité et des coûts : transitions de cycle de vie entre classes de stockage, gestion des versions d'objets ou sauvegardes, conservation à des fins de conformité, et paramètres de sauvegarde/PITR des bases de données. Vous devez savoir configurer chacun d'eux et prévoir son comportement en matière de coûts.
Comment RAD le met en œuvre
Stockage d'objets — la liste storage_buckets (disponible sur App_CloudRun comme sur App_GKE) provisionne des buckets GCS via la couche de stockage d'objets de la plateforme. Chaque entrée prend en charge storage_class (par défaut "STANDARD"), versioning_enabled (par défaut false), lifecycle_rules (âge, nombre de versions plus récentes, transitions de classe de stockage), CORS, public_access_prevention (par défaut "enforced") et uniform_bucket_level_access. La plateforme définit également une règle de suppression réversible (soft delete) à conservation nulle afin que les destructions ne soient pas bloquées, vide les buckets au moment de la destruction, et applique au bucket de sauvegarde une règle de suppression de cycle de vie pilotée par backup_retention_days (par défaut 7).
Protection des bases de données — PostgreSQL bénéficie de 7 sauvegardes automatiques quotidiennes conservées (04:00 UTC) plus la PITR avec 7 jours de conservation des journaux ; les disques sont en PD_SSD avec redimensionnement automatique. Les dumps au niveau applicatif sont distincts : un job Cloud Scheduler (backup_schedule, par défaut "0 2 * * *") déclenche un job d'export conteneurisé qui écrit les dumps dans le bucket de sauvegarde.
Stockage de fichiers — Filestore (create_filestore_nfs, filestore_tier par défaut BASIC_HDD, nom de partage share, no-root-squash) ou la VM NFS autogérée avec des instantanés pd-ssd quotidiens et 7 jours de conservation des instantanés.
À vous de jouer
- Déployez avec une entrée de bucket telle que
{ name_suffix = "media", versioning_enabled = true, lifecycle_rules = [...] }, incluant une transition versNEARLINEaprès 30 jours. - Dans Console > Cloud Storage > Buckets, ouvrez l'onglet Lifecycle du bucket et vérifiez la règle ; consultez Protection pour la gestion des versions et la prévention de l'accès public.
- Vérifiez depuis la CLI :
gcloud storage buckets describe gs://<bucket-name> \
  --format="yaml(lifecycle,versioning,publicAccessPrevention)"
- Dans Console > Cloud Scheduler, trouvez la planification de sauvegarde ; déclenchez-la manuellement (« Force run ») et suivez le job d'export dans Cloud Run > Jobs, puis vérifiez que le fichier de dump est arrivé dans le bucket de sauvegarde.
- Vous savez que cela a fonctionné lorsque la règle de cycle de vie apparaît dans la sortie de describe et qu'un nouvel objet de dump existe après l'exécution forcée.
Testez-vous
Q1 : La conformité impose de conserver les documents téléversés pendant 90 jours dans un stockage rapide, puis 7 ans dans un stockage économique, puis de les supprimer — sans modifier l'application. Comment ?
R : Object Lifecycle Management sur le bucket : une transition SetStorageClass (par exemple vers COLDLINE/ARCHIVE) à l'âge de 90 jours et une action Delete à environ 2 645 jours. Les règles de cycle de vie s'exécutent côté serveur ; l'application ne change donc jamais. Si les régulateurs exigent l'immuabilité, ajoutez une règle de conservation avec Bucket Lock — le cycle de vie seul n'empêche pas la suppression.
Q2 : L'équipe active la gestion des versions d'objets « en guise de sauvegarde », mais la facture du bucket triple en un mois. Que s'est-il passé et comment y remédier ?
R : Chaque écrasement/suppression conserve une version non actuelle facturée au tarif de stockage plein. Ajoutez des règles de cycle de vie fondées sur num_newer_versions (ou sur l'âge non actuel) pour élaguer les anciennes versions — exactement ce qu'exprime lifecycle_rules dans l'entrée storage_buckets. La gestion des versions protège contre la suppression accidentelle ; ce n'est pas une sauvegarde gérée avec conservation intégrée.
⚠️ Piège d'examen — Le job planifié de dump SQL et les sauvegardes automatiques de Cloud SQL sont des couches différentes : les sauvegardes automatiques + la PITR restaurent l'instance ; les dumps dans GCS sont portables, survivent à la suppression de l'instance et peuvent amorcer des migrations. Un scénario de type « restaurer après la suppression de l'instance » nécessite l'export, pas la PITR.
2.3 Configurer les systèmes de calcul (Configuring compute systems)
⏱ ~75 min · 💰 modéré — les frais du cluster GKE et les ressources des nœuds/pods dominent · ⚙️ Prérequis : profil Architecture GKE ; essayez
gke_cluster_mode = "STANDARD"dans un projet de test si le budget le permet
Pourquoi l'examen s'y intéresse — Les questions de provisionnement évaluent la surface de configuration de chaque plateforme de calcul : GKE Autopilot ou Standard (qui gère les nœuds, comment fonctionne la facturation), dimensionnement des machines/ressources, profils d'autoscaling et paramètres d'exécution serverless. L'examen affectionne les questions « quel mode/paramètre réduit la charge d'exploitation, et lequel donne le contrôle ».
Comment RAD le met en œuvre
GKE : create_google_kubernetes_engine (par défaut false) provisionne de 1 à 10 clusters (gke_cluster_count, par défaut 1). gke_cluster_mode (par défaut "AUTOPILOT") est le compromis principal : Autopilot est entièrement géré, facturé par pod, avec provisionnement automatique des nœuds ; "STANDARD" supprime le pool par défaut et crée un pool de nœuds explicite avec gke_node_machine_type (par défaut e2-standard-4), un autoscaling de gke_node_min_count (par défaut 1) à gke_node_max_count (par défaut 5), gke_node_disk_type (par défaut pd-balanced) et des nœuds protégés (Shielded nodes : démarrage sécurisé + surveillance de l'intégrité). Les deux modes ont en commun : Dataplane V2, l'allocation d'adresses IP VPC native, le canal standard de la Gateway API, l'autoscaling vertical des pods, Managed Service for Prometheus, le canal de publication REGULAR (fixe), la répartition des coûts et gke_autoscaling_profile (par défaut BALANCED, ou OPTIMIZE_UTILIZATION pour une réduction agressive). Notez que ces clusters UTILISENT bien private_cluster_config { enable_private_nodes = true } (les nœuds n'ont pas d'adresse IP externe — obligatoire, car les projets gérés par RAD interdisent compute.vmExternalIpAccess) avec un master_ipv4_cidr_block dédié issu de gke_master_base_cidr ; seul enable_private_endpoint reste à false, de sorte que le plan de contrôle reste joignable sur son point de terminaison public pour la CI/CD.
Cloud Run : container_resources (valeurs par défaut cpu_limit = "1000m", memory_limit = "512Mi"), accélération du processeur au démarrage toujours active, execution_environment (par défaut gen2), timeout_seconds (par défaut 300), affinité de session activée, et vérifications de démarrage/d'activité via startup_probe_config / health_check_config.
Provisionnement des charges de travail sur GKE : la même forme container_resources, un sidecar Cloud SQL Auth Proxy injecté lorsque enable_cloudsql_volume = true (par défaut) et qu'une base de données existe, et des CronJobs via la liste cron_jobs.
À vous de jouer
- Dans Console > Kubernetes Engine > Clusters, ouvrez le cluster — notez « Mode: Autopilot », le canal de publication et la liste des fonctionnalités activées.
- Comparez via la CLI :
gcloud container clusters describe <cluster-name> \
  --location=us-central1 \
  --format="value(autopilot.enabled, releaseChannel.channel, autoscaling.autoscalingProfile)"
- Remplacez
gke_autoscaling_profileparOPTIMIZE_UTILIZATIONdans le portail et appliquez à nouveau ; relancez describe pour constater le changement de profil. - Sur Cloud Run, augmentez
container_resources.memory_limità1Giet observez le déploiement d'une nouvelle révision dans Console > Cloud Run > Revisions. - Vous savez que cela a fonctionné lorsque la sortie de describe reflète chaque modification du portail sans que vous ayez touché à un nœud, une VM ou un fichier YAML.
Testez-vous
Q1 : Une équipe sans expérience de l'exploitation de Kubernetes a besoin de GKE pour son écosystème d'API, mais ne doit gérer ni les nœuds, ni les mises à niveau, ni le placement des charges. Quel mode, et pourquoi ?
R : Autopilot (gke_cluster_mode = "AUTOPILOT", la valeur par défaut ici). Google gère les nœuds, les réparations et les mises à niveau ; la facturation se fait par demande de ressources des pods, si bien que le bon dimensionnement des demandes est la seule tâche de capacité restante. Le mode Standard s'adresse aux charges de travail qui ont besoin de types de machines spécifiques, de GPU/SSD locaux ou d'un contrôle de la planification — la description de la variable du module cite elle-même les charges gRPC sensibles à la latence comme cas d'usage du mode Standard.
Q2 : Sur Autopilot, quel est le levier de coût équivalent à « choisir un type de machine plus petit » en mode Standard ?
R : Les demandes de ressources des pods (container_resources) — Autopilot facture ce que les pods demandent, pas les nœuds. Le CPU/la mémoire surdemandés sont du pur gaspillage ; le VPA (activé au niveau du cluster, et exposé par charge de travail via enable_vertical_pod_autoscaling dans App_GKE) ajuste les demandes en fonction de l'utilisation observée. gke_autoscaling_profile = "OPTIMIZE_UTILIZATION" resserre en outre la réduction d'échelle.
Q3 : Quand accepteriez-vous la charge d'exploitation supplémentaire du mode Standard sur cette plateforme ?
R : Lorsque les charges de travail ont besoin d'un contrôle explicite des nœuds : une série de machines précise (gke_node_machine_type), des types de disques ou un comportement de planification qu'Autopilot restreint. Le module provisionne alors un unique pool de nœuds explicite avec un autoscaling de 1 à 5 nœuds et les protections des VM protégées (Shielded VM) — une charge d'exploitation échangée contre le contrôle du matériel.
Au-delà des modules — Non provisionnés ici : modèles d'instances Compute Engine et groupes d'instances gérés pour les niveaux applicatifs, provisionnement Spot ou standard (le point « compute volatility » — les Spot VMs et les pods Spot échangent la préemption contre le prix), Google Cloud VMware Engine et sa mise en réseau, et gestion des correctifs à l'échelle d'un parc (VM Manager / gestion des correctifs de l'OS). La VM NFS est la seule charge de travail Compute Engine créée par les modules. Étudiez la documentation des Spot VMs et créez une Spot VM avec gcloud compute instances create ... --provisioning-model=SPOT dans un projet de test.
⚠️ Piège d'examen — Autopilot ≠ « pas de planification de capacité ». Vous définissez toujours des demandes/limites, et les calculs HPA/quotas s'appliquent toujours — les valeurs de type quota_memory_requests d'App_GKE doivent utiliser des suffixes binaires ("4Gi"), car un "4" nu est interprété par Kubernetes comme 4 octets et bloque toute planification.
2.4 Exploiter Gemini Enterprise Agent Platform pour des workflows de ML de bout en bout (Leveraging Gemini Enterprise Agent Platform for end-to-end ML workflows)
⏱ ~étude uniquement · 💰 aucun coût de plateforme · ⚙️ Prérequis : rien de déployable
Pourquoi l'examen s'y intéresse — Le guide PCA actuel évalue l'architecture des workflows de ML sur Gemini Enterprise Agent Platform : utiliser Agent Platform Pipelines pour automatiser et orchestrer le cycle de vie du ML, préparer les données pour leur intégration à la plateforme, et utiliser AI Hypercomputer — intégrer des GPU et des TPU pour l'entraînement et le service des modèles, choisir parmi les modèles de consommation et mener des entraînements à grande échelle.
Comment RAD le met en œuvre — Non mis en œuvre par les modules de fondation. Le rapprochement le plus proche est architectural : un modèle entraîné servi sous forme de conteneur se déploierait sur ces modules comme n'importe quelle autre charge de travail (Cloud Run pour une inférence irrégulière nécessitant peu d'exploitation, GKE pour un service à haut débit) — mais ni App_CloudRun ni App_GKE n'exposent de paramètres GPU ou TPU.
Au-delà des modules — Étudiez Agent Platform Pipelines (des définitions de pipelines orchestrant la préparation des données, l'entraînement, l'évaluation et le déploiement), la manière dont les données d'entraînement sont intégrées (BigQuery et Cloud Storage comme sources, gestion des caractéristiques pour garder l'entraînement et le service cohérents) et AI Hypercomputer : choix entre GPU et TPU, et modèles de consommation tels que la demande, Spot et les réservations pour l'entraînement à grande échelle. L'exemple du guide d'examen associe également AI Hypercomputer à Cloud Run functions et à Agent Platform pour les charges de ML/IA. Les noms de produits de ce domaine ont changé récemment (les fonctionnalités de Vertex AI apparaissent désormais sous Gemini Enterprise Agent Platform) ; lisez donc la documentation produit actuelle plutôt que d'anciens supports d'étude.
Testez-vous
Q1 : Un modèle donne de bons résultats hors ligne mais se dégrade en production ; l'enquête montre que les caractéristiques sont calculées différemment au moment du service. Quel est le problème, et quelle est la correction architecturale ?
R : Un décalage entre entraînement et service (training-serving skew). Centralisez les définitions des caractéristiques afin que les mêmes valeurs calculées alimentent à la fois l'entraînement (par lots) et la prédiction (en ligne) — un feature store géré, ou une étape de pipeline partagée unique — au lieu de dupliquer la logique des caractéristiques dans le chemin de service.
Q2 : Une équipe de recherche a besoin de plusieurs semaines de capacité TPU pour un grand entraînement qui ne doit pas être interrompu. Quel modèle de consommation convient, et lequel ne convient pas ?
R : La capacité réservée (une réservation ou une capacité engagée) — elle garantit les accélérateurs pour toute la durée de l'entraînement. La capacité Spot est bien moins chère, mais peut être récupérée à tout moment, ce qui convient aux jobs tolérants aux pannes et dotés de points de contrôle, pas à un entraînement qui ne doit pas être interrompu.
2.5 Configurer des solutions ou des API prédéfinies avec Agent Platform (Configuring prebuilt solutions or APIs with Agent Platform)
⏱ ~étude uniquement + lab de 20 min sur la gestion des secrets · 💰 aucun coût de plateforme · ⚙️ Prérequis : déploiement App_CloudRun par défaut
Pourquoi l'examen s'y intéresse — Vous devez distinguer les API d'IA de Google (Search, Conversation, Vision, Image, Video et Audio) et choisir la bonne pour chaque cas d'usage plutôt que d'entraîner un modèle personnalisé, intégrer les fonctionnalités de Gemini Enterprise (agents d'IA et NotebookLM) dans les processus métier, et intégrer des modèles de Model Garden dans une solution — de manière sécurisée.
Comment RAD le met en œuvre — Les API d'IA elles-mêmes ne sont pas provisionnées, mais le modèle d'intégration sécurisée est entièrement démontré : secret_environment_variables injecte des identifiants dans Cloud Run via des références Secret Manager (jamais des variables d'environnement en clair), et App_GKE matérialise les secrets via le module complémentaire CSI Secret Manager de GKE (SecretProviderClass + synchronisation des secrets). Une application appelant une API d'IA avec une clé la recevrait exactement de cette manière. L'alternative sans clé apparaît dans le module d'application DataAnalyst_CloudRun : il appelle un modèle Gemini via Vertex AI sous l'identité de son compte de service Cloud Run, auquel roles/aiplatform.user est attribué via additional_cloudrun_sa_roles (une validation refuse une liste qui ne le contient pas) ; il n'y a donc aucune clé d'API à stocker ni à faire tourner.
À vous de jouer
- Ajoutez un secret factice à
secret_environment_variableset redéployez. - Dans Console > Cloud Run > (service) > Revisions > Containers, vérifiez que la variable apparaît comme une référence de secret, et non comme une valeur ; puis :
gcloud run services describe <service-name> --region=us-central1 \
  --format="yaml(spec.template.containers[0].env)"
- Vous savez que cela a fonctionné lorsque l'entrée env affiche
valueSource.secretKeyRefplutôt qu'une valeur littérale.
Testez-vous
Q1 : Un produit a besoin d'OCR sur des factures numérisées et d'un agent d'assistance conversationnel. Quelles capacités prédéfinies, et quand passeriez-vous à un entraînement personnalisé ?
R : Une capacité Vision (OCR/détection de texte dans les documents, ou Document AI pour les factures structurées) et une capacité Conversation (un agent conversationnel). Ne passez à un entraînement ou à un réglage personnalisé que lorsque la qualité du modèle prédéfini sur les données de votre domaine est insuffisante. Le prédéfini d'abord est la posture par défaut de l'examen.
Q2 : Une application appelle un modèle Gemini depuis Cloud Run. Pourquoi préférer le rôle IAM du compte de service à une clé d'API dans Secret Manager ?
R : Le compte de service reçoit automatiquement des identifiants de courte durée ; il n'existe donc aucun secret de longue durée susceptible de fuiter, à faire tourner ou dont il faudrait limiter la portée — l'accès est accordé et révoqué via IAM (roles/aiplatform.user) et apparaît dans les journaux d'audit sous une identité nommée. Une clé d'API dans Secret Manager est protégée au repos, mais reste un identifiant au porteur.
Au-delà des modules — Étudiez les catégories d'API d'IA de Google citées dans le guide (Search, Conversation, Vision, Image, Video, Audio) et le rôle de chacune, les agents d'IA de Gemini Enterprise et NotebookLM en tant qu'outils de workflow pour les utilisateurs métier, les options de déploiement de Model Garden (modèles Google, ouverts et partenaires ; API gérée ou point de terminaison autodéployé) et les modèles d'ancrage/RAG. Essayez gcloud ml vision detect-text <image-path> dans un projet de test pour un aperçu de deux minutes d'une API prédéfinie.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.