Guide de préparation à la certification PCA : Section 4 — Analyse et optimisation des processus techniques et métier (Analyzing and optimizing technical and business processes) (~15 % de l'examen)
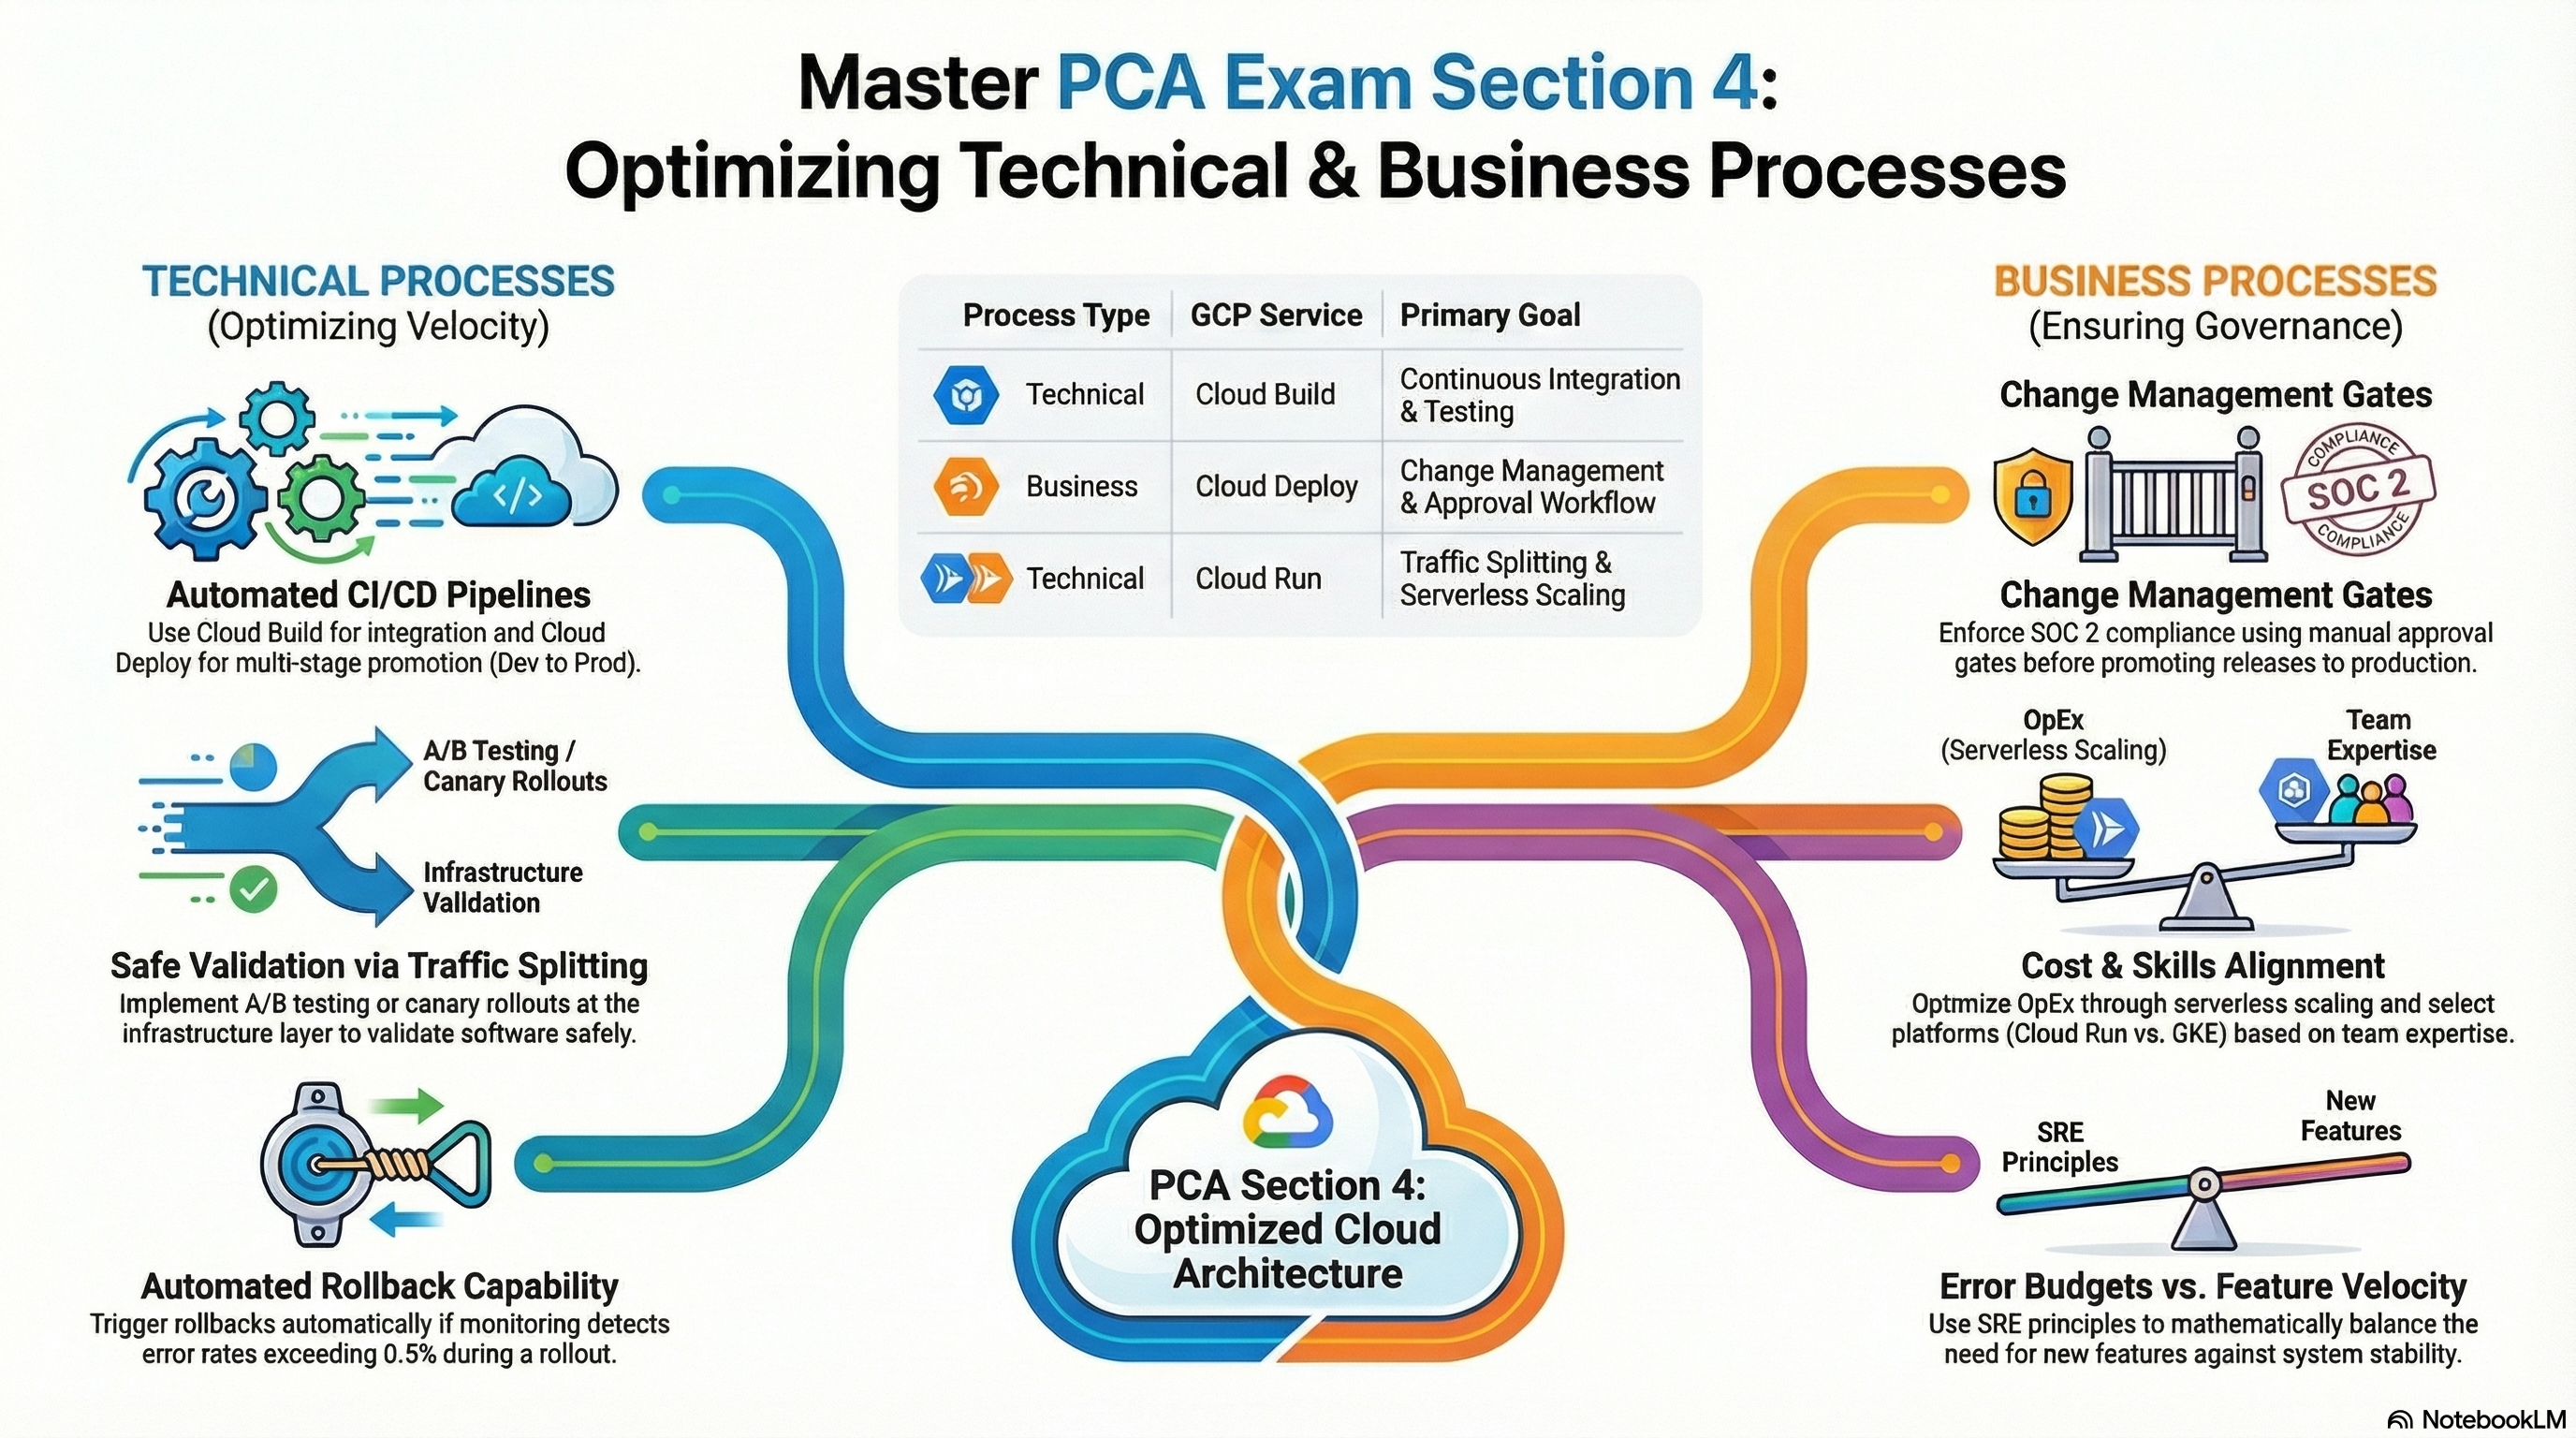
📚 Guide d'examen officiel : Professional Cloud Architect certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Cette section porte sur l'architecture des processus : cycle de vie de la livraison logicielle, stratégie de test et de mise en production, et les contrôles organisationnels (approbations, gouvernance des coûts, prise de décision) qui les encadrent. La moitié déployable se trouve dans la surface CI/CD d'App_CloudRun et dans la couche Cloud Deploy de la plateforme ; la moitié humaine — culture SRE, gestion des parties prenantes, post-mortems — doit être étudiée dans les ouvrages SRE et le Well-Architected Framework. Déployez le profil Sécurité et livraison de la Carte des labs avec enable_cicd_trigger = true et enable_cloud_deploy = true.
4.1 Analyser et définir les processus techniques (Analyzing and defining technical processes)
⏱ ~90 min · 💰 faible — minutes Cloud Build et stockage Artifact Registry · ⚙️ Prérequis : profil Sécurité et livraison + un dépôt GitHub (
github_repository_url, jeton ou installation de l'App)
Pourquoi l'examen s'y intéresse — L'examen évalue les choix de conception du SDLC : où ont lieu les builds, comment les artefacts acquièrent leur provenance, comment les mises en production progressent d'un environnement à l'autre, et comment le risque est contenu à chaque étape (pourcentages canary, portes d'approbation, chemins de retour arrière). Attendez-vous à des questions distinguant la CI (build/test/intégration) de la CD (mise en production/promotion) et demandant quel outil Google prend en charge quelle étape.
Comment RAD le met en œuvre
| Étape du SDLC | Mise en œuvre | Variables (valeurs par défaut) |
|---|---|---|
| Déclencheur source | Déclencheur GitHub Cloud Build sur push | enable_cicd_trigger (par défaut false), cicd_trigger_config.branch_pattern (par défaut "^main$", plus des filtres de fichiers inclus/ignorés) |
| Build | L'exécuteur Kaniko v1.23.2 effectue les builds sans cluster (sans démon Docker) et pousse vers Artifact Registry avec les tags latest, la version de l'application et COMMIT_SHA | enable_cicd_trigger |
| Provenance | une étape facultative gcloud beta container binauthz attestations sign-and-create signe le condensé COMMIT_SHA avec la clé KMS de l'attestateur | enable_binary_authorization |
| Déploiement (simple) | gcloud run services update vers la nouvelle image | chemin par défaut |
| Déploiement (progressif) | Pipeline Cloud Deploy avec des cibles par étape et des configurations skaffold dans GCS | enable_cloud_deploy (par défaut false), cloud_deploy_stages — par défaut dev → staging → prod, où prod a require_approval = true |
| Canary / blue-green | Répartition du trafic entre révisions Cloud Run ; la somme des entrées doit être exactement 100 (validé) | traffic_split (par défaut [] = tout le trafic vers la dernière révision) |
| Hygiène des artefacts | Règles de nettoyage AR | max_images_to_retain (par défaut 7), delete_untagged_images (par défaut true), image_retention_days (par défaut 30) |
Deux détails à assimiler comme matière d'examen : les builds taguent chaque image avec le COMMIT_SHA immuable (le condensé que signe l'attestation — latest n'est jamais le contrat de déploiement), et le pipeline par défaut encode l'asymétrie de gouvernance qu'attend l'examen : la préproduction se promeut librement, la production exige un humain.
À vous de jouer
- Poussez un commit sur la branche configurée et suivez Console > Cloud Build > History — repérez l'étape de build Kaniko et (si elle est activée) l'étape d'attestation.
- Examinez les tags obtenus :
gcloud artifacts docker images list \
  <region>-docker.pkg.dev/<project>/<repo>/<image> \
  --include-tags --limit=5
- Avec Cloud Deploy activé, ouvrez Console > Cloud Deploy > Delivery pipelines, promouvez la release de
devversstaging, puis constatez queprodattend à l'état « Needs approval ». - Configurez un canary : définissez
traffic_splità 90 % LATEST / 10 % vers une révision précédente (avec untag = "canary"), appliquez, puis vérifiez :
gcloud run services describe <service-name> --region=us-central1 \
  --format="yaml(status.traffic)"
- Vous savez que cela a fonctionné lorsque l'étape prod est bloquée en attente d'approbation et que
status.trafficaffiche la répartition 90/10 avec l'URL canary taguée.
Testez-vous
Q1 : Une équipe veut valider les nouvelles versions sur 5 % du trafic de production avec un retour arrière instantané. Quel mécanisme ici, et quelle est l'action de retour arrière ?
R : traffic_split de Cloud Run — par exemple 95 % vers la révision stable, 5 % vers la nouvelle (éventuellement avec une URL de tag stable pour des tests ciblés). Le retour arrière consiste à réattribuer le trafic à la révision précédente, et non à redéployer, car Cloud Run conserve les révisions antérieures (max_revisions_to_retain, par défaut 7). C'est l'équivalent serverless des déploiements canary que décrit l'examen.
Q2 : Pourquoi le pipeline signe-t-il le tag COMMIT_SHA de l'image plutôt que latest ?
R : Les attestations se lient à un condensé immuable. latest est un pointeur mobile — le signer reviendrait à attester « tout ce vers quoi pointe ce tag », ce qui ruine l'intégrité de la chaîne d'approvisionnement. La règle Binary Authorization vérifie que le condensé déployé porte une signature valide de l'attestateur, ce qui n'est vrai que pour l'artefact précis issu du build.
Q3 : Où se situe la frontière CI/CD dans le pipeline de cette plateforme ?
R : CI = Cloud Build (déclencheur → build Kaniko → push vers Artifact Registry → attestation) : produire un artefact vérifié. CD = Cloud Deploy (release → dev → staging → approbation → prod) : promouvoir cet artefact d'un environnement à l'autre. L'examen attend de vous que vous attribuiez les échecs de test/build à la CI et la stratégie de promotion/approbation/déploiement à la CD.
Au-delà des modules — L'examen couvre aussi les tests et la validation des logiciels et de l'infrastructure (unitaires, d'intégration ou de charge ; le pipeline présenté ici n'exécute aucune étape de test — en ajouter une est un bon exercice), la pratique du dépannage et de l'analyse des causes profondes (post-mortems sans recherche de coupable ; Cloud Trace et Cloud Profiler comme outils), la reprise après sinistre en tant que processus défini (objectifs RTO/RPO, et plans de reprise répétés, pas seulement rédigés — les sauvegardes et la PITR des sections 1.2 et 2.2 en sont la matière première), ainsi que le catalogue de services et le provisionnement — proposer aux équipes des solutions sélectionnées et préapprouvées qu'elles peuvent provisionner elles-mêmes. Le portail RAD est lui-même un exemple de ce dernier modèle : un catalogue de modules validés, déployés via un pipeline unique et gouverné. Étudiez les métriques DORA (fréquence de déploiement, délai de mise en œuvre, taux d'échec des changements, MTTR) et le document d'architecture « Application deployment and testing strategies » — les compromis entre déploiement progressif (rolling), blue-green et canary reviennent régulièrement à l'examen.
⚠️ Piège d'examen — Ne confondez pas les déclencheurs Cloud Build et Cloud Deploy. Un scénario de type « construire à chaque fusion » relève de Cloud Build ; « promouvoir le même artefact de dev à staging puis prod avec des approbations » relève de Cloud Deploy. Reconstruire l'image pour chaque environnement (au lieu de promouvoir un artefact unique) est l'anti-modèle que l'examen veut vous voir rejeter.
4.2 Analyser et définir les processus métier (Analyzing and defining business processes)
⏱ ~45 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : Cloud Deploy activé (profil Sécurité et livraison)
Pourquoi l'examen s'y intéresse — Les architectes pilotent des processus de gestion du changement et de gouvernance, pas seulement de l'infrastructure : approbations imposées pour les environnements réglementés, responsabilité en matière de coûts, choix de plateforme fondés sur les compétences (une équipe qui ne sait pas exploiter Kubernetes ne doit pas se voir confier Kubernetes) et cadres de décision fondés sur les données, comme les budgets d'erreur SRE.
Comment RAD le met en œuvre — Les artefacts déployables sont ici de la gouvernance encodée sous forme de configuration. Le cloud_deploy_stages par défaut fait de la promotion en production une décision humaine (require_approval = true sur prod) — une porte de gestion du changement auditable qui satisfait aux attentes de séparation des tâches, avec auto_promote disponible par étape lorsque la vélocité compte davantage. La responsabilité des coûts découle de create_billing_budget + budget_alert_thresholds (section 1.1) et de la répartition des coûts GKE (activée sur chaque cluster, permettant une ventilation des coûts par espace de noms dans la facturation). Et l'existence même de la plateforme illustre une décision fondée sur la maturité des compétences : le portail permet à une équipe de choisir Cloud Run (faible exigence de compétences Kubernetes) ou GKE (orchestration complète) pour la même application — ce choix est en soi l'artefact du processus métier.
À vous de jouer
- Créez une release et promouvez-la vers l'étape
prod; dans Console > Cloud Deploy > Delivery pipelines > (pipeline) > Releases, ouvrez le déploiement en attente et utilisez Approve (ou rejetez-le). - Examinez la piste d'audit de cette approbation :
gcloud deploy rollouts list \
  --delivery-pipeline=<pipeline-name> --release=<release-name> \
  --region=us-central1 \
  --format="table(name,state,approvalState,deployStartTime)"
- Vous savez que cela a fonctionné lorsque le déploiement affiche
approvalState: APPROVEDavec un horodatage — une preuve qu'un processus de comité consultatif des changements peut exploiter.
Testez-vous
Q1 : Un assureur réglementé exige une validation documentée avant toute modification en production, mais ne veut aucune friction dans les environnements inférieurs. Comment l'exprimer sur cette plateforme — et, en termes d'examen, quel processus met-on en œuvre ?
R : cloud_deploy_stages avec require_approval = false (éventuellement auto_promote = true) sur dev/staging et require_approval = true sur prod — exactement la valeur par défaut du module. Cela met en œuvre la gestion du changement avec séparation des tâches : la personne qui déploie et celle qui approuve en production sont distinctes, et Cloud Deploy enregistre les deux, produisant les preuves d'audit (contrôle des changements de type SOC 2) qu'exige le scénario.
Q2 : La direction doit choisir entre Cloud Run et GKE pour un nouveau produit ; l'équipe compte de solides développeurs d'applications et aucun ingénieur plateforme. Qu'est-ce que l'examen attend de vous que vous pesiez ?
R : La maturité des compétences de l'équipe est une donnée d'architecture de premier ordre. Sans capacité d'exploitation Kubernetes, le modèle géré de Cloud Run (pas de clusters, de quotas, de PDB ni de mises à niveau) réduit le risque opérationnel, même si GKE offre plus de contrôle ; choisir GKE exigerait de recruter ou de former (un facteur de coût et de délai). L'examen récompense constamment l'adéquation entre la complexité de la plateforme et les capacités de l'organisation, et non la flexibilité maximale.
Au-delà des modules — Étudiez ce qu'aucun module ne peut montrer : gestion des parties prenantes (influence et facilitation), évaluation de l'équipe et maturité des compétences, gestion de la réussite client, planification de la continuité des activités, budgets d'erreur SRE comme mécanisme de décision (vélocité des fonctionnalités ou fiabilité), définition des SLI/SLO avec les parties prenantes, communication en cas d'incident, et traduction des métriques techniques en KPI métier. Les chapitres « Embracing Risk » et « Service Level Objectives » du livre SRE de Google, disponible gratuitement, constituent la préparation de référence pour l'examen sur ce point.
⚠️ Piège d'examen — Une porte d'approbation relève de la gestion du changement, pas de la validation du changement. Si le scénario demande comment détecter automatiquement les mauvaises versions, la réponse est l'analyse canary/les tests dans le pipeline — un bouton d'approbation humaine ne vérifie pas l'exactitude, il attribue une responsabilité.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.