Services GCP — Module Socle de Plateforme
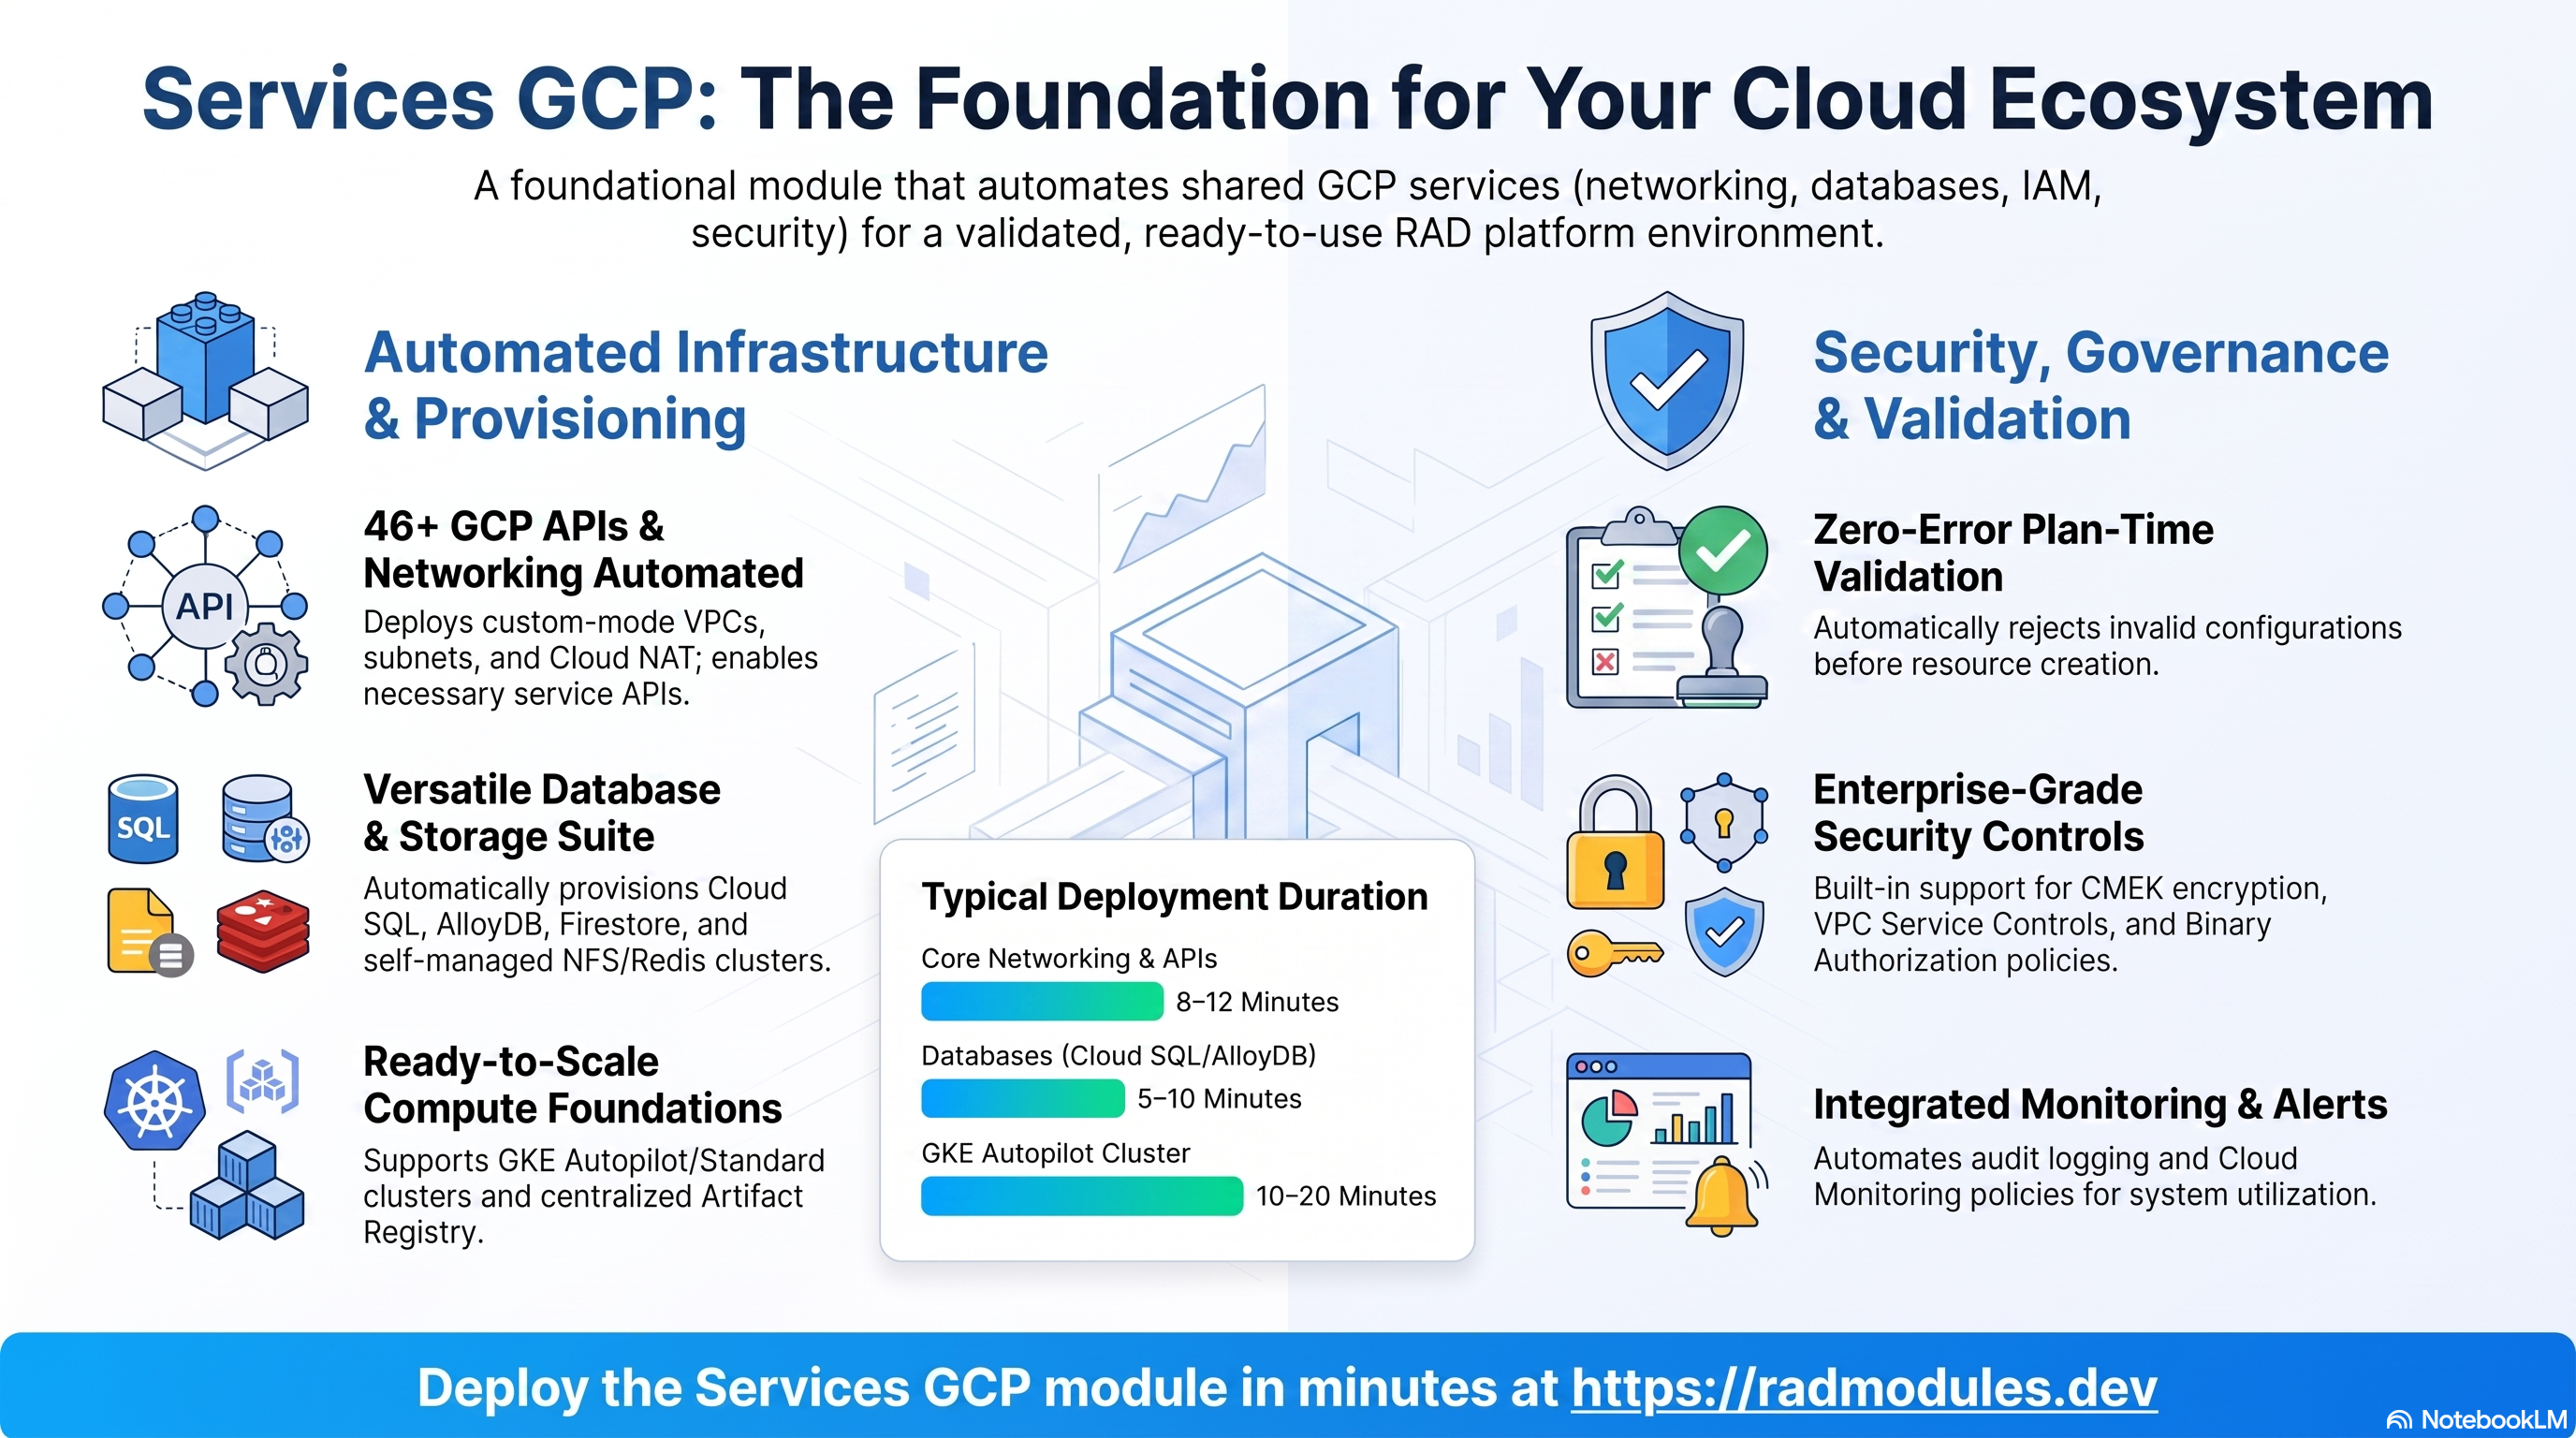
Services GCP est la couche socle de la plateforme, provisionnant l'infrastructure partagée dont dépend chaque application : le VPC et le réseau, les bases de données Cloud SQL et AlloyDB, Memorystore Redis, Cloud Filestore (ou une VM NFS/Redis autogérée), le cluster GKE Autopilot, le dépôt Artifact Registry partagé, les comptes de service de la plateforme et IAM, et les contrôles de sécurité optionnels (Binary Authorization, CMEK, VPC Service Controls et Security Command Center).
Parce que tout le reste dépend de ses sorties, Services GCP doit être provisionné et sain avant que App CloudRun, App GKE, ou tout module d'application ne soit déployé — mais vous n'avez pas besoin d'organiser cela vous-même. Lorsque vous déployez un module d'application dans un projet qui n'a pas encore Services GCP, la plateforme le détecte, le provisionne automatiquement en premier (avec les ressources spécifiques que le propre requires_services de l'application déclare — par exemple, Postgres vs. MySQL, GKE ou non), attend qu'il réussisse, puis déploie votre application par-dessus. Le déploiement direct de Services GCP, comme documenté ci-dessous, reste pris en charge pour le préconfigurer avant qu'une application n'en dépende ou pour partager délibérément un déploiement entre plusieurs applications.
Ordre de déploiement :
Services GCP → App CloudRun / App GKE → Application Modules
Services GCP déployés
Un déploiement Services GCP entièrement configuré provisionne et intègre les services GCP suivants :
| Capacité | Service Google Cloud |
|---|---|
| Réseau privé | Compute Engine VPC, Sous-réseaux, Cloud Router, Cloud NAT, Private Service Connect, Règles de pare-feu |
| Bases de données relationnelles | Cloud SQL (PostgreSQL / MySQL), AlloyDB pour PostgreSQL |
| Base de données de documents (optionnel) | Firestore (Native, édition Enterprise) |
| Cache géré (optionnel) | Memorystore pour Redis |
| Stockage de fichiers géré (optionnel) | Cloud Filestore (NFS) |
| Fichier/cache autogéré (optionnel) | VM Compute Engine (NFS + Redis) dans un groupe d'instances géré |
| Orchestration de conteneurs (optionnel) | Clusters GKE Autopilot / Standard, GKE Fleet, Backup for GKE |
| Registre de conteneurs | Artifact Registry (Docker) |
| Identité et accès | Cloud IAM, comptes de service de la plateforme, Workload Identity Federation (optionnel) |
| Secrets | Secret Manager (mot de passe root de la base de données) |
| Sécurité de la chaîne d'approvisionnement (optionnel) | Binary Authorization, clé d'attestation Cloud KMS, Container Analysis |
| Chiffrement (optionnel) | Cloud KMS (CMEK) |
| Contrôles d'exfiltration de données (optionnel) | VPC Service Controls, Access Context Manager |
| Posture de sécurité (optionnel) | Security Command Center, analyse des vulnérabilités Container Analysis |
| Observabilité | Cloud Monitoring (règles d'alerte, canaux de notification), Cloud Logging |
| Gestion des coûts (optionnel) | Budgets de facturation Cloud |
Prérequis
Avant de déployer Services GCP :
- Un projet GCP avec la facturation activée.
- Identité de déploiement : le compte de service utilisé par la plateforme pour appliquer le module a besoin d'autorisations pour créer l'infrastructure partagée qu'il gère. Préférez l'ensemble de privilèges minimum que
Project GCPaccorde à son identité de déploiement (voir le guide de ce module) plutôt qu'un rôle primitif large ; accordez-le dans le projet cible, idéalement limité dans le temps et conditionnel.roles/ownerfonctionnera mais est beaucoup plus large que nécessaire — si vous l'accordez lors de l'intégration d'un projet externe, limitez-le à la fenêtre d'intégration plutôt que de le laisser en place. - API requises : le module active automatiquement les API dont son ensemble de fonctionnalités par défaut a besoin, avec un délai de propagation avant que les ressources ne soient provisionnées. Deux exceptions délibérées : les API GKE Enterprise / Anthos fleet (
gkehub,gkeconnect,anthosconfigmanagement,anthospolicycontroller,mesh) sont activées parProject_GCPau Tier-0, pas ici — sur un projet non provisionné parProject_GCP,configure_config_management/configure_policy_controller/configure_cloud_service_meshéchouent à l'apply avecError 403: GKE Hub API has not been used in project ...et doivent être fournies viaadditional_apis; etalloydb.googleapis.coma été complètement supprimé, doncenable_alloydbéchoue à l'apply. - Accès au compte de facturation (uniquement pour le budget de facturation optionnel) : l'identité de déploiement a besoin d'un accès en lecture au compte de facturation.
- Rôles au niveau de l'organisation (uniquement pour VPC Service Controls et les notifications SCC) : la création de périmètres et de notifications est ignorée silencieusement lorsque l'identité appelante ne dispose pas des rôles requis au niveau de l'organisation.
Réseau (VPC)
Provisionne un réseau VPC en mode personnalisé avec un sous-réseau régional par région de disponibilité configurée. Toutes les ressources — Cloud SQL, Redis, Filestore, GKE et la VM NFS autogérée — communiquent exclusivement via IP privée au sein de ce réseau. Un Cloud Router et une passerelle Cloud NAT sont provisionnés par région pour l'accès Internet sortant depuis les instances privées, et une plage est réservée pour Private Service Connect afin que les services gérés par Google soient accessibles en privé. Des règles de pare-feu sont créées pour les vérifications de santé des équilibreurs de charge, IAP SSH, TCP/UDP/ICMP intra-VPC, NFS et le trafic HTTP/HTTPS. Lorsque plus d'un cluster GKE est provisionné, des règles de pare-feu Istio est-ouest supplémentaires sont créées pour le trafic maillé inter-clusters.
Console : Réseau VPC → Réseaux VPC → sélectionnez le réseau → Onglet Sous-réseaux (CIDR par région) ; Onglet Pare-feu (règles et tags cibles). Cloud NAT sous Services réseau → Cloud NAT.
# List all VPC networks in the project
gcloud compute networks list --project=PROJECT_ID

# List subnets — verify CIDR ranges and regions
gcloud compute networks subnets list \
  --project=PROJECT_ID \
  --format="table(name,region,ipCidrRange,network)"

# Confirm Cloud NAT is configured
gcloud compute routers nats list \
  --router=ROUTER_NAME \
  --region=REGION \
  --project=PROJECT_ID

# List firewall rules
gcloud compute firewall-rules list --project=PROJECT_ID \
  --format="table(name,direction,sourceRanges,allowed)"
Cloud SQL
Provisionne des instances Cloud SQL PostgreSQL et/ou MySQL dans la région principale, avec IP privée uniquement (pas de point de terminaison public), des sauvegardes quotidiennes automatisées et un stockage SSD à redimensionnement automatique. Les deux moteurs prennent en charge la disponibilité ZONAL (zone unique) ou REGIONAL (HA avec veille à chaud automatique), des réplicas en lecture optionnels (inter-régions lorsqu'une deuxième région est configurée), une fenêtre de maintenance et une piste de mise à jour configurables, des Query Insights optionnels et une authentification de base de données Cloud SQL IAM optionnelle. Le mot de passe root de la base de données est généré et stocké dans Secret Manager.
Dans un projet géré par RAD, l'instance est limitée de trois manières : taille (au plus 2 vCPU), réplicas en lecture (au plus 1 dans un projet sandbox ou de lab, 2 en développement ou en production), et la limite d'auto-croissance du disque (100 Go en sandbox et lab, 500 Go en développement, 1 To en production — Cloud SQL augmente sinon un disque sans limite). Le plafond de disque est défini lors de la création d'une instance ; une instance qui existe déjà conserve la limite qu'elle a. Un projet que vous apportez n'est limité par aucune de ces restrictions.
Console : SQL → sélectionnez l'instance. L'onglet Connexions confirme que l'IP privée est activée / l'IP publique est désactivée ; les onglets Sauvegardes, Indicateurs et Maintenance affichent les paramètres correspondants ; les réplicas en lecture apparaissent sous le primaire dans la vue d'ensemble SQL.
# List all Cloud SQL instances
gcloud sql instances list --project=PROJECT_ID \
  --format="table(name,databaseVersion,settings.tier,region,state)"

# Describe a specific instance — availability type, flags, maintenance window
gcloud sql instances describe INSTANCE_NAME \
  --project=PROJECT_ID \
  --format="yaml(settings.availabilityType,ipAddresses,settings.databaseFlags,settings.maintenanceWindow)"

# List read replicas for a primary instance
gcloud sql instances list --project=PROJECT_ID \
  --filter="masterInstanceName=INSTANCE_NAME" \
  --format="table(name,databaseVersion,region,state)"
AlloyDB pour PostgreSQL
AlloyDB n'est plus utilisable dans ce module.
alloydb.googleapis.coma été supprimé de l'ensemble des API activées suite à une décision de coût explicite (PR #2673), doncenable_alloydb = trueéchoue à l'apply au lieu de créer un cluster. Les ressourcesalloydb.tf, les variablesenable_alloydb/alloydb_cpu_count/alloydb_database_flags/enable_alloydb_read_pool/alloydb_read_pool_node_countet les sortiesalloydb_*restent déclarées mais sont inaccessibles à moins que l'API ne soit fournie viaadditional_apis(refusé sur les dossiers gérés par RAD). Utilisez Cloud SQL PostgreSQL (create_postgres) à la place.
Console : AlloyDB pour PostgreSQL → Clusters pour afficher les détails du cluster et de l'instance, y compris l'état du moteur de colonnes.
# List AlloyDB clusters
gcloud alloydb clusters list \
  --region=REGION \
  --project=PROJECT_ID

# List AlloyDB instances in a cluster (primary and read pool)
gcloud alloydb instances list \
  --cluster=CLUSTER_NAME \
  --region=REGION \
  --project=PROJECT_ID
Firestore
Crée éventuellement une base de données Firestore Native en édition Enterprise — une base de données de documents sans serveur adaptée aux schémas flexibles, à la synchronisation en temps réel et à la prise en charge des clients hors ligne. L'ID et l'emplacement de la base de données sont configurables ; l'ID par défaut est firestore-db-<random_id> et l'emplacement par défaut est la région principale lorsqu'il est laissé vide.
Console : Firestore pour parcourir la base de données, les collections et les documents.
# List Firestore databases
gcloud firestore databases list --project=PROJECT_ID
Memorystore (Redis)
Provisionne éventuellement une instance Cloud Memorystore pour Redis dans la région principale comme alternative gérée à la VM NFS/Redis autogérée. Prend en charge le niveau BASIC (nœud unique) ou STANDARD_HA (basculement inter-zones), une taille de mémoire et une version de moteur configurables, la connectivité DIRECT_PEERING ou PRIVATE_SERVICE_ACCESS, et la persistance optionnelle (instantanés RDB ou AOF, sur STANDARD_HA uniquement). La chaîne AUTH est stockée dans Secret Manager.
Console : Memorystore → Redis → sélectionnez l'instance pour afficher le niveau, la taille de la mémoire, la version, le mode de connectivité, l'IP privée et la fenêtre de maintenance.
# List all Memorystore Redis instances
gcloud redis instances list \
  --region=REGION \
  --project=PROJECT_ID \
  --format="table(name,tier,memorySizeGb,redisVersion,state)"

# Describe a specific instance — IP, connect mode, persistence config
gcloud redis instances describe INSTANCE_NAME \
  --region=REGION \
  --project=PROJECT_ID \
  --format="yaml(host,port,tier,connectMode,redisVersion,memorySizeGb,persistenceConfig)"
Filestore
Provisionne éventuellement une instance Cloud Filestore dans la région principale en tant que stockage NFS partagé géré et couvert par un SLA — l'alternative à la VM NFS autogérée. Prend en charge les niveaux BASIC_HDD, BASIC_SSD et ENTERPRISE (régional, multi-zones), chacun avec des capacités minimales imposées. L'instance exporte un seul partage NFS montable par plusieurs clients simultanément.
Console : Filestore → Instances → sélectionnez l'instance pour afficher le niveau, la capacité, l'IP privée, ainsi que le nom du partage de fichiers exporté et le chemin de montage.
# List all Filestore instances — tier, capacity, IP, state
gcloud filestore instances list \
  --project=PROJECT_ID \
  --format="table(name,tier,fileShares[0].capacityGb,networks[0].ipAddresses[0],state)"

# Describe a specific instance — NFS mount point and share name
gcloud filestore instances describe INSTANCE_NAME \
  --zone=ZONE \
  --project=PROJECT_ID \
  --format="yaml(fileShares,networks,tier,state)"
VM NFS et Redis autogérée
L'alternative moins coûteuse aux services gérés Filestore et Memorystore. Provisionne une seule VM Compute Engine exécutant à la fois un serveur NFS (port 2049) et Redis (port 6379), déployée en tant que groupe d'instances géré régional de taille 1 avec auto-réparation en cas d'échec de la vérification de santé TCP, un disque de données persistant SSD (un disque avec état par instance, préservé lors de la recréation) et des instantanés de disque quotidiens avec une rétention de 7 jours. Recommandé pour le développement et les déploiements sensibles aux coûts.
Le MIG est distribué sur chaque zone de la région avec distribution_policy_target_shape = "ANY", de sorte que GCE place l'instance unique là où la capacité existe. Cela a remplacé un ancien épinglage à une seule zone qui restait bloqué indéfiniment sur ZONE_RESOURCE_POOL_EXHAUSTED — un échec de capacité, pas de quota, c'est pourquoi le quota CPU/instance peut sembler complètement libre alors que la VM ne démarre jamais.
| Variable | Valeur par défaut | Description |
|---|---|---|
nfs_excluded_zones | [] | Zones à exclure de la politique de distribution du MIG. Nécessaire pour le mode d'échec résiduel où même target_shape = "ANY" engage l'instance dans une zone en rupture de stock et y réessaie indéfiniment ; l'exclusion de cette zone reconstruit le MIG avec une politique qui ne peut pas la choisir. La modification de cette liste force le remplacement du MIG (distribution_policy_zones est immuable) — le disque de données survit via l'instantané quotidien, et un nouveau déploiement n'a rien à perdre. Ne vaut la peine d'être défini que lorsqu'un sous-ensemble de zones est en rupture de stock ; si toutes les zones sont épuisées, les exclusions ne peuvent pas aider et le MIG s'auto-réparera une fois la capacité revenue. |
La VM autogérée et les services gérés Filestore/Memorystore sont indépendants. L'exécution des deux crée une infrastructure redondante et risque un stockage de fichiers en split-brain — utilisez l'un ou l'autre.
Console : Compute Engine → Instances de VM (VM Running) ; Groupes d'instances (MIG 1/1 sain) ; Disques (capacité du disque de données) ; Instantanés (instantanés quotidiens).
# List Compute Engine instances — confirm the NFS/Redis VM is running
gcloud compute instances list --project=PROJECT_ID \
  --format="table(name,zone,machineType,status)"

# List Managed Instance Groups — confirm health
gcloud compute instance-groups managed list --project=PROJECT_ID \
  --format="table(name,zone,targetSize,status.isStable)"

# List recent disk snapshots
gcloud compute snapshots list --project=PROJECT_ID \
  --format="table(name,sourceDisk,status,creationTimestamp)"
Cluster GKE Autopilot
Provisionne éventuellement un ou plusieurs clusters GKE dans la région principale, enregistrés dans une flotte GKE. Le mode Autopilot (par défaut) est entièrement géré par Google — le provisionnement des nœuds, la mise à l'échelle et le renforcement de la sécurité sont automatiques et la facturation est par pod. Le mode Standard donne un contrôle total sur le type de machine, le disque et le nombre de pools de nœuds via les variables de pool de nœuds, pour les charges de travail avec des exigences strictes en matière de planification ou de matériel. Les CIDR des nœuds, des pods et des services sont configurables et ne doivent pas se chevaucher. Trois add-ons Fleet indépendants sont disponibles : Cloud Service Mesh (Istio géré, mTLS), Config Sync (réconciliation GitOps) et Policy Controller (OPA Gatekeeper). Lorsque plus d'un cluster est provisionné, Multi-Cluster Ingress est disponible via le cluster de configuration.
Les nœuds sont toujours privés, et ce n'est pas configurable. Chaque cluster est créé avec private_cluster_config { enable_private_nodes = true }. Les projets gérés par RAD appliquent une règle d'organisation constraints/compute.vmExternalIpAccess DENY ; sans nœuds privés, GKE essaie d'attribuer des IP externes à ses nœuds, la création de nœuds échoue avec Constraint constraints/compute.vmExternalIpAccess violated, et le cluster reste bloqué en ERROR. Seuls les nœuds sont affectés — enable_private_endpoint reste à sa valeur par défaut (false), de sorte que le plan de contrôle conserve son point de terminaison public et que les outils CI/CD en dehors du VPC peuvent toujours l'atteindre.
Le plan de contrôle de chaque cluster a également besoin de son propre /28 privé, découpé par cluster à partir d'un CIDR de base dédié dans un bloc RFC1918 différent des plages de sous-réseau, de pod et de service afin qu'il ne puisse pas entrer en collision avec elles. Comme les trois autres plages, il est fixé lors de la création du cluster — le modifier force le remplacement du cluster.
Console : Kubernetes Engine → Clusters (état, mode, version, CIDR) ; Flottes (enregistrement) ; Fonctionnalités → Service Mesh / Gestion de la configuration / Contrôleur de stratégie (état des add-ons).
# List all GKE clusters
gcloud container clusters list --project=PROJECT_ID \
  --format="table(name,location,status,autopilot.enabled,currentMasterVersion)"

# Describe a cluster — view CIDRs and configuration
gcloud container clusters describe CLUSTER_NAME \
  --region=REGION \
  --project=PROJECT_ID \
  --format="yaml(clusterIpv4Cidr,servicesIpv4Cidr,network,subnetwork,autopilot)"

# List fleet memberships — confirm cluster registration
gcloud container fleet memberships list --project=PROJECT_ID \
  --format="table(name,state.code,endpoint.gkeCluster.resourceLink)"

# Get credentials and inspect the cluster
gcloud container clusters get-credentials CLUSTER_NAME \
  --region=REGION --project=PROJECT_ID
kubectl get nodes -o wide
kubectl get pods --all-namespaces
Sauvegarde pour GKE
Active éventuellement Backup for GKE sur le ou les clusters provisionnés, créant des sauvegardes planifiées de l'état des ressources Kubernetes (Deployments, ConfigMaps, Secrets, Services) et des données PersistentVolumeClaim vers Cloud Storage, avec un calendrier et une période de rétention configurables. Les sauvegardes peuvent être restaurées sur le même cluster ou sur un cluster différent.
Console : Kubernetes Engine → Backup for GKE → Plans de sauvegarde (calendrier, rétention) ; sélectionnez un plan → Sauvegardes (sauvegardes terminées, taille, expiration) ; utilisez Restaurer à partir d'une sauvegarde terminée.
# List all GKE backup plans in the region
gcloud beta container backup-restore backup-plans list \
  --location=REGION \
  --project=PROJECT_ID \
  --format="table(name,cluster,retentionPolicy.backupDeleteLockDays,state)"

# List completed backups for a backup plan
gcloud beta container backup-restore backups list \
  --backup-plan=BACKUP_PLAN_NAME \
  --location=REGION \
  --project=PROJECT_ID \
  --format="table(name,state,createTime,deleteLockExpireTime)"
Artifact Registry
Provisionne un dépôt Docker partagé dans la région principale pour stocker et distribuer des images de conteneurs. Tous les modules d'application poussent et tirent des images de ce dépôt. L'analyse des vulnérabilités optionnelle lors du push et le chiffrement CMEK optionnel peuvent être appliqués.
Console : Artifact Registry → Dépôts → sélectionnez le dépôt pour parcourir les images et les tags.
# List Artifact Registry repositories
gcloud artifacts repositories list --project=PROJECT_ID

# List images in the shared repository
gcloud artifacts docker images list \
  REGION-docker.pkg.dev/PROJECT_ID/REPO_NAME \
  --include-tags
IAM et comptes de service
Implémente une stratégie IAM de moindre privilège en utilisant des comptes de service de plateforme dédiés, exposés en sorties pour les modules d'application en aval :
- Compte de service Cloud Build — exécution du pipeline CI/CD ; construit des images et gère les déploiements.
- Compte de service Cloud Deploy — livraison progressive ; gère les pipelines de livraison et les jobs de déploiement.
- Compte de service Cloud Run — identité d'exécution pour les conteneurs Cloud Run ; accède à Cloud SQL, au stockage et aux secrets que chaque application lui accorde individuellement.
- Compte de service VM NFS/Redis — identité pour la VM NFS/Redis autogérée.
Ces comptes sont limités au locataire et partagés. Un déploiement compatible GKE gère également gke-sa, que App GKE crée sous le même nom. Services GCP n'est pas le seul créateur de quatre d'entre eux (cloudbuild-sa, cloudrun-sa, nfs-sa, gke-sa) — une application déployée avant Services GCP provisionne cloudbuild-sa et cloudrun-sa (App CloudRun), cloudbuild-sa (App GKE), et nfs-sa sur le chemin NFS intégré, et ne les supprime jamais. clouddeploy-sa est créé ici seul. Un compte qui existe déjà est importé dans l'état et géré normalement, il est donc également supprimé lorsque ce module est détruit. Chaque compte est donc sondé avant l'apply ; un compte qui existe déjà est importé dans l'état et géré comme n'importe quel autre, de sorte que le déploiement de Services GCP dans un projet qu'un module d'application a atteint en premier n'échoue pas avec already exists. Les liaisons IAM sont appliquées de toute façon.
L'accès à Secret Manager est par secret. Aucun compte de plateforme ne détient un rôle Secret Manager au niveau du projet : ni cloudrun-sa, gke-sa, cloudbuild-sa, ni le compte Cloud Build par défaut du projet (PROJECT_NUMBER@cloudbuild.gserviceaccount.com). Une charge de travail ne peut lire que les secrets que sa propre application lui confie :
| Secret | Qui accorde secretAccessor, à qui |
|---|---|
Mot de passe root Cloud SQL (secret-<instance>-root-password) | Ce module, à cloudrun-sa de son locataire et (avec GKE) à gke-sa. App CloudRun / App GKE garantissent en outre que l'octroi est uniquement de création, ne le révoquant jamais, pour un compte que ce module ne gère pas. |
Mot de passe DB d'une application, ses propres secrets, secret_environment_variables | Le module d'application, par secret (App_Common/modules/app_iam). |
Secrets référencés uniquement par un job d'initialisation ou cron, un frère additional_services, un sidecar additional_containers, ou le mot de passe DB d'une étape Cloud Deploy | Le module d'application, par secret (App CloudRun / App GKE iam.tf). |
| Le jeton GitHub (CI/CD) | Le module d'application, aux comptes Cloud Build et à l'agent de service Cloud Build, sur ce seul secret. |
L'octroi du mot de passe root appartient ici, et non à une application, car chaque application sur l'instance partage une liaison : lorsqu'une application en était propriétaire, la destruction de cette application révoquait le mot de passe root des jobs de base de données de tous ses frères. L'identité de déploiement conserve roles/secretmanager.admin (défini par Project GCP), dont elle a besoin pour créer des secrets et définir leurs politiques IAM.
Mise à niveau : l'accès à Secret Manager est par secret
Les projets déployés avant ce changement détiennent roles/secretmanager.secretAccessor au niveau du projet sur cloudrun-sa-<tenant>, gke-sa-<tenant>, cloudbuild-sa-<tenant> et PROJECT_NUMBER@cloudbuild.gserviceaccount.com, et roles/secretmanager.secretVersionManager sur cloudrun-sa-<tenant>. L'application des nouvelles versions de modules ne les supprime pas : Services GCP oublie ces liaisons plutôt que de les détruire (ainsi son apply ne peut pas retirer l'accès aux applications non encore mises à jour), et les octrois des modules d'application sont des appels gcloud add-iam-policy-binding de création uniquement qui ne révoquent jamais. Supprimez-les une fois, à la main, dans cet ordre :
- Appliquez
Services GCP. Il ajoute les octrois de mot de passe root pourcloudrun-sa/gke-saet oublie ceux au niveau du projet (le plan afficheforget, jamaisdestroy, pour ces liaisons). - Appliquez chaque module d'application dans le locataire (wrappers
App CloudRun/App GKE). Chacun ajoute ses octrois par secret : secrets de job, de sidecar, de service frère et d'étape qui étaient auparavant accessibles uniquement via le rôle au niveau du projet. - Vérifiez que chaque secret référencé par chaque charge de travail est accordé par secret (ci-dessous), et que les applications et une nouvelle exécution de leurs jobs sont saines.
- Révoquez les octrois au niveau du projet (ci-dessous). Répétez les étapes 1 à 4 par locataire lorsqu'un projet en héberge plusieurs ; révoquez du compte Cloud Build par défaut seulement après que le dernier locataire du projet a été mis à jour, car il est partagé par tous.
Vérifier (étape 3). Chaque secret référencé par un service ou un job Cloud Run doit lister son compte d'exécution comme secretAccessor. Exécutez par région :
PROJECT_ID=my-project
REGION=us-central1
PREFIX=abc123def4          # the tenant prefix: the suffix of cloudrun-sa-<prefix>
SA="cloudrun-sa-${PREFIX}@${PROJECT_ID}.iam.gserviceaccount.com"

{ gcloud run services list --project="$PROJECT_ID" --region="$REGION" --format="value(metadata.name)" |
    while read -r s; do gcloud run services describe "$s" --project="$PROJECT_ID" --region="$REGION" --format=json; done
  gcloud run jobs list --project="$PROJECT_ID" --region="$REGION" --format="value(metadata.name)" |
    while read -r j; do gcloud run jobs describe "$j" --project="$PROJECT_ID" --region="$REGION" --format=json; done
} | jq -r --arg sa "$SA" '.. | objects | select(.serviceAccountName? == $sa) | .. | .secretKeyRef?.name // empty' |
  sort -u | while read -r secret; do
    gcloud secrets get-iam-policy "$secret" --project="$PROJECT_ID" --format=json |
      jq -e --arg m "serviceAccount:$SA" '.bindings[]? | select(.role == "roles/secretmanager.secretAccessor") | .members[] | select(. == $m)' >/dev/null \
      && echo "ok       $secret" || echo "MISSING  $secret"
  done
Toute ligne MISSING signifie qu'une application n'a pas été réappliquée avec la nouvelle version du module ; appliquez-la et vérifiez à nouveau avant de révoquer. Pour GKE, confirmez que le SecretSync de chaque application s'est matérialisé (kubectl get secretsync -A, chaque secret <prefix>-secrets présent) après son apply.
Révoquer (étape 4). remove-iam-policy-binding échoue sans danger avec not found pour une liaison qu'un projet n'a jamais eue.
PROJECT_ID=my-project
PREFIX=abc123def4
PROJECT_NUMBER=$(gcloud projects describe "$PROJECT_ID" --format="value(projectNumber)")

# Cloud Run runtime account (Services GCP + App CloudRun)
gcloud projects remove-iam-policy-binding "$PROJECT_ID" \
  --member="serviceAccount:cloudrun-sa-${PREFIX}@${PROJECT_ID}.iam.gserviceaccount.com" \
  --role="roles/secretmanager.secretAccessor" --condition=None
gcloud projects remove-iam-policy-binding "$PROJECT_ID" \
  --member="serviceAccount:cloudrun-sa-${PREFIX}@${PROJECT_ID}.iam.gserviceaccount.com" \
  --role="roles/secretmanager.secretVersionManager" --condition=None

# GKE workload account (Services GCP gke.tf + App GKE)
gcloud projects remove-iam-policy-binding "$PROJECT_ID" \
  --member="serviceAccount:gke-sa-${PREFIX}@${PROJECT_ID}.iam.gserviceaccount.com" \
  --role="roles/secretmanager.secretAccessor" --condition=None

# Tenant Cloud Build account (Services GCP + App CloudRun + App GKE)
gcloud projects remove-iam-policy-binding "$PROJECT_ID" \
  --member="serviceAccount:cloudbuild-sa-${PREFIX}@${PROJECT_ID}.iam.gserviceaccount.com" \
  --role="roles/secretmanager.secretAccessor" --condition=None

# Project's default Cloud Build account (Services GCP) -- shared by every tenant,
# so only after the LAST tenant in the project is updated. First confirm nothing
# outside these modules relies on it: a build config with availableSecrets, or a
# trigger running as this account, needs its own per-secret grant instead.
gcloud projects remove-iam-policy-binding "$PROJECT_ID" \
  --member="serviceAccount:${PROJECT_NUMBER}@cloudbuild.gserviceaccount.com" \
  --role="roles/secretmanager.secretAccessor" --condition=None

# What remains project-wide (expect the deploying identity's secretmanager.admin)
gcloud projects get-iam-policy "$PROJECT_ID" --flatten="bindings[].members" \
  --filter="bindings.role~^roles/secretmanager\." \
  --format="table(bindings.role,bindings.members)"
Un compte d'application dédié (dedicated_service_account_id) n'a jamais détenu de rôle Secret Manager au niveau du projet et n'a besoin de rien ici. Pour annuler une révocation, exécutez la même commande avec add-iam-policy-binding.
support_users n'accorde aucun accès IAM. Son seul effet est d'ajouter des destinataires d'e-mail aux canaux de notification du budget de facturation Cloud, et seulement lorsque create_billing_budget = true ; les destinataires d'alertes Cloud Monitoring proviennent de notification_alert_emails avec configure_email_notification.
Console : IAM et administration → Comptes de service (confirmez l'existence des comptes de service de la plateforme) ; IAM (filtrez par e-mail de compte de service ou utilisateur de support pour afficher les liaisons).
# Confirm the platform service accounts were created
gcloud iam service-accounts list --project=PROJECT_ID \
  --format="table(displayName,email)"

# View the project's IAM policy bindings
gcloud projects get-iam-policy PROJECT_ID \
  --format="table(bindings.role,bindings.members)"
Workload Identity Federation
Crée éventuellement un pool et un fournisseur Workload Identity Federation afin que les identités CI/CD externes — GitHub Actions, GitLab CI ou tout fournisseur compatible OIDC — puissent s'authentifier auprès des API GCP à l'aide de jetons de courte durée, sans fichiers de clés de compte de service de longue durée. Les identités externes authentifiées peuvent usurper l'identité des comptes de service CI/CD de la plateforme. Le type de fournisseur ne peut pas être modifié après le provisionnement sans recréer le fournisseur.
Console : IAM et administration → Workload Identity Federation → sélectionnez le pool et le fournisseur pour afficher l'émetteur, les audiences et les conditions d'attributs autorisés.
# List Workload Identity pools
gcloud iam workload-identity-pools list \
  --location=global --project=PROJECT_ID \
  --format="table(name,displayName,state)"

# Describe a provider — view issuer and attribute mappings
gcloud iam workload-identity-pools providers describe PROVIDER_NAME \
  --workload-identity-pool=POOL_NAME \
  --location=global --project=PROJECT_ID
Binary Authorization
Applique éventuellement la provenance des images au moment du déploiement afin que seules les images de conteneurs portant une attestation cryptographique valide d'un attestateur de confiance puissent être déployées sur Cloud Run ou GKE dans le projet. L'attestateur et la clé de signature Cloud KMS sont provisionnés par le module ; les pipelines CI/CD signent les images au moment de la build. La politique s'applique à l'ensemble du projet sans option de désactivation par service. Modes d'évaluation : ALWAYS_ALLOW (tout autoriser — pour la configuration initiale), REQUIRE_ATTESTATION (le mode de production prévu) et ALWAYS_DENY (verrouillage d'urgence).
Console : Sécurité → Binary Authorization → Politique (mode d'évaluation) et Attestateurs (attestateurs de confiance et clés de signature).
# View the current Binary Authorization policy
gcloud container binauthz policy export --project=PROJECT_ID

# List configured attestors
gcloud container binauthz attestors list \
  --project=PROJECT_ID \
  --format="table(name,userOwnedGrafeasNote.noteReference)"

# Check whether a specific image has a valid attestation
gcloud container binauthz attestations list \
  --attestor=ATTESTOR_NAME \
  --attestor-project=PROJECT_ID \
  --artifact-url=IMAGE_URI
Chiffrement CMEK
Remplace éventuellement le chiffrement géré par Google par des clés gérées par le client via Cloud KMS. Un trousseau de clés et une clé de chiffrement symétrique sont provisionnés dans la région principale, et les ressources prises en charge (Cloud SQL, Cloud Storage, Artifact Registry, GKE) sont configurées pour les utiliser pour le chiffrement au repos. La clé tourne automatiquement selon un calendrier configurable, les versions plus anciennes étant conservées pour le déchiffrement. Planifiez le CMEK lors du déploiement initial — l'activation après le provisionnement des ressources avec des clés gérées par Google nécessite une migration des données, et les comptes de service doivent détenir le rôle de chiffreur/déchiffreur KMS ou la création de ressources échouera.
Console : Sécurité → Gestion des clés → confirmez le trousseau de clés et la clé dans la région principale ; vérifiez la période de rotation et l'état de la version de la clé primaire. Sur la vue d'ensemble d'une instance Cloud SQL, confirmez que le chiffrement affiche Customer-managed.
# List key rings in the primary region
gcloud kms keyrings list \
  --location=REGION --project=PROJECT_ID \
  --format="table(name,createTime)"

# List keys — view rotation period and primary key state
gcloud kms keys list \
  --keyring=KEYRING_NAME \
  --location=REGION --project=PROJECT_ID \
  --format="table(name,purpose,rotationPeriod,nextRotationTime,primary.state)"

# Confirm a Cloud SQL instance is encrypted with the CMEK key
gcloud sql instances describe INSTANCE_NAME \
  --project=PROJECT_ID \
  --format="yaml(diskEncryptionConfiguration,diskEncryptionStatus)"
VPC Service Controls
Établit éventuellement un périmètre VPC Service Controls autour du projet pour protéger contre l'exfiltration de données. Une fois appliqué, le périmètre restreint l'accès à l'API Google Cloud aux requêtes provenant de l'intérieur du périmètre — des identifiants IAM valides seuls ne suffisent pas depuis l'extérieur des réseaux autorisés. Le périmètre autorise les requêtes provenant des plages de sous-réseaux VPC, des plages d'adresses IP d'administrateur/opérateur, de l'agent de service IAP et des comptes de service CI/CD. La création du périmètre est ignorée avec un avertissement lorsque l'identité appelante ne dispose pas du rôle requis au niveau de l'organisation. Validez toujours en mode simulation (par défaut) pendant 24 à 72 heures avant de passer à l'application.
Console : Sécurité → VPC Service Controls (périmètre et mode). Pour les violations en mode simulation, utilisez Logging → Explorateur de journaux et filtrez sur le type de métadonnées d'audit VPC Service Control.
# List access policies in the organisation
gcloud access-context-manager policies list --organization=ORG_ID

# List perimeters within the access policy
gcloud access-context-manager perimeters list \
  --policy=POLICY_NAME \
  --format="table(name,status.resources,status.restrictedServices)"

# View dry-run violation logs
gcloud logging read \
  'protoPayload.metadata.@type="type.googleapis.com/google.cloud.audit.VpcServiceControlAuditMetadata"' \
  --project=PROJECT_ID \
  --limit=20 \
  --format="table(timestamp,protoPayload.serviceName,protoPayload.methodName)"
Security Command Center
Active éventuellement Security Command Center pour agréger les résultats de sécurité, les erreurs de configuration et les rapports de vulnérabilité de tous les services GCP dans un tableau de bord unique. Des détecteurs intégrés identifient les buckets de stockage accessibles publiquement, les comptes de service sur-privilégiés et les règles de pare-feu inutilisées. Les résultats de SCC peuvent éventuellement être acheminés vers un sujet Pub/Sub pour des alertes en temps réel ou une ingestion SIEM. La création de la configuration de notification est ignorée avec un avertissement lorsque l'identité appelante ne dispose pas du rôle requis au niveau de l'organisation.
L'analyse des vulnérabilités lors du push (Container Analysis) peut également être activée indépendamment pour les images Artifact Registry, et les journaux d'audit Cloud détaillés (Lecture de données et Écriture de données) peuvent être activés pour la conformité — les deux augmentent considérablement le volume et le coût des journaux.
Console : Sécurité → Security Command Center → Résultats (résultats actifs par gravité et source). Pour les analyses de vulnérabilités, Artifact Registry → sélectionnez une image → onglet Sécurité. Pour les notifications SCC, Pub/Sub → Sujets.
# List active Security Command Center findings
gcloud scc findings list PROJECT_ID \
  --source=- \
  --filter="state=ACTIVE" \
  --format="table(name,category,severity,eventTime)"

# Check which audit log types are enabled for the project
gcloud projects get-iam-policy PROJECT_ID \
  --format="yaml(auditConfigs)"

# List Pub/Sub topics — confirm SCC notification topic
gcloud pubsub topics list --project=PROJECT_ID \
  --format="table(name)"
Surveillance et budgets
Crée éventuellement des canaux de notification par e-mail Cloud Monitoring et des règles d'alerte pour l'utilisation des ressources d'infrastructure — CPU, mémoire et disque — sur les VM Compute Engine provisionnées par le module (principalement la VM NFS/Redis autogérée). Les règles d'alerte évaluent l'utilisation moyenne sur une fenêtre glissante et se déclenchent lorsque le seuil configuré est dépassé. Un budget de facturation Cloud avec des alertes de seuil par e-mail peut également être créé pour suivre et contrôler les dépenses GCP.
Console : Monitoring → Alertes → Canaux de notification et Règles ; Monitoring → Explorateur de métriques pour l'utilisation en temps réel. Facturation → Budgets et alertes pour le budget ; Facturation → Rapports pour la répartition des coûts.
# List Cloud Monitoring notification channels
gcloud beta monitoring channels list --project=PROJECT_ID \
  --format="table(displayName,type,labels.email_address,enabled)"

# List all alert policies
gcloud alpha monitoring policies list --project=PROJECT_ID \
  --format="table(displayName,enabled,conditions[0].displayName)"

# List budgets for the billing account
gcloud billing budgets list \
  --billing-account=BILLING_ACCOUNT_ID \
  --format="table(name,displayName,amount.specifiedAmount.units,thresholdRules)"
Variables de configuration
Les variables sont organisées en groupes qui correspondent aux sections affichées dans l'interface utilisateur de déploiement. Configurez un groupe à la fois avant de déployer.
Les entrées sont validées au moment de la planification. Le module applique des règles de valeur et de combinaison avant la création de toute ressource (il nécessite OpenTofu ≥ 1.9). Les valeurs invalides — un
tenant_idmal formé, un seuil hors limites, une version de base de données inexistante — et les combinaisons invalides — un réplica en lecture sans son primaire, un périmètre VPC-SC appliqué sans IPs autorisées, un add-on GKE sans cluster — font échouer la planification avec une erreur claire et nommée plutôt que d'apparaître comme un échec cryptique en milieu d'apply ou, pire, de réussir silencieusement sans rien faire. Chaque groupe ci-dessous note les règles qui s'appliquent. L'intention est qu'un plan déploie ce que vous avez demandé ou vous dise exactement pourquoi il ne peut pas le faire.
Groupe 1 — Projet et services principaux
Choisir vos services principaux. Ce groupe représente l'ensemble de décisions le plus important — il sélectionne les backends de données et de calcul auxquels chaque module d'application en aval se liera. Les indicateurs de base de données ne sont pas mutuellement exclusifs dans le code, mais choisissez délibérément par charge de travail :
create_postgrespour les applications relationnelles à usage général (le défaut sûr) ;create_mysqlspécifiquement pour les applications natives MySQL (WordPress, Moodle, OpenEMR) ;enable_alloydbau lieu de Postgres lorsque la charge de travail est axée sur l'analyse, les vecteurs ou l'IA (moteur en colonnes + pgvector/SCANN) ;create_firestorecomme complément, non comme remplacement, lorsqu'une application a besoin d'un magasin de documents sans serveur avec synchronisation en temps réel. L'activation de backends que vous n'utiliserez pas est la source la plus courante de coûts évitables — chacun est facturé qu'une application s'y connecte ou non. Définissezcreate_google_kubernetes_engine = trueuniquement si vous avez l'intention de déployer des modules d'application GKE ; les applications Cloud Run n'en ont pas besoin, et un cluster Autopilot inactif entraîne toujours des frais de plan de contrôle.
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | ID du projet GCP dans lequel toutes les ressources du module sont déployées. Le modifier après le déploiement initial recrée toutes les ressources dans le nouveau projet. |
tenant_id | "demo" | Identifiant court (lettres minuscules et chiffres uniquement, pas de tirets — appliqué au moment de la planification) utilisé comme préfixe de chaque nom de ressource. Ne jamais modifier après le déploiement initial — cela renommerait, et donc recréerait, chaque ressource. |
availability_regions | ["us-central1"] | Régions pour les ressources régionales (sous-réseaux, Cloud SQL, Redis). La première région est la principale ; une deuxième région active les réplicas en lecture inter-régions. 1 à 2 régions sont prises en charge, et vous devez fournir au moins un subnet_cidr_range par région (appliqué au moment de la planification). |
create_postgres | false | Provisionne une instance Cloud SQL PostgreSQL dans la région principale. Le choix généraliste pour les charges de travail relationnelles — mais désactivé par défaut, donc un déploiement qui a besoin de Postgres doit le demander. Les modules d'application qui le nécessitent déclarent create_postgres = true dans leur propre carte requires_services, que la plateforme lit lors du provisionnement automatique de ce module. |
create_mysql | false | Provisionne une instance Cloud SQL MySQL. Activez pour les applications natives MySQL (WordPress, Moodle, OpenEMR) ; désactivez sinon pour éviter une instance inutilisée. |
enable_alloydb | false | Non pris en charge — désactiver. alloydb.googleapis.com a été retiré de l'ensemble des API activées du module suite à une décision de coût explicite (PR #2673), donc enable_alloydb = true échoue à l'apply avec une erreur de service non activé à moins qu'un opérateur ne fournisse l'API via additional_apis (et les dossiers gérés par RAD le refusent dans la liste blanche des dossiers). Utilisez create_postgres à la place. |
create_firestore | false | Crée une base de données Firestore Native en édition Enterprise. Un magasin de documents sans serveur — paiement à l'utilisation, mise à l'échelle à zéro, donc faible risque à activer de manière spéculative. |
create_google_kubernetes_engine | false | Provisionne des clusters GKE. Doit être true avant de déployer tout module d'application GKE ; inutile (et un coût de plan de contrôle superflu) pour les déploiements uniquement Cloud Run. |
Groupe 2 — Notifications et étiquettes
| Variable | Valeur par défaut | Description |
|---|---|---|
support_users | [] | Adresses e-mail ajoutées comme destinataires pour les alertes de budget de facturation uniquement, et seulement lorsque create_billing_budget = true (fusionné avec budget_alert_emails). N'accorde aucun accès IAM et n'alimente pas les alertes Cloud Monitoring — les destinataires de la surveillance proviennent de notification_alert_emails avec configure_email_notification. Inerte tant que create_billing_budget = false. |
resource_labels | {} | Étiquettes clé-valeur appliquées à toutes les ressources créées par le module (centre de coûts, environnement, équipe). |
Groupe 3 — Réseau et VPC
| Variable | Valeur par défaut | Description |
|---|---|---|
subnet_cidr_range | ["10.0.0.0/24"] | Plages CIDR pour les sous-réseaux VPC, une par région de disponibilité. Doivent être des plages RFC 1918 valides et ne doivent pas se chevaucher entre elles ou avec les CIDR de pods/services GKE. Entre 1 et 2 plages prises en charge. |
Groupe 4 — Services de base de données et de stockage
Choisir la configuration de la base de données. Trois axes déterminent le coût et la résilience ici. Le type de disponibilité (
ZONALvsREGIONAL) est le plus important :ZONALest moins cher mais une panne de zone unique met la base de données — et toutes les applications qui en dépendent — complètement hors ligne ;REGIONALdouble approximativement le coût de l'instance en échange d'un standby à chaud automatique et d'un basculement en moins d'une minute, et est le bon choix pour toute application de production. Le niveau (*_tier) définit le vCPU/la mémoire : un sous-provisionnement se manifeste par une latence des requêtes et une accumulation de la file d'attente de connexions, donc dimensionnez-le en fonction de la charge soutenue et augmentez-le lorsque le CPU se maintient au-dessus de ~70 %. Les réplicas en lecture déchargent le trafic à forte lecture et fournissent une cible de promotion DR — cela vaut la peine une fois qu'un seul primaire est limité en lecture, et est exempt de sortie inter-régions uniquement si vous les maintenez dans la région primaire (configurez une deuxième entréeavailability_regionspour la localité/DR inter-régions). Un réplica sans son primaire (create_*_read_replica = truealors quecreate_* = false) est rejeté au moment de la planification plutôt que de ne rien faire silencieusement. Ajustez*_database_flags(notammentmax_connections) en fonction du nombre de réplicas/applications pour éviter l'épuisement detoo many clients. Pour AlloyDB, dimensionnezalloydb_cpu_countà la charge de travail analytique et n'ajoutez un pool de lecture que lorsque le débit de lecture nécessite réellement une mise à l'échelle horizontale.
Cloud SQL — PostgreSQL
| Variable | Valeur par défaut | Description |
|---|---|---|
postgres_database_version | "POSTGRES_17" | Version du moteur PostgreSQL (POSTGRES_17 / POSTGRES_16 / POSTGRES_15 / POSTGRES_14). La rétrogradation n'est pas prise en charge. |
postgres_database_availability_type | "ZONAL" | ZONAL (zone unique, dev/test) ou REGIONAL (HA avec basculement automatique, recommandé pour la production). |
postgres_tier | "db-custom-1-3840" | Type de machine (vCPU / mémoire) pour l'instance PostgreSQL. Limité à 2 vCPU dans un projet géré par RAD (gcp-rad-*) : un lifecycle.precondition dans pgsql.tf n'admet que db-f1-micro, db-g1-small, db-custom-1-* et db-custom-2-*, et fait échouer le plan sinon. Un projet apporté par vous-même n'est pas touché — vous choisissez la taille et la payez. |
postgres_database_flags | [{ name = "max_connections", value = "200" }] | Paramètres du serveur PostgreSQL. Certains changements de drapeaux nécessitent un redémarrage de l'instance. |
create_postgres_read_replica | false | Provisionne des réplicas en lecture pour l'instance PostgreSQL. |
postgres_read_replica_count | 1 | Nombre de réplicas en lecture PostgreSQL (inter-régions lorsqu'une deuxième région est configurée). Nombre entier de 0 à 10 ; dans un projet géré par RAD, au maximum 1 (bac à sable, lab) ou 2 (développement, production). |
enable_cloudsql_iam_auth | false | Active l'authentification de base de données IAM Cloud SQL sur toutes les instances, éliminant la rotation des mots de passe. |
Cloud SQL — MySQL
| Variable | Valeur par défaut | Description |
|---|---|---|
mysql_database_version | "MYSQL_8_4" | Version du moteur MySQL (MYSQL_8_4 / MYSQL_8_0 / MYSQL_5_7). La rétrogradation n'est pas prise en charge. |
mysql_database_availability_type | "ZONAL" | ZONAL (zone unique) ou REGIONAL (HA). REGIONAL recommandé pour la production. |
mysql_tier | "db-custom-1-3840" | Type de machine pour l'instance MySQL. Limité à 2 vCPU dans un projet géré par RAD (gcp-rad-*) par le lifecycle.precondition correspondant dans mysql.tf — même ensemble autorisé que postgres_tier. |
mysql_database_flags | [{ name = "max_connections", value = "200" }, { name = "local_infile", value = "off" }] | Variables du serveur MySQL. Les valeurs par défaut désactivent local_infile comme bonne pratique de sécurité. |
create_mysql_read_replica | false | Provisionne des réplicas en lecture pour l'instance MySQL. |
mysql_read_replica_count | 1 | Nombre de réplicas en lecture MySQL (inter-régions lorsqu'une deuxième région est configurée). Nombre entier de 0 à 10 ; dans un projet géré par RAD, au maximum 1 (bac à sable, lab) ou 2 (développement, production). |
Cloud SQL — Paramètres de maintenance partagés
| Variable | Valeur par défaut | Description |
|---|---|---|
sql_maintenance_window_day | 7 | Jour de la semaine (1=Lun … 7=Dim) pour la fenêtre de maintenance Cloud SQL sur les instances primaires. |
sql_maintenance_window_hour | 3 | Heure (0–23, UTC) pour la fenêtre de maintenance Cloud SQL. |
sql_maintenance_update_track | "stable" | Piste de maintenance : canary (précoce), stable, ou week5. |
enable_query_insights | false | Active Cloud SQL Query Insights sur les primaires PostgreSQL et MySQL (sans coût supplémentaire). |
AlloyDB
| Variable | Valeur par défaut | Description |
|---|---|---|
alloydb_cpu_count | 2 | vCPU par instance AlloyDB (2 / 4 / 8 / 16 / 32 / 64). Utilisé uniquement lorsque enable_alloydb = true. |
alloydb_database_flags | [] | Indicateurs PostgreSQL appliqués à l'instance primaire AlloyDB. |
enable_alloydb_read_pool | false | Provisionne un pool de lecture AlloyDB pour le déchargement analytique. |
alloydb_read_pool_node_count | 1 | Nombre de nœuds dans le pool de lecture AlloyDB (1–20). Utilisé uniquement lorsque enable_alloydb_read_pool = true. |
Firestore
| Variable | Valeur par défaut | Description |
|---|---|---|
firestore_database_id | "" | ID de la base de données Firestore (généré automatiquement comme firestore-db-<random_id> si vide). Utilisé uniquement lorsque create_firestore = true. |
firestore_location_id | "" | Emplacement Firestore (par défaut la région principale si vide). Utilisé uniquement lorsque create_firestore = true. |
Stockage et cache : une décision, trois groupes. Les groupes 5, 6 et 7 offrent les mêmes deux capacités — stockage de fichiers partagés (NFS) et un cache Redis — selon deux modèles de livraison. Autogéré (Groupe 5) regroupe les deux sur une seule petite VM : de loin le moins cher, pas de SLA, un seul point de défaillance, convient pour le développement et les déploiements sensibles aux coûts. Géré (Groupes 6 et 7) les divise en Memorystore Redis et Cloud Filestore : avec SLA, compatible HA, patché par Google, et donc plus cher. Choisissez un seul modèle — l'exécution de la VM autogérée aux côtés de Filestore géré crée deux partages NFS indépendants (split-brain : une écriture sur l'un est invisible pour les clients de l'autre). Les valeurs par défaut vous donnent intentionnellement la VM à faible coût (
create_network_filesystem = true) et désactivent les services gérés ; si vous passez au mode géré, définissezcreate_network_filesystem = falseen premier.
Groupe 5 — NFS et Redis autogérés
| Variable | Valeur par défaut | Description |
|---|---|---|
create_network_filesystem | true | Provisionne une VM Compute Engine en tant que serveur NFS et cache Redis combinés. L'alternative moins coûteuse à Filestore et Memorystore gérés ; pas de SLA et un seul point de défaillance — convient pour le dev/test, pas pour la production. |
network_filesystem_machine | "e2-small" | Type de machine Compute Engine pour la VM NFS/Redis. Sous-dimensionné pour un NFS à haut débit ou de grands ensembles de données Redis — passez à e2-medium/n2-standard-2 pour une utilisation plus intensive. |
network_filesystem_capacity | 10 | Taille en Go du disque persistant pour les données NFS. Peut être augmentée mais pas diminuée — provisionnez généreusement, car un disque plein provoque des échecs d'écriture ENOSPC de l'application. |
Groupe 6 — Redis géré (Memorystore)
Choisir la configuration Redis. Le choix crucial est le niveau :
BASICest un nœud unique sans réplication — un événement de maintenance ou une défaillance de nœud vide l'ensemble des données et (pour les magasins de sessions) déconnecte tous les utilisateurs ;STANDARD_HAajoute un réplica inter-zone avec basculement automatique pour environ le double du coût, et est le seul niveau sur lequel la persistance (instantanésRDBouAOF) prend effet. Pour tout ce qui contient un état important lors d'un basculement — sessions, compteurs de limite de débit, files d'attente de tâches — utilisezSTANDARD_HAavec un mode de persistance non-DISABLED(une instanceSTANDARD_HAde production laissée àDISABLEDest rejetée au moment de la planification). La définition de la persistance surBASICest également rejetée, car elle serait ignorée silencieusement.redis_connect_modene peut pas être modifié après la création, alors décidez du peering ou de l'accès aux services privés dès le départ.
| Variable | Valeur par défaut | Description |
|---|---|---|
create_redis | false | Provisionne une instance Cloud Memorystore Redis. Activez uniquement lorsque create_network_filesystem = false pour éviter une infrastructure redondante. |
redis_tier | "BASIC" | BASIC (nœud unique, pas de réplication — cache uniquement) ou STANDARD_HA (basculement inter-zone, ~2× coût — requis pour un état durable). |
redis_memory_size_gb | 1 | Capacité mémoire en Go (1–300). Dimensionnez en fonction de l'ensemble de travail + marge ; une instance sous-dimensionnée expulse les clés chaudes. |
redis_version | "REDIS_7_2" | Version du moteur Redis (REDIS_7_2 / REDIS_7_0 / REDIS_6_X). |
redis_connect_mode | "DIRECT_PEERING" | DIRECT_PEERING (plus simple, convient à la plupart) ou PRIVATE_SERVICE_ACCESS (segmentation plus stricte). Ne peut pas être modifié après la création. |
redis_persistence_mode | "DISABLED" | Mode de persistance (effectif sur STANDARD_HA uniquement — appliqué) : DISABLED, RDB (instantanés périodiques), ou AOF (perte minimale, surcharge d'écriture plus élevée). |
redis_rdb_snapshot_period | "ONE_HOUR" | Intervalle d'instantanés RDB. Utilisé uniquement lorsque redis_persistence_mode = "RDB". |
Groupe 7 — Filestore NFS géré
Choisir la configuration Filestore. Le niveau définit à la fois les performances et la capacité minimale que vous devez payer :
BASIC_HDD(≥ 1024 Go) pour un débit standard sensible aux coûts ;BASIC_SSD(≥ 2560 Go) pour des IOPS plus élevées ;ENTERPRISE(≥ 1024 Go) pour les performances les plus élevées avec une disponibilité multi-zone régionale. Le minimum niveau↔capacité est appliqué au moment de la planification, de sorte qu'unBASIC_SSDsous-dimensionné échoue rapidement plutôt qu'au niveau de l'API. Le niveau ne peut pas être modifié après le provisionnement, et la capacité ne peut qu'augmenter — choisissez donc le niveau délibérément et commencez avec une marge réaliste.
| Variable | Valeur par défaut | Description |
|---|---|---|
create_filestore_nfs | false | Provisionne une instance Cloud Filestore NFS. Activez uniquement lorsque create_network_filesystem = false. |
filestore_tier | "BASIC_HDD" | BASIC_HDD (min 1024 Go), BASIC_SSD (min 2560 Go), ou ENTERPRISE (min 1024 Go, HA régionale). Ne peut pas être modifié après le provisionnement. |
filestore_capacity_gb | 1024 | Capacité en Go. Minimum par niveau appliqué au moment de la planification. Peut être augmentée mais pas diminuée après le provisionnement. |
Groupe 8 — Google Kubernetes Engine
Choisir la configuration GKE. Par défaut,
AUTOPILOT— Google gère le provisionnement, la mise à l'échelle et le renforcement des nœuds, vous êtes facturé par pod, et les variablesgke_node_*sont entièrement ignorées. Passez àSTANDARDuniquement lorsqu'une charge de travail nécessite un contrôle qu'Autopilot ne fournit pas : types de machines spécifiques, SSD local ou planification sensible à la latence (par exemple, le service History de Temporal). En mode Standard, les variables du pool de nœuds s'appliquent, etgke_node_min_count ≤ gke_node_initial_count ≤ gke_node_max_countest appliqué au moment de la planification. Les variables CIDR sont les paramètres les plus risqués de ce groupe : les plages de nœuds, de pods et de services ne doivent pas se chevaucher entre elles ni avecsubnet_cidr_range, et la plage de pods doit être suffisamment grande pour votre nombre maximal de pods — les chevauchements entraînent l'échec de la création du cluster, et un CIDR de pods sous-dimensionné provoque des échecs de planificationno available IP addressesplus tard. Les valeurs par défaut sont dimensionnées pour une utilisation typique ; ne les modifiez qu'avec un plan IP délibéré. Les trois add-ons Fleet nécessitent chacun un cluster (create_google_kubernetes_engine = true, appliqué) et ajoutent une surcharge de réconciliation continue — activez-les lorsque vous utilisez réellement mTLS (Service Mesh), GitOps (Config Sync) ou l'application de politiques (Policy Controller), pas par défaut.
Paramètres du cluster
| Variable | Valeur par défaut | Description |
|---|---|---|
gke_cluster_name_prefix | "gke-cluster" | Préfixe pour les noms de cluster ; un index basé sur 1 est ajouté (par exemple, gke-cluster-1). Ne pas modifier après le provisionnement. |
gke_cluster_count | 1 | Nombre de clusters GKE à provisionner (1–10). |
gke_cluster_mode | "AUTOPILOT" | AUTOPILOT (recommandé, entièrement géré) ou STANDARD (contrôle manuel du pool de nœuds). |
gke_autoscaling_profile | "BALANCED" | BALANCED (priorité à la disponibilité) ou OPTIMIZE_UTILIZATION (réduction agressive). |
CIDR réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
gke_subnet_base_cidr | "10.128.0.0/12" | CIDR de base pour les sous-réseaux de nœuds GKE. Ne doit pas chevaucher les CIDR de sous-réseau, de pod ou de service. |
gke_pod_base_cidr | "10.64.0.0/10" | CIDR de base pour les plages d'adresses IP des pods. Ne doit pas chevaucher d'autres CIDR. |
gke_service_base_cidr | "10.8.0.0/16" | CIDR de base pour les plages ClusterIP des services Kubernetes. Ne doit pas chevaucher d'autres CIDR. |
gke_master_base_cidr | "172.16.0.0/16" | CIDR de base à partir duquel la plage privée du plan de contrôle (un /28 par cluster) est découpée. Délibérément dans un bloc RFC1918 différent (172.16.0.0/12, pas 10.x) des trois ci-dessus, afin qu'il ne puisse jamais entrer en collision avec eux quelle que soit leur taille. Requis car les clusters fonctionnent avec des nœuds privés — le plan de contrôle d'un cluster privé a toujours besoin de son propre /28 dédié, que son point de terminaison API soit privé ou non. |
Pool de nœuds en mode Standard (ignoré en Autopilot)
| Variable | Valeur par défaut | Description |
|---|---|---|
gke_node_machine_type | "e2-standard-4" | Type de machine du pool de nœuds pour le mode Standard. |
gke_node_initial_count | 1 | Nombre initial de nœuds par zone (1–10), ajusté par l'autoscaler. |
gke_node_min_count | 1 | Nombre minimum de nœuds par zone maintenu par l'autoscaler (0–10). |
gke_node_max_count | 5 | Nombre maximum de nœuds par zone que l'autoscaler peut atteindre (1–100). |
gke_node_disk_size_gb | 50 | Taille du disque de démarrage par nœud en Go (10–65536). Par défaut 50 plutôt que 100 pour maintenir une marge sous la politique d'organisation custom.devDiskSizeCeiling du niveau de développement, qui plafonne un disque individuel à 100 Go — l'ancienne valeur par défaut était exactement à ce plafond, donc toute augmentation était rejetée. |
gke_node_disk_type | "pd-balanced" | Type de disque de démarrage : pd-balanced, pd-ssd, ou pd-standard. |
Add-ons Fleet
| Variable | Valeur par défaut | Description |
|---|---|---|
configure_cloud_service_mesh | false | Active Cloud Service Mesh (Istio géré) avec mTLS et gestion du trafic. Nécessite create_google_kubernetes_engine = true. |
configure_config_management | false | Active Config Sync pour la réconciliation GitOps à partir d'un dépôt Git. Nécessite create_google_kubernetes_engine = true. |
configure_policy_controller | false | Active Policy Controller (OPA Gatekeeper) pour l'application de la conformité. Nécessite create_google_kubernetes_engine = true. |
Groupe 9 — Sauvegarde et restauration GKE
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_gke_backup | false | Active la sauvegarde pour GKE sur les clusters provisionnés. Nécessite create_google_kubernetes_engine = true. |
gke_backup_retention_days | 30 | Jours de rétention des instantanés de sauvegarde GKE (1–365). |
gke_backup_schedule | "0 3 * * *" | Planification Cron (UTC) pour les jobs de sauvegarde GKE automatiques. |
Groupe 11 — Contrôles de service VPC
Choisir la configuration VPC-SC — à manipuler avec précaution. C'est la fonctionnalité du module ayant le plus grand rayon d'action : un périmètre appliqué restreint tout accès à l'API Google aux requêtes provenant de l'intérieur, de sorte que les identifiants IAM valides seuls cessent de fonctionner en dehors de la liste blanche. Le chemin sûr est non négociable : activez avec
vpc_sc_dry_run = true(la valeur par défaut), surveillez les journaux d'audit pour les entréesPOLICY_VIOLATIONpendant 24 à 72 heures, ajoutez chaque IP/réseau légitime àadmin_ip_ranges/vpc_cidr_ranges, puis définissezvpc_sc_dry_run = false. L'application avec unadmin_ip_rangesvide vous bloquerait l'accès à votre propre projet — cette combinaison spécifique est maintenant rejetée au moment de la planification, mais le risque plus large d'une liste blanche incomplète vous incombe de le gérer via le mode simulation (dry-run). N'activez ceci que lorsque le contrôle de l'exfiltration de données est une exigence réelle.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vpc_sc | false | Crée un périmètre de contrôles de service VPC autour du projet. Toujours activer avec vpc_sc_dry_run = true en premier. |
vpc_cidr_ranges | [] | Plages CIDR de sous-réseaux VPC autorisées à travers le périmètre. Utilisé uniquement lorsque enable_vpc_sc = true. |
admin_ip_ranges | [] | Plages CIDR d'adresses IP d'administrateur/opérateur autorisées à travers le périmètre (bureau, VPN, exécuteurs CI/CD). Obligatoire (non vide) lors de l'application — enable_vpc_sc = true avec vpc_sc_dry_run = false et aucune plage est rejeté au moment de la planification. |
vpc_sc_dry_run | true | true = audit uniquement (violations journalisées, non bloquées). Définir à false seulement après avoir examiné les journaux du mode simulation (dry-run). |
Groupe 12 — Autorisation binaire
Choisir la configuration de l'autorisation binaire. L'état final souhaité est
REQUIRE_ATTESTATION— seules les images signées par votre attestateur CI/CD peuvent être déployées sur Cloud Run ou GKE à l'échelle du projet. Mais l'ordre des opérations est important : passer àREQUIRE_ATTESTATIONavant que le pipeline de signature ne produise des attestations valides bloque chaque déploiement dans le projet — et cela ne peut pas être annulé depuis ce module. La mise à jour de la politique est additive et uniquement d'escalade (plusieurs locataires partagent une politique de projet), donc la remise debinauthz_evaluation_modeàALWAYS_ALLOWest ignorée : l'apply réussit, enregistre un AVERTISSEMENT, et la politique en direct reste appliquée. La récupération se fait hors bande avecgcloud container binauthz policy import <file>. Activez d'abord avecALWAYS_ALLOW, mettez en place le pipeline d'attestation, confirmez que les images sont signées, puis resserrez àREQUIRE_ATTESTATION.ALWAYS_DENYest un interrupteur de verrouillage d'urgence, pas un paramètre normal.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_binary_authorization | false | Active la vérification d'image au moment du déploiement de l'autorisation binaire pour le projet. S'applique à l'échelle du projet, sans option de désactivation par service. |
binauthz_evaluation_mode | "ALWAYS_ALLOW" | ALWAYS_ALLOW (configuration initiale — tout autoriser), REQUIRE_ATTESTATION (production — appliquer les signatures), ou ALWAYS_DENY (verrouillage d'urgence — tout bloquer). |
Groupe 14 — Clés de chiffrement gérées par le client (CMEK)
Choisir la configuration CMEK — décider au jour zéro. CMEK vous donne le contrôle sur le cycle de vie des clés de chiffrement au repos pour Cloud SQL, Cloud Storage, Artifact Registry et GKE. Le point critique est le timing : l'activer sur un nouveau déploiement est transparent, mais l'activer après que des ressources existent déjà avec des clés gérées par Google nécessite une migration de données. C'est une fonctionnalité de conformité/gouvernance — activez-la uniquement si la garde des clés est une exigence réelle, et si c'est le cas, activez-la dès le premier déploiement.
cmek_key_rotation_periodéchange l'hygiène cryptographique contre l'agitation opérationnelle ; la valeur par défaut de 90 jours est un équilibre judicieux.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_cmek | false | Provisionne des clés Cloud KMS pour le chiffrement géré par le client de Cloud SQL, Cloud Storage, Artifact Registry et GKE. Décider lors du déploiement initial — la rétro-ingénierie nécessite une migration de données. |
cmek_key_rotation_period | "7776000s" | Période de rotation automatique des clés KMS sous forme de durée en secondes avec un suffixe s (par défaut 90 jours). |
Groupe 16 — Fédération d'identité de charge de travail
Choisir la configuration WIF — le champ de restriction est obligatoire en pratique. WIF permet aux CI/CD externes (GitHub Actions, GitLab CI, tout fournisseur OIDC) d'emprunter l'identité des comptes de service de la plateforme avec des jetons de courte durée au lieu de fichiers de clés de longue durée — une amélioration de sécurité stricte si la portée est correctement définie. Le piège est le champ de portée : pour
github, unwif_github_orgvide supprime la restrictionrepository_owner, de sorte que tout dépôt GitHub sur Internet pourrait échanger un jeton et emprunter l'identité de votre SA ; pourgeneric, unwif_oidc_issuer_urivide/invalide fait simplement échouer la création du fournisseur. Les deux sont maintenant détectés au moment de la planification —githubnécessitewif_github_org, etgenericnécessite un émetteurhttps://— mais le point sous-jacent demeure : toujours épingler la fédération à votre organisation/émetteur/audience.wif_provider_typene peut pas être modifié après le provisionnement sans recréer le fournisseur.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_workload_identity_federation | false | Crée un pool et un fournisseur WIF pour l'authentification CI/CD sans clé (pas de fichiers de clés de compte de service). |
wif_provider_type | "github" | Type de fournisseur : github, gitlab, ou generic. Ne peut pas être modifié après le provisionnement. |
wif_github_org | "" | Organisation GitHub pour restreindre l'échange de jetons. Obligatoire lorsque wif_provider_type = "github" (appliqué) — une valeur vide permettrait à tout dépôt d'emprunter l'identité du compte de service. |
wif_gitlab_hostname | "gitlab.com" | Nom d'hôte GitLab pour l'émetteur OIDC. Utilisé uniquement lorsque wif_provider_type = "gitlab". |
wif_oidc_issuer_uri | "" | URI de l'émetteur OIDC pour un fournisseur générique. Doit être une URL https:// — obligatoire et validée lorsque wif_provider_type = "generic". |
wif_allowed_audiences | [] | Audiences de jetons OIDC autorisées. Utilisé uniquement lorsque wif_provider_type = "generic". |
Groupe 17 — Sécurité, audit et conformité
Choisir la configuration de sécurité et d'audit. Ce sont en grande partie des commutateurs indépendants et à faible risque dont le coût principal est la dépense d'observabilité plutôt que le rayon d'action.
enable_vulnerability_scanningest une assurance bon marché — détection CVE par scan-on-push qui alimente également l'attestation d'autorisation binaire.enable_security_command_centercentralise les résultats ;enable_scc_notificationsles achemine vers Pub/Sub pour l'alerte/SIEM et nécessite que SCC soit activé (la combinaison est vérifiée au moment de la planification). Le seul à activer délibérément estenable_audit_logging: les journaux d'audit de lecture/écriture de données sont inestimables pour la conformité mais peuvent multiplier le coût d'ingestion de Cloud Logging — activez-le pour les environnements réglementés, pas par réflexe.
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vulnerability_scanning | false | Active l'analyse CVE par scan-on-push de Container Analysis pour les images Artifact Registry. Faible coût, grande valeur. |
enable_audit_logging | false | Active les journaux d'audit Cloud de lecture et d'écriture de données pour tous les services pris en charge. Augmente considérablement le volume et le coût des journaux — activez pour la conformité, pas par défaut. |
enable_security_command_center | false | Active Security Command Center pour les résultats de sécurité centralisés. |
enable_scc_notifications | false | Acheminer les résultats SCC vers un sujet Pub/Sub. Nécessite enable_security_command_center = true (appliqué au moment de la planification). |
Groupe 18 — Cloud Monitoring et alertes
Choisir la configuration des alertes. Faible enjeu mais facile à rendre inerte. Les seuils (0–100, appliqués) surveillent principalement la VM NFS/Redis autogérée, ils sont donc plus importants lorsque
create_network_filesystem = true. L'erreur courante est d'activerconfigure_email_notificationavec unnotification_alert_emailsvide — le canal est créé sans destinataires et chaque alerte est silencieusement ignorée. Si vous activez les alertes, fournissez au moins une adresse.
| Variable | Valeur par défaut | Description |
|---|---|---|
configure_email_notification | false | Crée un canal de notification par e-mail Cloud Monitoring pour les politiques d'alerte de seuil de CPU, de mémoire et de disque. À associer à un notification_alert_emails non vide. |
notification_alert_emails | [] | Adresses e-mail pour les notifications d'alerte d'infrastructure. Utilisé uniquement lorsque configure_email_notification = true. |
alert_cpu_threshold | 80 | Utilisation du CPU en % au-dessus de laquelle une alerte est déclenchée (0–100, appliquée). |
alert_memory_threshold | 80 | Utilisation de la mémoire en % au-dessus de laquelle une alerte est déclenchée (0–100, appliquée). |
alert_disk_threshold | 80 | Utilisation du disque en % au-dessus de laquelle une alerte est déclenchée (0–100, appliquée). |
Groupe 19 — Facturation et budget
Choisir la configuration du budget. Un garde-fou bon marché contre les dépenses incontrôlées. La seule subtilité est
budget_alert_thresholds: ce sont des fractions debudget_amount, pas des pourcentages —0.5signifie 50 %. Entrer50ne déclencherait qu'à 5000 % du budget (c'est-à-dire jamais), donc le module restreint chaque valeur à la plage(0, 1]au moment de la planification. Comme pour la surveillance, fournissezbudget_alert_emailsou les alertes n'auront nulle part où aller.
| Variable | Valeur par défaut | Description |
|---|---|---|
create_billing_budget | false | Crée un budget de facturation Cloud avec des alertes de seuil de dépenses. Nécessite un accès au compte de facturation. |
budget_alert_emails | [] | Adresses e-mail pour les notifications d'alerte de budget de facturation. |
budget_amount | 100 | Limite budgétaire mensuelle en USD. |
budget_alert_thresholds | [0.5, 0.9, 1.0] | Seuils de dépenses sous forme de fractions de budget_amount (chacun dans (0, 1], appliqué) auxquels les alertes se déclenchent — 0.5 = 50 %, pas 50. |
Sorties
Après un déploiement réussi, les valeurs suivantes sont disponibles dans l'interface utilisateur de la plateforme et sont consommées par les modules d'application en aval.
| Sortie | Description |
|---|---|
deployment_id | ID hexadécimal aléatoire utilisé comme suffixe dans tous les noms de ressources. |
primary_region | La région GCP principale où les ressources à région unique sont provisionnées. |
host_project_id | L'ID du projet GCP dans lequel toutes les ressources ont été déployées. |
vpc_network_name | Nom du réseau VPC. |
vpc_network_id | ID complet de la ressource du réseau VPC. |
cloudrun_service_account | E-mail du compte de service Cloud Run. |
cloudbuild_service_account | E-mail du compte de service Cloud Build. |
nfs_server_ip | IP interne statique de la VM du serveur NFS (lorsque create_network_filesystem = true). |
redis_on_nfs_server_ip | IP interne statique de la VM combinée NFS/Redis (lorsque create_network_filesystem = true). |
redis_on_nfs_connection_string | URI de connexion Redis redis://{ip}:6379 (lorsque create_network_filesystem = true). |
postgres_instance_ip | IP privée de l'instance Cloud SQL PostgreSQL (lorsque create_postgres = true). |
postgres_instance_connection_name | Nom de connexion PostgreSQL pour Cloud SQL Auth Proxy (lorsque create_postgres = true). |
mysql_instance_ip | IP privée de l'instance Cloud SQL MySQL (lorsque create_mysql = true). |
mysql_instance_connection_name | Nom de connexion MySQL pour Cloud SQL Auth Proxy (lorsque create_mysql = true). |
redis_host | IP hôte de l'instance Memorystore Redis (lorsque create_redis = true). |
redis_port | Port de l'instance Memorystore Redis (lorsque create_redis = true). |
redis_connection_string | Chaîne de connexion Memorystore Redis {host}:{port} (lorsque create_redis = true). |
filestore_ip | IP privée du serveur Filestore NFS (lorsque create_filestore_nfs = true). |
filestore_name | Nom de l'instance Filestore (lorsque create_filestore_nfs = true). |
filestore_file_share_name | Nom du partage de fichiers NFS Filestore exporté (lorsque create_filestore_nfs = true). |
alloydb_cluster_name | Nom du cluster AlloyDB (lorsque enable_alloydb = true). |
alloydb_primary_ip | IP privée de l'instance primaire AlloyDB (lorsque enable_alloydb = true). |
alloydb_read_pool_ip | IP privée de l'instance du pool de lecture AlloyDB (lorsque enable_alloydb + enable_alloydb_read_pool). |
gke_cluster_name | Nom du cluster GKE primaire (lorsque create_google_kubernetes_engine = true). |
gke_cluster_endpoint | Point de terminaison du cluster GKE primaire (sensible ; lorsque create_google_kubernetes_engine = true). |
gke_cluster_ca_certificate | Certificat CA du cluster GKE primaire (sensible ; lorsque create_google_kubernetes_engine = true). |
gke_cluster_location | Région du cluster GKE primaire (lorsque create_google_kubernetes_engine = true). |
gke_cluster_mode | "single" ou "multi", déterminé à partir du nombre de clusters (lorsque create_google_kubernetes_engine = true). |
gke_service_account_email | E-mail du compte de service du nœud GKE (lorsque create_google_kubernetes_engine = true). |
gke_clusters | Carte de tous les détails du cluster — nom, point de terminaison, certificat CA, emplacement et CIDR (sensible ; lorsque create_google_kubernetes_engine = true). |
gke_mci_config_cluster | Nom du cluster de configuration pour l'Ingress multi-cluster (GKE multi-cluster). |
gke_fleet_membership_ids | ID d'adhésion à la flotte pour tous les clusters (GKE avec Config Management, Policy Controller ou Service Mesh). |
artifact_registry_repository_name | Nom du dépôt Artifact Registry partagé. |
artifact_registry_repository_location | Région du dépôt Artifact Registry. |
artifact_registry_repository_project | ID du projet du dépôt Artifact Registry. |
storage_kms_key_name | Nom de la ressource de clé Cloud KMS utilisée pour le chiffrement Cloud Storage (lorsque enable_cmek = true). |
binauthz_attestor_name | Nom de l'attestateur d'autorisation binaire (lorsque enable_binary_authorization = true). |
binauthz_kms_key_id | ID de la clé KMS utilisée pour la signature d'attestation (lorsque enable_binary_authorization = true). |
binauthz_note_id | ID de la note Container Analysis pour l'autorisation binaire (lorsque enable_binary_authorization = true). |
Pièges de configuration et valeurs par défaut judicieuses
Étant donné que Services GCP est la couche de plateforme dont dépend chaque module d'application, une mauvaise configuration ici peut bloquer tous les déploiements en aval simultanément.
Niveaux de risque : Critique (perte de données, panne totale, faille de sécurité) — Élevé (service indisponible ou dégradation significative) — Moyen (fonction dégradée ou coût accru) — Faible (impact mineur).
Beaucoup de ces problèmes sont maintenant détectés au moment de la planification. Les lignes marquées 🛡 plan-time sont validées avant la création de toute ressource — le plan échoue avec une erreur claire et nommée, de sorte que vous n'atteignez jamais la conséquence décrite. Les lignes restantes (chevauchement CIDR, dimensionnement des niveaux, ZONAL en production) sont des jugements que le module ne peut pas décider en toute sécurité pour vous ; elles sont listées afin que vous preniez la décision délibérément. Un plan propre est votre confirmation que les règles de valeur/combinaison ont été respectées — mais il ne valide pas les choix de dimensionnement ou de topologie.
Fiabilité du provisionnement. Les ressources lentes à créer comportent des
timeoutsexplicites et généreux afin qu'un provisionnement lent normal ne soit jamais abandonné en cours d'apply : Cloud SQL et AlloyDB jusqu'à 60 minutes, clusters GKE 40 à 60 minutes, Memorystore/Filestore et la connexion Private Service Access 30 minutes. Vous n'avez pas besoin de surveiller un long apply. Si une erreur d'API transitoire (ou une credential qui expire pendant un très long apply) laisse toujours une ressource active dans GCP mais absente de l'état Terraform, relancez le déploiement — un état partiel se termine simplement ; une ressource qui signale "existe déjà" peut être importée dans l'état plutôt que recréée. Voir la phase Dépannage et débogage du lab pour les commandes de récupération exactes.
| Variable | Valeur par défaut judicieuse | Risque | Conséquence d'une valeur incorrecte |
|---|---|---|---|
tenant_id | alphanumérique en minuscules, défini une seule fois | Élevé 🛡 plan-time | Les majuscules, les tirets ou les underscores sont rejetés au moment de la planification — il préfixe chaque nom de ressource et les caractères invalides briseraient autrement le nommage GCP sur des dizaines de ressources. Le modifier ultérieurement renomme (recrée) tout. |
wif_github_org (avec wif_provider_type = "github") | votre organisation GitHub | Critique 🛡 plan-time | Vide supprime la restriction repository_owner, permettant à tout dépôt GitHub d'emprunter l'identité des comptes de service de la plateforme. Maintenant rejeté au moment de la planification lorsque WIF + github est activé. |
wif_oidc_issuer_uri (avec wif_provider_type = "generic") | votre émetteur https:// | Élevé 🛡 plan-time | Un émetteur vide/non-HTTPS échoue à la création du fournisseur ; maintenant validé au moment de la planification. |
create_*_read_replica sans create_* | correspondre au primaire | Moyen 🛡 plan-time | Auparavant, le réplica était silencieusement supprimé (vous pensiez avoir des réplicas ; vous n'en aviez aucun). Maintenant rejeté au moment de la planification. |
enable_alloydb_read_pool sans enable_alloydb | correspondre au cluster | Moyen 🛡 plan-time | Pool de lecture silencieusement supprimé sans cluster AlloyDB ; maintenant rejeté au moment de la planification. |
enable_scc_notifications sans enable_security_command_center | activer SCC d'abord | Faible 🛡 plan-time | Configuration de notification silencieusement ignorée sans SCC ; maintenant rejetée au moment de la planification. |
gke_node_min_count / gke_node_max_count (mode Standard) | min ≤ initial ≤ max | Moyen 🛡 plan-time | min > max est une configuration d'autoscaler invalide qui échoue à la création du pool de nœuds ; l'ordre est maintenant appliqué au moment de la planification. |
budget_alert_thresholds | [0.5, 0.9, 1.0] | Moyen 🛡 plan-time | Les valeurs sont des fractions, pas des pourcentages — entrer 50 pour "50 %" ne se déclencherait qu'à 5000 % du budget (jamais). Restreint à (0, 1] au moment de la planification. |
enable_vpc_sc | false ; toujours activer avec vpc_sc_dry_run = true d'abord | Critique | L'activation avec vpc_sc_dry_run = false lors de la première activation bloque immédiatement l'accès API à Cloud Build, Cloud Run, GKE et Secret Manager pour toute identité, IP ou réseau manquant du niveau d'accès. Exécuter en mode simulation pendant 24 à 72 heures, puis appliquer. |
vpc_sc_dry_run | true — ne jamais ignorer le mode simulation lors de la première activation | Critique | false sans audit préalable en mode simulation provoque un blocage API immédiat et à large rayon d'action sans retour arrière automatique — le niveau d'accès doit être corrigé manuellement. |
admin_ip_ranges | CIDR du bureau/VPN + IP des runners CI/CD | Critique (partiellement 🛡 plan-time) | Vide lors de l'application (enable_vpc_sc = true, vpc_sc_dry_run = false) est rejeté au moment de la planification. En mode simulation, c'est autorisé, mais une liste d'autorisation incomplète apparaît toujours comme POLICY_VIOLATION dans les journaux d'audit — la raison d'être du mode simulation. |
enable_binary_authorization | false ; activer seulement après la mise en place du pipeline d'attestation | Critique | REQUIRE_ATTESTATION sans pipeline d'attestation fonctionnel bloque chaque déploiement d'image dans le projet. Revenir à binauthz_evaluation_mode ne l'annule pas — la mise à jour de la politique est additive et ne fait qu'escalader, donc une rétrogradation est ignorée (l'apply réussit toujours, enregistrant un AVERTISSEMENT). La récupération est hors bande : gcloud container binauthz policy import <file>. |
subnet_cidr_range | ["10.0.0.0/24"] — ne doit pas chevaucher les CIDR de pods/services GKE | Élevé | Le chevauchement avec gke_pod_base_cidr ou gke_service_base_cidr échoue à la création du cluster GKE avec un conflit CIDR, bloquant tous les modules d'application GKE. |
gke_pod_base_cidr | "10.64.0.0/10" — suffisamment grand pour la densité des pods | Élevé | Trop petit pour le nombre de pods attendu : GKE ne peut pas planifier de nouveaux pods une fois le CIDR des pods épuisé (no available IP addresses). |
postgres_database_availability_type | "ZONAL" ; utiliser "REGIONAL" pour la production | Élevé | "ZONAL" en production n'a pas de veille à chaud — une panne de zone entraîne une indisponibilité complète de la base de données pour tous les modules d'application dépendants. |
postgres_tier / mysql_tier | "db-custom-1-3840" | Élevé (partiellement 🛡 plan-time) | Sous-provisionné : la limitation du CPU entraîne des requêtes lentes, une accumulation de la file d'attente de connexion et des délais d'attente d'application. Mettre à niveau lorsque le CPU soutenu dépasse 70 % — mais dans un projet géré par RAD (gcp-rad-*), la mise à niveau est limitée à 2 vCPU par une précondition au moment de la planification, donc toute valeur plus grande échoue au plan avec une erreur nommée plutôt que de provisionner. Cela a remplacé la politique d'organisation custom.radSqlTierCeiling le 19/08/2026, que le sondage a montré ne rien refuser. Le dimensionnement au-delà de cette limite signifie un déploiement dans votre propre projet. |
postgres_database_flags | max_connections = "200" | Élevé | Trop faible pour le nombre de réplicas : épuisement du pool de connexions (FATAL: sorry, too many clients already) sur tous les modules. |
mysql_database_availability_type | "ZONAL" ; utiliser "REGIONAL" pour la production | Élevé | Même risque de défaillance sur une seule zone que PostgreSQL pour les applications basées sur MySQL (WordPress, Moodle, OpenEMR). |
network_filesystem_capacity | 10 Go | Élevé | Trop petit : le disque NFS se remplit et les applications ne parviennent pas à écrire (ENOSPC). La capacité ne peut qu'être augmentée — provisionner généreusement. |
filestore_capacity_gb | 1024 Go (minimum BASIC_HDD) | Élevé 🛡 plan-time | En dessous du minimum du niveau, le provisionnement de Filestore échouerait à l'API ; le minimum par niveau (1024 Go BASIC_HDD/ENTERPRISE, 2560 Go BASIC_SSD) est maintenant appliqué au moment de la planification. |
redis_tier | "BASIC" | Élevé | "BASIC" pour le stockage de session en production : une défaillance de nœud ou un événement de maintenance entraîne la perte de toutes les données Redis et la déconnexion de tous les utilisateurs. Utiliser "STANDARD_HA". |
redis_persistence_mode | "DISABLED" ; utiliser "RDB"/"AOF" pour la production STANDARD_HA | Élevé (partiellement 🛡 plan-time) | "DISABLED" avec STANDARD_HA en production vide toutes les données Redis lors du basculement (appliqué pour environment = production). La définition de RDB/AOF sur BASIC est rejetée au moment de la planification, car le niveau ignore la persistance. |
enable_cmek | false | Élevé | L'activation après le provisionnement des ressources avec des clés gérées par Google nécessite une migration des données ; les comptes de service doivent détenir le rôle d'encryptage/décryptage KMS ou la création de ressources échoue. |
create_google_kubernetes_engine | true avant tout module d'application GKE | Élevé | false lorsqu'un module d'application GKE est déployé : le cluster n'existe pas et tous les déploiements GKE échouent. |
create_network_filesystem + create_filestore_nfs | Utiliser l'un ou l'autre | Moyen | Les deux true créent deux infrastructures NFS indépendantes, ce qui conduit à un stockage de fichiers en split-brain où les écritures sur un partage sont invisibles pour les clients de l'autre. |
network_filesystem_machine | "e2-small" | Moyen | Sous-provisionné pour un NFS à haut débit ou de grands ensembles de données Redis. Mettre à niveau vers e2-medium ou n2-standard-2 pour la production. |
enable_gke_backup | false — nécessite create_google_kubernetes_engine = true | Moyen 🛡 plan-time | L'activation sans cluster GKE (ainsi que les autres add-ons GKE : Service Mesh, Config Sync, Policy Controller) est maintenant rejetée au moment de la planification. Activer GKE d'abord. |
enable_audit_logging | false | Moyen | true augmente considérablement le volume et le coût d'ingestion de Cloud Logging. Activer délibérément pour les environnements de conformité. |
configure_email_notification | false | Faible | true avec une liste notification_alert_emails vide crée un canal de notification sans destinataires — les alertes sont silencieusement ignorées. |
Guides associés
- Lab pratique : Services GCP — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.