Guide de préparation à la certification PDE : Section 3 — Appliquer les pratiques d'ingénierie de la fiabilité des sites (Applying site reliability engineering practices) (~18 % de l'examen)
📚 Guide officiel de l'examen : Professional Cloud DevOps Engineer certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Ce guide couvre la section 3 de l'examen à l'aide des modules fondamentaux de RAD. La théorie des SLO et des budgets d'erreur n'est ici abordée que sur le plan conceptuel (les modules émettent les métriques à partir desquelles les SLI sont construits, mais ne créent aucun objet SLO), tandis que la gestion du cycle de vie du service et l'atténuation des incidents sont entièrement pratiques, grâce aux contrôles de scaling d'App_CloudRun, à la pile HPA/VPA/PDB d'App_GKE et au retour arrière instantané fondé sur le trafic. Déployez le profil GKE release engineer (ingénieur de release GKE) ainsi qu'un service Cloud Run (n'importe quel profil) de la carte des labs.
3.1 Équilibrer le changement, la vélocité et la fiabilité du service (Balancing change, velocity, and reliability of the service)
⏱ ~60 min (surtout de l'étude + un exercice dans la console) · 💰 aucun coût supplémentaire · ⚙️ Prérequis : profil Observability baseline (socle d'observabilité, pour les métriques sur lesquelles reposent les SLO)
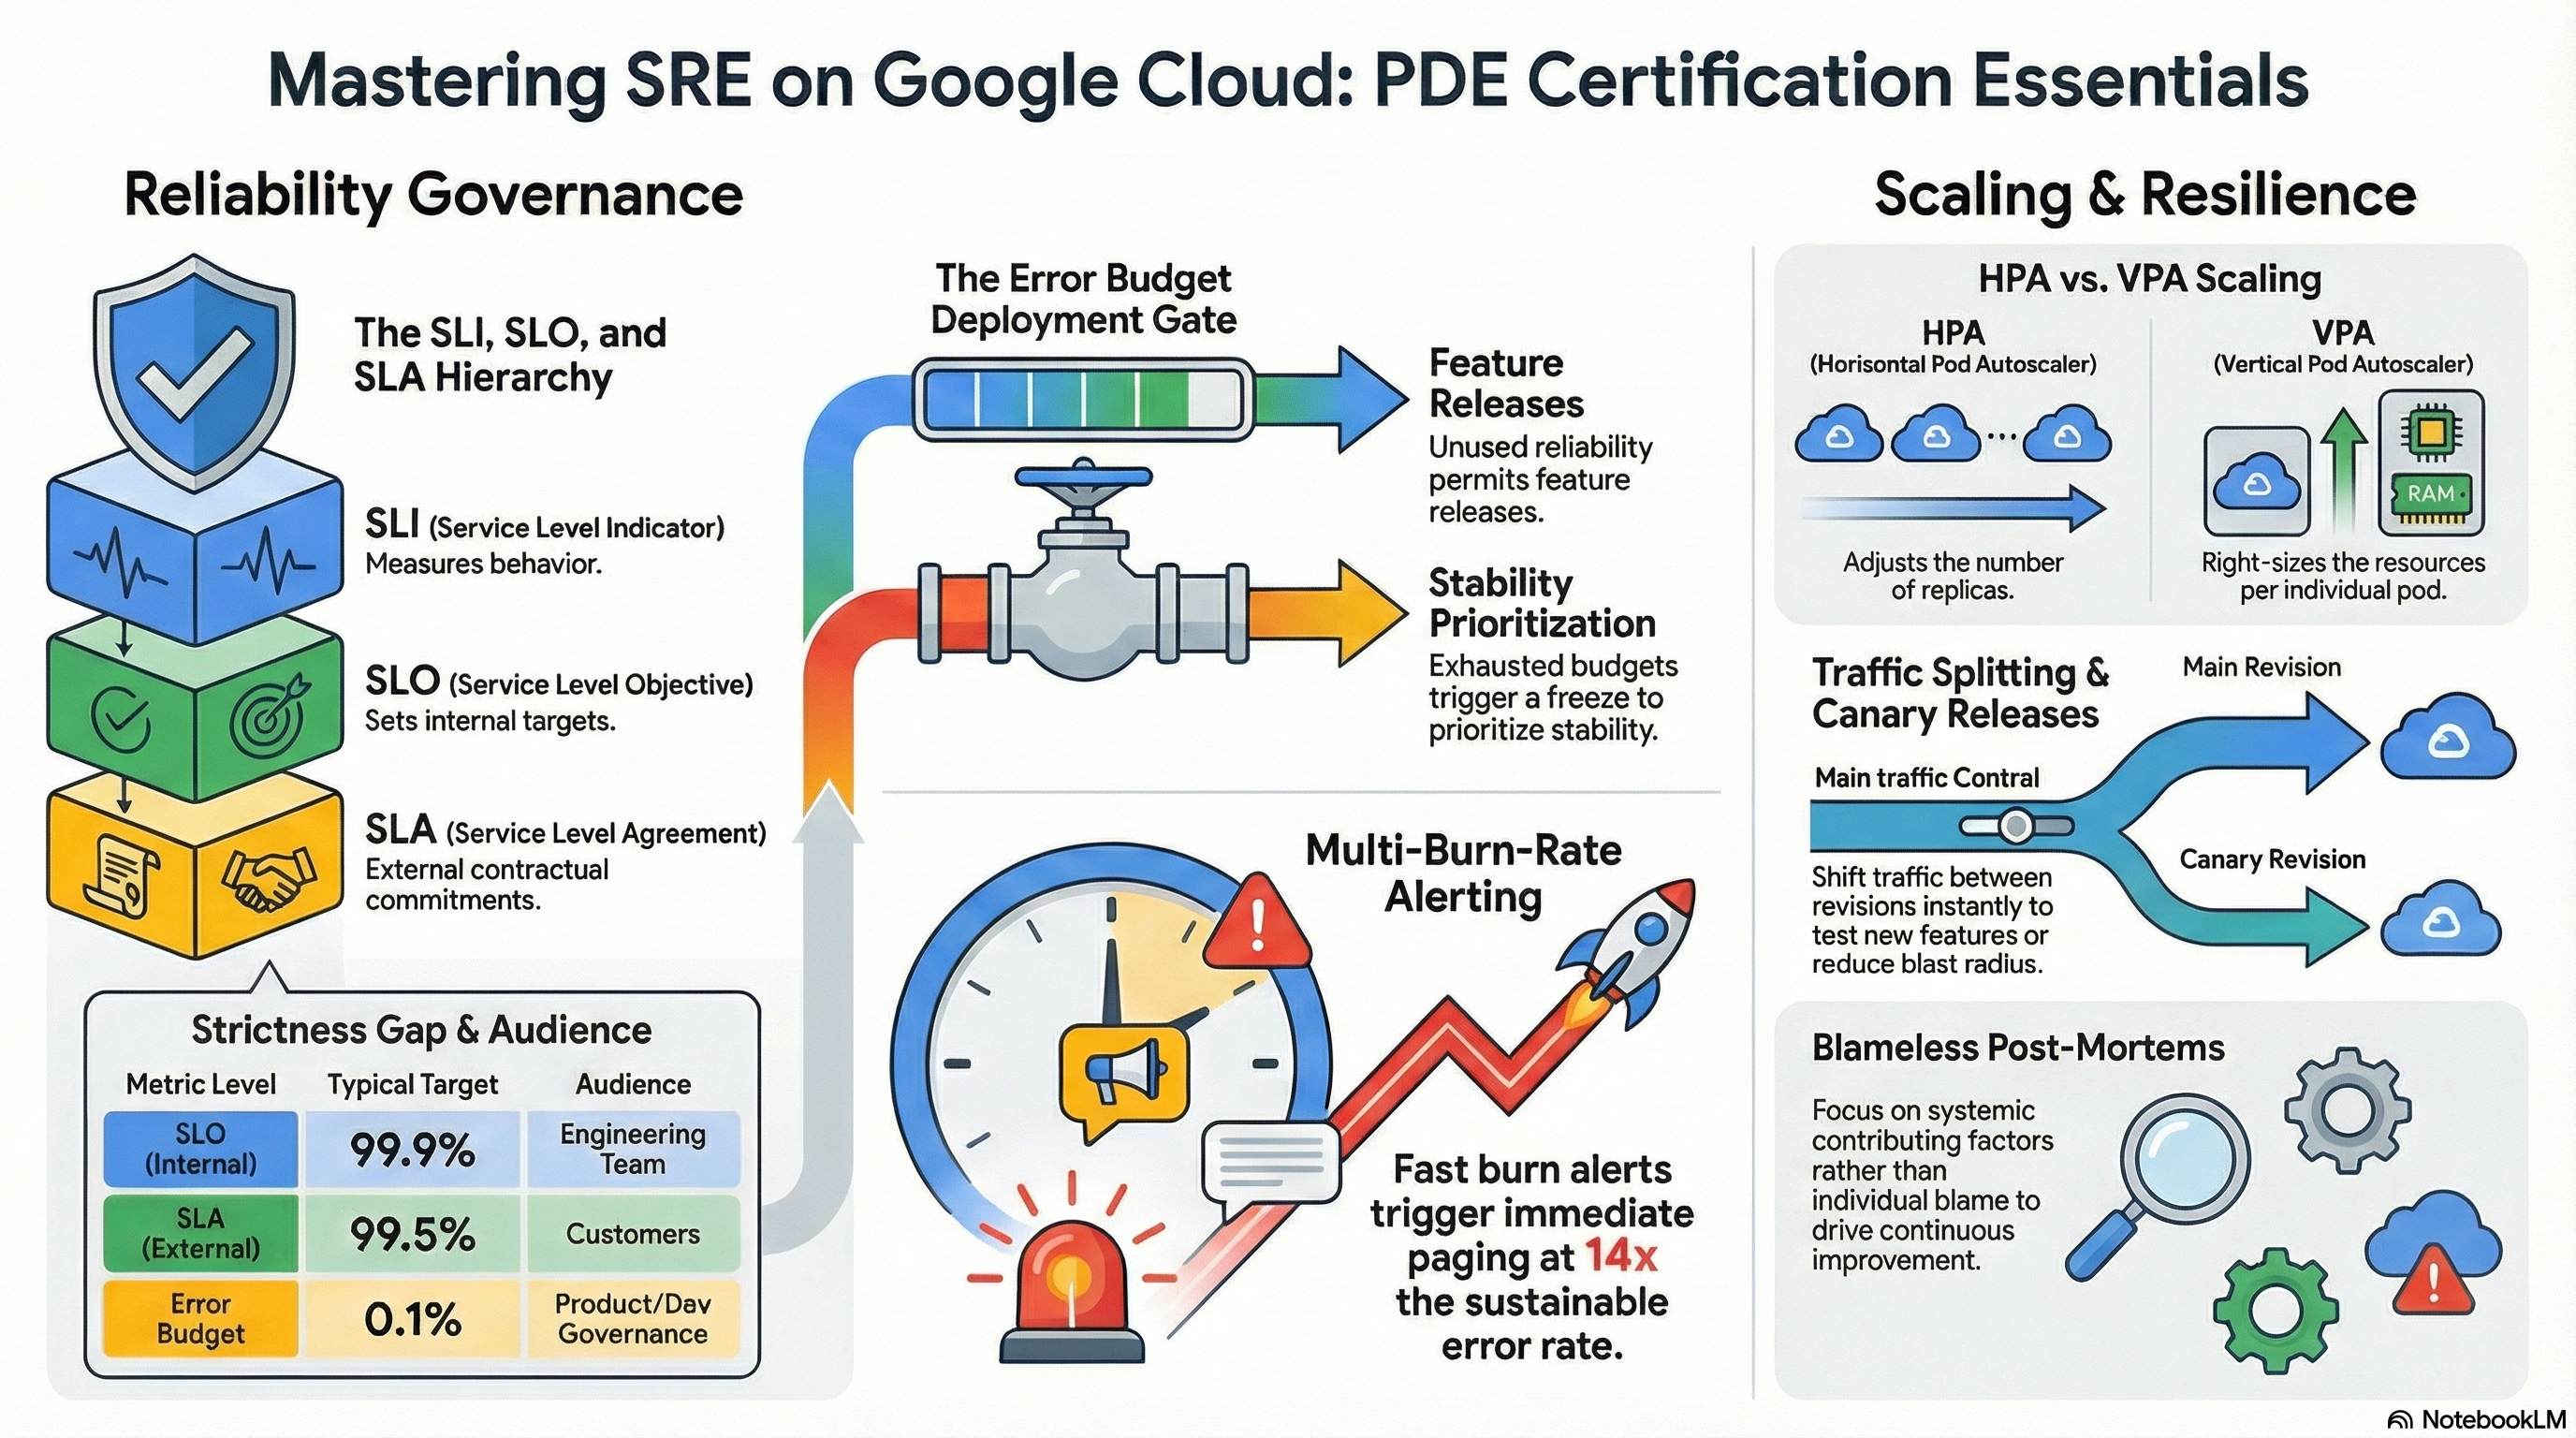
Pourquoi l'examen s'y intéresse — C'est le cœur du SRE : les SLI mesurent le comportement, les SLO fixent des objectifs internes, les SLA sont des engagements externes (toujours moins stricts que le SLO), et le budget d'erreur (1 − SLO) est la monnaie objective qui arbitre entre la livraison de fonctionnalités et le renforcement de la fiabilité. L'examen teste la couche décisionnelle : ce qui se passe lorsque le budget est épuisé, quel taux de consommation doit déclencher une alerte d'astreinte, et qui est responsable de la politique de budget d'erreur.
Comment RAD le met en œuvre — Pas sous forme de SLO : aucun objet SLO ou service Cloud Monitoring n'existe dans les modules. La capacité la plus proche est la matière première des SLI et les alertes à seuil : la couche de surveillance crée des alertes fixes d'utilisation du CPU et de la mémoire à 0,9 (90 %) par plateforme, la variable alert_policies vous permet d'alerter sur n'importe quelle métrique (par ex. run.googleapis.com/request_count ou request_latencies), et les tableaux de bord générés automatiquement représentent le nombre de requêtes et la latence p95 — exactement les signaux que vous choisiriez comme SLI de disponibilité et de latence.
À vous de jouer
- Avec un service Cloud Run déployé et recevant un peu de trafic, créez manuellement un véritable SLO sur le service du module : Console > Monitoring > Services > Define service, choisissez le service Cloud Run, puis Create SLO → type de SLI Availability (fondé sur les requêtes) → objectif 99,9 % sur 30 jours glissants.
- Ajoutez sur ce SLO les deux alertes standard de taux de consommation (consommation rapide : 14,4× sur 1h ; consommation lente : 6× sur 6h) depuis l'onglet Alerts du SLO.
- Inspectez ce que la console a construit, via l'API :
gcloud monitoring services list --project=$GOOGLE_PROJECT_ID
gcloud alpha monitoring policies list \
  --filter="displayName~'burn rate'" --format="value(displayName)"
- Générez du trafic (par ex.
for i in $(seq 1 200); do curl -s -o /dev/null <service-url>; done) et observez la jauge du budget d'erreur évoluer sur la page du SLO. - Vous savez que cela a fonctionné lorsque la page du SLO affiche le pourcentage de conformité, le budget d'erreur restant et les graphiques de taux de consommation pour le service déployé par le module.
Testez-vous
Q1 : Votre SLO est de 99,9 % de disponibilité sur 30 jours, et un incident vient de consommer 50 % du budget d'erreur restant en 2 heures. Selon la politique SRE standard, que doit faire l'équipe de la release de fonctionnalités prévue demain ?
R : La suspendre. Une consommation aussi rapide signifie que le rythme soutenable est largement dépassé ; la politique de budget d'erreur échange la vélocité des releases contre du travail de fiabilité jusqu'à ce que le budget se reconstitue. C'est tout l'intérêt du budget — une porte objective, convenue à l'avance, plutôt qu'une décision prise au jugé en plein incident.
Q2 : Pourquoi le SLA est-il toujours moins strict que le SLO (par ex. SLA à 99,5 % vs SLO à 99,9 %) ?
R : Le SLO est l'objectif interne dont vous maîtrisez les conséquences (gel des releases) ; le SLA entraîne des pénalités externes (remboursements, contrats). L'écart constitue la marge opérationnelle : vous voulez franchir votre objectif interne, réagir et rétablir la situation bien avant toute violation contractuelle.
Q3 : Pourquoi déclencher l'astreinte sur le taux de consommation du budget d'erreur plutôt que sur le pourcentage brut d'erreurs ?
R : L'alerte sur le taux de consommation proportionne l'urgence à l'impact sur le budget : une consommation 14× sur une heure menace le budget mensuel et mérite une alerte d'astreinte, alors qu'une consommation lente de 1,5× relève d'un ticket. Les alertes à seuil brut alertent soit trop souvent (bruit), soit trop tard (budget déjà épuisé) — le modèle multifenêtre et multitaux du SRE Workbook résout les deux problèmes.
Au-delà des modules — À étudier : la surveillance des SLO dans Cloud Monitoring (SLI fondés sur les requêtes vs sur des fenêtres), les chapitres du SRE Workbook consacrés aux alertes sur les SLO et à la politique de budget d'erreur, et la mesure du travail opérationnel répétitif (toil). Dans un projet de test, essayez gcloud monitoring services create / l'API REST des SLO pour scripter ce que vous avez fait en cliquant dans la console — l'examen peut faire référence à des définitions de SLO au format JSON. Sachez aussi comment Cloud Service Mesh s'inscrit dans le point sur les budgets d'erreur : les charges de travail du maillage apparaissent automatiquement comme services dans Cloud Monitoring, avec des SLI de disponibilité et de latence fondés sur les requêtes, prêts à recevoir des SLO. Services_GCP ne peut activer le maillage (configure_cloud_service_mesh, par défaut false) que dans un projet que vous apportez vous-même ; l'option est masquée pour les projets que RAD crée pour vous.
⚠️ Piège d'examen — 99,9 % par mois ≈ 43 minutes d'indisponibilité, 99,99 % ≈ 4,3 minutes. Les réponses d'examen dépendent souvent de la question de savoir si une fenêtre de maintenance ou un temps de reprise proposés tiennent seulement dans le budget du SLO indiqué.
3.2 Gérer le cycle de vie du service (Managing service lifecycle)
⏱ ~75 min · 💰 modéré (réplicas GKE) · ⚙️ Prérequis : profil ingénieur de release GKE + n'importe quel déploiement Cloud Run
Pourquoi l'examen s'y intéresse — Les questions de gestion de la capacité testent quel levier résout quel problème : scaling horizontal pour la charge, dimensionnement vertical pour l'efficacité, instances minimales pour la latence, maximums pour la protection des coûts. Sur GKE, vous devez connaître la sémantique HPA vs VPA (et savoir qu'ils entrent en conflit sur une même métrique de ressource) ; sur Cloud Run, les compromis du scale-to-zero.
Comment RAD le met en œuvre
| Contrôle | Cloud Run (App_CloudRun) | GKE (App_GKE) |
|---|---|---|
| Plancher | min_instance_count (par défaut 0 — scale-to-zero) | min_instance_count (par défaut 1) → HPA minReplicas |
| Plafond | max_instance_count (par défaut 1) | max_instance_count (par défaut 3) → HPA maxReplicas |
| Déclencheur horizontal | charge des requêtes (gérée par Cloud Run) | un Horizontal Pod Autoscaler : utilisation cible du CPU 70 %, de la mémoire 80 % |
| Vertical | container_resources (cpu_limit par défaut 1000m, memory_limit par défaut 512Mi) | container_resources, ou enable_vertical_pod_autoscaling (par défaut false) → VPA avec updateMode: Auto, plancher 10m/32Mi |
| Contrôle de l'état prêt (readiness) | startup_probe_config (HTTP /healthz, période de 10s, 10 échecs) | startup_probe_config (délai de 10s/période de 10s) |
| Liveness | health_check_config (période de 30s, 3 échecs → redémarrage) | health_check_config (délai de 15s/période de 30s) |
Deux détails de câblage à connaître : le HPA GKE n'est créé que lorsque max_instance_count > 1 et que le VPA est désactivé — le module n'exécute jamais HPA et VPA ensemble sur la même charge de travail ; et le HPA porte une précondition au moment du plan exigeant min_instance_count <= max_instance_count.
La planification de la capacité a aussi un volet quotas. Lorsque RAD crée un projet pour vous, Project_GCP y définit des préférences Cloud Quotas : CPU Compute Engine plafonnés à 24 par région (les nœuds Autopilot puisent dans ce pool), allocation CPU Cloud Run à 16 vCPU par région, et GPU à zéro. Un max_instance_count supérieur à ce que permettent ces quotas n'apporte aucune capacité, et gcloud beta quotas preferences list --project=$GOOGLE_PROJECT_ID indique ce que le projet peut réellement utiliser.
À vous de jouer
- Sur GKE, inspectez la pile d'autoscaling du module :
kubectl get hpa -n <namespace>
kubectl describe hpa <service-name> -n <namespace>   # see the 70%/80% targets
- Chargez le service et observez la réaction du HPA (Autopilot provisionne automatiquement la capacité des nœuds) :
kubectl run loadgen --image=busybox -n <namespace> --restart=Never -- \
  /bin/sh -c "while true; do wget -q -O- http://<service-name>; done"
kubectl get hpa <service-name> -n <namespace> --watch
- Passez au dimensionnement vertical : définissez
enable_vertical_pod_autoscaling = truedans le portail et appliquez — notez dans le plan que le HPA est détruit et qu'unVerticalPodAutoscalerapparaît. Consultez ses recommandations après un peu de charge :kubectl get vpa -n <namespace> -o yaml. - Sur Cloud Run, définissez
min_instance_count = 1et appliquez, puis comparez la latence de démarrage à froid avant/après aveccurl -w "%{time_total}\n" -o /dev/null -s <url>après une période d'inactivité. - Vous savez que cela a fonctionné lorsque le HPA fait évoluer les réplicas vers
max_instance_countsous charge, que le VPA émet des demandes cibles après observation et que le service Cloud Run préchauffé répond sans latence de plusieurs secondes à la première requête.
Testez-vous
Q1 : Un service GKE subit des arrêts OOM (OOM-kill) sous un trafic régulier (et non en pics). Recourez-vous au HPA ou au VPA, et pourquoi ?
R : Au VPA (ou à l'augmentation manuelle de la mémoire dans container_resources) : c'est l'allocation par pod qui est incorrecte, pas le nombre de réplicas. Un HPA sur la mémoire ajouterait des réplicas, masquant le problème à grands frais. Le VPA observe l'utilisation réelle et relève la demande — la bonne correction verticale pour une erreur de dimensionnement. Notez que le module impose de choisir : activer le VPA supprime le HPA.
Q2 : Pourquoi max_instance_count compte-t-il sur une plateforme à l'usage comme Cloud Run, où l'inactivité ne coûte rien ?
R : Il limite le rayon d'impact dans les deux sens : coûts incontrôlés lors d'un pic de trafic ou d'une tempête de nouvelles tentatives, et protection contre la surcharge des dépendances en aval à capacité fixe (le max_connections de Cloud SQL vaut 200 par défaut dans Services_GCP), qu'un scaling illimité de Cloud Run épuiserait.
Au-delà des modules — Le réglage de la concurrence de Cloud Run (requêtes par instance) n'est pas exposé sous forme de variable de module ; étudiez la façon dont la concurrence interagit avec l'allocation du CPU et le nombre d'instances (gcloud run services update --concurrency=... dans un projet de test). Étudiez aussi les concepts d'autoscaling au niveau du cluster GKE (provisionnement automatique des nœuds), même si Autopilot les masque. La liste du point 3.2 cite également l'autoscaling des groupes d'instances gérés (le serveur NFS de Services_GCP s'exécute dans un MIG régional, mais de taille fixe et sans autoscaler), les réservations Compute Engine, Dynamic Workload Scheduler pour obtenir des accélérateurs rares, la demande d'augmentation de quotas en amont d'un lancement, ainsi que les étapes de planification et de retrait du cycle de vie d'un service, dont aucun n'est configuré par les modules.
⚠️ Piège d'examen — Les cibles en pourcentage du HPA sont relatives à la demande (request), pas à la limite. Un pod avec une faible demande de CPU atteint presque immédiatement « 70 % d'utilisation » ; des demandes incorrectes donnent l'impression que le HPA est défaillant.
3.3 Atténuer l'impact des incidents sur les utilisateurs (Mitigating incident impact on users)
⏱ ~60 min · 💰 faible · ⚙️ Prérequis : profils ingénieur pipeline + ingénieur de release GKE
Pourquoi l'examen s'y intéresse — Pendant un incident, l'atténuation prime sur le diagnostic : détourner le trafic de la version défectueuse, revenir en arrière, rejeter la charge abusive, maintenir la capacité en vie malgré les perturbations de l'infrastructure. L'examen couvre aussi le volet humain — rôles de commandement de l'incident, communication et post-mortems sans recherche de coupable — qu'aucun module Terraform ne peut déployer.
Comment RAD le met en œuvre
- Retour arrière instantané de révision (Cloud Run) : chaque révision conservée (
max_revisions_to_retain, par défaut7) est une cible de retour arrière ; redirigeztraffic_split(ou utilisez le gestionnaire de trafic de la console) — quelques secondes, aucun build. - Retour arrière de pipeline (Cloud Deploy) : chaque cible conserve l'historique de ses releases ;
gcloud deploy targets rollbackredéploie les condensés figés de la release précédente. - Retour arrière de charge de travail (GKE) :
kubectl rollout undorevient au ReplicaSet précédent ; le chemin CI/CD direct (kubectl set image) préserve l'historique des déploiements. - Disponibilité face aux perturbations :
enable_pod_disruption_budget(par défauttrue) crée un PDB avecpdb_min_available(par défaut"1") — automatiquement omis lorsquemax_instance_count = 1, cas où un PDB bloquerait indéfiniment le drainage des nœuds ; il est aussi créé pour le namespace de chaque étape Cloud Deploy.enable_topology_spread(par défautfalse) répartit les réplicas entre les zones. - Confinement des défaillances en périphérie :
enable_cloud_armor(par défautfalse) place devant Cloud Run un équilibreur de charge global dont la règle inclut une limitation de débit par IP — 500 requêtes/60s, dépassement → refus avec HTTP 429 et bannissement de 300s — ainsi que des règles WAF OWASP préconfigurées et Adaptive Protection contre les attaques DDoS de couche 7. Lorsqu'il est activé,ingress_settingsest forcé àinternal-and-cloud-load-balancingafin que le WAF ne puisse pas être contourné via l'URL directe*.run.app. - Ajout de capacité : relever
max_instance_count(etmin_instance_count, pour préchauffer des instances avant un pic attendu) est le levier de capacité sur les deux moteurs ; sur GKE, lemaxReplicasdu HPA suit. Cela n'aide que tant que les quotas du projet laissent de la marge (voir 3.2). - Sondes d'autoréparation : les échecs de liveness redémarrent les conteneurs (3 échecs consécutifs sur le
health_check_configde Cloud Run) ; les sondes de démarrage tiennent le trafic à l'écart des instances qui ne sont pas prêtes.
À vous de jouer
- Mettez en scène un « mauvais déploiement » sur Cloud Run : poussez une modification qui renvoie des erreurs 500 (ou considérez simplement la dernière révision comme défectueuse), puis exécutez l'atténuation :
gcloud run services update-traffic <service> --region=us-central1 \
  --to-revisions=<previous-revision>=100
Chronométrez-vous — c'est l'atténuation « en moins d'une minute » qu'attend l'examen. 2. Sur GKE, cassez puis annulez un déploiement :
kubectl set image deployment/<name> <app>=badregistry.example/nope:1 -n <ns>
kubectl rollout status deployment/<name> -n <ns>   # watch it stall on ImagePullBackOff
kubectl rollout undo deployment/<name> -n <ns>
Notez que la stratégie de mise à jour progressive a laissé les anciens pods servir le trafic pendant tout ce temps.
3. Vérifiez que le PDB vous protège pendant la maintenance : kubectl get pdb -n <ns> et confirmez que MIN AVAILABLE correspond à pdb_min_available.
4. Avec Cloud Armor activé, bombardez le point de terminaison au-delà de 500 req/min depuis une seule IP et observez les 429 ainsi qu'un bannissement de 5 minutes ; consultez Console > Network Security > Cloud Armor policies > (policy) > Logs.
5. Vous savez que cela a fonctionné lorsque le trafic a été détourné de la révision défectueuse sans aucune interruption, que le déploiement GKE bloqué n'a jamais fait passer les réplicas prêts sous le plancher du PDB et que la limitation de débit a renvoyé des 429.
Testez-vous
Q1 : Un mauvais déploiement GKE en est à 50 % lorsque les erreurs explosent. Pourquoi kubectl rollout undo peut-il être exécuté sans risque immédiatement, en plein déploiement ?
R : Une mise à jour progressive conserve le ReplicaSet précédent jusqu'à son achèvement ; undo inverse simplement le sens, en remontant l'ancien ReplicaSet (réputé sain) sous les mêmes contraintes maxSurge/maxUnavailable. Aucune reconstruction, aucun risque pour les données des charges de travail sans état — c'est précisément pourquoi l'examen le privilégie comme première réponse.
Q2 : Pourquoi le module s'abstient-il délibérément de créer un PDB lorsque max_instance_count = 1 ?
R : Un PDB avec un min-available de 1 sur un seul réplica rend le pod impossible à évincer, bloquant indéfiniment le drainage et les mises à niveau des nœuds — transformant un outil de fiabilité en panne opérationnelle. Avec un seul réplica, la protection contre les perturbations volontaires n'a de toute façon aucun sens ; la vraie correction consiste à exécuter plus d'un réplica.
Q3 : Lors d'une attaque DDoS présumée, pourquoi le bannissement fondé sur le débit de Cloud Armor est-il préférable à une augmentation de max_instance_count ?
R : La limitation de débit rejette la charge abusive en périphérie avant qu'elle ne consomme du calcul ou n'atteigne la base de données ; augmenter le scaling absorbe l'attaque à vos frais et la reporte sur les systèmes en aval à capacité fixe. Atténuez au niveau le plus externe capable de distinguer le trafic malveillant.
Au-delà des modules — Le processus de gestion des incidents relève de l'étude pure : les rôles de l'Incident Command System (commandant d'incident, responsable des communications, responsable des opérations), la classification de la gravité, la communication de l'état et la structure d'un post-mortem sans recherche de coupable (chronologie, facteurs contributifs, actions assorties de responsables). Lisez les chapitres « Managing Incidents » et « Postmortem Culture » du Google SRE Book ; entraînez-vous à rédiger un post-mortem pour un incident de lab que vous mettez en scène ci-dessus.
⚠️ Piège d'examen — Un PodDisruptionBudget ne protège que contre les perturbations volontaires (drainages, mises à niveau, consolidation par l'autoscaler). Les plantages de nœuds, les arrêts OOM et les évictions de pods sous pression sur un nœud l'ignorent — les réponses affirmant qu'un PDB empêche les défaillances involontaires sont fausses.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.