Guide de préparation à la certification PDE : Section 1 — Amorcer et maintenir une organisation Google Cloud (Bootstrapping and maintaining a Google Cloud organization) (~20 % de l'examen)
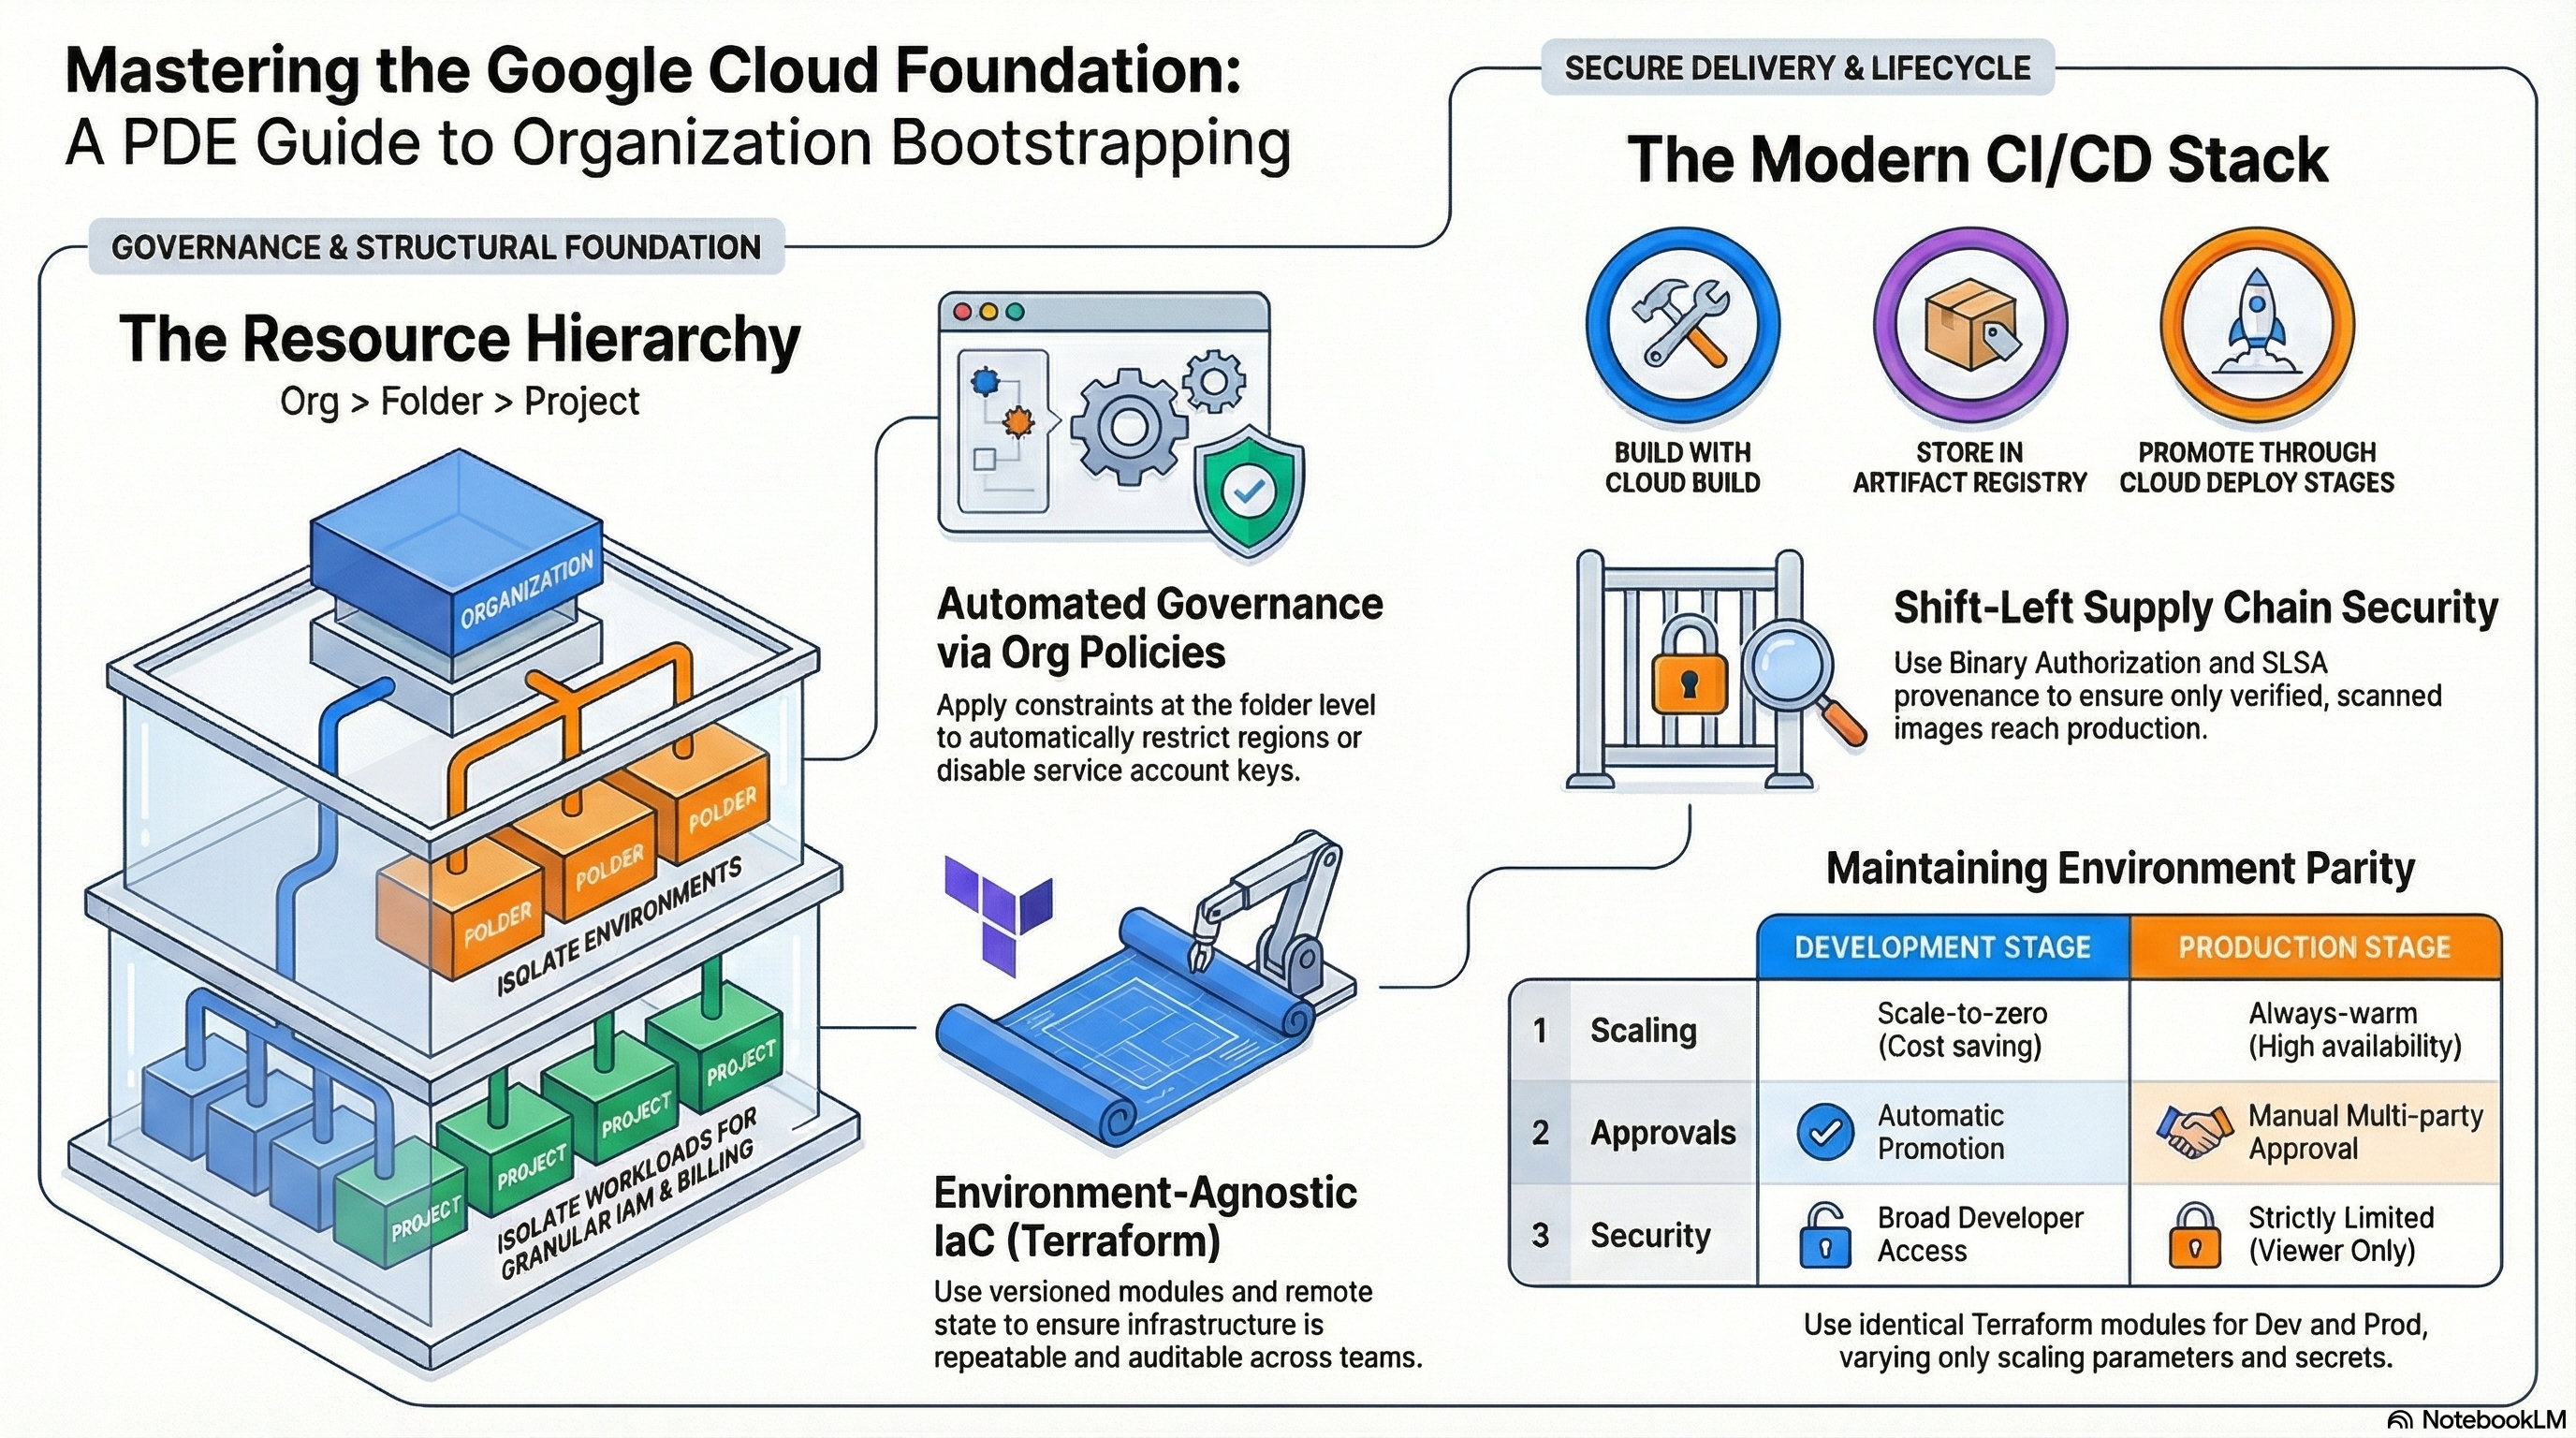
📚 Guide officiel de l'examen : Professional Cloud DevOps Engineer certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Ce guide couvre la section 1 de l'examen en utilisant la plateforme RAD comme lab. Les modules fondamentaux mis en pratique ici sont App_CloudRun et App_GKE (les moteurs de déploiement), Services_GCP (la couche de plateforme déployée une fois par projet) et les briques App_Common qu'ils partagent. Déployez le profil Pipeline engineer (ingénieur pipeline) de la carte des labs avant de commencer.
1.1 Concevoir la hiérarchie globale des ressources d'une organisation (Designing the overall resource hierarchy for an organization)
⏱ ~30 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : déploiement par défaut
Pourquoi l'examen s'y intéresse — Les ingénieurs DevOps héritent de la hiérarchie organisation → dossier → projet → ressource et doivent savoir où rattacher quoi : règles d'administration et IAM au niveau des dossiers pour les garde-fous propres à un environnement entier, comptes de facturation en dehors de la hiérarchie, projets comme frontière d'isolation et de quota. Les scénarios d'examen vérifient que vous placez une contrainte au bon niveau (par ex. une règle au niveau d'un dossier plutôt que répétée projet par projet) et que vous isolez les environnements par projet plutôt que par convention de nommage.
Comment RAD le met en œuvre — Pas de manière significative : les quatre modules fondamentaux opèrent tous à l'intérieur d'un unique projet existant ; aucun dossier, aucune règle d'administration ni aucune ressource de type « project factory » n'est créé. La capacité la plus proche est le libellé de gouvernance — resource_labels (par défaut {}) dans les deux moteurs d'application est fusionné dans un ensemble commun de libellés (qui ajoute toujours les clés application, deployment, tenant et managed-by) et apposé sur chaque ressource, ce qui constitue la base de l'attribution des coûts par libellé et du filtrage des journaux.
Deux autres considérations du point 1.1 laissent une empreinte observable dans le lab. Réseau partagé : Services_GCP construit un VPC par projet et atteint les services à IP privée gérés par Google, comme Cloud SQL, via l'accès aux services privés, qui est un appairage de réseaux VPC (google_service_networking_connection) ; les moteurs d'application découvrent ce VPC par libellé au lieu de créer le leur. Comptes de service : les builds s'exécutent sous un compte de service Cloud Build dédié à chaque déploiement (cloudbuild-sa-*, voir 1.3), et non sous une identité par défaut aux droits étendus. Le VPC partagé, les points de terminaison Private Service Connect, la surveillance multiprojet et les contrôles de résidence des données ne sont pas configurés par les modules.
À vous de jouer
- Dans le portail, définissez
resource_labels = { team = "payments", env = "lab" }sur un module applicatif déployé et appliquez. - Dans Console > Cloud Run > (service) > Details, vérifiez les libellés ; puis dans Billing > Reports, regroupez par clé de libellé
teampour voir l'attribution des coûts par libellé. - Vérifiez depuis la CLI :
gcloud run services describe <service-name> --region=us-central1 \
  --format="value(metadata.labels)"
gcloud projects get-ancestors $GOOGLE_PROJECT_ID
- Vous savez que cela a fonctionné lorsque les libellés
teametenvapparaissent à côté des libellésmanaged-byettenantinjectés par le module, et queget-ancestorsmontre où se situe votre projet de lab dans la hiérarchie.
Testez-vous
Q1 : Votre entreprise veut que chaque projet hors production soit limité à us-central1, tandis que les projets de production restent multirégionaux. Où mettre cela en œuvre avec le moins d'effort continu ?
R : Rattachez une règle d'administration constraints/gcp.resourceLocations à un dossier non-production et placez-y tous les projets hors production. Les règles se transmettent par héritage dans la hiérarchie, de sorte que les nouveaux projets reçoivent automatiquement la restriction — aucune configuration par projet ni modification Terraform n'est nécessaire.
Q2 : Pourquoi les modules RAD apposent-ils un libellé tenant et deployment sur chaque ressource au lieu de s'appuyer sur les noms des ressources ?
R : Les libellés peuvent être interrogés dans les exports de facturation, les filtres de journaux et l'inventaire des éléments, alors que les noms sont des chaînes libres. Les libellés vous offrent le showback des coûts et un regroupement opérationnel sur des types de ressources hétérogènes — le même mécanisme que l'examen attend pour la refacturation (chargeback) dans une organisation multi-équipes.
Au-delà des modules — Étudiez directement la documentation sur la hiérarchie des ressources et les règles d'administration : entraînez-vous avec gcloud resource-manager folders list --organization=<ORG_ID>, gcloud org-policies list --project=<PROJECT>, et examinez les blueprints de zone d'atterrissage (landing zone) Cloud Foundation Fabric/FAST pour voir comment les entreprises amorcent dossiers, facturation et IAM avec Terraform. Sachez aussi qu'un compte de facturation est associé à des projets mais se situe en dehors de la hiérarchie. Pour le reste de la liste du point 1.1 : VPC partagé (projets hôtes et de service) vs appairage de réseaux VPC vs Private Service Connect ; surveillance multiprojet via un champ d'application des métriques Cloud Monitoring et des récepteurs de journaux agrégés ou des buckets de journaux ; hygiène des comptes de service (comptes de service dédiés par charge de travail, aucune clé gérée par l'utilisateur, iam.disableServiceAccountKeyCreation) ; et résidence des données via la contrainte gcp.resourceLocations et des buckets de journaux régionaux.
⚠️ Piège d'examen — Les règles d'administration ne sont pas de l'IAM : refuser une autorisation dans IAM et contraindre la configuration d'une ressource (par ex. disableServiceAccountKeyCreation) relèvent de plans de contrôle différents, et l'examen apprécie les réponses qui combinent les deux.
1.2 Gérer l'infrastructure (Managing infrastructure)
⏱ ~60 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : n'importe quel module déployé
Pourquoi l'examen s'y intéresse — L'examen teste les critères de décision en matière d'IaC : outils déclaratifs fondés sur l'état (Terraform/OpenTofu, Infrastructure Manager) vs scripts impératifs, la manière dont l'état distant permet la collaboration et le verrouillage, la façon dont la dérive est détectée et corrigée, et le moment où il faut délibérément laisser un autre système gérer une partie d'une ressource. Attendez-vous à des scénarios sur ce qu'affiche terraform plan après que quelqu'un a cliqué un peu partout dans la console.
Comment RAD le met en œuvre — Les modules de déploiement sont l'artefact :
| Pratique | Où l'observer |
|---|---|
| Modules déclaratifs couvrant toute la pile | App_CloudRun déclare un service Cloud Run v2 ; App_GKE déclare un Deployment Kubernetes |
| Paramétrage, aucune valeur codée en dur | chaque moteur expose 130 à 160 variables avec des validations, par ex. les entrées de traffic_split doivent totaliser 100 |
| Garde-fous au moment du plan | App_GKE comporte des dizaines de contrôles de préconditions, par ex. instances min ≤ max, quotas de mémoire avec suffixe binaire |
| Propriété partagée délibérée | le service Cloud Run ciblé par Cloud Deploy ignore les modifications de l'image de conteneur, de sorte que Cloud Deploy gère les déploiements d'images tandis que Terraform gère tout le reste |
| CI pour l'IaC elle-même | un pipeline Cloud Build au niveau du dépôt exécute des contrôles de conventions, tofu fmt -check + tofu validate sur chaque module, tflint et tofu test sur les tests de validation d'App_CloudRun |
| Découverte plutôt que duplication | la couche réseau découvre les VPC gérés par Services_GCP par libellé au lieu de les redéclarer |
La variable de contrôle du déploiement est deploy_application (par défaut true) — la définir à false provisionne l'infrastructure de support sans la charge de travail, un modèle de déploiement par étapes qu'il est utile de connaître.
À vous de jouer
- Comprenez la porte de validation : avant tout déploiement, la CI de la plateforme exécute sur l'IaC une boucle d'analyse statique sans identifiants —
tofu init -backend=false, puistofu validate(contrôles de types et de références) et un contrôle de formatage (tofu fmt -check) — de sorte que les erreurs de syntaxe, de type et de préconditions sont détectées sans toucher à un projet réel. C'est la porte de revue de code ; vous en constatez le résultat sous la forme d'un déploiement rejeté avant même d'atteindreplan/apply. - Simulez une dérive : dans Console > Cloud Run > (service) > Edit & deploy new revision, modifiez manuellement la limite de mémoire à
1Gi. La prochaine fois que la plateforme réapplique votre déploiement,terraform planpropose de ramener la mémoire à la limite déclarée danscontainer_resources(par défaut512Mi) — car la modification faite dans la console constitue une dérive par rapport à l'état déclaré. - Comparez avec une dérive autorisée : déployez une nouvelle image via le pipeline Cloud Deploy (profil ingénieur pipeline). Lors de l'apply suivant, le plan n'affiche aucune différence pour l'image, car l'image de conteneur est délibérément ignorée par Terraform.
- Vous savez que cela a fonctionné lorsque le plan de l'étape 2 propose une mise à jour sur place annulant votre modification manuelle, tandis que l'étape 3 affiche « No changes » pour l'attribut d'image.
Testez-vous
Q1 : Après le déploiement d'un correctif urgent avec gcloud run services update --image=..., le terraform apply suivant l'a annulé et a de nouveau cassé la production. Quelle conception évite cette catégorie d'incident ?
R : Soit faire passer toutes les modifications d'image par le pipeline auquel Terraform délègue (Cloud Deploy) et faire ignorer l'attribut d'image par Terraform, comme le fait cette plateforme, soit faire en sorte que le chemin d'urgence mette d'abord à jour la source IaC. La cause racine est l'existence de deux rédacteurs pour un même attribut ; la correction consiste à en attribuer explicitement la propriété.
Q2 : Pourquoi le dépôt exécute-t-il tofu validate et tofu test en CI plutôt que seulement tofu plan sur l'infrastructure réelle ?
R : La validation et les tests unitaires s'exécutent sans identifiants ni projet réel (-backend=false), de sorte qu'ils détectent à faible coût, à chaque commit, les violations de syntaxe, de type et de préconditions. Les plans exécutés sur l'état réel sont plus lents, nécessitent des secrets et relèvent du pipeline de déploiement, pas de la porte de revue de code.
Au-delà des modules — L'examen cite davantage d'outils IaC que n'en utilise ce lab : Infrastructure Manager (l'exécuteur Terraform géré de Google), les blueprints Cloud Foundation Toolkit, Config Connector (les ressources Google Cloud sous forme d'objets Kubernetes), Helm et les contrôleurs GitOps. Le modèle GitOps est partiellement visible ici : dans un projet que vous apportez vous-même, configure_config_management = true dans Services_GCP enregistre le cluster dans un parc (fleet) et active Config Sync, mais celui-ci synchronise le dépôt d'exemple public de démarrage rapide de Google, et non un dépôt que vous contrôlez, et l'option est masquée pour les projets que RAD crée pour vous. Entraînez-vous aussi à écrire des scripts pour Google Cloud avec les bibliothèques clientes Python ou Go, car « l'automatisation par scripts » fait l'objet d'un point à part entière.
⚠️ Piège d'examen — terraform plan ne détecte la dérive que pour les attributs que Terraform gère. Les ressources créées entièrement en dehors de Terraform lui sont invisibles ; les trouver nécessite Cloud Asset Inventory ou l'analyse de configuration, pas un plan.
1.3 Concevoir une pile d'architecture CI/CD dans Google Cloud et dans des environnements hybrides et multicloud (Designing a CI/CD architecture stack in Google Cloud, hybrid, and multi-cloud environments)
⏱ ~45 min · 💰 faible (minutes Cloud Build) · ⚙️ Prérequis : profil ingénieur pipeline
Pourquoi l'examen s'y intéresse — Les questions d'architecture testent le choix des outils : Cloud Build pour la CI, Artifact Registry pour les artefacts, Cloud Deploy pour la livraison progressive, Binary Authorization pour l'application, au moment du déploiement, des règles de la chaîne d'approvisionnement — ainsi que l'emplacement des frontières de confiance (quel compte de service fait quoi, où les attestations sont créées et vérifiées).
Comment RAD le met en œuvre — La pile complète est câblée dans App_CloudRun (le moteur GKE la reproduit à l'identique) :
- CI :
enable_cicd_trigger(par défautfalse) crée un déclencheur Cloud Build avec une définition de build inline — aucun fichier de configuration de build distinct n'est nécessaire dans le dépôt de l'application. L'étape 1 construit avec Kaniko (gcr.io/kaniko-project/executor:v1.23.2, cache de couches activé avec une durée de vie du cache de 24h). - Gestion des artefacts : les images sont poussées avec trois tags — la version configurée,
latestet$COMMIT_SHA— vers le dépôt Artifact Registry partagé (shared-repo-*), découvert ou créé en solution de repli. - Sécurité de la chaîne d'approvisionnement : lorsque
enable_binary_authorization = true, l'étape 2 résout le condensé (digest) de l'image et exécutegcloud beta container binauthz attestations sign-and-createavec l'attesteurpipeline-attestor, en signant avec la clé KMSbinauthz-signerdu trousseau{project}-binauthz-keyring. Le service Cloud Run utilise la règle Binary Authorization par défaut du projet ; le cluster GKE applique la règle unique du projet. Le niveau d'application de la règle dépend debinauthz_evaluation_mode(par défautALWAYS_ALLOW; définissezREQUIRE_ATTESTATIONpour l'imposer). - CD :
enable_cloud_deploy(par défautfalse) provisionne un pipeline de livraison Cloud Deploy ainsi qu'une cible par étape. Notez que le définir sansenable_cicd_trigger = trueest rejeté par une précondition au moment du plan — un pipeline de livraison sans déclencheur CI ne recevrait jamais de releases. Les configurations Skaffold résident dans un bucket GCS nommé{project}-{8-char-hash}-cd-configs. - Les builds s'exécutent sous un compte de service dédié (
cloudbuild-sa-*), qui reçoitroles/clouddeploy.releaseret un accès en lecture au bucket Skaffold — et non sous une identité par défaut aux droits étendus.
À vous de jouer
- Déployez le profil ingénieur pipeline, puis poussez un commit sur la branche
maindu dépôt connecté (lecicd_trigger_config.branch_patterndu déclencheur vaut par défaut^main$). - Suivez le build : Console > Cloud Build > History — repérez l'étape Kaniko, l'étape d'attestation et l'étape de déploiement.
gcloud builds list --region=us-central1 --limit=3
gcloud artifacts docker images list \
  us-central1-docker.pkg.dev/$GOOGLE_PROJECT_ID/<repo-name>/<app-name> \
  --include-tags --limit=5
gcloud container binauthz attestations list \
  --attestor=pipeline-attestor --attestor-project=$GOOGLE_PROJECT_ID --limit=3
- Dans Console > Cloud Deploy > Delivery pipelines, ouvrez le pipeline et vérifiez qu'une release nommée
release-<short-sha>est arrivée dans la première étape. - Vous savez que cela a fonctionné lorsque l'image apparaît dans Artifact Registry avec le tag du SHA de commit, qu'une attestation existe pour son condensé et que l'étape dev affiche un déploiement réussi.
Testez-vous
Q1 : Pourquoi l'étape d'attestation signe-t-elle le condensé de l'image plutôt que le tag :latest ou celui du SHA de commit ?
R : Les tags sont des pointeurs modifiables ; un condensé est l'identité de l'image adressée par son contenu. Binary Authorization vérifie les attestations par rapport au condensé déployé ; signer un tag permettrait donc à une image repoussée d'hériter d'une signature qu'elle n'a jamais méritée.
Q2 : Un collègue définit enable_cloud_deploy = true mais laisse enable_cicd_trigger = false, et le plan échoue avec une erreur de précondition. Bug ou choix de conception ?
R : Choix de conception — une précondition au moment du plan rejette enable_cloud_deploy = true sans enable_cicd_trigger = true, car un pipeline de livraison sans déclencheur CI pour l'alimenter en releases resterait vide. Le parallèle avec l'examen : la CD se situe en aval de la CI ; concevez la pile comme un flux unique.
Q3 : Pourquoi Kaniko plutôt qu'une étape de build utilisant un daemon Docker ?
R : Kaniko construit des images OCI entièrement dans l'espace utilisateur, à l'intérieur du conteneur de build — sans socket de daemon Docker privilégié —, ce qui réduit la surface d'attaque de l'environnement de build ; c'est le modèle recommandé dans Cloud Build.
Au-delà des modules — Le lab se limite à Google Cloud. Pour la moitié « hybride et multicloud » du titre, étudiez comment Cloud Deploy atteint les clusters GKE associés (attached clusters) et les cibles personnalisées, et où se situent les outils tiers largement utilisés : Jenkins ou GitHub Actions comme alternative de CI, Argo CD comme CD GitOps en mode pull, Packer pour les images de VM et kpt pour la configuration Kubernetes par paquets. Les configurations Skaffold générées par les modules déploient des manifestes bruts (rawYaml) ; Kustomize, que Cloud Deploy sait aussi rendre via Skaffold, n'est pas utilisé. Pour la sécurité des outils CI/CD, connaissez les pools privés de Cloud Build, les comptes de service de build à privilège minimal et la fédération d'identité de charge de travail pour une CI externe, à la place des clés de compte de service.
⚠️ Piège d'examen — binauthz_evaluation_mode = "ALWAYS_ALLOW" (la valeur par défaut ici) signifie que Binary Authorization est configuré mais n'impose rien. La création d'attestations dans le pipeline n'a aucun effet tant que la règle n'indique pas REQUIRE_ATTESTATION.
1.4 Gérer plusieurs environnements (Managing multiple environments)
⏱ ~45 min · 💰 faible à modéré (un service Cloud Run ou un namespace GKE par étape) · ⚙️ Prérequis : profil ingénieur pipeline avec
enable_cloud_deploy = true
Pourquoi l'examen s'y intéresse — Vous devez garder dev/staging/prod structurellement identiques tout en faisant varier les paramètres, décider où placer les portes d'approbation et savoir de quelle frontière d'isolation chaque environnement a besoin (namespace vs service vs projet). Les scénarios d'examen sondent les mécanismes de promotion : quel artefact passe d'une étape à l'autre et ce qui ne doit pas être reconstruit.
Comment RAD le met en œuvre — cloud_deploy_stages définit le chemin de promotion. La valeur par défaut est :
[
  { name = "dev",     require_approval = false, auto_promote = false },
  { name = "staging", require_approval = false, auto_promote = false },
  { name = "prod",    require_approval = true,  auto_promote = false },
]
Chaque étape devient une cible Cloud Deploy (avec require_approval reporté tel quel) et un environnement d'exécution suffixé par le nom de l'étape : des services Cloud Run nommés <service>-<stage>, ou des namespaces GKE par étape transmis à Skaffold via le paramètre de déploiement NAMESPACE. Les étapes avec auto_promote = true reçoivent une automatisation Cloud Deploy dotée d'une règle advance-rollout, de sorte qu'un déploiement réussi progresse automatiquement. Terraform ne provisionne que le service/namespace de la première étape ; les étapes suivantes se matérialisent lorsque Cloud Deploy y effectue une promotion — même release rendue, même condensé d'image, aucune reconstruction. Des surcharges par étape (project_id, region, service_name) existent sur chaque objet d'étape, ce qui permet d'exprimer une promotion entre projets, même si le lab exécute toutes les étapes dans un seul projet.
Les autres considérations du point 1.4, et l'endroit où le lab les aborde :
- Environnements éphémères : chaque déploiement est créé et supprimé via le portail ; un environnement de test de courte durée n'est donc qu'un déploiement suivi d'une suppression. Les modules ne le font pas expirer automatiquement.
- Application sûre des correctifs et des mises à niveau : le cluster GKE de
Services_GCPest inscrit dans le canal de releaseREGULAR, si bien que Google le met à niveau automatiquement ; la maintenance Cloud SQL est planifiée avecsql_maintenance_window_day(par défaut7),sql_maintenance_window_hour(par défaut3) etsql_maintenance_update_track(par défautstable;canaryreçoit les mises à jour environ une semaine plus tôt, ce qui permet à un projet de préproduction de rencontrer un problème de maintenance avant la production). - Parcs et règles : dans un projet que vous apportez vous-même,
Services_GCPenregistre son cluster dans un parc GKE lorsque vous définissezconfigure_config_management,configure_policy_controller(contraintes OPA Gatekeeper),configure_cloud_service_meshougke_cluster_countau-delà de1. Ces options sont masquées pour les projets que RAD crée pour vous.
À vous de jouer
- Avec le profil ingénieur pipeline déployé, faites sortir la release actuelle de dev par promotion :
gcloud deploy releases promote \
  --delivery-pipeline=<pipeline-name> \
  --region=us-central1 --project=$GOOGLE_PROJECT_ID
- Promouvez de nouveau vers prod, puis ouvrez Console > Cloud Deploy > (pipeline) — le déploiement en prod s'arrête sur Pending approval (en attente d'approbation). Approuvez-le :
gcloud deploy rollouts list --delivery-pipeline=<pipeline-name> \
  --release=<release-name> --region=us-central1
gcloud deploy rollouts approve <rollout-name> \
  --delivery-pipeline=<pipeline-name> --release=<release-name> \
  --region=us-central1
- Comparez les environnements :
gcloud run services listaffiche maintenant<service>-dev,<service>-staging,<service>-prodexécutant le même condensé d'image. - Vous savez que cela a fonctionné lorsque le déploiement en prod a exigé une approbation explicite et que les trois services indiquent le même condensé d'image dans
gcloud run services describe ... --format="value(spec.template.spec.containers[0].image)".
Testez-vous
Q1 : Staging a validé le condensé d'image X, mais prod exécute le condensé Y après la promotion. Dans un pipeline correctement conçu, est-ce possible ?
R : Non — Cloud Deploy promeut la release, qui fige les condensés d'image au moment de la création de la release. Si prod affiche un condensé différent, quelque chose en dehors du pipeline l'a déployé (les journaux d'audit montreront qui), ou bien le pipeline reconstruit à chaque étape, ce qui va à l'encontre du principe « construire une fois, promouvoir plusieurs fois » attendu par l'examen.
Q2 : Où ajouteriez-vous un passage entièrement automatique dev → staging tout en conservant la porte de prod ?
R : Définissez auto_promote = true sur l'étape dev — le module crée alors une automatisation Cloud Deploy avec une règle advance-rollout limitée à la cible dev. Prod conserve require_approval = true, de sorte que l'automatisation ne contourne jamais la porte humaine.
Au-delà des modules — Le lab conserve toutes les étapes dans un seul projet. Pour être complet en vue de l'examen, étudiez l'isolation des environnements par projet (IAM, quotas et VPC distincts par environnement), les paramètres de déploiement et les cibles personnalisées de Cloud Deploy, ainsi que la vérification post-déploiement (verify dans les profils Skaffold), dont aucun n'est configuré par les modules. Étudiez aussi la gestion à l'échelle d'un parc en entreprise (champs d'application de parc, namespaces d'équipe, Config Sync depuis votre propre dépôt, bundles Policy Controller au niveau du parc), les intervalles et exclusions de maintenance GKE, et les mises à niveau par surcapacité (surge upgrades) des pools de nœuds.
⚠️ Piège d'examen — require_approval conditionne le déploiement dans la cible, pas la création de la release. Une release peut exister et rester indéfiniment sans promotion ; l'approbation se fait par cible, c'est pourquoi seule la cible prod porte cet indicateur.
1.5 Mettre en place des environnements de développement cloud sécurisés (Enabling secure cloud development environments)
⏱ ~45 min · 💰 faible (un service Cloud Run tant qu'il tourne) · ⚙️ Prérequis : un déploiement
CodeServer_CloudRun(facultatif)
Pourquoi l'examen s'y intéresse — Les environnements des développeurs font partie du système de livraison : un ordinateur portable doté d'identifiants à longue durée de vie et d'outils installés à la main est à la fois un risque de sécurité et une source de dérive du type « ça marche sur ma machine ». L'examen teste les alternatives gérées (Cloud Workstations, Cloud Shell), la manière d'amorcer un environnement avec les bons outils (images personnalisées, IDE, Cloud SDK) et la place de l'assistance par IA dans le développement et l'exploitation : Gemini Code Assist dans l'IDE, Gemini Cloud Assist dans la console et la Gemini CLI dans le terminal.
Comment RAD le met en œuvre — Uniquement par analogie. Aucun module ne provisionne Cloud Workstations ni ne configure Gemini. La capacité la plus proche est constituée des wrappers CodeServer_CloudRun / CodeServer_GKE (et des wrappers Coder_CloudRun / Coder_GKE, qui déploient la plateforme d'espaces de travail Coder), qui exécutent un VS Code dans le navigateur sur les mêmes moteurs fondamentaux que n'importe quelle autre application :
- Image personnalisée : l'image est construite à partir d'un Dockerfile d'une ligne (
FROM codercom/code-server). C'est là qu'une équipe intégrerait le Cloud SDK et ses propres outils ; le module n'en ajoute aucun. - Contrôle d'accès :
enable_password(par défauttrue) génère un mot de passe aléatoire pour l'éditeur et le stocke dans Secret Manager ;enable_iap(par défautfalse) aveciap_authorized_usersplace Identity-Aware Proxy devant l'éditeur, de sorte que l'accès exige une identité Google. - Persistance : sur Cloud Run, le répertoire personnel repose sur un bucket Cloud Storage déclaré par le module.
À vous de jouer
- Déployez
CodeServer_CloudRun, puis définissezenable_iap = trueetiap_authorized_users = ["user:you@example.com"]avec Update. - Ouvrez l'URL du service dans une fenêtre de navigation privée et vérifiez que vous êtes redirigé vers une connexion Google avant le chargement de l'éditeur.
- Comparez avec le produit géré dans un projet de test : Console > Cloud Workstations, créez une configuration de station de travail à partir d'une image prédéfinie et notez ce que Google gère pour vous (application des correctifs à l'image, arrêt en cas d'inactivité, aucune IP publique).
- Vous savez que cela a fonctionné lorsqu'une requête non authentifiée n'atteint jamais l'éditeur et que vous pouvez citer deux éléments que Cloud Workstations gère et que l'éditeur auto-hébergé laisse à votre charge.
Testez-vous
Q1 : Des prestataires ont besoin d'un IDE cohérent et préconfiguré, avec accès à des ressources privées dans un VPC, et la sécurité interdit tout code source sur les ordinateurs personnels. Quel service Google Cloud convient ?
R : Cloud Workstations. Les configurations de station de travail définissent une image de conteneur (prédéfinie ou personnalisée, avec vos outils intégrés), s'exécutent dans votre VPC et peuvent être limitées à des points de terminaison privés, de sorte que le code source reste dans Google Cloud. Cloud Shell est un environnement personnel et éphémère doté d'un petit répertoire personnel persistant, et non un environnement d'équipe gouverné.
Q2 : Un ingénieur d'astreinte veut un résumé en langage clair des raisons de la hausse du taux d'erreurs d'un service Cloud Run, sans écrire d'abord une requête de journaux. Quel outil d'IA est conçu pour cela ?
R : Gemini Cloud Assist, qui travaille dans la console Google Cloud sur les ressources, les journaux et les métriques de votre projet. Gemini Code Assist vise l'écriture de code dans l'IDE, et la Gemini CLI apporte le modèle dans le terminal.
Au-delà des modules — Étudiez les configurations Cloud Workstations (images prédéfinies vs personnalisées, délais d'inactivité et d'exécution, clusters privés, disques persistants), Cloud Shell (répertoire personnel persistant de 5 GB, Cloud SDK préinstallé, VM éphémère) et les trois déclinaisons de Gemini citées dans le guide de l'examen : Gemini Code Assist, Gemini Cloud Assist et la Gemini CLI. Aucune n'est provisionnée ni configurée par les modules RAD.
⚠️ Piège d'examen — Un IDE auto-hébergé dans le navigateur n'est pas un équivalent de Cloud Workstations simplement parce qu'il s'exécute sur Google Cloud. Le service géré est la bonne réponse lorsqu'une question met l'accent sur des images gouvernées de manière centralisée, un accès privé au VPC ou l'absence de code source sur les postes.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.