Guide de préparation à la certification PDE : Section 2 — Concevoir et mettre en œuvre des pipelines CI/CD, y compris les tests continus, pour les charges de travail applicatives, d'infrastructure et de machine learning (Building and implementing CI/CD pipelines, including continuous testing, for application, infrastructure, and machine learning workloads) (~25 % de l'examen)
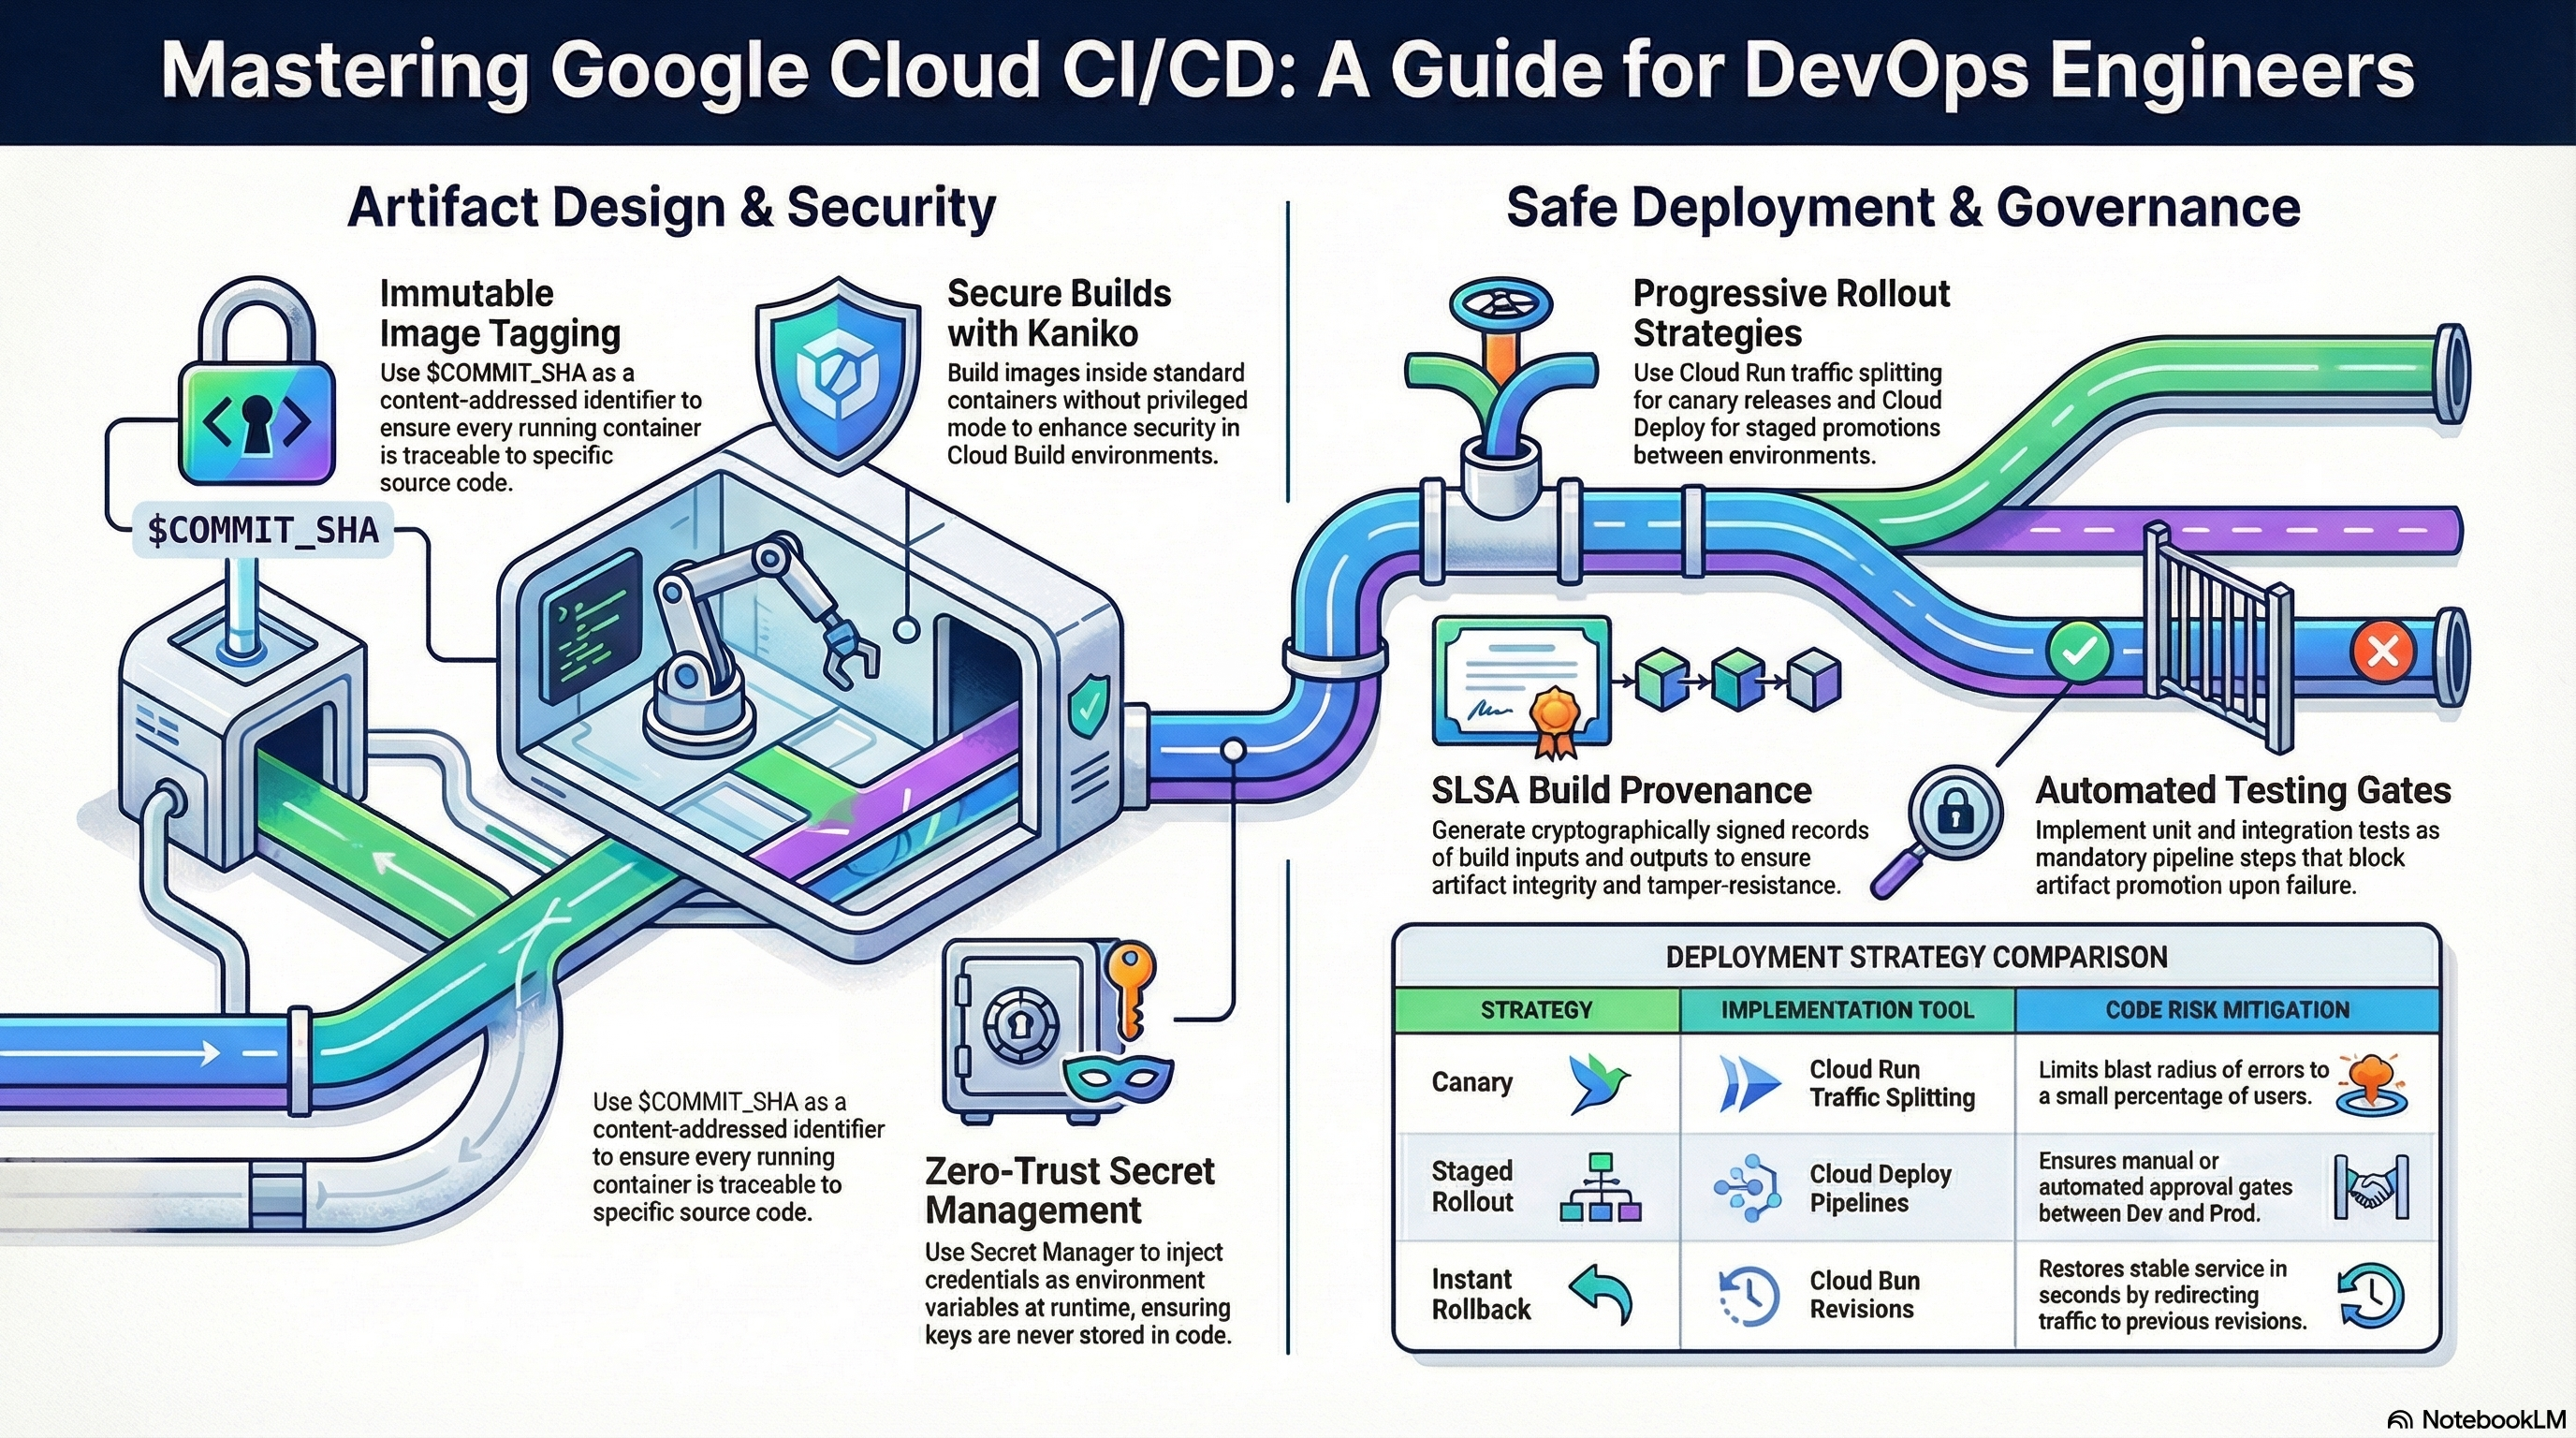
📚 Guide officiel de l'examen : Professional Cloud DevOps Engineer certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Cette section partage avec la section 4 la plus forte pondération de l'examen et constitue le lab le plus solide de la plateforme RAD. Le pipeline est implémenté dans App_CloudRun et App_GKE (une définition Cloud Build inline : build Kaniko → attestation Binary Authorization facultative → déploiement), les briques partagées App_Common fournissant le pipeline Cloud Deploy et la connexion GitHub. Déployez le profil Pipeline engineer (ingénieur pipeline) de la carte des labs avant de commencer ; la sous-section 2.2 utilise aussi le profil GKE release engineer (ingénieur de release GKE) pour le chemin Kubernetes.
2.1 Concevoir des pipelines (Designing pipelines)
⏱ ~60 min · 💰 faible (minutes Cloud Build, stockage AR) · ⚙️ Prérequis : profil ingénieur pipeline
Pourquoi l'examen s'y intéresse — Les questions de conception de pipeline testent la stratégie d'artefacts : des références d'image immuables et traçables (condensé/SHA de commit plutôt que latest), la mise en cache des builds pour la rapidité, l'hygiène du registre (règles de nettoyage pour que le stockage ne croisse pas indéfiniment) et l'emplacement de l'analyse des vulnérabilités. Vous devez pouvoir justifier l'ordre de chaque étape et le rayon d'impact d'une erreur.
Comment RAD le met en œuvre — Un déclencheur, trois étapes de build, définis inline dans App_CloudRun :
| Décision de conception | Mise en œuvre |
|---|---|
| Portée du déclencheur | cicd_trigger_config.branch_pattern (par défaut ^main$), plus des filtres de chemins facultatifs included_files/ignored_files et des substitutions personnalisées |
| Outil de build | Kaniko v1.23.2, sans daemon, avec un cache de couches de 24h pour la réutilisation |
| Tags | chaque build pousse trois tags : <application_version>, latest et $COMMIT_SHA — le tag du SHA est celui qu'utilise l'étape de déploiement, ce qui préserve la traçabilité du commit jusqu'à l'exécution |
| Registre | dépôt partagé découvert automatiquement ; s'il est absent, la plateforme crée shared-repo-<prefix> (format Docker, tags modifiables) |
| Nettoyage | trois règles limitées aux images de cette application : une règle KEEP conservant les max_images_to_retain (par défaut 7) versions les plus récentes, une règle DELETE pour les images sans tag lorsque delete_untagged_images (par défaut true), et une règle DELETE pour les images de plus de image_retention_days (par défaut 30) jours |
| Journalisation des builds | les journaux de build arrivent dans Cloud Logging, pas dans un bucket GCS de journaux |
| Identité de build | un compte de service Cloud Build dédié à chaque déploiement, et non l'ancien compte par défaut du projet |
L'analyse des vulnérabilités est une option de la couche plateforme : enable_vulnerability_scanning (par défaut false) dans Services_GCP active l'analyse des vulnérabilités héritée du dépôt Artifact Registry.
À vous de jouer
- Poussez un commit trivial sur le dépôt connecté et suivez Console > Cloud Build > History ; ouvrez le build et lisez le journal de chaque étape (les accès au cache Kaniko sont visibles au deuxième build — comparez les durées).
- Inspectez la trace des artefacts :
gcloud builds list --region=us-central1 --limit=2
gcloud artifacts docker images list \
  us-central1-docker.pkg.dev/$GOOGLE_PROJECT_ID/<repo>/<app> --include-tags
gcloud artifacts repositories describe <repo> --location=us-central1 \
  --format="yaml(cleanupPolicies)"
- Dans le portail, abaissez
image_retention_daysà7et réappliquez ; relancez la commandedescribeet vérifiez que leolderThande la règledelete-old-imagesest passé à604800s. - Vous savez que cela a fonctionné lorsque chaque version d'image affiche les trois tags et que les règles de nettoyage reflètent les valeurs de vos variables.
Testez-vous
Q1 : Les coûts de stockage de votre registre ne cessent d'augmenter, alors qu'une règle de nettoyage supprime les images de plus de 30 jours. Les builds s'exécutent 40×/jour. Quelle est la lacune probable ?
R : Les images sans tag (des couches orphelines chaque fois que latest est redirigé) ne sont pas couvertes par une simple règle fondée sur l'âge des images taguées. La plateforme RAD associe précisément pour cette raison la règle d'âge à une règle DELETE des images sans tag (delete_untagged_images). Vérifiez aussi que le nombre défini par la règle KEEP ne conserve pas plus que prévu.
Q2 : Pourquoi l'étape de déploiement référence-t-elle le tag $COMMIT_SHA plutôt que latest, alors que les deux pointent vers la même image juste après le build ?
R : latest est un pointeur mobile — un build concurrent ou ultérieur change ce vers quoi il pointe, ce qui ruine la reproductibilité et le raisonnement sur le retour arrière. Le SHA de commit est stable et relie la révision en cours d'exécution au commit source exact, ce dont l'audit et l'investigation d'incidents ont aussi besoin.
Q3 : Où ajouteriez-vous une porte de tests unitaires dans ce pipeline, et qu'est-ce qui fait échouer le build ?
R : Sous forme d'étape avant l'étape Kaniko (ou d'un stage de test dans le Dockerfile). Toute étape qui se termine avec un code non nul fait échouer l'ensemble de l'exécution Cloud Build, de sorte que rien n'est poussé ni déployé — le contrat CI classique d'échec rapide (fail-fast).
Au-delà des modules — Le titre de la section mentionne désormais les tests continus et trois types de charges de travail. Le pipeline RAD construit et déploie un conteneur applicatif ; il n'exécute aucun test et ne construit pas d'artefacts d'infrastructure ni de ML. Étudiez les étapes de test dans Cloud Build (tests unitaires avant l'étape de build, tests d'intégration sur une étape déployée), la CI/CD pour l'infrastructure (un tofu plan sur pull request, apply à la fusion, ou Infrastructure Manager) et les pipelines de ML (Vertex AI Pipelines, avec modèles et conteneurs versionnés dans Artifact Registry et Vertex AI Model Registry). Les types de déclencheurs autres qu'un push sur une branche (pull request, tag, manuel, Pub/Sub, webhook) et les flux d'approbation sur le déclencheur Cloud Build lui-même (approvalConfig) peuvent aussi faire l'objet de questions ; les approbations Cloud Deploy sont traitées dans la section 1.4.
⚠️ Piège d'examen — Les règles KEEP d'Artifact Registry l'emportent sur les règles DELETE : une image correspondant à la règle KEEP most_recent_versions n'est jamais supprimée, même si elle dépasse le seuil d'âge. Raisonnez sur le nettoyage comme « règles DELETE moins règles KEEP ».
2.2 Mettre en œuvre et gérer des pipelines (Implementing and managing pipelines)
⏱ ~90 min · 💰 faible à modéré (services par étape) · ⚙️ Prérequis : profil ingénieur pipeline ; profil ingénieur de release GKE pour le chemin Kubernetes
Pourquoi l'examen s'y intéresse — C'est la sous-section des stratégies de déploiement : canary vs blue/green vs rolling, la façon dont la répartition du trafic de Cloud Run met en œuvre les déploiements canary, le fonctionnement concret de la promotion, de l'approbation et du retour arrière dans Cloud Deploy, et ce que fait réellement une mise à jour progressive Kubernetes. Attendez-vous à des scénarios du type « les erreurs ont explosé après le déploiement — quelle est l'action sûre la plus rapide ? ».
Comment RAD le met en œuvre
- Canary Cloud Run :
traffic_split(par défaut[]= 100 % vers la dernière révision) est une liste d'objets{ type, revision, percent, tag }rendus dans la configuration du trafic du service. Des validations exigent que les pourcentages totalisent exactement 100 et qu'unerevisionfigure dans chaque entrée d'allocation par révision. Letagfacultatif donne à une révision une URL stable pour la tester avant qu'elle ne reçoive du trafic réel. - Hygiène des révisions :
max_revisions_to_retain(par défaut7) élague les anciennes révisions après chaque apply — il liste les révisions de la plus récente à la plus ancienne et supprime l'excédent, en ignorant toute révision qui reçoit actuellement du trafic. - Mécanismes de Cloud Deploy : les cibles portent
require_approval;auto_promote = truesur une étape crée une automatisation Cloud Deploy avec une règle advance-rollout. L'agent de service Cloud Deploy reçoitroles/run.admin(Cloud Run) ouroles/container.developer(GKE) ; le compte de service Cloud Build reçoitroles/clouddeploy.releaser. - Deux chemins de déploiement depuis la CI (Cloud Run) : avec
cicd_enable_cloud_deploy = true(par défautfalse), l'étape de déploiement du déclencheur crée une release avecgcloud deploy releases create release-<short-sha> --source=<skaffold-from-GCS>; sinon, elle appelle directementgcloud run services update --image=...:$COMMIT_SHA. - Mise à jour progressive GKE : le chemin direct du déclencheur GKE exécute
kubectl set image <workload-type>/<name> ... -n <namespace>. Le Deployment Kubernetes ne définit aucune stratégie explicite ; c'est donc la stratégie RollingUpdate par défaut de Kubernetes (25 % maxSurge / 25 % maxUnavailable) qui s'applique ; les StatefulSets utilisentstateful_update_strategy(par défautRollingUpdate, ouOnDeletepour un contrôle manuel). Le PodDisruptionBudget (enable_pod_disruption_budget, par défauttrue) protège la disponibilité lors des perturbations au niveau des nœuds qui accompagnent les mises à jour.
À vous de jouer
- Canary Cloud Run : déployez une modification de configuration pour créer une deuxième révision, listez les révisions, puis définissez dans le portail :
traffic_split = [
  { type = "TRAFFIC_TARGET_ALLOCATION_TYPE_LATEST", percent = 10, tag = "canary" },
  { type = "TRAFFIC_TARGET_ALLOCATION_TYPE_REVISION", revision = "<service>-00001-xyz", percent = 90 }
]
Appliquez, puis vérifiez :
gcloud run services describe <service> --region=us-central1 \
  --format="yaml(status.traffic)"
- Effectuez un retour arrière instantané en modifiant la répartition pour envoyer 100 % du trafic vers l'ancienne révision, puis réappliquez — aucun build, aucune nouvelle révision.
- Retour arrière Cloud Deploy : dans Console > Cloud Deploy > (pipeline) > (target), cliquez sur Rollback, ou :
gcloud deploy targets rollback <target-name> \
  --delivery-pipeline=<pipeline> --region=us-central1
- Mise à jour progressive GKE (profil GKE) : déclenchez-en une manuellement et suivez-la :
kubectl set image deployment/<name> <app>=<image>:<new-tag> -n <namespace>
kubectl rollout status deployment/<name> -n <namespace>
kubectl rollout undo deployment/<name> -n <namespace>   # instant revert
kubectl get pdb -n <namespace>                          # the module-created PDB
- Vous savez que cela a fonctionné lorsque
status.trafficaffiche votre répartition 90/10 avec une URL de tagcanary, et que le déploiement GKE remplace les pods progressivement tandis que le PDB indiqueALLOWED DISRUPTIONS≥ 0 tout du long.
Testez-vous
Q1 : Cinq minutes après un déploiement Cloud Run, le taux d'erreurs 5xx triple. Quelle est l'atténuation sûre la plus rapide ?
R : Renvoyer 100 % du trafic vers la révision saine précédente (gestionnaire de trafic de la console, gcloud run services update-traffic, ou traffic_split dans l'IaC). Les anciennes révisions restent instantanément déployables ; cela prend quelques secondes et ne nécessite aucun build. Examinez ensuite la révision défectueuse via ses journaux — elle existe toujours, elle ne reçoit simplement plus de trafic.
Q2 : Quelle est la différence entre un canary par répartition du trafic Cloud Run et une stratégie canary Cloud Deploy ?
R : La répartition du trafic est un contrôle d'exécution sur un service, entre ses révisions — vous déplacez vous-même les pourcentages. Le canary de Cloud Deploy est une stratégie de pipeline qui automatise une progression par paliers de pourcentage avec vérification entre les phases. Les modules RAD mettent en œuvre la première et utilisent une simple promotion par étapes (et non la stratégie canary) dans Cloud Deploy.
Q3 : Pourquoi l'élagage des révisions ignore-t-il les révisions qui reçoivent du trafic, et quelle défaillance leur suppression provoquerait-elle ?
R : Une révision qui reçoit un pourcentage quelconque de trafic constitue une capacité active ; la supprimer casserait la répartition du trafic (gcloud refuse la suppression). L'élagage de rétention ne doit jamais retirer que des révisions entièrement vidées — c'est la même raison pour laquelle vous conservez N révisions réputées saines comme réserve de retour arrière.
Au-delà des modules — Les feature flags (qui découplent la mise en production du déploiement), la stratégie canary de Cloud Deploy avec des pourcentages par phase et un job verify, ainsi que la vérification de déploiement ou le retour arrière automatisé piloté par des métriques de réussite (taux d'erreurs et latence issus de Cloud Monitoring, ou télémétrie de qualité de modèle issue d'un pipeline de ML) ne sont pas configurés par les modules. Pour le dépannage des problèmes de déploiement, entraînez-vous à lire un déploiement Cloud Deploy en échec (gcloud deploy rollouts describe) et les journaux de rendu/déploiement Cloud Build qui y sont liés.
⚠️ Piège d'examen — Blue/green ≠ canary : le blue/green bascule 100 % du trafic d'un coup entre deux environnements complets (retour arrière instantané, capacité doublée) ; le canary déplace d'abord un petit pourcentage (risque progressif, pas de capacité doublée). La répartition du trafic de Cloud Run peut exprimer les deux, mais l'examen attend que vous nommiez la bonne stratégie compte tenu de la contrainte donnée.
Auditer et suivre les déploiements (Auditing and tracking deployments)
⏱ ~45 min · 💰 faible à modéré (ingestion des journaux d'audit) · ⚙️ Prérequis : profil ingénieur pipeline +
enable_audit_logging = true
Pourquoi l'examen s'y intéresse — Après un déploiement non autorisé ou défectueux, vous devez reconstituer qui a déployé quoi, quand, et à partir de quelle source. L'examen teste la connaissance des journaux d'audit des activités d'administration vs des journaux d'audit d'accès aux données (les premiers toujours actifs et gratuits, les seconds à activer et facturés), et la manière dont la provenance des artefacts et l'historique des releases bouclent la chaîne du commit jusqu'à l'exécution.
Comment RAD le met en œuvre
- Journaux d'audit d'accès aux données :
enable_audit_logging(par défautfalsedans les deux moteurs et dansServices_GCP) active la journalisation d'audit IAM du projet pourallServicesavecADMIN_READ,DATA_READetDATA_WRITE, ainsi que des configurations explicites par service pour Secret Manager et Cloud KMS — de sorte que chaque accès à un secret et chaque utilisation de clé sont journalisés. - Chaîne de provenance du déploiement : SHA de commit → tag d'image (étape de build) → attestation sur le condensé de l'image (étape Binary Authorization) → release Cloud Deploy figeant le condensé → historique des déploiements par cible avec l'identité de l'approbateur. Chaque maillon peut être interrogé.
- Les journaux de build sont forcés vers Cloud Logging (
CLOUD_LOGGING_ONLY), ce qui rend l'activité de build consultable à côté des journaux d'audit. - Historique de configuration : chaque modification d'infrastructure passe par
tofu plan/apply; l'historique git du dépôt IaC et les instantanés d'état constituent donc la piste d'audit de la configuration.
À vous de jouer
- Activez
enable_audit_logging = true, appliquez, puis lisez votre propre piste. Trouvez qui a déployé la dernière révision Cloud Run :
gcloud logging read \
  'protoPayload.serviceName="run.googleapis.com"
   AND protoPayload.methodName:"Services.ReplaceService"' \
  --limit=5 --format="table(timestamp, protoPayload.authenticationInfo.principalEmail)"
- Lisez un secret dans la console, puis prouvez que la journalisation des accès aux données l'a capturé :
gcloud logging read \
  'protoPayload.serviceName="secretmanager.googleapis.com"
   AND protoPayload.methodName:"AccessSecretVersion"' --limit=5
- Parcourez la chaîne de provenance de l'image en cours d'exécution : récupérez son condensé avec
gcloud run services describe, puisgcloud container binauthz attestations list --attestor=pipeline-attestorpour trouver sa signature, puis Console > Cloud Deploy > (pipeline) > Release history pour voir quand elle a été promue et qui a approuvé la prod. - Vous savez que cela a fonctionné lorsque vous pouvez nommer le principal, l'horodatage, le condensé d'image et l'utilisateur approbateur du dernier déploiement en prod sans quitter la console/la CLI.
Testez-vous
Q1 : La sécurité demande un relevé de chaque lecture du mot de passe de la base de données de production au cours du dernier mois, mais Logs Explorer n'affiche rien. Cause la plus probable ?
R : Les journaux d'audit d'accès aux données (DATA_READ) n'étaient pas activés pour Secret Manager — seuls les journaux des activités d'administration sont actifs par défaut, et la lecture d'une version de secret est un accès aux données, pas une action d'administration. C'est exactement ce qu'active enable_audit_logging ; cela ne peut pas être activé rétroactivement.
Q2 : Une image tourne en prod sans avoir été produite par aucune exécution Cloud Build. Quels sont les deux contrôles de ce lab qui l'auraient (a) détectée et (b) empêchée ?
R : (a) Les journaux d'audit des activités d'administration sur run.googleapis.com montrent l'appel ReplaceService hors pipeline et son principal. (b) Binary Authorization avec binauthz_evaluation_mode = "REQUIRE_ATTESTATION" aurait bloqué le déploiement, puisque seul le pipeline détient la clé de signature KMS de pipeline-attestor.
Au-delà des modules — Les modules ne configurent ni récepteurs de journaux ni conservation : étudiez les récepteurs agrégés vers BigQuery/GCS pour la conservation à long terme des journaux d'audit, les paramètres de conservation des buckets de journaux (gcloud logging buckets update _Default --retention-days=...) et la provenance SLSA générée nativement par Cloud Build (gcloud artifacts docker images describe ... --show-provenance) — l'attestation KMS du pipeline RAD est un mécanisme apparenté mais distinct.
⚠️ Piège d'examen — Les journaux d'audit des activités d'administration sont toujours actifs, non configurables et gratuits ; les journaux d'accès aux données sont désactivés par défaut (sauf pour BigQuery), doivent être activés par service ou via allServices, et peuvent coûter cher en volume. Les questions qui reposent sur « pourquoi n'y a-t-il aucun journal ? » tournent généralement autour de cette distinction.
2.3 Gérer la configuration et les secrets des pipelines (Managing pipeline configuration and secrets)
⏱ ~45 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : profil ingénieur pipeline
Pourquoi l'examen s'y intéresse — Les secrets dans les pipelines sont un mode de défaillance classique : jetons dans le code source, mots de passe dans l'état Terraform, texte en clair dans les journaux de build. L'examen teste l'endroit où les secrets doivent résider (Secret Manager), la manière dont ils atteignent l'exécution (des références, pas des valeurs) et la façon dont la rotation s'effectue sans interruption de service.
Comment RAD le met en œuvre
- Le PAT GitHub n'entre jamais dans l'état Terraform :
github_token(sensible) n'est requis qu'au premier apply ; la plateforme l'écrit avecgcloud secrets versions add(un provisioner, et non un attribut de ressource stocké) et le secret est abandonné plutôt que supprimé lors de la destruction. Lors des applies suivants, le jeton stocké est réutilisé — le déclencheur résout la version de secret existante au lieu de redemander le jeton. - Les secrets d'exécution sont des références :
secret_environment_variables(map variable d'environnement → nom de secret) est rendu sous forme de références de secrets Cloud Run ; le moteur GKE synchronise les secrets via le module complémentaire Secret Manager CSI vers des Secrets Kubernetes. Le conteneur voit une valeur ; l'état et les manifestes voient une référence. - Générés, pas choisis : le mot de passe de la base de données est une valeur aléatoire de
database_password_length(par défaut32) caractères, stockée directement dans Secret Manager. - Rotation :
secret_rotation_period(par défaut2592000s= 30 jours) configure les notifications de rotation de Secret Manager vers un sujet Pub/Sub ;enable_auto_password_rotation(par défautfalse) boucle la boucle avec un job de rotation déclenché par Eventarc qui effectue une rotation à deux versions, sans interruption de service (ajout de la nouvelle version → mise à jour de l'utilisateur de la base de données → désactivation de l'ancienne version aprèsrotation_propagation_delay_sec, par défaut90). - Les paramètres de pipeline non secrets circulent sous forme de substitutions Cloud Build (
cicd_trigger_config.substitutions), visibles dans la définition du déclencheur — la distinction, attendue à l'examen, entre configuration et secrets. - Injection au build vs à l'exécution : ce pipeline n'injecte aucun secret au moment du build. Les arguments de build Docker sont transmis à Kaniko sous forme de simples options
--build-arg, visibles dans le déclencheur et dans le journal de build ; ils servent donc uniquement à la configuration ; chaque identifiant dont l'application a besoin arrive à l'exécution sous forme de référence de secret. Lorsqu'un build a réellement besoin d'un secret,availableSecretsavecsecretEnvdans Cloud Build est le modèle à connaître. - Gestion des clés : la clé de signature Binary Authorization (
binauthz-signer) est une clé asymétrique Cloud KMS ;enable_cmek(par défautfalse) dansServices_GCPcrée une clé Cloud KMS pour le chiffrement géré par le client des ressources compatibles, avec rotation tous lescmek_key_rotation_period(par défaut7776000s= 90 jours). - Certificats : lorsque
App_GKEsert le trafic via la Gateway API, il émet des certificats gérés par Google via Certificate Manager et les rattache au moyen d'une map de certificats. - Fédération d'identité de charge de travail :
enable_workload_identity_federation(par défautfalse, avec unwif_provider_typeparmigithub,gitlabougeneric) dansServices_GCPcrée un pool et un fournisseur afin qu'une CI externe puisse appeler Google Cloud sans clé de compte de service. Cette option n'est disponible que dans un projet que vous apportez vous-même ; elle est masquée pour les projets que RAD crée pour vous.
À vous de jouer
- Listez les secrets créés par le module et vérifiez qu'aucune valeur n'est visible nulle part dans les sorties de l'IaC :
gcloud secrets list --filter="name~<deployment-prefix>" \
  --format="table(name,createTime)"
gcloud secrets versions list <db-password-secret-name>
- Dans Console > Cloud Run > (service) > Revisions > (latest) > Variables & Secrets, vérifiez que
DB_PASSWORDaffiche une référence de secret (.../versions/latest), et non une valeur. - Activez
enable_auto_password_rotation = truedans le portail et appliquez ; une fois le flux de rotation exécuté,gcloud secrets versions listaffiche une nouvelle version ENABLED et la précédente DISABLED. - Raisonnez sur le cas négatif : le PAT GitHub et le mot de passe de la base de données n'apparaissent jamais dans l'état Terraform — ils sont écrits directement dans Secret Manager et consommés par référence, de sorte que l'état ne contient que le nom du secret. Une inspection de l'état ne révélerait jamais la valeur du jeton, ce qui est tout l'intérêt de la conception « une référence, pas une valeur ».
- Vous savez que cela a fonctionné lorsque les secrets possèdent plusieurs versions dont seule la plus récente est activée, et que l'exécution résout les secrets uniquement par référence.
Testez-vous
Q1 : Pourquoi écrire le jeton GitHub via un provisioner gcloud secrets versions add est-il préférable à une ressource Terraform gérée de version de secret ?
R : Une ressource gérée de version de secret stocke le contenu du secret dans l'état ; quiconque a un accès en lecture à l'état lit le jeton. Le provisioner envoie la valeur directement à Secret Manager, de sorte que l'état ne contient que le nom du secret. Le compromis (Terraform ne peut pas détecter une dérive de la valeur) est acceptable pour des identifiants écrits une seule fois.
Q2 : Lors de la rotation d'un mot de passe, pourquoi ajouter la nouvelle version du secret avant de désactiver l'ancienne au lieu de la remplacer sur place ?
R : Les instances en cours d'exécution peuvent détenir des connexions authentifiées avec l'ancien mot de passe et relire l'ancienne version tant que la propagation n'est pas terminée. La fenêtre à deux versions permet aux anciens et aux nouveaux identifiants de coexister (l'utilisateur de la base de données est mis à jour, l'ancienne version reste lisible), ce qui permet une rotation sans interruption de service ; l'ancienne version n'est désactivée qu'après le délai de propagation.
Au-delà des modules — Parameter Manager (configuration non secrète versionnée, pouvant référencer des secrets Secret Manager) n'est pas utilisé par les modules. Étudiez aussi la hiérarchie des clés Cloud KMS (trousseau, clé, version) et la différence entre la rotation automatique des clés et la rotation des secrets.
⚠️ Piège d'examen — Définir secret_rotation_period seul ne déclenche aucune rotation : la rotation dans Secret Manager est un calendrier de notifications Pub/Sub. Quelque chose doit consommer la notification et écrire une nouvelle version — ici, c'est le mécanisme enable_auto_password_rotation.
2.4 Sécuriser le pipeline de déploiement (Securing the deployment pipeline)
⏱ ~45 min · 💰 faible (l'analyse des vulnérabilités est facturée par image analysée) · ⚙️ Prérequis : profil ingénieur pipeline +
enable_vulnerability_scanning = truedansServices_GCP
Pourquoi l'examen s'y intéresse — Un pipeline est un chemin privilégié vers la production ; l'examen teste donc les contrôles qui rendent ce qu'il produit digne de confiance : analyser les artefacts à la recherche de vulnérabilités connues, prouver d'où provient un artefact (provenance SLSA, attestations), refuser d'exécuter tout ce qui ne dispose pas de cette preuve (Binary Authorization) et limiter l'IAM de chaque environnement afin qu'une compromission de dev ne puisse pas atteindre prod.
Comment RAD le met en œuvre
- Artifact Analysis et analyse des vulnérabilités :
enable_vulnerability_scanning(par défautfalse) dansServices_GCPactive les API Container Analysis et On-Demand Scanning et configure l'analyse du dépôt Artifact Registry partagé pour qu'elle hérite du paramètre du projet ; chaque image poussée est ainsi analysée à la recherche de CVE connues. - Binary Authorization : traité dans la section 1.3. Le pipeline signe le condensé de l'image avec une clé Cloud KMS détenue par l'attesteur
pipeline-attestor, etbinauthz_evaluation_mode = "REQUIRE_ATTESTATION"fait refuser par la règle toute image dépourvue de cette attestation. DansServices_GCP, la règle ne peut qu'être durcie : un apply ultérieur peut la relever àREQUIRE_ATTESTATIONmais ne l'abaissera pas, car d'autres tenants peuvent en dépendre. - L'analyse ne conditionne pas la signature. L'étape d'attestation signe chaque image produite par le build ; elle ne lit pas d'abord les résultats de l'analyse. Activer les deux fonctionnalités vous donne donc les résultats d'analyse et une provenance imposée, mais pas « seules les images sans vulnérabilité peuvent être déployées ». Cette porte est le modèle à connaître pour l'examen, et vous l'ajouteriez sous forme d'étape de build avant la signature.
- Identité de pipeline au moindre privilège : les builds s'exécutent sous un compte de service Cloud Build dédié qui ne reçoit que les rôles nécessaires, comme
roles/clouddeploy.releaseret les droits de signature sur l'unique clé KMS. L'agent de service Cloud Deploy détient le rôle de déploiement à l'exécution (roles/run.adminouroles/container.developer).
À vous de jouer
- Avec
enable_vulnerability_scanning = true, poussez un commit, puis listez ce que l'analyseur a trouvé pour la nouvelle image :
gcloud artifacts docker images list \
  us-central1-docker.pkg.dev/$GOOGLE_PROJECT_ID/<repo>/<app> \
  --show-occurrences --occurrence-filter='kind="VULNERABILITY"' --limit=1
- Définissez
binauthz_evaluation_mode = "REQUIRE_ATTESTATION", puis essayez de déployer une image non signée hors pipeline (gcloud run deploy <service> --image=us-docker.pkg.dev/cloudrun/container/hello --region=us-central1) et lisez le refus. - Comparez ce que prouve le pipeline avec ce que Cloud Build peut générer nativement :
gcloud artifacts docker images describe <image>@<digest> --show-provenance. - Vous savez que cela a fonctionné lorsque l'analyse liste des occurrences de vulnérabilités pour votre image, que le déploiement non signé est refusé et que vous pouvez expliquer lequel des deux contrôles l'a bloqué.
Testez-vous
Q1 : L'analyse est activée et Binary Authorization impose les attestations, et pourtant une image présentant une CVE critique a atteint la production. Comment ?
R : L'attestation a été créée sans consulter l'analyse. L'application des règles prouve qu'une image est passée par le pipeline, pas qu'elle est sûre. Pour bloquer les images vulnérables connues, le pipeline doit évaluer l'analyse (ou utiliser une règle d'attestation fondée sur les vulnérabilités) avant de signer, de sorte qu'une image non conforme ne reçoive jamais d'attestation.
Q2 : Dev et prod partagent un projet et un compte de service de build. Quel est le risque, et quelle est la structure recommandée ?
R : Quiconque peut modifier le pipeline de dev peut agir avec les autorisations dont les déploiements de prod ont besoin. Placez les environnements dans des projets distincts, donnez à chacun sa propre identité de déploiement dotée de rôles accordés uniquement dans cet environnement, et accordez la promotion vers prod via une approbation Cloud Deploy plutôt que par un IAM direct sur l'environnement d'exécution de prod.
Au-delà des modules — Les niveaux du framework SLSA et ce que satisfait la provenance native de Cloud Build ; la validation continue de Binary Authorization pour GKE ; les règles d'attestation fondées sur les vulnérabilités ; et les conditions IAM par environnement. Le lab exécute toutes les étapes dans un seul projet ; l'IAM limité à un environnement est donc un sujet d'étude plutôt qu'un exercice pratique.
⚠️ Piège d'examen — Une attestation est une déclaration de provenance, pas de sûreté. L'analyse détecte les problèmes ; seule une règle qui refuse d'attester (ou de déployer) au vu de ces résultats les arrête.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.