Apache Superset sur Google Cloud Run
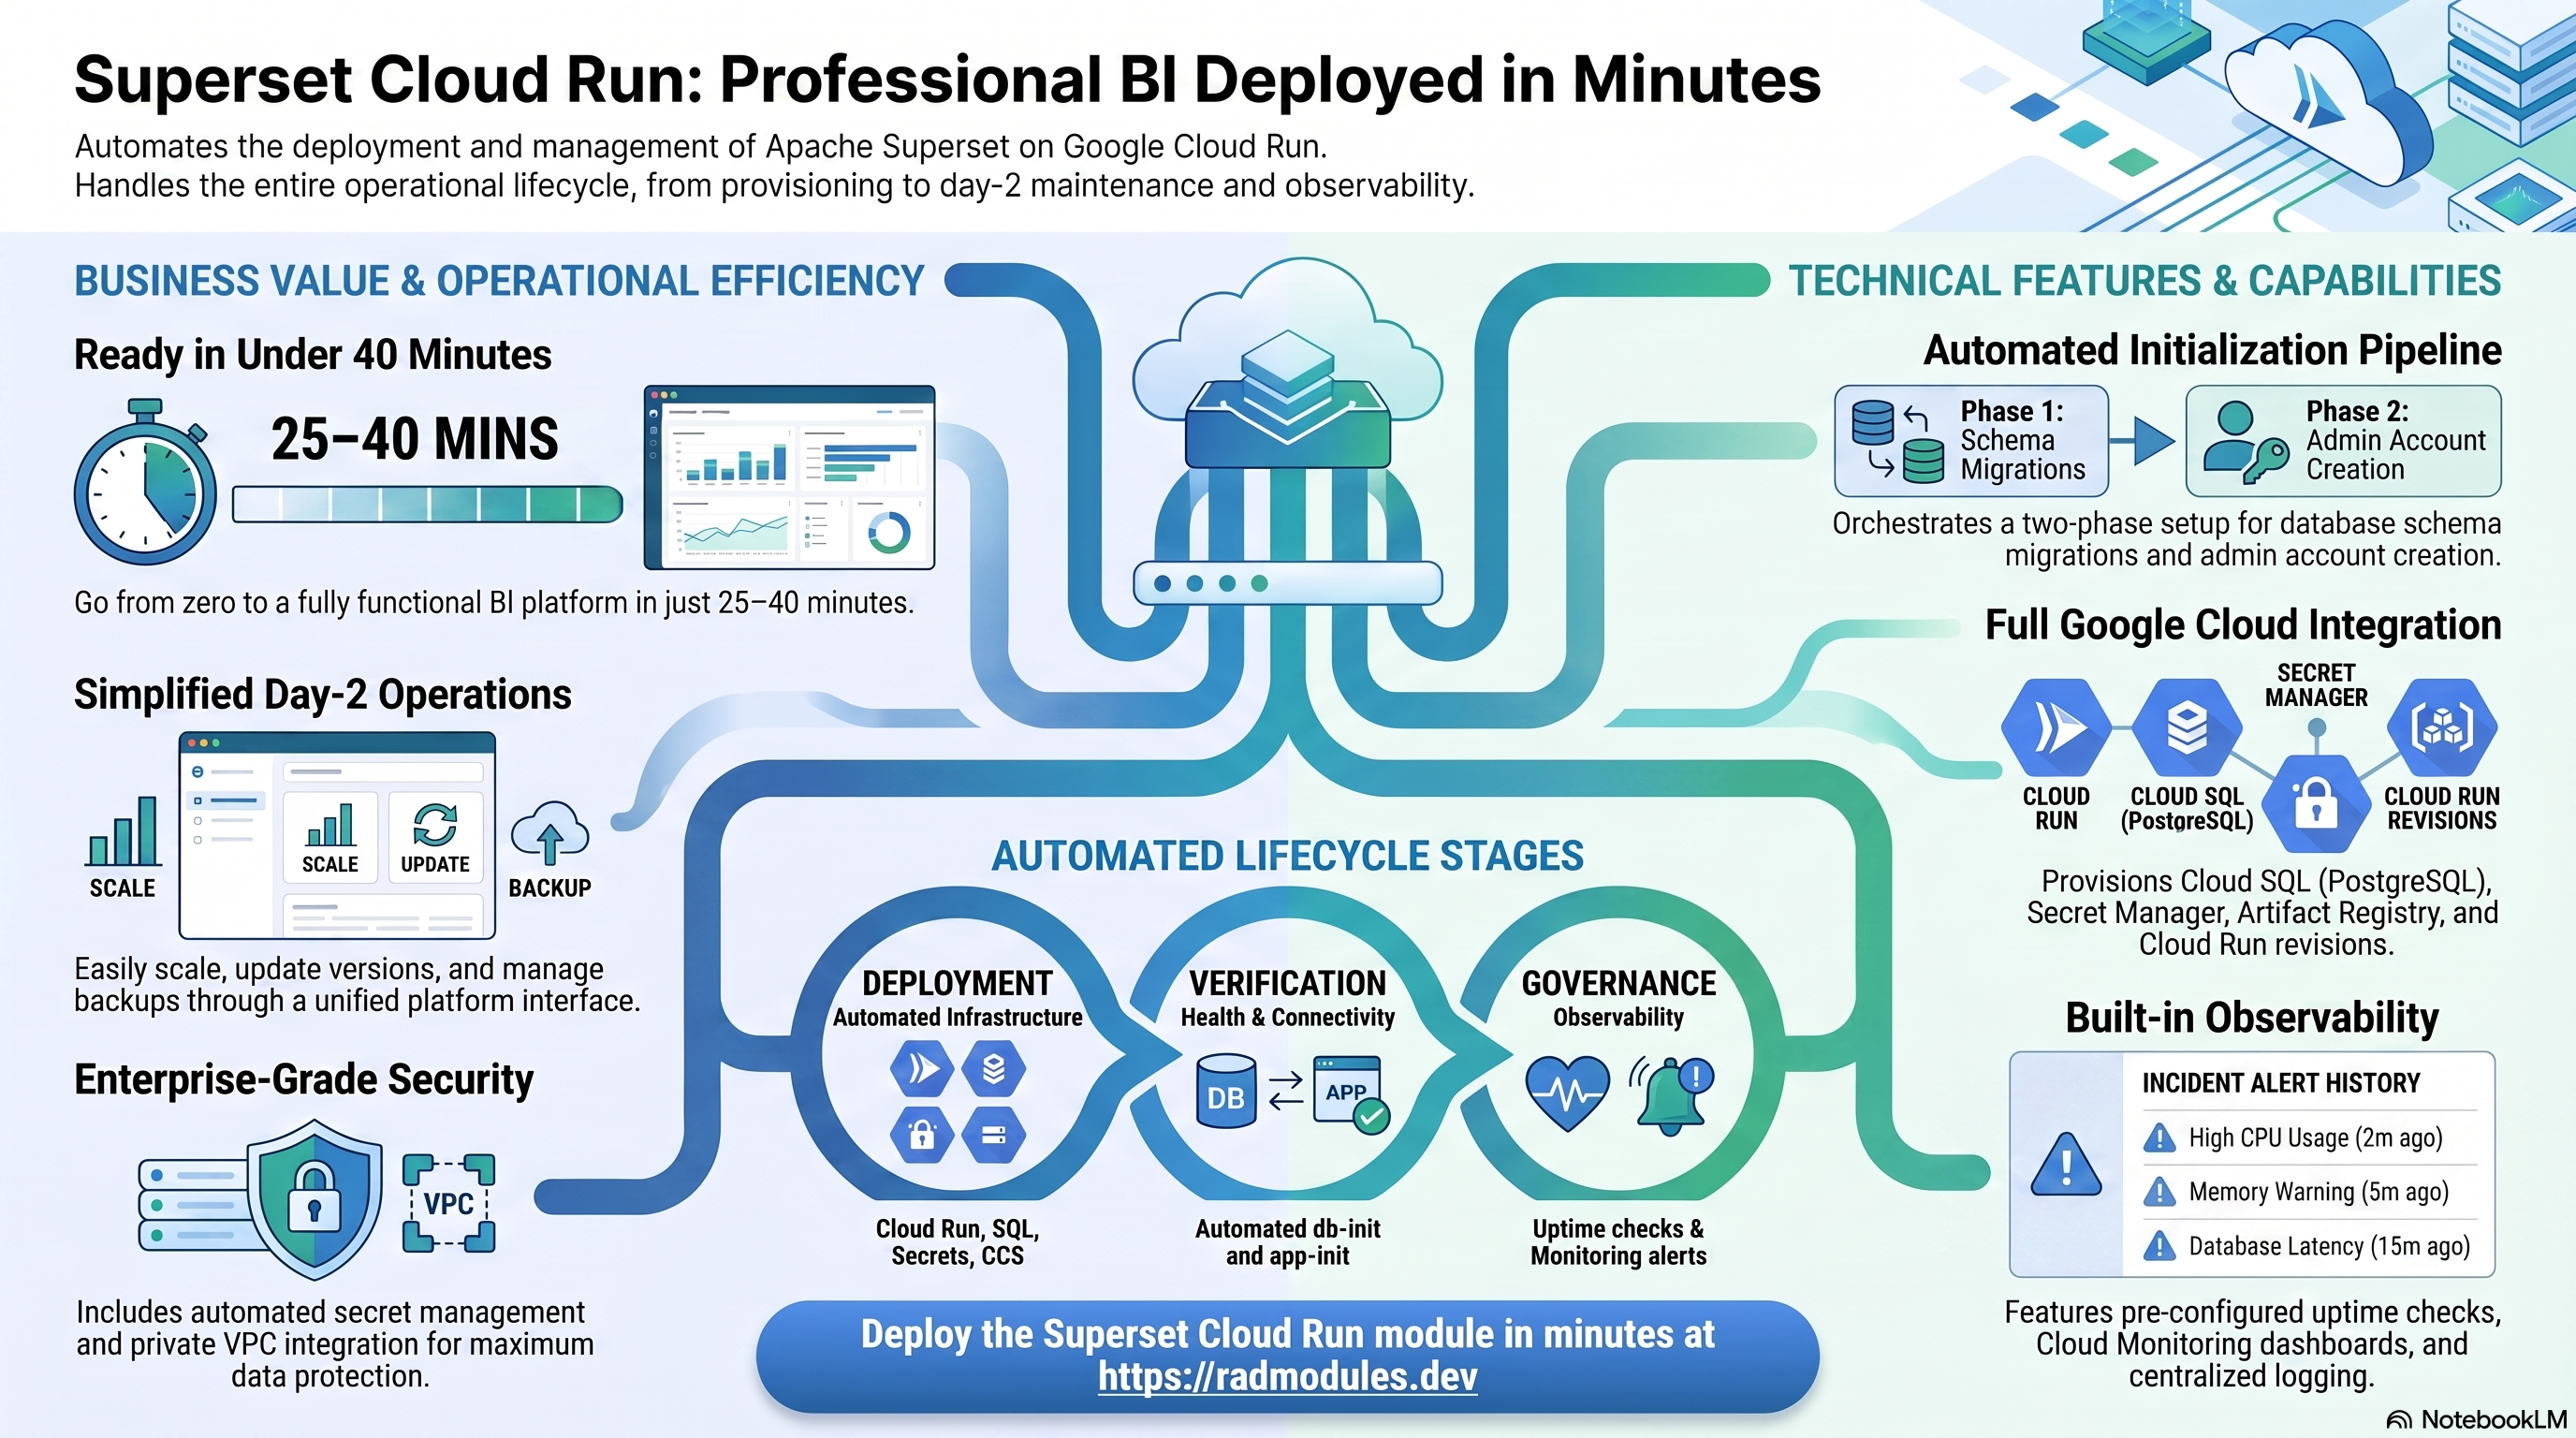
Apache Superset est une plateforme open source d'exploration et de visualisation de données utilisée par des organisations du monde entier. Ce module déploie Superset sur Cloud Run v2 au-dessus du socle App_CloudRun, qui provisionne et gère l'infrastructure Google Cloud partagée.
Ce guide se concentre sur les services cloud qu'utilise Superset et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à toute application Cloud Run — identité du service, entrée et équilibrage de charge, mise à l'échelle et concurrence, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide du socle App_CloudRun plutôt que de les répéter ici.
1. Vue d'ensemble
Superset s'exécute comme un conteneur Python/Gunicorn sur Cloud Run v2. Le déploiement assemble un ensemble ciblé de services Google Cloud :
| Fonctionnalité | Service Google Cloud | Remarques |
|---|---|---|
| Calcul | Cloud Run v2 | Service Python/Gunicorn, 2 vCPU / 2 GiB par défaut, mise à l'échelle automatique selon les requêtes |
| Base de données | Cloud SQL for PostgreSQL 15 | Obligatoire — stocke les tableaux de bord, graphiques, jeux de données et paramètres utilisateur |
| Stockage objet | Cloud Storage | Un bucket de données dédié provisionné automatiquement |
| Cache et requêtes asynchrones | Redis | Désactivé par défaut ; fortement recommandé pour les déploiements de production multi-utilisateurs |
| Secrets | Secret Manager | SUPERSET_SECRET_KEY et mot de passe de la base de données générés automatiquement |
| Entrée | URL Cloud Run / Cloud Load Balancing | URL run.app par défaut, équilibreur de charge HTTPS externe et domaine personnalisé facultatifs |
Valeurs par défaut judicieuses à connaître d'emblée :
- PostgreSQL 15 est obligatoire. Superset l'utilise comme base de métadonnées pour l'ensemble des tableaux de bord, graphiques, jeux de données et définitions de rôles. MySQL n'est pas pris en charge.
SUPERSET_SECRET_KEYest généré automatiquement. Une clé aléatoire de 50 caractères est générée et stockée dans Secret Manager. Elle signe les sessions Flask — la faire tourner invalide toutes les sessions utilisateur actives. Considérez-la comme immuable après le premier déploiement.- L'initialisation en deux phases s'exécute automatiquement. Un job
db-initcrée la base de données PostgreSQL et l'utilisateur ; puis un jobapp-initexécute les migrations de schéma et crée l'utilisateur administrateur. Les deux s'exécutent à chaque déploiement mais sont idempotents. - Redis est désactivé par défaut. Sans Redis, les workers Celery n'ont pas de broker ; l'exécution asynchrone des requêtes et la mise en cache des tableaux de bord sont indisponibles. Activez-le en production.
- La sonde de santé cible
/health— le point de terminaison de disponibilité Gunicorn de Superset. - L'environnement d'exécution
gen2est utilisé. Il est nécessaire pour une compatibilité Linux complète et, lorsque NFS est activé, pour les montages de volumes NFS.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que PROJECT et REGION sont définis. Les noms des
services et des ressources figurent dans les sorties du déploiement.
A. Cloud Run — le service Superset
Superset s'exécute comme un service Cloud Run v2 qui se met à l'échelle automatiquement selon la charge de requêtes, entre les nombres minimal et maximal d'instances. Chaque déploiement crée une révision immuable ; le trafic peut être réparti entre les révisions pour des déploiements progressifs sûrs.
- Console : Cloud Run → sélectionnez le service pour voir les révisions, le trafic, les journaux et les métriques.
- CLI :
gcloud run services list --project "$PROJECT" --region "$REGION"
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION"
gcloud run revisions list --service <service-name> --project "$PROJECT" --region "$REGION"
Consultez App_CloudRun pour la mise à l'échelle, la concurrence, l'environnement d'exécution et la répartition du trafic.
B. Cloud SQL for PostgreSQL 15
Superset stocke toutes ses métadonnées dans une instance gérée Cloud SQL for
PostgreSQL 15. Le service s'y connecte de façon privée via le Cloud SQL Auth Proxy
par un socket Unix (pas d'IP publique). Au premier déploiement, le job db-init crée
la base de données et l'utilisateur de l'application, et le job app-init applique
les migrations de schéma.
- Console : SQL → sélectionnez l'instance pour voir les connexions, les sauvegardes, les flags et les métriques.
- CLI :
gcloud sql instances list --project "$PROJECT"
gcloud sql instances describe <instance-name> --project "$PROJECT"
gcloud sql connect <instance-name> --user=<db-user> --project "$PROJECT"
Le nom de l'instance, la base de données, l'utilisateur et le secret du mot de passe figurent dans les sorties. Consultez App_CloudRun pour le modèle de connexion, les sauvegardes et la rotation du mot de passe.
C. Cloud Storage
Un bucket Cloud Storage dédié est provisionné automatiquement pour les exports de données, les sorties de graphiques et les fichiers de rapports de Superset. L'accès est accordé automatiquement au compte de service.
- Console : Cloud Storage → Buckets.
- CLI :
gcloud storage buckets list --project "$PROJECT"
gcloud storage ls gs://<data-bucket>/          # bucket name is in the Outputs
Consultez App_CloudRun pour les montages GCS Fuse et CMEK.
D. Cache Redis et moteur de requêtes asynchrones
Redis sert de backend de cache et de broker Celery à Superset. Lorsqu'il est activé, il assure l'exécution SQL asynchrone, le préchauffage du cache des tableaux de bord et les rapports planifiés. Sans Redis, toutes les requêtes s'exécutent de façon synchrone et bloquent les workers Gunicorn.
- Console : Memorystore → Redis (si vous utilisez une instance gérée).
- CLI :
redis-cli -h <redis-host> ping
redis-cli -h <redis-host> info keyspace
E. Secret Manager
SUPERSET_SECRET_KEY et le mot de passe de la base de données sont stockés dans
Secret Manager et injectés dans le service à l'exécution.
- Console : Security → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT"
gcloud secrets versions access latest --secret=<secret-name> --project "$PROJECT"
Consultez App_CloudRun pour les détails d'injection et de rotation.
F. Réseau et entrée
Le service est accessible par défaut à son URL run.app. Un équilibreur de charge
HTTPS externe avec un domaine personnalisé, Cloud CDN et Cloud Armor peut être ajouté
par-dessus ; les paramètres d'entrée et la sortie VPC contrôlent la connectivité.
- Console : Cloud Run (URL du service) ; Network services → Load balancing.
- CLI :
gcloud run services describe <service-name> --region "$REGION" --format='value(status.url)'
gcloud compute addresses list --project "$PROJECT"
Consultez App_CloudRun.
G. Cloud Logging et Monitoring
Les journaux des conteneurs sont envoyés à Cloud Logging ; les métriques de Cloud Run
et de Cloud SQL sont envoyées à Cloud Monitoring. Un test de disponibilité sur
/health est disponible mais désactivé par défaut
(uptime_check_config.enabled = false). Des règles d'alerte facultatives sont
disponibles.
- Console : Logging → Logs Explorer ; Monitoring → Dashboards / Alerting.
- CLI :
gcloud run services logs read <service-name> --project "$PROJECT" --region "$REGION" --limit 50
3. Comportement de l'application Superset
- Configuration de la base de données au premier déploiement. Le job
db-initcrée la base de données Superset et l'utilisateur de façon idempotente avant le démarrage du service. Il s'exécute avecpostgres:15-alpineet arrête le sidecar Cloud SQL Auth Proxy viaquitquitquità la fin. - Migrations de schéma à chaque déploiement. Le job
app-initexécutesuperset db upgradeà chaque déploiement, appliquant les modifications de schéma en attente. Il exécute ensuitesuperset fab create-adminpour créer ou mettre à jour l'utilisateur administrateur, etsuperset initpour charger les rôles et permissions par défaut. Le jobapp-initdépend de la réussite dedb-init. - Séquence de démarrage. Le job
app-initdispose d'un délai d'expiration de 30 minutes pour absorber les migrations lentes de la première exécution. La sonde de démarrage HTTP (délai initial de 60 s, seuil de 12 échecs) laisse jusqu'à 180 secondes au pool de workers Gunicorn pour démarrer. - Clé secrète Flask.
SUPERSET_SECRET_KEYsigne les sessions Flask et chiffre les identifiants de connexion aux bases de données stockés dans les métadonnées de Superset. La modifier après le premier déploiement invalide toutes les sessions et rend illisibles les identifiants stockés. La clé est générée automatiquement sous forme de chaîne aléatoire de 50 caractères dans Secret Manager. - Requêtes asynchrones et rapports planifiés. Les workers Celery de Superset
utilisent Redis comme broker et backend de résultats. Sans Redis, les requêtes
asynchrones et les rapports planifiés sont indisponibles. Configurez
enable_redis = trueet renseignezredis_hosten production. - Chemin de santé. Les sondes de disponibilité (readiness) et de vivacité ciblent
/health, qui renvoie HTTP 200 lorsque le pool de workers Gunicorn est prêt. - Inspecter les jobs en cours d'exécution :
gcloud run jobs list --project "$PROJECT" --region "$REGION"
gcloud run jobs executions list --job <job-name> --project "$PROJECT" --region "$REGION"
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres propres à Superset ou notables pour lui sont listés ; toutes les autres entrées sont héritées d'App_CloudRun avec leur comportement standard.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Projet Google Cloud cible. |
region | us-central1 | Région du service et des ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques par environnement. |
support_users | [] | Adresses e-mail auxquelles sont accordés l'accès au projet et les alertes de surveillance. |
resource_labels | {} | Libellés appliqués à toutes les ressources. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | superset | Nom de base des ressources. Ne pas modifier après le premier déploiement. |
application_display_name | Apache Superset | Nom convivial affiché dans la console. |
application_description | Apache Superset - Data Exploration and Visualisation Platform | Description du service. |
application_version | latest | Tag de version de l'image Superset ; fixez une version précise en production. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Mettez false pour ne provisionner que l'infrastructure. |
container_resources | { cpu_limit = "2000m", memory_limit = "2Gi" } | CPU et mémoire par instance ; 2 vCPU / 2 GiB minimum pour Superset. |
container_port | 8088 | Superset/Gunicorn écoute sur le port 8088. |
container_image_source | custom | custom construit le Dockerfile fourni (nécessaire pour psycopg2) ; prebuilt utilise une image existante. |
execution_environment | gen2 | Génération Cloud Run ; gen2 est nécessaire pour les montages NFS et un réseau amélioré. |
min_instance_count | 1 | Nombre minimal d'instances ; gardez ≥ 1 pour éviter les délais de démarrage à froid (~30–60 s pour Superset). |
max_instance_count | 5 | Nombre maximal d'instances (plafond de coût). |
timeout_seconds | 600 | Délai d'expiration des requêtes ; étendu pour les requêtes SQL de longue durée. |
enable_cloudsql_volume | true | Cloud SQL Auth Proxy pour les connexions par socket. |
traffic_split | [] | Répartition du trafic canary/blue-green entre les révisions. |
Groupe 5 — Contrôle d'accès et d'entrée
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_iap | false | Exige une connexion Google via Identity-Aware Proxy. |
iap_authorized_users / iap_authorized_groups | [] | Qui peut accéder via IAP. |
ingress_settings | all | Les réseaux autorisés à atteindre le service (all / internal / LB uniquement). |
vpc_egress_setting | PRIVATE_RANGES_ONLY | Mode de routage du trafic sortant via le connecteur VPC. |
Groupe 6 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Paramètres non secrets supplémentaires. SUPERSET_SECRET_KEY est injecté automatiquement. |
secret_environment_variables | {} | Correspondance variable d'environnement → nom de secret Secret Manager. |
secret_propagation_delay / secret_rotation_period | (défini) | Délai d'attente de réplication / cadence de rotation. |
Groupe 7 — Sauvegarde et restauration
| Variable | Valeur par défaut | Description |
|---|---|---|
backup_schedule | 0 2 * * * | Cron de sauvegarde automatique (UTC). |
backup_retention_days | 7 | Rétention ; à augmenter pour la production ou la conformité. |
enable_backup_import / backup_source / backup_uri / backup_format | options de restauration | Restaure à partir d'une sauvegarde lors du déploiement. |
Groupe 8 — CI/CD et Binary Authorization
Intégration Cloud Build / Cloud Deploy standard d'App_CloudRun — consultez
App_CloudRun. Entrées clés : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy,
enable_binary_authorization.
Groupe 9 — SQL personnalisé et NFS
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_custom_sql_scripts / custom_sql_scripts_bucket / custom_sql_scripts_path / custom_sql_scripts_use_root | désactivé | Exécute du SQL depuis un bucket GCS après le provisionnement. Consultez App_CloudRun. |
nfs_instance_name / nfs_instance_base_name | (défini) | Instance NFS existante / nom de base d'une instance intégrée. Superset ne nécessite pas NFS. |
Groupe 10 — Domaine, CDN, Cloud Armor et rétention des images
| Variable | Valeur par défaut | Description |
|---|---|---|
application_domains | [] | Noms d'hôte personnalisés pour l'équilibreur de charge externe. |
enable_cdn | false | Active Cloud CDN sur le backend de l'équilibreur de charge. |
enable_cloud_armor / admin_ip_ranges | désactivé | Associe une règle WAF / restreint l'accès privilégié. |
max_images_to_retain / delete_untagged_images / image_retention_days | (défini) | Règle de nettoyage d'Artifact Registry. |
Groupe 11 — Stockage et système de fichiers
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Provisionne le bucket de données. |
storage_buckets / gcs_volumes | (défini) | Buckets supplémentaires / montages GCS Fuse. |
enable_nfs | false | Volume Filestore partagé. Superset ne nécessite pas NFS. |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options CMEK. |
Groupe 12 — Backend de base de données
| Variable | Valeur par défaut | Description |
|---|---|---|
database_type | POSTGRES_15 | Fixe — ne pas modifier. Superset nécessite PostgreSQL. |
application_database_name | superset_db | Nom de la base de données. Immuable après le premier déploiement. |
application_database_user | superset_user | Utilisateur de l'application. Immuable après le premier déploiement. |
database_password_length | 32 | Longueur du mot de passe généré (16–64). |
enable_auto_password_rotation / rotation_propagation_delay_sec | désactivé | Rotation du mot de passe de la base de données. |
db_host_env_var_name / db_name_env_var_name / db_user_env_var_name / db_port_env_var_name / service_url_env_var_name | (défini) | Noms sous lesquels les détails de connexion sont injectés. |
Groupe 13 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Laissez vide pour utiliser le pipeline intégré en deux phases db-init + app-init. |
cron_jobs | [] | Jobs récurrents déclenchés par Cloud Scheduler — utiles pour le préchauffage du cache ou la génération de rapports. |
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe / startup_probe_config | HTTP /health, délai de 60 s, 12 échecs | Laisse jusqu'à 180 s au pool de workers Gunicorn pour s'initialiser. |
liveness_probe / health_check_config | HTTP /health, délai de 30 s | Sonde de vivacité. |
uptime_check_config | désactivé, /health | Test de disponibilité Cloud Monitoring. |
alert_policies | [] | Règles d'alerte sur métriques. |
Groupe 21 — Cache Redis
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_redis | false | Active Redis pour Celery et la mise en cache. Fortement recommandé en production. |
redis_host | "" | Nom d'hôte ou IP de Redis. Obligatoire lorsque enable_redis = true. |
redis_port | 6379 | Port Redis (un nombre dans la variante Cloud Run). |
redis_auth | "" | Mot de passe d'authentification Redis facultatif (sensible). |
Groupe 22 — VPC Service Controls et journalisation d'audit
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vpc_sc | false | Applique un périmètre VPC-SC (nécessite organization_id). |
vpc_cidr_ranges / vpc_sc_dry_run | (défini) | CIDR du niveau d'accès / mode simulation (dry-run). |
enable_audit_logging | false | Cloud Audit Logs détaillés. |
5. Sorties
Renvoyés lors d'un déploiement réussi — le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du service Cloud Run. |
service_url | URL run.app par défaut du service. |
service_location | Région dans laquelle le service s'exécute. |
stage_services | URL des services par étape (Cloud Deploy). |
load_balancer_ip / load_balancer_url | IP / URL de l'équilibreur de charge HTTPS externe (lorsqu'il est activé). |
database_instance_name | Nom de l'instance Cloud SQL. |
database_name / database_user | Nom / utilisateur de la base de données de l'application. |
database_password_secret | Secret Secret Manager contenant le mot de passe de la base. |
database_host / database_port | Point de terminaison / port de la base. |
storage_buckets | Buckets Cloud Storage créés. |
network_name / network_exists / regions | Réseau VPC, présence, régions. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels / uptime_check_names | État de la surveillance, canaux, tests de disponibilité. |
initialization_jobs | Noms des jobs de configuration. |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / github_repository_url / github_repository_owner / github_repository_name / cicd_configuration | État et détails du CI/CD. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Registre et déclencheur de build. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État de VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | État de la journalisation d'audit et de CMEK. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
SUPERSET_SECRET_KEY (généré automatiquement) | immuable après le premier déploiement | Critique | Modifier la clé invalide toutes les sessions actives et rend définitivement illisibles les identifiants de connexion aux bases de données stockés. |
database_type | POSTGRES_15 | Critique | Superset nécessite PostgreSQL ; le modifier empêche le démarrage. |
enable_cloudsql_volume | true | Critique | Le désactiver supprime le sidecar Auth Proxy ; toutes les connexions PostgreSQL échouent. |
application_database_name / _user | à définir une seule fois | Critique | Immuables après le premier déploiement ; les renommer recrée la base/l'utilisateur et détruit tous les tableaux de bord et métadonnées. |
enable_backup_import | false sauf en cas de restauration | Critique | L'activer sans backup_uri valide fait échouer le job d'import. |
enable_redis | true en production | Élevé | Sans Redis, les workers Celery n'ont pas de broker ; les requêtes asynchrones et les rapports planifiés sont indisponibles. |
redis_host | à définir explicitement | Élevé | Obligatoire lorsque enable_redis = true ; une valeur vide fait échouer les workers Celery au démarrage. |
container_resources.memory_limit | 2Gi minimum | Élevé | En dessous de 1 GiB, les workers Gunicorn sont arrêtés pour manque de mémoire (OOM) pendant l'exécution des requêtes. |
container_resources.cpu_limit | 2000m | Élevé | En dessous de 1000m, le job de migration app-init peut dépasser sa fenêtre de 30 minutes. |
min_instance_count | 1 | Élevé | 0 ajoute une latence de démarrage à froid et risque de manquer du travail asynchrone ; Superset met 30–60 s à démarrer. |
startup_probe.failure_threshold | 12 ou plus | Élevé | Le réduire trop fortement amène Cloud Run à arrêter le conteneur avant que Superset ait terminé les migrations de la base de données. |
application_version | fixer une version précise | Moyen | latest déclenche des mises à niveau non maîtrisées susceptibles d'introduire des changements d'API incompatibles. |
enable_iap / enable_cloud_armor | à activer en production | Moyen | Sans eux, le formulaire de connexion de Superset est accessible publiquement. |
timeout_seconds | 600 | Moyen | Le réduire en dessous de 120 s interrompt en cours d'exécution les requêtes analytiques de longue durée. |
backup_retention_days | 7 (à augmenter en production) | Moyen | Trop court pour une rétention de conformité. |
Pour le comportement du socle évoqué tout au long de cette page — identité du service, mise à l'échelle et concurrence, entrée et équilibrage de charge, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir des images — consultez App_CloudRun. La configuration applicative propre à Superset, partagée avec la variante GKE, est décrite dans Superset_Common.
Guides associés
- Lab pratique : Superset sur Cloud Run — déployez-le étape par étape, avec les écrans de la console et les commandes à chaque étape.
- Apache Superset sur GKE Autopilot — la même application sur Kubernetes, lorsque vous avez besoin de l'autre cible de déploiement.
- Superset Common — Configuration applicative partagée — la configuration partagée par les deux cibles de déploiement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.