Bank of Anthos multi-cluster sur GKE
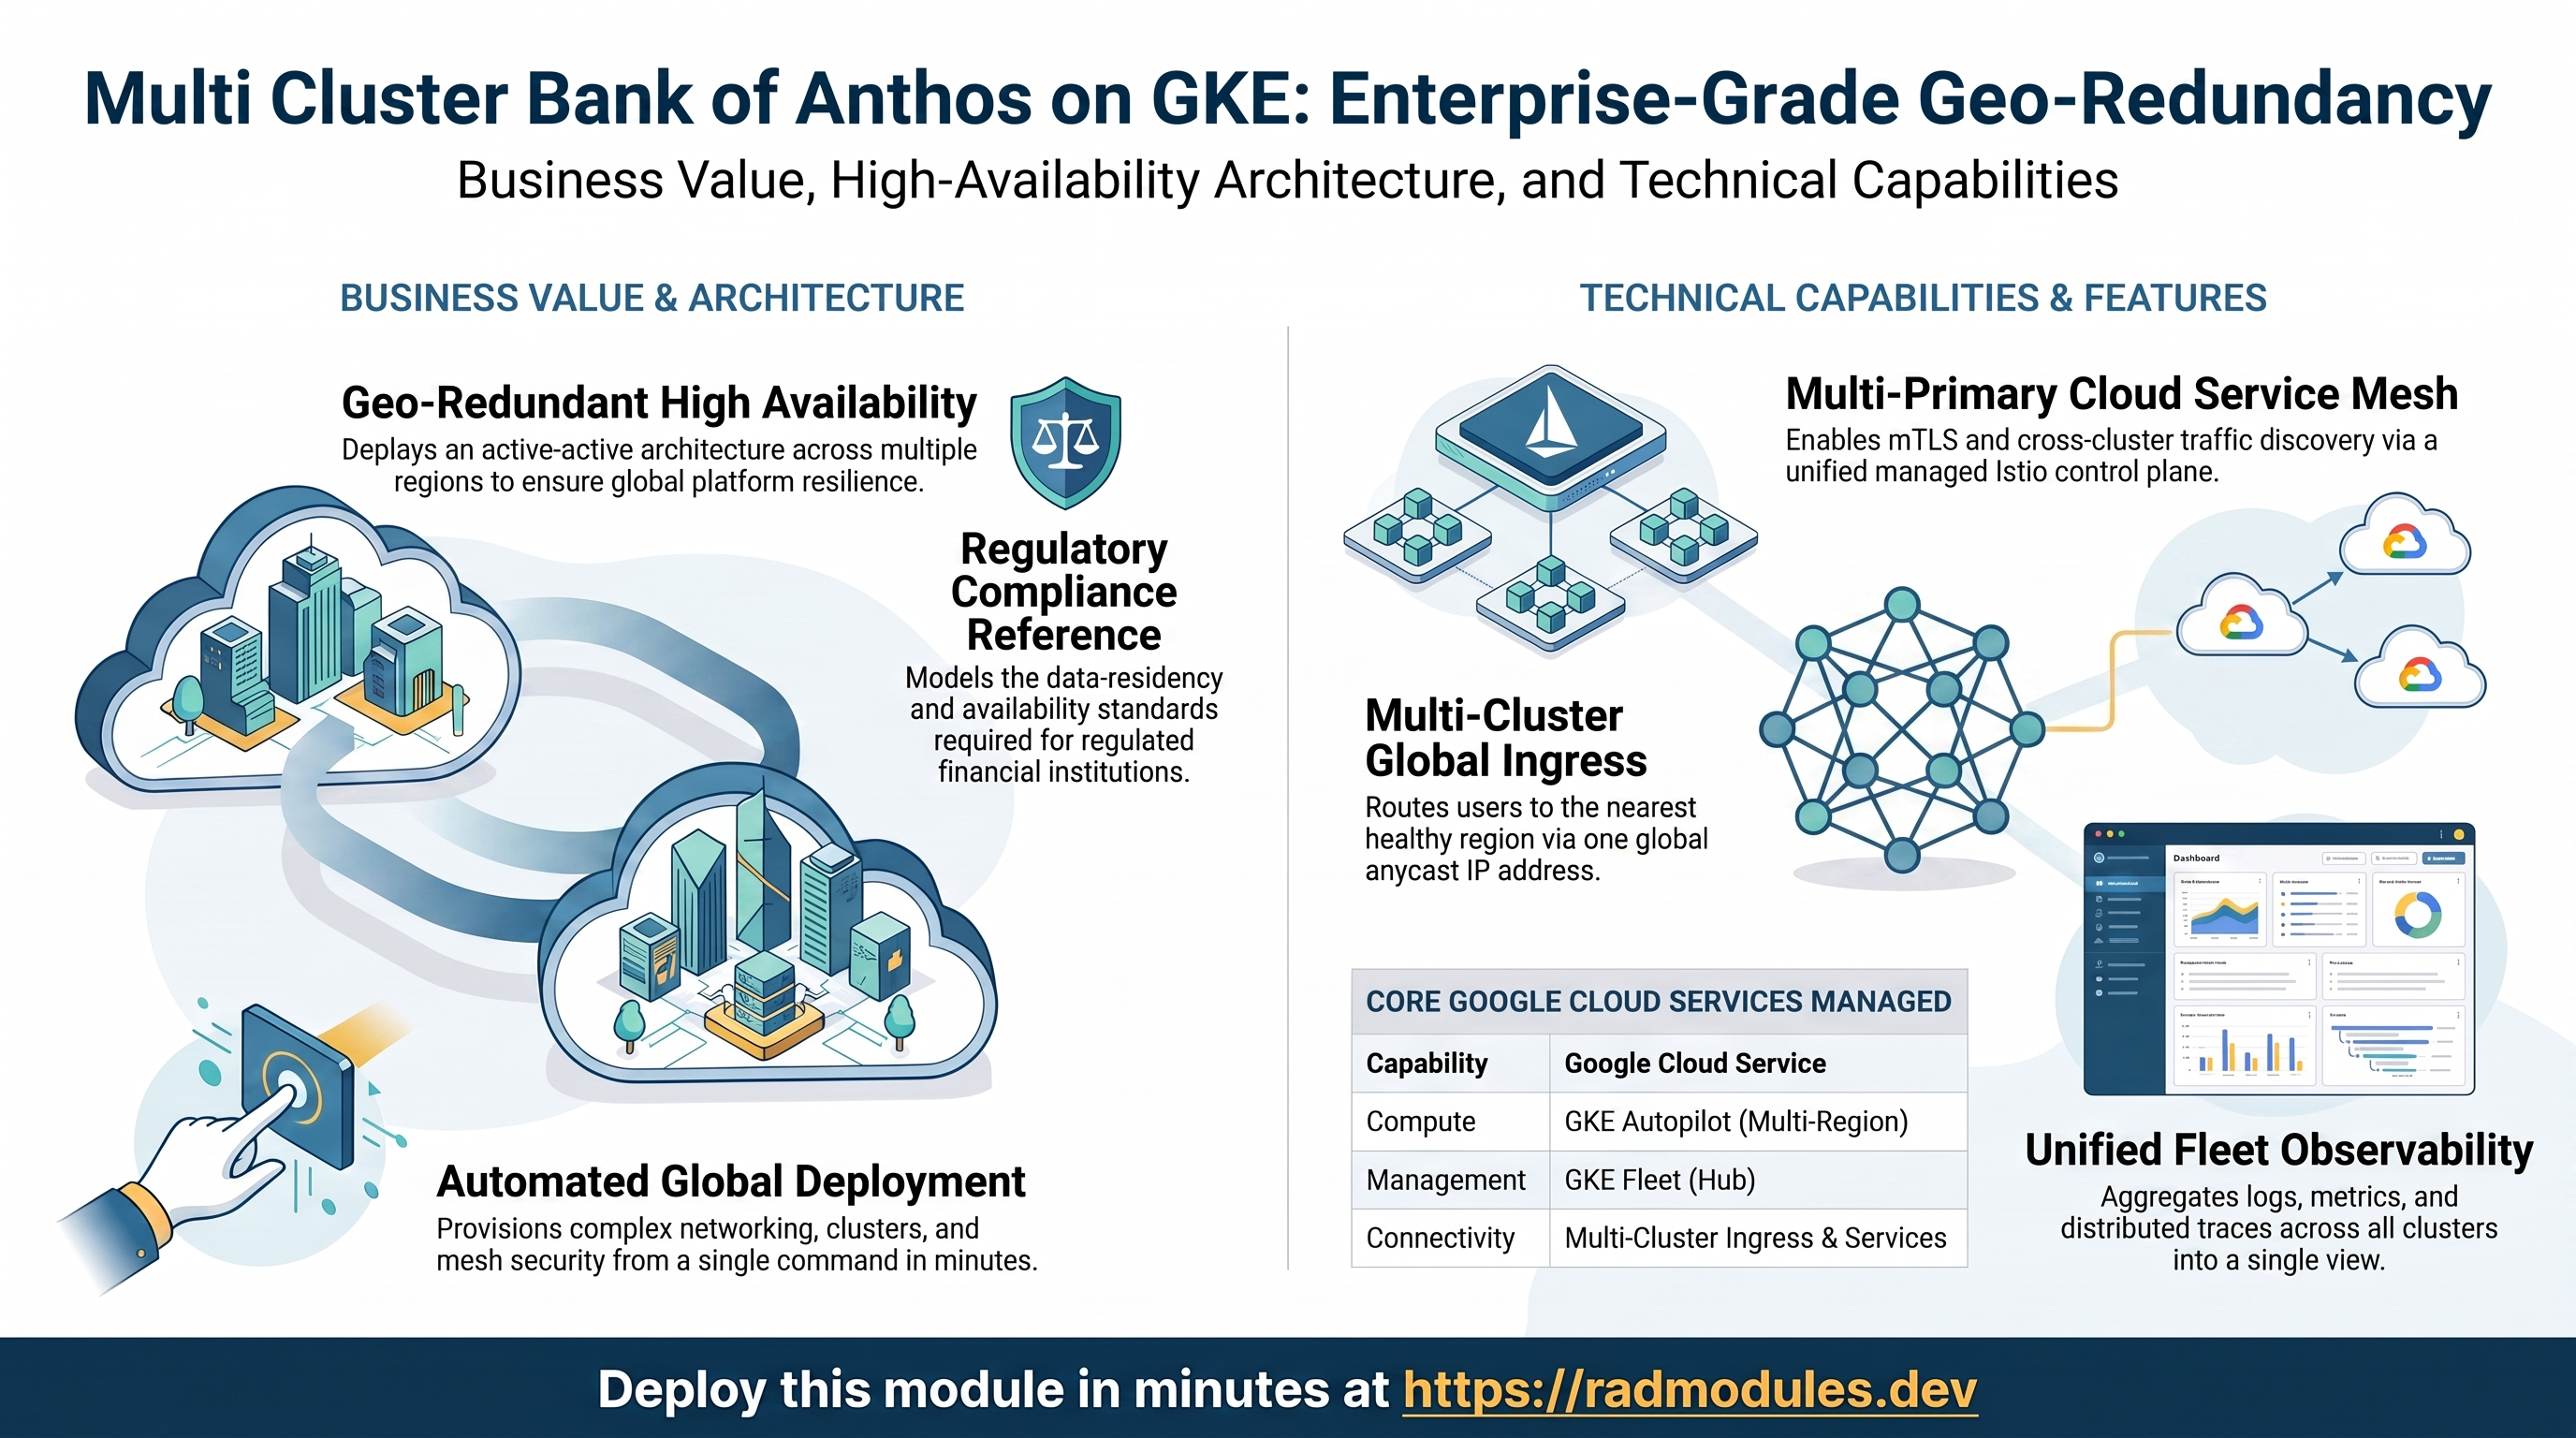
Ce module déploie Bank of Anthos — la démo bancaire de microservices open source de Google — sur plusieurs clusters GKE dans plusieurs régions, connectés ensemble comme une seule plateforme d'application. C'est un module autonome et indépendant : il construit son propre VPC, crée chaque cluster GKE, les enregistre tous dans une Flotte GKE, les joint en un seul Cloud Service Mesh multi-primaire, et les met en façade avec une passerelle multi-cluster / équilibreur de charge externe global afin qu'une seule adresse publique serve la région saine la plus proche.
Il est destiné à servir de référence éducative pour l'architecture active-active et géo-redondante que les plateformes financières réglementées et de paiement mondiales utilisent pour répondre aux exigences de haute disponibilité et de résidence des données. Ce n'est pas un système bancaire de production.
Ce guide se concentre sur les services Google Cloud que le module utilise et sur la manière de les explorer et de les opérer depuis la console Cloud et la ligne de commande — avec une attention particulière au travail sur plusieurs clusters à la fois.
Ce que coûte Bank of Anthos sur RAD, et comment cela se compare
Bank of Anthos multi-cluster sur le module GKE de RAD coûte environ 24 US$ par mois dans votre propre projet, et RAD ne facture aucun frais de module pour cela. Les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement), donc une restauration ne coûte normalement aucun crédit. Si vous n'en avez besoin qu'occasionnellement, un projet géré par RAD peut être supprimé et restauré dans les 30 jours sans frais supplémentaires, de sorte que ce chiffre mensuel devient quelques dollars au lieu de cela — voir Mettez-le en pause gratuitement, ci-dessous.
Ce que vous payez sur RAD
| Dans un projet Google Cloud que vous possédez | Dans un projet que RAD gère pour vous | |
|---|---|---|
| Frais de module, une fois par déploiement | Gratuit (0 crédit) | Gratuit (0 crédit) |
| Builds | Inclus dans le prix : pas de frais de build pour la création, 5 mises à jour par mois (mois calendaire UTC) gratuites puis 2 crédits chacune, et rien pour la suppression ou pour un build échoué, dans la limite de 10 builds échoués par jour (UTC). Les sessions de lab et les projets clients sont l'exception : ils sont toujours facturés pour le temps de build à la minute | Idem |
| Coût d'exécution Google Cloud | Facturé par Google à votre propre compte de facturation, environ 24 US$ par mois pour la configuration par défaut (tableau ci-dessous) | Mesuré à l'heure en crédits ; RAD publie 51 crédits par jour, soit environ 1 530 par mois (environ 153 US$ au prix de la recharge ; estimé à partir des prix catalogue Google, et incluant les frais de cluster) |
| Qui possède quoi | Vous possédez le projet et sa facturation ; RAD le déploie et le met à jour | RAD possède le projet, avec des garde-fous, des quotas et des alertes budgétaires ; vous avez accès à la console, et un solde minimum acheté est maintenu en réserve |
Pourquoi les deux colonnes diffèrent. Le chiffre géré par RAD inclut les frais de gestion du cluster GKE (environ 73 US$ par mois) et la fondation partagée du projet. Dans votre propre projet, le niveau gratuit de Google couvre les frais de gestion d'un cluster par compte de facturation, ce que le chiffre du projet propre suppose. Il est estimé à partir des prix catalogue de Google, car il n'y a pas encore assez d'historique GKE géré par RAD pour le mesurer, donc la confirmation de déploiement ne le cite pas.
10 crédits coûtent 1 US$ pour une recharge unique, et moins sur un plan mensuel. Dans un projet géré par RAD, la base de données, le serveur de fichiers et le réseau sont partagés par chaque application du projet, de sorte qu'une deuxième application n'ajoute pas une deuxième base de données.
Coût d'exécution par défaut dans votre propre projet (us-central1, prix catalogue Google) :
| Ressource (par défaut du module) | Par mois |
|---|---|
| Pod GKE Autopilot, 0,5x vCPU / 0,5 Gio | 18 US$ |
| Cloud NAT et réseau | 5 US$ |
| Cloud Storage (modules complémentaires, sauvegardes) | 1 US$ |
| Frais de gestion du cluster GKE | partagés entre toutes les applications GKE du projet ; 0 US$ si c'est votre seul cluster, sinon ~73 US$ |
| Total | environ 24 US$ |
Comment cela se compare
- Bank of Anthos est l'architecture de référence open source de Google pour une plateforme bancaire active-active et géo-redondante — ce n'est pas un produit commercial, et il n'y a pas d'équivalent SaaS à comparer.
- La comparaison honnête est la complexité opérationnelle, pas une facture mensuelle : reproduire ce que ce module automatise — plusieurs clusters GKE dans différentes régions, une Flotte, un maillage de services multi-primaire et une passerelle multi-cluster — à la main nécessite une véritable expertise en Kubernetes multi-cluster et en réseau inter-régions. Un seul VPS (même bien spécifié) ne peut pas remplacer cette architecture, ce qui est l'intérêt de l'exécuter ici plutôt que sur une seule machine.
- Le coût de RAD est d'environ 24 US$ par mois dans votre propre projet sans aucun frais de module — ce module existe pour enseigner le modèle, pas pour vendre un déploiement, donc RAD ne le facture pas au-delà du coût d'infrastructure de Google.
Mettez-le en pause gratuitement : supprimez un projet géré par RAD, restaurez-le quand vous en avez besoin
Si Bank of Anthos s'exécute dans un projet que RAD gère pour vous, vous avez une deuxième option qui va bien au-delà de la mise à l'échelle à zéro : supprimez l'ensemble du projet et restaurez-le dans les 30 jours pour presque rien. Cela convient bien mieux à Bank of Anthos dont vous n'avez besoin qu'occasionnellement — pour l'évaluer, un environnement de démonstration, une charge de travail saisonnière ou intermittente — que de le faire fonctionner en continu.
Une restauration n'est pas garantie — conservez vos propres sauvegardes. Les conditions de Google Cloud ne garantissent pas qu'un projet restauré, ou les ressources qu'il contient, seront utilisables après sa restauration, de sorte que la restauration ne peut pas être considérée comme un moyen de récupérer un projet supprimé. Avant de supprimer, assurez-vous d'avoir effectué des sauvegardes appropriées des données et de la configuration de l'application et de les avoir stockées en dehors du projet. Si une restauration échoue, ou si le projet restauré ne fonctionne pas, la solution de repli consiste à redéployer l'application (voir la section suivante) et à restaurer sa configuration et ses données à partir de ces sauvegardes.
- Comment ça marche. La suppression d'un projet géré par RAD délie d'abord sa facturation, puis demande à Google de supprimer le projet. Google ne supprime pas le projet immédiatement : il le conserve, récupérable, pendant 30 jours. Comme la facturation est déjà déliée, rien n'est facturé pendant qu'il attend. Contrairement à la suppression d'un module, cela ne détruit pas la base de données, aucune VM ou la ressource de calcul une par une — l'ensemble du projet, et tout ce qu'il contient, s'arrête simplement.
- La restauration est une vérification, pas une reconstruction. Dans les 30 jours, le propriétaire du projet peut le restaurer. RAD demande à Google de récupérer le projet et de rattacher son compte de facturation, puis vous demande d'exécuter Mettre à jour sur chaque déploiement pour confirmer que tout est revenu. Comme rien n'a été détruit individuellement, cette mise à jour trouve les mêmes ressources déjà présentes — c'est une vérification, pas une reconstruction, et une mise à jour ne facture jamais les frais de module à nouveau. Pour Bank of Anthos, cela ne coûte rien : il n'y a pas de frais de module, et les mises à jour sont incluses dans le prix (5 par mois pour chaque déploiement).
- Ainsi, un mois d'utilisation occasionnelle peut coûter quelques dollars, et non les 153 US$ par mois pour le maintenir en fonctionnement. Déployez Bank of Anthos, utilisez-le pendant un certain temps, supprimez le projet. Restaurez-le la prochaine fois que vous en avez besoin, confirmez avec Mettre à jour, et supprimez-le à nouveau lorsque vous avez terminé. Vous ne payez les frais de module qu'une seule fois et pour le temps où il était réellement en ligne.
- Ce que cela nécessite. Vous devez être propriétaire du projet (pas un projet dont RAD gère uniquement la facturation), et vous le restaurez vous-même dans les 30 jours — après cela, Google le supprime définitivement. La restauration est admise comme la création d'un nouveau projet : votre solde de crédits achetés doit toujours dépasser le seuil du niveau (100 crédits pour le niveau sandbox que la plupart des évaluations utilisent). Google indique que la plupart des services fonctionnent à nouveau pleinement dans les 36 heures suivant une restauration.
- Un véritable manque : les sauvegardes nocturnes ne survivent pas. Les sauvegardes et autres fichiers générés sont écrits dans un bucket à l'intérieur du projet, et ce bucket n'est pas protégé par la suppression logicielle de Cloud Storage, il est donc très probable qu'il disparaisse dès que vous supprimez le projet — même si le projet lui-même est récupérable pendant 30 jours. Si vous avez personnalisé Bank of Anthos et que vous souhaitez conserver ce travail, copiez une sauvegarde (vers Google Drive ou un bucket en dehors du projet) avant de supprimer. Pour une installation par défaut sans rien d'irremplaçable, cela n'a pas d'importance.
Payez uniquement pendant que vous l'utilisez, l'autre façon : supprimer et redéployer
L'option ci-dessus ne s'applique qu'à un projet géré par RAD ; dans votre propre projet, ou une fois la fenêtre de 30 jours passée, la façon d'arrêter de payer est de supprimer le déploiement et de le redéployer lorsque vous en avez besoin.
- Ce que coûte un redéploiement. Il n'y a pas de frais de module ici et les builds sont inclus, donc un redéploiement ne coûte rien en crédits RAD — la suppression permet d'économiser de l'argent dès que Bank of Anthos resterait inutilisé, à la fois dans votre propre projet (environ 0,80 US$ par jour) et dans un projet géré par RAD (51 crédits par jour).
- La majeure partie du coût d'exécution est généralement partagée. Pour Bank of Anthos, il s'agit de la base de données. Ils ne s'arrêtent que si rien d'autre dans le projet ne les utilise, donc la suppression de cette application pendant que quelque chose d'autre partage le projet n'économise que la partie calcul de cette application.
- Conservez d'abord vos données. Les sauvegardes nocturnes vont dans un bucket à l'intérieur du déploiement et sont supprimées avec lui, alors copiez la dernière sauvegarde avant de la supprimer si vous voulez la conserver.
Sessions de lab et environnements gérés
- Sessions de lab, pour la formation. Un formateur anime une session pour une classe. Chaque participant obtient l'application dans son propre projet Google Cloud pendant 15 minutes à 24 heures, dans la limite d'une allocation définie par le formateur. Le formateur peut aussi créer un seul environnement partagé pour toute la classe, et chacun utilise alors la même application et ses données. Soit le formateur finance toutes les places, soit chaque participant paie la sienne. Tout est supprimé à la fin de la session et les crédits inutilisés sont reversés au formateur.
- Environnements gérés, pour les cabinets de conseil. Un partenaire exécute l'application pour un client à partir d'un portefeuille cloisonné qu'il finance, et règle directement avec le client. Si le portefeuille est faible, la facturation est suspendue et les données sont conservées, de sorte que personne ne reçoit de frais inattendus. À la fin, le partenaire transfère le projet et les déploiements deviennent la propriété du client.
Les crédits peuvent être achetés dans plus de 20 devises, y compris XAF, XOF, NGN, GHS, KES et ZAR, par carte, virement bancaire ou argent mobile.
Sources (8 octobre 2026) : Prix catalogue Google Cloud de l'API Cloud Billing Catalog ; frais RAD et estimation des crédits quotidiens de radmodules.dev/pricing ; Supprimer et restaurer des projets pour les mécanismes de pause/restauration et ce qu'il dit sur les objets Cloud Storage sans suppression logicielle. Les prix changent ; vérifiez chaque source avant de vous fier à un chiffre.
1. Vue d'ensemble
Le module met en place une plateforme multi-cluster complète à partir de zéro, puis y déploie l'application bancaire :
| Capacité | Service Google Cloud | Notes |
|---|---|---|
| Calcul | GKE Autopilot (Standard facultatif) | Un cluster par région ; cluster_size clusters, 2 par défaut |
| Gestion multi-cluster | Flotte GKE (Hub) | Chaque cluster enregistré comme membre de la Flotte |
| Maillage de services | Cloud Service Mesh (Istio géré) | Multi-primaire, activé à l'échelle de la flotte en mode de gestion automatique |
| Découverte inter-cluster | Services multi-clusters (MCS) | Fonctionnalité de la Flotte pour les backends de services inter-clusters |
| Ingress global | Ingress multi-cluster + équilibreur de charge d'application externe global | Une adresse IP anycast achemine vers le cluster sain le plus proche |
| TLS | Certificat géré par Google | Provisionné automatiquement pour un domaine sslip.io dérivé de l'IP globale |
| Réseau | VPC partagé, sous-réseaux par cluster, Cloud Router + Cloud NAT, règles de pare-feu | VPC à routage global ; un Cloud Router + Cloud NAT par région de cluster. Les clusters ne sont pas privés — le module ne déclare aucun private_cluster_config, de sorte que les nœuds et le point de terminaison du plan de contrôle utilisent la configuration publique par défaut de GKE |
| Observabilité | Cloud Logging, Cloud Monitoring, Service géré pour Prometheus, Cloud Trace | Agrégé sur l'ensemble de la flotte |
| Application | Bank of Anthos (v0.6.10) | 9 microservices (Python + Java) plus deux bases de données PostgreSQL intra-cluster |
Choses à savoir d'emblée :
- C'est véritablement multi-cluster.
cluster_size(par défaut2) clusters sont créés et chacun est placé dans une région deavailable_regionsen mode round-robin. Avec les valeurs par défaut, vous obtenez deux clusters :gke-cluster-1dansus-west1etgke-cluster-2dansus-east1. L'ajout de régions supplémentaires ou l'augmentation decluster_sizese propage davantage (par exemple, 2 régions + 4 clusters cyclentus-west1,us-east1,us-west1,us-east1). - Les noms de cluster sont indexés à partir de 1 —
gke-cluster-1,gke-cluster-2, …,gke-cluster-N.cluster1est toujours le cluster primaire / de configuration dansavailable_regions[0]. - Les bases de données ne vivent que sur le cluster primaire. Les StatefulSets PostgreSQL
accounts-dbetledger-dbne sont déployés que surgke-cluster-1. Les clusters non primaires exécutent les services sans état ainsi que les Services et ConfigMaps de la base de données, mais pas les pods de la base de données — ils sont conçus pour atteindre les bases de données du cluster primaire via la flotte. La perte du cluster primaire met la couche de données hors ligne. - Une IP globale, un domaine. Une seule adresse globale est réservée et l'application est publiée à
https://boa.<GLOBAL_IP>.sslip.io, avec TLS émis automatiquement.sslip.iorésout tout nom<ip>.sslip.iovers cette IP, donc aucune zone DNS n'est requise. - Le maillage est multi-primaire. Cloud Service Mesh est activé au niveau de la flotte avec une gestion automatique ; chaque cluster exécute un plan de contrôle géré et partage un domaine de confiance (
<project>.svc.id.goog), de sorte que les sidecars de n'importe quel cluster s'authentifient mutuellement. - Aucun Cloud SQL, Memorystore ou Secret Manager n'est utilisé par l'application. Bank of Anthos exécute son propre PostgreSQL intra-cluster et une paire de clés JWT Kubernetes-Secret. (Certaines API de projet connexes sont activées, mais l'application ne dépend pas de ces services gérés.)
- Le premier déploiement est long. La création de plusieurs clusters, l'enregistrement de la flotte, le provisionnement du maillage géré et la mise en place de l'équilibreur de charge global avec un certificat géré prend généralement 40 à 60 minutes.
2. Services Google Cloud et comment les explorer
Comme il s'agit d'un déploiement multi-cluster, la plupart des explorations impliquent de basculer entre les contextes de cluster. Configurez un contexte par cluster et réutilisez-les partout :
export PROJECT="<your-project-id>"
export REGION1="us-west1"   # available_regions[0] — primary/config cluster
export REGION2="us-east1"   # available_regions[1]

gcloud container clusters get-credentials gke-cluster-1 --region "$REGION1" --project "$PROJECT"
gcloud container clusters get-credentials gke-cluster-2 --region "$REGION2" --project "$PROJECT"

# Friendlier context aliases
kubectl config rename-context "gke_${PROJECT}_${REGION1}_gke-cluster-1" cluster1
kubectl config rename-context "gke_${PROJECT}_${REGION2}_gke-cluster-2" cluster2
kubectl config get-contexts
L'espace de noms de l'application est bank-of-anthos sur chaque cluster.
A. Clusters GKE — le tissu de calcul
Chaque cluster exécute les charges de travail bancaires sur Autopilot (Standard est facultatif). Les clusters sont natifs du VPC, inscrits dans le canal de publication choisi, et ont GKE Security Posture, Managed Prometheus, le pilote CSI GCS FUSE, l'API Gateway et la gestion des coûts activés.
- Console : Moteur Kubernetes → Clusters liste chaque cluster avec son mode, sa région, sa version et le nombre de nœuds.
- CLI :
gcloud container clusters list --project "$PROJECT" \
  --format="table(name,location,autopilot.enabled,currentMasterVersion,status)"
kubectl --context cluster1 get nodes -o wide
kubectl --context cluster2 get nodes -o wide
B. Flotte GKE (Hub)
Chaque cluster est enregistré comme membre de la Flotte (ID de membre = nom du cluster) sous une seule flotte au niveau du projet. La flotte est ce qui permet au maillage, à MCS et à l'Ingress multi-cluster de s'étendre sur plusieurs clusters.
- Console : Moteur Kubernetes → Flottes affiche tous les membres et les fonctionnalités de la flotte activées par cluster.
- CLI :
gcloud container fleet memberships list --project "$PROJECT"
gcloud container fleet features list --project "$PROJECT"
C. Services multi-clusters (MCS)
MCS est activé en tant que fonctionnalité de la flotte afin que les services puissent avoir des backends sur plusieurs clusters. Le frontend est publié à l'échelle de la flotte via un MultiClusterService (bank-of-anthos-mcs) sur le cluster de configuration.
- Console : Moteur Kubernetes → Services et Ingress (sur le cluster de configuration) affiche le service multi-cluster.
- CLI :
kubectl --context cluster1 get multiclusterservice -n bank-of-anthos
kubectl --context cluster1 describe multiclusterservice bank-of-anthos-mcs -n bank-of-anthos
# The MCS importer runs in the gke-mcs namespace on member clusters:
kubectl --context cluster2 get pods -n gke-mcs
D. Cloud Service Mesh (multi-primaire)
Le maillage est activé à l'échelle de la flotte avec une gestion automatique — Google exécute le plan de contrôle Istio pour chaque cluster. L'espace de noms bank-of-anthos porte l'étiquette de révision CSM correspondant au canal de publication du cluster — istio.io/rev=asm-managed pour REGULAR, -rapid/-stable pour les deux autres — de sorte que chaque pod reçoit un sidecar Envoy (chaque pod d'application affiche 2/2 prêt). Une étiquette nommant une révision que le canal ne sert pas ne génère pas d'erreur ; l'injection est silencieusement ignorée et les pods démarrent sans sidecar. Tous les clusters partagent un domaine de confiance, de sorte que le maillage est multi-primaire et que le trafic entre les clusters est mutuellement authentifié.
- Console : Moteur Kubernetes → Maillage de services affiche la topologie combinée, les signaux d'or et l'état mTLS sur tous les clusters.
- CLI :
gcloud container fleet mesh describe --project "$PROJECT"   # per-membership control/data plane state
# Confirm sidecar injection on each cluster:
kubectl --context cluster1 get pods -n bank-of-anthos
kubectl --context cluster2 get pods -n bank-of-anthos
# Inspect the SPIFFE identity in a sidecar's certificate:
POD=$(kubectl --context cluster1 get pod -n bank-of-anthos -l app=frontend -o jsonpath='{.items[0].metadata.name}')
kubectl --context cluster1 exec "$POD" -n bank-of-anthos -c istio-proxy -- \
  cat /var/run/secrets/workload-spiffe-credentials/certificates.pem \
  | openssl x509 -noout -text | grep -E "URI:"
E. Passerelle multi-cluster et équilibrage de charge global
Une seule IP globale (bank-of-anthos) est réservée et un MultiClusterIngress (bank-of-anthos-mci) sur le cluster de configuration provisionne un équilibreur de charge d'application externe global dont les backends s'étendent sur chaque cluster. Le réseau de Google achemine chaque utilisateur vers le cluster sain le plus proche. Notez que le manifeste MultiClusterIngress ne contient aucune annotation networking.gke.io/static-ip ou networking.gke.io/pre-shared-certs, de sorte que l'équilibreur de charge n'adopte pas l'adresse globale réservée, et les objets ManagedCertificate et FrontendConfig (HTTP→HTTPS 301) appliqués au cluster de configuration ne sont pas référencés par celui-ci — le manifeste Ingress à cluster unique qui les lierait (manifests/ingress.yaml) est généré mais jamais appliqué. Lisez l'adresse réelle de l'équilibreur de charge à partir de l'état MultiClusterIngress (kubectl get mci -n bank-of-anthos -o jsonpath='{.items[0].status.VIP}').
- Console : Services réseau → Équilibrage de charge affiche l'équilibreur de charge global, ses frontends, le service backend et l'état de chaque groupe de points de terminaison réseau par cluster.
- CLI :
gcloud compute addresses list --global --project "$PROJECT" --filter="name~bank"
kubectl --context cluster1 get multiclusteringress -n bank-of-anthos
kubectl --context cluster1 get managedcertificate -n bank-of-anthos \
  -o jsonpath='{range .items[*]}{.metadata.name}{"\t"}{.status.certificateStatus}{"\n"}{end}'
# Backend health per cluster NEG:
BACKEND=$(gcloud compute backend-services list --global --project "$PROJECT" \
  --filter="name~bank-of-anthos" --format="value(name)" | head -1)
gcloud compute backend-services get-health "$BACKEND" --global --project "$PROJECT"
F. Réseau (VPC, NAT, pare-feu)
Tous les clusters partagent un VPC à routage global. Chaque cluster reçoit son propre sous-réseau avec des plages secondaires pour les pods et les services, un Cloud Router + Cloud NAT pour la sortie privée, une IP externe statique réservée et un ensemble de règles de pare-feu (trafic interne, le plan de contrôle GKE, les vérifications de santé de l'équilibreur de charge et les ports webhook ASM). Notez que le module crée également une règle allow-ssh-<deployment_id> ouvrant TCP/22 à l'ensemble du VPC depuis 0.0.0.0/0 — réduisez-la ou supprimez-la si vous conservez le déploiement au-delà d'une démo.
- Console : Réseau VPC → Réseaux VPC → le réseau du déploiement ; Réseau VPC → Pare-feu.
- CLI :
gcloud compute networks subnets list --project "$PROJECT" \
  --format="table(name,region,ipCidrRange)"
gcloud compute firewall-rules list --project "$PROJECT" \
  --format="table(name,direction,allowed[].map().firewall_rule().list())"
G. Observabilité (Logging, Monitoring, Prometheus, Trace)
Les journaux des pods sont acheminés vers Cloud Logging ; les métriques GKE et du maillage sont acheminées vers Cloud Monitoring et Managed Prometheus ; le maillage envoie des traces distribuées vers Cloud Trace. Tout cela est agrégé à travers la flotte, de sorte que vous pouvez comparer les clusters côte à côte.
- Console : Logging → Explorateur de journaux ; Monitoring → Tableaux de bord (groupe GKE) ; Moteur Kubernetes → Maillage de services pour les signaux d'or.
- CLI :
gcloud logging read \
  'resource.type="k8s_container" AND resource.labels.namespace_name="bank-of-anthos"' \
  --project "$PROJECT" --limit 20 \
  --format="table(timestamp,resource.labels.cluster_name,resource.labels.location)"
kubectl --context cluster1 top pods -n bank-of-anthos
kubectl --context cluster2 top pods -n bank-of-anthos
H. L'application Bank of Anthos
Bank of Anthos est une simulation de banque de détail : inscrivez-vous, connectez-vous, consultez les soldes et transférez des fonds. Elle comprend un frontend, userservice, contacts, ledgerwriter, balancereader, transactionhistory, un loadgenerator (trafic synthétique continu), et les bases de données PostgreSQL accounts-db / ledger-db. Le générateur de charge maintient le trafic afin que les tableaux de bord et les traces du maillage affichent immédiatement des données en direct. L'authentification utilise une paire de clés JWT stockée comme Secret Kubernetes jwt-key.
- Console : Moteur Kubernetes → Charges de travail (filtrer par l'espace de noms
bank-of-anthos), par cluster. - CLI :
kubectl --context cluster1 get deploy,statefulset,svc -n bank-of-anthos
kubectl --context cluster2 get deploy,statefulset,svc -n bank-of-anthos   # note: no DB StatefulSets here
3. Comportement
Ce qui est déployé lors de l'apply. Le module active les API de projet requises, crée (ou réutilise) le VPC partagé et les sous-réseaux/NAT/pare-feu par cluster, puis crée cluster_size clusters GKE dans les régions choisies. Chaque cluster est enregistré dans la flotte et le module attend que chaque adhésion atteigne READY (interrogé jusqu'à ~10 minutes) avant de continuer. Si le maillage est activé, il est activé au niveau de la flotte et par adhésion en mode de gestion automatique, et le module attend que le maillage se configure sur chaque cluster.
Déploiement de l'application sur les clusters. Avec deploy_application = true, le module télécharge la version épinglée de Bank of Anthos (v0.6.10), crée l'espace de noms bank-of-anthos (étiqueté pour l'injection de sidecar) sur chaque cluster, applique le secret JWT et applique les manifestes de charge de travail :
- Sur le cluster primaire (
cluster1), l'ensemble complet des manifestes est appliqué, y compris les StatefulSetsaccounts-dbetledger-db. - Sur tous les autres clusters, les mêmes manifestes sont appliqués, mais les StatefulSets de la base de données sont supprimés — les services sans état et les Services/ConfigMaps de la base de données sont toujours créés afin que les autres pods puissent les résoudre, et ils sont conçus pour utiliser les bases de données du cluster primaire à travers la flotte. Tout StatefulSet de base de données préexistant sur des clusters non primaires est supprimé.
Le module attend que les déploiements deviennent disponibles sur chaque cluster avant de signaler le succès.
Ingress global. Une fois l'application en cours d'exécution, le module active la fonctionnalité de flotte Ingress multi-cluster (cluster de configuration = cluster1) et applique, sur le cluster de configuration, le MultiClusterService (backends frontend sur plusieurs clusters), le MultiClusterIngress (l'équilibreur de charge global), un service NodePort + BackendConfig (vérifications de santé de l'équilibreur de charge), le certificat géré pour boa.<GLOBAL_IP>.sslip.io, le FrontendConfig (redirection HTTPS) et un ConfigMap de télémétrie de maillage dans istio-system. Le trafic circule alors : utilisateur → IP anycast globale → NEG du cluster sain le plus proche → pod frontend (sidecar Envoy) → services en aval via mTLS du maillage.
Suivi manuel. Le certificat géré par Google est provisionné de manière asynchrone et peut prendre 10 à 60 minutes pour devenir Active ; jusqu'à ce moment, HTTPS peut avertir ou échouer. Utilisez les identifiants de démonstration affichés sur la page de connexion de Bank of Anthos pour vous connecter. Pour activer le CDN, les domaines personnalisés, l'IAP ou les politiques de trafic inter-cluster (VirtualService/DestinationRule), appliquez les ressources Kubernetes pertinentes après le déploiement.
Notes d'exécution. Chaque pod d'application exécute 2/2 (application + sidecar). Le maillage partage un domaine de confiance, de sorte que les appels inter-clusters sont mutuellement authentifiés. Étant donné que la couche de données ne réside que sur le cluster primaire, la mise à l'échelle du primaire à zéro ou la perte de sa région affecte les bases de données — les frontends sans état sur d'autres clusters restent accessibles via l'équilibreur de charge global mais dépendent du primaire pour les données.
Destroy. Le processus de destruction exécute des étapes de nettoyage ordonnées qui suppriment les ressources Ingress/Service multi-cluster, désactivent les fonctionnalités de flotte de maillage et d'Ingress multi-cluster, désenregistrent les adhésions à la flotte et suppriment les règles de pare-feu et les NEG MCS restants avant de supprimer les clusters et le VPC. Les API activées par le module restent activées pour éviter de perturber d'autres charges de travail.
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement.
Groupe 1 — Projet et régions
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Projet Google Cloud cible. Doit déjà exister. |
tenant_id | demo | Identifiant du locataire. Doit être composé de 1 à 20 lettres minuscules, chiffres et tirets — d'autres valeurs échouent à la validation. Présent sur le formulaire mais non référencé par aucune ressource dans ce module. |
available_regions | ["us-west1", "us-east1"] | Régions dans lesquelles les clusters sont placés, en mode round-robin par index de cluster. S'il y a moins de régions que de clusters, les régions sont cyclées. Doit avoir au moins une entrée. |
Groupe 2 — Réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
create_network | true | Crée un nouveau VPC partagé pour tous les clusters. Définissez false pour utiliser un réseau existant nommé par network_name. |
network_name | vpc-network | Nom du VPC partagé. Lors de la création, un suffixe unique est ajouté automatiquement. |
subnet_name | vpc-subnet | Nom de base pour les sous-réseaux par cluster (<subnet_name>-cluster<N>). Utilisé uniquement lorsque create_network = true. |
Groupe 3 — Clusters GKE
| Variable | Valeur par défaut | Description |
|---|---|---|
create_autopilot_cluster | true | Crée des clusters Autopilot (nœuds entièrement gérés). Définissez false pour les clusters Standard avec des pools de nœuds gérés. S'applique à tous les clusters. |
release_channel | REGULAR | Canal de publication GKE pour tous les clusters : RAPID, REGULAR, STABLE, ou NONE. |
cluster_size | 2 | Nombre de clusters GKE à créer. Minimum 2 pour une démo multi-cluster significative ; la limite supérieure est limitée par le quota régional. |
Groupe 4 — Maillage de services
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_cloud_service_mesh | true | Installe et configure Cloud Service Mesh (Istio géré) à l'échelle de la flotte pour mTLS, le trafic inter-cluster et l'observabilité unifiée. Google sélectionne la version du maillage à partir de release_channel des clusters ; il n'y a pas d'entrée de version. |
Groupe 5 — Application
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Déploie Bank of Anthos sur tous les clusters après leur création. Définissez false pour provisionner uniquement l'infrastructure du cluster. |
5. Sorties
| Sortie | Description |
|---|---|
deployment_id | L'ID de déploiement (fourni ou auto-généré) utilisé pour suffixer les noms de ressources. |
project_id | L'ID du projet cible. |
L'adresse publique de l'application n'est pas exposée en tant que sortie Terraform. Récupérez l'IP globale à partir de l'adresse globale réservée (
gcloud compute addresses list --global --filter="name~bank") ou de l'étatMultiClusterIngress, puis naviguez vershttps://boa.<GLOBAL_IP>.sslip.io.
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
cluster_size | 2 (ou plus) | Élevé | Définir 1 va à l'encontre du but — pas d'ingress multi-cluster, d'étendue de maillage ou de basculement. Des valeurs très grandes peuvent épuiser le quota régional et échouer en cours d'apply. |
available_regions | ≥ 2 régions distinctes | Élevé | Une seule région supprime la géo-redondance ; tous les clusters partagent le domaine de défaillance d'une seule région. |
Cluster primaire (cluster1) | traiter comme la couche de données | Critique | Les bases de données accounts-db / ledger-db ne s'exécutent que sur le cluster primaire. La perte de sa région, ou sa mise à l'échelle à zéro, met la couche de données hors ligne pour chaque cluster. |
deployment_id | définir une fois, puis laisser | Critique | Le modifier après le premier déploiement force la recréation des ressources nommées (VPC, clusters), détruisant l'état d'exécution. |
release_channel | laisser à REGULAR sauf si vous avez une raison | Élevé | L'étiquette de révision CSM gérée (asm-managed/-rapid/-stable) et le ConfigMap de configuration de maillage istio-<revision> sont tous deux dérivés de cela. Changer le canal après le premier déploiement ne déplace pas le maillage — CSM conserve le canal avec lequel il a été provisionné. |
create_network / network_name | true pour un nouveau projet | Moyen | Pointer vers un réseau inexistant ou existant qui se chevauche (lorsque false) interrompt la création de sous-réseaux et de clusters. |
| Attente du certificat géré | prévoir 10 à 60 min | Moyen | Naviguer vers https://boa.<IP>.sslip.io avant que le certificat ne soit Active affiche des avertissements ou des échecs TLS — attendu pendant le provisionnement, pas une erreur de déploiement. |
create_autopilot_cluster | true | Faible | Les clusters Standard ajoutent la gestion des pools de nœuds et le coût par nœud ; Autopilot est plus simple et moins cher pour cette démo. |
enable_cloud_service_mesh | true | Moyen | Le désactiver supprime mTLS, la gestion du trafic inter-cluster et l'observabilité du maillage de services que le module est conçu pour démontrer. |
| Temps de premier déploiement | prévoir 40 à 60 min | Faible | Le provisionnement multi-cluster + flotte + maillage géré + équilibreur de charge global est intrinsèquement lent ; ne supposez pas un blocage. |
Ceci est un module éducatif autonome qui construit son propre VPC, ses clusters, sa flotte, son maillage et son équilibreur de charge global — il ne dépend pas d'un module de fondation séparé. Pour l'application en amont, consultez le référentiel Bank of Anthos.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.