Kestra sur Google Cloud Run
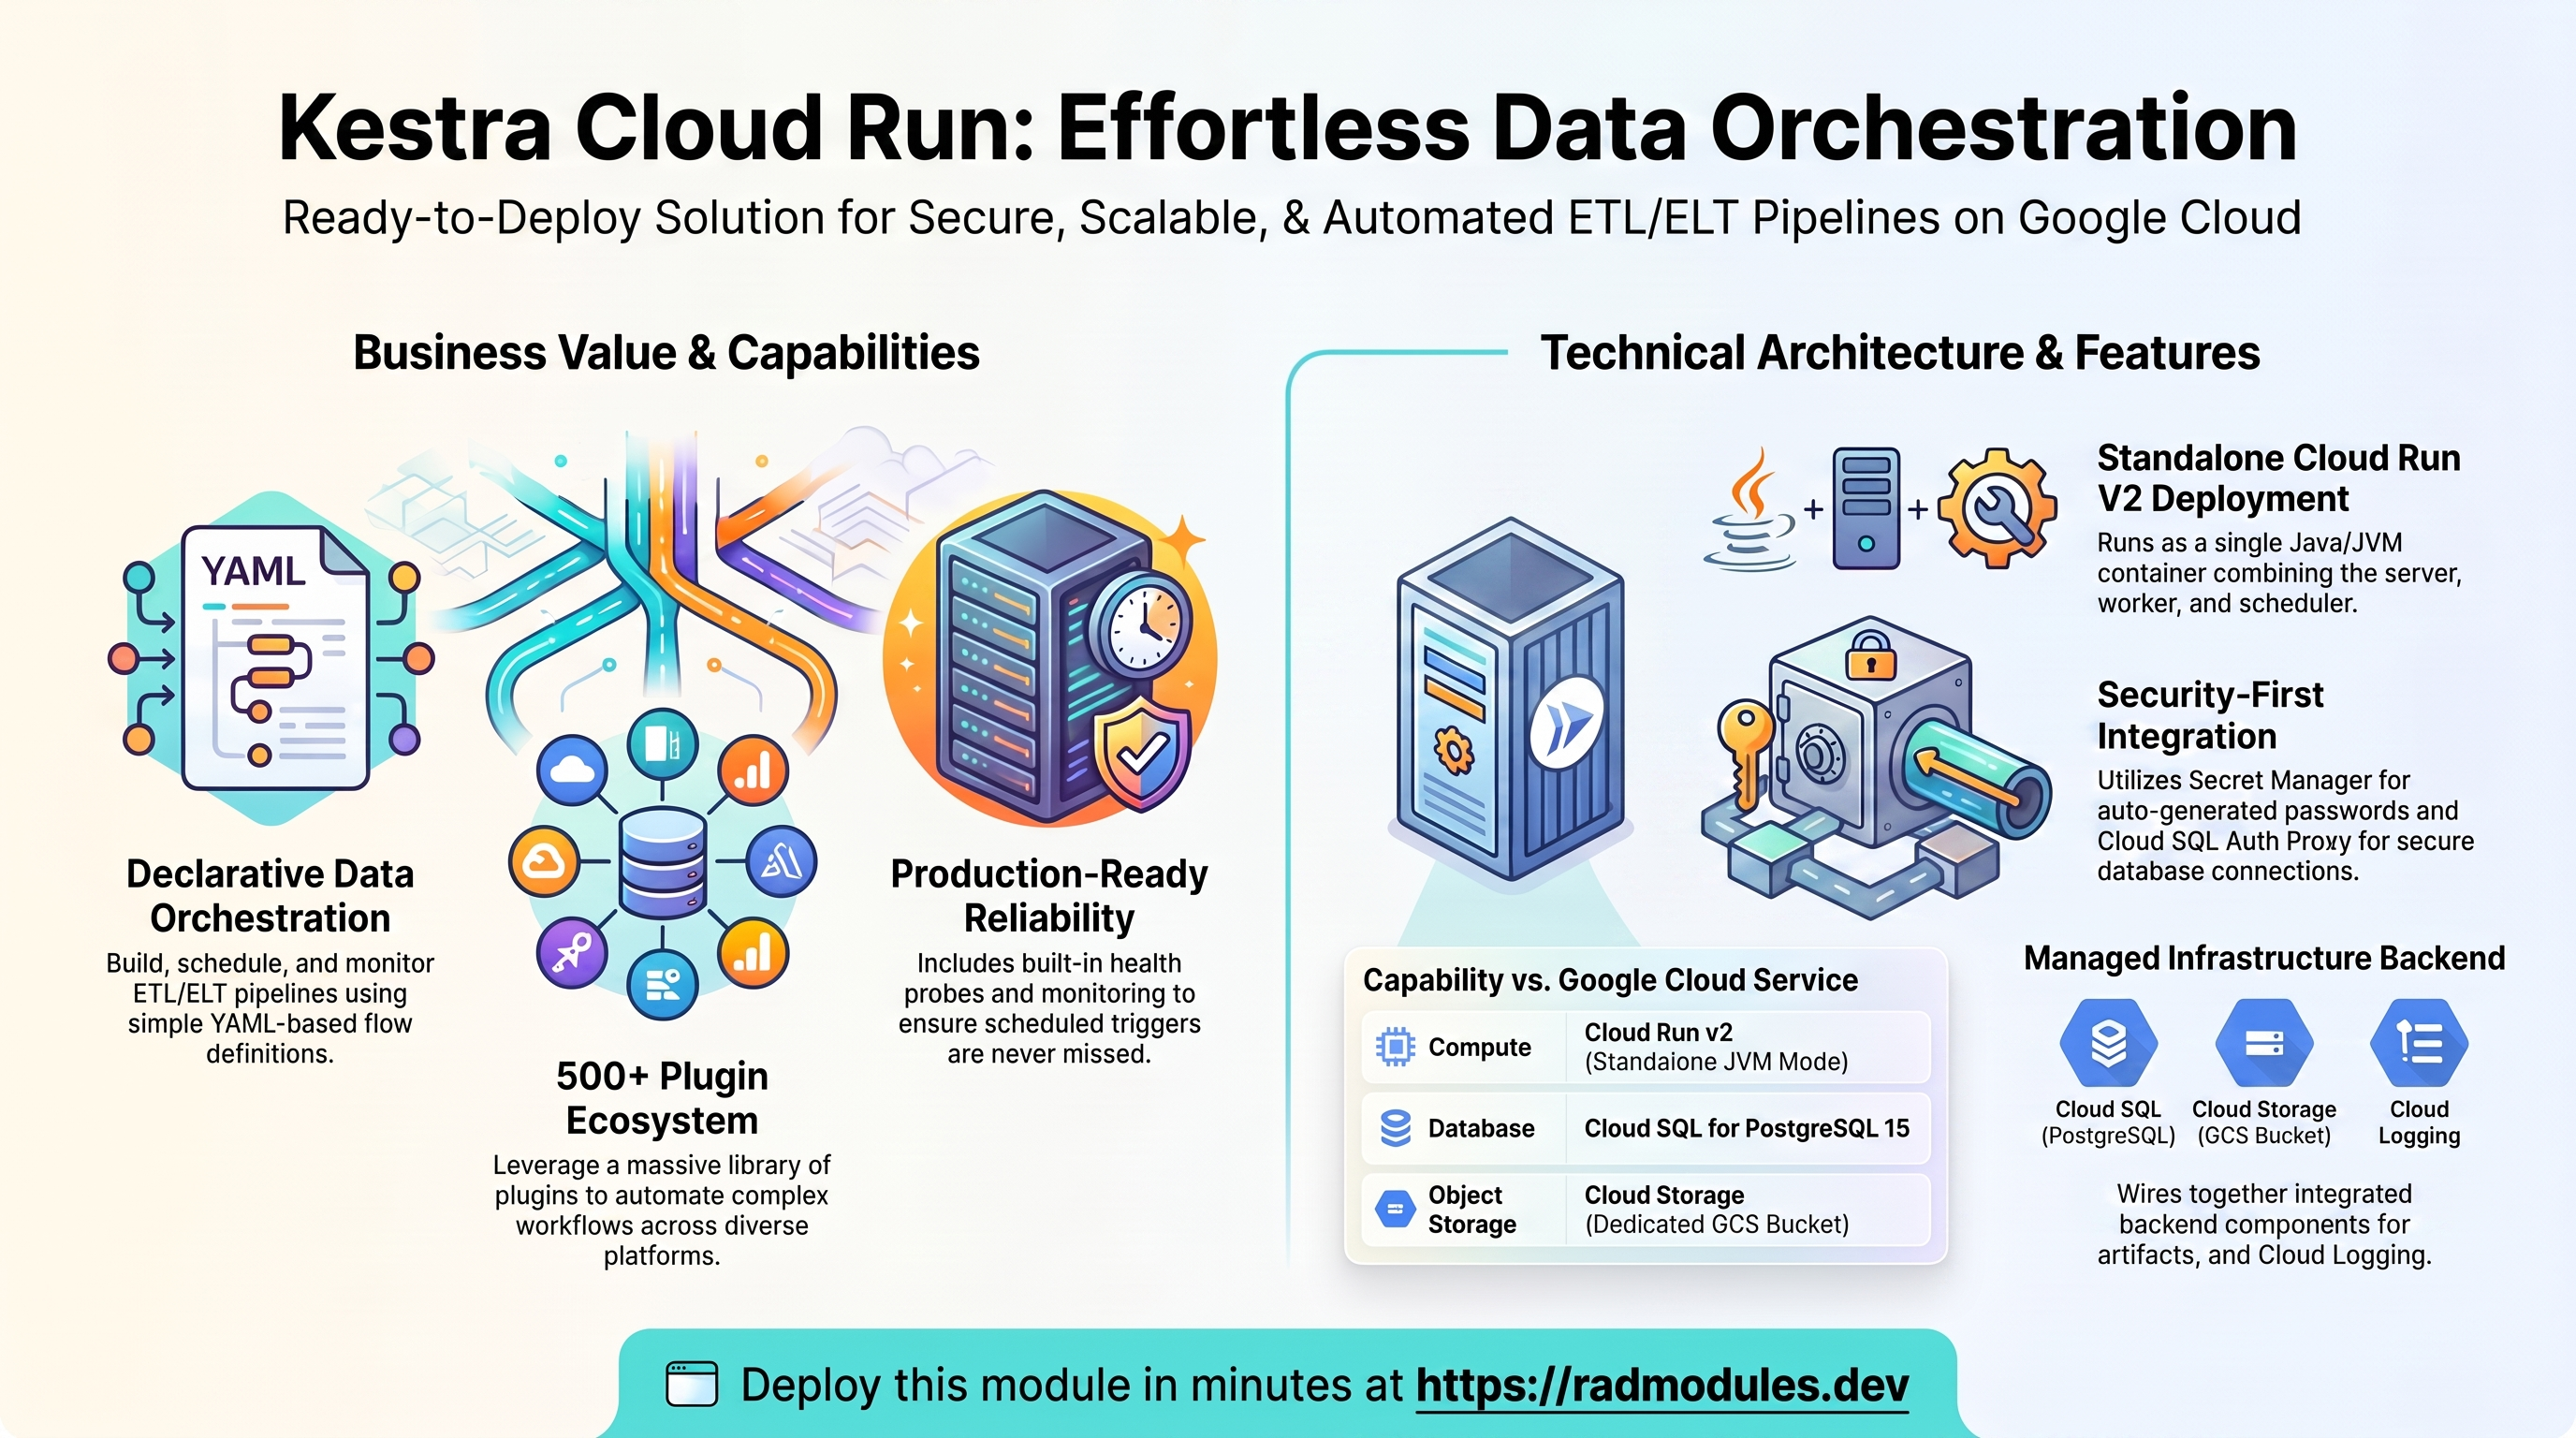
Kestra est une plateforme open source d'orchestration de données (Apache 2.0) permettant de créer, de planifier et de surveiller des pipelines ETL/ELT, des traitements par lots et des automatisations de workflows, au moyen de définitions de flux déclaratives en YAML et d'un écosystème de plus de 500 plugins. Ce module déploie Kestra sur Cloud Run v2 en mode autonome au-dessus du socle App_CloudRun, qui provisionne et gère l'infrastructure Google Cloud partagée.
Ce guide se concentre sur les services cloud qu'utilise Kestra et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à toutes les applications Cloud Run — identité du service, entrée et équilibrage de charge, mise à l'échelle et concurrence, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide du socle App_CloudRun plutôt que de les répéter ici.
1. Vue d'ensemble
Kestra s'exécute comme un conteneur Java/JVM sur Cloud Run v2 en mode autonome (serveur, worker et planificateur dans un seul conteneur). Le déploiement assemble un ensemble ciblé de services Google Cloud :
| Fonctionnalité | Service Google Cloud | Remarques |
|---|---|---|
| Calcul | Cloud Run v2 | Service Java/JVM, 2 vCPU / 4 Gio par défaut, mode autonome à instance unique |
| Base de données | Cloud SQL for PostgreSQL 15 | Obligatoire — stocke la file d'attente, le référentiel et l'historique des exécutions |
| Stockage d'objets | Cloud Storage | Bucket GCS dédié aux flux, aux exécutions et aux artefacts |
| Secrets | Secret Manager | Mot de passe administrateur Kestra et mot de passe de la base de données générés automatiquement |
| Entrée | URL Cloud Run / Cloud Load Balancing | URL run.app par défaut, équilibreur de charge HTTPS externe et domaine personnalisé facultatifs |
Valeurs par défaut judicieuses à connaître d'emblée :
- PostgreSQL 15 est obligatoire. Kestra utilise PostgreSQL à la fois pour sa file d'attente interne et pour son référentiel de flux. MySQL n'est pas pris en charge.
- Le mode autonome exécute tous les composants dans un seul conteneur.
Conservez
max_instance_count = 1pour éviter des états de verrouillage de file d'attente conflictuels entre instances. - Le démarrage à froid de la JVM Java est lent. La sonde de démarrage par
défaut accorde jusqu'à environ 14 minutes. Conservez
min_instance_count = 1en production pour ne jamais manquer de déclencheurs planifiés. - Redis n'est pas utilisé. En mode autonome, Kestra utilise PostgreSQL pour la mise en file d'attente.
- Un pont de socket Unix est intégré. Le Cloud SQL Auth Proxy crée un socket
Unix, mais Java JDBC ne sait pas se connecter nativement via des sockets Unix.
Le script personnalisé
entrypoint.shutilisesocatpour relier de manière transparente le socket à TCP127.0.0.1:5432. - Le mot de passe administrateur est généré automatiquement et stocké dans Secret Manager ; il n'est jamais défini en clair.
- Un bucket de stockage GCS est toujours provisionné pour les flux, les
exécutions et les artefacts ; son nom est injecté automatiquement en tant que
KESTRA_STORAGE_GCS_BUCKET.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que PROJECT et REGION sont définis. Les noms
des services et des ressources sont indiqués dans les Sorties du
déploiement.
A. Cloud Run — le service Kestra
Kestra s'exécute comme un service Cloud Run v2. Comme le mode autonome de Kestra regroupe le serveur, le worker et le planificateur dans un seul processus, il s'exécute sous la forme d'une instance unique de longue durée. Chaque déploiement crée une révision immuable ; le trafic peut être réparti entre les révisions pour des déploiements sûrs.
- Console : Cloud Run → sélectionnez le service pour consulter les révisions, le trafic, les journaux et les métriques.
- CLI :
gcloud run services list --project "$PROJECT" --region "$REGION"
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION"
gcloud run revisions list --service <service-name> --project "$PROJECT" --region "$REGION"
Consultez App_CloudRun pour la mise à l'échelle, la concurrence, l'environnement d'exécution et la répartition du trafic.
B. Cloud SQL for PostgreSQL 15
Kestra stocke tout l'état des workflows — définitions de flux, historique des
exécutions, déclencheurs, espaces de noms et file d'attente interne des tâches —
dans une instance gérée Cloud SQL for PostgreSQL 15. Le service se connecte via
le Cloud SQL Auth Proxy par un socket Unix ; entrypoint.sh relie ce socket
à TCP pour que le pilote Java JDBC puisse se connecter (aucune IP publique n'est
exposée). Lors du premier déploiement, un job d'initialisation crée la base de
données et l'utilisateur Kestra, et accorde les privilèges requis.
- Console : SQL → sélectionnez l'instance pour consulter les connexions, les sauvegardes, les flags et les métriques.
- CLI :
gcloud sql instances list --project "$PROJECT"
gcloud sql instances describe <instance-name> --project "$PROJECT"
gcloud sql connect <instance-name> --user=<db-user> --project "$PROJECT"
Le nom de l'instance, la base de données, l'utilisateur et le secret du mot de passe figurent dans les Sorties. Consultez App_CloudRun pour le modèle de connexion, les sauvegardes et la rotation des mots de passe.
C. Cloud Storage
Un bucket Cloud Storage dédié est provisionné pour le backend de stockage
d'artefacts GCS de Kestra. Toutes les exécutions de flux, les entrées/sorties des
tâches et les objets de stockage internes y sont écrits. Le nom du bucket est
injecté dans chaque instance en tant que KESTRA_STORAGE_GCS_BUCKET. Des buckets
supplémentaires ou des volumes GCS Fuse (environnement d'exécution gen2 requis)
peuvent être montés pour l'accès des flux aux données.
- Console : Cloud Storage → Buckets.
- CLI :
gcloud storage buckets list --project "$PROJECT"
gcloud storage ls gs://<kestra-storage-bucket>/        # bucket name in Outputs
Consultez App_CloudRun pour les options GCS Fuse et CMEK.
D. Secret Manager
Le mot de passe administrateur de Kestra et le mot de passe de la base de données sont stockés dans Secret Manager et injectés dans le service à l'exécution. Aucune valeur en clair n'apparaît dans la configuration.
- Console : Security → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT"
gcloud secrets versions access latest --secret=<admin-password-secret> --project "$PROJECT"
Le secret du mot de passe administrateur est nommé
<resource_prefix>-admin-password. Le nom du secret du mot de passe de la base
de données figure dans les Sorties. Consultez
App_CloudRun pour les détails d'injection et de rotation.
E. Réseau et entrée
Le service est accessible par défaut à son URL run.app. Un équilibreur de
charge HTTPS externe avec domaine personnalisé, Cloud CDN et Cloud Armor peut
être ajouté ; les paramètres d'entrée et la sortie VPC contrôlent la
connectivité.
- Console : Cloud Run (URL du service) ; Network services → Load balancing.
- CLI :
gcloud run services describe <service-name> --region "$REGION" --format='value(status.url)'
gcloud compute addresses list --project "$PROJECT"
Consultez App_CloudRun.
F. Cloud Logging et Monitoring
Les journaux des conteneurs sont envoyés vers Cloud Logging ; les métriques Cloud
Run et Cloud SQL vers Cloud Monitoring. Les sondes de santé ciblent le point de
terminaison /health de Kestra. Des tests de disponibilité et des règles
d'alerte facultatifs sont disponibles (le test de disponibilité est désactivé
par défaut — activez-le pour la surveillance en production).
- Console : Logging → Logs Explorer ; Monitoring → Dashboards / Alerting.
- CLI :
gcloud run services logs read <service-name> --project "$PROJECT" --region "$REGION" --limit 50
3. Comportement de l'application Kestra
- Initialisation de la base de données au premier déploiement. Un job
d'initialisation (
db-init) utilisepostgres:15-alpinepour se connecter via le Cloud SQL Auth Proxy et crée de manière idempotente la base de données et l'utilisateur Kestra, accorde les privilèges et réinitialise le schéma public afin que Flyway puisse appliquer proprement toutes les migrations sur une instance Cloud SQL neuve. Une fois terminé, le job signale au proxy de s'arrêter proprement. - Migrations Flyway au démarrage. Kestra exécute des migrations de schéma
basées sur Flyway à chaque démarrage. Le paramètre
FLYWAY_DATASOURCES_POSTGRES_BASELINE_ON_MIGRATE=trueévite les échecs sur Cloud SQL, qui pré-remplit le schéma public avec des objets d'extension. La mise à niveau d'application_versionapplique automatiquement les modifications de schéma. - Pont du socket Unix vers TCP. Le Cloud SQL Auth Proxy de Cloud Run crée un
socket Unix sur
${DB_HOST}/.s.PGSQL.5432. Java JDBC ne sait pas se connecter nativement via un socket Unix. Le script personnaliséentrypoint.shdétecte ce socket, crée un lien symbolique sur/tmp/cloudsql.sock(pour éviter les problèmes liés au séparateur deux-points) et démarre un pontsocatqui redirige TCP127.0.0.1:5432vers le socket. Les variables JDBCDATASOURCES_POSTGRES_URL,DATASOURCES_POSTGRES_USERNAMEetDATASOURCES_POSTGRES_PASSWORDsont ensuite assemblées à partir des variables d'environnementDB_*injectées par la plateforme, avant le lancement de Kestra. - Point de terminaison de santé. Les sondes de démarrage et d'activité
ciblent
GET /healthsur le port 8080. La sonde de démarrage par défaut accorde jusqu'à environ 14 minutes au démarrage de la JVM. La sonde de démarrage au niveau de l'infrastructure est de type TCP (sans chemin), ce qui fournit à la couche de routage de Cloud Run un signal d'activité simple avant que la sonde applicative ne prenne le relais. - Connexion administrateur. Le nom d'utilisateur administrateur initial est
admin. Le mot de passe se récupère dans Secret Manager (voir §2.D). - Déclencheurs planifiés. Le planificateur interne de Kestra traite les
déclencheurs définis dans les flux (cron, intervalle, webhook).
min_instance_count = 1garantit qu'une instance active est toujours disponible. La mise à l'échelle à zéro (0) fait manquer des fenêtres de déclenchement pendant les démarrages à froid.
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres propres à Kestra ou notables pour lui sont listés ; toutes les autres entrées sont héritées de App_CloudRun avec leur comportement standard.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Projet Google Cloud cible. |
region | us-central1 | Région du service et des ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques pour chaque environnement. |
support_users | [] | Adresses e-mail auxquelles sont accordés l'accès au projet et les alertes de surveillance. |
resource_labels | {} | Libellés appliqués à toutes les ressources. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | kestra | Nom de base des ressources. Ne le modifiez pas après le premier déploiement. |
application_version | latest | Tag de version de l'image Kestra ; incrémentez-le pour déployer une nouvelle version (par exemple 0.17.0). |
display_name | Kestra Data Orchestration | Nom convivial affiché dans la console et dans l'interface de la plateforme. |
description | Kestra Data Orchestration - ETL/ELT pipeline and workflow orchestration on Cloud Run | Description du service Cloud Run. |
deploy_application | true | Définissez false pour provisionner uniquement l'infrastructure. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
cpu_limit | 2000m | CPU par instance ; 2 vCPU minimum recommandés pour la JVM de Kestra. |
memory_limit | 4Gi | Mémoire par instance ; 4 Gio recommandés (2 Gio minimum). |
container_port | 8080 | Port du serveur Kestra/Micronaut. Doit correspondre à MICRONAUT_SERVER_PORT. |
min_instance_count | 1 | Nombre minimal d'instances. Conservez une valeur ≥ 1 pour ne jamais manquer de déclencheurs planifiés. |
max_instance_count | 1 | Nombre maximal d'instances. Laissez à 1 en mode autonome pour éviter les conflits de file d'attente. |
timeout_seconds | 300 | Durée maximale d'une requête, en secondes. |
execution_environment | gen2 | gen2 est requis pour les montages de volumes GCS Fuse. |
enable_cloudsql_volume | true | Conteneur annexe Cloud SQL Auth Proxy — requis pour le pont JDBC par socket Unix. |
enable_image_mirroring | true | Met en miroir l'image Kestra dans Artifact Registry avant le déploiement. |
cpu_always_allocated | true | Maintient le CPU alloué en permanence (recommandé pour le planificateur de Kestra). |
ingress_settings | all | Réseaux autorisés à atteindre le service : all, internal ou internal-and-cloud-load-balancing. |
vpc_egress_setting | PRIVATE_RANGES_ONLY | Mode d'acheminement du trafic sortant via le connecteur VPC. |
traffic_split | [] | Répartition du trafic entre les révisions pour des déploiements progressifs. |
max_revisions_to_retain | 7 | Nombre d'anciennes révisions à conserver. |
Groupe 5 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Paramètres supplémentaires non secrets. Les variables principales de Kestra sont injectées automatiquement ; ne les remplacez pas ici. |
secret_environment_variables | {} | Correspondance variable d'environnement → nom du secret Secret Manager. |
secret_propagation_delay | 30 | Nombre de secondes d'attente après la création d'un secret (0 à 300). |
secret_rotation_period | 2592000s | Période des notifications de rotation de Secret Manager. |
enable_auto_password_rotation | false | Rotation automatisée et sans interruption du mot de passe de la base de données. |
rotation_propagation_delay_sec | 90 | Nombre de secondes d'attente après la rotation avant de redémarrer le service. |
Groupe 7 — Sauvegarde et restauration
| Variable | Valeur par défaut | Description |
|---|---|---|
backup_schedule | 0 2 * * * | Expression cron de la sauvegarde automatique (UTC). |
backup_retention_days | 7 | Durée de conservation ; augmentez-la pour la production et la conformité. |
enable_backup_import / backup_source / backup_uri / backup_format | options de restauration | Restaure à partir d'une sauvegarde lors du déploiement. |
Groupe 8 — CI/CD et Binary Authorization
Intégration standard Cloud Build / Cloud Deploy d'App_CloudRun — voir
App_CloudRun. Entrées principales : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy,
enable_binary_authorization.
Groupe 9 — NFS et SQL personnalisé
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_nfs | false | Provisionne un partage Cloud Filestore (NFS) et le monte dans le service. Nécessite gen2. |
nfs_mount_path | /mnt/nfs | Chemin de montage dans le conteneur. |
enable_custom_sql_scripts / custom_sql_scripts_bucket / custom_sql_scripts_path / custom_sql_scripts_use_root | désactivé | Exécute du SQL depuis un bucket GCS après le provisionnement. Consultez App_CloudRun. |
Groupe 10 — Domaine, CDN, Cloud Armor et rétention des images
| Variable | Valeur par défaut | Description |
|---|---|---|
application_domains | [] | Noms d'hôte personnalisés pour l'équilibreur de charge HTTPS externe. |
enable_cdn | false | Active Cloud CDN sur le backend de l'équilibreur de charge HTTPS. Nécessite enable_cloud_armor = true. |
enable_cloud_armor / admin_ip_ranges | désactivé | Associe une règle WAF / restreint les accès privilégiés. |
max_images_to_retain / delete_untagged_images / image_retention_days | (définies) | Règle de nettoyage d'Artifact Registry. |
Groupe 11 — Stockage
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Provisionne les buckets supplémentaires de storage_buckets. Le bucket de stockage de Kestra est toujours créé. |
storage_buckets | [] | Buckets GCS supplémentaires en plus du bucket de stockage intégré. |
gcs_volumes | [] | Buckets GCS à monter via GCS Fuse (nécessite gen2). |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options CMEK. |
Groupe 12 — Backend de base de données
| Variable | Valeur par défaut | Description |
|---|---|---|
db_name | kestra | Nom de la base de données PostgreSQL. Immuable après le premier déploiement. |
db_user | kestra | Utilisateur de l'application. Immuable après le premier déploiement. |
database_type | POSTGRES_15 | Moteur Cloud SQL. Kestra nécessite PostgreSQL. |
database_password_length | 32 | Longueur du mot de passe généré (16 à 64). |
enable_cloudsql_volume | true | Requis pour le pont JDBC par socket Unix. |
Groupe 13 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Laissez vide pour utiliser le job db-init intégré. Fournissez une liste non vide pour le remplacer entièrement. |
cron_jobs | [] | Jobs Cloud Run récurrents déclenchés par Cloud Scheduler. |
additional_services | [] | Services Cloud Run complémentaires déployés aux côtés du service Kestra principal. |
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe | HTTP /health, délai de 30 s, période de 20 s, 40 échecs | Sonde de démarrage applicative — accorde jusqu'à environ 14 minutes au démarrage de la JVM. |
liveness_probe | HTTP /health, délai de 180 s, période de 30 s, 5 échecs | Sonde de vivacité applicative. |
startup_probe_config | TCP, sans chemin | Sonde de démarrage au niveau de l'infrastructure (ne suit pas les redirections HTTP). |
uptime_check_config | désactivé, chemin /health | Test de disponibilité Cloud Monitoring. Activez-le pour la surveillance en production. |
alert_policies | [] | Règles d'alerte sur les métriques. |
Groupe 20 — Identity-Aware Proxy (IAP)
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_iap | false | Exige une connexion Google via Identity-Aware Proxy. |
iap_authorized_users / iap_authorized_groups | [] | Qui peut accéder via IAP. |
Groupe 22 — VPC Service Controls et journalisation d'audit
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vpc_sc | false | Applique un périmètre VPC-SC (nécessite organization_id). |
vpc_cidr_ranges / vpc_sc_dry_run | (définies) | CIDR du niveau d'accès / mode simulation (dry-run). |
enable_audit_logging | false | Journaux Cloud Audit Logs détaillés. |
5. Sorties
Renvoyées après un déploiement réussi — le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du service Cloud Run. |
service_url | URL run.app par défaut du service. |
service_location | Région dans laquelle s'exécute le service. |
stage_services | URL des services propres à chaque étape (Cloud Deploy). |
load_balancer_ip / load_balancer_url | IP / URL de l'équilibreur de charge HTTPS externe (lorsqu'il est activé). |
database_instance_name | Nom de l'instance Cloud SQL. |
database_name / database_user | Nom / utilisateur de la base de données de l'application. |
database_password_secret | Secret Secret Manager contenant le mot de passe de la base de données. |
database_host / database_port | Point de terminaison / port de la base de données. |
storage_buckets | Buckets Cloud Storage créés (y compris le bucket de stockage de Kestra). |
network_name / network_exists / regions | Réseau VPC, présence, régions. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels / uptime_check_names | État de la surveillance, canaux, tests de disponibilité. |
initialization_jobs | Noms des jobs de configuration initiale. |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / cicd_configuration | État et détails du CI/CD. |
github_repository_url / github_repository_owner / github_repository_name | Détails du dépôt GitHub. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Dépôt et déclencheur de build. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État de VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | État des journaux d'audit et de CMEK. |
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
db_name | kestra — défini une fois pour toutes | Critique | Immuable après le premier déploiement ; le modifier connecte Kestra à une base de données vide, ce qui fait perdre tous les flux, l'historique des exécutions, les déclencheurs et les espaces de noms. |
application_name | kestra — défini une fois pour toutes | Critique | Immuable après le premier déploiement ; le modifier renomme toutes les ressources GCP, ce qui entraîne leur recréation complète avec perte de données. |
KESTRA_BASICAUTH_ENABLED (injecté à true) | laissez la valeur injectée | Critique | Le passer à false expose l'intégralité de l'interface et de l'API REST de Kestra sans authentification. Ne le désactivez que derrière un proxy d'authentification de confiance (IAP, Cloud Armor). |
enable_backup_import | false, sauf en cas de restauration | Critique | L'activer sans backup_uri valide fait échouer le job d'importation. |
max_instance_count | 1 | Élevé | Plusieurs instances provoquent des conflits de verrouillage de la file d'attente PostgreSQL et la double attribution de tâches dans la Community Edition. |
min_instance_count | 1 | Élevé | La valeur 0 fait manquer des déclencheurs planifiés pendant les périodes de démarrage à froid. |
memory_limit | 4Gi | Élevé | Des valeurs inférieures à 2 Gio provoquent des OutOfMemoryError de la JVM sous une charge d'exécutions concurrentes. |
enable_cloudsql_volume | true | Élevé | Requis pour le pont JDBC par socket Unix ; sans lui, le pont de socket de entrypoint.sh n'a aucun socket à relier. |
KESTRA_QUEUE_TYPE / KESTRA_REPOSITORY_TYPE (injectés à postgres) | laissez les valeurs injectées | Élevé | Seul PostgreSQL est provisionné ; les remplacer par un backend non pris en charge fait échouer le démarrage. |
execution_environment | gen2 | Élevé | Les montages NFS et GCS Fuse nécessitent gen2 ; passer à gen1 fait échouer les montages. |
Seuil d'échecs de startup_probe | 40 (valeur par défaut) | Élevé | Le réduire en dessous d'environ 10 provoque des redémarrages prématurés lors d'un démarrage lent de la JVM, avant que Kestra n'ait fini de se charger. |
ENDPOINTS_ALL_PORT (injecté à 8080) | laissez la valeur injectée | Élevé | Remplacer ce port casse les contrôles de santé de Cloud Run et provoque des redémarrages continus du conteneur. |
min_instance_count | 1 | Moyen | La valeur 0 ajoute une latence de démarrage à froid et expose au risque de manquer des tâches planifiées. |
ingress_settings | all (ou équilibreur de charge uniquement en production) | Moyen | La valeur internal bloque tous les déclencheurs webhook externes et les appels d'API provenant de l'extérieur du VPC. |
enable_iap / enable_cloud_armor | à activer pour les accès d'administration | Moyen | Sinon, l'interface et l'API de Kestra sont accessibles publiquement. |
backup_retention_days | 7 (à augmenter en production) | Moyen | Trop court pour les exigences de conservation réglementaire. |
organization_id | à définir en cas d'utilisation de VPC-SC | Moyen | S'il est vide, VPC Service Controls est ignoré sans avertissement. |
Suppression des ressources — délai connu du sous-réseau Cloud Run
Lors de la suppression de ce déploiement, vous pouvez rencontrer l'erreur suivante :
Error: Error waiting for Subnetwork to be deleted: The following serverless IPv4 address(es)
on subnet ... are still in use.
GCP libère les adresses IPv4 serverless de manière asynchrone après la suppression du service Cloud Run. Attendez 20 à 30 minutes après la première tentative de suppression, puis relancez la commande de suppression ; elle aboutira une fois que GCP aura libéré les adresses réservées.
Pour le comportement du socle auquel ce guide fait référence — identité du service, mise à l'échelle et concurrence, entrée et équilibrage de charge, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir des images — consultez App_CloudRun. La configuration applicative propre à Kestra partagée avec la variante GKE est décrite dans Kestra_Common.
Guides associés
- Lab pratique : Kestra sur Cloud Run — déployez-le pas à pas, avec les écrans de la console et les commandes à chaque étape.
- Kestra sur GKE Autopilot — la même application sur Kubernetes, lorsque vous avez besoin de l'autre cible de déploiement.
- Kestra Common — Configuration applicative partagée — la configuration partagée par les deux cibles de déploiement.
- Déployé aux côtés de Windmill sur Google Cloud Run, Temporal sur GKE Autopilot, CloudBeaver sur Google Cloud Run dans la solution Data & Workflow Orchestration.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.