Kavita sur Google Cloud Run
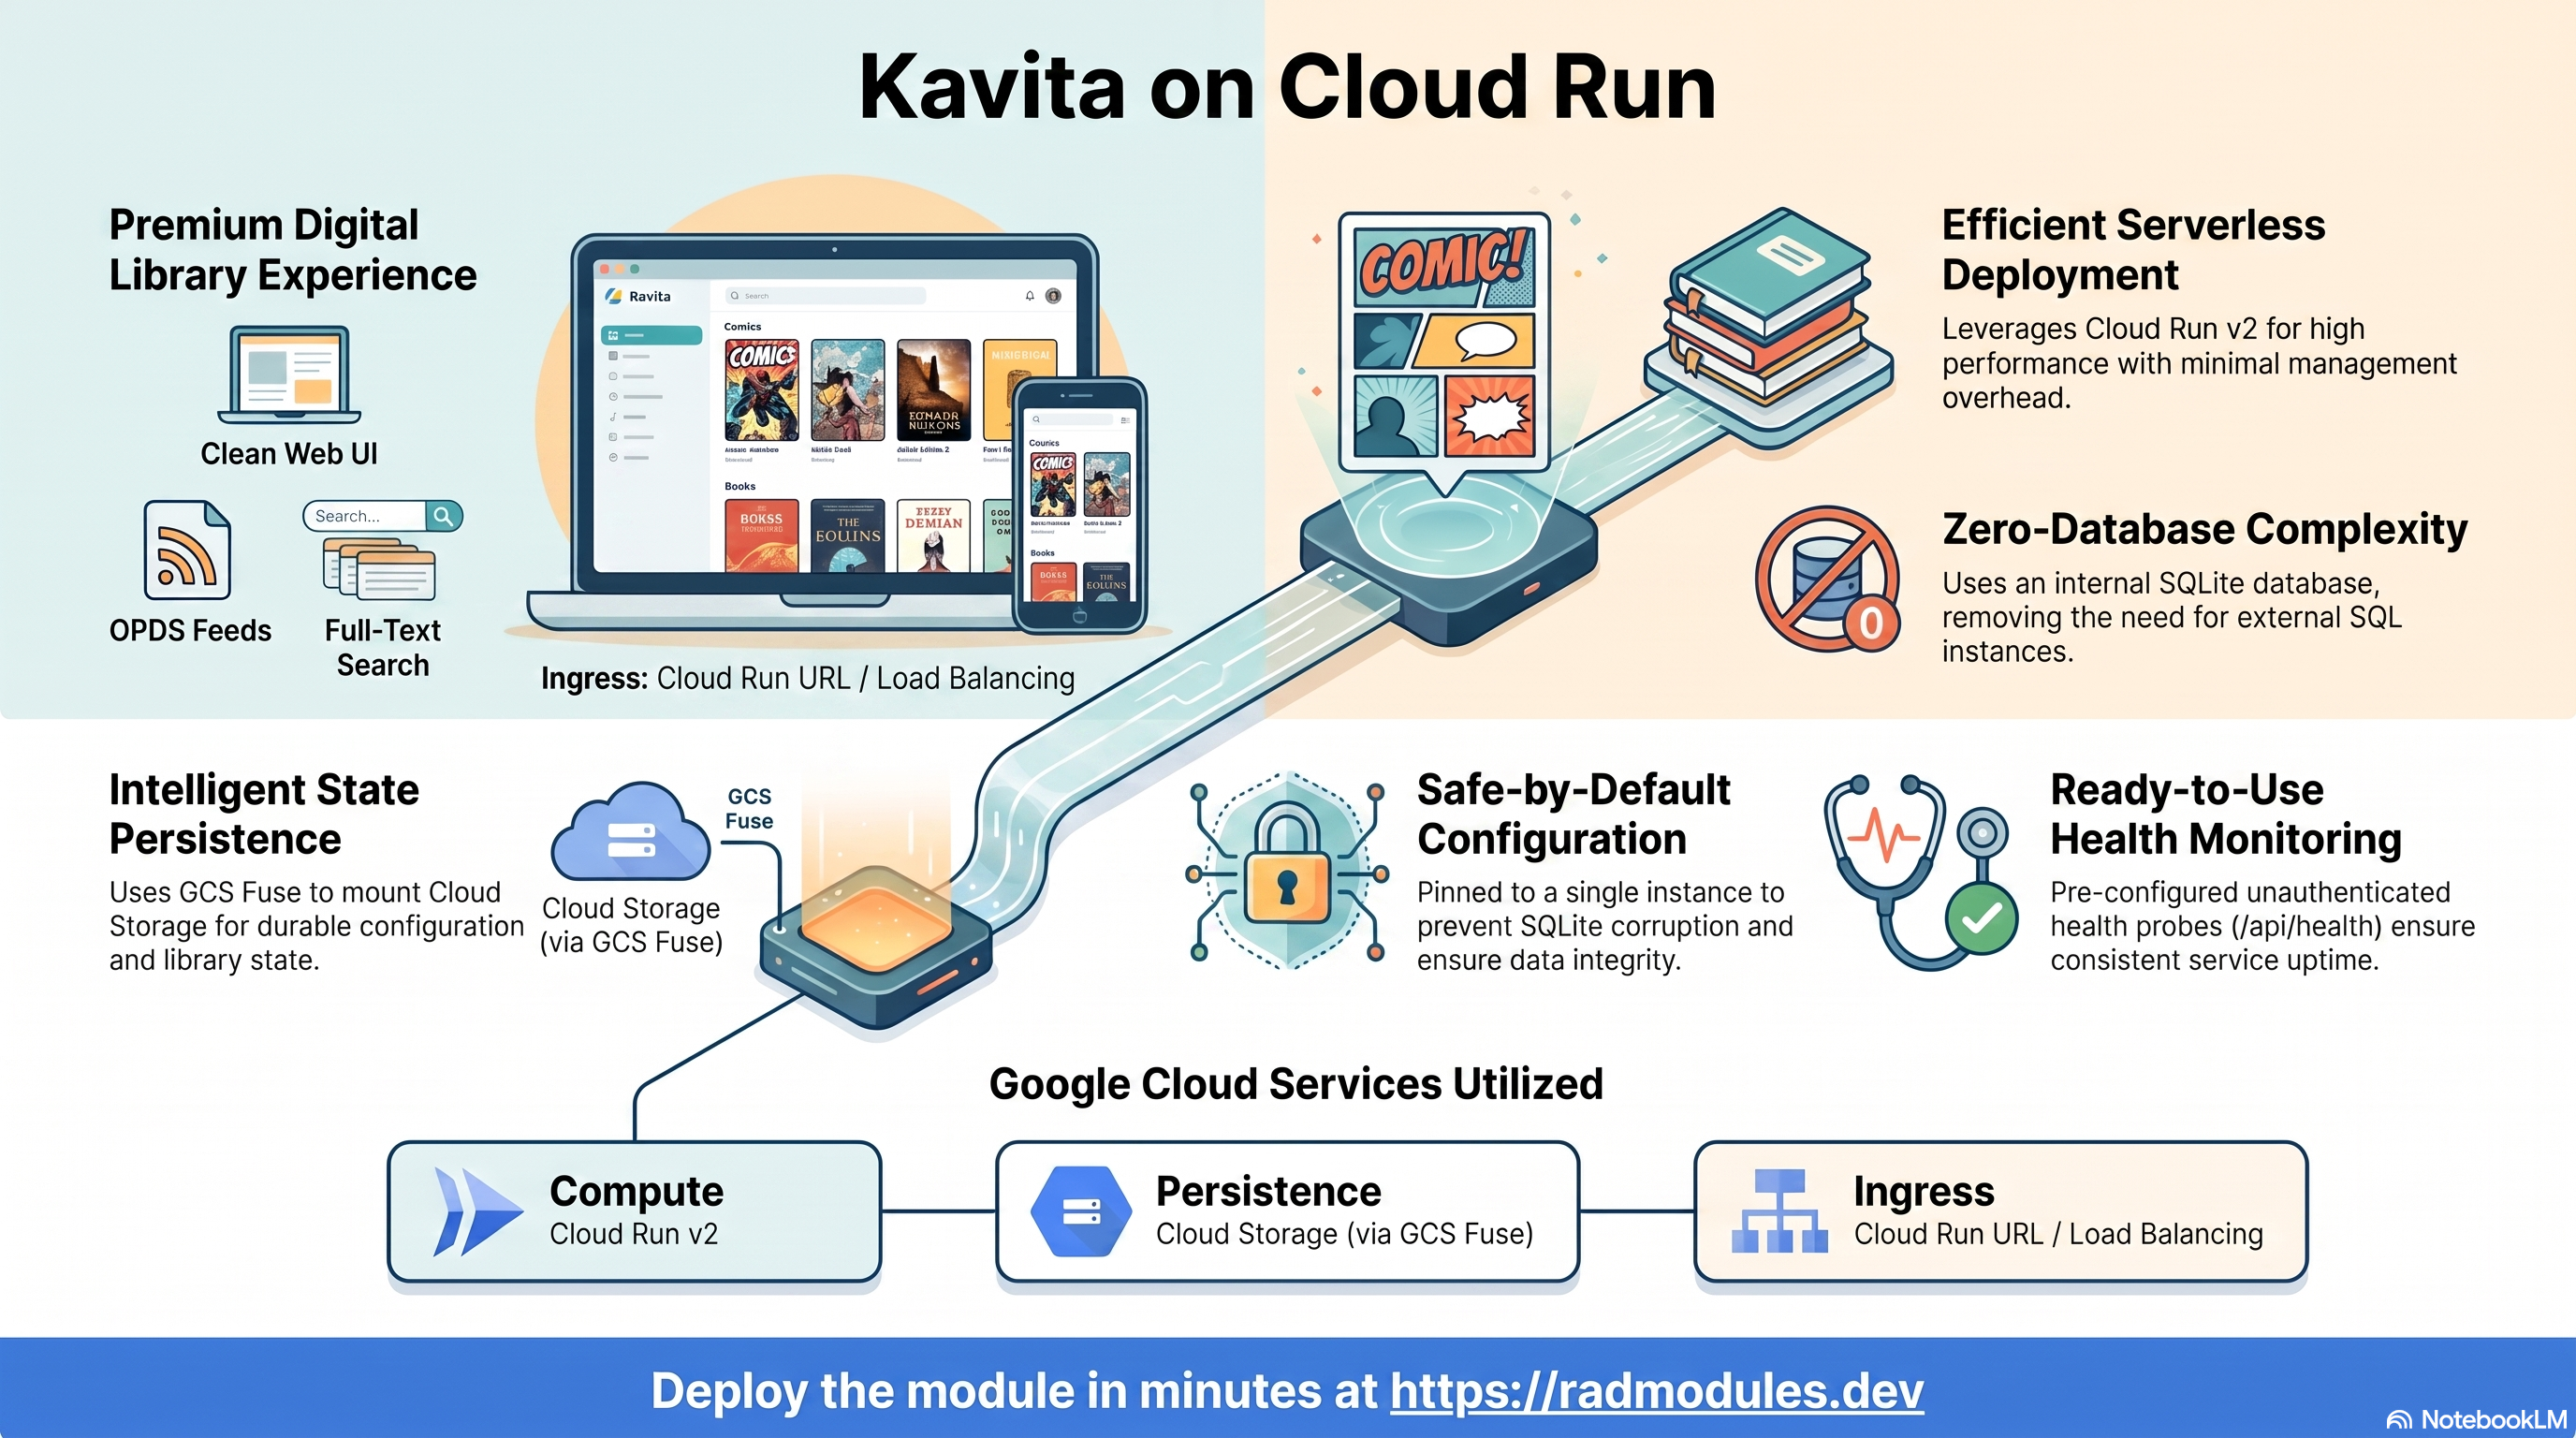
Kavita est une bibliothèque numérique et un serveur de lecture auto-hébergés et rapides pour les bandes dessinées, les mangas et les livres numériques — une interface web de lecture épurée, des flux OPDS, des collections, des listes de lecture et une recherche plein texte sur votre bibliothèque, le tout construit sur .NET avec une base de données SQLite interne. Ce module déploie Kavita sur Cloud Run v2 au-dessus du socle App_CloudRun, qui provisionne et gère l'infrastructure Google Cloud partagée.
Ce guide se concentre sur les services cloud qu'utilise Kavita et sur la manière de les explorer et de les exploiter depuis la console Google Cloud et la ligne de commande. Pour les mécanismes communs à toutes les applications Cloud Run — identité du service, entrée et équilibrage de charge, mise à l'échelle et concurrence, CI/CD, Cloud Armor, IAP, Binary Authorization, VPC Service Controls, sauvegardes et cycle de vie du déploiement — reportez-vous au guide du socle App_CloudRun plutôt que de les répéter ici.
1. Vue d'ensemble
Kavita s'exécute comme un unique conteneur .NET sur Cloud Run v2 sans base de
données ni cache externes — tout ce dont il a besoin (paramètres, base de
données SQLite interne et index de la bibliothèque) se trouve sur le disque sous
/kavita/config.
| Fonctionnalité | Service Google Cloud | Remarques |
|---|---|---|
| Calcul | Cloud Run v2 | Conteneur web .NET sur le port 5000, 1000m de CPU / 1Gi de mémoire par défaut ; min=1/max=1 |
| Base de données | Aucune — SQLite interne | database_type est fixé à NONE par Kavita_Common ; aucune instance Cloud SQL n'est créée |
| Persistance de l'état | Bucket Cloud Storage monté via GCS Fuse | /kavita/config contient la base de données SQLite (kavita.db), les paramètres, les couvertures et les journaux — c'est la seule option de persistance de Cloud Run (pas de PVC bloc) |
| Stockage d'objets | Cloud Storage | Un bucket storage est provisionné automatiquement et monté sur /kavita/config |
| Secrets | Secret Manager | Aucun secret généré — l'assistant de configuration du premier lancement crée le compte administrateur ; secret_ids/secret_values sont vides |
| Entrée | URL Cloud Run / Cloud Load Balancing | URL run.app par défaut ; équilibreur de charge HTTPS externe et domaine personnalisé facultatifs |
Valeurs par défaut judicieuses à connaître d'emblée :
- Ici, SQLite n'a pas d'autre choix que de résider sur GCS Fuse. Cloud Run
n'offre pas d'option de volume persistant bloc, si bien que
/kavita/config(la base de données SQLite et les paramètres de Kavita) est toujours monté via gcsfuse. C'est le seul endroit de ce module où la mise en garde habituelle du dépôt, « gcsfuse corrompt SQLite », est inévitable plutôt qu'une erreur de configuration — la description du module elle-même recommande Kavita_GKE pour les bibliothèques de production, où les mêmes données résident sur un véritable PVC bloc. ConsidérezKavita_CloudRuncomme adapté avant tout aux bibliothèques de petite à moyenne taille. min_instance_countvaut1par défaut, et non0. Contrairement à la plupart des modules d'application Cloud Run (qui utilisent par défaut la mise à l'échelle à zéro), Kavita garde par défaut une instance toujours active, ce qui évite les délais de démarrage à froid pendant qu'il recharge l'index de sa bibliothèque et remonte le volume gcsfuse.max_instance_countest fixé à1. Kavita n'offre ni clustering ni coordination des écritures partagées ; une seconde instance écrivant dans le même fichier SQLite monté via gcsfuse risque de corrompre l'index de la bibliothèque.- Pas de base de données, pas de Redis.
database_typeest fixé àNONE, et Redis est forcé à l'arrêt :main.tfcode en durenable_redis = falsequelle que soit la valeur par défaut héritée du socle pour cette variable (true) — Kavita n'a aucun usage d'une file d'attente ou d'un cache. - Aucun secret généré automatiquement. Aucun mot de passe administrateur, clé d'API ou clé de signature n'est créé dans Secret Manager. Le compte administrateur est créé de manière interactive via l'assistant de configuration du premier lancement de Kavita, la première fois que vous ouvrez l'URL du service.
- Image construite sur mesure, tag de version épinglé. Le Dockerfile est une
fine surcouche de
jvmilazz0/kavita:${KAVITA_VERSION}.application_version = "latest"se résout en un argument de build épingléKAVITA_VERSION = 0.8.7dansKavita_Common(et non en l'APP_VERSIONgénérique qu'injecte le socle) — changer de version impose de modifier cette valeur épinglée et de reconstruire l'image, pas seulement de redéployer. - Le chemin de santé est
/api/health, non authentifié, pour les deux sondes. La sonde de démarrage accorde une marge d'échecs généreuse pour tolérer l'indexation de la bibliothèque au premier démarrage. - Seul le répertoire d'état de Kavita est persisté par ce module. Le contenu
réel de la bibliothèque (bandes dessinées, mangas, livres numériques) n'est pas
provisionné ici — ajoutez vos propres
gcs_volumes(ou NFS) pour ce contenu et enregistrez-le comme bibliothèque dans l'interface de Kavita après le déploiement.
2. Services Google Cloud et comment les explorer
Toutes les commandes supposent que PROJECT et REGION sont définis. Les noms
des services et des ressources sont indiqués dans les Sorties du
déploiement.
A. Cloud Run — le service Kavita
Kavita s'exécute comme un unique service Cloud Run v2. Comme il s'agit d'une
application SQLite à écrivain unique adossée à un volume monté via gcsfuse,
n'augmentez pas max_instance_count au-delà de 1.
- Console : Cloud Run → sélectionnez le service pour consulter les révisions, le trafic, les journaux et les métriques.
- CLI :
gcloud run services list --project "$PROJECT" --region "$REGION"
gcloud run services describe <service-name> --project "$PROJECT" --region "$REGION"
gcloud run revisions list --service <service-name> --project "$PROJECT" --region "$REGION"
Consultez App_CloudRun pour la mise à l'échelle, la concurrence, l'environnement d'exécution et la répartition du trafic.
B. Cloud Storage — le bucket de configuration et d'état de la bibliothèque monté via GCS Fuse
Kavita_Common provisionne un unique bucket Cloud Storage (suffixe storage) et
ce module le monte sur /kavita/config via GCS Fuse. Il contient la base de
données SQLite de Kavita (kavita.db), les images de couverture, les signets, les
sauvegardes et les journaux — en pratique, tout l'état durable de Kavita. Des
buckets supplémentaires peuvent être déclarés via storage_buckets, et des
montages de contenu supplémentaires en lecture seule via gcs_volumes.
- Console : Cloud Storage → Buckets.
- CLI :
gcloud storage buckets list --project "$PROJECT" --filter="name~kavita"
gcloud storage ls gs://<config-bucket>/        # bucket name is in the Outputs
Consultez App_CloudRun pour les options de montage GCS Fuse et CMEK.
C. Secret Manager
Kavita n'a aucun secret généré — ce module ne crée ni mot de passe
administrateur, ni clé d'API, ni clé de signature. La clé de signature JWT propre
à Kavita (TokenKey) est générée automatiquement par l'application au premier
démarrage et persistée sur le volume /kavita/config monté via gcsfuse, et non
dans Secret Manager. Les secrets que vous ajoutez vous-même via
secret_environment_variables transitent par Secret Manager comme pour tout
autre module d'application.
- Console : Security → Secret Manager.
- CLI :
gcloud secrets list --project "$PROJECT" --filter="name~kavita"
Consultez App_CloudRun pour les détails d'injection et de rotation.
D. Réseau et entrée
Le service est accessible par défaut à son URL run.app (ingress_settings = "all"), ce qui permet aux navigateurs, aux applications de lecture mobiles et aux
clients OPDS de l'atteindre directement. Un équilibreur de charge HTTPS externe
avec domaine personnalisé, Cloud CDN et Cloud Armor peut être ajouté ; les
paramètres d'entrée et la sortie VPC contrôlent la connectivité.
- Console : Cloud Run (URL du service) ; Network services → Load balancing.
- CLI :
gcloud run services describe <service-name> --region "$REGION" --format='value(status.url)'
gcloud compute addresses list --project "$PROJECT"
Consultez App_CloudRun.
E. Cloud Logging et Monitoring
Les journaux des conteneurs sont envoyés vers Cloud Logging ; les métriques Cloud Run vers Cloud Monitoring, avec des tests de disponibilité et des règles d'alerte facultatifs.
- Console : Logging → Logs Explorer ; Monitoring → Dashboards / Alerting.
- CLI :
gcloud run services logs read <service-name> --project "$PROJECT" --region "$REGION" --limit 50
3. Comportement de l'application Kavita
- Aucune initialisation de base de données au premier déploiement. Kavita n'a
pas de job
db-init— il n'y a aucune base de données externe à amorcer.initialization_jobsest par défaut une liste vide ; seuls les jobs personnalisés que vous fournissez sont exécutés. - Aucune étape de migration. Kavita crée et migre lui-même son schéma SQLite
interne au premier démarrage ; la mise à niveau d'
application_version(suivie d'une reconstruction) applique automatiquement les modifications de schéma sans job de migration distinct. - Aucun secret immuable généré automatiquement. Contrairement à la plupart
des modules d'application, aucune clé de chiffrement, aucun jeton
administrateur ni secret JWT n'est créé dans Secret Manager. Le
TokenKeyJWT propre à Kavita est généré en interne au premier démarrage et persisté sur le volume/kavita/config— rien à faire tourner ni à perdre de vue au niveau de la couche Terraform. - Chemin de santé. Les sondes de démarrage et d'activité ciblent toutes deux
le point de terminaison public et non authentifié
/api/health. La sonde de démarrage utilise une marge d'échecs plus large (initial_delay_seconds = 15,period_seconds = 10,failure_threshold = 10) pour tolérer une indexation de la bibliothèque plus lente au premier démarrage, avant que la sonde de vivacité (initial_delay_seconds = 30,period_seconds = 30,failure_threshold = 3) prenne le relais. - Inscription / comportement au premier lancement. Il n'existe ni compte administrateur pré-créé ni identifiant généré. Ouvrez l'URL du service : l'assistant de configuration du premier lancement de Kavita vous guide dans la création du compte administrateur initial et l'ajout de votre première bibliothèque. Effectuez cette étape rapidement après le déploiement : tant qu'elle n'a pas été réalisée, le service est accessible mais non revendiqué.
- Redis est désactivé de force.
main.tfdéfinitenable_redis = falsesans condition lors de l'appel àApp_CloudRun, ce qui remplace la valeur par défautenable_redis = truedu socle — aucunREDIS_HOST/REDIS_PORTn'est jamais injecté, et les variablesredis_host/redis_port/redis_authn'ont aucun effet. enable_cloudsql_volumeest fixé à désactivé.main.tftransmet directementenable_cloudsql_volume = falseau socle quelle que soit la variable (dont la valeur par défaut est d'ailleurs aussifalse) — Kavita n'a pas de conteneur annexe Cloud SQL Auth Proxy.- Build d'image personnalisé. Le conteneur est construit à partir d'un
Dockerfile qui est une fine surcouche (
FROM jvmilazz0/kavita:${KAVITA_VERSION}) ;application_version = "latest"se résout en l'argument de build épingléKAVITA_VERSION = 0.8.7(changer de version impose de modifier la valeur épinglée dansKavita_Common, puis de reconstruire — voir la convention du dépôt sur les « images de base au tag latest »). - Inspecter le service et son état monté :
gcloud run services describe <service-name> \
  --region "$REGION" --project "$PROJECT" \
  --format='value(status.url)'
gcloud run jobs list --project "$PROJECT" --region "$REGION"
gcloud run jobs executions list --job <job-name> --project "$PROJECT" --region "$REGION"
4. Variables de configuration
Les variables sont regroupées exactement comme elles apparaissent sur la plateforme de déploiement. Seuls les paramètres propres à Kavita ou notables pour lui sont listés ; toutes les autres entrées sont héritées de App_CloudRun avec leur comportement standard.
Groupe 1 — Projet et identité
| Variable | Valeur par défaut | Description |
|---|---|---|
project_id | (obligatoire) | Projet Google Cloud cible. |
region | us-central1 | Région du service et des ressources régionales. |
Groupe 2 — Environnement de déploiement
| Variable | Valeur par défaut | Description |
|---|---|---|
tenant_id | demo | Suffixe court qui rend les noms de ressources uniques pour chaque environnement. |
support_users | [] | Adresses e-mail auxquelles sont accordés l'accès au projet et les alertes de surveillance. |
resource_labels | {} | Libellés appliqués à toutes les ressources. |
Groupe 3 — Identité de l'application
| Variable | Valeur par défaut | Description |
|---|---|---|
application_name | kavita | Nom de base des ressources. Ne le modifiez pas après le premier déploiement. |
application_display_name | Kavita | Nom lisible affiché dans la console. |
description | Kavita — self-hosted comics, manga and ebook server (.NET, SQLite) | Description du service. |
application_version | latest | Tag de l'image Kavita ; latest se résout en l'argument de build épinglé KAVITA_VERSION = 0.8.7 dans Kavita_Common. |
Groupe 4 — Exécution et mise à l'échelle
| Variable | Valeur par défaut | Description |
|---|---|---|
deploy_application | true | Définissez false pour provisionner uniquement l'infrastructure. |
cpu_limit | 1000m | CPU par instance ; Kavita est un serveur .NET léger. |
memory_limit | 1Gi | Mémoire par instance ; suffisante pour de grandes bibliothèques. |
min_instance_count | 1 | Maintenu à 1 par défaut pour éviter les démarrages à froid pendant le chargement de l'index de la bibliothèque — la plupart des modules Cloud Run utilisent 0 par défaut. |
max_instance_count | 1 | Laissez à 1. Pas de clustering — une seconde instance écrivant dans le même fichier SQLite monté via gcsfuse risque de le corrompre. |
container_port | 5000 | Port HTTP fixe de Kavita. |
execution_environment | gen2 | Requis pour le montage GCS Fuse. |
timeout_seconds | 300 | Durée maximale d'une requête (0 à 3600 secondes). |
enable_cloudsql_volume | false | Kavita n'utilise pas Cloud SQL ; la valeur est aussi codée en dur à false dans main.tf, quelle que soit celle-ci. |
enable_image_mirroring | true | Met en miroir l'image Kavita dans Artifact Registry. |
container_protocol | http1 | HTTP/1.1 suffit ; Kavita n'a aucun usage gRPC justifiant h2c. |
traffic_split | [] | Répartit le trafic entre les révisions pour des déploiements progressifs. |
max_revisions_to_retain | 7 | Déclarée par souci de cohérence avec la convention ; non référencée par le déploiement de ce module. |
service_annotations / service_labels | {} | Annotations/libellés personnalisés sur la ressource de service Cloud Run. |
Groupe 5 — Contrôle d'accès et d'entrée
| Variable | Valeur par défaut | Description |
|---|---|---|
ingress_settings | all | Accès public pour l'interface de lecture, les flux OPDS et les applications clientes de lecture. |
vpc_egress_setting | PRIVATE_RANGES_ONLY | N'achemine via le VPC que le trafic RFC 1918. |
enable_iap | false | Exige une connexion Google. Les clients OPDS et les applications de lecture mobiles ne peuvent généralement pas mener à bien le flux d'authentification d'IAP. |
iap_authorized_users / iap_authorized_groups | [] | Qui peut accéder via IAP. |
Groupe 6 — Variables d'environnement et secrets
| Variable | Valeur par défaut | Description |
|---|---|---|
environment_variables | {} | Paramètres supplémentaires non secrets ; Kavita n'en a besoin d'aucun par défaut. |
secret_environment_variables | {} | Correspondance variable d'environnement → nom du secret Secret Manager. |
secret_propagation_delay | 30 | Nombre de secondes d'attente après la création d'un secret avant de poursuivre. |
secret_rotation_period | 2592000s | Fréquence des notifications de rotation de Secret Manager — pertinente uniquement pour les secrets que vous ajoutez vous-même ; Kavita n'en crée aucun. |
Groupe 7 — Sauvegarde et restauration
| Variable | Valeur par défaut | Description |
|---|---|---|
backup_schedule | 0 2 * * * | Expression cron de la sauvegarde automatique (UTC). |
backup_retention_days | 7 | Durée de conservation ; augmentez-la pour la production. |
enable_backup_import / backup_source / backup_uri / backup_format | options de restauration | Restaure /kavita/config à partir d'une sauvegarde lors du déploiement — Kavita n'a pas de dump de base de données distinct ; son état est le répertoire de configuration lui-même. |
Groupe 8 — CI/CD et Binary Authorization
Intégration standard Cloud Build / Cloud Deploy d'App_CloudRun — voir
App_CloudRun. Entrées principales : enable_cicd_trigger,
github_repository_url, github_token, enable_cloud_deploy,
enable_binary_authorization.
Groupe 9 — Scripts SQL personnalisés et découverte d'instance NFS
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_custom_sql_scripts | false | Sans objet — Kavita n'a pas de base de données SQL. |
custom_sql_scripts_bucket / custom_sql_scripts_path / custom_sql_scripts_use_root | — | Sans objet. |
nfs_instance_name / nfs_instance_base_name | "" / app-nfs | Pertinent uniquement si vous ajoutez un montage NFS pour un contenu de bibliothèque distinct ; inutilisé par défaut. |
Groupe 10 — Cloud Armor, CDN et rétention des images
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_cloud_armor | false | Provisionne un équilibreur de charge HTTPS global et le WAF Cloud Armor. |
admin_ip_ranges | [] | Plages CIDR exemptées des règles WAF. |
application_domains | [] | Noms de domaine personnalisés pour l'équilibreur de charge HTTPS. |
enable_cdn | false | Active Cloud CDN sur le backend de l'équilibreur de charge HTTPS. |
max_images_to_retain / delete_untagged_images / image_retention_days | (définies) | Règle de nettoyage d'Artifact Registry. |
Groupe 11 — Stockage et système de fichiers
| Variable | Valeur par défaut | Description |
|---|---|---|
create_cloud_storage | true | Crée le bucket storage provisionné automatiquement (monté sur /kavita/config) ainsi que les éventuels storage_buckets. |
storage_buckets | [] | Buckets GCS supplémentaires en plus du bucket de configuration provisionné automatiquement. |
enable_nfs | false | Désactivé par défaut ; activez-le uniquement pour monter un contenu de bibliothèque distinct via NFS. |
nfs_mount_path | /mnt/nfs | Chemin de montage de ce partage NFS (distinct de /kavita/config). |
gcs_volumes | [] | Montages de volumes GCS Fuse supplémentaires — par exemple un bucket en lecture seule contenant le contenu de la bibliothèque. |
manage_storage_kms_iam / enable_artifact_registry_cmek | false | Options CMEK. |
enable_redis / redis_host / redis_port / redis_auth | inertes | Déclarées uniquement pour refléter les variables du socle — main.tf code en dur enable_redis = false sans condition ; Kavita n'utilise jamais Redis, quelles que soient ces valeurs. |
Groupe 12 — Backend de base de données (sans objet)
| Variable | Valeur par défaut | Description |
|---|---|---|
database_type | NONE | Fixé par Kavita_Common — Kavita stocke tout dans un fichier SQLite interne ; aucune instance Cloud SQL n'est créée. |
database_password_length | 32 | Non référencée — Kavita n'a pas de base de données SQL. |
Toutes les autres variables liées à la base de données de ce groupe
(sql_instance_name, application_database_name/_user,
enable_mysql_plugins, enable_postgres_extensions, l'ensemble
db_*_env_var_name, enable_auto_password_rotation, etc.) sont déclarées
uniquement pour refléter les variables du socle et n'ont aucun effet sur un
déploiement Kavita.
Groupe 13 — Jobs et tâches planifiées
| Variable | Valeur par défaut | Description |
|---|---|---|
initialization_jobs | [] | Laissez vide — Kavita n'a pas de job db-init ni de migration ; il gère lui-même son schéma SQLite au premier démarrage. |
cron_jobs | [] | Inutilisé par défaut ; ajoutez au besoin des tâches planifiées personnalisées (par exemple des instantanés de collections). |
Groupe 14 — Observabilité et santé
| Variable | Valeur par défaut | Description |
|---|---|---|
startup_probe | HTTP /api/health, délai de 15 s | Sonde de démarrage ; la marge de 10 tentatives tolère l'indexation de la bibliothèque au premier démarrage. |
liveness_probe | HTTP /api/health, délai de 30 s | Sonde de vivacité. |
startup_probe_config / health_check_config | variante désactivée / HTTP /api/health | Sondes structurées alternatives (inactives par défaut ; ce sont startup_probe/liveness_probe qui s'appliquent). |
uptime_check_config | { enabled=false, path="/api/health" } | Test de disponibilité Cloud Monitoring ; désactivé par défaut. |
alert_policies | [] | Règles d'alerte sur les métriques. |
Groupe 15 — Réseau
| Variable | Valeur par défaut | Description |
|---|---|---|
network_name | "" | Déclarée par souci de cohérence avec la convention ; non transmise à App_CloudRun par ce module — le réseau VPC est découvert automatiquement à la place. |
Groupe 23 — VPC Service Controls et journalisation d'audit
| Variable | Valeur par défaut | Description |
|---|---|---|
enable_vpc_sc | false | Applique un périmètre VPC-SC (nécessite organization_id). |
vpc_cidr_ranges / vpc_sc_dry_run | (définies) | CIDR du niveau d'accès / mode simulation (dry-run). |
enable_audit_logging | false | Journaux Cloud Audit Logs détaillés. |
5. Sorties
Renvoyées après un déploiement réussi — le moyen le plus rapide de localiser et d'explorer les ressources en cours d'exécution.
| Sortie | Description |
|---|---|
service_name | Nom du service Cloud Run. |
kavita_url | URL VPC interne du service Kavita (port 5000) ; accessible uniquement depuis le VPC lorsque ingress_settings = "internal". |
service_location | Région dans laquelle s'exécute le service. |
stage_services | URL des services propres à chaque étape (Cloud Deploy). |
load_balancer_ip / load_balancer_url | IP / URL de l'équilibreur de charge HTTPS externe (lorsqu'il est activé). |
storage_buckets | Buckets Cloud Storage créés, y compris le bucket storage monté sur /kavita/config. |
network_name / network_exists / regions | Réseau VPC, présence, régions. |
container_image / container_registry | Image déployée et dépôt Artifact Registry. |
monitoring_enabled / monitoring_notification_channels / uptime_check_names | État de la surveillance, canaux, tests de disponibilité. |
initialization_jobs | Noms des éventuels jobs d'initialisation personnalisés que vous avez fournis (aucun par défaut). |
deployment_id / tenant_id / resource_prefix | Identifiants de nommage. |
project_id / project_number | Identifiants du projet. |
cicd_enabled / github_repository_url / github_repository_owner / github_repository_name / cicd_configuration | État et détails du CI/CD. |
artifact_registry_repository / cloudbuild_trigger_name / cloudbuild_trigger_id | Dépôt et déclencheur de build. |
vpc_sc_enabled / vpc_sc_perimeter_name / vpc_sc_dry_run_mode | État de VPC-SC. |
audit_logging_enabled / artifact_registry_cmek_enabled | État des journaux d'audit et de CMEK. |
Notez qu'il n'existe aucune sortie database_* — Kavita ne provisionne aucune
instance Cloud SQL.
6. Pièges de configuration et valeurs par défaut judicieuses
Risque : Critique (perte de données / panne / sécurité) — Élevé (service dégradé) — Moyen (coût ou dégradation partielle) — Faible (mineur).
Validation héritée au moment du plan. Ce module transmet sa configuration au moteur du socle App_CloudRun, qui valide les valeurs et leurs combinaisons au moment du plan — un réplica en lecture sans son instance principale, IAP sans identités autorisées, un environnement d'exécution
gen1avec un montage GCS Fuse, unredis_port/backup_retention_dayshors plage. Une configuration invalide fait échouer le plan avec une erreur claire et nommée avant la création de toute ressource ; la plupart des erreurs ci-dessous sont donc détectées en amont plutôt qu'à l'apply ou à l'exécution.
| Paramètre | Valeur judicieuse | Risque | Conséquence en cas d'erreur |
|---|---|---|---|
/kavita/config sur GCS Fuse | À n'accepter que pour les bibliothèques de petite ou moyenne taille | Critique | GCS Fuse est la seule option de persistance de Cloud Run ; les écritures concurrentes ou les analyses intensives de métadonnées sur un fichier SQLite adossé à gcsfuse risquent de corrompre l'index de la bibliothèque. Pour les grandes bibliothèques, utilisez plutôt le PVC bloc de Kavita_GKE. |
max_instance_count | 1 | Critique | Kavita n'offre pas de clustering ; une seconde instance écrivant dans le même fichier SQLite monté via gcsfuse corrompt l'index de la bibliothèque ainsi que les données des administrateurs et des utilisateurs. |
| Stockage du contenu de la bibliothèque | Ajoutez des gcs_volumes (ou NFS) distincts de /kavita/config | Élevé | Kavita_Common ne persiste que le répertoire d'état de configuration/SQLite — sans montage distinct pour les fichiers réels de bandes dessinées, mangas et livres numériques, il n'existe aucun emplacement durable pour stocker le contenu de la bibliothèque lui-même. |
enable_iap | false, sauf si tous les clients le prennent en charge | Élevé | Le flux OPDS de Kavita et les applications de lecture mobiles ne peuvent généralement pas mener à bien le flux d'authentification de Google IAP ; activer IAP casse donc l'accès depuis les liseuses, même si l'interface du navigateur continue de fonctionner grâce à une vérification dans le navigateur. |
ingress_settings | all | Élevé | internal empêche l'interface de lecture et les clients OPDS d'atteindre directement le service. |
| Compte administrateur du premier lancement | Terminez l'assistant de configuration immédiatement après le déploiement | Moyen | Tant que l'assistant n'a pas été exécuté, le service est accessible mais non revendiqué — la première personne qui atteint l'URL peut créer le compte administrateur initial. |
application_version / KAVITA_VERSION | Épinglez explicitement la version en production | Moyen | "latest" se résout en la valeur épinglée KAVITA_VERSION = 0.8.7 de Kavita_Common ; changer de version impose de modifier cette valeur épinglée et de reconstruire l'image, pas seulement de redéployer. |
min_instance_count | 1 (valeur par défaut) | Moyen | La valeur 0 active la mise à l'échelle à zéro mais ajoute une latence de démarrage à froid pendant que gcsfuse remonte le volume et que Kavita recharge l'index de sa bibliothèque. |
enable_redis (inerte) | laissez tel quel | Faible | Définir cette variable n'a aucun effet — main.tf code en dur enable_redis = false quelle que soit la valeur transmise. |
enable_cloudsql_volume | false | Faible | Kavita n'utilise jamais Cloud SQL ; la valeur est codée en dur à false dans main.tf quel que soit ce paramètre. |
backup_retention_days | 7 (à augmenter en production) | Moyen | Trop court pour une conservation réglementaire ; tout l'état de Kavita réside dans le répertoire /kavita/config, si bien que c'est l'unique voie de sauvegarde. |
Pour le comportement du socle auquel ce guide fait référence — identité du
service, mise à l'échelle et concurrence, entrée et équilibrage de charge, CI/CD,
Cloud Armor, IAP, Binary Authorization, VPC-SC, sauvegardes et mise en miroir des
images — consultez App_CloudRun. La configuration propre à
l'application Kavita partagée avec la variante GKE — notamment pourquoi elle n'a
ni secrets générés ni base de données, et comment le répertoire d'état
/kavita/config est monté différemment sur chaque plateforme (GCS Fuse ici,
contre un PVC bloc sur GKE) — est décrite dans
Kavita_Common.
Guides associés
- Lab pratique : Kavita sur Cloud Run — déployez-le pas à pas, avec les écrans de la console et les commandes à chaque étape.
- Kavita sur GKE Autopilot — la même application sur Kubernetes, lorsque vous avez besoin de l'autre cible de déploiement.
- Kavita Common — Configuration applicative partagée — la configuration partagée par les deux cibles de déploiement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.