Guide de préparation à la certification ACE : Section 3 — Garantir le bon fonctionnement d'une solution cloud (Ensuring the successful operation of a cloud solution) (~30 % de l'examen)
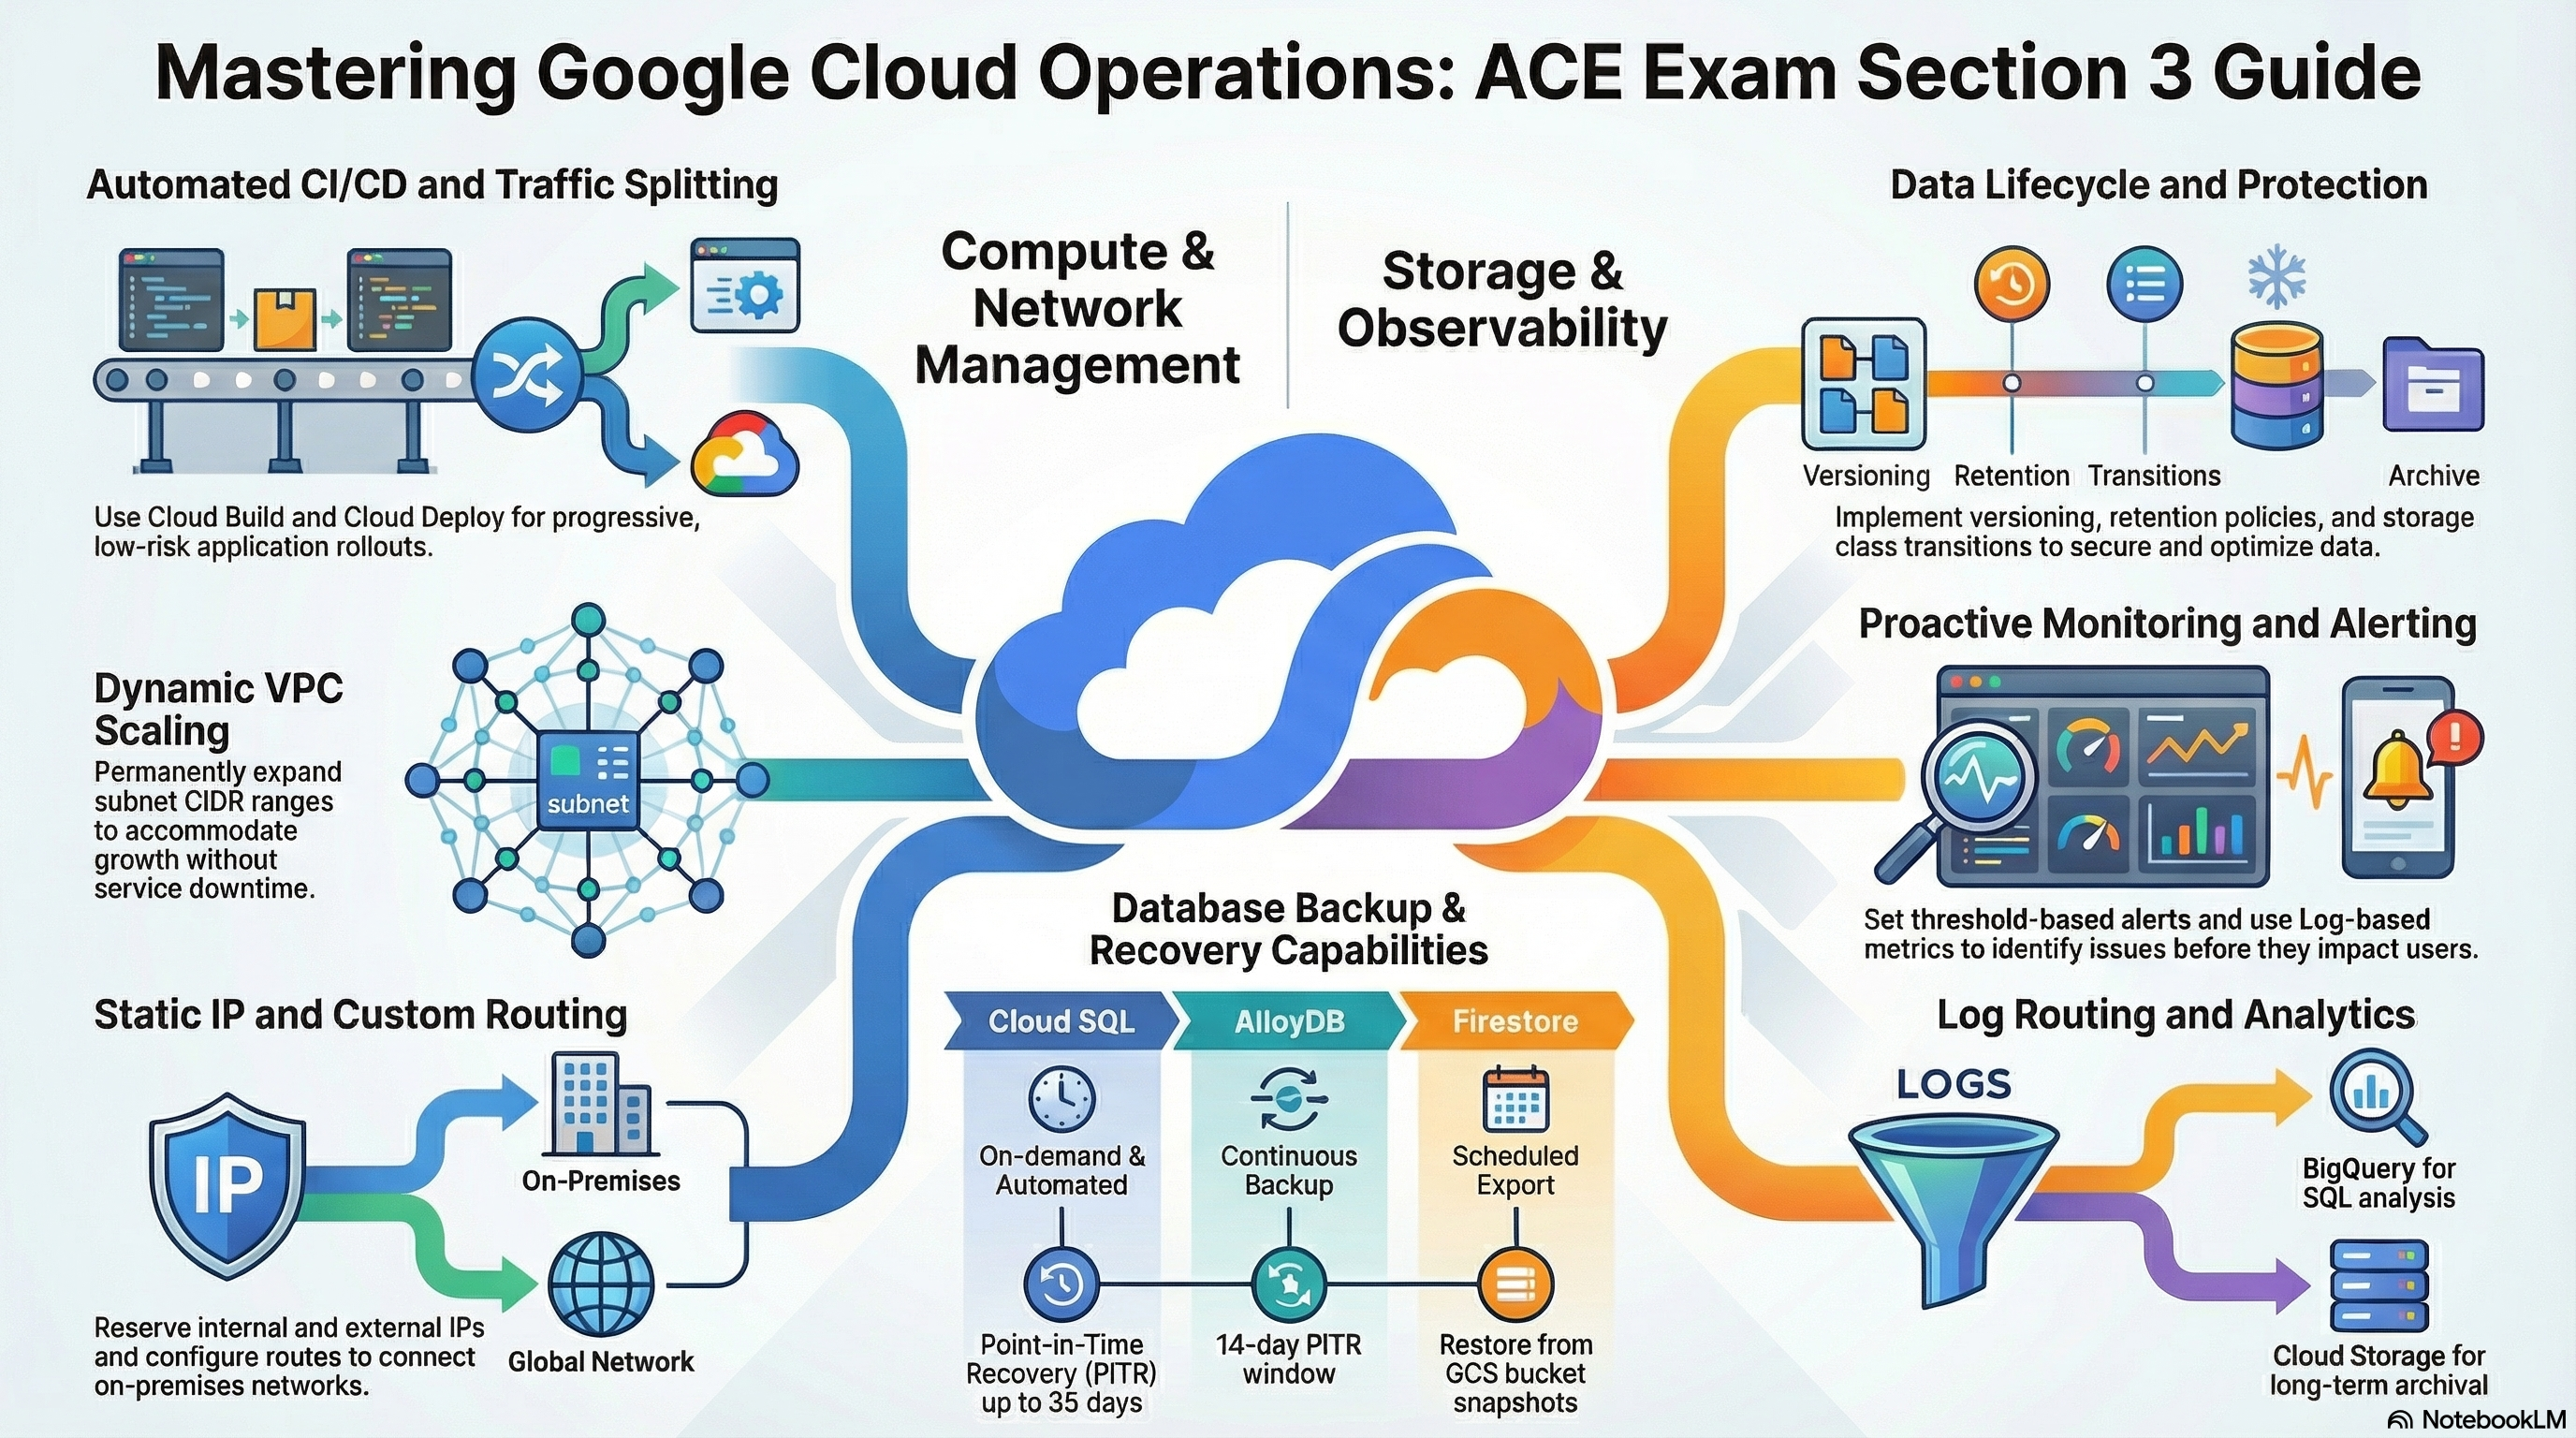
📚 Guide officiel de l'examen : certification Associate Cloud Engineer — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Ce guide couvre la Section 3 de l'examen — l'exploitation au quotidien (day-2) — à l'aide des modules de base de la plateforme RAD. App_CloudRun et App_GKE en assurent l'essentiel (révisions, trafic, CI/CD, sauvegardes, alertes) ; Services_GCP fournit les alertes d'infrastructure et la journalisation d'audit. Déployez le profil application serverless (ainsi que le profil application Kubernetes pour les labs kubectl et le profil compléments d'exploitation et de sécurité pour la 3.4) de la cartographie des labs.
3.1 Gestion des ressources de calcul (Managing compute resources)
⏱ ~90 min · 💰 faible ; chaque étape Cloud Deploy exécute son propre service — supprimez-les après le lab · ⚙️ Prérequis : profil application serverless ;
enable_cicd_trigger+ un dépôt GitHub pour le lab CI/CD
Pourquoi l'examen s'y intéresse — Exploiter des ressources de calcul, c'est déployer de nouvelles versions en toute sécurité (canary/blue-green via la répartition du trafic), mettre à l'échelle manuellement et automatiquement, et travailler sur un cluster Kubernetes en ligne de commande (kubectl get/describe/logs/scale). Attendez-vous à des questions sur le transfert du trafic Cloud Run entre révisions et sur le diagnostic des pods. Le guide actuel mentionne aussi l'inventaire GKE, les pools de nœuds, l'autoscaling horizontal et vertical des pods, les requêtes de ressources des pods Autopilot, l'accès de GKE à Artifact Registry, l'autoscaling Cloud Run, la répartition du trafic sur Cloud Run, Cloud Run functions et GKE, l'association de GPU/TPU, le déploiement d'un agent sur Agent Runtime dans Gemini Enterprise Agent Platform (anciennement Vertex AI Agent Engine), la gestion des notebooks dans Gemini Enterprise Agent Platform Workbench (anciennement Vertex AI Workbench) et dans BigQuery, ainsi que les environnements de développement comme Cloud Workstations.
Comment RAD le met en œuvre —
Révisions et trafic (Cloud Run) : chaque mise à jour depuis le portail crée une nouvelle révision ; max_revisions_to_retain (par défaut 7) élague les anciennes révisions qui ne servent plus de trafic. traffic_split (par défaut [] = 100 % vers la dernière révision) accepte une liste d'entrées { type, revision, percent, tag } dont la somme doit être exactement 100 (vérifié au moment du plan), par ex. 90 % TRAFFIC_TARGET_ALLOCATION_TYPE_LATEST / 10 % vers une révision nommée — un déploiement canary déclaratif.
CI/CD : enable_cicd_trigger (par défaut false), avec github_repository_url et github_token, crée un déclencheur Cloud Build (cicd_trigger_config.branch_pattern par défaut "^main$") qui construit l'image avec Kaniko, la pousse vers Artifact Registry, puis soit met directement à jour le service, soit — lorsque enable_cloud_deploy = true — crée une release Cloud Deploy via cloud_deploy_stages (par défaut dev → staging → prod, avec require_approval = true sur prod). Notez que enable_cloud_deploy = true sans enable_cicd_trigger = true est rejeté au moment du plan — les releases Cloud Deploy ne proviennent que du pipeline CI/CD.
Opérations Kubernetes (App_GKE) : le HPA s'étend de min_instance_count (par défaut 1) à max_instance_count (par défaut 3) ; enable_pod_disruption_budget (par défaut true) crée un PDB avec pdb_min_available (par défaut "1", ignoré lorsque max_instance_count = 1) ; enable_resource_quota (par défaut false) plafonne le namespace à quota_cpu_requests/quota_cpu_limits (par défaut "4"), quota_memory_requests (par défaut "4Gi") / quota_memory_limits (par défaut "8Gi") — les valeurs de mémoire doivent porter un suffixe binaire (Gi/Mi), ce qu'impose une validation au moment du plan, car Kubernetes interprète un "4" nu comme 4 octets, ce qui bloquerait toute planification de pods. cron_jobs déploie des CronJobs Kubernetes. enable_vertical_pod_autoscaling (par défaut false) ajoute un VPA à côté du HPA, et container_resources est transformé en requêtes de pods, sur lesquelles Autopilot s'appuie pour la planification et la facturation.
Accès à Artifact Registry : les images résident dans l'Artifact Registry du projet (les images publiques y sont copiées par enable_image_mirroring, par défaut true), et le compte de service des nœuds GKE gke-sa-{prefix} détient roles/artifactregistry.reader, ce qui est tout ce dont un cluster a besoin pour tirer des images d'un dépôt du même projet.
Opérations Compute Engine : la VM NFS de Services_GCP s'exécute dans un MIG avec des vérifications d'état assurant la réparation automatique et une planification d'instantanés quotidiens avec conservation de 7 jours — un exemple concret de protection de VM par instantanés.
Essayez
- Déployez une modification visible (par ex. définissez une variable d'environnement dans
environment_variables), puis répartissez le trafic dans le portail :traffic_split = [{ type = "TRAFFIC_TARGET_ALLOCATION_TYPE_LATEST", percent = 90 }, { type = "TRAFFIC_TARGET_ALLOCATION_TYPE_REVISION", revision = "<service>-0000X", percent = 10, tag = "previous" }]. Vérifiez, puis entraînez-vous sur l'équivalent impératif évalué par l'examen :gcloud run revisions list --service=<service-name> --region=us-central1
gcloud run services update-traffic <service-name> --region=us-central1 \
--to-revisions=<service>-0000X=10,LATEST=90
gcloud run services describe <service-name> --region=us-central1 --format="yaml(status.traffic)" - Sur GKE, exercez-vous sur la boucle
kubectlessentielle :gcloud container clusters get-credentials gke-cluster-1 --region=us-central1
kubectl get pods -n <namespace> -o wide
kubectl describe pod <pod-name> -n <namespace>
kubectl logs <pod-name> -n <namespace> --tail=50
kubectl scale deployment <name> -n <namespace> --replicas=3 # HPA will reconcile this
kubectl get pdb,resourcequota -n <namespace> - Avec la CI/CD activée, poussez un commit sur
mainet observez :gcloud builds list --limit=3, puis Cloud Deploy > Delivery pipelines pour promouvoir dev → staging et approuver prod (gcloud deploy rollouts approve ...en est la forme en ligne de commande). - Vous savez que cela a fonctionné lorsque
status.trafficaffiche votre répartition 90/10 et que la révision taguée est servie sur sa propre URL de tag.
Testez-vous
Q1 : Cinq minutes après une release, le taux d'erreurs grimpe sur la nouvelle révision Cloud Run. Quel est le retour arrière le plus rapide ?
R : gcloud run services update-traffic <service> --to-revisions=<previous-revision>=100. Les révisions sont immuables : la précédente est donc toujours déployée et prête — transférer le trafic est instantané et ne nécessite ni nouveau build ni redéploiement. C'est exactement ce que traffic_split déclare sous forme Terraform.
Q2 : Vous exécutez kubectl scale deployment app --replicas=10, mais le nombre de pods redescend à 3. Pourquoi ?
R : Un HorizontalPodAutoscaler contrôle le nombre de réplicas (le module en crée un allant de min_instance_count à max_instance_count, maximum par défaut 3). Le HPA ramène toute mise à l'échelle manuelle dans ses bornes ; pour monter plus haut, augmentez max_instance_count (ou modifiez/supprimez le HPA), pas le Deployment.
Q3 : Pendant une maintenance du cluster, pourquoi au moins un pod de l'application reste-t-il toujours actif ?
R : enable_pod_disruption_budget (true par défaut) crée un PDB avec minAvailable: 1, si bien que les interruptions volontaires (drainage de nœuds, mises à niveau) ne peuvent pas évincer le dernier pod disponible. Notez qu'il ne protège pas contre les défaillances involontaires comme le plantage d'un nœud.
Au-delà des modules — Les flux de travail SSH sur les VM ne font pas partie des modules applicatifs : entraînez-vous avec gcloud compute ssh <vm> --tunnel-through-iap (la règle fw-allow-iap-ssh du module pour 35.235.240.0/20 l'autorise déjà vers la VM NFS), gcloud compute instances list --filter="status=RUNNING", les instantanés à la demande (gcloud compute disks snapshot), la création d'images à partir de disques et les mises à jour progressives de MIG (gcloud compute instance-groups managed rolling-action start-update). Étudiez aussi les commandes d'ajout, de redimensionnement, d'autoscaling et de suppression de pools de nœuds GKE Standard (gcloud container node-pools create|update --enable-autoscaling|delete), qu'Autopilot masque. Et, sans qu'aucun ne soit abordé par les modules : la répartition du trafic sur GKE (backendRefs pondérés dans une HTTPRoute de la Gateway API) et sur Cloud Run functions (gcloud run services update-traffic, puisqu'elles s'exécutent sur Cloud Run) ; l'association de GPU (gcloud compute instances create --accelerator=type=nvidia-l4,count=1, pools de nœuds GPU GKE ou nodeSelector Autopilot, services Cloud Run avec GPU) et de TPU (VM TPU, pools de nœuds TPU GKE) ; le déploiement d'un agent sur Agent Runtime depuis l'ADK ou le SDK Agent Platform ; la création et l'arrêt d'instances Workbench et l'exécution de notebooks dans BigQuery Studio ; ainsi que les configurations Cloud Workstations et les postes de travail en tant qu'environnements de développement gérés et contrôlés par IAM.
⚠️ Piège d'examen — gcloud run deploy envoie toujours 100 % du trafic vers la nouvelle révision, sauf si le service avait auparavant été placé en contrôle manuel du trafic (--no-traffic / répartitions explicites). Si une question dit « déployer sans servir de trafic », la réponse fait intervenir --no-traffic et les tags, à l'image du champ tag de traffic_split ici.
3.2 Gestion des solutions de stockage et de données (Managing storage and data solutions)
⏱ ~60 min · 💰 négligeable (stockage du bucket de sauvegarde) · ⚙️ Prérequis : profil application serverless avec une base de données (
database_type≠NONE)
Pourquoi l'examen s'y intéresse — Le travail quotidien sur les données : exécuter et restaurer des sauvegardes, comprendre la différence entre PITR et restauration depuis un instantané, gérer le cycle de vie des objets et se connecter aux bases de données pour exécuter des requêtes. Les mises en situation vérifient généralement que vous savez quel mécanisme de récupération convient à un RPO donné, et comment réduire automatiquement les coûts de stockage. Le guide actuel couvre aussi l'estimation des coûts de stockage, la consultation de l'état des jobs Dataflow et BigQuery, la sauvegarde de Firestore, Spanner, AlloyDB et Bigtable en plus de Cloud SQL, la gestion du parc de bases de données depuis Database Center et la configuration de clés de chiffrement gérées par le client (CMEK).
Comment RAD le met en œuvre — App_CloudRun/App_GKE provisionnent un pipeline automatisé de sauvegarde logique : un job Cloud Scheduler déclenche un job Cloud Run qui exécute l'export de sauvegarde selon backup_schedule (par défaut "0 2 * * *" UTC), en vidant la base de données de l'application dans un bucket GCS de sauvegarde dédié, dont la règle de cycle de vie supprime les objets plus anciens que backup_retention_days (par défaut 7). Les restaurations sont prises en charge nativement : enable_backup_import (par défaut false), avec backup_source (gcs ou gdrive), backup_file et backup_format, exécute un job d'import ponctuel. enable_custom_sql_scripts (par défaut false) exécute les fichiers .sql de custom_sql_scripts_bucket/custom_sql_scripts_path dans l'ordre lexicographique (un chemin non vide est exigé au moment du plan), éventuellement en tant qu'utilisateur root de la base de données.
Indépendamment de ces dumps logiques, l'instance Cloud SQL conserve elle-même 7 sauvegardes quotidiennes automatiques (04:00 UTC), avec le PITR activé et une conservation des journaux de transactions de 7 jours. La bonne hygiène des buckets est illustrée par la couche de stockage d'objets de la plateforme : versioning_enabled par bucket, lifecycle_rules (âge, nombre de versions plus récentes, transitions de classe de stockage), règle de suppression réversible (soft delete) et public_access_prevention (par défaut enforced).
CMEK : enable_cmek de Services_GCP (par défaut false) crée un trousseau de clés Cloud KMS et des clés (soumises à une rotation tous les cmek_key_rotation_period, par défaut "7776000s" = 90 jours) et accorde à l'agent de service géré par Google de chaque produit le rôle roles/cloudkms.cryptoKeyEncrypterDecrypter, afin que Cloud SQL, AlloyDB, Artifact Registry et Cloud Storage puissent chiffrer avec votre clé. Définissez-le uniquement lors du premier déploiement : la clé d'une ressource est fixée à sa création, si bien que l'activer plus tard remplace l'instance Cloud SQL (et ses données) ainsi que le dépôt Artifact Registry.
Essayez
- Déclenchez une sauvegarde tout de suite, au lieu d'attendre la planification :
gcloud scheduler jobs list --location=us-central1
gcloud scheduler jobs run <backup-job-name> --location=us-central1
gcloud run jobs executions list --region=us-central1 --limit=3
gcloud storage ls -l gs://<backup-bucket>/ - Inspectez la partie sauvegardes gérées :
gcloud sql backups list --instance=<instance-name>etgcloud sql instances describe <instance-name> --format="yaml(settings.backupConfiguration)"— noteztransactionLogRetentionDays: 7. - Ajoutez une transition de cycle de vie à un bucket dans le portail (
lifecycle_rulesavec unSetStorageClassbasé sur l'âge versNEARLINE), redéployez et vérifiez :gcloud storage buckets describe gs://<bucket> --format="yaml(lifecycle_config)". - Exécutez un script SQL personnalisé : téléversez
001_create_table.sqldans un bucket, définissezenable_custom_sql_scripts = trueavec le bucket et le chemin, redéployez, puis lisez les journaux du job avecgcloud run jobs executions describe <execution> --region=us-central1. - Vous savez que cela a fonctionné lorsqu'un nouveau dump horodaté apparaît dans le bucket de sauvegarde et que
gcloud sql backups listaffiche les 7 sauvegardes automatiques conservées.
Testez-vous
Q1 : Un ingénieur a supprimé une table à 14:32. Le dernier dump nocturne date de 02:00. Quelle est la récupération qui perd le moins de données, et pourquoi est-elle disponible ici ?
R : La récupération à un moment précis (PITR) — restaurez (clonez) l'instance Cloud SQL à 14:31. Le PITR est activé sur l'instance avec une conservation des journaux de transactions de 7 jours ; n'importe quelle seconde de cette fenêtre est donc récupérable, alors que le dump GCS de 02:00 ferait perdre 12,5 heures d'écritures. L'examen attend de vous que vous sachiez que le PITR crée une nouvelle instance au lieu de rembobiner l'instance existante.
Q2 : Comment maintenir stables les coûts du bucket de sauvegarde sans aucun nettoyage manuel ?
R : Avec une règle de cycle de vie des objets qui supprime les objets plus anciens que N jours — exactement ce que backup_retention_days configure sur le bucket de sauvegarde. La gestion du cycle de vie est évaluée quotidiennement par GCS lui-même ; aucun job ni cron n'est nécessaire de votre côté.
Au-delà des modules — gcloud sql connect mérite qu'on s'y exerce, mais ne fonctionnera pas directement avec ces instances, car elles n'ont pas d'adresse IP publique — connectez-vous via le proxy d'authentification Cloud SQL (cloud-sql-proxy <connection-name>) ou Cloud SQL Studio dans la console. Étudiez aussi : les sauvegardes à la demande (gcloud sql backups create --instance=...), les mécanismes de sauvegarde des autres produits (export/import Firestore vers GCS, Backup for GKE — notez que Services_GCP dispose de enable_gke_backup, par défaut false, planification 0 3 * * *, conservation de 30 jours), l'historique des jobs BigQuery (bq ls -j) et le Simulateur de coût (Pricing Calculator) pour estimer les coûts de stockage. Non implémentés non plus : les sauvegardes planifiées et le PITR de Firestore, les sauvegardes Spanner et Bigtable, les sauvegardes et restaurations AlloyDB à la demande (le cluster AlloyDB du module, lorsque enable_alloydb = true, dispose déjà d'une règle de sauvegarde hebdomadaire automatique conservant 7 sauvegardes — inspectez-la avec gcloud alloydb backups list --region=us-central1, puis entraînez-vous avec gcloud alloydb backups create), l'état des jobs Dataflow (gcloud dataflow jobs list / describe), l'exécution de requêtes sur BigQuery (bq query), Firestore, Spanner (gcloud spanner databases execute-sql) et Bigtable (cbt read), ainsi que Database Center — la vue console de l'ensemble du parc présentant l'état, l'inventaire et les recommandations pour Cloud SQL, AlloyDB, Spanner, Bigtable, Firestore et Memorystore.
⚠️ Piège d'examen — La gestion des versions des objets et la suppression par cycle de vie interagissent : supprimer un objet versionné crée une version non actuelle qui reste facturée jusqu'à ce qu'une règle num_newer_versions/d'âge la purge. « Nous avons activé la gestion des versions et les coûts de stockage ont doublé » est une mise en situation classique.
3.3 Gestion des ressources réseau (Managing networking resources)
⏱ ~40 min · 💰 une adresse IP statique réservée mais non associée est facturée à l'heure — libérez-la après le lab · ⚙️ Prérequis : profil application Kubernetes (pour
reserve_static_ip) ou n'importe quel déploiement avec Cloud Armor
Pourquoi l'examen s'y intéresse — Les opérations sur des réseaux en production : réserver des adresses IP statiques internes/externes, ajouter des sous-réseaux ou étendre des plages à mesure que les charges de travail augmentent, et maintenir les règles de pare-feu à jour. L'examen privilégie les commandes gcloud compute addresses et d'extension de sous-réseau, et le guide actuel y ajoute les routes statiques personnalisées, l'exploitation de Cloud DNS et de Cloud NAT, ainsi que la gestion des règles de pare-feu VPC et des stratégies Cloud NGFW.
Comment RAD le met en œuvre — Deux schémas opérationnels sont en place :
- Adresses IP statiques :
reserve_static_ipd'App_GKE(par défauttrue) réserve une adresse IP externe statique globale pour la Gateway/l'équilibreur de charge (static_ip_namepermet de la remplacer en option) ;App_CloudRuncrée de même une adresse IP statique globale lorsque son équilibreur de charge est activé, et la VM NFS deServices_GCPdétient une adresse interne réservée, afin que l'adresse IP du partage survive au remplacement de l'instance. - Sous-réseaux par région : ajouter une région à
availability_regionsdansServices_GCPcrée, lors de l'application suivante, un nouveau sous-réseau, un routeur et une passerelle NAT dans cette région, sans toucher aux sous-réseaux existants. - Cloud NAT : chaque région reçoit un Cloud Router et une passerelle NAT (
{network}-nat-gw-{region}) — inspectez-la avecgcloud compute routers nats describe <nat-name> --router=<router-name> --region=us-central1. - Règles de pare-feu VPC : le module gère ses propres règles basées sur des tags et des plages (voir la Section 2.3) ; listez-les et inspectez-les avec
gcloud compute firewall-rules list/describeplutôt que de les modifier sur place.
Essayez
- Listez les adresses réservées et identifiez celles qui sont globales ou régionales, internes ou externes :
gcloud compute addresses list
gcloud compute addresses describe <address-name> --global - Dans le portail, définissez
reserve_static_ip = falsesur App_GKE et redéployez ; observez que la Gateway utilise désormais une adresse IP éphémère susceptible de changer lors d'une recréation — puis remettez-la àtrue(bonne pratique de production). - Entraînez-vous sur les commandes manuelles de l'examen dans votre projet :
gcloud compute addresses create lab-ip --region=us-central1
gcloud compute addresses delete lab-ip --region=us-central1 --quiet - Vous savez que cela a fonctionné lorsque
gcloud compute addresses listaffiche l'adresse globale du module avec l'étatIN_USE(associée à une règle de transfert).
Testez-vous
Q1 : Après un redéploiement de maintenance, des clients signalent que le DNS ne résout plus vers l'application. L'adresse IP de la Gateway a changé. Qu'est-ce qui était mal configuré ?
R : L'équilibreur de charge utilisait une adresse IP éphémère (reserve_static_ip = false). Les adresses IP externes éphémères peuvent changer chaque fois que la ressource frontale est recréée ; les points de terminaison de production référencés par le DNS doivent utiliser une adresse statique réservée — c'est précisément pourquoi le module utilise true par défaut.
Q2 : Un équilibreur de charge d'application externe global a besoin d'une adresse IP. Réservation régionale ou globale ?
R : Globale (gcloud compute addresses create NAME --global). Les équilibreurs de charge globaux utilisent une seule adresse IP anycast ; les adresses régionales s'associent à des ressources régionales (VM, règles de transfert d'équilibreurs de charge régionaux). Se tromper de portée est une mauvaise réponse fréquemment proposée.
Au-delà des modules — Non implémentés : les routes statiques personnalisées, la gestion de l'appairage VPC, les opérations sur les enregistrements Cloud DNS et l'extension de la plage d'adresses IP d'un sous-réseau (le module crée des sous-réseaux, mais vous devriez vous entraîner à en agrandir un) : gcloud compute networks subnets expand-ip-range <subnet> --region=us-central1 --prefix-length=23 (extension uniquement — une plage ne peut jamais être réduite). Parcourez aussi VPC network > Routes pour comprendre la différence entre les routes générées par le système et les routes personnalisées avec sauts suivants (gcloud compute routes create lab-route --network=<vpc> --destination-range=192.168.100.0/24 --next-hop-gateway=default-internet-gateway), entraînez-vous à modifier des enregistrements Cloud DNS (gcloud dns record-sets create dans une zone de test), et gérez les règles et les associations d'une stratégie de pare-feu réseau Cloud NGFW (gcloud compute network-firewall-policies rules update).
⚠️ Piège d'examen — Une adresse IP statique externe réservée qui n'est associée à rien reste facturée ; libérer les adresses inutilisées est une réponse classique en matière de réduction des coûts (et une recommandation Active Assist).
3.4 Surveillance et journalisation (Monitoring and logging)
⏱ ~75 min · 💰 la journalisation d'audit augmente le volume et le coût de Cloud Logging · ⚙️ Prérequis :
support_usersdéfini ;configure_email_notification = true+notification_alert_emailssur Services_GCP ;enable_audit_logging = truepour le lab d'audit
Pourquoi l'examen s'y intéresse — Vous devez savoir lire et filtrer les journaux dans l'explorateur de journaux (Logs Explorer), créer des règles d'alerte sur des métriques, comprendre les canaux de notification, savoir quels journaux d'audit existent par défaut (Admin Activity : toujours activés ; Data Access : sur activation explicite) et diagnostiquer les charges de travail à partir de leur télémétrie. Le guide actuel va plus loin : métriques personnalisées, journaux de flux VPC et journaux de pare-feu, export des journaux, buckets de journaux, Log Analytics et le routeur de journaux (Log Router), outils de diagnostic (Cloud Trace, Cloud Profiler, Query Insights, conseiller d'index), le tableau de bord Personalized Service Health, l'Ops Agent, Google Cloud Managed Service for Prometheus, Gemini Cloud Assist pour Cloud Monitoring, Active Assist et Cloud Hub.
Comment RAD le met en œuvre —
Métriques et alertes : définir support_users crée des canaux de notification par e-mail ainsi que des règles d'alerte intégrées — pour Cloud Run, utilisation du CPU > 90 % et utilisation de la mémoire > 90 % (P99 sur des fenêtres de 60 s, via la couche de surveillance de la plateforme) ; alert_policies (par défaut []) ajoute des règles de seuil personnalisées sur n'importe quel type de métrique, filtrées automatiquement sur votre service. Services_GCP ajoute des alertes d'infrastructure lorsque configure_email_notification = true avec notification_alert_emails : CPU/mémoire/disque de Cloud SQL par rapport à alert_cpu_threshold/alert_memory_threshold/alert_disk_threshold (tous 80 par défaut), et des règles de CPU, de mémoire et d'instance arrêtée pour la VM NFS — l'alerte de mémoire NFS lit la métrique de l'Ops Agent agent.googleapis.com/memory/percent_used. Un tableau de bord Cloud Monitoring est créé pour chaque application.
Sondes : startup_probe_config et health_check_config définissent des sondes de démarrage et d'activité HTTP/TCP sur les deux plateformes — une vérification d'état à la manière de Kubernetes, visible dans la spécification de la révision ou du pod.
Agents et Prometheus : le script de démarrage de la VM NFS installe l'Ops Agent, qui alimente son alerte agent.googleapis.com/memory/percent_used. Les clusters GKE activent Google Cloud Managed Service for Prometheus (managed_prometheus { enabled = true }).
Diagnostic : enable_query_insights (Services_GCP, par défaut false) active Cloud SQL Query Insights pour les instances principales PostgreSQL et MySQL.
Journalisation : les clusters GKE envoient les journaux SYSTEM_COMPONENTS et WORKLOADS. enable_audit_logging (par défaut false) active les journaux d'audit Data Access allServices ADMIN_READ/DATA_READ/DATA_WRITE, ainsi que des configurations explicites pour Secret Manager et KMS.
Tests de disponibilité : uptime_check_config (par défaut { enabled = false, path = "/" } — vous devez définir enabled = true ; check_interval par défaut "60s", timeout par défaut "10s") crée un <service>-uptime-check — une sonde HTTP GET lancée depuis plusieurs régions du monde — ainsi qu'une règle <service>-uptime-check-alert sur monitoring.googleapis.com/uptime_check/check_passed qui notifie les canaux support_users (via la couche de surveillance de la plateforme). Le test n'est créé que lorsque le point de terminaison est publiquement accessible (par ex. un domaine personnalisé, l'hôte nip.io de l'équilibreur de charge ou l'URL run.app avec ingress_settings = "all") ; les déploiements uniquement internes n'en reçoivent aucun. La sortie uptime_check_names renvoie le nom du test créé.
Essayez
- Listez les éléments de surveillance créés par les modules :
(Console : Monitoring > Alerting et Monitoring > Dashboards. Si votre service est publiquement accessible, ouvrez aussi Monitoring > Uptime checks et repérez
gcloud beta monitoring channels list --format="table(displayName, labels.email_address)"
gcloud alpha monitoring policies list --format="table(displayName, enabled)"<service>-uptime-check, qui sonde depuis plusieurs régions.) - Lisez les journaux de votre application avec des filtres dans le style de l'examen :
gcloud logging read 'resource.type="cloud_run_revision" AND severity>=ERROR' --limit=10
gcloud logging read 'resource.type="k8s_container" AND resource.labels.namespace_name="<namespace>"' --limit=10 - Activez
enable_audit_logging = true, redéployez, effectuez une action (lisez la valeur d'un secret dans la console), puis retrouvez-la :gcloud logging read 'logName:"cloudaudit.googleapis.com%2Fdata_access" AND protoPayload.serviceName="secretmanager.googleapis.com"' --limit=5 - Cassez volontairement une sonde : définissez
health_check_config.pathsur/broken, redéployez, et observez la révision qui ne parvient pas à devenir prête (Cloud Run) ou le pod qui redémarre en boucle (kubectl describe podmontre des sondes d'activité en échec). Annulez ensuite la modification. - Vous savez que cela a fonctionné lorsque la liste des règles affiche les alertes de CPU/mémoire et que l'étape 3 renvoie une entrée Data Access mentionnant votre compte principal.
Testez-vous
Q1 : L'équipe sécurité demande « qui a lu le mot de passe de la base de données mardi dernier ? » — pouvez-vous répondre avec les paramètres par défaut ?
R : Non. Les lectures de secrets sont des événements d'audit Data Access (DATA_READ), désactivés par défaut ; seuls les journaux Admin Activity (par ex. modification de l'IAM, création de secrets) sont toujours activés. Avec enable_audit_logging = true, le module active les journaux Data Access pour Secret Manager (et pour tous les services), ce qui permet de répondre à la question depuis l'explorateur de journaux.
Q2 : Une règle d'alerte existe et sa condition se déclenche, mais personne ne reçoit d'e-mail. Que vérifier en premier ?
R : Les canaux de notification — une règle sans canal (ou avec des canaux non vérifiés) évalue ses conditions mais ne notifie personne. En termes RAD : support_users/notification_alert_emails ne doivent pas être vides, car ce sont eux qui créent et associent les canaux de messagerie.
Q3 : Un pod GKE est en CrashLoopBackOff. Donnez la séquence de diagnostic en deux commandes.
R : kubectl describe pod <pod> -n <ns> (événements : erreurs de récupération d'image, OOMKilled, sondes en échec), puis kubectl logs <pod> -n <ns> --previous (sortie du conteneur qui a planté, et non du redémarrage en cours). L'option --previous est le détail qu'affectionne l'examen.
Au-delà des modules — Non implémentés : les récepteurs de journaux/exports du routeur de journaux (vers BigQuery, Cloud Storage ou Pub/Sub, à destination d'un système sur site ou tiers), les buckets de journaux personnalisés et Log Analytics, les métriques personnalisées (métriques basées sur les journaux, ou métriques applicatives écrites via l'API Monitoring/OpenTelemetry), les journaux de flux VPC et la journalisation des règles de pare-feu, l'instrumentation Cloud Trace/Profiler et le conseiller d'index. Entraînez-vous : créez une métrique de compteur basée sur les journaux à partir d'une requête de l'explorateur de journaux, créez un récepteur avec gcloud logging sinks create, mettez à niveau un bucket de journaux vers Log Analytics et interrogez-le en SQL, activez les journaux de flux sur un sous-réseau (gcloud compute networks subnets update <subnet> --region=us-central1 --enable-flow-logs) et la journalisation sur une règle de pare-feu (--enable-logging). Sachez distinguer le bucket _Required (Admin Activity et autres journaux obligatoires, conservation de 400 jours, non modifiable) du bucket _Default (conservation de 30 jours par défaut). Parcourez aussi, sur votre propre déploiement : le tableau de bord Personalized Service Health (incidents Google affectant vos projets), Gemini Cloud Assist dans Cloud Monitoring (interrogez-le sur une métrique ou une alerte), les recommandations Active Assist (ressources inactives, redimensionnement, autorisations IAM excessives) et Cloud Hub (une vue unique des événements en cours et de l'état des applications).
⚠️ Piège d'examen — Les journaux d'audit Admin Activity sont gratuits et toujours activés ; les journaux d'audit Data Access sont à activer explicitement, facturables et volumineux (BigQuery est le seul service pour lequel Data Access est activé par défaut). Les confondre est l'erreur la plus courante de la Section 3.4.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.