Guide de préparation à la certification ACE : Section 2 — Planification et mise en œuvre d'une solution cloud (Planning and implementing a cloud solution) (~30 % de l'examen)
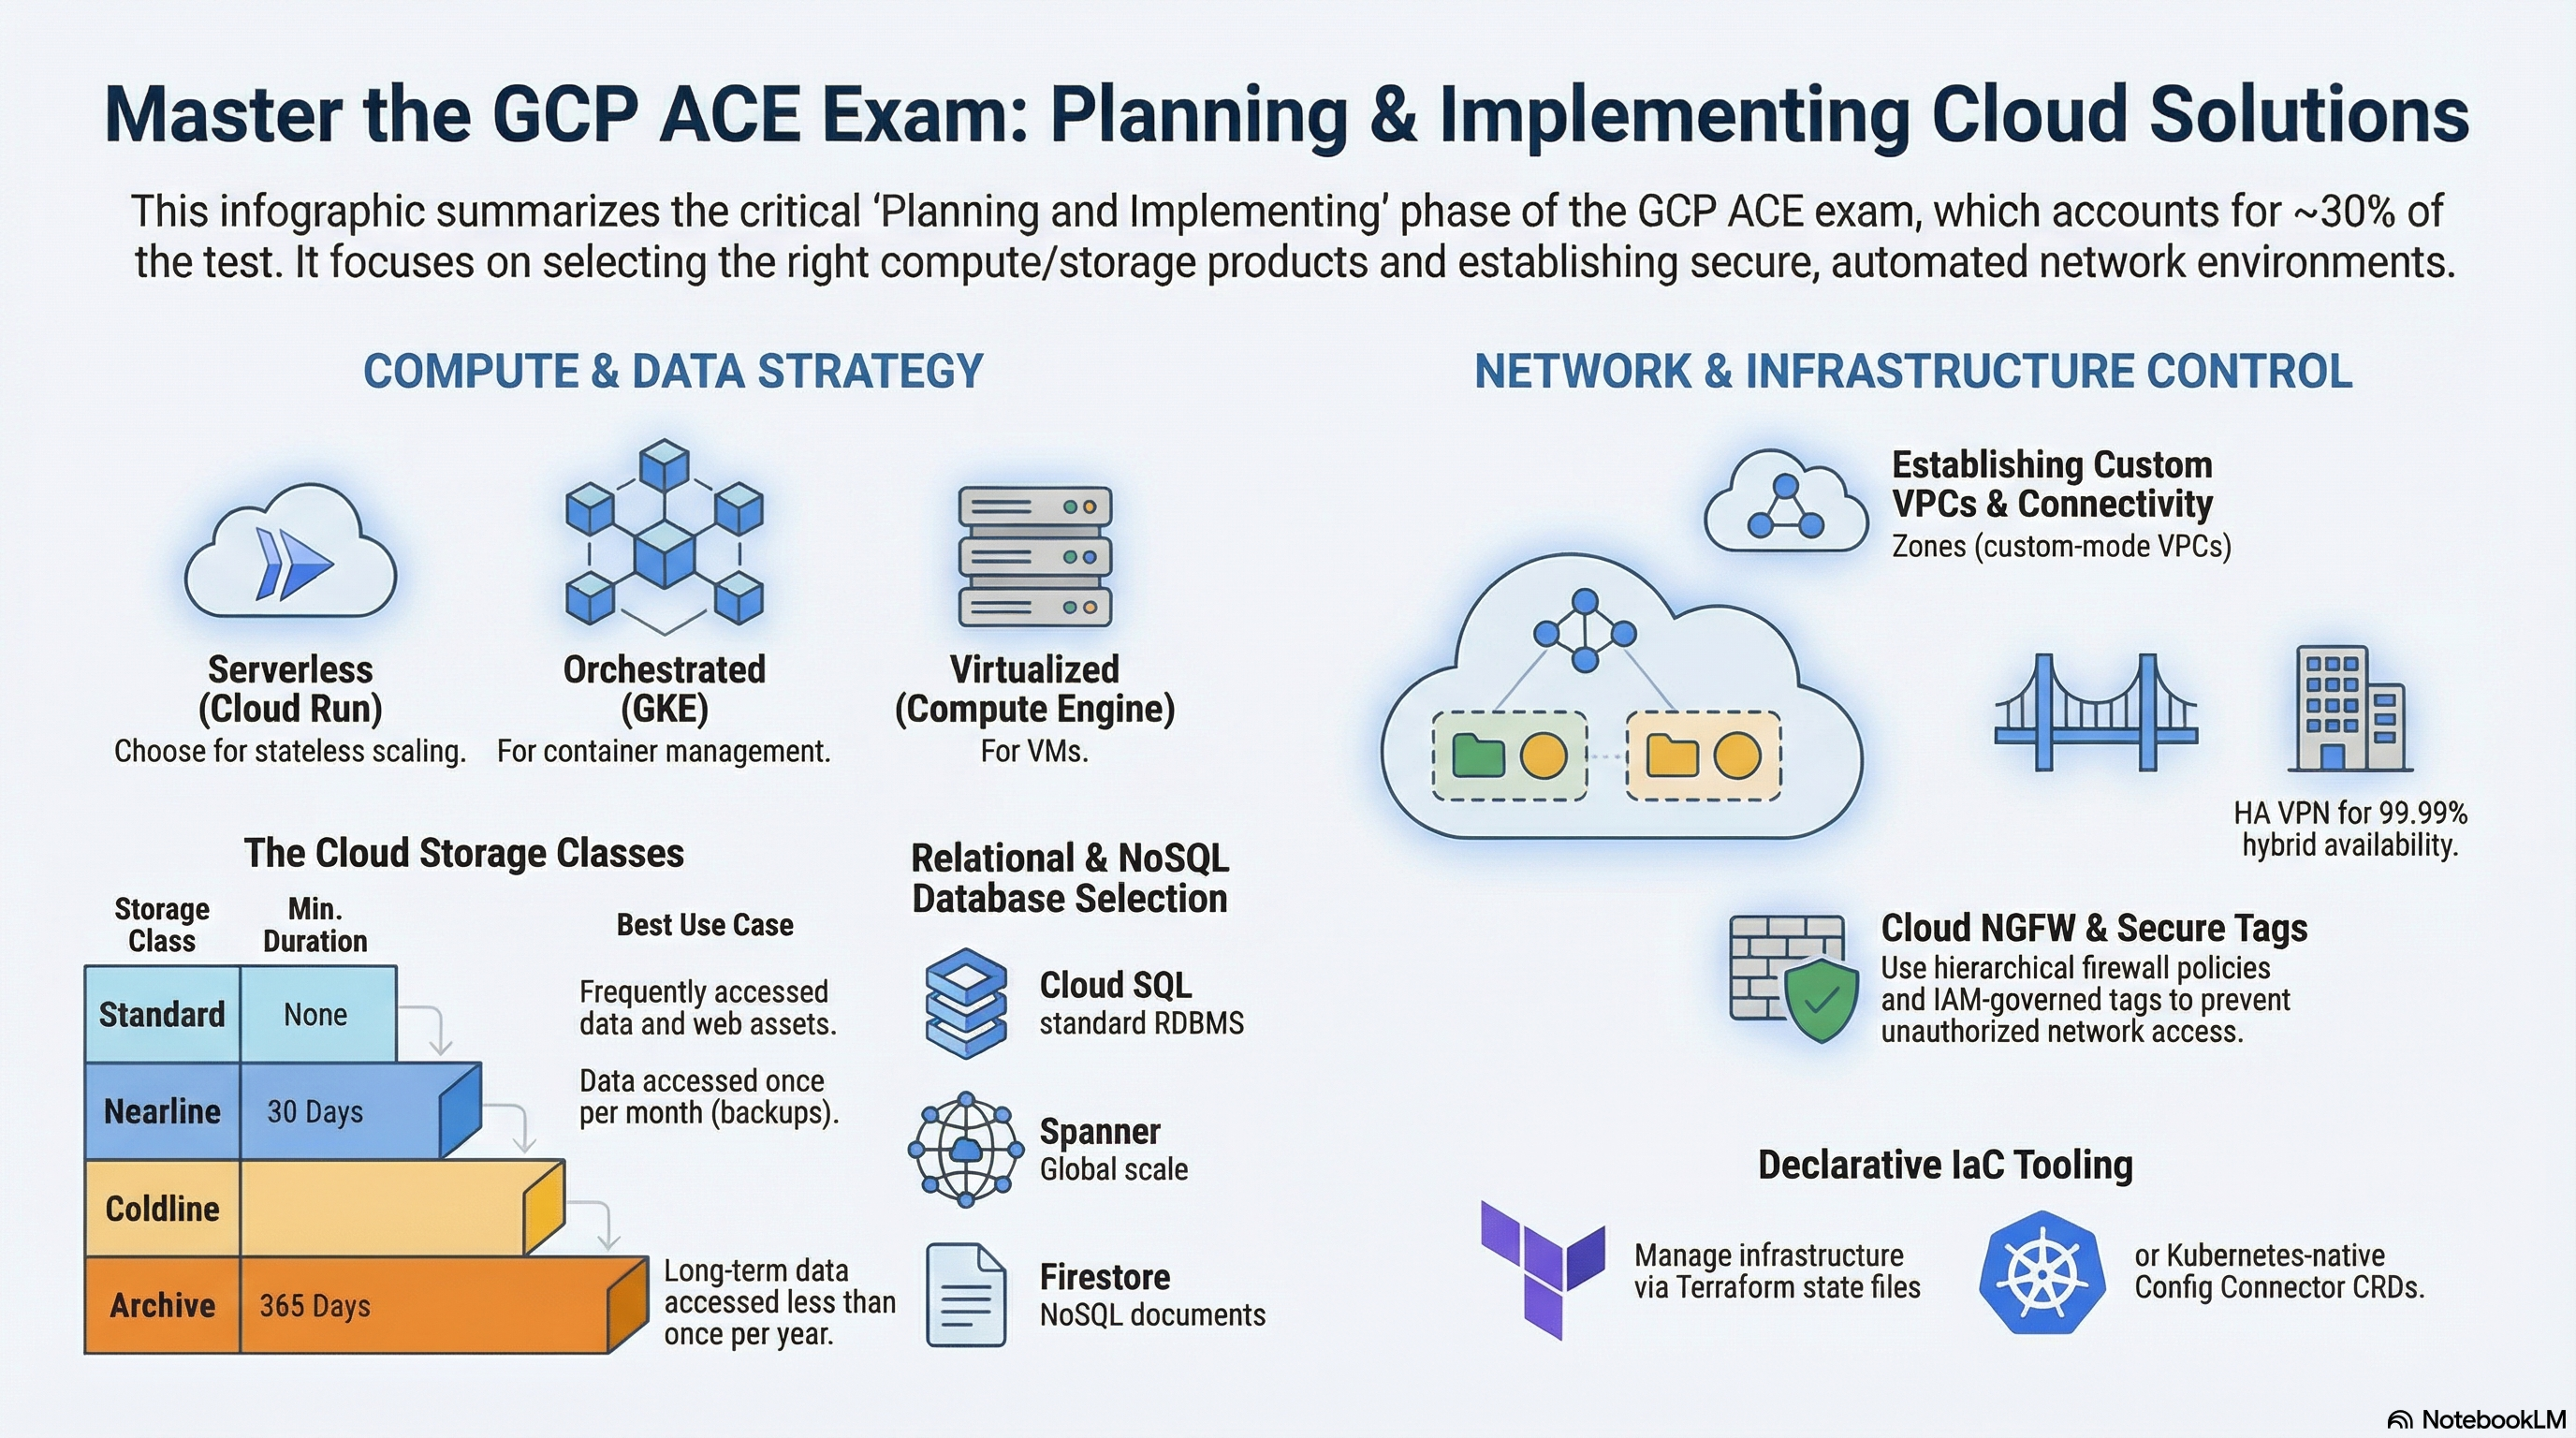
Ce guide couvre la Section 2 de l'examen en utilisant les modules de base de la plateforme RAD comme lab pratique. Les quatre modules de base sont mis en œuvre : Services_GCP fournit le VPC, les bases de données et (en option) le cluster GKE Autopilot ; App_CloudRun et App_GKE sont les deux moteurs de déploiement ; la bibliothèque partagée App_Common gère le stockage, les secrets et les builds. Déployez d'abord le profil application serverless, puis le profil application Kubernetes de la cartographie des labs.
2.1 Planification et mise en œuvre des ressources de calcul (Planning and implementing compute resources)
⏱ ~90 min · 💰 faible pour Cloud Run (mise à l'échelle jusqu'à zéro) ; modéré pour GKE Autopilot · ⚙️ Prérequis : profil application serverless ; profil application Kubernetes pour la partie GKE
Pourquoi l'examen s'y intéresse — La compétence la plus importante de la Section 2 consiste à choisir la bonne plateforme de calcul — Compute Engine pour un contrôle complet du système d'exploitation, GKE pour l'orchestration de conteneurs, Cloud Run pour des conteneurs sans état pilotés par les requêtes, Cloud Run functions pour des fragments de code pilotés par les événements, Agent Runtime sur Gemini Enterprise Agent Platform (anciennement Vertex AI Agent Engine) pour héberger des agents d'IA — puis à configurer correctement la mise à l'échelle et les ressources de chacune. Attendez-vous à des mises en situation comparant l'économie de la mise à l'échelle jusqu'à zéro, les démarrages à froid, le choix du type de machine (y compris les types de machines personnalisés), la tarification Spot, le choix du disque Compute Engine (Persistent Disk zonal ou régional, ou Hyperdisk), OS Login et VM Manager, les configurations de cluster GKE (Autopilot, régional, privé), le traitement piloté par les événements (Pub/Sub, notifications Cloud Storage, Eventarc), ainsi que les cas où une charge de travail a besoin de GPU ou de TPU.
Comment RAD le met en œuvre — La même application peut être déployée via App_CloudRun ou via App_GKE, ce qui rend la comparaison concrète :
Cloud Run (App_CloudRun) :
| Variable | Valeur par défaut | Remarques |
|---|---|---|
container_image_source | "custom" | prebuilt déploie directement container_image ; custom construit l'image avec Cloud Build |
min_instance_count | 0 | 0 = mise à l'échelle jusqu'à zéro ; ≥1 élimine les démarrages à froid |
max_instance_count | 1 | Plafond de coût (1–1000) |
container_resources | cpu_limit = "1000m", memory_limit = "512Mi" | Capacité par instance |
container_port | 8080 | Port vers lequel Cloud Run achemine les requêtes |
execution_environment | "gen2" | gen2 est requis pour les volumes NFS et GCS Fuse |
timeout_seconds | 300 | Délai d'expiration des requêtes, 0–3600 |
cpu_always_allocated | false | Par défaut, facturation à la requête (CPU uniquement pendant le traitement des requêtes) ; définissez true pour garder le CPU alloué entre les requêtes |
enable_image_mirroring (par défaut true) copie d'abord les images publiques dans Artifact Registry (une copie tenant compte du digest), de sorte que le service ne tire jamais directement depuis Docker Hub.
GKE (App_GKE) : min_instance_count (par défaut 1) et max_instance_count (par défaut 3) deviennent les nombres minimal et maximal de réplicas d'un HPA ; container_resources devient les requêtes/limites des pods (Autopilot facture selon les requêtes). workload_type (par défaut null) se résout en Deployment, mais définir stateful_pvc_enabled = true sélectionne automatiquement un StatefulSet avec des PVC par pod (stateful_pvc_size et stateful_pvc_mount_path obligatoires) ; combiner explicitement workload_type = "Deployment" avec stateful_pvc_enabled = true échoue au moment du plan. enable_vertical_pod_autoscaling (par défaut false) ajoute un VPA. Le cluster lui-même provient de Services_GCP : gke_cluster_mode (par défaut AUTOPILOT, ou STANDARD avec un pool de nœuds e2-standard-4 explicite dont l'autoscaling va de 1 à 5 nœuds via gke_node_min_count/gke_node_max_count), emplacement régional, nœuds privés (un cluster privé disposant de sa propre plage de plan de contrôle issue de gke_master_base_cidr), canal de publication REGULAR, Workload Identity et Managed Prometheus.
Compute Engine n'apparaît qu'une fois : create_network_filesystem (par défaut true) exécute une VM Ubuntu e2-small à partir d'un modèle d'instance, dans un groupe d'instances géré de taille 1, avec un disque de démarrage zonal pd-standard et un disque de données avec état pd-ssd, OS Login activé dans les métadonnées de l'instance (enable-oslogin = true), Shielded VM, des vérifications d'état TCP avec réparation automatique et une planification d'instantanés quotidiens (conservation de 7 jours) — un MIG modeste mais bien réel à inspecter. Le MIG est fixé à une instance ; il ne fait pas d'autoscaling.
Le traitement piloté par les événements n'apparaît lui aussi qu'une fois : enable_auto_password_rotation (par défaut false) relie les notifications de rotation de Secret Manager à un sujet Pub/Sub, et un déclencheur Eventarc (google.cloud.pubsub.topic.v1.messagePublished) les transmet à un service de distribution Cloud Run — le schéma Pub/Sub → Eventarc → Cloud Run que décrit l'examen.
Essayez
- Déployez le profil application serverless, puis inspectez le service et ses révisions :
Dans Cloud Run > service > Revisions, vérifiez que le CPU et la mémoire correspondent à
gcloud run services list --region=us-central1
gcloud run services describe <service-name> --region=us-central1 \
--format="yaml(spec.template.spec.containers[0].resources, spec.template.metadata.annotations)"container_resources. - Passez
max_instance_countà5dans le portail et redéployez ; observez l'apparition de la nouvelle révision avecgcloud run revisions list --service=<service-name> --region=us-central1. - Déployez le profil application Kubernetes, connectez-vous et inspectez la charge de travail :
gcloud container clusters get-credentials gke-cluster-1 --region=us-central1
kubectl get deployments,hpa,pods -n <namespace>
kubectl describe hpa -n <namespace> - Inspectez l'unique VM Compute Engine et son MIG :
gcloud compute instance-groups managed listetgcloud compute instances list --filter="name~nfs". - Vous savez que cela a fonctionné lorsque le HPA affiche
MINPODS 1 / MAXPODS 3(ou vos valeurs personnalisées) et que la révision Cloud Run affiche vos limites de CPU et de mémoire.
Testez-vous
Q1 : Une API HTTP sans état reçoit un trafic imprévisible et en rafales, et l'équipe ne veut rien payer pendant les nuits sans activité. Cloud Run ou GKE — et quelle variable RAD exprime ce choix ?
R : Cloud Run avec min_instance_count = 0 — Cloud Run descend à zéro instance entre les requêtes et ne facture que pendant le traitement. Les pods GKE Autopilot (minimum HPA de 1 dans ce module) continuent d'être facturés pour leurs requêtes de ressources jour et nuit. La contrepartie est la latence de démarrage à froid sur la première requête après une période d'inactivité.
Q2 : Vous définissez stateful_pvc_enabled = true dans App_GKE sans toucher à workload_type. Qu'est-ce qui est déployé, et pourquoi ?
R : Un StatefulSet. Le module sélectionne automatiquement un StatefulSet dès que des PVC par pod sont demandés, car un Deployment ne peut pas donner à chaque réplica son propre volume et son identité stables. Forcer workload_type = "Deployment" en même temps fait échouer la validation au moment du plan.
Q3 : Sur GKE Autopilot, que se passe-t-il si la spécification d'un conteneur ne comporte aucune requête de CPU/mémoire, et pourquoi le module les définit-il toujours ?
R : Autopilot exige des requêtes de ressources — il rejette le pod ou applique des valeurs par défaut, et il facture par ressource demandée. Le module transforme toujours container_resources en requêtes/limites, afin que la planification et la facturation soient déterministes.
Au-delà des modules — Compute Engine à usage général, Cloud Run functions, Agent Runtime et les accélérateurs ne sont pas implémentés. Pour l'examen :
- Créez vous-même une VM :
gcloud compute instances create test-vm --zone=us-central1-a --machine-type=e2-micro, puis connectez-vous en SSH avecgcloud compute ssh test-vm --zone=us-central1-a. Étudiez les familles de machines (E2/N2/C3), les types de machines personnalisés (--custom-cpu/--custom-memory), les Spot VMs (--provisioning-model=SPOT), les règles de disponibilité (maintenance sur l'hôte, redémarrage automatique), les clés SSH par rapport à OS Login, ainsi que les modèles d'instance avec un MIG en autoscaling (gcloud compute instance-groups managed set-autoscaling). - Stockage Compute Engine : Persistent Disk zonal, Persistent Disk régional (réplication synchrone sur deux zones) ou Google Cloud Hyperdisk (performances provisionnées indépendamment de la taille).
- VM Manager : inventaire du système d'exploitation, gestion des correctifs et règles d'OS sur un parc de machines (il s'appuie sur l'agent OS Config).
- Cloud Run functions :
gcloud functions deployavec un déclencheur HTTP, Pub/Sub ou Cloud Storage ; sachez qu'elles s'exécutent sur Cloud Run et que les événements sont acheminés via Eventarc. - Agent Runtime sur Gemini Enterprise Agent Platform (anciennement Vertex AI Agent Engine) : connaissez-le comme l'option gérée pour héberger des agents d'IA, et sachez quand le préférer à l'exécution d'un conteneur d'agent sur Cloud Run ou GKE.
- GPU ou TPU : les GPU pour le ML à usage général et les charges graphiques (pouvant être associés à Compute Engine, GKE et Cloud Run), les TPU pour l'entraînement et l'inférence TensorFlow/JAX/PyTorch à grande échelle. Vérifiez d'abord la disponibilité régionale.
kubectl: installez-le (gcloud components install kubectl gke-gcloud-auth-plugin, ou utilisez Cloud Shell, où il est préinstallé) avantget-credentials.- Opérations sur les pools de nœuds GKE Standard (
gcloud container node-pools create/resize) — le cluster RAD utilise par défaut Autopilot, où les pools de nœuds sont invisibles.
⚠️ Piège d'examen — Dans ce module, max_instance_count de Cloud Run vaut 1 par défaut : un test de charge plafonnera rapidement, et ce n'est pas une limite de Cloud Run, mais un plafond de coût délibéré. À l'examen, les mises en situation où « le service cesse de monter en charge » relèvent généralement d'un paramètre de nombre maximal d'instances, pas d'un quota.
2.2 Planification et mise en œuvre des solutions de stockage et de données (Planning and implementing storage and data solutions)
⏱ ~75 min · 💰 Cloud SQL est le principal coût de base ; Filestore (
BASIC_HDD1 Tio) et Redis ajoutent un coût non négligeable — supprimez-les après le lab · ⚙️ Prérequis : plateforme de base ; activezcreate_redis/create_filestore_nfspour ces labs
Pourquoi l'examen s'y intéresse — La Section 2.2 évalue le choix des produits : stockage d'objets (GCS), stockage de fichiers (Filestore) ou stockage de blocs ; relationnel (Cloud SQL/AlloyDB/Spanner) ou NoSQL (Firestore/Bigtable) ; mise en cache (Memorystore) ; et déplacement de données (Dataflow, Pub/Sub, Managed Service for Apache Kafka), ainsi que les produits de fichiers plus récents (Google Cloud NetApp Volumes, Google Cloud Managed Lustre). Elle porte aussi sur les paramètres de création de base — classes de stockage, disponibilité régionale ou zonale, connectivité privée vers les bases de données gérées — ainsi que sur le chargement des données et leur redondance entre régions.
Comment RAD le met en œuvre — Services_GCP provisionne la couche de données ; les modules applicatifs la consomment et la montent.
| Variable (Services_GCP) | Valeur par défaut | Ce qu'elle crée |
|---|---|---|
create_postgres | true | Cloud SQL PostgreSQL (postgres_database_version par défaut POSTGRES_17, postgres_tier par défaut db-custom-1-3840) |
postgres_database_availability_type | ZONAL | Définissez REGIONAL pour la haute disponibilité avec une instance de secours synchrone |
create_postgres_read_replica | false | Instances répliquées zonales avec accès en lecture (postgres_read_replica_count par défaut 1) |
create_mysql | false | Cloud SQL MySQL (mysql_database_version par défaut MYSQL_8_4) |
enable_alloydb | false | Cluster AlloyDB + instance principale (alloydb_cpu_count par défaut 2) |
create_firestore | false | Base de données Firestore (mode natif) |
create_redis | false | Memorystore Redis (redis_tier par défaut BASIC, redis_memory_size_gb par défaut 1, AUTH activé) |
create_filestore_nfs | false | Filestore (filestore_tier par défaut BASIC_HDD, filestore_capacity_gb par défaut 1024) |
L'instance Cloud SQL n'utilise qu'une adresse IP privée (pas d'IPv4 publique, mode SSL chiffré uniquement), accessible via Private Services Access, avec des sauvegardes quotidiennes automatiques (7 conservées, 04:00 UTC) et la récupération à un moment précis (PITR) activée. La persistance Redis (redis_persistence_mode, par défaut DISABLED) n'est configurable que sur le niveau STANDARD_HA, et des préconditions vérifiées au moment du plan rejettent le niveau BASIC lorsque resource_labels.environment = "production" — et rejettent aussi redis_persistence_mode = "DISABLED" sur une instance STANDARD_HA de production, si bien que les caches de production doivent activer la persistance RDB ou AOF.
Côté application, storage_buckets (par défaut [], avec create_cloud_storage à true par défaut) provisionne un bucket GCS par entrée — location prenant par défaut la région du déploiement (définissez une multirégion comme US pour une redondance entre régions), storage_class par défaut STANDARD, versioning_enabled par défaut false, public_access_prevention par défaut "enforced", avec des lifecycle_rules et une configuration CORS facultatives (la couche de stockage d'objets de la plateforme). gcs_volumes monte des buckets dans le conteneur via GCS Fuse, enable_nfs (par défaut true) monte le partage NFS sur nfs_mount_path (par défaut /mnt/nfs), et database_type (par défaut POSTGRES ; MYSQL/NONE) sélectionne le moteur Cloud SQL auquel l'application se connecte, via le proxy d'authentification Cloud SQL (un volume de socket Unix sur Cloud Run via enable_cloudsql_volume, par défaut true ; un conteneur sidecar de proxy sur GKE). Pour charger des données, enable_backup_import (par défaut false) charge un dump de base de données existant depuis un objet GCS dans cette base, au moyen d'un job ponctuel (détaillé dans la Section 3.2).
Essayez
- Inspectez la base de données en ligne de commande et vérifiez qu'elle n'a pas d'adresse IP publique :
Notez
gcloud sql instances list
gcloud sql instances describe <instance-name> \
--format="yaml(settings.availabilityType, settings.ipConfiguration, settings.backupConfiguration)"pointInTimeRecoveryEnabled: trueet l'absence d'adresse publique. - Dans le portail, ajoutez un bucket :
storage_buckets = [{ name_suffix = "media", versioning_enabled = true, storage_class = "NEARLINE" }], redéployez, puis vérifiez :gcloud storage buckets list --format="table(name, storageClass, versioning_enabled)"
gcloud storage cp /etc/hostname gs://<bucket-name>/test.txt && gcloud storage ls -L gs://<bucket-name>/test.txt - Définissez
create_redis = trueetcreate_filestore_nfs = truedans Services_GCP, redéployez, puis exécutez :gcloud redis instances list --region=us-central1etgcloud filestore instances list. Vérifiez l'AUTH Redis et l'adresse IP privée dans la sortie. - Vous savez que cela a fonctionné lorsque le bucket affiche la classe
NEARLINEavec la gestion des versions activée, et que l'instance SQL afficheavailabilityType: ZONALavec les sauvegardes activées.
Testez-vous
Q1 : L'application a besoin d'un système de fichiers partagé en lecture-écriture, monté simultanément par 10 instances Cloud Run. GCS, Filestore ou un disque persistant ?
R : Filestore (ou le serveur NFS du module) — il s'agit d'un partage de fichiers NFS géré qui prend en charge l'accès POSIX simultané par plusieurs rédacteurs, que RAD monte via enable_nfs/nfs_mount_path. Les disques persistants sont des périphériques de blocs à rédacteur unique destinés aux VM ; GCS est un stockage d'objets (le montage GCS Fuse offre une sémantique d'objets à cohérence à terme, pas un système de fichiers POSIX).
Q2 : Revue de mise en production : l'instance Cloud SQL doit survivre à une panne de zone. Quelle variable unique change, et que fait-elle concrètement ?
R : postgres_database_availability_type = "REGIONAL". Cloud SQL maintient alors une instance de secours synchrone dans une seconde zone de la même région, avec basculement automatique. Cela double à peu près le coût de l'instance, et ce n'est pas la même chose qu'une instance répliquée avec accès en lecture (asynchrone, zonale dans ce module, sans basculement automatique).
Q3 : Pourquoi le module rejette-t-il redis_tier = "BASIC" lorsque resource_labels.environment = "production" ?
R : Le niveau BASIC est un nœud unique, sans réplication ni SLA — un événement de maintenance ou une défaillance du nœud vide le cache et provoque une interruption de service. STANDARD_HA ajoute une instance répliquée avec basculement automatique, et seul STANDARD_HA prend en charge la persistance RDB/AOF dans ce module.
Au-delà des modules — Non implémentés : BigQuery, Spanner, Bigtable, Dataflow, Pub/Sub en tant que bus de messagerie applicatif, Google Cloud Managed Service for Apache Kafka, Google Cloud NetApp Volumes, Google Cloud Managed Lustre et Storage Transfer Service. Pour l'examen : chargez un CSV dans BigQuery (bq load + bq query --dry_run pour estimer le coût), créez puis supprimez une petite instance Spanner, publiez/récupérez un message Pub/Sub (gcloud pubsub topics create t && gcloud pubsub subscriptions create s --topic=t), sachez où se placent Dataflow (pipelines Apache Beam gérés), Managed Kafka (streaming compatible Kafka), NetApp Volumes (NFS/SMB géré) et Managed Lustre (système de fichiers parallèle à haut débit pour l'IA et le HPC), comparez les voies de chargement des données (gcloud storage cp pour un envoi en ligne de commande, chargements BigQuery depuis Cloud Storage, Storage Transfer Service pour les transferts volumineux ou récurrents), et révisez les classes de stockage GCS (Standard/Nearline/Coldline/Archive, avec des durées minimales de 0/30/90/365 jours) ainsi que les emplacements de buckets multirégionaux/birégionaux.
⚠️ Piège d'examen — « Sauvegardes activées » ≠ récupération illimitée : le PITR (activé ici avec une conservation des journaux de transactions de 7 jours) vous permet de restaurer à un instant donné dans la fenêtre ; les sauvegardes quotidiennes seules ne permettent de restaurer qu'à partir des instantanés de sauvegarde. Dans ce module, MySQL dispose de la journalisation binaire mais d'aucun bloc de configuration PITR — ne supposez pas une parité entre les moteurs.
2.3 Planification et mise en œuvre des ressources réseau (Planning and implementing networking resources)
⏱ ~75 min · 💰 le lab Cloud Armor + équilibreur de charge global ajoute le coût d'une règle de transfert et d'une stratégie · ⚙️ Prérequis : plateforme de base ;
enable_cloud_armor = trueavec un domaine pour le lab d'équilibrage de charge
Pourquoi l'examen s'y intéresse — Vous devez savoir créer un VPC en mode personnalisé avec des sous-réseaux, écrire des règles de pare-feu VPC avec priorités et tags cibles ainsi que des stratégies Cloud Next Generation Firewall (Cloud NGFW) ciblant des tags sécurisés ou des comptes de service, connecter des réseaux (Cloud VPN, appairage de réseaux VPC, Cloud Interconnect), distinguer les niveaux de service réseau Premium et Standard, donner un accès Internet sortant aux instances privées via Cloud NAT, et choisir le bon équilibreur de charge (équilibreur de charge d'application externe global pour HTTP(S), équilibreur de charge réseau passthrough pour TCP/UDP). L'accès privé aux services gérés (Private Services Access, Private Google Access ou Private Service Connect) est une mise en situation récurrente.
Comment RAD le met en œuvre — Services_GCP construit un VPC en mode personnalisé vpc-network-{prefix} (les sous-réseaux ne sont pas créés automatiquement) avec un sous-réseau par région dans availability_regions (par défaut ["us-central1"], CIDR issus de subnet_cidr_range, par défaut ["10.0.0.0/24"]), un Cloud Router + Cloud NAT par région ({network}-nat-gw-{region}), et une plage d'appairage Private Services Access (/16) utilisée par Cloud SQL, Redis et Filestore pour leurs adresses IP privées. Les règles de pare-feu reposent sur des tags et des plages : {network}-fw-allow-lb-hc admet les plages de vérification d'état de Google 130.211.0.0/22 et 35.191.0.0/16 ; {network}-fw-allow-iap-ssh admet la plage de transfert TCP d'IAP 35.235.240.0/20 sur tcp:22 ; les règles NFS/Redis ciblent les tags nfsserver/redisserver ; les règles HTTP ciblent les tags httpserver/webserver sur 80/443/8080/8443. Les plages secondaires GKE (pods/services) sont découpées dans gke_pod_base_cidr (par défaut 10.64.0.0/10) et gke_service_base_cidr (par défaut 10.8.0.0/16) uniquement lorsque le cluster est activé.
En périphérie : dans App_CloudRun, vpc_egress_setting (par défaut PRIVATE_RANGES_ONLY, ou ALL_TRAFFIC) contrôle la sortie VPC directe (le service obtient une interface réseau dans le sous-réseau — aucun connecteur d'accès au VPC sans serveur n'est utilisé), et ingress_settings (par défaut all) contrôle qui peut atteindre le service. enable_cloud_armor (par défaut false) provisionne un équilibreur de charge d'application externe global — NEG sans serveur → service de backend avec une stratégie Cloud Armor (règles OWASP préconfigurées sqli/xss/lfi/rce, limitation de débit à 500 requêtes/min/IP, Adaptive Protection) → mappage d'URL → proxy HTTPS → adresse IP statique globale — avec application_domains facultatif (un certificat <ip-dashed>.nip.io sans configuration est dérivé lorsqu'il est vide) ; des certificats gérés par Google sont émis par domaine lorsque vous en fournissez un, et enable_cdn (par défaut false) active Cloud CDN au niveau du service de backend. Dans App_GKE, enable_custom_domain utilise la Gateway API (GatewayClass gke-l7-global-external-managed) avec Certificate Manager, reserve_static_ip (par défaut true) réserve une adresse globale, et enable_cloud_armor active la même Gateway, en se rabattant sur un certificat HTTPS <ip>.nip.io dérivé lorsqu'aucun domaine personnalisé n'est défini.
Essayez
- Parcourez le réseau en ligne de commande :
gcloud compute networks list --filter="name~vpc-network"
gcloud compute networks subnets list --network=<vpc-name>
gcloud compute routers list
gcloud compute routers nats list --router=<router-name> --region=us-central1
gcloud compute firewall-rules list --filter="network~<vpc-name>" \
--format="table(name, sourceRanges.list(), allowed[].map().firewall_rule().list(), targetTags.list())" - Observez Private Services Access : VPC network > VPC network peering affiche
servicenetworking-googleapis-com;gcloud compute addresses list --global --filter="purpose=VPC_PEERING"affiche la plage /16 réservée. - Activez
enable_cloud_armor = trueavecapplication_domains = ["app.example.com"](un domaine que vous contrôlez), redéployez, puis inspectez l'équilibreur de charge et la stratégie WAF :gcloud compute forwarding-rules list --global
gcloud compute security-policies list
gcloud compute security-policies describe <policy-name> --format="table(rules[].priority, rules[].action, rules[].description)" - Basculez
vpc_egress_settingsurALL_TRAFFICet observez dans Cloud Run > service > Networking que tout le trafic sortant passe désormais par le VPC (et donc par Cloud NAT). - Vous savez que cela a fonctionné lorsque la liste des règles de pare-feu affiche les plages de vérification d'état et d'IAP ci-dessus, et que la stratégie de sécurité affiche des règles WAF deny(403) ainsi qu'une règle de bannissement basée sur le débit.
Testez-vous
Q1 : L'instance Cloud SQL n'a pas d'adresse IP publique, et pourtant Cloud Run s'y connecte. Nommez les deux mécanismes en jeu.
R : Private Services Access attribue à l'instance Cloud SQL une adresse IP privée dans une plage appairée gérée par Google, et Cloud Run atteint cette adresse RFC 1918 via la sortie VPC directe (vpc_egress_setting = "PRIVATE_RANGES_ONLY" achemine le trafic à destination des plages privées dans le VPC), le proxy d'authentification Cloud SQL se chargeant de l'authentification et du chiffrement.
Q2 : Une VM du sous-réseau doit télécharger des paquets du système d'exploitation, mais ne doit jamais être joignable depuis Internet. Qu'est-ce qui le permet, et que vérifieriez-vous si les téléchargements échouent ?
R : Cloud NAT — il donne aux instances sans adresse IP externe un accès Internet sortant, sans aucune exposition entrante. Si les téléchargements échouent, vérifiez que la passerelle NAT couvre le sous-réseau/la région (gcloud compute routers nats describe) et qu'aucune règle de pare-feu de refus en sortie ne prime sur l'autorisation par défaut.
Q3 : Pourquoi l'activation de Cloud Armor dans App_CloudRun fait-elle aussi passer l'entrée (ingress) à une autre valeur que « all » ?
R : Cloud Armor évalue le trafic au niveau de l'équilibreur de charge. Si le service Cloud Run acceptait encore le trafic direct vers run.app (ingress = all), un attaquant pourrait contourner entièrement le WAF ; restreindre l'entrée à internal-and-cloud-load-balancing oblige chaque requête à passer par le chemin protégé.
Au-delà des modules — Non implémentés : les stratégies de pare-feu réseau Cloud NGFW et les tags sécurisés (les modules utilisent des règles de pare-feu VPC classiques avec des tags réseau), le VPC partagé (projets hôtes/de service), l'appairage VPC entre vos propres VPC, Cloud VPN / Interconnect, le choix du niveau de service réseau et les équilibreurs de charge internes. Pour l'examen : créez une stratégie de pare-feu réseau globale avec une règle ciblant un tag sécurisé (gcloud compute network-firewall-policies create / rules create --target-secure-tags) et associez-la à un VPC de test, appairez deux VPC de test et vérifiez la non-transitivité, révisez le VPN haute disponibilité (SLA de 99,99 %, nécessite Cloud Router/BGP), et sachez que le niveau Premium (par défaut) achemine le trafic sur le réseau de Google, tandis que le niveau Standard le remet à l'Internet public à proximité de la région et ne prend en charge que les équilibreurs de charge externes régionaux.
⚠️ Piège d'examen — Priorité des règles de pare-feu : le plus petit nombre l'emporte, les règles par défaut se situent à 65534, et une règle « allow » ne prévaut pas sur une règle « deny » de priorité supérieure. N'oubliez pas non plus que les plages de vérification d'état (130.211.0.0/22, 35.191.0.0/16) doivent être autorisées, sinon votre équilibreur de charge marque tous les backends comme non opérationnels — le module crée cette règle pour vous, c'est pourquoi tout « fonctionne tout seul ».
2.4 Planification et mise en œuvre de ressources à l'aide d'outils (Planning and implementing resources using tooling)
⏱ ~45 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : n'importe quel profil déployé
Pourquoi l'examen s'y intéresse — L'ACE attend de vous que vous compreniez ce qu'apporte l'IaC (état souhaité déclaratif, différences calculées par le plan avant l'application, reproductibilité, correction des dérives), le flux de travail Terraform de base (init → validate → plan → apply), l'état distant et les outils que cite l'examen : Terraform, Fabric FAST (le framework de zone d'atterrissage Terraform de Google), Config Connector (les ressources GCP en tant qu'objets Kubernetes) et Helm (gestionnaire de paquets Kubernetes). Le guide mentionne aussi la planification et la mise en œuvre assistées par l'IA — Gemini CLI, Google Antigravity, Gemini Cloud Assist et Application Design Center. Vous n'avez pas besoin d'écrire des modules de zéro.
Comment RAD le met en œuvre — L'ensemble de la plateforme RAD est de l'IaC : votre portail de déploiement recueille les valeurs des variables et exécute OpenTofu dans Cloud Build (un pipeline de création pour le premier déploiement et un pipeline de mise à jour pour les modifications : tofu init → plan → apply). Chaque option du portail mentionnée dans ce guide est une variable Terraform ; deploy_application (par défaut true) est un bon exemple de contrôle déclaratif — définissez-la à false et l'application suivante supprime la charge de travail tout en conservant intacte l'infrastructure qui la soutient (VPC, base de données, buckets). Les modules illustrent aussi une politique vérifiée au moment du plan : 23 préconditions dans App_CloudRun et 32 dans App_GKE rejettent les combinaisons invalides (par ex. un CDN sans domaine personnalisé) avant le moindre appel d'API.
Essayez
- Observez le flux de travail IaC de bout en bout : lancez n'importe quel déploiement depuis le portail, puis exécutez
gcloud builds list --limit=5et ouvrez le journal du dernier build pour voir les étapesinit → plan → applys'exécuter dans l'ordre. - Dans la sortie de ce plan, repérez où votre champ du portail (par ex.
min_instance_count) aboutit sur le service Cloud Run — reliez une option du portail à l'attribut d'API concret qu'elle définit. - Observez la correction des dérives : dans la console, modifiez manuellement la limite de mémoire de votre service Cloud Run (Edit & deploy new revision), puis lancez une mise à jour depuis le portail sans modifier les variables et regardez le plan annuler votre modification manuelle.
- Relisez les étapes plan/apply du journal de build pour voir exactement quelles actions de création, de mise à jour ou sans effet l'application a effectuées.
- Vous savez que cela a fonctionné lorsque la sortie du plan de l'étape 3 montre votre modification faite dans la console en train d'être annulée (une mise à jour sur place qui revient à
512Miou à votre valeur configurée).
Testez-vous
Q1 : Un collègue a « corrigé » la production en modifiant une règle de pare-feu dans la console. L'application IaC planifiée suivante a annulé la correction. Que s'est-il passé, et quel est le bon flux de travail ?
R : Terraform réconcilie les ressources réelles avec la configuration déclarée ; les modifications faites hors processus dans la console sont donc annulées en tant que dérive. Le bon flux de travail consiste à modifier la variable/la configuration dans le code source (ou le portail) et à l'appliquer via le pipeline — les modifications dans la console de ressources gérées par IaC doivent être réservées aux urgences de type « bris de glace » et reportées immédiatement dans le code.
Q2 : Pourquoi tofu plan est-il important à l'examen (et sur cette plateforme) avant apply ?
R : plan calcule la différence exacte de création/mise à jour/destruction par rapport à l'état, sans rien modifier, ce qui vous permet de repérer les changements destructeurs (par ex. le remplacement d'une base de données) avant qu'ils ne se produisent. Le pipeline RAD exécute toujours plan -out=plan.tfplan et applique ce plan enregistré, ce qui garantit que ce qui a été examiné est bien ce qui est exécuté.
Au-delà des modules — Le portail fait abstraction de la gestion de l'état ; entraînez-vous donc séparément : configurez un backend GCS avec gestion des versions pour l'état distant (terraform { backend "gcs" { bucket = "..." } }), sachez pourquoi l'état distant et le verrouillage sont importants pour les équipes, et survolez Config Connector (les ressources GCP en tant que CRD Kubernetes), Fabric FAST (une zone d'atterrissage Terraform par étapes : organisation, dossiers, réseau, sécurité) et Helm (helm install d'un chart dans un cluster GKE — les modules génèrent plutôt les manifestes Kubernetes avec Terraform). Entraînez-vous aussi sur les équivalents bruts en ligne de commande que l'examen affectionne : gcloud compute instances create, gcloud container clusters create-auto, gcloud run deploy — les questions sur l'IaC reviennent souvent à « savez-vous ce que cela automatise ? ».
Planification et mise en œuvre assistées par l'IA (📘) — aucun de ces outils ne fait partie des modules, mais chacun peut être utilisé avec eux : utilisez Gemini Cloud Assist dans la console pour expliquer ou dépanner les ressources créées par votre déploiement ; utilisez Gemini CLI (un agent open source en ligne de commande) ou Google Antigravity (un IDE centré sur les agents) pour lire du code Terraform et proposer des modifications dans une copie de test d'un module ; et parcourez Application Design Center pour voir comment il compose des modèles d'application à partir de composants fournis par Google et les déploie. Sachez à quoi sert chacun, et que leurs résultats doivent toujours passer par la même discipline revue → plan → application que l'IaC écrit à la main.
⚠️ Piège d'examen — terraform destroy (et le bouton Delete du portail) supprime tout ce qui figure dans l'état, pas seulement les ressources « inutilisées » — tandis que Purge dans le portail ne supprime rien dans le cloud et se contente de faire oublier le déploiement à RAD. À l'inverse, les ressources créées en dehors de l'IaC lui sont invisibles — supprimer le déploiement Terraform ne nettoiera pas vos expérimentations faites dans la console.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.