Pratiques d'ingénierie
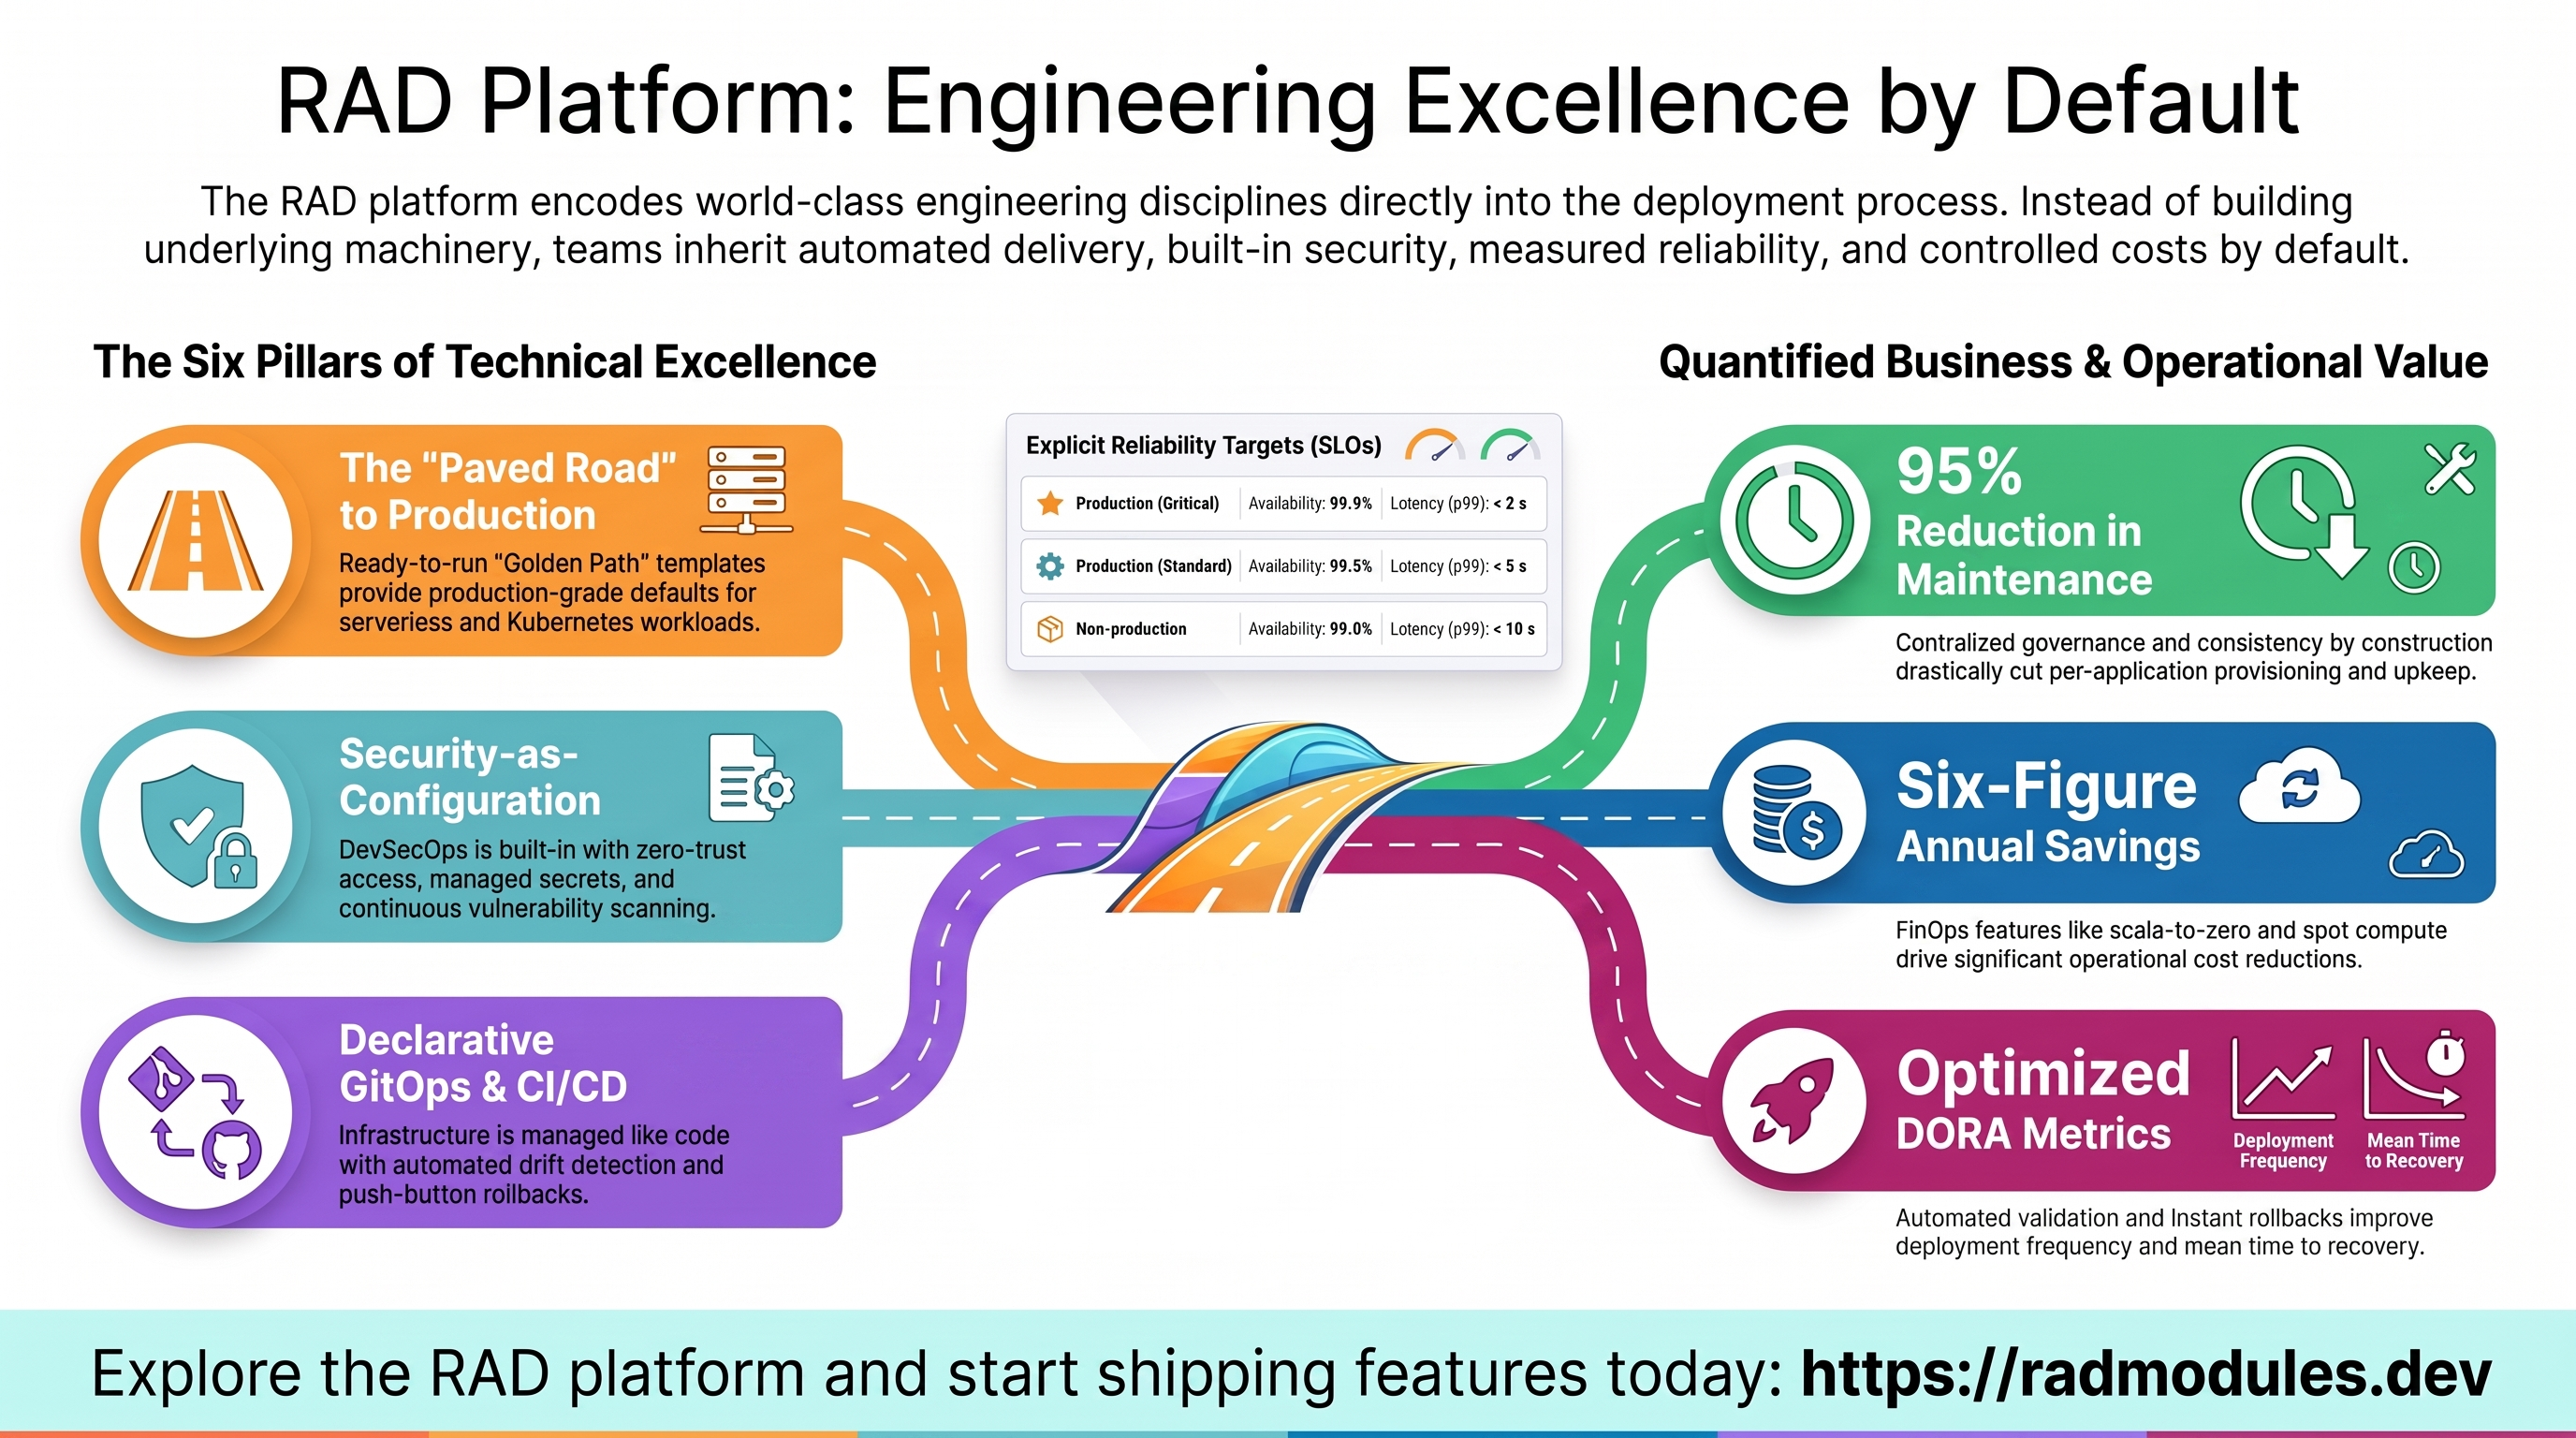
Vue d'ensemble
La plateforme ne se contente pas de déployer des applications — elle intègre les disciplines d'ingénierie sur lesquelles s'appuient les plus grandes organisations technologiques du monde pour exécuter des logiciels en toute sécurité à grande échelle. Chaque solution que vous déployez hérite de ces pratiques par défaut : la livraison est automatisée, la sécurité est intégrée, la fiabilité est mesurée et les coûts sont maîtrisés — sans que vous ayez à écrire ni à maintenir la moindre partie des mécanismes sous-jacents.
Ce document résume six disciplines que la plateforme applique pour votre compte — Platform Engineering, GitOps et Infrastructure as Code, CI/CD, DevSecOps, Site Reliability Engineering et FinOps — ainsi que les variables de configuration par lesquelles vous les façonnez.
1. Platform Engineering
Une plateforme « paved road » (chemin balisé) : les aspects communs et difficiles de l'exécution de charges de travail de production sont résolus une fois pour toutes et proposés en libre-service, afin que les équipes livrent des fonctionnalités au lieu d'assembler de l'infrastructure.
- Un catalogue de solutions prêtes à l'emploi. Chaque application prise en charge est disponible sous forme de déploiement clés en main — la plupart sur les deux environnements d'exécution (serverless et Kubernetes) — de sorte que lancer une nouvelle charge de travail relève de la configuration, et non d'un projet d'ingénierie.
- Golden paths. Des modèles préconçus et prédurcis couvrent les archétypes courants — services web sans état, charges de travail avec état et services d'IA/d'inférence — chacun configuré avec des valeurs par défaut de niveau production.
- Gouvernance centralisée, consommation décentralisée. Les contrôles transverses (identité, chiffrement, politique d'images) sont définis une seule fois au niveau de la plateforme et hérités automatiquement par chaque déploiement.
- Cohérence par construction. Chaque déploiement suit le même modèle de nommage, de structure et de configuration, de sorte que toute solution est lisible par tout opérateur et que les ressources sont identifiables d'elles-mêmes dans la console, la facturation et les journaux d'audit.
- Prêt pour le multirégion. La même solution peut être déployée dans des régions supplémentaires pour la géoredondance ou une latence plus faible, derrière un routage mondial.
- Intégration guidée. Les nouvelles équipes partent du catalogue et d'une implémentation de référence plutôt que d'une page blanche.
2. GitOps et Infrastructure as Code
L'infrastructure est décrite de manière déclarative et gérée comme du code applicatif — versionnée, relue et reproductible.
- Déclarative et versionnée. Chaque déploiement est entièrement décrit par sa configuration ; l'état souhaité réside dans le système de gestion de versions, et non dans la mémoire d'un opérateur.
- État isolé par déploiement. Chaque tenant et chaque application dispose de son propre état indépendant, ce qui élimine les interférences entre déploiements et la contention sur les verrous.
- Correction des dérives à l'application. Chaque mise à jour planifie par rapport à l'état déclaré, de sorte que les modifications effectuées en dehors de la plateforme sont mises en évidence et réconciliées lors de la prochaine mise à jour du déploiement. RAD accélère le déploiement ; il ne surveille pas en continu un déploiement une fois celui-ci en fonctionnement.
- Reproductibilité. Chaque déploiement est épinglé à une version exacte des sources, de sorte que tout état antérieur peut être reconstruit et reprovisionné dans un autre projet ou une autre région.
- Modifications relues, avec une approbation proportionnée au rayon d'impact. Les modifications à plus fort impact — celles qui affectent des fondations partagées — nécessitent une relecture supplémentaire avant d'être appliquées.
3. Intégration et livraison continues (CI/CD)
D'une simple modification à un déploiement en fonctionnement, automatiquement et en toute sécurité.
- Build et livraison managés. Les images de conteneurs sont construites, testées et déployées au moyen de pipelines managés — aucun serveur de build à provisionner ni à maintenir.
- Provenance d'image flexible. Déployez une image préconstruite, construisez à partir des sources ou répliquez
une image amont dans votre registre privé (
container_image_source,enable_image_mirroring). - Livraison progressive. Les versions peuvent passer par des environnements — développement →
préproduction → production — avec une promotion automatique facultative et des points d'approbation humaine
entre les étapes (
enable_cloud_deploy,cloud_deploy_stages). - Validation avant provisionnement. Les erreurs de configuration sont rejetées en amont, avant la création de toute ressource, de sorte que les modifications défectueuses n'atteignent jamais votre environnement.
- Garde-fous sur les actions destructrices. Le démantèlement et les autres opérations à fort impact exigent une confirmation humaine explicite. Deux démantèlements sont planifiés : un environnement de lab est supprimé à la fin de sa session de formation, et un projet géré par RAD dont la facturation a été désactivée faute de crédits achetés est supprimé une fois sa période d'avertissement écoulée.
- Étapes post-déploiement automatisées. L'initialisation de la base de données, les migrations et l'installation de plugins/extensions s'exécutent automatiquement à chaque déploiement.
- Visibilité des échecs. Les échecs de pipeline sont signalés immédiatement via des canaux de notification configurables.
4. DevSecOps
La sécurité est intégrée à chaque déploiement dès la première application — et non ajoutée après coup.
- La sécurité comme configuration. Chaque garde-fou est un paramètre relu et versionné, appliqué de manière cohérente à tous les déploiements.
- Identité au moindre privilège. Chaque application s'exécute sous sa propre identité, avec uniquement les autorisations dont elle a besoin. Des fournisseurs d'identité externes peuvent être fédérés sans clés de longue durée (dans un projet que vous apportez vous-même).
- Accès zero trust. Un accès contrôlé par l'identité peut être placé devant n'importe quelle application d'un seul
interrupteur (
enable_iap), remplaçant les VPN par des vérifications d'identité à chaque requête. - Secrets managés. Les identifiants sont conservés dans un coffre de secrets managé, injectés à
l'exécution, jamais codés en dur, et peuvent faire l'objet d'une rotation automatique planifiée
(
enable_auto_password_rotation). - Périmètres de services. Des périmètres par tenant (
enable_vpc_sc,vpc_sc_dry_run) isolent les données et les services, avec un déploiement sûr commençant par un mode simulation (dry-run). Proposés dans un projet que vous apportez vous-même, et non dans un projet géré par RAD. - Intégrité de la chaîne d'approvisionnement. L'admission des images signées (
enable_binary_authorization), l'analyse continue des vulnérabilités et la génération de nomenclatures logicielles (SBOM) garantissent que seules des images de confiance s'exécutent. L'intégrité s'étend à l'outillage de déploiement lui-même : les versions des fournisseurs et des dépendances sont épinglées par des empreintes cryptographiques, de sorte qu'un binaire modifié est détecté entre deux exécutions au lieu d'être adopté silencieusement. - Chiffrement partout. Des clés de chiffrement gérées par le client protègent les données au repos, et TLS termine chaque chemin d'entrée avec des certificats gérés et renouvelés automatiquement.
- Protection réseau. Un pare-feu applicatif web managé avec protection DDoS
(
enable_cloud_armor), une micro-segmentation avec refus par défaut (enable_network_segmentation) et des restrictions sur les chemins d'administration (admin_ip_ranges) protègent chaque charge de travail. - Policy-as-code à l'échelle de la flotte. Des garde-fous à l'échelle de l'organisation sont appliqués à partir d'une source de règles unique appliquée à chaque cluster, les violations étant remontées de manière centralisée — de sorte que les mêmes règles d'admission et de configuration valent partout, et non déploiement par déploiement (une fonctionnalité de flotte, disponible dans un projet que vous apportez vous-même).
- Audit continu. Un audit de sécurité intégré fait apparaître les erreurs de configuration avant qu'elles ne deviennent des incidents, et les constats sont regroupés dans une vue unique.
5. Site Reliability Engineering (SRE)
La fiabilité est définie, mesurée et conçue — et non simplement espérée.
- Objectifs de niveau de service. Les objectifs de fiabilité sont explicites, avec des points de départ recommandés selon la criticité :
| Niveau | Disponibilité | Latence (p99) | Budget d'erreur (30 j) |
|---|---|---|---|
| Production (critique) | 99,9% | < 2 s | 43 min |
| Production (standard) | 99,5% | < 5 s | 3.6 hr |
| Hors production | 99,0% | < 10 s | 7.2 hr |
- Politique de budget d'erreur. Lorsqu'un budget est consommé de manière significative, la livraison de fonctionnalités non critiques est suspendue au profit du travail de fiabilité — ce qui rend l'arbitrage entre fiabilité et vélocité explicite et fondé sur les données.
- Alertes sur le taux de consommation. Les budgets d'erreur sont protégés par des alertes de taux de consommation sur plusieurs fenêtres — une alerte de consommation rapide (budget consommé à environ 14× le rythme soutenable sur une courte fenêtre) détecte les incidents aigus, tandis qu'une alerte de consommation lente (environ 6× sur une fenêtre plus longue) détecte l'érosion progressive — ce qui réduit à la fois les fausses alertes et les incidents manqués.
- Fiabilité codifiée. Les budgets d'interruption (
enable_pod_disruption_budget,pdb_min_available), les sondes de santé et des échéances de déploiement déterministes (deployment_timeout) sont appliqués par défaut, de sorte que les décisions de fiabilité résident dans la configuration plutôt que dans la mémoire des opérateurs. - Réduction du labeur. Les tâches d'exploitation récurrentes — élagage des révisions, nettoyage des ressources obsolètes, attente de la disponibilité des dépendances — sont automatisées.
- Livraison mesurée (DORA). La plateforme améliore directement les quatre indicateurs de livraison standard du secteur :
| Indicateur | Comment la plateforme aide |
|---|---|
| Fréquence de déploiement | Des déploiements guidés et reproductibles rendent les mises en production fréquentes routinières |
| Délai de mise en œuvre des modifications | Des déploiements légers et standardisés traitent les modifications en quelques minutes |
| Taux d'échec des modifications | Des fondations standardisées et une validation en amont réduisent les échecs |
| Temps moyen de rétablissement | Une restauration scriptée raccourcit le rétablissement |
- Réponse aux incidents. Un runbook des schémas de problèmes connus accélère le diagnostic.
6. FinOps
Le coût est une préoccupation d'ingénierie de premier plan — maîtrisé par défaut et visible par tenant.
- Économie de la mise à l'échelle jusqu'à zéro. Les charges de travail serverless ne coûtent rien au repos et sont facturées à la
requête et à la seconde (
min_instance_count) ; les charges de travail Kubernetes sont facturées pour les ressources réellement demandées et ajustées en continu. - Calcul Spot pour les travaux interruptibles. Certains déploiements de référence GKE (comme les démonstrations bancaires) s'exécutent sur de la capacité Spot, réduisant les coûts des nœuds d'environ 60–90% en contrepartie d'une possible préemption à court préavis — un arbitrage délibéré entre coût et durabilité.
- Règles de cycle de vie automatisées. Les anciennes révisions, les images sans tag et les objets anciens sont
élagués automatiquement (
max_revisions_to_retain, ainsi que des contrôles de conservation des images et de cycle de vie des buckets), ce qui empêche la dérive des coûts de stockage. - Répartition des coûts par tenant. Un nommage de ressources identifiable de lui-même se répercute dans la facturation, ce qui permet la refacturation par tenant et des plafonds de dépenses par client pour les scénarios SaaS.
- Services configurables par niveau. Chaque service sous-jacent coûteux — bases de données, cache, stockage de fichiers, calcul — est dimensionné par la configuration, de sorte que vous payez le niveau dont vous avez besoin.
- Profils coût/performance explicites. Des profils documentés Low-Cost, Low-Latency et Balanced font de l'arbitrage un choix délibéré.
- Délestage vers la périphérie. La mise en cache à la périphérie mondiale (
enable_cdn) déplace le trafic principalement en lecture hors du calcul, réduisant le calcul et la sortie réseau. - Maîtrise proactive des dépenses. Les alertes budgétaires ainsi que les recommandations sur les remises pour engagement d'utilisation et pour utilisation soutenue détectent tôt les dépassements et permettent de réaliser des économies sur les composants toujours actifs.
- Prise en compte de la sortie réseau entre périmètres. Lorsque les charges de travail s'étendent sur plusieurs clouds ou régions, le trafic entre périmètres emprunte des chemins publics et engendre des frais de sortie des deux côtés ; une interconnexion privée ou un VPN offre une latence prévisible et une sortie réseau moins coûteuse pour les topologies de production multisites.
Les pratiques en un coup d'œil
| Discipline | Ce que la plateforme fait pour vous |
|---|---|
| Platform Engineering | Catalogue en libre-service, golden paths, gouvernance centralisée, cohérence par construction |
| GitOps et IaC | Déploiements déclaratifs, versionnés et reproductibles, avec correction des dérives à la mise à jour |
| CI/CD | Build managé et livraison progressive, points de validation, approbation des actions destructrices |
| DevSecOps | Identité au moindre privilège, secrets managés, périmètres (dans votre propre projet), intégrité de la chaîne d'approvisionnement, policy-as-code, chiffrement, WAF |
| SRE | SLO et budgets d'erreur avec alertes sur le taux de consommation, résilience codifiée, réduction du labeur, gains DORA |
| FinOps | Mise à l'échelle jusqu'à zéro, calcul Spot, automatisation du cycle de vie, répartition des coûts par tenant, niveaux de service, délestage vers la périphérie, alertes de dépenses |
En résumé
Ces six disciplines ne sont ni des modules complémentaires facultatifs ni un modèle de maturité vers lequel vous progressez — elles constituent la posture opérationnelle par défaut de la plateforme. Chaque solution que vous déployez est livrée au moyen de pipelines automatisés, sécurisée par une défense en profondeur, mesurée par rapport à des objectifs de fiabilité et maîtrisée en coûts dès le premier déploiement. Vous héritez des pratiques d'ingénierie d'une équipe plateforme mature et vous les façonnez par la configuration, plutôt que de les construire et de les maintenir vous-même.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.