Guide de préparation à la certification PSE : Section 1 — Configuration de l'accès (Configuring access) (~25 % de l'examen)
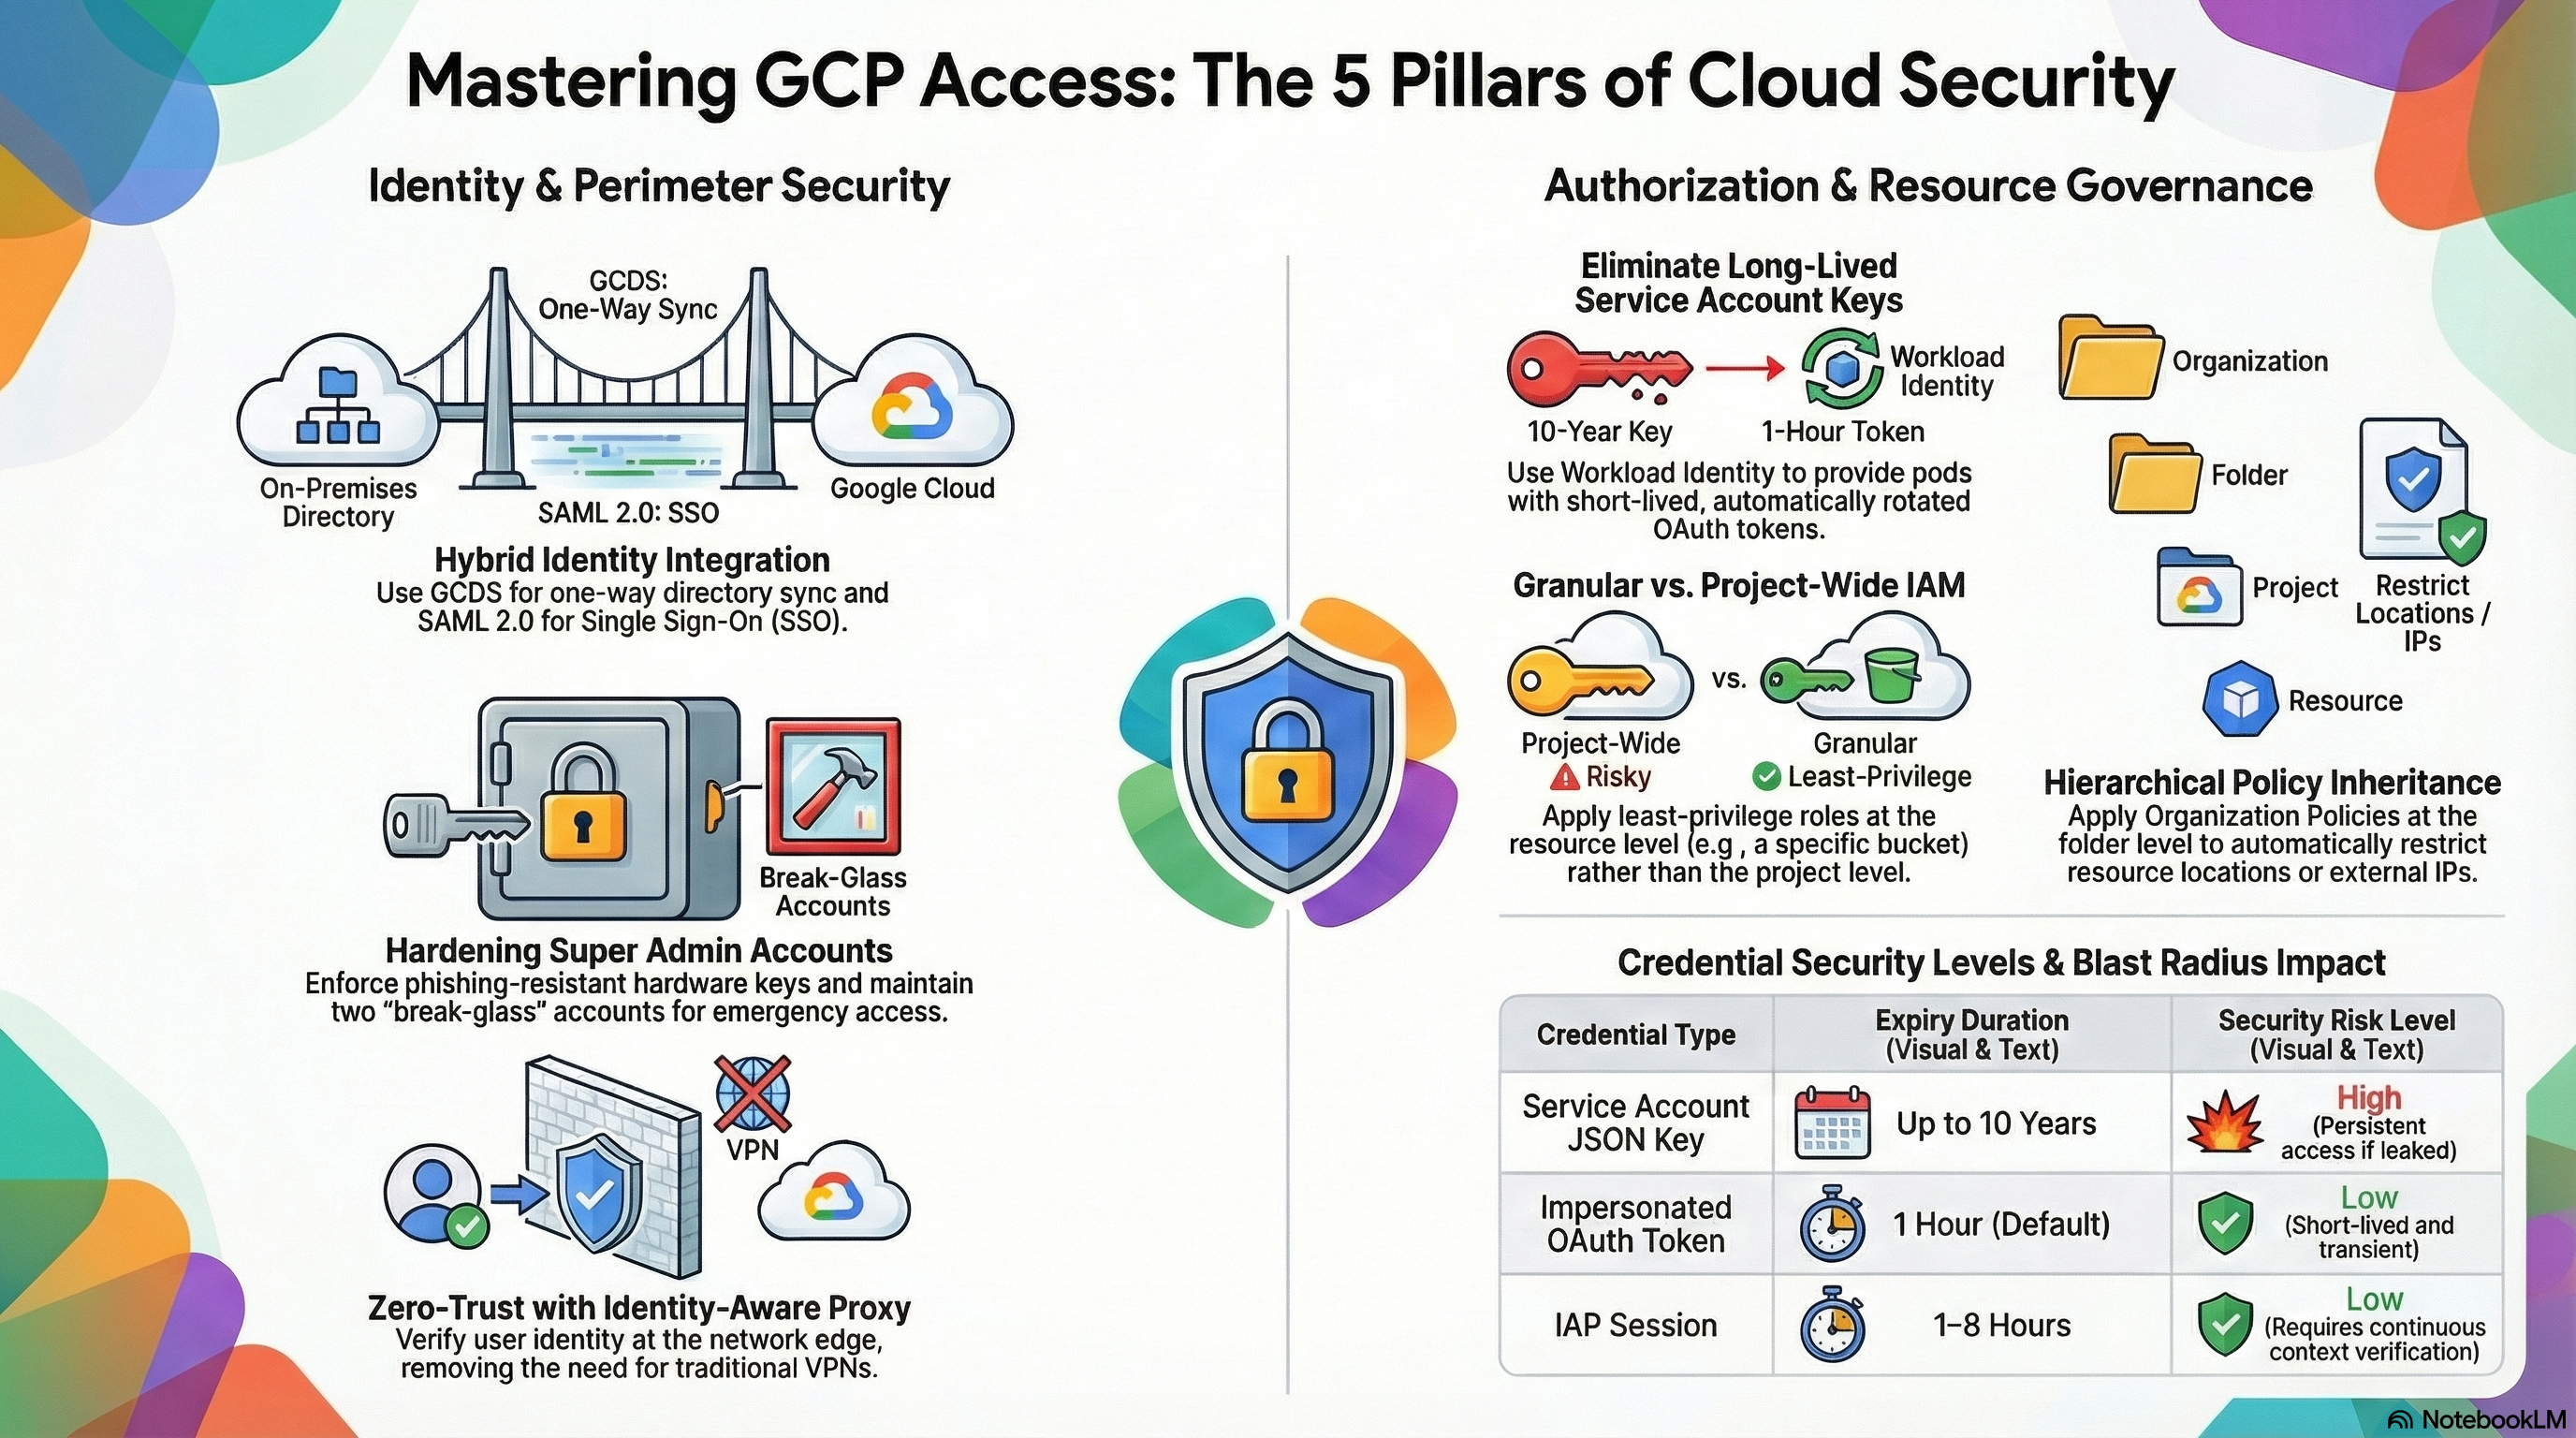
📚 Guide officiel de l'examen : certification Professional Cloud Security Engineer — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Ce guide couvre la section 1 de l'examen Professional Cloud Security Engineer à l'aide des modules fondamentaux de la plateforme RAD. Services_GCP crée les comptes de service dédiés et leurs attributions de rôles au niveau du projet ; App_CloudRun et App_GKE relient ces identités aux charges de travail (Workload Identity sur GKE, comptes de service d'exécution dédiés sur Cloud Run, IAP pour l'authentification des utilisateurs finaux) ; App_Common applique des liaisons au moindre privilège au niveau des ressources. Avant de commencer, déployez le profil secure-platform ainsi que guarded-edge (Cloud Run) ou zero-trust-gke, décrits dans la carte des labs.
1.1 Gestion de Cloud Identity (Managing Cloud Identity)
⏱ ~45 min (essentiellement de la lecture) · 💰 aucun coût supplémentaire · ⚙️ Prérequis : déploiement par défaut
Pourquoi l'examen s'y intéresse — L'examen vérifie que vous savez choisir la bonne architecture d'identité : Google Cloud Directory Sync (GCDS), Workforce Identity Federation ou Cloud Identity seul ; dans quels cas le SSO SAML fait de Google le fournisseur de services plutôt que le fournisseur d'identité ; et comment protéger les comptes super-administrateur. Il s'agit de décisions de conception portant sur le cycle de vie de l'identité humaine, qui se situent au-dessus de tout projet individuel.
Comment RAD le met en œuvre — Non mis en œuvre par les modules fondamentaux. Les modules consomment des identités existantes au lieu de les gérer : iap_authorized_users et iap_authorized_groups (tous deux [] par défaut) acceptent des principaux user:, group:, serviceAccount: et domain: (la plateforme normalise le format du principal), et support_users ([] par défaut) alimente les canaux de notification de la surveillance. C'est le reflet de la réalité : l'ingénieur sécurité reçoit des groupes de l'équipe chargée des identités et les lie aux ressources.
Essayez
- Dans votre portail de déploiement, ajoutez un groupe Google à
iap_authorized_groups(formatgroup:team@example.com) sur un déploiement oùenable_iap = true, puis redéployez. - Dans Console > IAM & Admin > IAM, filtrez sur le groupe et vérifiez qu'il détient désormais
roles/iap.httpsResourceAccessorau niveau du projet. - Vérification en CLI :
gcloud projects get-iam-policy $GOOGLE_PROJECT_ID \
  --flatten="bindings[].members" \
  --filter="bindings.role:roles/iap.httpsResourceAccessor" \
  --format="table(bindings.members)"
- Vous savez que cela a fonctionné lorsque le groupe apparaît dans la liste des liaisons — et que le retirer de la variable du portail puis redéployer supprime de nouveau la liaison.
Testez-vous
Q1 : Votre entreprise compte 5 000 utilisateurs dans un Active Directory sur site et souhaite qu'ils accèdent à GCP avec leurs identifiants d'entreprise existants, sans créer de mots de passe chez Google. Que configurez-vous ?
R : GCDS pour synchroniser à sens unique les utilisateurs et groupes depuis AD vers Cloud Identity, plus le SSO SAML avec l'IdP de l'entreprise, afin que Google agisse comme fournisseur de services et ne stocke ni ne vérifie jamais de mots de passe. Autre solution : Workforce Identity Federation évite toute synchronisation en émettant des identifiants fédérés de courte durée — choisissez-la lorsque vous ne voulez aucun objet utilisateur dans Cloud Identity.
Q2 : Quelle est la différence entre Workforce Identity Federation et Workload Identity Federation ?
R : Workforce Identity Federation fédère des utilisateurs humains issus d'un IdP externe (OIDC/SAML) dans Google Cloud sans provisionner de comptes Cloud Identity. Workload Identity Federation fédère des charges de travail non humaines (GitHub Actions, AWS, etc.) afin qu'elles puissent emprunter l'identité de comptes de service sans clés JSON exportées. L'examen intervertit fréquemment ces termes dans les distracteurs.
Au-delà des modules — À étudier : l'architecture de synchronisation à sens unique de GCDS ; la configuration du SSO SAML 2.0 dans la console d'administration (Security > Authentication > SSO with third-party IdP) ; les bonnes pratiques pour les super-administrateurs (≥2 comptes d'accès d'urgence, clés de sécurité matérielles, aucun usage quotidien) ; l'API Admin SDK Directory pour l'automatisation du cycle de vie ; et les pools/fournisseurs Workforce Identity Federation (IAM & Admin > Workforce Identity Federation). Essayez dans une organisation de test : gcloud iam workforce-pools list --location=global --organization=ORG_ID.
⚠️ Piège d'examen — GCDS synchronise depuis l'environnement sur site vers Cloud Identity, jamais l'inverse, et ne synchronise pas les mots de passe par défaut — l'authentification passe toujours par le SSO ou par les mots de passe Google.
1.2 Gestion des comptes de service (Managing service accounts)
⏱ ~1,5 h · 💰 aucun coût supplémentaire · ⚙️ Prérequis : secure-platform ; zero-trust-gke pour Workload Identity
Pourquoi l'examen s'y intéresse — L'examen teste la hiérarchie des risques liés aux identifiants : clés de compte de service exportées (le pire) → rotation des clés → emprunt d'identité/jetons de courte durée → Workload Identity / fédération (le mieux, sans clé). Vous devez savoir quand créer des comptes de service dédiés plutôt que d'utiliser ceux par défaut, et comment Workload Identity sur GKE lie un ServiceAccount Kubernetes (KSA) à un compte de service Google (GSA).
Comment RAD le met en œuvre — Services_GCP ne s'appuie jamais sur le compte de service Compute Engine par défaut pour les charges de travail. Il crée des comptes à usage délimité :
| Compte de service | Usage | Exemples de rôles |
|---|---|---|
cloudrun-sa-{prefix} | Exécution Cloud Run | roles/run.admin, roles/secretmanager.secretAccessor, roles/cloudsql.client, roles/storage.objectAdmin, roles/compute.networkUser |
cloudbuild-sa-{prefix} | Builds CI/CD | 17 rôles, dont roles/cloudkms.signerVerifier, roles/binaryauthorization.attestorsViewer, roles/containeranalysis.admin |
clouddeploy-sa-{prefix} | Livraison progressive | roles/clouddeploy.jobRunner, roles/run.admin, roles/container.admin |
gke-sa-{prefix} | Nœuds GKE + charges de travail | rôles de nœud (roles/logging.logWriter, roles/monitoring.metricWriter, roles/artifactregistry.reader) plus rôles de charge de travail (roles/cloudsql.client, roles/secretmanager.secretAccessor) |
nfs-sa-{prefix} | VM du serveur NFS | rôles compute/monitoring minimaux |
Sur GKE, App_GKE annote le KSA de l'espace de noms avec iam.gke.io/gcp-service-account et lie roles/iam.workloadIdentityUser au membre serviceAccount:{project}.svc.id.goog[namespace/ksa]. Le pool de charges de travail du cluster est {project}.svc.id.goog (explicite en mode STANDARD, automatique sur Autopilot). Aucune clé JSON n'est créée nulle part dans les modules. L'emprunt d'identité est également démontré : cloudbuild-sa reçoit roles/iam.serviceAccountUser sur clouddeploy-sa, et roles/iam.serviceAccountTokenCreator au niveau du projet.
Workload Identity Federation est opérationnel dans Services_GCP : enable_workload_identity_federation (false par défaut) crée le pool wif-pool avec un fournisseur OIDC choisi par wif_provider_type — "github" (par défaut) → fournisseur github-actions avec l'émetteur https://token.actions.githubusercontent.com et une condition d'attribut facultative qui épingle le propriétaire du dépôt à wif_github_org ; "gitlab" → fournisseur gitlab-ci pointant vers wif_gitlab_hostname ; "generic" → fournisseur oidc-provider avec wif_oidc_issuer_uri et wif_allowed_audiences. Les identités du pool (principalSet://.../*) reçoivent roles/iam.workloadIdentityUser sur les comptes de service Cloud Build, Cloud Deploy et Cloud Run, de sorte qu'une CI externe échange son jeton OIDC contre des identifiants GCP de courte durée — sans clé exportée. Notez que l'ensemble de principaux avec caractère générique est délibérément large ; les configurations de production se limitent à un attribut de dépôt précis. Ces paramètres WIF ne sont proposés que lorsque vous déployez Services_GCP dans un projet qui vous appartient : dans un projet géré par RAD, ils sont retirés du formulaire, car fédérer un système de CI externe dans un projet situé au sein de l'organisation de RAD crée une relation de confiance qui survit au déploiement.
Essayez
- Déployez zero-trust-gke. Dans Console > IAM & Admin > Service Accounts, repérez
gke-sa-{prefix}et ouvrez son onglet Permissions — vous y verrez l'attribution deroles/iam.workloadIdentityUserau principal KSA. - Inspectez l'annotation du KSA et prouvez l'échange de jeton sans clé :
gcloud container clusters get-credentials <cluster> --region us-central1
kubectl get serviceaccount -n <namespace> <prefix> \
  -o jsonpath='{.metadata.annotations.iam\.gke\.io/gcp-service-account}'
# From inside an application pod — token comes from the GKE metadata server:
kubectl exec -n <namespace> deploy/<prefix> -- \
  curl -s -H "Metadata-Flavor: Google" \
  "http://metadata.google.internal/computeMetadata/v1/instance/service-accounts/default/email"
- Vérifiez qu'il n'existe aucune clé gérée par l'utilisateur :
for SA in $(gcloud iam service-accounts list --format="value(email)"); do
  gcloud iam service-accounts keys list --iam-account=$SA \
    --managed-by=user --format="value(name)"
done
- Vous savez que cela a fonctionné lorsque le pod renvoie l'adresse e-mail du GSA (et non un compte par défaut de nœud) et que la liste des clés ne renvoie rien.
Testez-vous
Q1 : Un pod de l'espace de noms app1 doit lire un secret Secret Manager sans aucun fichier de clé monté. Quels sont les trois éléments qui rendent cela possible ?
R : (1) le pool Workload Identity du cluster {project}.svc.id.goog ; (2) le KSA annoté avec iam.gke.io/gcp-service-account: gsa@project.iam.gserviceaccount.com ; (3) une liaison IAM qui accorde roles/iam.workloadIdentityUser sur le GSA à serviceAccount:{project}.svc.id.goog[app1/ksa-name]. Le pod reçoit alors des jetons GSA de courte durée du serveur de métadonnées GKE.
Q2 : Scénario — un auditeur découvre que des développeurs téléchargent des clés JSON pour un pipeline de CI exécuté sur GitHub Actions. Que recommandez-vous ?
R : Workload Identity Federation : créez un pool d'identités de charge de travail avec un fournisseur OIDC GitHub, restreignez-le par une condition d'attribut sur le propriétaire du dépôt, et accordez au principal fédéré roles/iam.workloadIdentityUser sur le compte de service du pipeline. Les jetons OIDC propres à GitHub sont échangés contre des identifiants Google de courte durée ; aucune clé n'est jamais exportée. Appliquez en outre constraints/iam.disableServiceAccountKeyCreation.
Q3 : Pourquoi la plateforme crée-t-elle cloudbuild-sa-{prefix} au lieu d'utiliser l'agent de service Cloud Build par défaut pour tout ?
R : Un SA dédié reçoit exactement les rôles dont le pipeline a besoin (signer des attestations, pousser vers AR, déployer) et peut être audité par déploiement ; l'ancien compte par défaut {project_number}@cloudbuild.gserviceaccount.com est partagé par tous les builds du projet, ce qui élargit le rayon d'impact et brouille les pistes d'audit.
Au-delà des modules — Inspectez la configuration WIF déployée avec gcloud iam workload-identity-pools providers list --workload-identity-pool=wif-pool --location=global, et connaissez les équivalents manuels : gcloud iam workload-identity-pools create demo-pool --location=global puis gcloud iam workload-identity-pools providers create-oidc github --workload-identity-pool=demo-pool --location=global --issuer-uri=https://token.actions.githubusercontent.com --attribute-mapping="google.subject=assertion.sub". Étudiez aussi les règles d'administration constraints/iam.disableServiceAccountKeyCreation et constraints/iam.automaticIamGrantsForDefaultServiceAccounts, l'audit de l'âge des clés, la désactivation d'un compte de service sans le supprimer (gcloud iam service-accounts disable SA), les identifiants de courte durée via l'API IAM Service Account Credentials, et l'emprunt d'identité via gcloud auth print-access-token --impersonate-service-account=SA.
⚠️ Piège d'examen — roles/iam.serviceAccountUser permet à un principal d'associer un compte de service / s'exécuter en tant que ce compte (au moment du déploiement), tandis que roles/iam.serviceAccountTokenCreator lui permet de générer des jetons pour le SA (emprunt d'identité). Accorder l'un ou l'autre au niveau du projet revient de fait à céder tous les SA du projet — accordez-les plutôt sur la ressource SA individuelle.
1.3 Gestion de l'authentification (Managing authentication)
⏱ ~1 h · 💰 aucun coût supplémentaire (IAP lui-même est gratuit) · ⚙️ Prérequis : guarded-edge ou zero-trust-gke avec
enable_iap = true
Pourquoi l'examen s'y intéresse — L'examen teste l'authentification contextuelle basée sur un proxy (IAP comme brique de BeyondCorp) par opposition à l'accès basé sur le réseau (VPN), le flux de consentement OAuth, le contrôle des sessions et les niveaux d'application de la validation en deux étapes. Vous devez savoir ce qu'IAP authentifie (l'identité Google, via OAuth) et ce qu'il autorise ensuite (roles/iap.httpsResourceAccessor).
Comment RAD le met en œuvre — Deux modèles d'intégration IAP différents, tous deux derrière enable_iap (false par défaut) :
| Aspect | App_CloudRun | App_GKE |
|---|---|---|
| Mécanisme | IAP natif de Cloud Run v2 — le service est créé avec IAP activé et s'exécute au stade de lancement BETA | GCPBackendPolicy sur le backend de la Gateway, qui référence un Secret Kubernetes {service}-iap-oauth contenant le secret du client OAuth |
| Entrées requises | au moins un de iap_authorized_users / iap_authorized_groups (validation au moment du plan) | idem, plus iap_oauth_client_id, iap_oauth_client_secret et iap_support_email (validations au moment du plan) |
| Agent de service | roles/run.invoker accordé à service-{project_number}@gcp-sa-iap.iam.gserviceaccount.com | IAP configuré sur le service de backend de l'équilibreur de charge |
| Autorisation des utilisateurs | roles/iap.httpsResourceAccessor au niveau du projet + roles/run.invoker sur le service | roles/iap.httpsResourceAccessor accordé par backend |
| Protection contre le verrouillage | l'identité qui déploie est automatiquement ajoutée à la liste autorisée (découverte à partir de l'OpenID userinfo de l'appelant) | même logique d'ajout automatique |
Notez que sur Cloud Run, l'IAP natif protège aussi l'URL directe *.run.app ; aucune restriction d'entrée n'est donc nécessaire pour IAP seul.
Essayez
- Définissez
enable_iap = trueavec votre adresse e-mail dansiap_authorized_users, puis redéployez. - Ouvrez l'URL du service dans une fenêtre de navigation privée — vous êtes redirigé vers la connexion Google ; après authentification avec un compte non autorisé, vous obtenez la page IAP « You don't have access ».
- Dans Console > Security > Identity-Aware Proxy, trouvez la ressource et passez en revue les principaux.
- Vérifications en CLI :
# Cloud Run: IAP-enabled services run in the BETA launch stage
gcloud run services describe <service> --region us-central1 \
  --format="value(launchStage)"
# Who can pass IAP?
gcloud projects get-iam-policy $GOOGLE_PROJECT_ID \
  --flatten="bindings[].members" \
  --filter="bindings.role:roles/iap.httpsResourceAccessor" \
  --format="table(bindings.members)"
- Vous savez que cela a fonctionné lorsqu'un compte Google non autorisé est bloqué par IAP avant que la requête n'atteigne votre conteneur (aucune entrée n'est produite dans les journaux de l'application).
Testez-vous
Q1 : Scénario — la mission d'un prestataire prend fin. L'application interne étant protégée par IAP, comment l'accès est-il révoqué, et en combien de temps ?
R : Retirez l'utilisateur (ou son appartenance au groupe) de iap_authorized_users/iap_authorized_groups et redéployez — la liaison roles/iap.httpsResourceAccessor est supprimée et IAP lui refuse l'accès en périphérie du réseau Google en quelques minutes. Aucune révocation de certificat VPN, aucune modification de pare-feu ni déconnexion applicative n'est nécessaire ; c'est l'avantage BeyondCorp que l'examen attend.
Q2 : Pourquoi App_GKE exige-t-il un ID et un secret de client OAuth alors qu'App_CloudRun ne le fait pas ?
R : Cloud Run v2 expose un IAP natif (iap_enabled), qui utilise une configuration OAuth gérée par Google. Le chemin via la Gateway GKE utilise l'IAP classique sur service de backend, qui exige toujours de créer un client OAuth dans APIs & Services > Credentials et de le fournir via iap_oauth_client_id/iap_oauth_client_secret ; le module stocke le secret dans un Secret Kubernetes référencé par la GCPBackendPolicy.
Au-delà des modules — Non couvert : la stratégie de mots de passe et la gestion des sessions pour les comptes utilisateur (Admin Console > Security > Password management, et le contrôle des sessions Google Cloud pour la fréquence de réauthentification), l'application de la validation en deux étapes (Admin Console > Security > 2-step verification ; sachez que les clés matérielles FIDO2 sont la seule méthode résistante à l'hameçonnage), le réglage de la durée des sessions IAP, l'accès contextuel (combinaison d'IAP et des niveaux d'accès Access Context Manager pour des conditions liées à l'appareil ou à l'adresse IP), l'intégration d'applications SAML, et le transfert TCP d'IAP pour SSH/RDP — essayez gcloud compute ssh VM --tunnel-through-iap dans un projet de test (la règle de pare-feu fw-allow-iap-ssh de la plateforme pour 35.235.240.0/20 autorise déjà ce chemin).
⚠️ Piège d'examen — IAP authentifie l'utilisateur, mais un service Cloud Run doit aussi autoriser la requête transmise : sans roles/run.invoker pour l'utilisateur (ou pour l'agent de service IAP), les requêtes échouent encore après une connexion réussie. Le module accorde les deux — retenez cette paire pour l'examen.
1.4 Gestion et mise en œuvre des contrôles d'autorisation (Managing and implementing authorization controls)
⏱ ~1 h · 💰 aucun coût supplémentaire · ⚙️ Prérequis : déploiement par défaut de n'importe quel module d'application
Pourquoi l'examen s'y intéresse — Les questions de scénario reposent sur l'endroit où un rôle est accordé : roles/editor au niveau du projet est presque toujours une mauvaise réponse ; l'attribution de rôles prédéfinis au niveau des ressources est le modèle attendu. Vous devez aussi connaître l'accès uniforme au niveau du bucket, IAM Conditions, les stratégies de refus et les outils Policy Intelligence.
Comment RAD le met en œuvre — la couche IAM au niveau des ressources de la plateforme constitue un catalogue opérationnel du moindre privilège :
| Liaison | Portée | Rôle |
|---|---|---|
| Lecture du secret du mot de passe de la base de données | le secret concerné | roles/secretmanager.secretAccessor |
| Secrets d'application modifiables | le secret concerné | roles/secretmanager.secretVersionManager |
| Accès aux données du bucket de l'application | le bucket concerné | roles/storage.objectAdmin |
| Métadonnées du bucket de l'application | le bucket concerné | roles/storage.legacyBucketReader |
| Jeton GitHub | le secret concerné | roles/secretmanager.secretAccessor (SA de build uniquement) |
| Déploiement Cloud Build | projet | var.deployment_role + roles/iam.serviceAccountUser sur le SA d'exécution |
Les buckets créés par la couche de stockage d'objets de la plateforme activent l'accès uniforme au niveau du bucket pour chacun d'eux, et le bucket de sauvegarde a l'accès uniforme au niveau du bucket activé avec la prévention de l'accès public appliquée. Les secrets sont injectés dans les charges de travail uniquement par référence — secret_environment_variables ({} par défaut) associe des noms de variables d'environnement à des ID de secrets Secret Manager, résolus à l'exécution.
Deux autres objectifs de l'examen apparaissent ici. Autorisations via des groupes : iap_authorized_groups lie un groupe Google plutôt que des individus, de sorte que les changements d'appartenance dans Cloud Identity modifient l'accès sans redéploiement. Access Context Manager : lorsque enable_vpc_sc = true, la plateforme crée des niveaux d'accès Access Context Manager (plages CIDR des sous-réseaux VPC, admin_ip_ranges, l'agent de service IAP et les comptes de service CI/CD) — voir la section 2.2. Ces paramètres ne sont proposés que dans un projet que vous apportez ; un projet géré par RAD les omet du formulaire, car une organisation possède une seule stratégie d'accès et un tenant ne doit pas modifier celle de RAD.
Essayez
- Dans Console > Security > Secret Manager, ouvrez le secret du mot de passe de la base de données (nommé
secret-{instance}-{service}) et consultez Permissions — seuls les SA de la charge de travail et du build y figurent, aucun principal à l'échelle du projet. - Comparez la stratégie au niveau de la ressource et au niveau du projet :
gcloud secrets get-iam-policy secret-<instance>-<service> \
  --format="table(bindings.role, bindings.members)"
gcloud storage buckets describe gs://<app-bucket> \
  --format="value(uniform_bucket_level_access)"
- Test négatif : créez manuellement un nouveau secret (
gcloud secrets create scratch-secret --replication-policy=automatic), puis exécutez une commande dans la charge de travail et tentez de le lire — l'accès est refusé, car l'attributionsecretAccessordu SA est faite par secret et non au niveau du projet. (Sur GKE,gke-sadétient aussi une attributionsecretAccessorau niveau du projet, issue de Services_GCP ; effectuez donc ce test sur le déploiement Cloud Run pour obtenir un résultat net.) - Ajoutez le secret à
secret_environment_variablesdans le portail, redéployez et testez de nouveau. Vous savez que cela a fonctionné lorsque la lecture auparavant refusée réussit désormais.
Testez-vous
Q1 : Scénario — une application doit lire un bucket et un secret. Un collègue propose d'accorder roles/editor « pour faire simple ». Que faites-vous, et pourquoi ?
R : Accordez roles/storage.objectViewer (ou objectAdmin si elle écrit) sur ce bucket et roles/secretmanager.secretAccessor sur ce secret uniquement. Si le SA est compromis, l'attaquant atteint deux ressources au lieu du projet entier. L'examen attend des rôles prédéfinis à la portée de ressource la plus étroite ; des rôles personnalisés uniquement lorsqu'aucun rôle prédéfini ne convient.
Q2 : Une ancienne ACL d'objet accorde la lecture à allUsers sur un objet d'un bucket. Comment garantir qu'IAM est l'unique source de vérité ?
R : Activez l'accès uniforme au niveau du bucket — les ACL d'objet cessent totalement d'être évaluées et l'IAM du bucket/du projet régit tous les accès. Associez-le à public_access_prevention = enforced pour bloquer toute attribution future à allUsers/allAuthenticatedUsers, comme le fait le bucket de sauvegarde du module.
Q3 : Comment empêcheriez-vous tout le monde, y compris les propriétaires du projet, de supprimer les récepteurs de journaux d'audit ?
R : Avec une stratégie de refus IAM — les règles de refus sont évaluées avant les liaisons d'autorisation et les priment. Associez une stratégie de refus aux autorisations concernées (par ex. logging.sinks.delete) avec un ensemble de principaux exemptés pour l'identité d'accès d'urgence. Une bonne hygiène des stratégies d'autorisation ne suffit pas à elle seule à obtenir ce résultat.
Au-delà des modules — Non mis en œuvre : la gestion des autorisations par ACL Cloud Storage en parallèle d'IAM (accès précis par opposition à l'accès uniforme au niveau du bucket, que la plateforme utilise et qui désactive les ACL), IAM Conditions (liaisons limitées dans le temps ou par attribut de ressource — essayez gcloud projects add-iam-policy-binding $GOOGLE_PROJECT_ID --member=user:x@example.com --role=roles/viewer --condition='expression=request.time < timestamp("2026-12-31T00:00:00Z"),title=temp'), les stratégies de refus IAM (gcloud iam policies create ... --kind=denypolicies), Privileged Access Manager (attributions temporaires juste-à-temps, soumises à approbation — connaissez ses cas d'usage : accès d'urgence, modifications en production, séparation des tâches) et Policy Intelligence (recommandations de rôles d'IAM Recommender, Policy Analyzer, Policy Troubleshooter). La conception de niveaux d'accès pour l'accès contextuel (conditions liées à l'appareil, à l'adresse IP, à l'identité) mérite aussi d'être étudiée au-delà des niveaux basés sur le réseau et l'identité que crée la plateforme.
⚠️ Piège d'examen — roles/secretmanager.secretAccessor permet de lire le contenu des secrets ; roles/secretmanager.viewer ne lit que les métadonnées. Les distracteurs les intervertissent. Le module accorde secretAccessor pour les lectures et secretVersionManager (gestion des versions) pour le chemin de rotation.
1.5 Définition de la hiérarchie des ressources (Defining the resource hierarchy)
⏱ ~45 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : un projet au sein d'une organisation pour observer les effets de la hiérarchie
Pourquoi l'examen s'y intéresse — L'héritage organisation → dossier → projet détermine la stratégie effective : les liaisons d'autorisation IAM sont héritées vers le bas, le refus prime sur l'autorisation, et les contraintes des règles d'administration fixent des garde-fous qu'aucun administrateur de projet ne peut contourner. L'examen teste la conception des dossiers, les contraintes personnalisées des règles d'administration (CEL) et l'ordre d'évaluation de la stratégie effective.
Comment RAD le met en œuvre — Les modules ont une portée limitée au projet et ne gèrent ni les dossiers ni les règles d'administration. Si votre projet de lab est un projet géré par RAD, il se trouve toutefois dans l'un des dossiers de palier de RAD et hérite des règles d'administration de ce dossier — et les modules sont écrits pour les respecter : le modèle d'instance du serveur NFS définit enable-oslogin = true pour constraints/compute.requireOsLogin et Shielded VM pour constraints/compute.requireShieldedVm (toutes deux appliquées sur les dossiers de développement et de production), les buckets utilisent par défaut l'accès uniforme au niveau du bucket pour constraints/storage.uniformBucketLevelAccess, et gcp.resourceLocations limite les régions que vous pouvez choisir. Le seul endroit où la hiérarchie est visible est la découverte de l'organisation par VPC Service Controls : la plateforme lit l'ID d'organisation du projet et distingue trois cas — projet directement sous l'organisation (ID d'organisation découvert automatiquement, VPC-SC se poursuit), projet imbriqué dans un dossier (ID de dossier défini mais ID d'organisation vide → un avertissement vous demande de définir organization_id explicitement), et projet autonome (aucune organisation → VPC-SC définitivement indisponible, ignoré avec un avertissement). C'est une leçon pratique sur la façon dont la position d'un projet dans la hiérarchie détermine les fonctionnalités de sécurité auxquelles vous avez tout simplement accès.
Essayez
- Découvrez où se situe votre projet de lab :
gcloud projects describe $GOOGLE_PROJECT_ID --format="value(parent.type, parent.id)"
- Dans Console > IAM & Admin > Organization Policies, passez en revue les contraintes effectives sur le projet (par ex.
constraints/iam.disableServiceAccountKeyCreation,constraints/gcp.resourceLocations) et notez à quel niveau chacune est définie :
gcloud org-policies list --project=$GOOGLE_PROJECT_ID
- Si vous êtes administrateur des règles d'administration dans un bac à sable, définissez une contrainte d'emplacement sur un dossier de test et tentez de déployer depuis le portail un bucket hors de la région autorisée — l'application échoue avec une violation de règle.
- Vous savez que cela a fonctionné lorsque vous pouvez expliquer, pour une contrainte donnée, quel ancêtre l'a définie et pourquoi le projet ne peut pas la remplacer.
Testez-vous
Q1 : Scénario — enable_vpc_sc = true se déploie sans erreur, mais aucun périmètre n'apparaît, et le journal indique que l'ID d'organisation n'a pas pu être découvert automatiquement. Le projet se trouve dans un dossier. Quelle est la correction ?
R : Définissez organization_id explicitement dans les variables du portail d'App_CloudRun/App_GKE. data.google_project n'expose org_id que pour les projets dont le parent est directement l'organisation ; les projets imbriqués dans un dossier renvoient folder_id à la place, si bien que la découverte automatique échoue par conception et que le module ignore VPC-SC avec un avertissement plutôt que de deviner.
Q2 : Un rôle IAM accordé au niveau de l'organisation entre en conflit avec une stratégie de refus au niveau d'un dossier. Laquelle l'emporte ?
R : La stratégie de refus. Le refus est évalué avant l'autorisation à chaque niveau ; une autorisation héritée du niveau de l'organisation ne peut pas primer sur un refus au niveau d'un dossier. Utilisez Policy Troubleshooter pour retracer la décision effective.
Au-delà des modules — À étudier : la gestion des dossiers et des projets à grande échelle (conception des dossiers par environnement, unité opérationnelle ou niveau de conformité, automatisation par fabrique de projets), les contraintes de règles d'administration prédéfinies par opposition aux contraintes personnalisées en CEL (IAM & Admin > Organization Policies > Custom constraints). Commande de test utile : gcloud org-policies describe constraints/iam.disableServiceAccountKeyCreation --effective --project=$GOOGLE_PROJECT_ID.
⚠️ Piège d'examen — Les contraintes des règles d'administration restreignent la configuration des ressources (ce qui peut être créé et comment) ; IAM contrôle qui peut agir. « Utiliser une règle d'administration pour retirer l'accès d'un utilisateur » est une mauvaise réponse classique — et inversement.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.