Guide de préparation à la certification PCNE : Section 1 — Conception et planification d'un réseau VPC Google Cloud (Designing and planning a Google Cloud VPC network) (~21 % de l'examen)
📚 Guide officiel de l'examen : Professional Cloud Network Engineer certification — vérifiez toujours la pondération des sections dans le guide d'examen Google Cloud en vigueur.
Cette section évalue les décisions de conception réseau : comment dimensionner et segmenter l'espace d'adressage IP, quand choisir le VPC partagé plutôt que l'appairage ou Private Service Connect, et comment planifier le réseau GKE avant que le premier cluster n'existe. Déployez d'abord le profil VPC Foundation ; ajoutez le profil GKE Network Lab avant d'aborder la partie 1.4. Les modules mis en pratique sont Services_GCP (le réseau lui-même) et App_Common (la manière dont les modules en aval le découvrent).
1.1 Conception d'une architecture réseau globale (Designing an overall network architecture)
⏱ ~45 min · 💰 aucun coût supplémentaire au-delà du profil VPC Foundation · ⚙️ Prérequis : déploiement par défaut
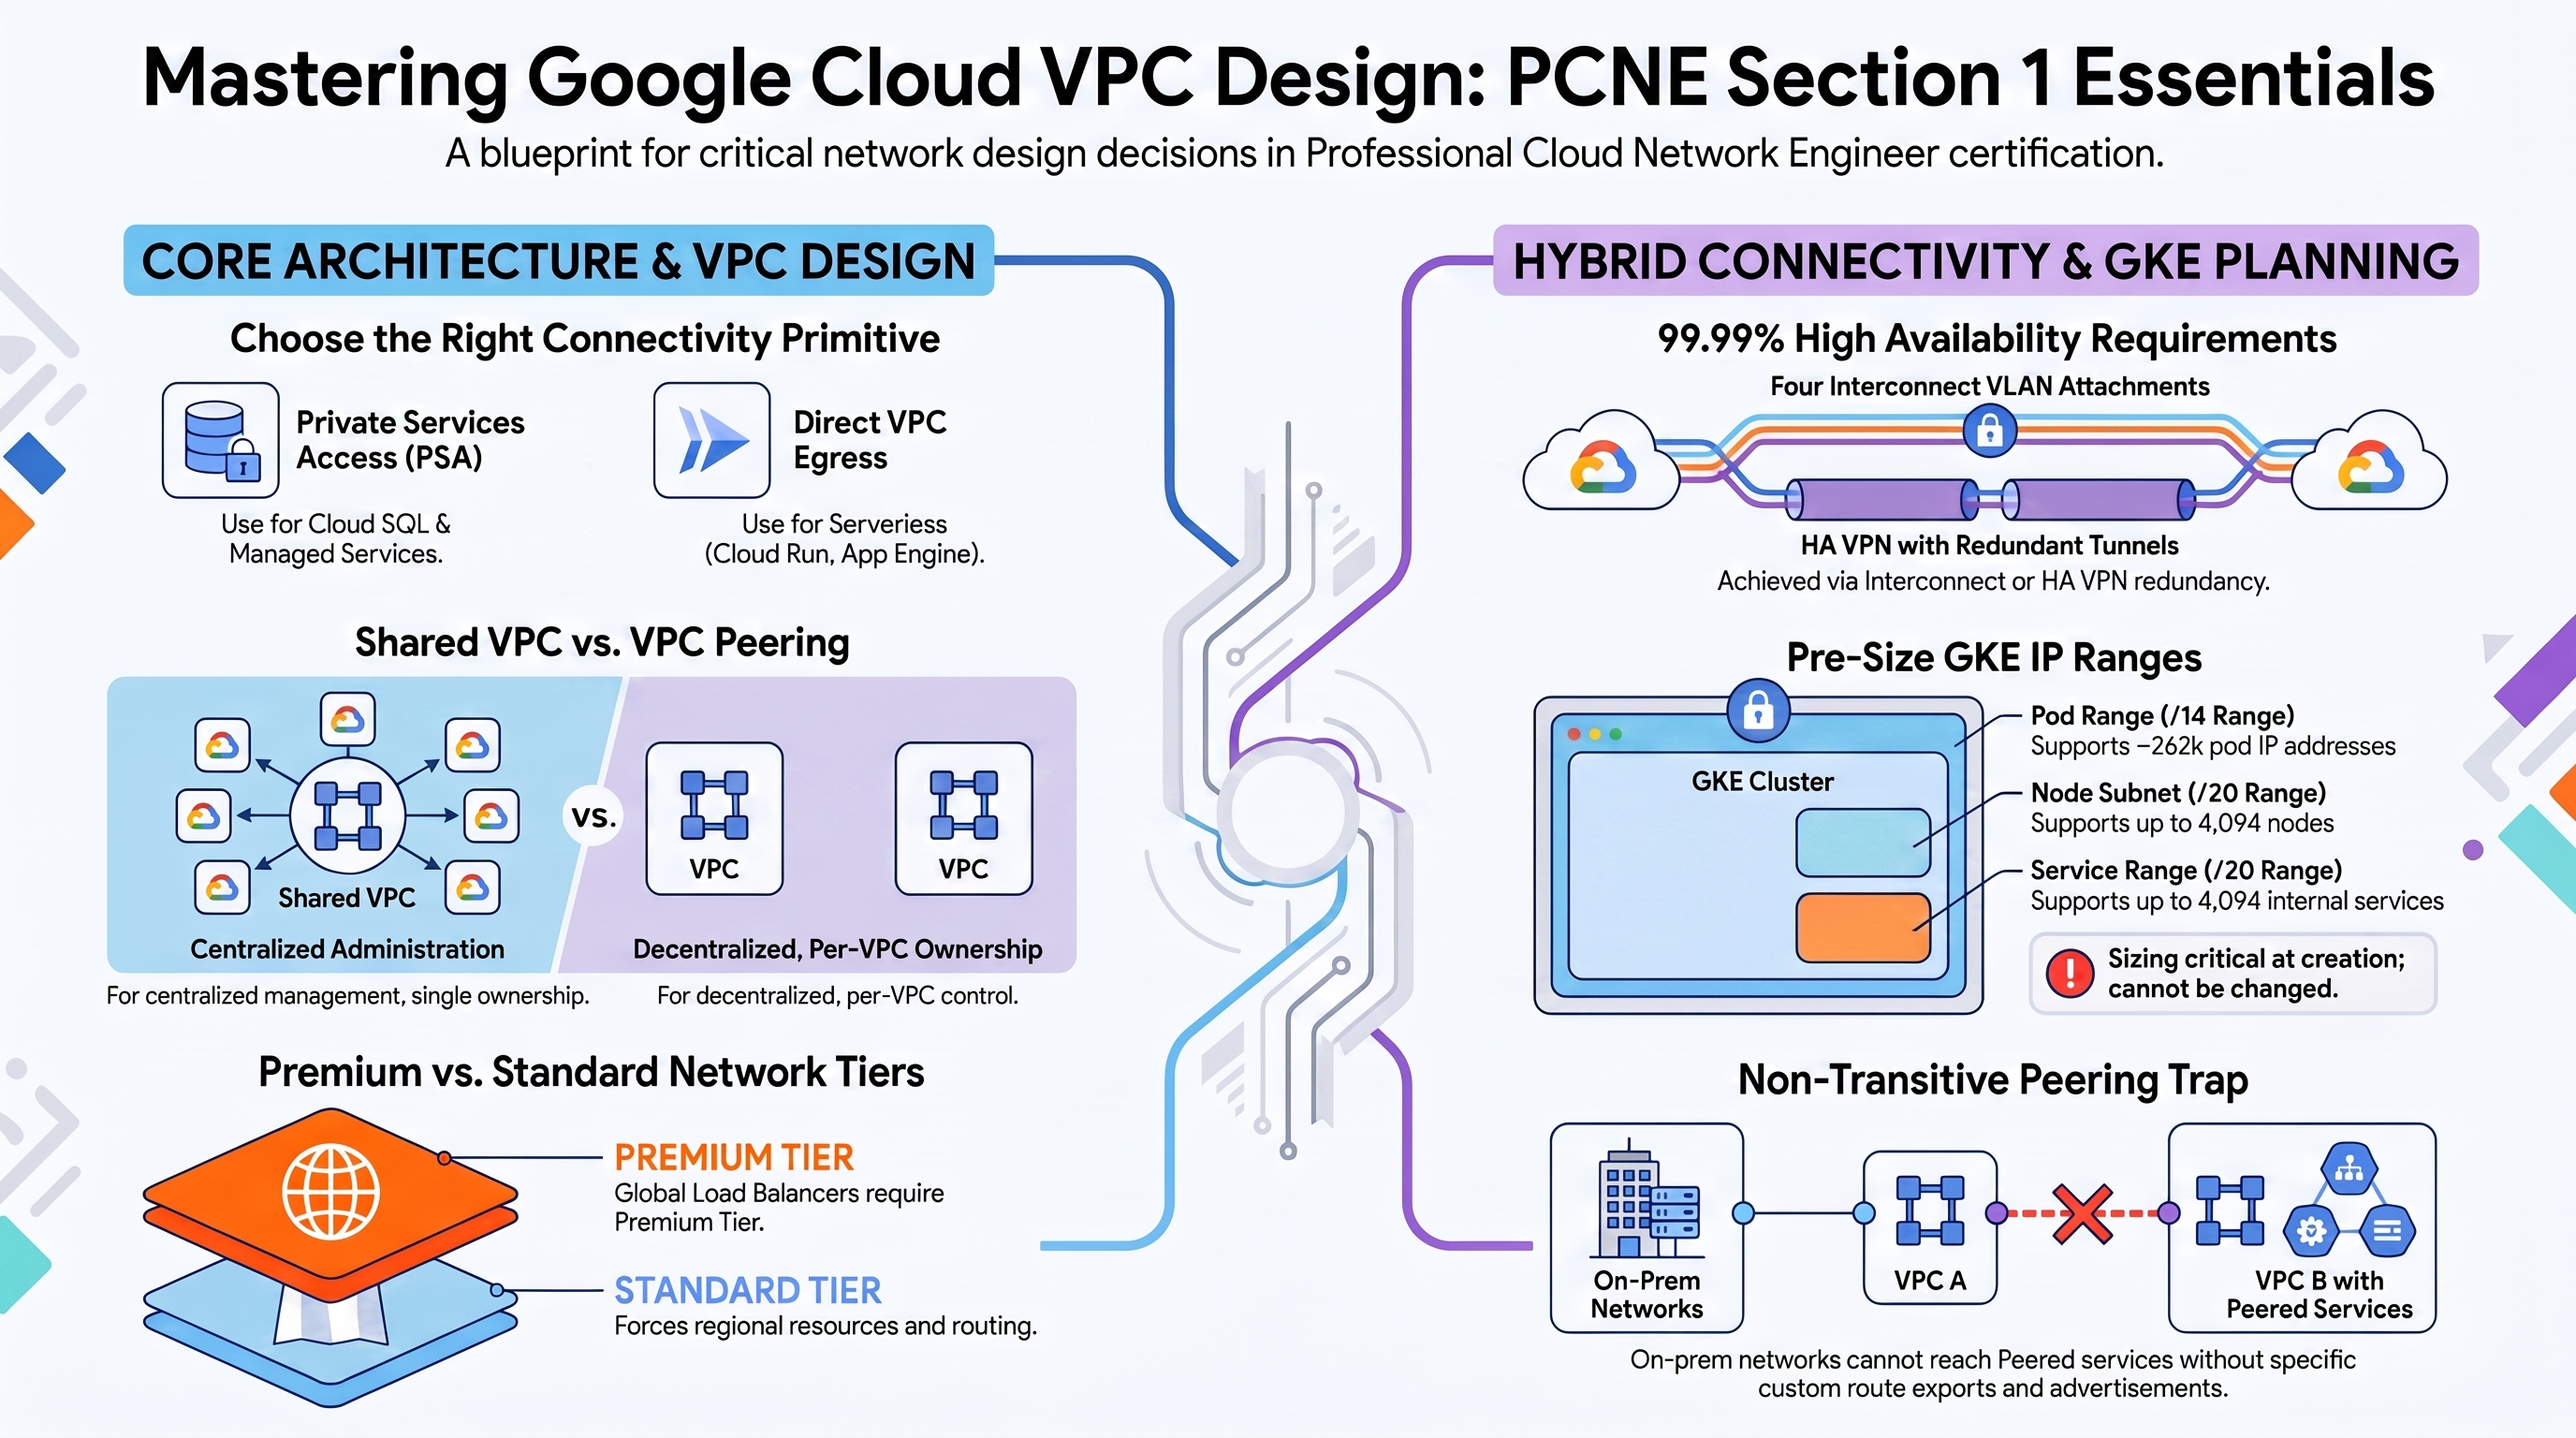
Pourquoi c'est important pour l'examen — Les questions d'architecture vérifient que vous savez choisir la bonne primitive de connectivité pour un service géré : l'accès aux services privés (PSA) pour Cloud SQL/Memorystore, Private Service Connect (PSC) pour les points de terminaison de producteurs, la sortie VPC directe ou un connecteur d'accès au VPC sans serveur (Serverless VPC Access) pour Cloud Run. Elles portent aussi sur le choix de l'équilibreur de charge (Application LB externe global, régional ou passthrough) et sur le respect des quotas par votre conception (plages de sous-réseaux par VPC, limites de routes d'appairage).
Comment RAD le met en œuvre — La plateforme fait trois choix d'architecture délibérés que vous pouvez examiner :
| Décision | Choix de RAD |
|---|---|
| Connectivité des services gérés | PSA : une plage interne /16 réservée à l'appairage VPC, plus une connexion Service Networking |
| Connectivité du sans-serveur vers le VPC | Sortie VPC directe de Cloud Run (une interface réseau sur un sous-réseau) — aucun connecteur Serverless VPC Access nulle part |
| Point d'entrée exposé à Internet | Un équilibreur de charge d'application externe avec un NEG sans serveur, créé lorsque enable_cloud_armor (par défaut false) ou enable_cdn (par défaut false) est activé |
Memorystore Redis expose en outre ce choix directement : redis_connect_mode (par défaut DIRECT_PEERING, option PRIVATE_SERVICE_ACCESS). Filestore utilise DIRECT_PEERING.
Essayez
-
Déployez le profil VPC Foundation. Dans Console > VPC network > VPC network peering, repérez l'appairage
servicenetworking-googleapis-comcréé par la connexion PSA. -
Inspectez la plage réservée et l'appairage depuis la CLI :
gcloud compute addresses list --global \
  --filter="purpose=VPC_PEERING" \
  --format="table(name,address,prefixLength,network)"
gcloud services vpc-peerings list \
--network=$(gcloud compute networks list --filter="name~vpc-network" --format="value(name)" | head -1) -
Dans Console > Cloud Run, ouvrez votre service > onglet Networking. Vérifiez que « VPC » affiche une interface réseau sur le sous-réseau Services_GCP (sortie VPC directe) plutôt qu'un connecteur.
-
Vous savez que cela a fonctionné lorsque l'adresse PSA affiche
prefixLength: 16et que l'IP privée de l'instance Cloud SQL (visible dans SQL > instance > Connections) se trouve dans cette plage.
Vérifiez vos acquis
Q1 : Un service Cloud Run doit joindre l'IP privée d'une instance Cloud SQL et un CIDR sur site via un VPN. Sortie VPC directe ou connecteur Serverless VPC Access — et quel paramètre de sortie ?
R : Les deux conviennent pour le routage vers le VPC, mais la sortie VPC directe (celle qu'utilise RAD) évite le coût des instances du connecteur et offre un meilleur débit. Pour joindre le site, vpc_egress_setting = "ALL_TRAFFIC" n'est pas strictement nécessaire — PRIVATE_RANGES_ONLY (la valeur par défaut de RAD) achemine les destinations RFC 1918 via le VPC, ce qui couvre un CIDR privé sur site. ALL_TRAFFIC est nécessaire lorsque des destinations publiques doivent aussi traverser le VPC (par exemple pour l'ajout d'une IP de sortie NAT à une liste d'autorisation).
Q2 : Pourquoi la plateforme réserve-t-elle un /16 pour l'accès aux services privés plutôt qu'un /24 ?
R : Chaque producteur de services (Cloud SQL, Memorystore, Filestore) découpe des sous-réseaux par région dans la plage allouée, à l'intérieur du VPC producteur de Google. Une petite allocation peut s'épuiser à mesure que l'on ajoute des instances, des réplicas et des régions, et l'agrandir ensuite impose de mettre à jour la réservation. Un /16 laisse de la marge pour tous les producteurs que la plateforme pourrait activer.
Q3 : Quel niveau de réseau utilisent les équilibreurs de charge créés par les modules ?
R : Les équilibreurs de charge d'application externes globaux avec le schéma EXTERNAL_MANAGED exigent le niveau Premium, qui est la valeur par défaut du projet. Les modules ne définissent jamais de network_tier ; tout fonctionne donc en Premium. Le niveau Standard imposerait un équilibrage de charge régional et des règles de transfert régionales — l'une des raisons pour lesquelles une conception « IP statique globale + niveau Standard » est un piège d'examen.
Au-delà des modules — L'examen porte aussi sur : les niveaux de réseau Premium et Standard (étudiez « Network Service Tiers overview » ; essayez gcloud compute project-info describe --format="value(defaultNetworkTier)") ; la topologie de résolution DNS (zones privées Cloud DNS, horizon partagé — rien dans RAD) ; les rôles IAM pour la conception réseau (roles/compute.networkAdmin vs networkUser vs securityAdmin, roles/compute.loadBalancerAdmin pour le provisionnement des équilibreurs de charge, et les attributions networkUser au niveau du sous-réseau pour le VPC partagé — seul roles/compute.networkUser apparaît dans RAD, attribué au compte de service GKE) ; les plans de réseau GKE (plages secondaires, évolutivité déterminée par l'espace IP, accès au plan de contrôle — voir 1.4) ; et les quotas/limites (étudiez « VPC resource quotas » : plages de sous-réseaux par réseau, plages secondaires par sous-réseau, limites d'appairage). Pour PSC, étudiez « Private Service Connect types » — RAD n'utilise que l'appairage PSA, jamais de points de terminaison PSC, malgré le nom de ressource psconnect_private_ip_alloc.
⚠️ Piège d'examen — L'accès aux services privés est mis en œuvre par appairage VPC ; il est donc non transitif : un réseau sur site connecté par VPN ne peut pas joindre l'IP privée d'une instance Cloud SQL à travers le VPC consommateur, sauf si vous exportez des routes personnalisées sur l'appairage et annoncez la plage PSA depuis Cloud Router. RAD active déjà l'export de routes personnalisées sur l'appairage PSA — sachez pourquoi.
1.2 Conception de réseaux VPC (Designing VPC networks)
⏱ ~45 min · 💰 aucun coût supplémentaire · ⚙️ Prérequis : profil VPC Foundation
Pourquoi c'est important pour l'examen — Vous devez choisir entre des VPC autonomes, le VPC partagé et des conceptions multi-VPC reliées par appairage, NCC ou PSC, puis défendre un plan IPAM : quels CIDR, combien de sous-réseaux, ressources globales ou régionales, MTU, et ce qui se passe en cas de collision d'espaces d'adressage.
Comment RAD le met en œuvre — Un VPC autonome en mode personnalisé par projet :
| Variable / comportement | Par défaut |
|---|---|
VPC vpc-network-{resource_prefix} — en mode personnalisé (les sous-réseaux ne sont pas créés automatiquement) | toujours |
availability_regions — un sous-réseau par région listée | ["us-central1"] |
subnet_cidr_range — un CIDR par région, validé pour 1 à 2 entrées | ["10.0.0.0/24"] |
Description de sous-réseau managed-by=services-gcp — le contrat de découverte utilisé par les modules d'application | toujours |
Le modèle IPAM déterministe mérite d'être étudié de près. Lorsqu'aucun VPC Services_GCP n'existe, App_CloudRun et App_GKE provisionnent des VPC intégrés dont le CIDR de sous-réseau est un /24 déterministe découpé dans 192.168.0.0/16 — dérivé d'un SHA-256 du suffixe du déploiement — afin que plusieurs déploiements autonomes n'annoncent jamais le même CIDR dans l'appairage PSA partagé. Le chemin GKE intégré va plus loin : des plages de pods issues de 10.0.0.0/8 et des plages de services issues de 100.64.0.0/10 — l'espace d'adressage partagé RFC 6598, un exemple concret de planification IP hors RFC 1918.
La couche de découverte exécute gcloud compute networks subnets list --filter="description~managed-by=services-gcp" et récupère aussi les tags réseau des règles de pare-feu d'entrée existantes, afin que l'interface VPC de Cloud Run porte les bons tags.
Essayez
-
Dans votre portail de déploiement, redéployez Services_GCP avec
availability_regions = ["us-central1", "us-west1"]etsubnet_cidr_range = ["10.0.0.0/24", "10.0.1.0/24"]. -
Vérifiez la disposition des sous-réseaux et que le VPC est en mode personnalisé :
gcloud compute networks describe vpc-network-<prefix> \
  --format="value(x_gcloud_subnet_mode,routingConfig.routingMode)"
gcloud compute networks subnets list \
  --network=vpc-network-<prefix> \
--format="table(name,region,ipCidrRange,description)" -
Console > VPC network > VPC networks — ouvrez le réseau et notez la colonne MTU (les modules ne la définissent jamais ; elle vaut donc la valeur par défaut, 1460).
-
Vous savez que cela a fonctionné lorsque deux sous-réseaux apparaissent, un par région, chacun portant la description
managed-by=services-gcp.
Vérifiez vos acquis
Q1 : Deux déploiements App_GKE dans un même projet, sans Services_GCP. Pourquoi le schéma de CIDR haché est-il nécessaire plutôt qu'un 192.168.0.0/24 fixe pour les deux ?
R : Les deux VPC intégrés sont appairés avec le même producteur Service Networking via PSA. Si deux VPC consommateurs annoncent des CIDR de sous-réseau identiques, le producteur n'installe une route de retour que pour l'un d'eux, ce qui fait disparaître silencieusement le trafic de réponse de l'autre déploiement. Des /24 déterministes et distincts par hachage garantissent des annonces sans chevauchement — pour la même raison que les plans IP sur site et cloud ne doivent jamais se chevaucher.
Q2 : Un client a besoin que 40 projets de service partagent un même réseau avec une administration centralisée du pare-feu. VPC autonomes avec appairage, ou VPC partagé ?
R : Le VPC partagé. L'appairage ne passe pas à l'échelle sur le plan administratif (maillage complet, non transitif, pare-feu géré VPC par VPC) et il est soumis aux limites de routes des groupes d'appairage. Le VPC partagé conserve les sous-réseaux, les routes et les règles de pare-feu dans un seul projet hôte, tandis que les projets de service y rattachent leurs charges de travail via roles/compute.networkUser sur des sous-réseaux précis. Le modèle « un VPC par projet » de RAD évite délibérément cela — connaissez les deux.
Au-delà des modules — Non mis en œuvre et très présent à l'examen : le VPC partagé (projets hôte/de service, IAM au niveau du sous-réseau — essayez gcloud compute shared-vpc enable HOST_PROJECT dans une organisation de test), l'appairage de réseaux VPC entre vos propres VPC (gcloud compute networks peerings create, souvenez-vous de la non-transitivité et de l'absence de CIDR qui se chevauchent), les topologies NCC en étoile/maillage pour les conceptions à nombreux VPC, IPv6 (sous-réseaux à double pile, --stack-type=IPV4_IPV6), BYOIP/PUPI, Private NAT pour les plages qui se chevauchent, l'automatisation IPAM (plages internes, gcloud network-connectivity internal-ranges create, pour réserver et allouer les CIDR de manière centralisée), les conceptions réseau globales ou régionales (un VPC est global ; l'isolation régionale vient des sous-réseaux, du mode de routage et des services par région), les décisions de MTU (1460 par défaut, 8896 en jumbo pour l'intra-VPC et l'Interconnect compatible), et l'insertion de NVA avec des routes statiques personnalisées ou basées sur des règles plus un LB interne. Pages à étudier : « Shared VPC overview », « VPC Network Peering », « Create and use IPv6 », « MTU of a VPC network ».
⚠️ Piège d'examen — Les sous-réseaux sont régionaux ; les VPC et leurs tables de routage sont globaux. « Créer un sous-réseau par zone » est faux, et une VM dans us-west1 joint un sous-réseau de us-central1 sans routage supplémentaire. Ne confondez pas le mode de routage dynamique (régional ou global, qui n'affecte que les routes apprises par Cloud Router) avec la portée des sous-réseaux.
1.3 Conception d'un réseau hybride et multicloud résilient et performant (Designing a resilient and performant hybrid and multi-cloud network)
⏱ ~60 min d'étude · 💰 aucun coût de plateforme · ⚙️ Prérequis : rien de déployé — concept uniquement
Pourquoi c'est important pour l'examen — Choisir entre Dedicated Interconnect (10/100 Gbit/s, votre propre présence en colocation), Partner Interconnect (50 Mbit/s–50 Gbit/s via un fournisseur), Cross-Cloud Interconnect (vers AWS/Azure) et HA VPN (chiffré, transporté par Internet, 99,99 % avec deux tunnels par interface) est le schéma de décision le plus récurrent de cet examen, avec les topologies SLA d'Interconnect à 99,9 % et 99,99 % et la conception du transfert DNS hybride.
Comment RAD le met en œuvre — Non mis en œuvre par les modules de fondation. Les seuls éléments voisins : le Cloud Router (ASN 64514, sans pair BGP — il existe pour servir d'ancrage à Cloud NAT), et l'export de routes personnalisées de l'appairage PSA, qui est exactement le réglage que vous activeriez pour qu'un réseau sur site puisse joindre les IP privées de Cloud SQL via un futur VPN/Interconnect.
Essayez
-
Même sans liaisons hybrides, vous pouvez inspecter les briques que laissent les modules :
gcloud compute routers list --format="table(name,region,network,bgp.asn)"
gcloud compute routers describe vpc-network-<prefix>-nat-gw-us-central1 \
--region=us-central1 --format="yaml(bgp,nats[].name)" -
Notez
bgp.asn: 64514(un ASN privé) ainsi que l'absence debgpPeerset d'interfaces— comparez avec ce qu'ajouterait un rattachement HA VPN. -
Vous savez que vous l'avez compris lorsque vous pouvez expliquer pourquoi ce routeur pourrait plus tard héberger à la fois NAT et des sessions BGP VPN sur le même réseau.
Vérifiez vos acquis
Q1 : Une entreprise a besoin d'une connectivité vers son site avec un SLA de 99,99 % et un chiffrement en transit. Quelle conception ?
R : HA VPN sur Cloud Interconnect (ou HA VPN seul si Interconnect ne se justifie pas). Le SLA Interconnect à 99,99 % exige quatre rattachements VLAN répartis sur deux zones métropolitaines (deux domaines de disponibilité edge chacune) avec un routage dynamique global ; Interconnect seul n'est pas chiffré, si bien que la réponse attendue à l'examen pour « chiffré + 99,99 % » est HA VPN sur Interconnect, ou MACsec sur les connexions Interconnect compatibles.
Q2 : Des hôtes sur site doivent appeler les API Google de manière privée via l'Interconnect. Que configurez-vous ?
R : Annoncez 199.36.153.4/30 (restricted.googleapis.com) ou 199.36.153.8/30 (private.googleapis.com) depuis Cloud Router sous forme d'annonce de route personnalisée, créez une zone privée Cloud DNS pour googleapis.com qui fait correspondre *.googleapis.com à ces VIP, et rendez-la résolvable sur site via le transfert DNS/une stratégie de serveur entrante. Notez que la NetworkPolicy GKE de RAD autorise déjà exactement ces deux /30 pour la sortie des pods — mêmes VIP, point d'application différent.
Au-delà des modules — Étudiez méthodiquement toute la liste de la partie 1.3 : Dedicated, Partner ou Cross-Cloud Interconnect (« Cloud Interconnect overview ») ; les appliances SD-WAN pour la connectivité des agences (spokes d'appliance de routeur NCC, section 4.4) ; quand le Direct Peering ou un Verified Peering Provider convient (services Google publics comme Workspace, sans accès au VPC et sans SLA) par rapport à Interconnect ; les topologies HA VPN, y compris le VPN entre deux VPC ; le mode de routage dynamique régional ou global et son effet sur les sous-réseaux annoncés par Cloud Router ; l'accès à plusieurs VPC depuis le site (VPC partagé, rattachements par VPC, appairage multi-VPC avec export de routes personnalisées, ou topologies NCC) ; l'accès privé depuis le site à des API Google comme Vertex AI (Private Google Access pour les hôtes sur site ou un point de terminaison PSC pour les API Google, annoncé sur la liaison hybride) ; l'accès aux services gérés via PSC et l'appairage PSA ; le DNS hybride (zones de transfert, stratégies DNS entrantes, appairage DNS, liaison entre projets) ; la planification IP entre le site et le cloud (plages internes, Private NAT en cas de chevauchement) ; la MTU sur les liaisons hybrides (1440 en général pour le VPN, jusqu'à 8896 sur Interconnect) ; MACsec. Commandes à mémoriser pour un projet de test : gcloud compute vpn-gateways create (HA VPN fournit automatiquement deux interfaces), gcloud compute interconnects attachments partner create, gcloud compute routers add-bgp-peer.
⚠️ Piège d'examen — « Le routage dynamique global rend mon VPN hautement disponible » — non. Le mode de routage détermine quels sous-réseaux sont annoncés/appris entre les régions ; la haute disponibilité vient de tunnels/rattachements redondants et du basculement BGP (éventuellement accéléré par BFD).
1.4 Conception pour Google Kubernetes Engine (Designing for Google Kubernetes Engine)
⏱ ~60 min · 💰 coût du cluster Autopilot tant qu'il est déployé · ⚙️ Prérequis : profil GKE Network Lab
Pourquoi c'est important pour l'examen — L'épuisement des adresses IP dans GKE est un incident classique : l'examen évalue le dimensionnement du sous-réseau des nœuds, de la plage secondaire des pods et de la plage secondaire des services avant la création du cluster, le choix entre nœuds publics ou privés et entre points de terminaison du plan de contrôle, et l'adéquation des pools de nœuds aux besoins des charges de travail.
Comment RAD le met en œuvre — La plateforme est un exemple concret de planification IP multicluster déterministe. Pour le cluster i, chaque plage est découpée dans un CIDR de base à l'aide de l'index du cluster :
| Plage | Dérivation | Résultat pour le cluster 1 (valeurs par défaut) |
|---|---|---|
| Sous-réseau des nœuds | un /20 espacé de 16 dans gke_subnet_base_cidr (10.128.0.0/12) | 10.128.0.0/20 (4 094 nœuds) |
| Plage des pods | une tranche /14 de gke_pod_base_cidr (10.64.0.0/10) | 10.64.0.0/14 (~262k IP de pods) |
| Plage des services | une tranche /20 de gke_service_base_cidr (10.8.0.0/16) | 10.8.0.0/20 (4 094 services) |
Chaque sous-réseau porte deux plages secondaires nommées (gke-{prefix}-pods-{i}, gke-{prefix}-services-{i}) — c'est-à-dire des clusters de VPC natif/à IP d'alias. Autres choix de conception vérifiés : gke_cluster_mode par défaut AUTOPILOT (ou STANDARD avec un pool de nœuds explicite : gke_node_machine_type par défaut e2-standard-4, autoscaling de gke_node_min_count 1 à gke_node_max_count 5, disques pd-balanced, nœuds Shielded) ; canal de publication REGULAR ; nœuds privés — private_cluster_config { enable_private_nodes = true } plus un /28 réservé au plan de contrôle issu de gke_master_base_cidr, nécessaire parce que les projets gérés par RAD refusent compute.vmExternalIpAccess ; enable_private_endpoint reste à false, si bien que le point de terminaison du plan de contrôle reste public pour la CI/CD. Le cluster intégré configure en outre des réseaux autorisés maîtres avec l'accès des CIDR publics de Google activé, plus un bloc 0.0.0.0/0 pour que les workers Cloud Build puissent joindre le serveur d'API.
Essayez
-
Déployez le profil GKE Network Lab, puis cartographiez le plan IP de bout en bout :
gcloud container clusters describe gke-cluster-1-<prefix> \
  --location=us-central1 \
  --format="yaml(clusterIpv4Cidr,servicesIpv4Cidr,ipAllocationPolicy,datapathProvider,privateClusterConfig)"
gcloud compute networks subnets describe vpc-network-<prefix>-gke-subnet-1-us-central1 \
  --region=us-central1 \
--format="yaml(ipCidrRange,secondaryIpRanges)" -
Vérifiez
privateClusterConfig.enablePrivateNodes: true(les nœuds n'ont pas d'IP externe) etdatapathProvider: ADVANCED_DATAPATH. -
Dans votre portail, définissez
gke_cluster_count = 2et redéployez : observez que le cluster 2 reçoit10.68.0.0/14pour les pods et10.8.16.0/20pour les services — sans chevauchement par construction. -
Vous savez que cela a fonctionné lorsque
kubectl get pods -o wideaffiche des IP de pods situées dans le CIDR des pods du cluster plutôt que dans le CIDR des nœuds (les IP d'alias en action) :gcloud container clusters get-credentials gke-cluster-1-<prefix> --location=us-central1
kubectl get pods -A -o wide | head
Vérifiez vos acquis
Q1 : Avec les valeurs par défaut, pourquoi la plateforme peut-elle prendre en charge 10 clusters (le maximum de gke_cluster_count) sans collision d'IP ?
R : Chaque CIDR de base est découpé à l'aide de l'index du cluster : 16 tranches /14 possibles pour les pods dans 10.64.0.0/10, 16 tranches /20 pour les services dans 10.8.0.0/16, et des /20 de nœuds espacés de 16 dans 10.128.0.0/12. L'arithmétique garantit des plages disjointes pour les index 1 à 10 — la même discipline de calcul préalable que l'examen attend pour « planifier l'espace IP de N clusters ».
Q2 : Un client soumis à réglementation exige des nœuds sans IP publique et un plan de contrôle joignable uniquement depuis un sous-réseau bastion. Qu'est-ce qui change par rapport à la conception RAD ?
R : Les nœuds privés sont déjà configurés (enable_private_nodes = true à la fois sur le cluster Services_GCP et sur la solution de repli intégrée d'App_GKE ; Cloud NAT gère leur trafic sortant). Seul le plan de contrôle change : définissez enable_private_endpoint = true, ou conservez le point de terminaison public mais limitez les réseaux autorisés maîtres au CIDR du bastion (aujourd'hui, le cluster intégré les ouvre à 0.0.0.0/0). Les clusters RAD ont un point de terminaison public par conception, car le chemin CI/CD (Cloud Build) a besoin d'accéder au serveur d'API ; le cluster intégré ouvre même les réseaux autorisés à 0.0.0.0/0 (l'authentification reste requise) — voyez-y un compromis de commodité, pas une bonne pratique de sécurité.
Q3 : Les pods sont planifiés, mais les nouveaux Services échouent avec « range exhausted ». Quelle plage pose problème, et pouvez-vous la corriger sur place ?
R : La plage secondaire des services. Elle est fixée à la création du cluster et ne peut pas être remplacée ; les pods peuvent être soulagés par des plages de pods supplémentaires (--additional-pod-ipv4-ranges / plages de pods par pool de nœuds), mais l'épuisement de la plage des services impose de recréer le cluster avec une plage plus grande — c'est pourquoi l'examen (et la valeur par défaut /20 de RAD) vous poussent à la dimensionner dès le départ.
Au-delà des modules — À étudier : nœuds publics ou privés et pools de nœuds (RAD montre les nœuds privés), clusters privés et les trois modèles d'accès au plan de contrôle (point de terminaison public, public + réseaux autorisés, point de terminaison privé), plus le plus récent point de terminaison du plan de contrôle basé sur DNS ; les sources d'adresses IP de GKE — RFC 1918, hors RFC 1918, la plage de services gérée par Google, la connectivité du plan de contrôle basée sur PSC, les plages IP partagées et PUPI (le chemin intégré de RAD utilise déjà 100.64.0.0/10 pour les services) ; GKE en IPv6/double pile ; les options d'équilibrage de charge de GKE (LB natif en conteneurs avec NEG — traité dans la section 3) ; la conception des pools de nœuds (taints, SSD local, spot). Documentation : « Alias IP ranges », « GKE address management », « About private clusters ».
⚠️ Piège d'examen — La plage des pods doit être dimensionnée selon nœuds × pods maximum par nœud × 2 (GKE réserve par défaut un /24 par nœud en mode Standard ; Autopilot la gère mais consomme tout de même la plage). Une réponse « plage de pods /24 pour un cluster de 100 nœuds » est toujours fausse — le sous-réseau des nœuds et la plage des pods se dimensionnent selon des calculs différents.
Need RAD to do something it does not do yet? Request it on the roadmap, or vote on what is already there.